Om du utforskar AI-drivna verktyg för web scraping har du säkert stött på Crawl4AI. Det är ett populärt open source-projekt som har väckt stort intresse bland utvecklare tack vare sin snabbhet och flexibilitet. Men vad händer om du inte kodar — eller om du bara vill få ut data snabbt, utan att brottas med Python-skript? Oavsett om du funderar på Crawl4AI för ditt nästa projekt eller letar efter ett mer lättanvänt alternativ, särskilt om du jobbar med försäljning, marknadsföring, e-handel eller fastigheter, så är du på rätt ställe. I den här recensionen går jag igenom vad Crawl4AI erbjuder, var det briljerar och var det kan lämna dig med fler frågor än svar. Jag visar också hur Thunderbit står sig som en modern no-code-lösning för företagsanvändare som vill skrapa webben med bara några klick.
Vad är Crawl4AI?
Crawl4AI är ett open source-Pythonbibliotek som är byggt för webbcrawling och datautvinning, med särskilt fokus på AI och användningsområden för stora språkmodeller (LLM). Det har fått fäste på GitHub tack vare sin höga hastighet, parallella crawling och förmåga att exportera data i AI-vänliga format som JSON och Markdown. Kort sagt är det ett verktyg för utvecklare som vill skrapa webbplatser i stor skala och sedan mata in datan i AI-modeller, analysdashboardar eller egna databaser.
Viktiga produkter och funktioner:
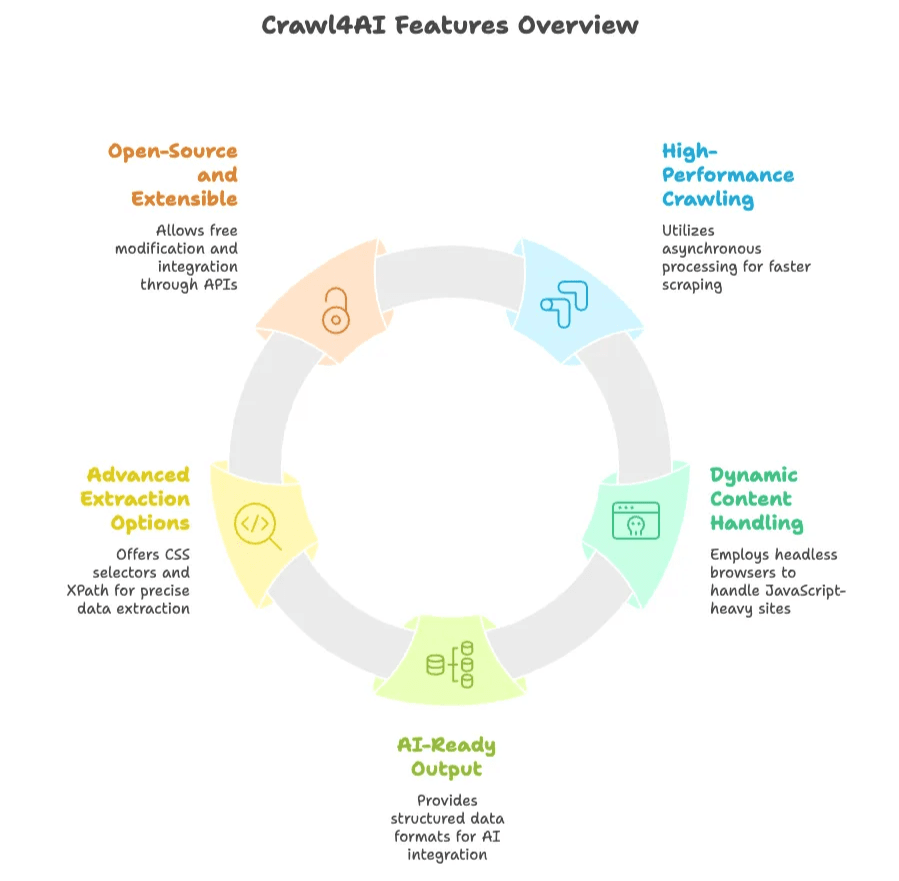
- Högpresterande crawling: Använder asynkron, parallell bearbetning för att crawla flera sidor samtidigt, vilket gör det mycket snabbare än många traditionella scrapers.
- Hantering av dynamiskt innehåll: Kontrollerar en headless browser (som Chromium via Playwright) för att köra JavaScript och skrapa moderna, dynamiska webbplatser.
- AI-redo output: Exporterar data som strukturerad text (JSON, Markdown eller rensad HTML) som är redo för AI eller dataanalys.
- Avancerade extraktionsalternativ: Låter användare ange extraktionsregler med CSS-selektorer eller XPath, och kan till och med integrera LLM:er för innehållssammanfattning eller extraktion.
- Open source och utbyggbart: Gratis att använda, ändra och vidareutveckla. Erbjuder Python-API, kommandoradsgränssnitt och REST API för flexibel integration.
Crawl4AI:s filosofi är att ”demokratisera data” genom att ge utvecklare en snabb, koddriven scraper utan kommersiella verktygs betalväggar eller begränsningar. Om du är bekväm med Python är det ett kraftfullt sätt att snabbt samla in stora mängder webdata.
Vem är Crawl4AI för?
Crawl4AI är främst byggt för tekniska användare — tänk utvecklare, data scientists, AI-forskare och alla som är bekväma med att skriva Python-skript. Här är några vanliga användningsområden:
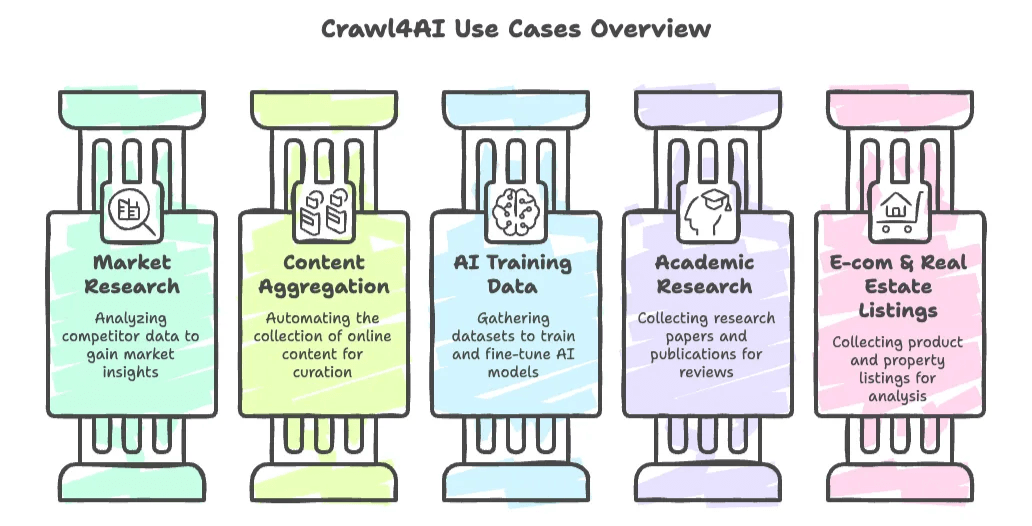
- Marknadsundersökningar och konkurrensanalys: Skrapa konkurrenters webbplatser, nyhetsartiklar eller sociala medier för insikter.
- Innehållsaggregiering: Automatisera insamlingen av nyheter, bloggar eller foruminlägg för kurering eller trendbevakning.
- Insamling av träningsdata för AI: Samla stora datamängder (som dokumentation, frågor och svar eller artiklar) för att träna eller finjustera språkmodeller.
- Akademisk forskning: Samla automatiskt in forskningsartiklar, rättsfall eller publikationer på nätet för litteraturöversikter.
- E-handel och fastighetsannonser: Utvecklare kan bygga anpassade crawlers för att samla in produkt- eller bostadsannonser för analys.
Men här är den avgörande frågan: Crawl4AI är inte byggt för icke-tekniska användare. Om du är försäljningschef, marknadsförare eller mäklare utan kodvana kommer du sannolikt att tycka att installationen och användningen känns avskräckande. Verktyget utgår från att du kan hitta runt i Python och är bekväm med att konfigurera extraktionsregler och felsöka problem.
Crawl4AI:s prisplan
En av Crawl4AI:s största fördelar är priset: det är helt gratis. Eftersom det är ett open source-projekt finns det inga licensavgifter, abonnemangsnivåer eller betalväggar. Du kan installera det via pip och börja använda det direkt.
Men ”gratis” kommer med några förbehåll:
- Installation och underhåll: Du behöver lägga tid på att sätta upp din miljö, skriva skript och underhålla dina scrapingflöden.
- Indirekta kostnader: Om du kör stora crawls kan du behöva betala för proxies, servrar eller molnresurser.
- Support: Det finns ingen officiell kundsupport — bara communityforum och GitHub-ärenden.
För företag med teknisk kompetens internt kan det här vara en kostnadseffektiv lösning. Men för icke-tekniska team kan tiden och arbetet som krävs för att komma igång snabbt äta upp fördelen med prislappen på noll kronor.
Användarfeedback för Crawl4AI
För att få en verklig känsla för hur Crawl4AI presterar gick jag igenom användarrecensioner på teknikbloggar, kataloger för AI-verktyg och communityforum. Här är vad jag fann:
Vad användare gillar
- Snabbhet och kostnadseffektivitet: Utvecklare är lyriska över hur snabbt Crawl4AI kan skrapa stora webbplatser och ofta överträffa betalda verktyg. Att det är gratis är ett stort plus.
- Open source-flexibilitet: Användare älskar att ha full kontroll över koden, utan vendor lock-in eller funktionsbegränsningar.
- AI-redo output: Den strukturerade, rena dataexporten (särskilt i JSON eller Markdown) sparar tid för dem som matar in data i AI-modeller eller analysverktyg.
Var användare kör fast
Men berömmet kommer med några tydliga förbehåll — särskilt för nybörjare eller personer som inte programmerar.
1. Brant inlärningskurva
Ett återkommande tema är att Crawl4AI inte är nybörjarvänligt. Om du är ny inom web scraping eller inte känner dig trygg med Python väntar en brant inlärningskurva. Det finns inget klick-och-klart-gränssnitt; allt görs via skript och konfigurationsfiler. Att sätta upp miljön, skriva extraktionsregler och hantera asynkron crawling kräver teknisk kunskap. En recensent uttryckte det rakt på sak: ”Om du inte kodar kommer du att vara vilse.”
2. Inte vänligt för helt nya nybörjare
Även för dem med viss teknisk bakgrund kan Crawl4AI vara utmanande. Dokumentationen blir bättre, men communityn är fortfarande liten, så det kan ta tid att få hjälp. Användare rapporterar buggar eller krascher på komplexa webbplatser, och felsökning innebär ofta att gräva i GitHub-ärenden eller Stack Overflow. Det saknas också inbyggda funktioner för vanliga företagsbehov — som att logga in på webbplatser, lösa CAPTCHA eller schemalägga återkommande crawls. Om du vill skrapa data enligt schema eller hantera autentisering behöver du bygga de funktionerna själv.
Exempel från verkligheten:
- En marknadschef på ett medelstort e-handelsföretag försökte använda Crawl4AI för att bevaka konkurrenters priser. Efter flera dagar av brottning med Python-skript och webbläsardrivrutiner gav de upp och bytte till ett no-code-verktyg. De tekniska hindren och bristen på support gjorde det opraktiskt för teamet.
- En fastighetsmäklare ville skrapa bostadsannonser från flera sajter. Personen upplevde att Crawl4AI:s installation var överväldigande och kom inte förbi den första konfigurationen. Utan en utvecklare till hands stannade projektet av.
Kort sagt är Crawl4AI ett kraftpaket för utvecklare, men en tuff lösning för företagsanvändare som bara vill få fram data utan huvudvärken.
Viktiga slutsatser från recensionen av Crawl4AI
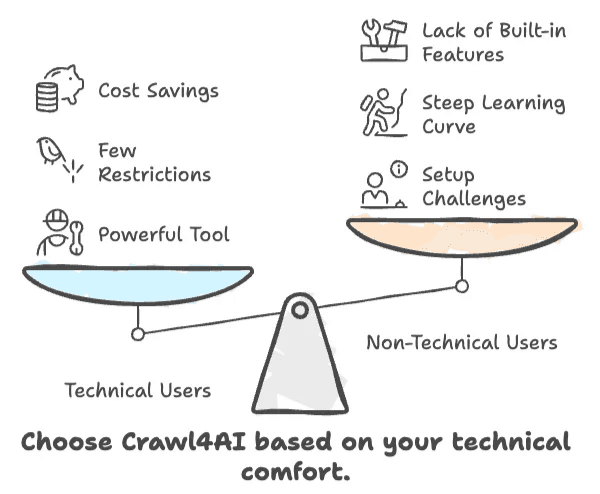
- Crawl4AI är snabbt, flexibelt och gratis — men bara om du är bekväm med kod.
- Icke-tekniska användare kommer att kämpa med installationen, inlärningskurvan och avsaknaden av inbyggda affärsfunktioner.
- Om du behöver en klick-och-klart-lösning utan kod är Crawl4AI troligen inte för dig.
- För utvecklare och AI-utövare är det ett kraftfullt verktyg med få begränsningar.
- För företagsanvändare kan tiden och ansträngningen som krävs överstiga kostnadsbesparingen.
Vi presenterar Thunderbit: AI-webbscrapern utan kod för företagsanvändare
Efter att ha sett var Crawl4AI brister för icke-tekniska användare, låt oss tala om ett bättre alternativ: Thunderbit.
Thunderbit är ett AI-drivet Chrome-tillägg för web scraping byggt specifikt för företagsanvändare — försäljning, marknadsföring, e-handel och fastighetsproffs som vill extrahera data från vilken webbplats som helst snabbt, utan någon kod alls. Jag har testat många scrapingverktyg, och Thunderbit utmärker sig genom sin enkelhet och kraft.
Vad gör Thunderbit annorlunda?
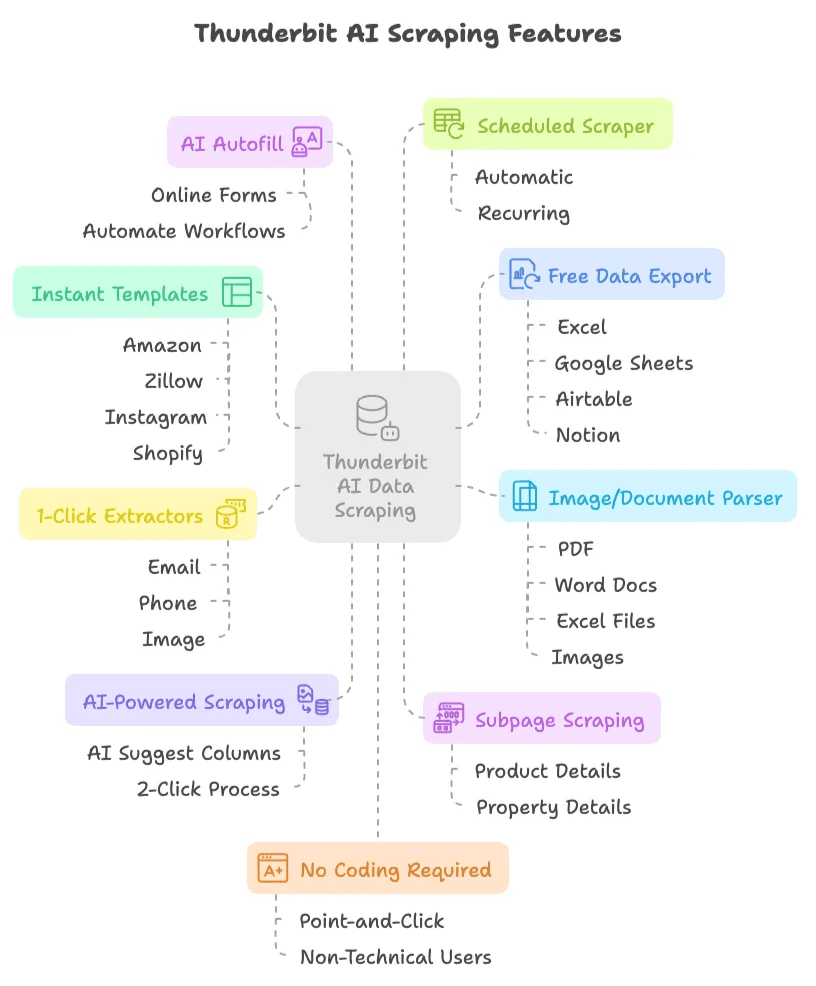
- AI-driven scraping i 2 klick: Klicka bara på ”Föreslå kolumner med AI”, låt AI föreslå vad som ska extraheras och tryck sedan på ”Skrapa”. Klart. Inga skript, inga selektorer, inga bekymmer.
- Skrapning av undersidor: Thunderbits AI kan automatiskt besöka undersidor (som produkt- eller fastighetsdetaljer) och berika din datatabell — ingen manuell uppsättning behövs.
- Direkta scraper-mallar: För populära webbplatser som Amazon, Zillow, Instagram och Shopify kan du exportera data med ett klick med förbyggda mallar.
- Gratis dataexport: Exportera din skrapade data till Excel, Google Sheets, Airtable eller Notion — utan extra kostnad.
- AI Autofill (helt gratis): Använd AI för att fylla i formulär online och automatisera arbetsflöden. Välj bara sammanhanget och låt Thunderbit sköta resten.
- Schemalagd Scraper: Ställ in automatiska, återkommande scrapingkörningar med ett enkelt schema — inga cron-jobb eller serverinstallation krävs.
- Ettklicks-extraktorer för e-post, telefon och bilder: Hämta direkt e-postadresser, telefonnummer eller bilder från vilken webbplats som helst.
- Bild-/dokumenttolk: Extrahera tabeller från PDF-filer, Word-dokument, Excel-filer eller bilder. Ladda upp filen, låt AI strukturera datan och klicka på ”Skrapa”.
- Ingen kod krävs: Allt är klickbart och utformat för icke-tekniska användare.
Skrapa data från vilken webbplats som helst med AI Get Started Free
Thunderbit handlar om att göra webdata tillgänglig för alla — inte bara utvecklare. Om du vill se hur det fungerar kan du kolla in nedladdningssidan för Thunderbit Chrome-tillägget eller läsa Thunderbit-bloggen för verkliga användningsfall.
Prova Thunderbit AI Web Scraper gratis
Thunderbits prisplaner
Thunderbit använder ett enkelt kreditsystem: 1 kredit = 1 utdatarad. Så här ser planerna ut:
| Nivå | Månadspris | Årspris (per månad) | Krediter (per månad) |
|---|---|---|---|
| Gratis | Gratis | Gratis | 6 sidor |
| Starter | 15 $ | 9 $ | 500 |
| Pro 1 | 38 $ | 16,5 $ | 3 000 |
| Pro 2 | 75 $ | 33,8 $ | 6 000 |
| Pro 3 | 125 $ | 68,4 $ | 10 000 |
| Pro 4 | 249 $ | 137,5 $ | 20 000 |
Du kan börja gratis och skrapa upp till 6 sidor (eller 10 med en gratis provperiod). Betalda planer låser upp fler krediter och avancerade funktioner, men även gratisnivån är generös för lättare användning. För mer information, besök sidan Thunderbit-priser.
Thunderbit jämfört med Crawl4AI: sida vid sida
Låt oss ställa Thunderbit och Crawl4AI mot varandra så att du kan se var varje verktyg glänser — och var Thunderbit gör livet enklare för företagsanvändare.
| Funktion / kriterium | Thunderbit | Crawl4AI |
|---|---|---|
| No-code, klick-och-klart-gränssnitt | ✅ | ❌ |
| Föreslå kolumner med AI (automatisk identifiering) | ✅ | ❌ |
| Skrapning av undersidor (automatiskt) | ✅ | ❌ |
| Direkta mallar (Amazon etc.) | ✅ | ❌ |
| Gratis dataexport (Excel, Sheets) | ✅ | ❌ |
| AI Autofill (formulärifyllning) | ✅ | ❌ |
| Schemalagd scraping (utan kod) | ✅ | ❌ |
| Ettklicks-extraktion av e-post/telefon/bilder | ✅ | ❌ |
| Extraktion av tabeller från bild/dokument | ✅ | ❌ |
| Hanterar dynamiskt innehåll | ✅ | ✅ |
| Open source | ❌ | ✅ |
| Kräver kodning | ❌ | ✅ |
| Gratis nivå finns | ✅ | ✅ |
| Community-support | ✅ | ⚠️ (begränsad) |
| Byggt för företagsanvändare | ✅ | ❌ |
| Byggt för utvecklare | ⚠️ | ✅ |
| Pris | $ (gratis och betalda planer) | Gratis |
| Kundsupport | ✅ | ❌ |
Teckenförklaring:
✅ = Ja
❌ = Nej
⚠️ = Begränsad/delvis
$ = Betalda planer finns
Slutsats
Om du är en utvecklare som gillar att experimentera med kod och vill ha total kontroll är Crawl4AI ett kraftfullt, gratis verktyg för web scraping i stor skala. Men om du är en företagsanvändare — särskilt inom försäljning, marknadsföring, e-handel eller fastigheter — och bara vill få ut data utan krångel, är Thunderbit den tydliga vinnaren. Det är byggt för icke-tekniska användare, med AI-driven automatisering, direkta mallar och ett vänligt gränssnitt som tar dig från webbplats till kalkylark på några sekunder.
Skrapa vilken webbplats som helst med Thunderbit
Vanliga frågor
1. Hur står sig Thunderbit jämfört med andra AI-webbskrapare som Crawl4AI?
Thunderbit är utformat för icke-tekniska användare och erbjuder ett no-code-gränssnitt där man klickar sig fram, medan Crawl4AI är ett utvecklarfokuserat open source-Pythonbibliotek. Thunderbit automatiserar komplexa uppgifter med AI, vilket gör web scraping tillgängligt för alla.
2. Vilka unika funktioner erbjuder Thunderbit för företagsanvändare?
Thunderbit erbjuder AI-drivna kolumnförslag, skrapning av undersidor, direkta mallar för populära webbplatser och gratis dataexport till Excel eller Google Sheets — allt utan kod. Det innehåller också schemalagd scraping och ettklicksextraktorer för e-post, telefonnummer och bilder.
3. Kan Thunderbit hantera komplex datautvinning som PDF-filer eller bilder?
Absolut! Thunderbits AI kan extrahera tabeller från PDF-filer, Word-dokument, Excel-filer och bilder. Ladda bara upp filen, låt AI strukturera datan och klicka på ”Skrapa” för omedelbara resultat. Läs mer på Thunderbit-bloggen.
Läs mer
- Vad är data scraping och hur gör man det 2025 – Thunderbit-bloggen
- De bästa verktygen och mjukvaran för web scraping 2025 – Thunderbit-bloggen
- De främsta AI-verktygen för datainsamling för modellklara datamängder – Medium
- Hur AI-webbscrapare kan hjälpa med datautvinning och analys - Forbes
Prova AI Web Scraper Get Started Free




