
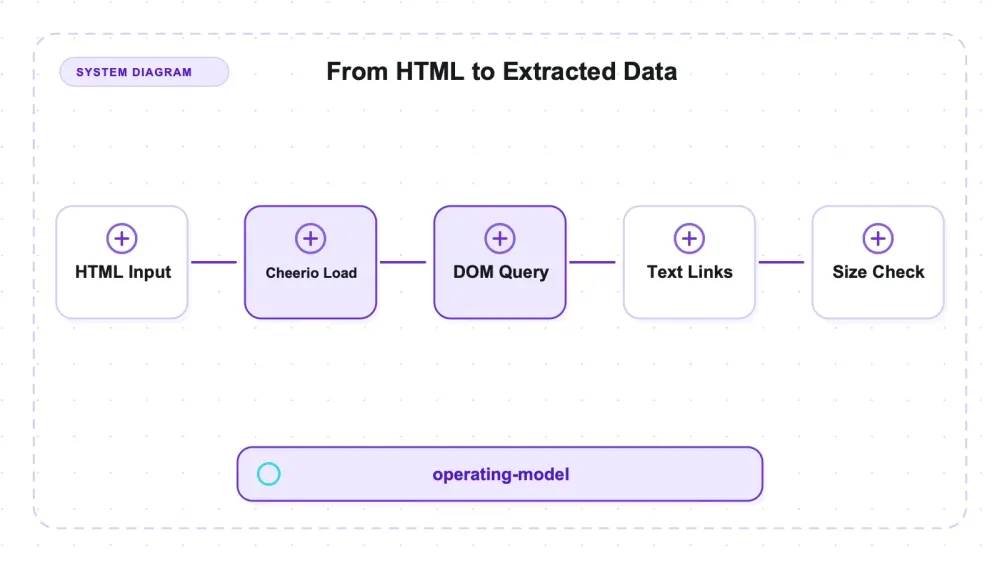
På en maskin tog det i Node med cheerio 2 927,89 ms att parsa och extrahera titlar samt href-länkar från ett syntetiskt HTML-dokument på 10 MB. selectolax, körd via CPython med en C-baserad parser, klarade samma fältextraktion på 158 ms. De sorterade titeltexterna och href-hasharna stämde överens. Det här är en jämförelse av hela stacken mellan olika runtime-miljöer, inte ett isolerat utlåtande om parseralgoritmen.
På en sida på 10 KB är gapet 2×, och det är inget någon skulle lägga märke till. Frågan är egentligen var dina sidor ligger på den kurvan.
Vad cheerio är
cheerio är HTML-parsern för Node som använder jQuery-syntax, och det är standardvalet i det ekosystemet av goda skäl: 30 449 GitHub-stjärnor, MIT-licens och en push till repo:t dagen innan jag körde testet. Testad version: 1.2.0.
Officiell referens: Cheerios officiella introduktion.
import * as cheerio from "cheerio";
const $ = cheerio.load(html);
const titles = $("h3.title").map((_, e) => $(e).text()).get();
const hrefs = $("a").map((_, e) => $(e).attr("href")).get();
Har du skrivit jQuery förut kan du redan API:t. Den igenkänningen är en stor del av varför det vann i sitt ekosystem.
Under huven är det inte en enda parser utan en hel kedja: htmlparser2 och parse5 för parsning, domhandler och domutils för trädet, cheerio-select för selektorer, plus undici, encoding-sniffer och andra — elva direkta beroenden, som i sin tur landar i 22 toppnivåpaket och 9,0 MiB på disk. De paketen bidrar med parsning och kodningsfunktioner, men de ökar också beroendebördan. Den här genomgången testade utdata för trasig indata, men inte korrekthet i teckenkodning och inte heller de två parsermotorerna var för sig.
Mätningen, och varför den går att lita på
Det här forskningsunderlaget hade redan en parser-benchmark: fem sidstorlekar från 1 KB till 10 MB, 50 iterationer, tre oberoende körningar och — det viktiga — en paritetskontroll som hashar det extraherade innehållet, sorterade titlar plus sorterade hrefs, mot en referensparser. En parser som i tysthet hoppar över arbete kan inte få en snabb tid.
Att lägga till cheerio krävde två kontroller innan någon siffra räknades.
Låg referensen där den låg förut? selectolax kördes om i samma session på samma testfiler. Dess content hash reproducerades på 5 av 5 storlekar, och p50 låg mellan 0,989× och 1,079× av den publicerade siffran. Så det här är samma maskin som producerade den ursprungliga tabellen.
Producerade cheerio samma scorerade fält? Dess content hash — beräknad i Node med exakt samma regel, SHA-256 över sorterad titeltext och sorterade hrefs — matchade referensen på 5 av 5 storlekar. Det bevisar paritet för de sorterade fälten i just de här testfilerna, inte DOM-struktur, dokumentordning, attribut, textnormalisering eller felåterhämtning.
Först då betyder tiderna något.
| Sidstorlek | selectolax | lxml | PyQuery | cheerio (Node) | cheerio vs selectolax |
|---|---|---|---|---|---|
| 1 KB | 0,0286 ms | 0,0508 | 0,0456 | 0,1147 ms | 4,0× |
| 10 KB | 0,1725 ms | 0,1802 | 0,1728 | 0,3490 ms | 2,0× |
| 100 KB | 1,4855 ms | 1,4145 | 1,4093 | 3,8399 ms | 2,6× |
| 1 MB | 14,97 ms | 15,03 | 14,96 | 59,37 ms | 4,0× |
| 10 MB | 158,10 ms | 165,25 | 162,86 | 2 927,89 ms | 18,5× |
p50 i millisekunder, median av tre körningar. parser-bench.json. De tre Python-parserna kördes i en process; cheerio kördes i Node 22, vilket är en gräns för både runtime och bibliotek — se nedan.
Så ska tabellen läsas, ärligt talat
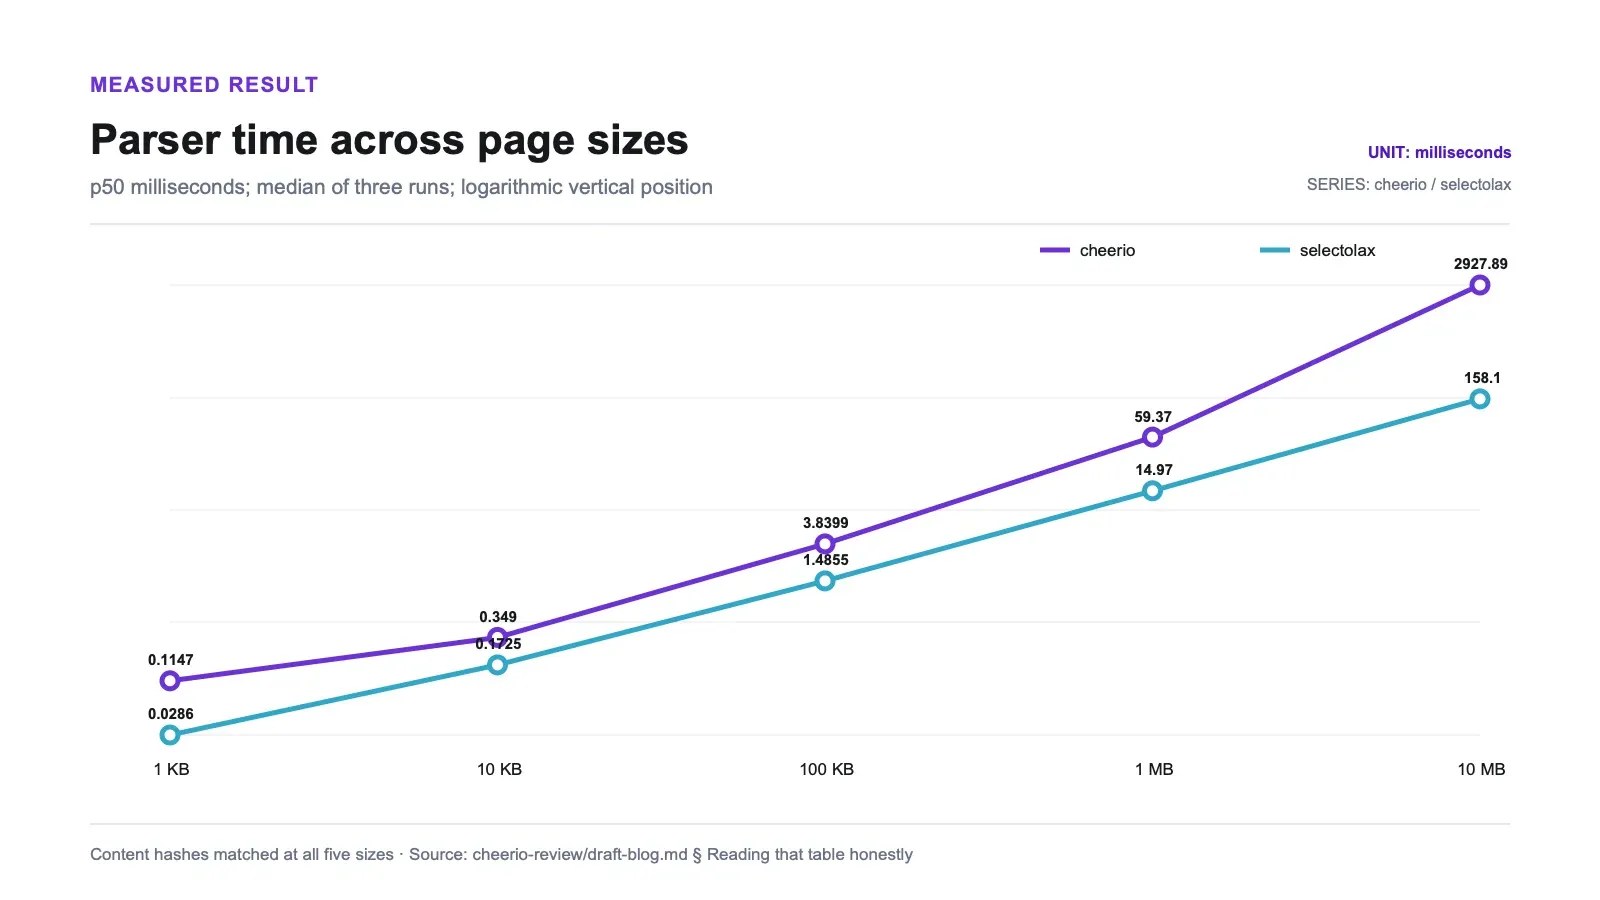
1 KB-raden är brus. Bland de tre Python-parserna var spridningen i den storleken 77,6 %, och enskilda körningar överlappade kraftigt — selectolax låg mellan 0,0267 och 0,0404 ms över sina tre körningar. Vid 28 mikrosekunder dominerar timerupplösning och schemaläggning. Jag skulle inte rangordna något vid 1 KB, inklusive cheerio.
Mitten av tabellen är oansenlig. 2× till 4× på sidor mellan 10 KB och 1 MB. För en scraper som hanterar några hundra sidor betyder det 45 millisekunder per sida i stället för 15, och du kommer aldrig märka det.
10 MB-raden är inte brus. cheerios tre körningar landade på 2 839, 2 928 och 2 954 ms — tajt och tydligt separerade från de mindre storlekarna. Slutresultatet vid 10 MB avviker markant från mönstret på de mindre sidstorlekarna. Fem datapunkter räcker inte för att fastställa asymptotisk komplexitet eller för att peka ut om det är runtime, parser, selektor, allokering eller garbage collection som orsakar hoppet.
Det hamnar i BeautifulSoups intervall. Den publicerade benchmarken mätte fyra fler parsers på samma 10 MB-fixture, och att lägga cheerios 2 927,89 ms bredvid dem är det mest användbara i den här artikeln:
| Parser (10 MB) | p50 |
|---|---|
| selectolax (lexbor) | 159,93 ms |
| lxml | 172,93 ms |
| parsel | 231,85 ms |
| selectolax (modest) | 247,95 ms |
| BeautifulSoup + lxml | 2 261,56 ms |
| BeautifulSoup + html.parser | 2 788,75 ms |
| cheerio | 2 927,89 ms |
De fyra Python-raderna är de publicerade siffrorna från bench_parse.json; cheerios är från den här körningen. Referensparsern reproducerades inom 0,989×–1,079× mellan de två körningarna, så behandla skillnader mindre än ungefär 8 % som inom den osäkerheten — cheerio mot BeautifulSoups html.parser-backend (5 % skillnad) är inom den, cheerio mot selectolax (18×) är det inte.
BeautifulSoup är biblioteket folk väljer när de vill ha bekvämlighet och samtidigt accepterar att det är långsamt — det är det som alla Python-diskussioner om prestanda brukar säga att man ska byta ut. På ett 10 MB-dokument ligger cheerio längst ner i samma intervall, inte i samma liga som de C-baserade parserna det ofta klumpas ihop med.
Frågan om en Node-baserad ersättare är fortfarande öppen i den här artikeln. Nyare alternativ för Node testades inte, så resultatet säger inte att byte av bibliotek är omöjligt eller att de är mindre etablerade. Det visar bara den uppmätta cheerio-vägen jämfört med de listade Python-stackarna.
Det är också en runtime-jämförelse, inte bara en biblioteksjämförelse. cheerios millisekunder kommer från Nodes JIT och garbage collector; de andra kommer från CPython som anropar C-baserade parsers. Content hash bevisar att samma arbete gjordes, och båda siffrorna är det en utvecklare faktiskt upplever när en stack väljs — men ingen bör läsa detta som att "cheerios algoritm är 18× sämre än selectolax". Det här är vad som hände, på den här maskinen, i varje biblioteks egen runtime.
Hur miljön såg ut
| Bibliotek | Paket | Disk | Licens | Stjärnor | Senaste push |
|---|---|---|---|---|---|
| cheerio | 22 (npm) | 9,0 MiB | MIT | 30 449 | 2026-08-11 |
| PyQuery | 3 (pip) | 20,1 MiB | BSD | 2 380 | 2026-07-27 |
Officiell referens: Cheerios dokumentation för konfiguration.
metadata-snapshot.json, hämtad samma dag som texten skrevs.
npm install cheerio tog under två sekunder och drog in 9,0 MiB. Kall import mättes till 0,056 s i en separat körning på samma maskin.
Elva direkta beroenden är mycket för en parser, och bra att känna till om du granskar ditt beroendeträd: htmlparser2, parse5, parse5-htmlparser2-tree-adapter, parse5-parser-stream, domhandler, domutils, dom-serializer, cheerio-select, encoding-sniffer, undici och whatwg-mimetype. Två fullständiga parserimplementationer följer med där, eftersom cheerio kan använda båda beroende på vad du ber om.
Trettiotusen stjärnor och en push dagen före testet är så friskt som underhållssignaler brukar bli i den här kategorin.
Minne, och vad trasig HTML gör med det
Minnesfotavtryck och beteende vid trasig input påverkar både driftsättning och felhantering, så båda mäts separat här.
Det bredare stresstestet finns i jämförelsen av minne och felaktig HTML för tio bibliotek.
Maximalt resident minne, via /usr/bin/time -l, en ny process per cell — importgolvet är det biblioteket kostar när det är laddat och vilande, topparna inkluderar dokumentet.
| Bibliotek | Runtime | Importgolv | Topp vid 226 KB | Topp vid 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18,7 | 19,9 | 71,2 |
| pyquery | python3.14 | 30,3 | 33,9 | 172,5 |
| resiliparse | python3.14 | 20,5 | 25,1 | 225,1 |
| markdownify | python3.14 | 23,9 | 28,9 | 278,5 |
| goose3 | python3.14 | 44,1 | 52,4 | 398,5 |
| cheerio | node22 | 66,8 | 76,5 | 398,5 |
| justext | python3.14 | 30,3 | 36,6 | 431,2 |
| newspaper4k | python3.14 | 52,6 | 61,8 | 668,5 |
| trafilatura | python3.14 | 52,5 | 64,8 | 927,1 |
| turndown | node22 | 47,8 | 68,4 | 2947,1 |
memory-results.json. Python- och Node-baslinjerna är inte jämförbara med varandra; tolken ingår i båda.
cheerio har det högsta importgolvet i den här blandade kontexttabellen på 66,8 MiB, inklusive Node-runtime och beroenden. Processen toppade på 398,5 MiB med 10 MB-fixturen. De andra raderna innehåller parsers, konverterare och artikelutdragare som gör olika huvudjobb, så använd dem som kontext för processfotavtryck snarare än som direkta prestandarankningar. Raden för turndown i samma runtime nådde mycket högre topp, men den gör konvertering snarare än den titel-och-href-kontrakt som mättes för cheerio.
Trasig HTML. Tolv dokument där exakt en sak gick sönder i varje — oavslutade taggar, felnästade inline-element, attribut utan citattecken och mellanslag, ensamma stängtaggar, ingen <html> alls, dubbla attribut, ett dokument avklippt mitt i en tagg, trasiga entiteter, en oavslutad <script>, en lögnaktig charset-deklaration, en kommentar som innehöll markup och 600 nivåer av nästning — plus två välformade kontroller i matchande storlekar, eftersom "den returnerade inget" bara säger något om trasighet om biblioteket inte också är tyst på ett rent dokument av samma storlek.
cheerio kastade fel på 0 av 14 och returnerade inget på 0, och återhämtade 11/22 scorerade markörer över de trasiga fixturerna (malformed-results.json). För parsers kontrollerar scorern heading- och länkmarkörer över elva scorerbara trasiga dokument; den scorerar inte paragrafmarkören, och fixturen med oavslutad <script> är exkluderad. Utan en baseline med samma kontrakt i den här delen är 11/22 ingen kvalitetsrankning. Den säkra slutsatsen är att cheerio returnerade icke-tom utdata utan fel på alla fjorton trasiga-plus-kontroll-inmatningar, samtidigt som den återhämtade hälften av de scorerade markörerna.
För- och nackdelar
Fördelar. Bekant jQuery-syntax. MIT. En underhållssignal i form av 30 449 stjärnor och aktivitet i repo:t dagen före testet. Två parser-backends och kodningsrelaterade paket finns med, även om backend-återhämtning och kodningsnoggrannhet inte isolerades här. Den sorterade hash-kontrollen för titel plus href matchade referensen i varje teststorlek.
Nackdelar. 18,5× långsammare än selectolax på ett 10 MB-dokument och 4× på 1 MB. Elva direkta beroenden, inklusive två kompletta parserimplementationer. Endast Node. Och inget i dokumentationen antyder någon storlek där det slutar vara det självklara valet.
Vem bör använda det, och vem bör inte
Använd cheerio om du arbetar i Node, om jQuery-formad API känns värdefullt och om dina representativa sidor liknar de testade storlekarna upp till 1 MB. En megabyte är den största testade punkten före det kraftiga hoppet vid 10 MB; den här artikeln fastställer inte gränsen mellan dem och påstår inte heller hur stor del av webben som ligger under den.
Benchmarka innan du använder det för mycket stora HTML-dokument som genererade rapporter, katalogdumpar eller långa list-sidor. Beteendet för XML-sitemaps testades inte. På HTML-fixturen på 10 MB är 2,9 sekunder per dokument en påtaglig kostnad som växer med volymen.
Om du arbetar i Python säger jämförelsen något annat: selectolax, lxml och PyQuery är i praktiken lika snabba från 10 KB och uppåt (inom 0,5 % till 5,4 %, med överlappande körningsintervall), så välj utifrån API i stället för hastighet. cheerios gap mot alla tre är den intressanta siffran, inte skillnaderna dem emellan.
Var en managed API-tjänst passar in
cheerio parsar HTML som du redan har. Det hämtar inte, renderar inte JavaScript och hanterar inte ett anti-bot-lager — och på många verkliga mål är det svårare halvan av jobbet.
En managed tjänst för hämtning/rendering/extrahering, inklusive vår egen Thunderbit, ligger i ett annat ansvarslager. Thunderbit benchmarkades inte här. Den relevanta skillnaden är att parsa levererad HTML med selektorer jämfört med att outsourca insamling, rendering och extraktion; den här artikeln ger ingen jämförelse med samma mått för kvalitet, latens eller kostnad.
Den rättvisa ramen: om du redan har HTML och vet vilka selektorer du vill använda är cheerio gratis och trevligt att jobba med. Om du hämtar sidor i skala, eller hellre vill beskriva datan än DOM:en, är det ett annat inköp.
För ett bredare perspektiv täcker vår översikt över web scraping-API:er hostade alternativ och open source-scraper-pelaren de självhystade. Om den parserade utdata ska vidare till en modell, går konvertering av HTML till Markdown i Python igenom var fidelity går förlorad.
Testa Thunderbit för webbdatastraktion
Bör du använda cheerio?
Ja, i Node, när API-formen är viktig och när representativa dokument håller sig nära det testade små-till-1 MB-intervallet.
API-kännedomen och de aktuella underhållssignalerna är legitima urvalskriterier. Benchmarken bevisar inte att en viss supportlösning finns eller att den testade fördelningen av sidstorlekar matchar en produktionsmängd.
Siffran att komma ihåg är 10 MB-siffran. Någonstans mellan 1 MB och 10 MB slutar cheerios kostnad följa de andra och börjar multipliceras — 4× blir 18,5×. Om din korpus innehåller så stora dokument bör du benchmarka innan du bestämmer dig, eftersom inget i biblioteket varnar dig.
Testa Thunderbit för webbdatastraktion Get Started Free
Vanliga frågor
Är det rättvist att jämföra cheerio med Python-parsers? Det är en stackjämförelse, inte en algoritmjämförelse. Alla fyra producerade identisk sorterad titeltext och identiska hrefs enligt hash-regeln på 5 av 5 sidstorlekar. Det bevisar inte total likvärdighet mellan parserna. cheerios tider inkluderar Nodes runtime-beteende, medan de andra inkluderar CPython som anropar C-baserade parsers; jämförelsen beskriver de här end-to-end-valen.
Varför rankas inte 1 KB-raden? För att mätningen vid 28 mikrosekunder domineras av brus. Över tre körningar spred sig Python-parserna 77,6 %, och enskilda körningar överlappade varandra. All ordning i den storleken skulle vara en artefakt. Från och med 10 KB är det stabilt nog att läsa.
Vad orsakar hoppet vid 10 MB? Det här testet säger inte det. Det som fastställs är att hoppet är verkligt och inte brus: cheerios tre körningar landade på 2 839, 2 928 och 2 954 ms, tydligt separerade från allt annat, medan gapet vid 1 MB var 4×. För att isolera orsaken skulle man behöva profilera cheerios parser-backends var för sig, vilket låg utanför ramen här.
Hur många beroenden har det egentligen?
Elva direkta, 22 toppnivåpaket efter resolution, 9,0 MiB på disk. Två av dem är kompletta parserimplementationer — htmlparser2 och parse5 — eftersom cheerio kan använda båda. Det är priset för att kunna hantera både förlåtande och standardspecifik parsning, och det är värt att känna till om du granskar beroendeträd.
Vad testades inte här?
Testerna täckte processens maximala minne för ett dokument på 226 KB och ett på 10 MB, plus en uppsättning med fjorton indata där varje post var trasig eller kontroll, där cheerio inte kastade fel på någon, returnerade icke-tom utdata på alla och återhämtade 11/22 scorerade markörer. De täckte inte strömmande parsning via parse5-parser-stream, korrekthet i kodning, backend-specifik återhämtning, var prestandahoppet ligger mellan 1 och 10 MB, XML-parsning eller nyare Node-alternativ.




