
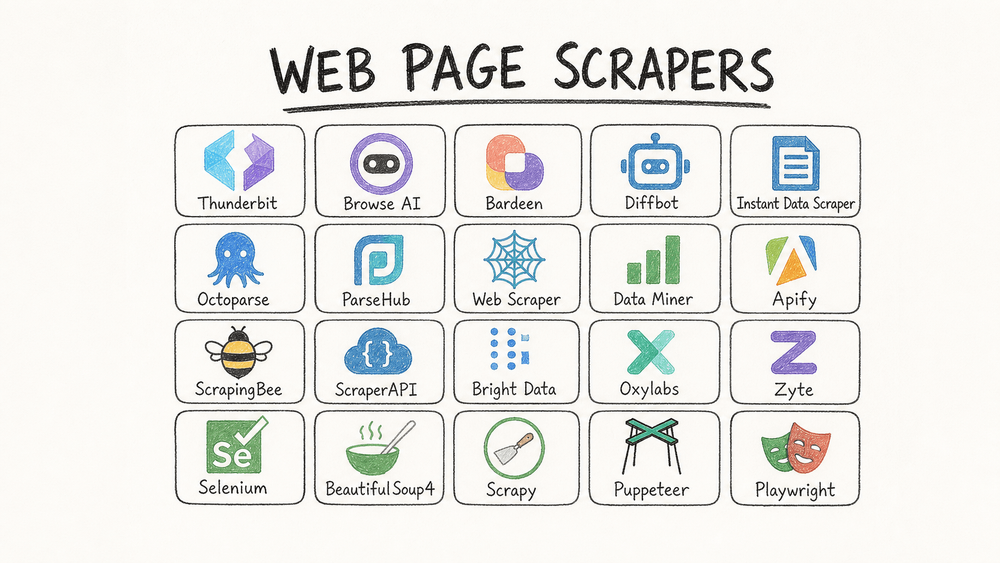
Om du utvärderar verktyg för webbscraping 2026 är du sannolikt inte ute efter en föreläsning i filosofi. Du vill ha en kortlista du kan lita på, ett snabbt sätt att skilja verktyg för affärsanvändare från mer tekniktunga lösningar, och tillräckligt med konkreta bevis för att undvika att köpa fel. Det är precis vad den här sidan ska hjälpa dig med.
Det korta svaret
Om du bara behöver beslutslogiken, använd detta:
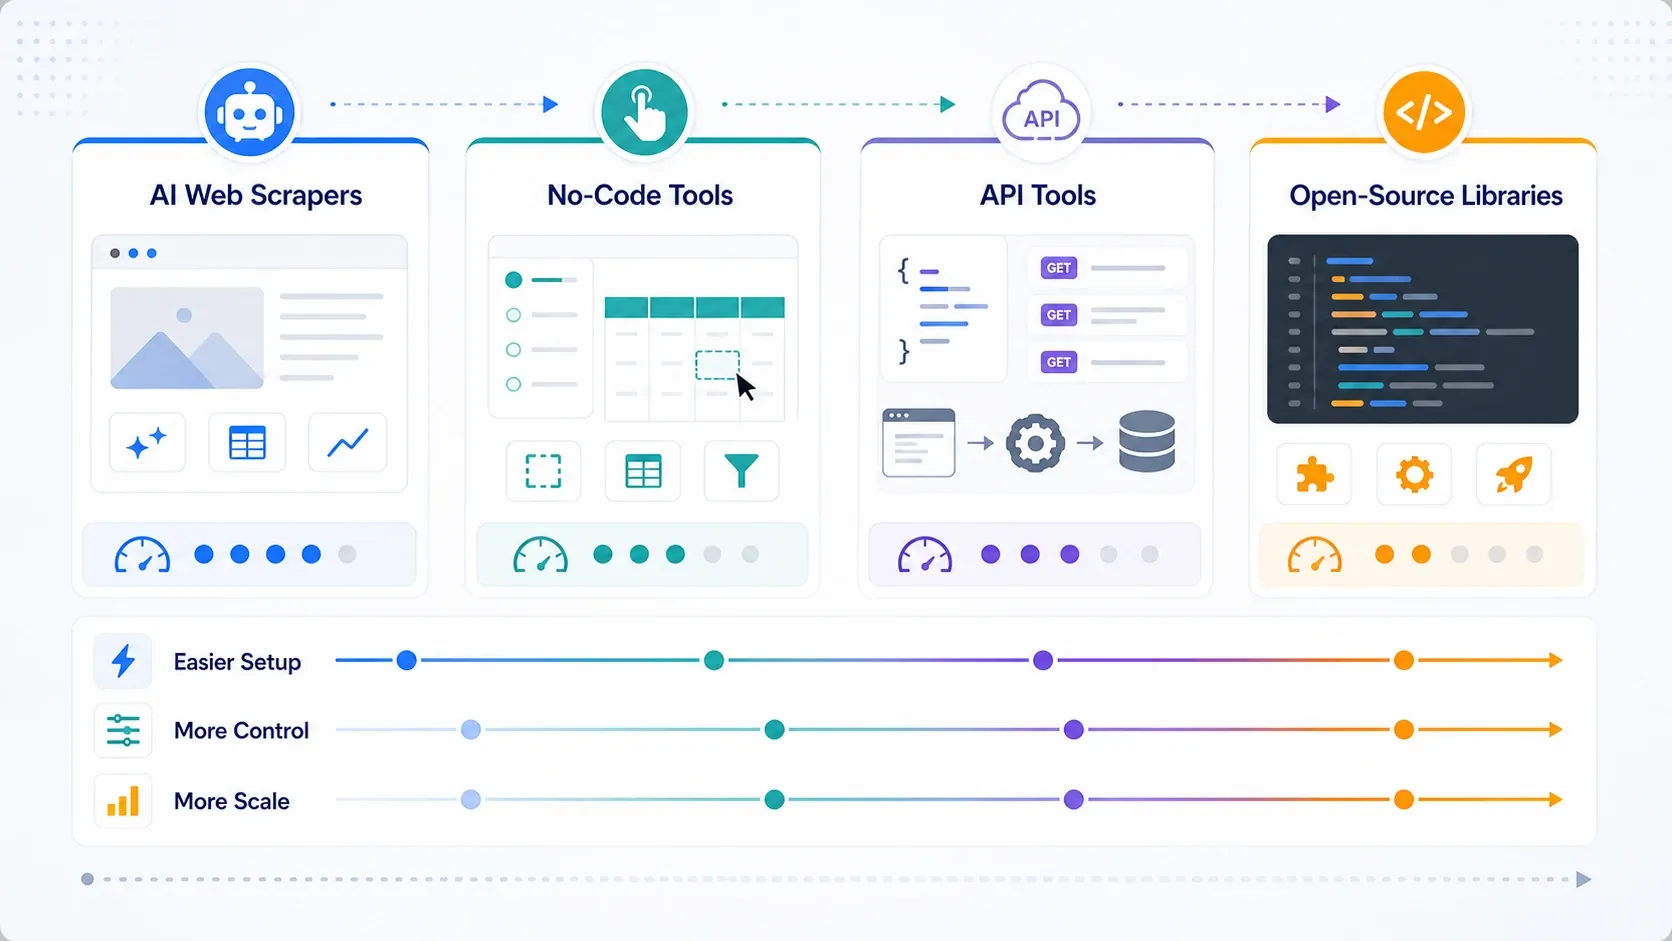
- Välj en AI-webbskrapare om du vill gå snabbast från webbplats till kalkylblad med minimal installation.
- Välj en no-code-skrapare om du behöver mer kontroll över uppgifter, schemaläggning eller körning i molnet utan att skriva kod.
- Välj en API-plattform om ditt team behöver rendering, proxyrotation, anti-bot-hantering eller integration i en intern produkt.
- Välj ett open source-bibliotek om du vill ha full kontroll och själv kan ansvara för underhåll, selectors, infrastruktur och felhantering.
I den här artikeln finns alla 20 verktyg kvar, men rekommendationslogiken är medvetet enkel: börja med det lättaste verktyget som pålitligt kan hantera ditt arbetsflöde, och gå bara vidare till mer avancerade lösningar när underhåll, blockeringar eller skala tvingar dig att göra det.
Snabb jämförelsetabell: de bästa verktygen för webbscraping 2026
Priser och planmodeller nedan har kontrollerats mot officiella produkt- eller prissidor i augusti 2026. När leverantörer använder förbrukningsbaserad debitering eller offert för företag, beskriver jag prismodellen i stället för att låtsas att det finns ett enda tillförlitligt listpris.
| Verktyg | Typ | Bäst för | Varför det kom med på 2026-listan | Prismodell (kontrollerad maj 2026) |
|---|---|---|---|---|
| Thunderbit | AI Web Scraper | Sälj, drift, e-handel, fastigheter | Snabbaste vägen för icke-kodare; AI-förslag på fält, undersidor, export och arbetsflöde i browser + moln | Gratis nivå, betalda planer, anpassad företagsprissättning |
| Browse AI | AI Web Scraper | Affärsanvändare som bevakar webbplatser | Starka no-code-robotar, övervakning och utdata i kalkylblad/API-stil | Gratis plan, betalda planer, premium managed tier |
| Bardeen | AI Automation + Scraping | Revenue ops och webbläsarflöden | Bäst när scraping bara är ett steg i ett större automationsflöde | Gratis plan och betalda planer |
| Diffbot | AI Extraction Platform | Företag och datateam | Bästa valet när du vill ha AI-extraktion och storskaliga strukturerade dataflöden | Företagsanpassad prissättning |
| Instant Data Scraper | Lättviktig webbläsareskrapare | Tillfälliga användare och snabba tabelluttag | Fortfarande ett av de enklaste sätten att snabbt få ut en synlig lista eller tabell till CSV | Gratis |
| Octoparse | No-Code Scraper | Analytiker och driftteam med större återkommande jobb | Moget visuellt gränssnitt med molnextraktion, anti-blockering och mallar | Gratis plan, betald från $69/månad, anpassat företagserbjudande |
| ParseHub | Low-Code Scraper | Analytiker som behöver logik och kontroll på skrivbordet | Flexibel projektlogik och nästlad navigation, men med brantare inlärningskurva än nyare AI-först-verktyg | Gratis plan och betalda planer |
| Web Scraper | No-Code Scraper | Nybörjare och lättare molnjobb | Bra startpunkt om du gillar sitemap-baserad scraping och en browser-first-setup | Gratis tillägg, betalda molnplaner |
| Data Miner | Browser Scraper | Forskare och tillväxtansvariga | Fortfarande användbart för snabb, receptbaserad extraktion direkt i webbläsaren | Gratis plan och betalda planer |
| Apify | API + Actor Platform | Tekniska team och hybridteam | Utmärkt ekosystem av Actors plus egen runtime när du växer ur webbläsartillägg | Gratis plan, start från $29/månad plus användning, större betalda nivåer |
| ScrapingBee | Scraping API | Utvecklare som skrapar JS-tunga webbplatser | Bra val när du vill ha rendering och proxyhantering utan att bygga webbläsarlagret själv | Gratis testperiod och betalda planer |
| ScraperAPI | Scraping API | Utvecklare som snabbt skalar upp request-volymen | Enkel API, testkrediter, strukturerade produkter och enklare avlastning av infrastruktur | 7-dagars testperiod med 5 000 krediter, betalt från $49/månad |
| Bright Data | Enterprise API + Proxy Platform | Program med hög volym och höga compliance-krav | Mest omfattande data-collecting-stack när unblock, proxy och managed acquisition är viktigare än enkelhet | Förbrukningsbaserad och produktbaserad prissättning |
| Oxylabs | Enterprise API + Proxy Platform | Team som köper scraping som infrastruktur | Stark för storskalig insamling, särskilt pris-, SEO- och marknadsundersökningar | Web Scraper API från $49/månad; bredare proxypriser varierar |
| Zyte | API + Anti-Bot Stack | Utvecklare och datateam | Bra val om du vill ha API-first-extraktion med starka byggstenar för browser, rotation och anti-detektering | Test med $5 i gratis kredit, förbrukningsbaserade åtaganden |
| Selenium | Open Source-webbläsarautomatisering | QA-liknande automation och svåra interaktionsflöden | Fortfarande användbart när användarinteraktionens precision är viktigare än genomströmning | Gratis och open source |
| BeautifulSoup4 | Open Source-parser | Nybörjare och lätt parsning | Bäst som parser i en enkel stack, inte som en fullständig scraping-plattform | Gratis och open source |
| Scrapy | Open Source-crawling framework | Produktionsklara, anpassade crawlers | Bästa balansen mellan kraft och mognad om du vill äga hela pipelinen själv | Gratis och open source |
| Puppeteer | Open Source-webbläsarautomatisering | Node-first scraping och webbläsarskriptning | Perfekt om ditt team redan är hemma i Chrome/Node-ekosystemet | Gratis och open source |
| Playwright | Open Source-webbläsarautomatisering | Modern automation för flera webbläsare | Ofta det renaste valet för modern browser automation med stark utvecklarupplevelse | Gratis och open source |
Så här utvärderade jag verktygen
Jag använde fyra filter:
- Tid till första lyckade scrapingkörningen
Om en icke-teknisk användare inte snabbt kan få fram användbara data spelar det stor roll. - Underhållsbelastning
Snabb installation är meningslös om arbetsflödet går sönder varje gång en webbplats ändras. - Skalbarhetstak
Vissa verktyg är perfekta för 50 sidor i veckan och usla för 5 miljoner förfrågningar i månaden. - Passar arbetsflödet
Det bästa verktyget för ett revenue ops-team är sällan det bästa för ett dataplattformsteam.
Resultatet är inte en universell ranking. Det är en beslutsguide för att först välja rätt typ av verktyg, och sedan rätt produkt inom den kategorin.
Vilken typ av webbscrapingverktyg behöver du egentligen?
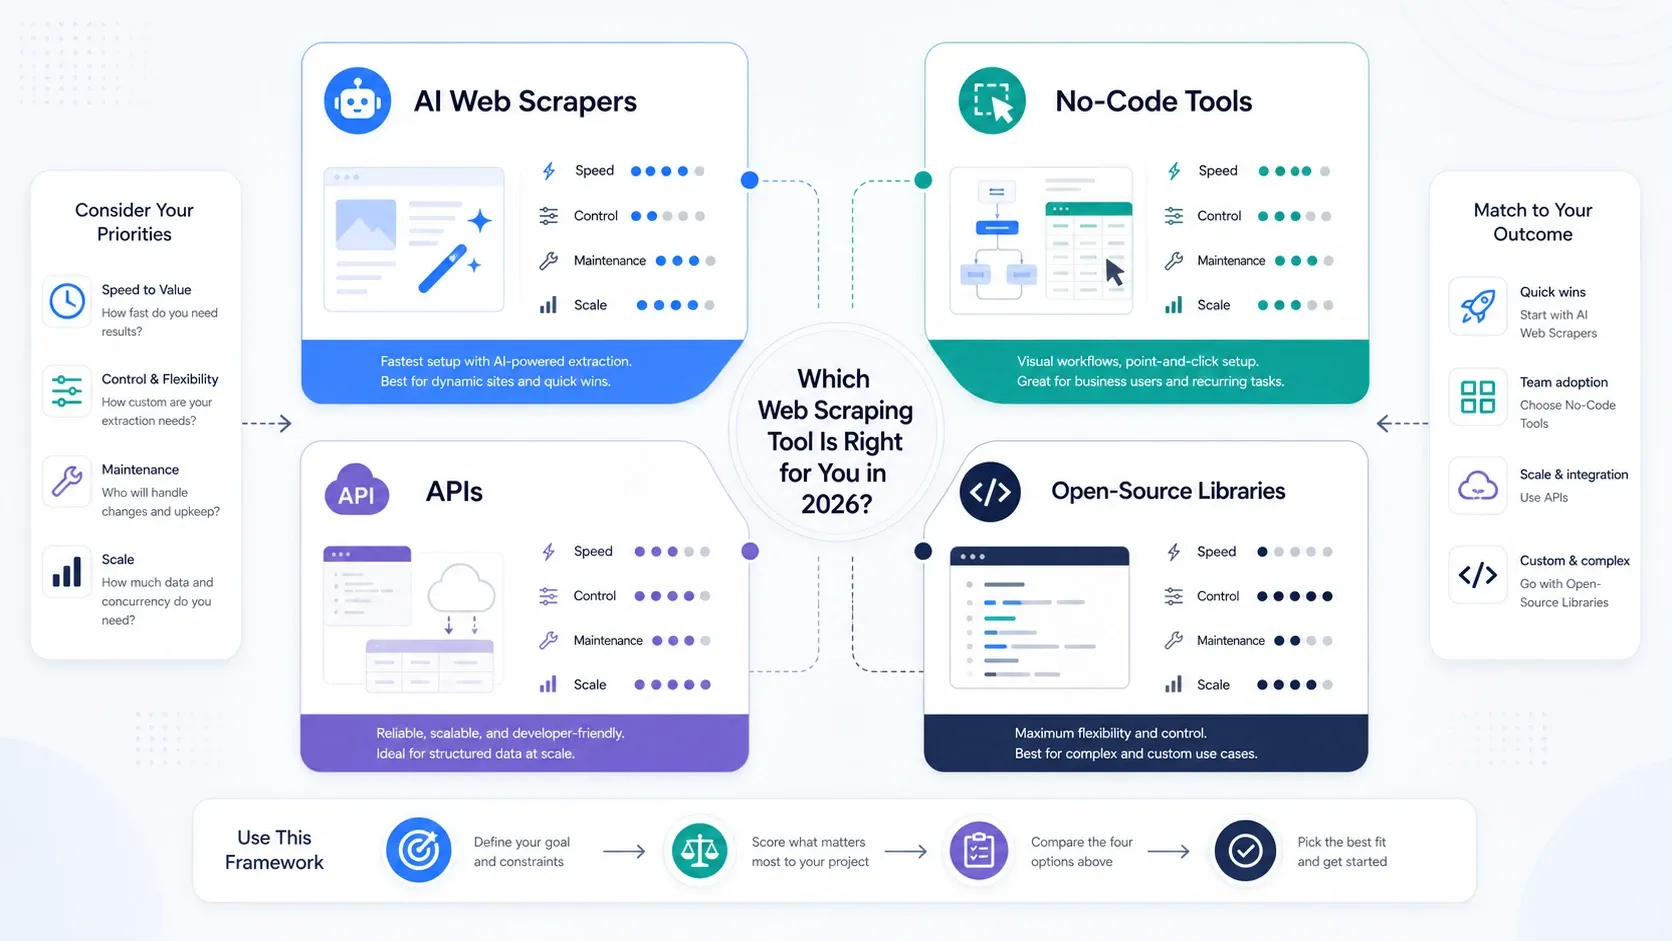
- Välj AI-webbskrapare om ditt främsta mål är snabbhet i arbetet.
- Välj no-code-verktyg om du behöver mer sidnumrering, schemaläggning och återupprepbar kontroll av uppgifter.
- Välj API:er och scraping-plattformar om rendering, rotation och unblock-förmåga nu är flaskhalsen.
- Välj open source-bibliotek om ditt team värderar kontroll högre än bekvämlighet och kan supportera stacken internt.
Om ditt team fortfarande funderar på om scraping ska ligga hos drift eller utveckling, börja med ett AI- eller no-code-verktyg först. Du lär dig vad som faktiskt spelar roll snabbare genom att köra riktiga jobb än genom att överdesigna stacken från början.
Bästa AI-webbskrapare för affärsteam
Det här är verktygen jag skulle titta på först om målet är data som är redo för kalkylblad med så lite installation som möjligt.
1. Thunderbit
Thunderbit är det enklaste alternativet här om ditt team vill extrahera strukturerad data utan att lära sig selectors, browser scripting eller scraping-infrastruktur. Arbetsflödet bygger på AI-förslag av fält, berikning från undersidor och direkt export till de verktyg affärsanvändare redan arbetar i.
- Bäst för: sälj, drift, e-handel, fastigheter och andra webbläsartunga team.
- Varför det sticker ut: det kortar ner installationstiden bättre än något annat på den här listan för icke-kodare.
- Att tänka på: om du behöver djup, anpassad crawlerlogik eller mycket specialiserad teknisk kontroll kommer du förr eller senare behöva gå vidare till mer avancerade lösningar.
- Prismodell: gratis nivå, självbetjänade betalplaner och företagsprissättning.
Om du vill se det snabbaste verkliga arbetsflödet innan du jämför fler verktyg, är den här genomgången den bästa startpunkten:
Testa Thunderbit på en live-sida Öppna valfri sida, låt AI läsa den och exportera en strukturerad tabell med ett klick. Get Started Free
2. Browse AI
Browse AI är fortfarande ett starkt val för affärsanvändare som vill ha klick-och-peka-setup plus återkommande övervakning. Robotmodellen är särskilt användbar när scraping och förändringsdetektering är lika viktiga.
- Bäst för: övervakning av prissidor, konkurrenters sidor och återupprepbar listutdragning.
- Varför det sticker ut: genomarbetad onboarding, färdiga robotar och en tydlig väg från webbplats till kalkylblad eller API-liknande output.
- Att tänka på: komplexa jobb med hög volym kan bli dyra eller operativt krångliga snabbare än i API-först-stackar.
- Prismodell: gratis plan, betalda planer, premium/managed tier.
3. Bardeen
Bardeen är mest intressant när scraping bara är ett moment i ett större webbläsarbaserat automationsflöde. Om du flyttar data till CRM-system, kalkylblad eller outbound-flöden spelar automationsdelen större roll än rå extraktionsdjup.
- Bäst för: revenue ops, leadflöden och browser-native uppgiftsautomation.
- Varför det sticker ut: starkare automationsberättelse än rena extraktionsverktyg.
- Att tänka på: det är inte det smidigaste valet när själva scrapen är komplex och affärskritisk.
- Prismodell: gratis plan och betalda planer.
4. Diffbot
Diffbot är för team som behöver AI-extraktion i företagsklass, inte för användare som söker den billigaste eller enklaste vägen. Det blir mer rimligt när kvalitet på strukturerad data och storskalig inmatning är viktigare än handpåläggning.
- Bäst för: datateam i företag, content intelligence och stora extraktionsprogram.
- Varför det sticker ut: extraktion med datorsyn-liknande teknik och tydligt fokus på strukturerad output.
- Att tänka på: överdrivet för små team och för jobbiga att använda om användningsfallet är lättviktigt.
- Prismodell: företagsanpassade planer och säljdriven process.
5. Instant Data Scraper
Instant Data Scraper förtjänar fortfarande en plats eftersom det finns gott om situationer där du bara behöver den synliga tabellen, katalogen eller listan direkt. Det är inte en plattform, men ofta räcker det.
- Bäst för: engångsextraktion, snabba leadlistor, enkla kataloger och synliga tabeller.
- Varför det sticker ut: nästan ingen friktion när sidan passar verktyget.
- Att tänka på: begränsad automation, begränsat djup och svag passform för avancerade arbetsflöden.
- Prismodell: gratis.
Bästa no-code-verktyg för återkommande jobb
När jobbet är mer än en tillfällig scrapingkörning blir visuella byggverktyg och molnkörning viktigare.
6. Octoparse
Octoparse är fortfarande en av de starkaste no-code-plattformarna om du behöver molnkörningar, mallar och mer avancerad uppgiftshantering än vad ett webbläsartillägg kan erbjuda.
- Bäst för: analytiker, pris-team och driftansvariga med återkommande insamlingsjobb.
- Varför det sticker ut: mogen uppgiftsbyggare, molnextraktion, anti-blockeringsfunktioner och ett stort mallbibliotek.
- Att tänka på: det är kraftfullare än AI-först-webbverktyg, men det innebär också mer arbete vid uppstart.
- Prismodell: gratis plan, betald från $69/månad, anpassat företagserbjudande.
7. ParseHub
ParseHub är fortfarande relevant för användare som vill ha mer kontroll än en AI-skrapare men inte vill bygga en kodbas. Det belönar tålamod, inte snabbhet.
- Bäst för: analytiker och tekniskt nyfikna användare som kan leva med en brantare inlärningskurva.
- Varför det sticker ut: flexibel navigationslogik och bättre kontroll än lättviktiga webbläsarverktyg.
- Att tänka på: produktupplevelsen känns tyngre än hos nyare aktörer, särskilt för snabbt arbetande affärsteam.
- Prismodell: gratis plan och betalda planer.
8. Web Scraper
Web Scraper är fortfarande en rimlig inkörsport om du gillar sitemap-modellen och vill ha något som börjar i webbläsaren och sedan kan växa till molnschemaläggning senare.
- Bäst för: nybörjare, hobbyprojekt och mindre återkommande jobb.
- Varför det sticker ut: lättillgängligt sitemap-flöde och enkel browser-first-användning.
- Att tänka på: det blir begränsande när du behöver mer anpassningsbar extraktionslogik.
- Prismodell: gratis webbläsartillägg och betalda molnplaner.
9. Data Miner
Data Miner är bäst att se som ett snabbt extraktionsverktyg snarare än en komplett scrapingplattform. Det förtjänar ändå en plats eftersom receptbaserat arbete är användbart för många research- och prospectinguppgifter.
- Bäst för: forskare, tillväxtteam och snabba exportjobb i webbläsaren.
- Varför det sticker ut: receptmodell, låg friktion och enkel export från webbläsaren.
- Att tänka på: inte rätt verktyg för seriös scraping på plattformsnivå.
- Prismodell: gratis plan och betalda planer.
Bästa API-plattformar när skala och blockering blir det verkliga problemet
Det här är lagret där utvecklingsteam slutar tänka “hur skrapar jag den här sidan?” och börjar tänka “hur gör jag detta tillförlitligt i stor volym?”
10. Apify
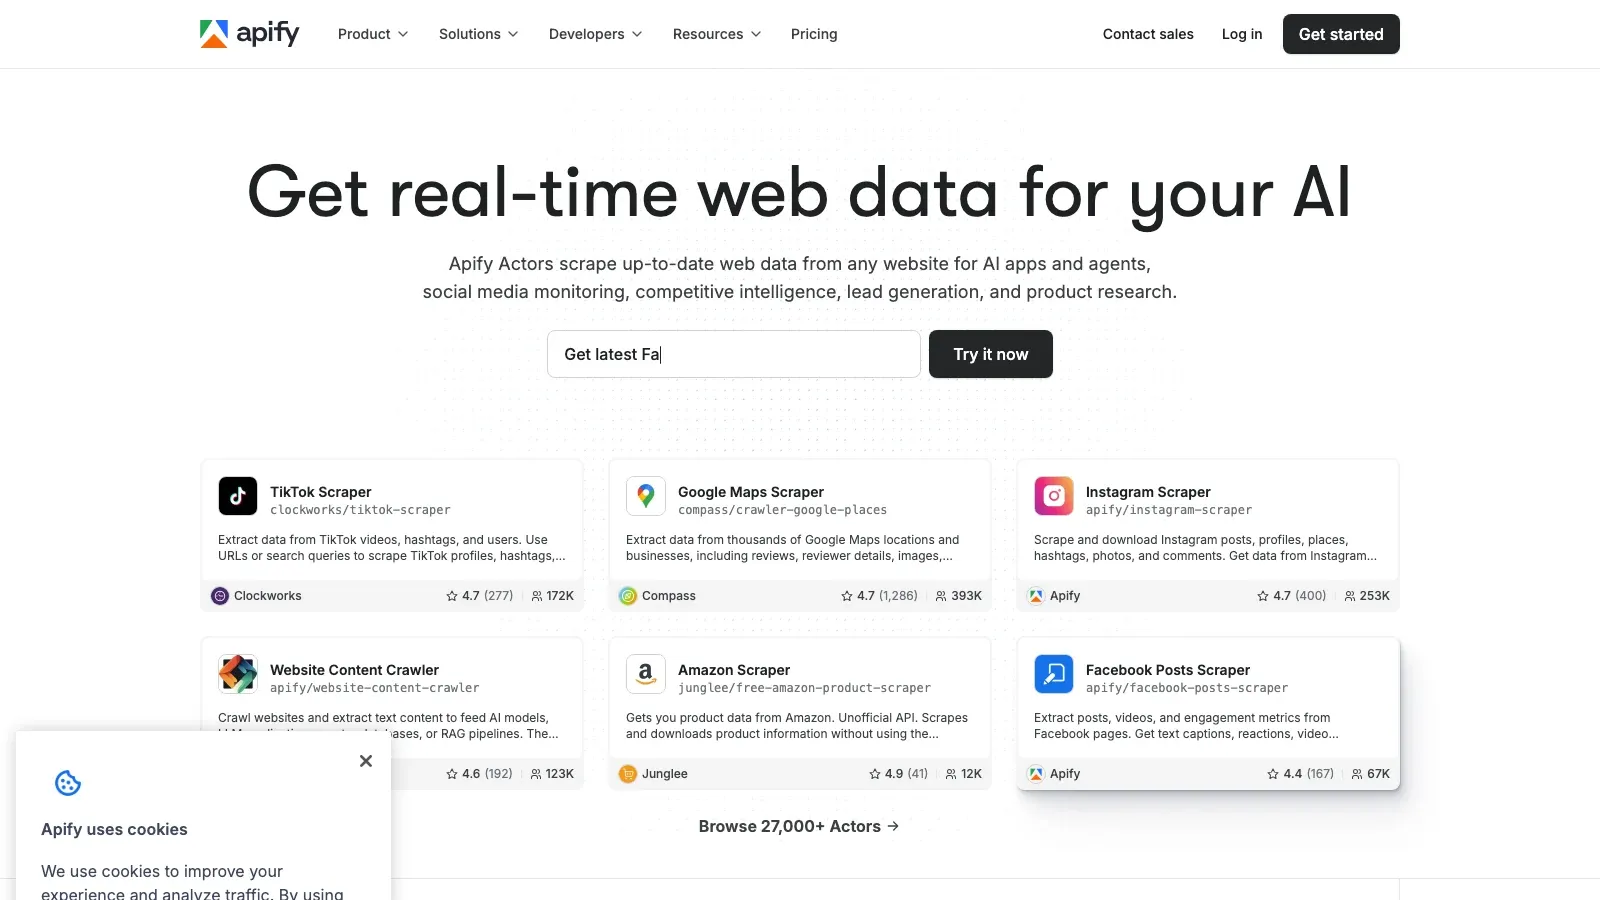
Apify är den mest flexibla plattformen i den här gruppen om du både vill ha en marknadsplats för återanvändbara scrapers och en plats att köra egen kod. Den bygger en bro mellan no-code-upptäckt och utvecklarkörning bättre än de flesta konkurrenter.
- Bäst för: hybridteam, utvecklingsdriven scraping och återanvändbara automationsflöden.
- Varför det sticker ut: Actor-ekosystemet plus egen runtime ger ovanligt stor bredd.
- Att tänka på: när du går över till egen kod är du tillbaka i utvecklingsland och enkelhetsfördelen minskar.
- Prismodell: gratis plan, start från $29/månad plus användning, större användningsnivåer och enterprise.
11. ScrapingBee
ScrapingBee är ett bra val när ditt verkliga behov är: “ge mig en renderad sida och sköt den jobbiga infrastrukturen åt mig”. Det passar särskilt bra för JS-tunga mål.
- Bäst för: utvecklare som skrapar dynamiska webbplatser och vill lägga minimal tid på infrastruktur.
- Varför det sticker ut: enkel API-lösning för rendering, proxies och webbläsarautomatisering.
- Att tänka på: det är en infrastrukturtjänst, så du ansvarar fortfarande för parsing, retry-logik och datakvalitet längre ner i kedjan.
- Prismodell: testperiod och betalda planer.
12. ScraperAPI
ScraperAPI är fortfarande ett av de enklaste sätten att avlasta proxyhantering och lyckade requests när du vill skala snabbt.
- Bäst för: utvecklare som behöver gå från prototyp till volym snabbt.
- Varför det sticker ut: rak API, testkrediter, strukturerade produkter och skalningsnivåer.
- Att tänka på: som alla API-first-produkter tar det inte bort behovet av tekniska beslut kring parsing och validering.
- Prismodell: 7-dagars testperiod med 5 000 krediter, betalt från $49/månad.
13. Bright Data
Bright Data är tungviktsalternativet när unblock-förmåga, proxyutbud och managed acquisition är viktigare än att verktyget ska vara enkelt.
- Bäst för: företagsprogram, stora insamlingar med höga compliance-krav och managed data acquisition.
- Varför det sticker ut: bredd i proxy-, scraper-, browser- och datasetprodukter.
- Att tänka på: dyrt och lätt att köpa mer än man behöver om arbetsflödet egentligen är ganska enkelt.
- Prismodell: förbrukningsbaserad och produktbaserad prissättning för API:er, proxies och managed services.
14. Oxylabs
Oxylabs är fortfarande ett starkt val för team som köper scraping som infrastruktur snarare än som ett webbläsarverktyg. Det blir särskilt relevant när tillförlitlighet och inköpsmognad spelar roll.
- Bäst för: företagsinsamling, prisövervakning, SEO-övervakning och marknadsundersökningar.
- Varför det sticker ut: robust infrastruktur, stark proxydjup och en tydligare företagsinriktad köpresa.
- Att tänka på: inte optimalt om ditt team vill ha ett avslappnat självbetjäningsflöde.
- Prismodell: Web Scraper API från $49/månad; andra produkter varierar per enhet och användning.
15. Zyte
Zyte förtjänar fortfarande att tas på allvar av utvecklings- och datateam som vill ha anti-detektering, browser actions, JS-rendering och roterande IP-adresser i ett och samma API-first-upplägg.
- Bäst för: tekniska team som bygger återupprepbara extraktionssystem.
- Varför det sticker ut: browser actions, JS-rendering, IP-rotation och anti-bot-funktioner i samma stack.
- Att tänka på: bättre för team med eget utvecklingsansvar än för icke-tekniska användare.
- Prismodell: test med $5 i gratis kredit och förbrukningsbaserade månadsåtaganden.
Testa ett enklare arbetsflöde innan du bygger för mycket Innan du binder upp dig på proxies och kod, se hur långt en AI-skrapare med ett klick tar dig. Get Started Free
Bästa open source-bibliotek för utvecklare som vill ha full kontroll
Om du vill äga hela scraperstacken från början till slut är det här de mest användbara byggstenarna 2026.
16. Selenium
Selenium är fortfarande användbart när du behöver QA-liknande interaktionsprecision, äldre webbläsarautomationsflöden eller mycket tydlig kontroll över användarflöden.
- Bäst för: interaktionstung automation, överlapp med QA och webbplatser där webbläsarbeteende är viktigare än crawl-throughput.
- Varför det sticker ut: mogen ekosystem och brett webbläsarstöd.
- Att tänka på: tyngre och långsammare än nyare webbläsarverktyg för många scrapinguppgifter.
- Prismodell: gratis och open source.
17. BeautifulSoup4
BeautifulSoup är inte en fullständig scrapingplattform, men det är fortfarande ett av de enklaste sätten att parsa rörig HTML i lättviktiga arbetsflöden.
- Bäst för: nybörjare, snabba skript och parser-först-uppgifter.
- Varför det sticker ut: enkelt API och låg mental belastning.
- Att tänka på: kombinera det med request-, browser- eller crawler-verktyg; på egen hand är det bara en parser.
- Prismodell: gratis och open source.
18. Scrapy
Scrapy är fortfarande det bästa svaret när du behöver ett riktigt crawler framework i stället för några få skript.
- Bäst för: produktionsklara, anpassade crawlers och internt ägda datapipelines.
- Varför det sticker ut: hög prestanda, pipelines, middleware och långsiktig utbyggbarhet.
- Att tänka på: det finns verkligt utvecklingsarbete här, och JS-tunga mål kräver ofta kompletterande verktyg.
- Prismodell: gratis och open source.
19. Puppeteer
Puppeteer är fortfarande ett starkt val för Node-först-team som vill ha direkt kontroll över Chromium och webbläsarskriptning.
- Bäst för: Node-baserad scraping, skärmdumpar och webbläsarautomation.
- Varför det sticker ut: direkt och kraftfull kontroll över Chromium-beteende.
- Att tänka på: snävare webbläsarstöd än Playwright och fortfarande resurskrävande i stor skala.
- Prismodell: gratis och open source.
20. Playwright
Playwright är min standardrekommendation för modern webbläsarautomation om ditt team skriver kod och vill ha ett nyare abstraktionslager än Selenium.
- Bäst för: modern webbläsarautomation, JS-tunga webbplatser och team som bryr sig om utvecklarupplevelsen.
- Varför det sticker ut: stark modell för flera webbläsare, tillförlitligt väntbeteende och rena API:er.
- Att tänka på: du ansvarar fortfarande för webbläsarinfrastruktur, samtidighet, selector-drift och datavalidering.
- Prismodell: gratis och open source.
Min kortlista efter teamtyp
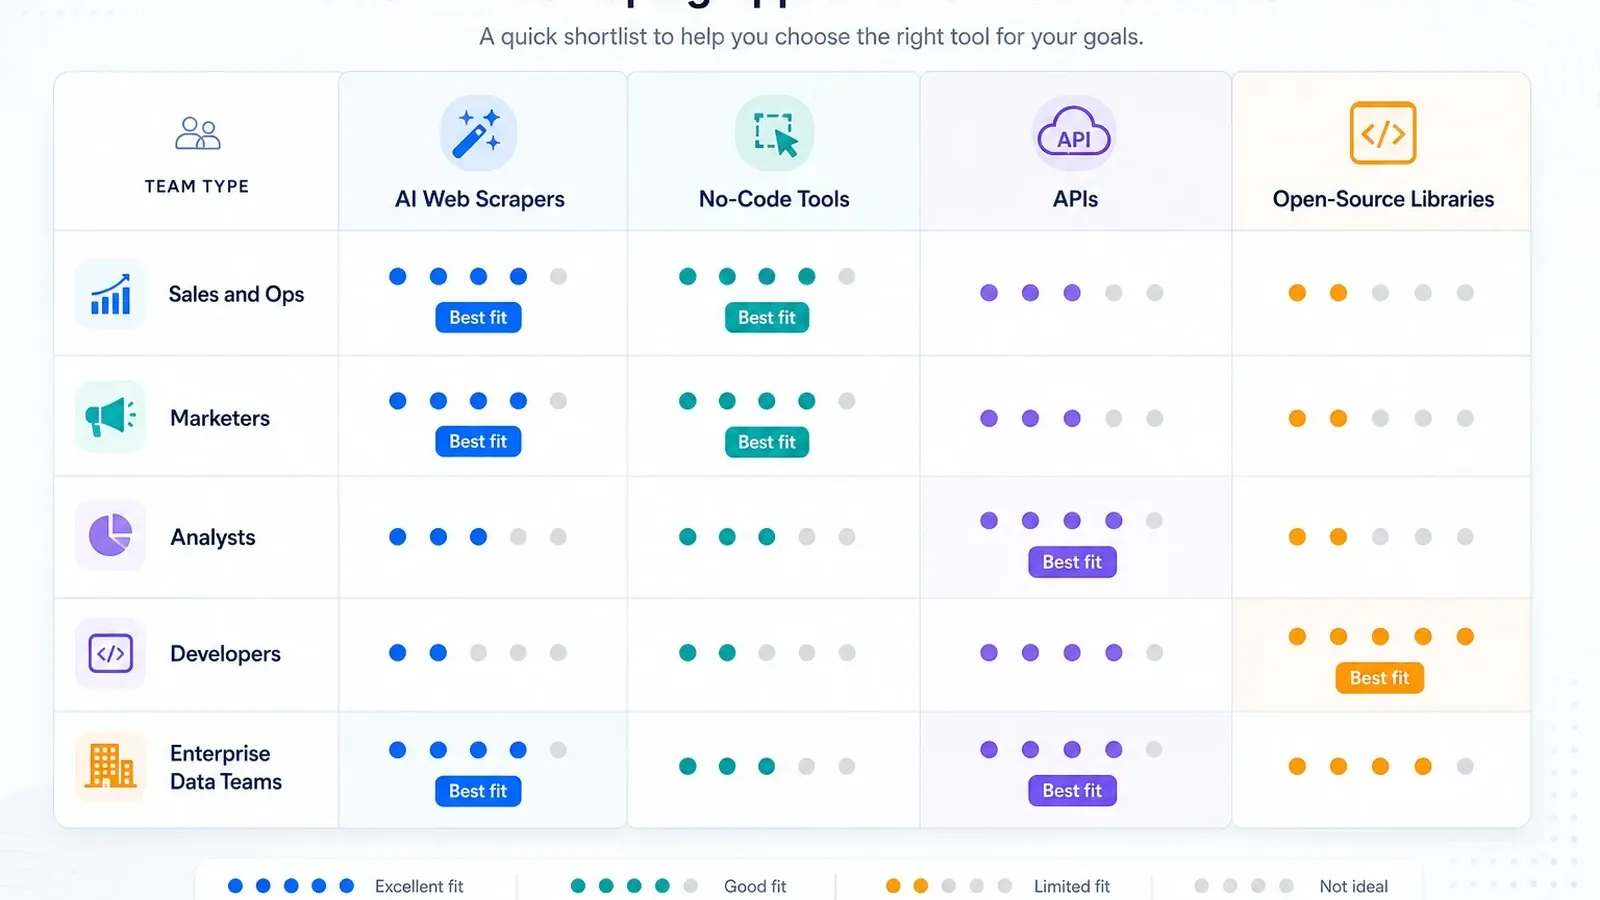
- Sälj- och driftteam: börja med Thunderbit, och titta sedan på Browse AI om övervakning är viktigare än berikning från undersidor.
- Analytiker och researchteam: Octoparse först om återkommande jobb är större än vad webbläsartillägg bekvämt kan hantera.
- GTM-team med mycket automation: Bardeen om scraping bara är ett steg i ett större arbetsflöde.
- Utvecklingsteam som bygger interna verktyg: Apify, Zyte, ScraperAPI eller Playwright beroende på hur mycket du vill äga av stacken.
- Företagsinriktade dataprogram: Bright Data, Oxylabs, Diffbot och Zyte är de seriösa infrastruktursamtalen.
När du bör gå ner i stacken
Använd den här regeln:
- Stanna med AI-verktyg tills du stöter på begränsningar i återupprepning eller specialfall.
- Gå till no-code-verktyg när schemaläggning, sidnumrering, anti-blockering eller molnkörningar är viktigare än enkelhet med ett klick.
- Gå till API:er när unblock-frekvens, JS-rendering och samtidighet blir de verkliga flaskhalsarna.
- Gå till open source-bibliotek när kostnaden för leverantörsabstraktion blir högre än kostnaden för att äga hela stacken själv.
De flesta team går ner i stacken för tidigt. Det är ett av de vanligaste misstagen jag ser.
Slutlig slutsats
För de flesta icke-tekniska team är rätt svar 2026 inte “den kraftfullaste skraparen”. Det är verktyget som får korrekt data in i nästa arbetsflöde med minst underhåll. Därför fortsätter AI-först-verktyg att vinna för operativa användare, medan API:er och open source-stackar passar bättre för tekniska team med tydliga krav på skala.
Om du vill ha kortaste vägen från sida till strukturerad output, börja med Thunderbit. Om du redan vet att jobbet kräver tung infrastruktur, hoppa direkt till API- och utvecklarnivån. Bara blanda inte ihop komplexitet med sofistikering.
Börja med det lättaste verktyget som faktiskt klarar jobbet Get Started Free
Vanliga frågor
1. Vilket är det bästa webscrapingverktyget för icke-tekniska användare 2026?
För de flesta icke-tekniska användare erbjuder AI-först-verktyg som Thunderbit och Browse AI snabbast väg till användbara data, eftersom de minskar arbete med selectors, installationsfriktion och underhåll.
2. Vad ska jag välja om mina webbplatser är tunga på JavaScript eller blockerar förfrågningar aggressivt?
Gå mot ScrapingBee, ScraperAPI, Zyte, Bright Data, Oxylabs, Playwright eller Selenium beroende på om du vill ha en managed tjänst eller direkt teknisk kontroll.
3. Är no-code-verktyg fortfarande relevanta nu när AI-webbskrapare är bättre?
Ja. No-code-verktyg som Octoparse och ParseHub spelar fortfarande roll när du behöver tydligare kontroll över logik, molnkörning och återupprepbar jobbhantering.
4. Vilka verktyg passar bäst för utvecklingsteam?
Apify, Zyte, ScraperAPI, Scrapy, Playwright, Puppeteer och Selenium är de mest naturliga valen när utvecklare äger arbetsflödet.
5. Hur gör jag en snabb kortlista utan att överforska?
Välj först typ av verktyg, inte leverantör. Avgör om du behöver AI-enkelhet, no-code-kontroll, API-infrastruktur eller open source-ägande. Jämför sedan produkter inom det lagret.
Relaterad läsning




