
Trustpilot har 361 miljoner aktiva recensioner från 1,27 miljoner företag — och de flesta scrapers som byggdes för att hämta den datan slutade fungera för månader sedan. Om du har försökt samla in recensioner nyligen har du säkert stött på den ökända inloggningsspärren vid sida 10 och sett ditt verktyg bara returnera ett felmeddelande.
Jag har ägnat de senaste veckorna åt att testa, undersöka och jämföra verktyg som fortfarande kan extrahera Trustpilot-recensioner pålitligt 2026. Läget har förändrats rejält: Trustpilots skydd mot bottar är mer aggressiva, frontend byggd i Next.js genererar klassnamn som ändras vid varje uppdatering, och — viktigast av allt — åtkomst utan inloggning stoppas numera redan efter 10 sidor med recensioner. En Reddit-tråd från slutet av 2025 fångade frustrationen perfekt: "none of the actors on the store work."
Så vilka verktyg fungerar faktiskt? Jag utvärderade fem stycken utifrån hur de hanterar inloggningsväggen, anti-bot-skydd, underhållsbehov och de praktiska behov som både marknadsförare och utvecklare har.
Varför det är svårare än man tror att skrapa Trustpilot-recensioner 2026
Trustpilot är inte en enkel statisk sajt där du kan skicka en vanlig HTTP-begäran och tolka resultatet med BeautifulSoup. Det är en modern, dynamiskt renderad plattform byggd på Next.js, och försvaret har blivit märkbart skarpare under det senaste året.
Det här är vad du faktiskt möter:
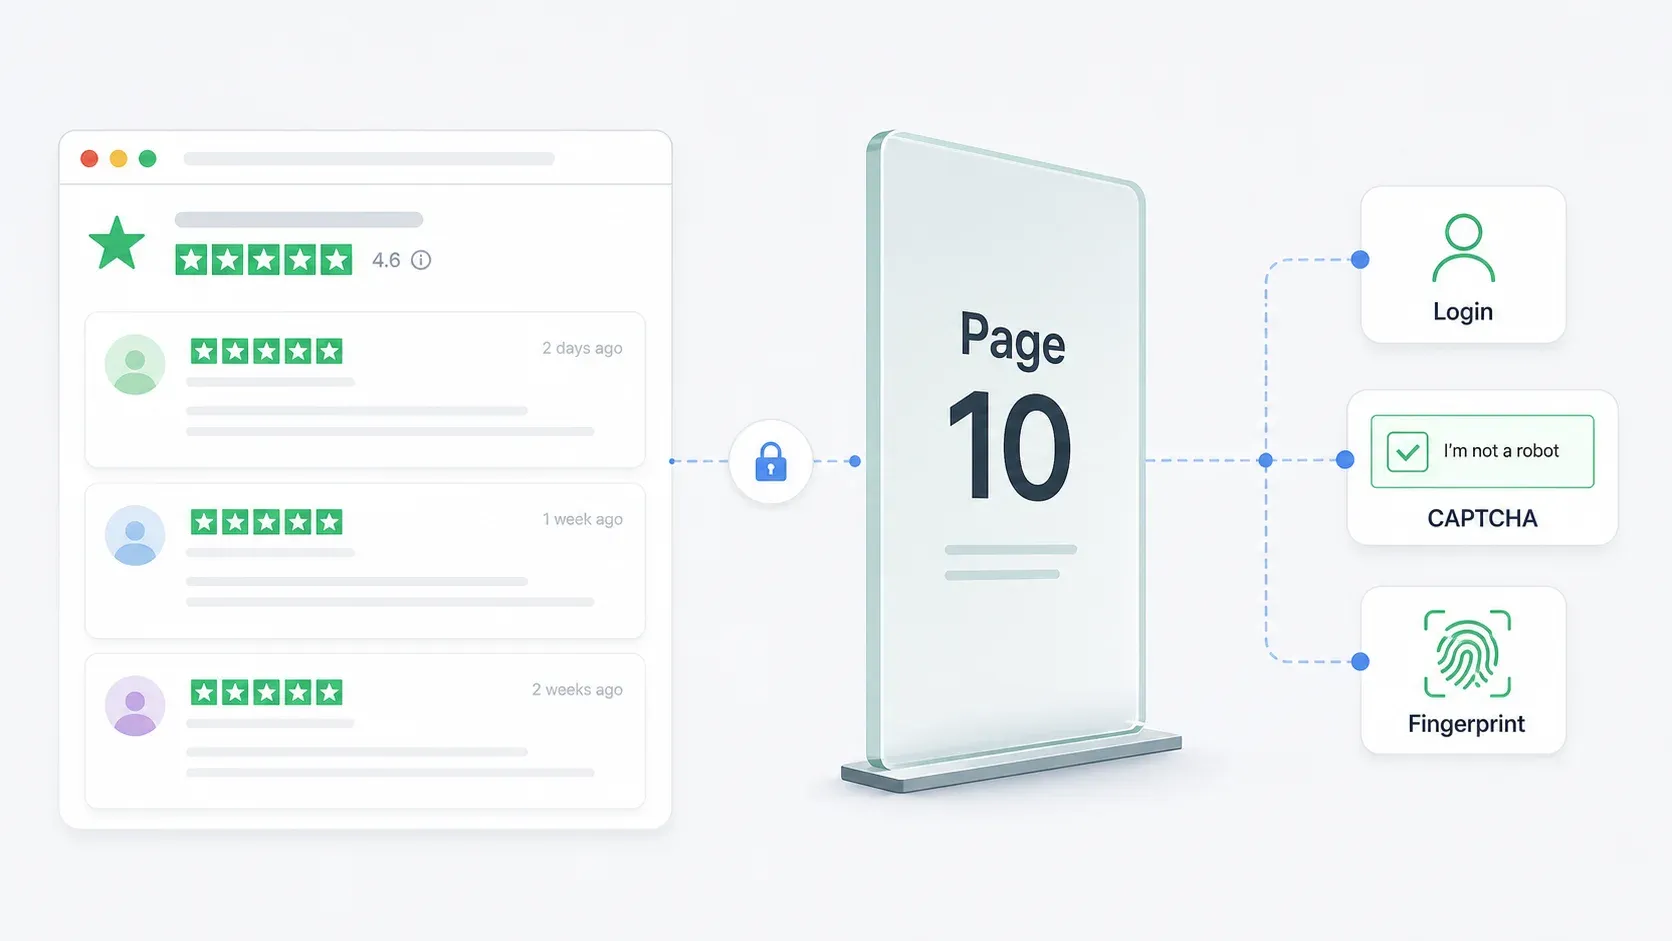
Inloggningsväggen vid sida 10. Det här är den enskilt största flaskhalsen. Web Scrapers egen Trustpilot-guide från mars 2026 bekräftar att Trustpilot bara visar de första 10 recensionssidorna innan en inloggningsruta visas. För ett företag med 2 000 recensioner (ungefär 100 sidor med 20 recensioner per sida) låses du ute från 90 % av datan om du inte har en autentiserad session.
Skydd mot bottar. Trustpilot använder reCAPTCHA, sessionsbaserad blockering, filtrering på CDN-nivå och browser fingerprinting. På deras Om-sida står det uttryckligen att sajten är "protected by reCAPTCHA" och att den samlar in signaler från enhet och interaktion.
Dynamiska CSS-klassnamn. Eftersom Trustpilot använder Next.js med CSS-moduler skapas klassnamn som styles_reviewCardInner__EwDq2 vid byggtid och ändras varje gång Trustpilot släpper en uppdatering. ScraperAPIs egen guide förlitar sig på just de här selektorerna — vilket betyder att kod som följer den guiden sannolikt går sönder nästa gång Trustpilot uppdaterar frontend.
Förändringar i DOM-strukturen. Det är inte bara klassnamnen som ändras. Själva HTML-strukturen kan också skifta. Element kapslas in på nya sätt, nya wrappers dyker upp och pagineringskomponenter byggs om.
CSS-selektor-baserade scrapers — oavsett om det är Apify Actors, Octoparse-flöden eller egna Python-skript — är strukturellt sköra på Trustpilot. De fungerar tills de inte gör det. Och "tills de inte gör det" mäts ofta i veckor, inte månader.
Vad vi letade efter i de bästa Trustpilot-recensionsscrapersen
Jag utvärderade inte dessa verktyg utifrån ett generiskt "kan den skrapa en webbsida"-perspektiv. Alla verktyg i den här listan kan hämta data från en enkel HTML-sida.
Den verkliga frågan: klarar de Trustpilot specifikt, med alla dess egenheter, 2026?
Det här vägde tyngst:
| Kriterium | Varför det spelar roll för Trustpilot |
|---|---|
| Hantering av inloggningsväggen (sida 10+) | De flesta företag har långt fler än 200 recensioner. En gräns på 10 sidor gör att du missar större delen av historiken. |
| Strategi för att kringgå anti-bot-skydd | reCAPTCHA, sessionsblockering och CDN-filtrering stoppar naiva scrapers direkt. |
| Robusthet i selektorer / underhåll | Genererade CSS-klasser gör att selektorbaserade verktyg ofta går sönder. Kan verktyget självläka? |
| Stöd för paginering | Recensioner kan spänna över hundratals sidor. Manuell extrahering sida för sida är inte rimlig. |
| No-code kontra kodkrav | Marknadsförare behöver klicka sig fram; utvecklare vill ha full kontroll. |
| Prissättning / gratisnivå | Budgetmedvetna team behöver tydlighet innan de binder upp sig. |
| Exportalternativ | Företagsanvändare behöver Google Sheets, Airtable och Notion — inte bara rå JSON. |
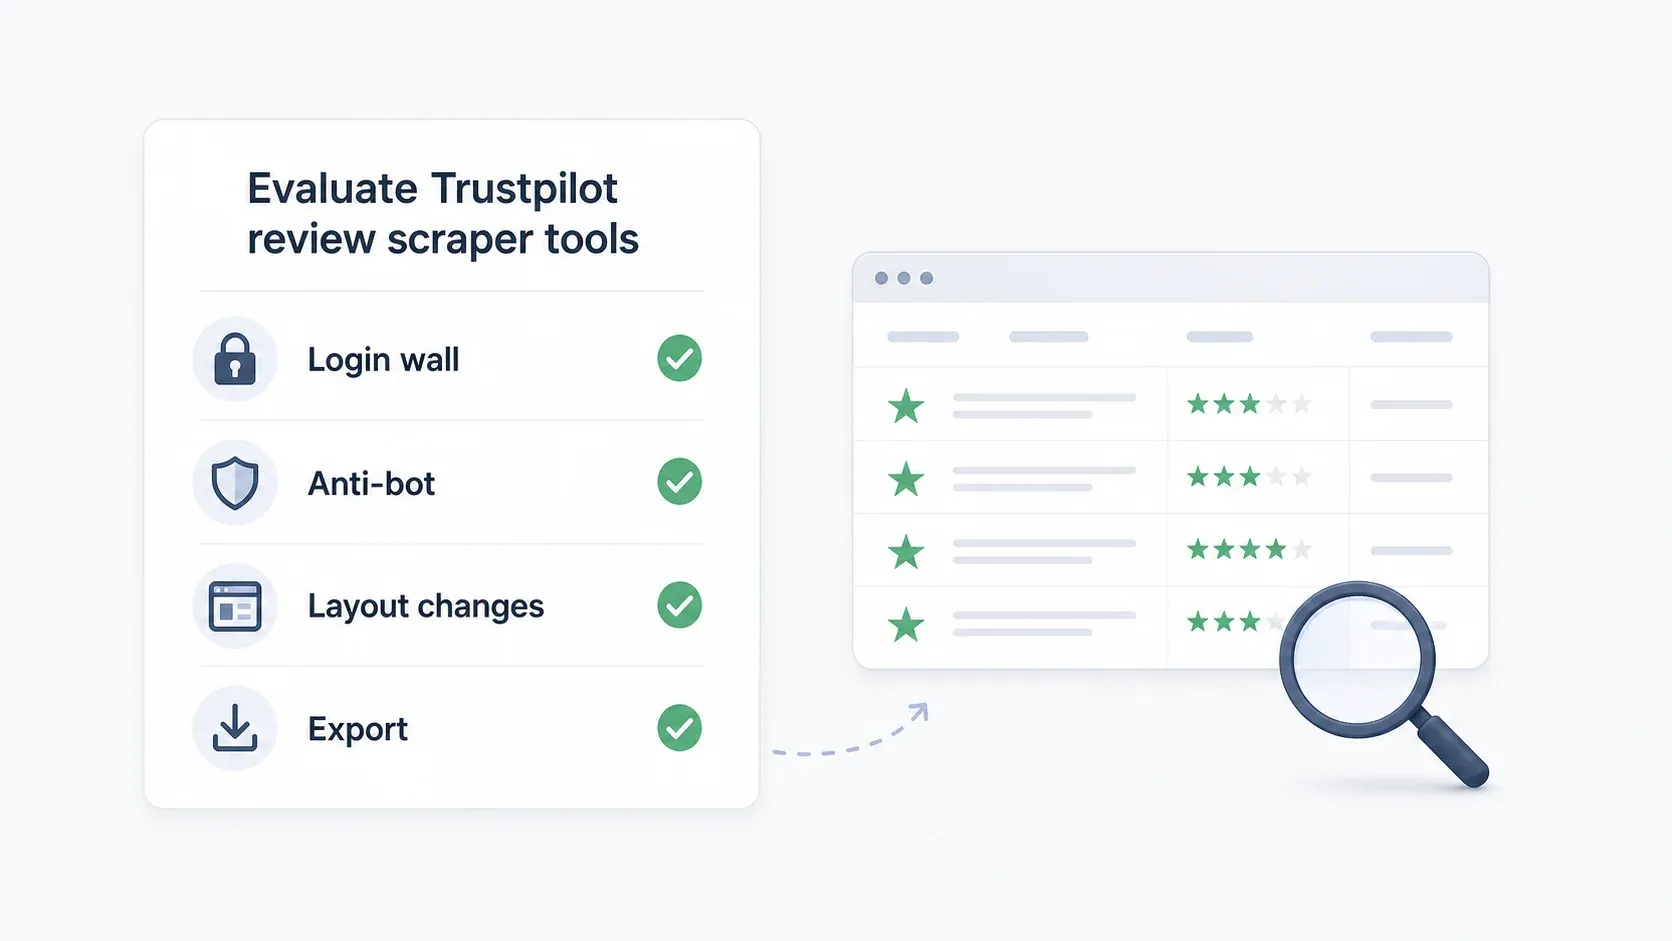
Inloggningsväggen är avgörande.
Om ett verktyg inte kommer förbi sida 10 — eller åtminstone ger en tydlig väg för autentiserad åtkomst — är det inte en fungerande Trustpilot-scraper 2026.
Bästa Trustpilot-recensionsscrapers i överblick
Jämförelsen i korthet:
| Verktyg | Kunskapsnivå | Hantering av inloggningsvägg | Anti-bot-strategi | Paginering | Gratisnivå | Exportalternativ |
|---|---|---|---|---|---|---|
| Thunderbit | No-code | Webbläsarläge (använder din inloggade Chrome-session) | AI-baserad semantisk extrahering anpassar sig till layoutändringar | Automatisk, flersidig | 6 sidor gratis/månad | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Apify | Low-code | Beror på Actor; vissa kräver cookie-konfiguration för sidor >10 | Inbyggd proxyrotation, Actorspecifik | Konfigurerbar per Actor | $5/månad i gratis plattformskrediter | JSON, CSV, Excel, XML, RSS |
| Octoparse | No-code (visuellt) | Manuell konfiguration av cookies/session | IP-rotation, residential proxies, CAPTCHA-lösning (betald) | Klick-/scrollflöde | Gratisplan + 14 dagars premiumtest | CSV, Excel, JSON, HTML, XML, databaser |
| Web Scraper | No-code (sitemap) | Begränsat — egen guide dokumenterar 10-sidorsgräns för recensioner | Moln + proxy på betalda planer | Konfigurerbar; JS-klick rekommenderas | Gratis Chrome-tillägg | CSV, XLSX |
| ScraperAPI | Utvecklare (Python) | Session-/cookie-hantering på kodnivå | 40M+ residential proxies, JS-rendering, CAPTCHA-hantering | Kodbaserad | 7 dagars test, 5 000 API-krediter | Utvecklarstyrt (CSV, JSON, etc.) |
1. Thunderbit

Thunderbit är ett AI-drivet Chrome-tillägg byggt för affärsteam som vill ha strukturerad data från webbplatser utan att skriva kod. För just Trustpilot finns en dedikerad mall för att skrapa recensioner som extraherar recensentens namn, betyg, recensionstitel, recensionstext, datum och företagets svar med ett enda klick.
Jag är partisk — jag jobbar här — men orsaken till att vi byggde Thunderbit på det här sättet hänger direkt ihop med varför Trustpilot är svårt att skrapa. Vår AI läser sidor semantiskt i stället för att förlita sig på CSS-selektorer. När Trustpilot ändrar sina klassnamn eller bygger om DOM-strukturen anpassar sig Thunderbit eftersom det tittar på innebörden i sidans element, inte på deras specifika HTML-adresser.
Testa Thunderbit för Trustpilot-skrapning
Så hanterar Thunderbit inloggningsväggen vid sida 10
Det är här webbläsarläge gör skillnad. Thunderbit körs i din Chrome-webbläsare — samma webbläsare där du redan är inloggad på Trustpilot. När du växlar till browser scraping-läge läser tillägget de sidor som är synliga i din autentiserade session. Inga proxytrick. Ingen cookie-injektion. Inga Playwright-session pools.
Det praktiska flödet: logga in på Trustpilot i Chrome, gå till recensionssidan du vill hämta, öppna tillägget. Med ett klick identifierar AI:n vilka recensionsfält sidan innehåller och gör extraktionen själv. Vill du ha en annan vinkel på datan? Beskriv det, så använder AI:n den versionen i stället. Pagineringen sköts automatiskt därifrån — Thunderbit fortsätter genom varje sida som din webbläsarsession har åtkomst till.
Varför Thunderbit inte går sönder när Trustpilot ändras
Vår Trustpilot-mallsida jämför detta direkt: traditionella scrapers går sönder när layouten ändras och CSS-selektorer måste uppdateras. Thunderbit använder semantisk AI som förstår innehåll utan att luta sig mot specifik CSS, hanterar dynamiskt innehåll och sköter automatisk paginering.
Jämför det med ScraperAPIs kodexempel, som parsar via klassnamn som styles_reviewCardInner__EwDq2. Den selektorn kommer att gå sönder nästa gång Trustpilot uppdaterar. Thunderbits AI frågar i stället: "var finns recensionstexten på den här sidan?" snarare än "vad ligger i just den här div-klassen?"
Viktiga funktioner för Trustpilot-skrapning
- AI-upptäckta fält: tillägget hittar recensionens fält själv (namn, betyg, datum, titel, text, företagets svar) utan manuell konfiguration — eller, om du har en specifik uppsättning i åtanke, anger du det så använder AI:n den
- Workflow med ett klick: ett klick → den färdiga tabellen. Punkt slut.
- Webbläsarläge för sidor som kräver inloggning: fungerar i din autentiserade Chrome-session för åtkomst till sida 10+
- Automatisk paginering: hanterar flersidiga recensionsuppsättningar utan manuella steg
- Skrapning av undersidor: kan besöka enskilda recensentprofiler för berikande data
- Schemalagd skrapning: sätt upp veckovis eller månadsvis bevakning av recensioner för omdömesspårning
- Export: Google Sheets, Airtable, Notion, CSV, JSON — allt ingår gratis
Prissättning
- Gratisplan: 6 sidor/månad, inget kreditkort krävs
- Kreditbaserat system: 1 kredit = 1 output-rad
- Betalda planer: $15/månad, eller cirka $9/månad vid årsbetalning (prissida)
Bäst för: Marknadsteam, driftteam och affärsanvändare som vill ha Trustpilot-recensioner utan att röra kod — och som inte vill lägga tid på att underhålla en scraper som går sönder varannan vecka.
2. Apify
Apify är en molnbaserad scraping-plattform med en marknadsplats för färdigbyggda "Actors" — scrapers som andra användare och Apifys team har tagit fram. För Trustpilot finns det i butiken flera community-underhållna Actors med varierande tillförlitlighet.
Avvägningen med Apify är att det kan vara kraftfullt, men uppdelat. Vissa Actors fungerar. Vissa är föråldrade. Vissa kräver cookies för sida 10+. Och Reddit-klagomålen om att "none of the actors on the store work" stämmer ofta — de visar hur snabbt Trustpilot-ändringar kan slå ut Actor-specifik logik.
Trustpilot Actors och kända begränsningar
Apify Store innehåller flera Trustpilot Actors. Minst en (av utvecklaren "burbn") anger uttryckligen att cookie-input krävs för sidor bortom 10. Andra har 0,0 i betyg, väldigt få användare eller mycket nyliga ändringsdatum — signaler om att underhåll pågår och att tillförlitligheten varierar.
De föråldrade Actorsen är också värda att nämna. En äldre Actor läste Trustpilots inbäddade __NEXT_DATA__-JSON direkt — ett smart sätt som var snabbare än DOM-parsning men som ändå gick sönder när Trustpilot ändrade sin datastruktur.
Hantering av inloggningsvägg och anti-bot
- Inloggningsvägg: beror helt på vilken Actor du väljer. Vissa stöder cookie-injektion för sida 10+; andra gör det inte.
- Anti-bot: Apifys plattform inkluderar proxyrotation och infrastruktur baserad på compute units. Residential proxies finns tillgängliga för $8/GB på Free/Starter-planer.
- Underhåll: när en Actor går sönder väntar du antingen på att underhållaren fixar den, byter till en annan Actor eller beställer en egen privat Actor.
Prissättning
- Gratisplan: $5/månad i förbetalda användningskrediter, inget kreditkort krävs
- Starter: $9/månad + pay-as-you-go
- Scale: $99/månad + pay-as-you-go
- Export: JSON, CSV, Excel, XML, RSS (beror på Actor)
Bäst för: Tekniskt vana användare som kan utvärdera flera Actors, konfigurera cookies och felsöka när något går sönder. Inte idealiskt för team som vill ha en lösning som bara fungerar utan uppmärksamhet.
3. Octoparse
Octoparse är en skrivbordsbaserad no-code-scraper med en visuell byggare för klicka-och-peka-flöden. Den placerar sig mellan Thunderbits enkelhet med ett klick och ScraperAPIs fulla utveckarkontroll — du får visuell konfiguration utan kod, men du bygger och underhåller fortfarande ett arbetsflöde.
Så sätter du upp en Trustpilot-scrape i Octoparse
Arbetsflödet är enkelt men manuellt:
- Klistra in en Trustpilot-URL för företagsrecensioner
- Välj ut recensionselement visuellt (titel, brödtext, betyg, datum, recensentnamn)
- Definiera en pagineringsloop med knappen för nästa sida
- Konfigurera väntetider (2–5 sekunder rekommenderas för att undvika reCAPTCHA)
- Kör lokalt för små exempel eller i molnet för större jobb
Installationen tar 10–15 minuter för någon som känner till verktyget. Haken: eftersom Octoparse använder visuella selektorer som är kopplade till DOM-element måste du uppdatera ditt flöde varje gång Trustpilot ändrar sidstrukturen.
Hantering av inloggningsvägg och anti-bot
- Inloggningsvägg: kräver manuell konfiguration av inloggning/cookies/session. Sköts inte automatiskt.
- Anti-bot: betalda planer inkluderar IP-rotation, residential proxies ($3/GB) och automatisk CAPTCHA-lösning ($1–1,5 per tusen).
- Underhåll: måttligt. Räkna med att bygga om eller justera arbetsflödet när Trustpilot uppdaterar sin frontend.
Prissättning
- Gratisplan: gratis för alltid, 10 uppgifter, 1 enhet, lokal extraktion, upp till 50 000 rader/månad
- Standard: $69/månad (faktureras årsvis)
- Professional: $149/månad
- 14 dagars premiumtest: inkluderar molnextraktion, schemaläggning, API och mallar
- Export: Excel, CSV, JSON, HTML, XML; databaser och Google Sheets på högre nivåer
Bäst för: Användare som vill ha visuell kontroll över arbetsflöden, inte har något emot initial uppsättningstid och är bekväma med att underhålla flöden när sidor förändras. Bra för team som behöver mer anpassning än ett verktyg med ett klick, men mindre komplexitet än att skriva Python.
4. Web Scraper
Web Scraper är ett Chrome-tillägg och en molnplattform med ett sitemap-baserat angreppssätt för scraping. Deras starkaste erbjudande för Trustpilot är en förbyggd mall för företagssidor som extraherar data på företagsnivå: företagsnamn, kategori, adress, betyg, antal recensioner, TrustScore och webbplats-URL.
För just recensionsskrapning finns det dock en dokumenterad begränsning som är viktig att lyfta.
Förbyggd mall kontra egen konfiguration
Marknadsplatsmallen fungerar bra för att hitta företag — att skrapa företagsprofiler över Trustpilot-kategorier. För egen extraktion av recensioner låter Sitemap Wizard dig bygga en scraper visuellt i Chrome-tillägget.
Web Scrapers egen guide från mars 2026 rekommenderar paginering med JavaScript-klick i stället för URL-baserad paginering, eftersom Trustpilot kan omordna innehållet dynamiskt mellan sidor och därmed flytta runt resultaten.
Hantering av inloggningsvägg och anti-bot
Här är det viktigt att vara rak: Web Scrapers officiella guide säger uttryckligen att Trustpilot bara tillåter de första 10 recensionssidorna innan en inloggningsprompt visas. Guiden dokumenterar detta som en känd begränsning snarare än att erbjuda en lösning.
- Inloggningsvägg: begränsad hantering. Gränsen på 10 recensionssidor dokumenteras i deras egen guide.
- Anti-bot: molnplaner inkluderar proxy-stöd; guiden rekommenderar 2–5 sekunders fördröjning och lägre samtidighet.
- Paginering: kan konfigureras, men är i praktiken begränsad till de första 10 recensionssidorna för oautentiserad åtkomst.
Prissättning
- Gratis Chrome-tillägg: lokal scraping, begränsad funktionalitet
- Project: $50/månad (5 000 URL-krediter)
- Professional: $100/månad (20 000 URL-krediter)
- Scale: från $200/månad (obegränsade URL-krediter med villkor)
- 7 dagars gratis test på betalda molnplaner
- Export: CSV, XLSX
Bäst för: Användare som vill ha en färdig mall för att skrapa Trustpilot-företagsprofiler, eller som bara behöver recensioner från de första 10 sidorna. Inte rätt val om du behöver fullständig recensionshistorik för företag med många recensioner.
5. ScraperAPI
ScraperAPI är scraping-infrastruktur för utvecklare — inte ett klickverktyg, utan ett proxy-/renderingslager som hanterar anti-bot-skydd medan du skriver parslogiken. Deras Trustpilot-lösningssida marknadsför JS-rendering, CAPTCHA-hantering och 40M+ proxies.
Om du är Python-utvecklare och vill ha full kontroll över extraheringslogiken ger ScraperAPI dig själva infrastrukturen.
Men du äger också underhållet.
Bygga en egen Trustpilot-scraper med ScraperAPI
ScraperAPIs guide från januari 2026 visar ett arbetsflöde i Python + BeautifulSoup:
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
Den färdiga koden i guiden sätter pages_to_scrape = 10 — vilket indirekt bekräftar den publika sidgränsen. För sida 10+ måste utvecklare själva hantera autentiserade sessioner, cookies och tokens.
Hantering av inloggningsvägg och anti-bot
- Inloggningsvägg: session-/cookie-hantering på kodnivå krävs. ScraperAPI sköter proxies och rendering; du sköter autentiseringslogiken.
- Anti-bot: residential proxy-pool med automatisk IP-rotation, JS-rendering via
render=true, CAPTCHA-hantering genom smart proxy-rotation. Finns på alla planer. - Underhåll: när Trustpilot ändrar klassnamn (vilket de gör regelbundet) måste du uppdatera din pars-kod. Guidens selektor
styles_reviewCardInner__EwDq2är redan en tidsinställd bomb.
Prissättning
- 7 dagars test: 5 000 gratis API-krediter, inget kreditkort krävs
- Hobby: $49/månad (100 000 API-krediter)
- Startup: $149/månad (1 000 000 krediter)
- Business: $299/månad (3 000 000 krediter)
- Export: vad din kod än producerar (vanligtvis CSV, JSON, databasinskrivningar)
Bäst för: Utvecklare som vill ha full anpassning, kan underhålla sina egna pars-skript och behöver programmerbar kontroll över sessionhantering, pagineringslogik och datastruktur. Inte för icke-tekniska användare.
Varför Trustpilot-scrapers fortsätter gå sönder (och hur du väljer en som inte gör det)
Det här är den mest underskattade faktorn när man väljer en Trustpilot-scraper. Frågan är inte "fungerar det här verktyget idag?" Det är "kommer det här verktyget fortfarande fungera om tre veckor?"
Scrapers går sönder på Trustpilot av fyra återkommande skäl:
-
Genererade CSS-klassändringar. Next.js CSS-moduler skapar klassnamn som
styles_reviewCardInner__EwDq2. Dessa ändras vid varje frontenduppdatering. Varje scraper som riktar in sig på dessa klasser går sönder. -
Förändringar i DOM-strukturen. Trustpilot kan bygga om sin HTML-hierarki — kapsla in recensionskort på andra sätt, byta wrapper-element, flytta metadata till nya positioner.
-
Förändringar i anti-bot-utlösare. reCAPTCHA-trösklar skiftar. Rotation av sessions-token blir mer aggressiv. Regler för CDN-filtrering uppdateras.
-
Förändringar i autentisering/session. Inloggningsväggen vid sida 10 infördes (eller började tillämpas striktare) i slutet av 2025. Framtida åtkomstbegränsningar kan dyka upp när som helst.
Den grundläggande arkitektoniska skillnaden är mellan selektorbaserad och semantisk extrahering:
-
Selektorbaserade verktyg (Apify Actors, Octoparse-flöden, ScraperAPI-skript, Web Scraper-sitemaps) frågar: "Hitta elementet på exakt den här CSS-platsen." När platsen ändras faller de tillbaka eller returnerar tom data.
-
Semantiska/AI-baserade verktyg (Thunderbit) frågar: "Hitta recensionstexten, betyget och datumet på den här sidan." AI:n tolkar sidans innehåll utifrån betydelse, inte adress. Layoutändringar bryter inte verktyget eftersom betydelsen inte har ändrats.
Min rekommendation:
- Noll tolerans för underhåll? → AI-baserat (Thunderbit)
- Lite underhåll okej, vill ha molnautomatisering? → Apify (med noggrant Actor-val och övervakning)
- Visuell kontroll, måttligt underhåll? → Octoparse
- Mallbaserat, begränsat scope? → Web Scraper
- Full kontroll, äga allt själv? → ScraperAPI
Vad du kan göra med skrapade Trustpilot-recensioner
Att extrahera recensioner är bara första steget. Frågan jag ser hela tiden i forum är: "Jag har datan — vad gör jag nu?"
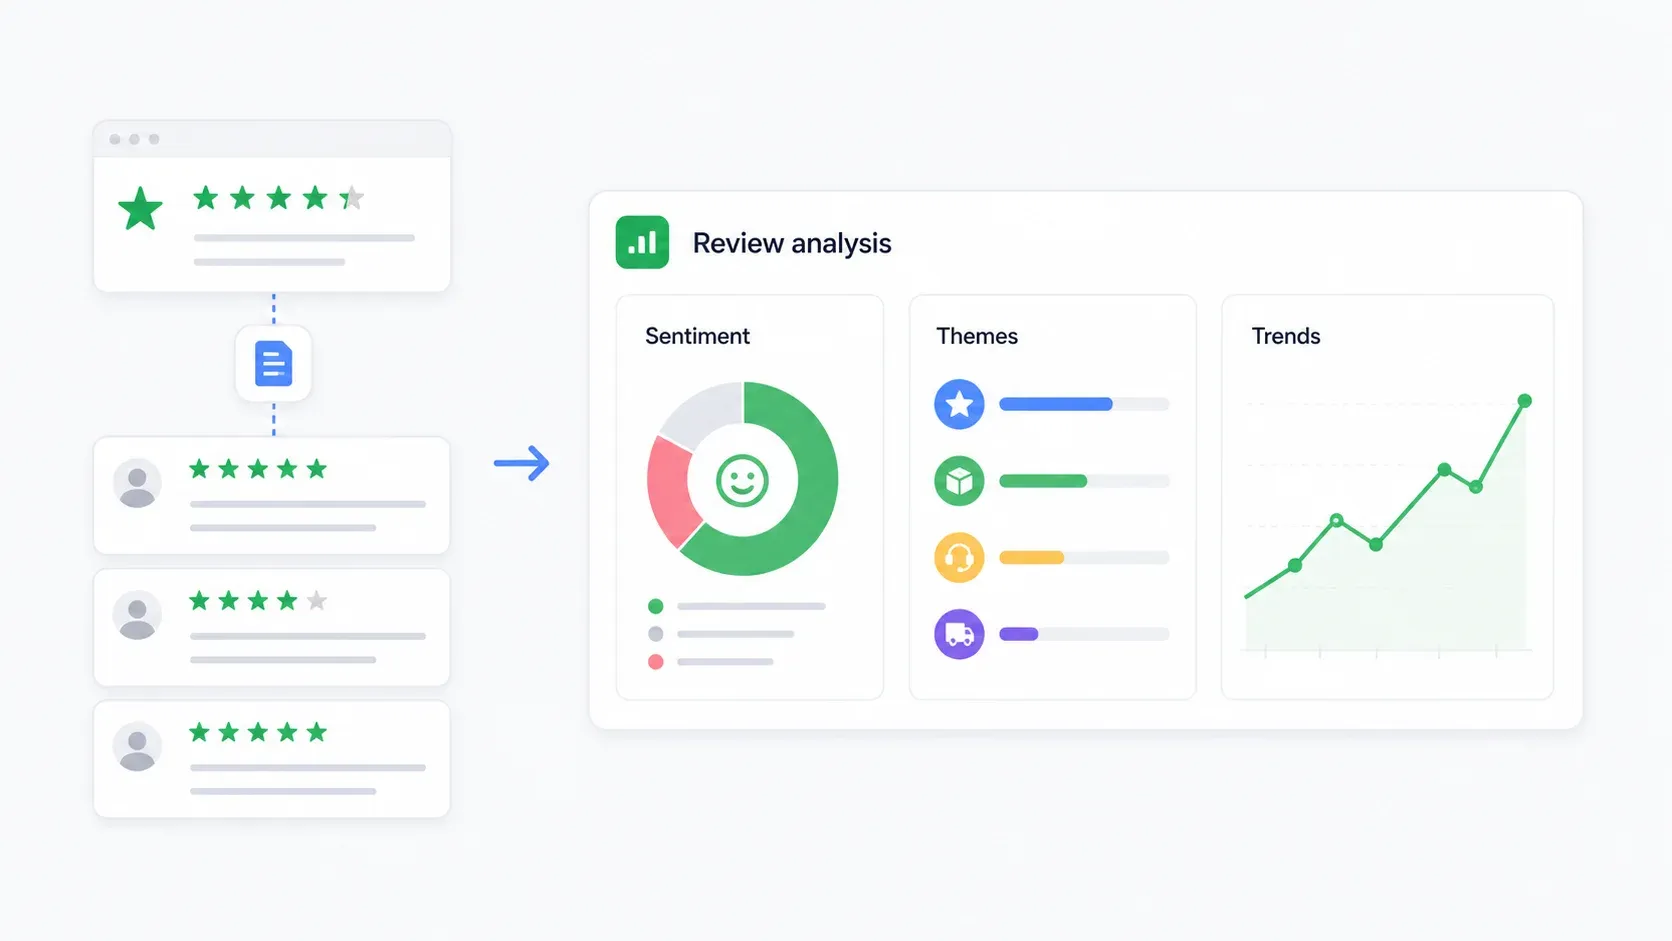
Sentimentanalys
Det enklaste flödet: exportera recensioner till Google Sheets och använd sedan ett AI-verktyg (ChatGPT, Claude eller en AI-funktion i Sheets) för att klassificera varje recension som positiv, neutral eller negativ. Lägg till kolumner för klagokategori, brådska och föreslagen åtgärdsprioritet.
För större datamängder kan du ladda upp CSV-filen till ChatGPT och be om en sammanfattning: "Klassificera dessa recensioner efter sentiment och identifiera de fem vanligaste klagoteman med representativa citat."
Konkurrentbevakning
Använd Thunderbits schemalagda scraping för att hämta konkurrenters recensioner veckovis eller månadsvis. Följ:
- Genomsnittligt betyg över tid
- Andel 1-stjärniga och 2-stjärniga recensioner
- Förändringar i recensionsvolym (får de fler eller färre recensioner?)
- Vanligaste klagoteman
- Företagets svarsfrekvens och svarstid
En enkel Google Sheets-dashboard med pivottabeller per betyg och datum ger dig ett flöde för konkurrensbevakning som uppdateras automatiskt.
Temaextraktion
Gruppera recensioner efter vanliga kategorier: leverans/frakt, kundsupport, återbetalningar, produktkvalitet, fakturering, appens användbarhet, pris/värde och bedrägeribekymmer. Resultatet bör vara en tabell som visar: tema, antal, genomsnittligt betyg, representativa citat och föreslagen affärsåtgärd.
Det här är mer användbart än ett ordmoln. Det visar vad som faktiskt driver nöjdhet eller missnöje.
Storskalig analys över flera företag
För research på kategorinivå kan du skrapa recensioner från flera företag i samma Trustpilot-kategori. Jämför recensionsvolymer, betyg, stjärnfördelning och förekomst av teman över ett helt marknadssegment. Web Scrapers mall för företagslistor är användbar för att hitta bolag; Thunderbit eller ScraperAPI kan sedan hantera uttag av recensionsnivådata för varje företag.
Juridiska och etiska överväganden kring Trustpilot-skrapning
Jag är inte jurist, och det här är inte juridisk rådgivning. Men efterlevnadsfrågan spelar roll här.
Trustpilots användarvillkor är tydliga. De förbjuder användare från att komma åt eller samla in innehåll "by any means other than as provided or specifically approved by Trustpilot," och pekar specifikt ut text mining, data mining och web scraping utan uttryckligt tillstånd.
Risknivåerna ser ungefär ut så här:
- Lägre risk: Exportera ditt eget företags recensioner för intern analys, särskilt med Trustpilots officiella företagsverktyg eller API.
- Måttlig risk: Skrapa offentliga konkurrentsidor i låg volym för marknadsresearch. Fortfarande underställt användarvillkor och integritetskrav.
- Högre risk: Skrapa autentiserat innehåll efter sida 10, kringgå tekniska skydd, distribuera recensentdata eller använda skrapade recensioner för träning av AI-modeller.
GDPR-aspekter: Recensentnamn, profil-länkar, recensionstext och platsdata kan utgöra personuppgifter enligt EU:s integritetslagstiftning. Praktiska skyddsåtgärder är att bara samla in nödvändiga fält, hash:a recensentnamn för intern analys, sätta lagringsperioder och inte publicera rå recensionstext i stor skala.
Offentlig kontra autentiserad data: Det finns en viktig juridisk och etisk skillnad mellan att skrapa sidor som vem som helst kan se (de första 10 recensionssidorna) och att skrapa data bakom en inloggningsvägg. Verktyg som bara arbetar med offentligt tillgänglig data innebär lägre efterlevnadsrisk än de som kräver inloggningsuppgifter.
Det här bör påverka ditt verktygsval. Thunderbits browser mode arbetar med sidor som är synliga i din egen session — det kringgår inte autentisering på egen hand. ScraperAPI ger utvecklare full kontroll, men också fullt ansvar för om sessionhanteringen är laglig.
Så väljer du rätt Trustpilot-recensionsscraper
Beslutsram per persona:
- Icke-teknisk marknadsförare som vill ha recensioner utan kod? → Thunderbit. Ett klick, AI sköter resten, export till Sheets/Notion/Airtable.
- Low-code-användare som är bekväm med konfiguration och felsökning? → Apify. Välj en Actor, konfigurera cookies för sida 10+, övervaka avbrott.
- Visuell byggare som vill ha kontroll över arbetsflödet? → Octoparse. Klicka dig fram, men räkna med underhåll när Trustpilot ändras.
- Behöver företagsdata eller bara recensioner från de första 10 sidorna? → Web Scraper. Starka förbyggda mallar för företagsprofiler.
- Utvecklare som vill ha full anpassning? → ScraperAPI. Äg din pars-logik, sessionhantering och datapipeline.
Om underhållstolerans är din främsta fråga går skalan från Thunderbit (nästan inget underhåll) till ScraperAPI (du underhåller allt). Budgetmässigt har varje verktyg på den här listan en gratis ingångspunkt — börja där innan du binder upp dig.
Slutsats
Trustpilot-recensionsdata är verkligen värdefullt för konkurrensanalys, omdömesspårning och kundinsikter.
Men 2026 kräver pålitlig extrahering ett verktyg som kan hantera inloggningsväggen vid sida 10, anpassa sig till DOM-ändringar och hantera anti-bot-skydd utan konstant manuell hantering.
För de flesta företagsanvändare är Thunderbit den mest friktionsfria vägen — ett klick, AI-driven fältdetektering, webbläsarläge för autentiserade sidor och inget underhåll när Trustpilot ändrar sin frontend. Du kan testa gratis med 6 sidor/månad och inget kreditkort.
För utvecklare som vill ha full kontroll erbjuder ScraperAPI infrastrukturen. För alla däremellan fyller Apify, Octoparse och Web Scraper varsin tydlig nisch. Nyckeln är att matcha verktyget med din tekniska nivå, din tolerans för underhåll och dina krav på efterlevnad.
Om du vill se hur Thunderbit hanterar Trustpilot specifikt har vi en genomgång på vår YouTube-kanal. Och för bredare sammanhang om web scraping utan kod eller vad web scraping faktiskt är täcker de guiderna grunderna.
FAQ
1. Kan man skrapa Trustpilot-recensioner bortom sida 10?
Ja, men bara via en autentiserad väg. Trustpilot blockerar oautentiserad åtkomst efter de första 10 recensionssidorna. Thunderbits browser mode fungerar inom din inloggade Chrome-session, så det kan komma åt sidor du själv kan se. ScraperAPI kräver session- och cookie-hantering på kodnivå. Apify Actors behöver cookie-konfiguration. Octoparse kräver manuell inloggnings-/cookie-setup. Web Scrapers egen dokumentation erkänner 10-sidorsgränsen utan att erbjuda någon inbyggd lösning.
2. Är det lagligt att skrapa Trustpilot-recensioner?
Trustpilots användarvillkor förbjuder automatiserad datainsamling utan uttryckligt tillstånd. Den juridiska risken varierar beroende på metod och användningsfall: att skrapa dina egna offentliga recensioner innebär lägre risk än att kringgå autentiseringsväggar för att skrapa konkurrenter. GDPR gäller för EU-relaterade recensionsdata. Detta är inte juridisk rådgivning — rådfråga jurist vid större eller kommersiella scraping-projekt.
3. Vilken data kan man extrahera från Trustpilot?
Vanliga fält är: recensentnamn, stjärnbetyg, recensionstitel, recensionstext, publiceringsdatum, datum för upplevelsen, verifierad köpstatus, recensentens plats, företagets svarstext, företagsnamn, TrustScore, totalt antal recensioner, stjärnfördelning och recensions-URL.
4. Hur ofta går Trustpilot-scrapers sönder?
Selektorbaserade verktyg (Apify Actors, Octoparse-flöden, egna Python-skript) kan gå sönder när som helst Trustpilot ändrar sina CSS-klasser eller DOM-struktur — vilket kan hända flera gånger i månaden. AI-semantiska verktyg som Thunderbit anpassar sig automatiskt eftersom de tolkar sidans innebörd i stället för att rikta in sig på specifika selektorer. Ingen lösning är dock immun mot större förändringar i åtkomstkontrollen, som inloggningsväggen vid sida 10.
5. Kan jag skrapa Trustpilot-recensioner gratis?
Varje verktyg i den här listan har en gratis ingångspunkt: Thunderbit erbjuder 6 gratis sidor/månad, ScraperAPI ger 5 000 testkrediter under 7 dagar, Web Scraper har ett gratis Chrome-tillägg för lokal användning, Octoparse har en gratisplan för alltid (10 uppgifter, 50 000 rader/månad) och Apify inkluderar $5/månad i gratis plattformskrediter. För småskaliga tester eller provkörningar fungerar alla dessa utan betalning.
Testa Thunderbit för att skrapa Trustpilot-recensioner Get Started Free
Läs mer



