
Google hanterar långt över 8,5 miljarder sökningar per dag—vissa uppskattningar landar snarare på 14 miljarder—och siffran fortsätter att stiga. All den sökdata är rena guldgruvan för SEO-team, säljops, e-handelsanalytiker och, i allt högre grad, AI-agenter som behöver färska bevis från webben. Problemet? Att välja en SERP API år 2026 känns mindre som att välja ett verktyg och mer som att försöka navigera i en labyrint av prissidor, kreditsystem och vaga löften om “strukturerad JSON.”
Jag har lagt de senaste veckorna på att granska åtta SERP API-leverantörer—testat svarstider, normaliserat prissättningen över röriga betalmodeller och kontrollerat vilka SERP-funktioner varje tjänst faktiskt tolkar till strukturerade fält. Målet: ge dig en ärlig jämförelse på äpplen-mot-äpplen-nivå som ingen annan artikel erbjuder. Vi går igenom hastighet, verklig kostnad i skala, parseringsomfattning, AI-agent-anpassning och driftsäkerhet i produktion. Om du har varit frustrerad över “du jämför prissidor, inte faktiskt utfall” (ett verkligt citat från en Reddit-tråd jag hittade), då är den här guiden för dig.
Varför du behöver en SERP API 2026 (och varför det är svårt att välja rätt)
En SERP API är en hostad tjänst som skickar en sökfråga till en sökmotor och returnerar resultatsidan i maskinläsbart format—vanligtvis JSON. I stället för att bygga egen proxyrotation, CAPTCHA-hantering, webbläsarrendering och parsers, anropar du bara en endpoint och får tillbaka strukturerad data. Enkelt i teorin, betydligt mer komplicerat i verkligheten.
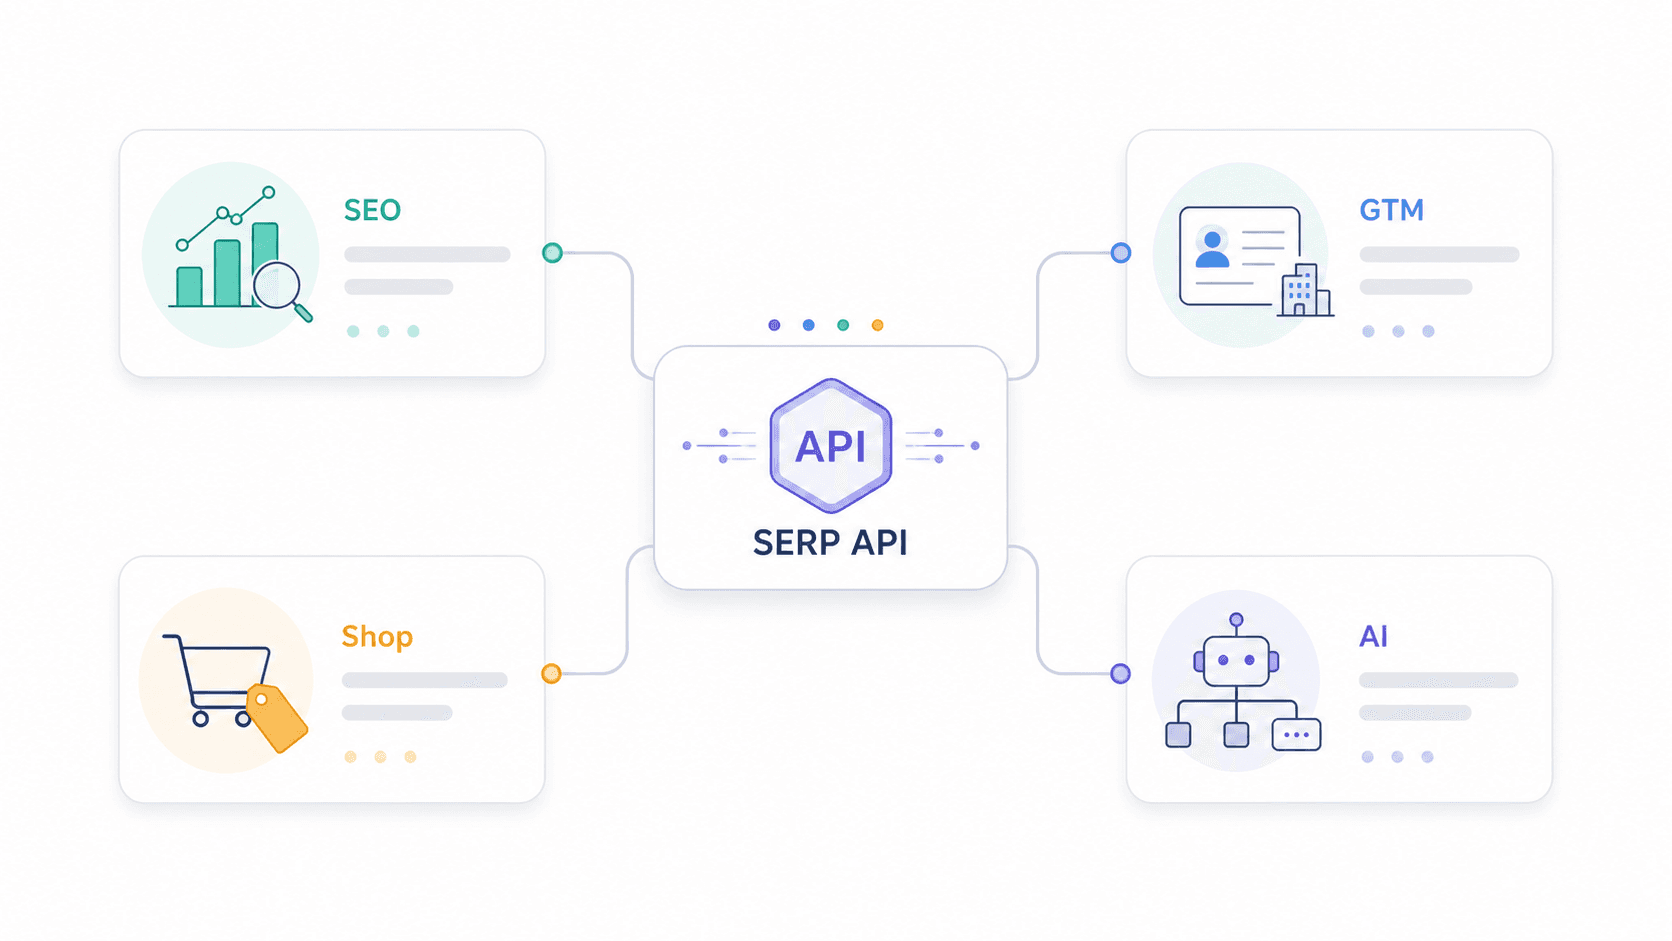
Användningsområdena har vuxit långt bortom rankningsspårning:
- SEO-team behöver rankingdata, snippet-ägande, People Also Ask-frågor och insyn i konkurrenter.
- Sälj- och GTM-team använder SERP:ar för att hitta företag, recensionssidor, kataloger och köpsignaler.
- E-handels-team bevakar Google Shopping, betalda annonser och konkurrentpriser.
- AI-utvecklare matar in SERP-data i LLM-agenter, RAG-pipelines och arbetsflödesverktyg som n8n och LangChain.
Marknaden för webbskrapning väntas nå 2,23 miljarder USD till 2031, med en årlig tillväxt på cirka 13,78 %. SERP API:er står för en stor del av den marknaden.
Här är kärnfrustrationen: alla leverantörer hävdar “strukturerad JSON”, men de faktiska SERP-element som parsas—PAA, knowledge panels, local packs, shoppingannonser, featured snippets—varierar kraftigt mellan dem. Prissättningen är lika snårig. Vissa tar betalt per sökning, andra per kredit, andra per resultat, och vissa har olika priser beroende på hastighetsnivå eller geografisk plats. En Reddit-användare sammanfattade det väl: “SerpApi tar betalt per lyckad sökning, ScraperAPI paketerar allt i krediter, och Serperdev ser billigt ut tills du mappar krediterna mot din verkliga arbetsbelastning.”
Den här artikeln fyller de luckor jag inte kunde hitta någon annanstans: en parseringsmatris som visar vad varje API faktiskt returnerar, normaliserad prissättning vid 1K/10K/100K frågor, AI-agent-passform och data om redo för produktion.
Så testade vi: kriterierna för att välja bästa SERP API
Jag utvärderade varje leverantör utifrån åtta dimensioner som direkt speglar det som faktiskt spelar roll i produktion. De flesta jämförelseartiklar berör bara två eller tre av dessa ytligt. Jag ville ha alla åtta, med belägg.
Hastighet och svarstid. Jag utgick från tredjepartsbenchmarkar—särskilt HasDatas jämförelse—samt leverantörernas dokumentation. Hastighet spelar roll när du bygger realtidsdashboards eller tool-calling AI-agenter som inte kan vänta 30 sekunder på svar.
Prissättning i skala (1K, 10K, 100K frågor). Jag normaliserade varje leverantörs prissättning till kostnad per 1 000 lyckade frågor. Det är det enda rättvisa sättet att jämföra kreditbaserade, abonnemangsbaserade och pay-as-you-go-modeller.
SERP-funktioner som parsas (utöver organiska resultat). Jag kontrollerade dokumentation och exempel-svar för att verifiera vilka SERP-element varje API returnerar som strukturerade fält—not bara rå HTML.
Gratisnivå och pay-as-you-go. Låg tröskel för att börja är viktigt. Om du inte kan testa en leverantör med din verkliga arbetsbelastning innan du binder upp hundratals dollar är det en varningssignal.
AI- och automationsintegration. År 2026 behöver fler team att SERP API:er matar AI-agenter än dashboards. Schemastabilitet, ren output och Markdown-konvertering spelar roll för vidare konsumtion i LLM:er.
Stöd för flera sökmotorer. De flesta artiklar fokuserar uteslutande på Google. Jag kollade vilka leverantörer som stöder Bing, Yandex, DuckDuckGo, Baidu och andra.
Rate limits och produktionsberedskap. Ingen jämförelseartikel går systematiskt igenom rate limits, retry-policyer eller SLA:er. Ändå behöver team som skalar till tusentals frågor per dag den informationen.
Utvecklarvänlighet. Dokumentationskvalitet, SDK-tillgång och tid till första resultat.
1. Thunderbit
Thunderbit har ett helt annat angreppssätt än traditionella SERP API:er. I stället för fasta endpoints som parsar fördefinierade SERP-element låter Thunderbits Extract API dig definiera ditt eget JSON Schema—och AI:n extraherar exakt de fält du anger från vilken sökresultatsida som helst. Distill API omvandlar valfri URL till ren Markdown, redo för LLM-användning.
Det betyder att Thunderbit fungerar på Google, Bing, Yandex, DuckDuckGo eller vilken annan sökmotor som helst—AI:n läser sidan på nytt varje gång i stället för att förlita sig på hårdkodade selektorer. SERP-layouts ändras hela tiden. Du behöver inte vänta på att en leverantör uppdaterar en parser.
Viktiga funktioner
- Extract API: Definiera ett anpassat JSON Schema (organiska resultat, PAA-frågor, lokala företag, shoppingprodukter—det du behöver) och få tillbaka exakt de fälten som strukturerad data.
- Distill API: Konvertera valfri SERP-sida till ren Markdown—perfekt för RAG-pipelines och LLM-sammanfattning.
- Multi-engine från början: Fungerar på alla åtkomliga söksidor, inte bara Google.
- Batchbearbetning: Hantera flera URL:er parallellt.
- Inbyggd anti-bot-hantering: CAPTCHA-lösning, JS-rendering och proxyrotation ingår.
- Rate limits per nivå: Gratis (600 enheter engångs, 2 samtidiga), Starter (60 000 enheter/mån, 30 samtidiga), Pro (600 000 enheter/mån, 50 samtidiga).
Prissättning
Kreditbaserad modell. Distill kostar 1 kredit per sida; Extract kostar 20 krediter per sida. Gratis krediter finns för testning. Med årsplan-räkning kan Distills marginalkostnad bli så låg som cirka 0,80 USD per 1K sidor, medan Extract ligger runt 16 USD per 1K sidor vid full användning. Värdet med Extract är att du får exakt det schema ditt nedströms system behöver—ingen efterbearbetning.
Se Thunderbit Pricing för aktuella paket.
Testa Thunderbit för AI-baserad SERP-extraktion
Bäst för
AI-agentflöden, RAG-pipelines, scraping över flera sökmotorer, team som behöver flexibel schemahantering i stället för fast output, och alla som tröttnat på att vänta på att en leverantör ska lägga till stöd för en ny SERP-funktion.
2. SerpApi
SerpApi är veteranen i det här segmentet—aktivt sedan 2016 och med det bredaste utbudet av Google-specifika endpoints. Det täcker Google Search, Maps, Shopping, Scholar, News, Jobs, Trends, Images, Videos och mer.
Viktiga funktioner
- Dedikerade endpoints för olika Google-produkter med mogen geostyrning (ned till stadsnivå).
- Parsar PAA, knowledge panels, local pack, annonser, shoppingresultat, featured snippets, answer boxes och relaterade sökningar som strukturerade fält.
- Välskött dokumentation och klientbibliotek på flera språk.
Prissättning
250 gratis sökningar/månad. Starter-plan: 25 USD/månad för 1 000 sökningar (effektivt 25 USD per 1K). Developer-planen (markerad som “Mest populär”): 75 USD/månad för 5 000 sökningar (~15 USD per 1K). Big Data: 275 USD/månad för 30 000 sökningar (~9,17 USD per 1K). Ingen enkel pay-as-you-go-modell—det är abonnemangspaket.
Hastighet och tillförlitlighet
HasDatas benchmark visar cirka 5,49 sekunder i genomsnittlig svarstid—not den snabbaste, men stabil. SerpApi annonserar 99,95 % SLA för upptid på betalda planer, och samtidighetsgränser varierar beroende på plan.
Bäst för
Team som behöver bredast möjliga täckning av Google-produkter (Maps, Scholar, Shopping, Jobs) med hög precision och stabila scheman. Enterprise-projekt med budget för premiumprissättning.
3. Serper
Serper är satsningen på hastighet och låg kostnad. Det är en nyare aktör som fokuserar på snabb Google SERP-skrapning till mycket konkurrenskraftigt pris, och den har blivit populär i n8n- och LangChain-communityn för AI-agentintegrationer.
Viktiga funktioner
- Ren JSON-output för Google Search, News, Scholar, Images, Shopping, Videos, Places, Patents och Autocomplete.
- Minimal uppsättning—du kan börja hämta resultat på under en minut.
- Så enkel att AI-agentramverk kan integrera den nativt.
Prissättning
2 500 gratis frågor vid registrering. Startpris runt 0,001 USD/sökning, sjunkande till cirka 0,00075 USD vid hög volym. Vänlig för pay-as-you-go. En hake: om du begär fler än 10 resultat per fråga kan det kosta 2 krediter (verifiera aktuellt beteende i din dashboard).
Hastighet och tillförlitlighet
Bland de snabbaste i benchmarkar—HasData rapporterar omkring 2,87 sekunder i snitt. Support är endast via e-post, och teamet har en relativt låg offentlig profil, vilket gör vissa användare försiktiga. Vid mycket hög samtidighet rapporterar vissa granskare tillförlitlighetsproblem. För de flesta arbetsflöden fungerar den dock bra.
Bäst för
Budgetmedvetna projekt, startups och AI-agentintegrationer som behöver snabb och billig Google SERP-data. Högvolym rank tracking där kostnad per fråga är den främsta begränsningen.
4. Scrapingdog
Scrapingdog har varit på marknaden i över 5 år och dyker konsekvent upp som den snabbaste i tredjepartsbenchmarkar. HasData mätte den till cirka 1,25 sekunder i genomsnittlig svarstid med 100 % träffsäkerhet.
Viktiga funktioner
- Google SERP API returnerar organiska resultat, PAA, featured snippets, annonser och lokala resultat som strukturerad JSON.
- Både rå HTML och parserad JSON finns att välja på.
- Dokumentation på flera språk med kodexempel för de flesta programmeringsspråk—det tar minuter, inte timmar, att komma igång.
- Support dygnet runt.
Prissättning
200 gratis krediter/månad. Betalda planer börjar runt 40 USD/månad. Pris per anrop börjar kring 0,001 USD och sjunker kraftigt vid hög volym—vissa jämförelser anger så lågt som 0,000058 USD i de högsta nivåerna.
Hastighet och tillförlitlighet
Hastighetssiffrorna är verkligen imponerande. Om ditt arbetsflöde är latenskänsligt och du gör högvolymutdrag av Google SERP med fast schema är Scrapingdog svårslaget på ren svarstid.
Bäst för
SEO-verktyg och rank trackers med hög volym som behöver låg latens och låg kostnad. Team som bygger produktionssystem där varje millisekund i API-svarstid spelar roll.
5. DataForSEO
DataForSEO är inte bara en SERP API—det är en hel API-svit för företag som bygger SEO-produkter. Den täcker SERP, nyckelord, backlinks, företagsdata, Google Ads, Trends och mer.
Viktiga funktioner
- Extremt omfattande parsering av SERP-funktioner—organiskt, betalt, local pack, knowledge graph, PAA, featured snippets, shopping, bilder, videos, top stories och mer.
- Två lägen: Live (synkront) för realtidsdashboards, och Standard (asynkront) för batcharbetsflöden där du köar uppgifter och hämtar resultat senare.
- Multi-engine: Google, Bing, Yahoo, Baidu, Naver, Seznam och andra.
Prissättning
Pay-as-you-go-modell, men kostnaden varierar beroende på endpoint, sökmotor, enhet, prioritet och läge. SERP-prissättningen ligger vanligtvis mellan cirka 0,0006 USD och 0,002 USD per uppgift för Google-organiskt beroende på standard vs. live och prioritet. Dokumentationen är tät—räkna med att behöva använda priskalkylatorn. DataForSEO Pricing.
Hastighet och tillförlitlighet
Standard async-läge kan vara långsammare (~10 sekunder) eftersom uppgifter köas. Live/höghastighetslägen kostar mer men passar för realtidsdashboards. Lång historik, beprövad stabilitet och enterprise-support finns tillgängligt.
Bäst för
SaaS-bolag som bygger SEO-plattformar, rank tracking-dashboards och verktyg för sökordsanalys. Team som är bekväma med komplex dokumentation och företagsnivå-infrastruktur.
6. Bright Data
Bright Data är enterprise-vikten. Dess SERP API är bara en del av helheten—proxies, datasets, Web Unlocker och scrapingverktyg. Värdeerbjudandet är skala, tillförlitlighet och infrastruktur.
Viktiga funktioner
- Dedikerade endpoints för Google Maps, Shopping och generell sökning—plus stöd för flera sökmotorer via proxyinfrastruktur som täcker Bing, Yahoo, Yandex och DuckDuckGo.
- Hävdar 100 % lyckandefrekvens med inbyggd unblock-teknik.
- Där Bright Data verkligen sticker ut: geostyrning, samtidighet och unblockning i enterprise-skala.
Prissättning
Inriktad på företag. Offentlig prissättning visar pay-as-you-go och abonnemangsalternativ, och många jämförelser nämner startåtaganden runt 499 USD/månad. Pris per anrop börjar omkring 0,005 USD men sjunker med volym. Bright Data Pricing. Gratisnivå finns (5 000 krediter/månad, inget kreditkort krävs).
Hastighet och tillförlitlighet
Benchmarkar visar ofta 2 till 5,58 sekunder. Skälet att välja Bright Data är inte lägsta medianlatens—det är enterprise-SLA, dedikerad support och infrastruktur som klarar miljontals samtidiga förfrågningar utan försämring. Dokumentation om rate limits rekommenderar att du skalar upp gradvis.
Bäst för
Enterprise-team som samlar in miljontals SERP:ar per månad. Organisationer som behöver Google Maps-/lokal företagsdata i stor skala. Team som redan använder Bright Datas proxyprodukter.
7. ScraperAPI
ScraperAPI är en allmän webbskrapnings-API som också erbjuder strukturerade Google SERP-endpoints. Det är “ett verktyg för allt”-alternativet—enkelt att integrera, med en proxy-pool på över 40 miljoner IP-adresser.
Viktiga funktioner
- Endpoints för strukturerad data för Google Search, Shopping, News och Jobs.
- Maskininlärningsbaserad anti-blockering och CAPTCHA-lösning, med JavaScript-rendering inkluderad utan extra kostnad.
- Geostyrning för lokaliserade resultat.
Prissättning
7 dagars gratis provperiod med 5 000 krediter. Betalda planer börjar runt 49 USD/månad. Haken: SERP-anrop kan förbruka andra krediter än vanliga scraping-förfrågningar, så normalisera alltid efter faktiskt levererade lyckade SERP-frågor. ScraperAPI Pricing.
Hastighet och tillförlitlighet
Här är den ärliga delen: HasDatas benchmark rapporterar cirka 33,66 sekunder i genomsnitt för SERP-frågor. Det är avsevärt långsammare än dedikerade SERP API:er. Hög träffsäkerhet (99,9 %), men latensen gör den mindre lämplig för realtidsapplikationer. Bättre för batchbearbetning.
Bäst för
Team som behöver en generell webbskrapningslösning där SERP är ett tillägg. Projekt där hastighet är mindre viktigt än tillförlitlighet och enkel uppsättning. Utvecklare som redan använder ScraperAPI för andra skrapningsuppgifter och vill samla leverantörer.
8. Apify
Apify är inte ett rent SERP API. Det är en skrapnings- och automationsplattform byggd kring “Actors”—återanvändbara skript för uppgifter som Google Search-skrapning, Maps-extraktion och arbetsflödesautomation. Tänk på det som en marknadsplats där du väljer (eller bygger) den scraper som passar exakt ditt behov.
Viktiga funktioner
- Marknadsplats med färdiga Google SERP actors med varierande funktionsomfång.
- Mycket anpassningsbart—bygg egna scrapingflöden, kedja ihop actors, schemalägg körningar.
- Output i JSON; flexibilitet att parse specifika SERP-funktioner via actor-konfiguration.
- Starkt när du vill kombinera SERP-extraktion med andra scraping- eller automationsuppgifter.
Prissättning
Gratisnivå med månatliga plattformscredits (värda cirka 5 USD, ungefär 1 400 resultat). Betalda planer börjar runt 29 USD/månad. Kostnaden på actor-nivå varierar—vissa tar betalt per resultat, andra per compute unit. Tredjepartsjämförelser placerar ofta Apify runt 0,003 USD/sökning vid liten skala. Apify Pricing.
Hastighet och tillförlitlighet
HasData rapporterar cirka 8,2 sekunder i snitt. Actor-baserad arkitektur ger extra overhead jämfört med dedikerade SERP-endpoints. Bättre för schemalagda/batchade flöden än för realtidsfrågor.
Bäst för
Team som behöver anpassad scraping + automation bortom bara SERP-data. Projekt som kombinerar SERP-extraktion med andra webbskrapningsuppgifter. Utvecklare som vill ha maximal flexibilitet framför färdiga endpoints.
Matris för SERP-parsering: vad varje API faktiskt returnerar
Det här är jämförelsen jag inte kunde hitta någon annanstans. Alla leverantörer säger “strukturerad JSON”, men de faktiska SERP-element som parsas som förstklassiga fält skiljer sig dramatiskt åt. Jag kontrollerade dokumentation och exempel-svar för var och en.
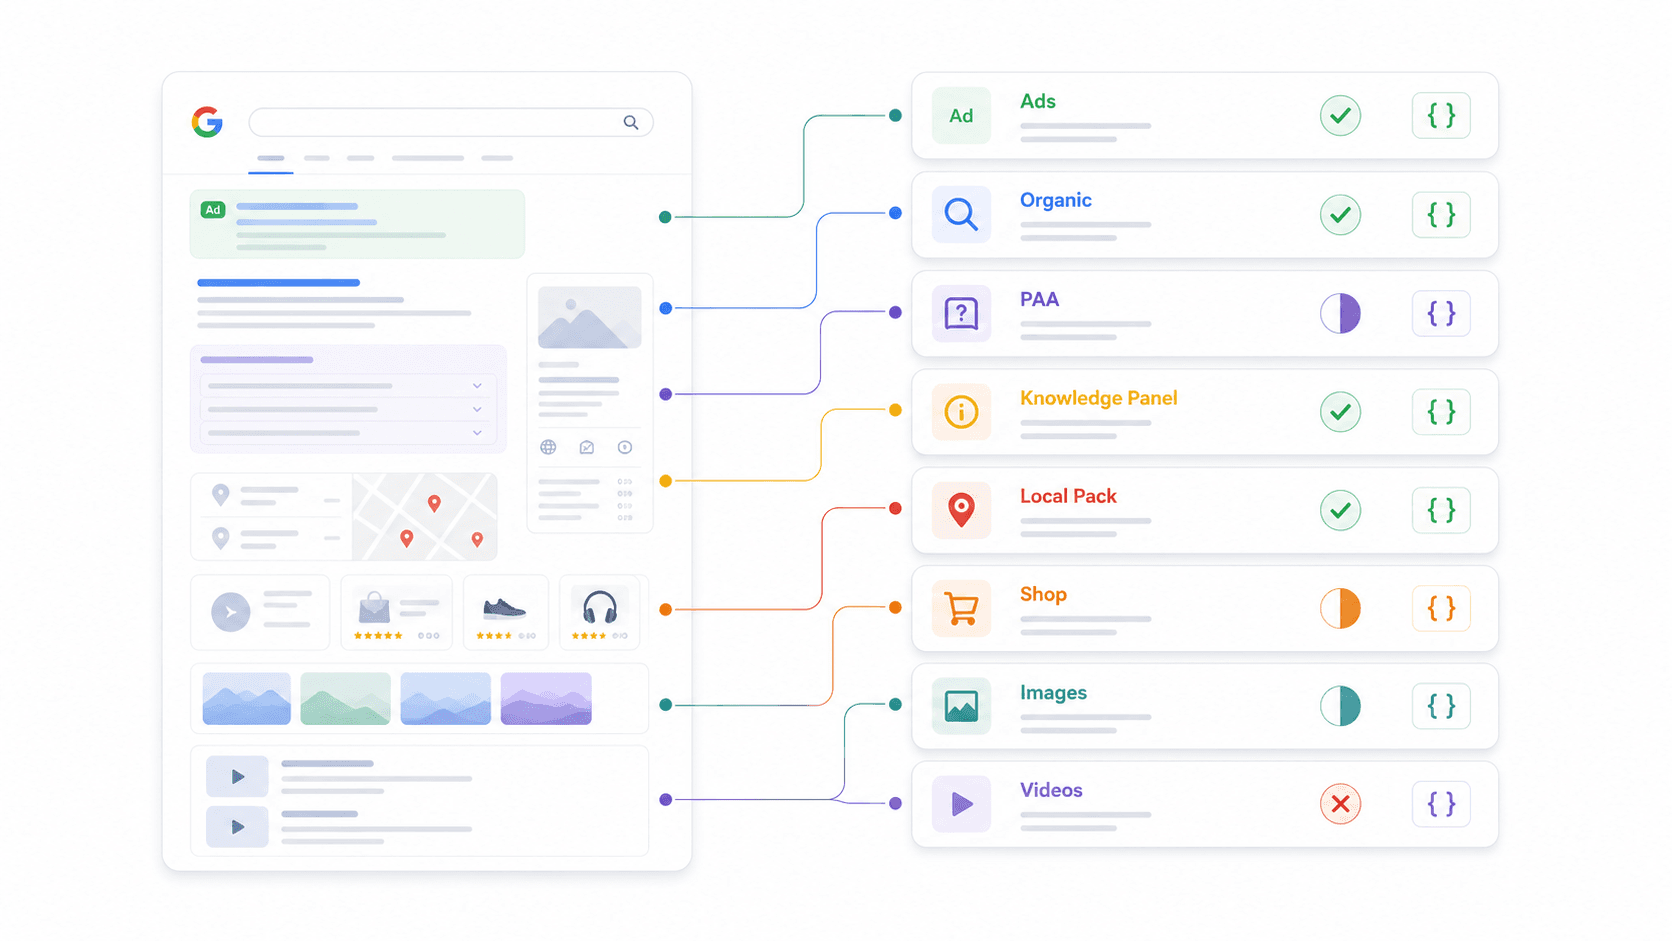
| SERP-funktion | Thunderbit | SerpApi | Serper | Scrapingdog | DataForSEO | Bright Data | ScraperAPI | Apify |
|---|---|---|---|---|---|---|---|---|
| Organiska resultat | Anpassat schema | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | Beror på actor |
| People Also Ask | Anpassat schema | ✅ | ✅ | ✅ | ✅ | Delvis | Delvis | Beror på actor |
| Knowledge Panel | Anpassat schema | ✅ | Delvis | Delvis | ✅ | Delvis | Delvis | Beror på actor |
| Local Pack / Maps | Anpassat schema | ✅ | ✅ | Delvis | ✅ | ✅ | Delvis | Beror på actor |
| Shoppingresultat | Anpassat schema | ✅ | ✅ | Delvis | ✅ | ✅ | ✅ | Beror på actor |
| Featured Snippets | Anpassat schema | ✅ | Delvis | ✅ | ✅ | Delvis | Delvis | Beror på actor |
| Annonser (topp/botten) | Anpassat schema | ✅ | Delvis | ✅ | ✅ | Delvis | Delvis | Beror på actor |
| Bildpaket | Anpassat schema | ✅ | ✅ | ✅ | ✅ | Delvis | Delvis | Beror på actor |
| Videorresultat | Anpassat schema | ✅ | ✅ | Delvis | ✅ | Delvis | Delvis | Beror på actor |
Vad “Anpassat schema” betyder för Thunderbit: I stället för att fördefiniera vilka SERP-funktioner som parsas definierar du själv ett JSON Schema för att extrahera exakt de fält du behöver. Vill du ha PAA-frågor plus svarssammanfattningar plus signaler för kommersiell intention? Definiera schemat och AI levererar det. Den här flexibiliteten är anledningen till att Thunderbit fungerar över alla sökmotorer—not bara Google.
Varför det här spelar roll för ditt arbetsflöde: Om du behöver PAA-data för content strategy, verifiera att leverantören faktiskt parsar det. Om du spårar shoppingannonser för e-handel, bekräfta att strukturerade shoppingfält finns. Anta inte att “strukturerad JSON” betyder full täckning.
Verklig kostnad i skala: pris per fråga-jämförelse
Listpriser på webbplatser berättar inte hela sanningen. Jag normaliserade allt till kostnad per 1 000 lyckade frågor vid tre volymnivåer.
| Leverantör | Kostnad för 1K frågor | Kostnad för 10K frågor | Kostnad för 100K frågor | Pay-as-you-go? | Gratisnivå |
|---|---|---|---|---|---|
| Thunderbit (Distill) | ~0,80–3,20 USD | ~8–32 USD | ~80–320 USD | Kreditpaket | Gratis krediter |
| Thunderbit (Extract) | ~16–64 USD | ~160–640 USD | ~1 600–6 400 USD | Kreditpaket | Gratis krediter |
| SerpApi | 25 USD (Starter) | ~150 USD (Developer) | ~917 USD (Big Data) | Nej (abonnemang) | 250/månad |
| Serper | ~1 USD | ~10 USD | ~75–100 USD | Ja | 2 500 frågor |
| Scrapingdog | ~1 USD | ~10 USD eller mindre | Kan sjunka långt under 10 USD | Plan/kredit | 200 krediter/månad |
| DataForSEO | ~0,60–2 USD | ~6–20 USD | ~60–200 USD | Ja | Testkrediter |
| Bright Data | ~0,50–5+ USD | Offertbaserat | Bäst vid enterprise-volym | Ja/plan | Gratisnivå (5 000 krediter/mån) |
| ScraperAPI | Kreditberoende | Kreditberoende | Kreditberoende | Plan/kredit | 5 000 testkrediter |
| Apify | ~3 USD (liten skala) | Beror på actor | Beror på actor | Plattformskrediter | Månatliga gratiskrediter |
Dolda kostnader att hålla koll på:
- Serpers möjliga 2-kreditavgift för fler än 10 resultat per fråga.
- DataForSEO:s prisskillnader mellan standard och live/högprioritetslägen.
- ScraperAPI:s kreditmultiplikatorer för SERP jämfört med vanlig scraping.
- Bright Datas minimiåtaganden för enterprise.
Värde i varje nivå:
- Sidoprojekt (50 USD/månad): Serper eller Scrapingdog för fast Google SERP JSON.
- Växande team (10K–50K frågor/månad): Serper, Scrapingdog eller DataForSEO beroende på parseringsdjup.
- Enterprise (100K+ frågor/månad): DataForSEO, Bright Data eller SerpApi Big Data.
- AI-first extraktion: Thunderbit, eftersom schemat matchar din nedströms agents förväntningar utan efterbearbetning.
Bästa SERP API för AI-agenter och LLM-flöden 2026
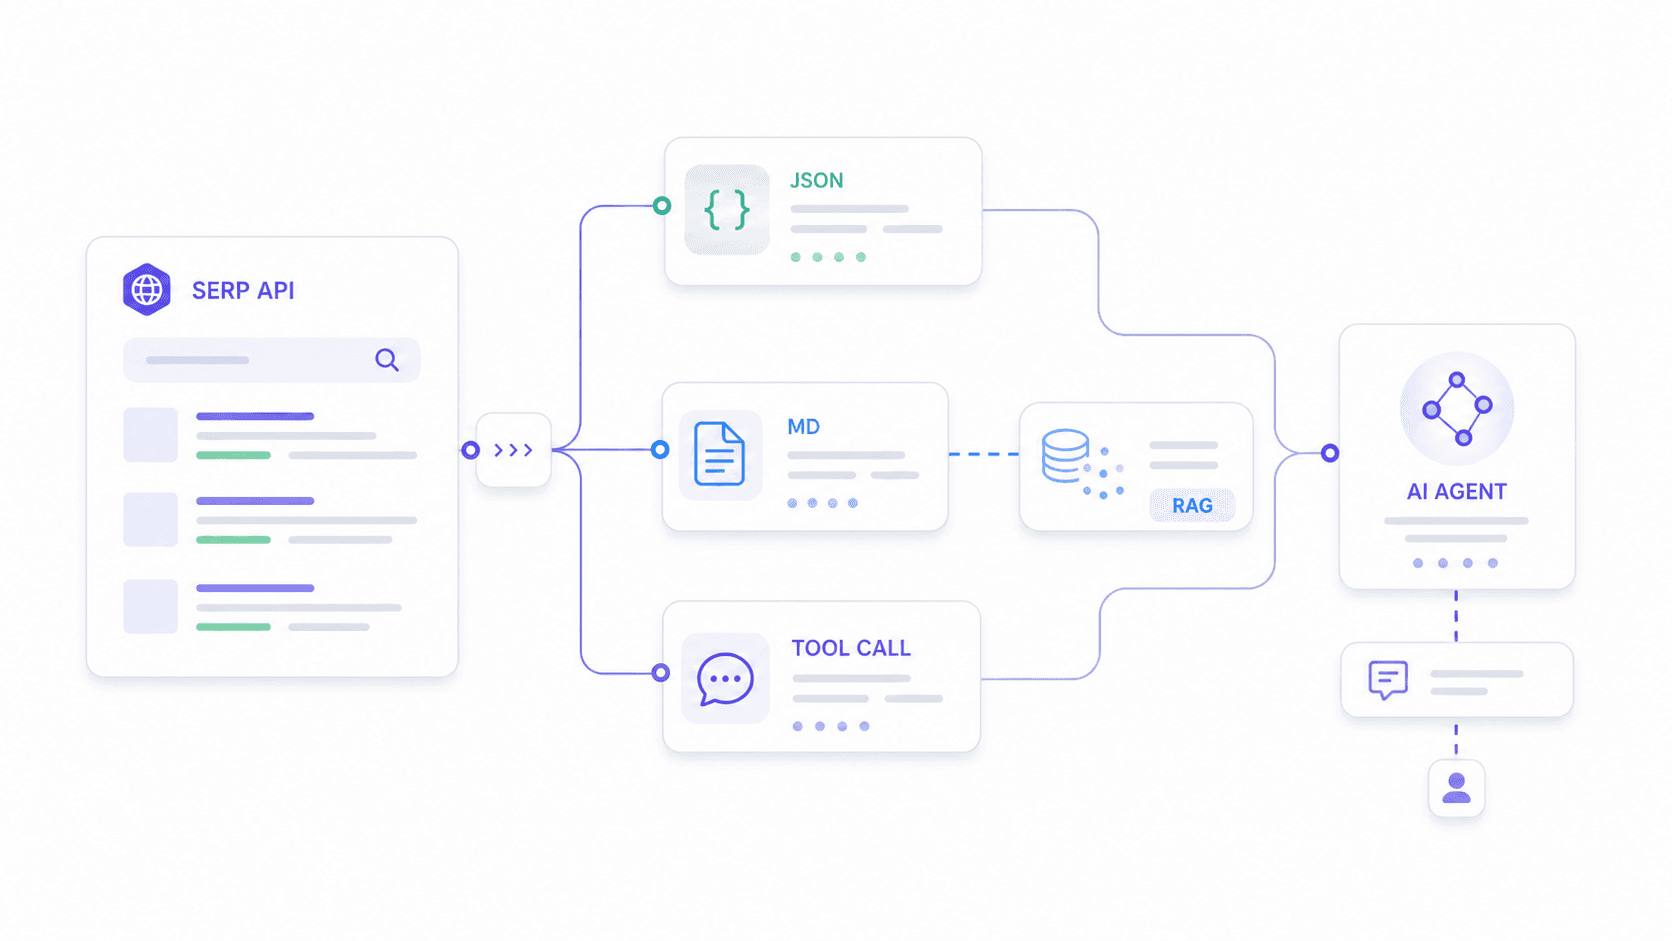
Det här är användningsfallet som ingen annan täcker särskilt bra. Jag hittade åtminstone tre Reddit-trådar där användare beskriver hur de försöker integrera SERP API:er med n8n-flöden och AI-agenter, och en av dem skrev rakt ut att de “inte har lyckats få det att fungera ordentligt med en AI-agent.”
AI-agenter behöver andra saker än rankningsdashboards. De behöver:
- Schemastabil JSON som inte går sönder i parseringen när en leverantör ändrar sitt outputformat.
- Anpassade outputfält som matchar vad nedströmsmodellen förväntar sig—inte en generell dump av allt.
- Ren Markdown eller text för RAG-embedding-pipelines.
- Tillräckligt låg latens för realtidsanrop av verktyg.
Hur varje leverantör passar in i en AI-agentstack
| Leverantör | Passform för AI-agent | Varför |
|---|---|---|
| Thunderbit | Utmärkt | Anpassat JSON Schema (Extract API) + Markdown för RAG (Distill API). Mest flexibel för agentspecifik extraktion. |
| Serper | Mycket bra | Snabb, ren JSON, populär i n8n/LangChain-communityn. Enkel och billig för grundläggande sökverktygsanrop. |
| SerpApi | Bra | Stabilt schema, utmärkt dokumentation. Fungerar bra när agenter behöver Google-vertikaler (Maps, Scholar, Shopping). |
| DataForSEO | Bra | Bäst när agenten ingår i en större SEO-datapipeline. |
| Scrapingdog | Bra | Snabb och billig; schemat är stabilt för Google SERP. |
| Bright Data | Bra | Insamling av färsk data i enterprise-skala över motorer och regioner. |
| ScraperAPI | Medel | Bättre när agenten också behöver generell webbcrawling. |
| Apify | Medel till bra | Flexibel men långsammare; bättre för schemalagda batchflöden. |
Praktiskt exempel med Thunderbit: Tänk dig att din AI-agent ska analysera sökintention för “bästa CRM för fastighetsmäklare”. Du definierar ett schema som begär organiska resultat (titel, URL, snippet, position), People Also Ask-frågor med svarssammanfattningar och en klassificering av kommersiell intention. Thunderbits Extract API returnerar exakt den strukturen—varken mer eller mindre. Din agent slösar inte tokens på att tolka irrelevanta fält eller rensa HTML-bilagor.
För RAG-pipelines omvandlar Thunderbits Distill API SERP-sidan till ren Markdown som är redo för embedding. De flesta dedikerade SERP API:er returnerar fasta JSON-scheman; Thunderbits angreppssätt låter utvecklare anpassa output efter vad nedströmsmodellen faktiskt förväntar sig.
Beslutsmatris per användningsfall: om du behöver X, välj Y
Forumanvändare frågar hela tiden efter konkreta rekommendationer kopplade till deras faktiska arbetsflöden—not allmänna “det beror på”-svar. Så jag byggde den här.
| Ditt användningsfall | Bästa val | Tvåa | Varför |
|---|---|---|---|
| SEO rank tracking (hög volym) | DataForSEO | Scrapingdog | SEO-nativa endpoints, bulkprissättning, omfattande parsering |
| Google Maps / lokala företagsdata | SerpApi | Bright Data | Mogen Maps-endpoint; Bright Data passar lokal scraping i enterprise-skala |
| AI-agent / n8n-automation | Thunderbit | Serper | Anpassat schema + Markdown för RAG; Serper är snabb och billig för enkla anrop |
| Budget-MVP / sidoprojekt (<50 USD/mån) | Serper | Scrapingdog | Generösa gratisnivåer, pay-as-you-go, minimal uppsättning |
| Flera sökmotorer (Bing, Yandex, DuckDuckGo) | Thunderbit | DataForSEO | Thunderbit fungerar på vilken sökmotor som helst via AI-extraktion; DataForSEO har multi-engine-endpoints |
| Google Reviews-aggregering | SerpApi | DataForSEO | Dedikerade endpoints för recensioner |
| E-handel / shoppingövervakning | SerpApi | DataForSEO | Stark täckning för Google Shopping och strukturerade fält |
| Anpassade scrapingflöden | Apify | ScraperAPI | Actor-flexibilitet; ScraperAPI är enkel för generell scraping + SERP |
Snabb persona-guide:
- SEO-team: Börja med DataForSEO om du bygger dashboards; använd SerpApi om täckning för Google-vertikaler och dokumentation väger tyngre än pris.
- Säljteam: Använd Thunderbit när arbetsflödet spänner över SERP:ar, katalogsidor och enrichment; använd Serper för enkla lead discovery-frågor.
- AI-verktygsutvecklare: Thunderbit för anpassade scheman/RAG, Serper för billig snabb sökning, SerpApi för robusta Google-vertikaler.
- Ensamföretagare: Börja med gratisnivåerna hos Serper, Scrapingdog, SerpApi och Thunderbit. Kör samma 20 produktionslika frågor innan du binder dig.
Jämförelse av rate limits, tillförlitlighet och produktionsberedskap
Jag önskar att det här avsnittet hade funnits när jag först utvärderade leverantörer för produktionsflöden. Team som skalar till tusentals frågor per dag behöver förutsägbara rate limits, automatiska retries och upptidsgarantier—och ingen annan jämförelseartikel går igenom detta systematiskt.
| Leverantör | Rate limit | Samtidiga förfrågningar | Retry vid fel | SLA / upptid |
|---|---|---|---|---|
| Thunderbit Free | 600 enheter, engångs | 2 | Inbyggt (anti-bot, CAPTCHA) | — |
| Thunderbit Starter | 60 000 enheter/mån | 30 | Inbyggt | — |
| Thunderbit Pro | 600 000 enheter/mån | 50 | Inbyggt | — |
| SerpApi | Planbaserat (sökningar/timme) | Planbaserat | Leverantören hanterar proxy/CAPTCHA | 99,95 % SLA |
| Serper | Konto-/planbaserat | Ej allmänt publicerat | Manuell klient-retry rekommenderas | Ingen offentlig SLA |
| Scrapingdog | Planbaserat | Kontrollera planvillkor | Anti-blockering hanteras | Inte alltid offentligt |
| DataForSEO | Dokumenterat per endpoint/läge | Varierar beroende på läge | Async stödjer polling/retry | Enterprise-support |
| Bright Data | Dokumenterat, skala upp gradvis | Enterprise-skala | Inbyggd unblockning | Enterprise-SLA |
| ScraperAPI | Planbaserad samtidighet | Kreditberoende | Hanterar retries/proxy | Betalda supportalternativ |
| Apify | Beror på actor/minne/compute | Plattformbegränsningar | Konfiguration på actor-nivå | Plattformens tillförlitlighet |
Checklista inför produktion innan du bestämmer dig:
- Fråga om leverantören debiterar för misslyckade eller blockerade förfrågningar.
- Bekräfta exakt samtidighet, anrop per minut och burst-beteende.
- Kontrollera om geostyrning, mobil vs. desktop och JS-rendering påverkar kreditförbrukningen.
- Spara exempel-JSON för 20–50 riktiga frågor och jämför fältnamn över flera dagar för att verifiera schemastabilitet.
- Lägg till klient-side retries och timeout-budgetar om SERP-data är affärskritiskt.
Sammanfattning i ögonkast: alla 8 SERP API:er jämförda
| Leverantör | Snitt-hastighet | Kostnad per 1K | Gratisnivå | Parseringstäckning | AI-passform | Multi-engine | Slutsats |
|---|---|---|---|---|---|---|---|
| Thunderbit | Medel (AI-extraktion) | Låg (Distill) till premium (Extract) | Ja | Anpassad (valfri funktion) | Utmärkt | Utmärkt | Bäst för AI-nativ anpassad SERP-extraktion och RAG |
| SerpApi | ~5,5 s | Premium | 250/månad | Utmärkt (fast) | Bra | Breda Google-vertikaler | Bästa mogna Google-täckningen |
| Serper | ~2–3 s | Mycket låg | 2 500 frågor | Bra | Mycket bra | Främst Google | Bästa billiga snabba API:et för AI/MVP |
| Scrapingdog | ~1,25 s | Mycket låg i skala | 200 krediter/månad | Bra | Bra | Kontrollera motorer | Bästa kombon av hastighet och kostnad |
| DataForSEO | Medel–långsam (standard) | Låg–måttlig | Testkrediter | Utmärkt | Bra | Utmärkt | Bästa infrastrukturen för SEO-plattformar |
| Bright Data | ~2–5,5 s | Enterprise | Gratisnivå (5 000/mån) | Bra (beror på produkt) | Bra | Utmärkt | Bäst för insamling i enterprise-skala |
| ScraperAPI | ~33 s | Kreditberoende | 5 000 test | Måttlig | Måttlig | Google-endpoints | Bäst om SERP är en del av bredare scraping |
| Apify | ~8 s | Beror på actor | Månatliga krediter | Beror på actor | Måttlig–bra | Beror på actor | Bäst för anpassade automationsflöden |
Hur Thunderbit passar in i ditt SERP-flöde
Lite mer kontext om varför vårt team byggde Thunderbits API på det sätt vi gjorde. Den traditionella SERP API-modellen—fasta endpoints, fördefinierade outputfält, endast Google—fungerar bra för enkel rank tracking. Men så fort du behöver något lite annorlunda (PAA-svar med sentiment, local pack-resultat med antal recensioner, eller shoppingdata formaterad för ett visst databasschema) sitter du fast med efterbearbetning eller leverantörsbyte.
Thunderbits Extract API vänder på modellen. Du berättar vad du vill ha via ett JSON Schema, och AI:n räknar ut hur det ska hämtas från vilken söksida du än pekar på. Google i dag, Bing i morgon, en nischad vertikal sökmotor nästa vecka—samma API, samma arbetssätt.
Distill API löser ett annat problem: att omvandla röriga SERP-sidor till ren Markdown som LLM:er faktiskt kan konsumera utan att fastna i HTML-rester, navigationselement och spårningsskript. Om du bygger en RAG-pipeline som behöver färsk sökbevisning är det här den snabbaste vägen från “live SERP” till “embeddat innehåll.”
Båda endpoints inkluderar anti-bot-hantering, CAPTCHA-lösning och JS-rendering direkt. Du betalar inte extra för det—det ingår i kreditkostnaden.
Testa Thunderbit Chrome-tillägget
Prova själv: Thunderbit Chrome Extension för webbläsarbaserad extraktion, eller anropa API:t direkt för programmatisk användning. Vår YouTube-kanal har genomgångar om du vill se det i praktiken innan du börjar koda.
En notis om laglighet
Det här kommer upp i varje FAQ, så här är den korta versionen: lagligheten kring SERP-skrapning beror på omständigheter och jurisdiktion. Fallet hiQ v. LinkedIn slog fast att skrapning av offentligt tillgänglig data inte nödvändigtvis är ett dataintrångsbrott, men det ger inte generellt tillstånd. Google har stämts SerpApi över SERP-skrapning, vilket signalerar ett aktivt kommersiellt tryck kring åtkomst.
Praktiskt råd: använd leverantörernas API:er enligt deras villkor, undvik att samla in personuppgifter om det inte är nödvändigt, och fråga leverantörerna hur de hanterar compliance. Anta inte att SERP-skrapning är riskfri.
Slutsats
Ingen enskild leverantör vinner på alla områden—rätt val beror på ditt användningsfall, din budget och din tekniska stack. Efter att ha normaliserat priser, testat hastighet, kartlagt parseringstäckning och utvärderat AI-agent-anpassning är mitt beslutsramverk detta:
- Behöver du flexibilitet + AI-agent-kompatibilitet? → Thunderbit
- Behöver du bred täckning av Google-produkter? → SerpApi
- Behöver du hastighet + lägsta kostnad? → Serper eller Scrapingdog
- Bygger du en SEO-plattform? → DataForSEO
- Enterprise-skala med SLA? → Bright Data eller DataForSEO
- Allmän scraping + tillfälliga SERP:ar? → ScraperAPI eller Apify
Börja med gratisnivåerna. Kör 20–50 riktiga frågor som matchar din produktionsarbetsbelastning. Jämför JSON-svaren. Kontrollera den faktiska kostnaden efter krediter och multiplikatorer. Bestäm dig sedan.
Priser ändras ofta på den här marknaden—den här jämförelsen normaliserades utifrån aktuella offentliga sidor i maj 2026. Om du läser detta månader senare bör du kontrollera igen innan du köper.
För mer om AI-webbskrapning och hur den skiljer sig från traditionella metoder har vi skrivit utförligt om ämnet. Och om du utvärderar webbskrapning utan kod klarar Thunderbits Chrome-tillägg även den delen.
FAQ
1. Vad är en SERP API och vem behöver en?
En SERP API är en tjänst som skickar sökfrågor till motorer som Google, Bing eller Yandex och returnerar resultaten som strukturerad data (vanligtvis JSON). SEO-proffs använder dem för rank tracking, säljteam för lead discovery, e-handels-team för prisövervakning och AI-utvecklare för att mata live sökdata till agenter och RAG-pipelines.
2. Vad kostar det att skrapa 1 000 Google-sökresultat via API?
Det varierar mycket—från cirka 0,60 USD per 1K (DataForSEO på standardnivå) till cirka 25 USD per 1K (SerpApi Starter-plan). Volymrabatter skiljer sig dramatiskt mellan leverantörer. Normalisera alltid till kostnad per 1 000 lyckade frågor i stället för att jämföra listpriser.
3. Kan jag använda en SERP API med AI-agenter som LangChain eller n8n?
Ja. Serper är populär i n8n-communityn för enkla sökanrop. Thunderbit är starkast när din agent behöver anpassade JSON-scheman eller Markdown för RAG. SerpApi fungerar bra för agenter som behöver stabil Google-vertikaldata (Maps, Scholar, Shopping).
4. Vilken SERP API har bäst gratisnivå för testning?
Serper erbjuder 2 500 gratis frågor vid registrering—generösast sett till volym. SerpApi ger 250/månad, Scrapingdog erbjuder 200 krediter/månad, ScraperAPI tillhandahåller 5 000 testkrediter (7 dagar), och Thunderbit inkluderar gratis krediter för prototypande. Apify har månatliga plattformskrediter värda cirka 5 USD.
5. Vilka SERP-funktioner bör jag kontrollera att en leverantör parsar innan köp?
Anta inte att “strukturerad JSON” betyder full täckning. Verifiera om API:t returnerar strukturerade fält för: People Also Ask, Knowledge Panel, Local Pack/Maps, Shoppingresultat, Featured Snippets, annonser (topp och botten), bildpaket och videorresultat. Använd parseringsmatrisen i den här artikeln som en startchecklista och testa med riktiga frågor innan du binder dig till en plan.
Testa Thunderbit för AI-webbskrapning Get Started Free
Läs mer



