
Google News hämtar innehåll från över 50 000 källor världen över, vilket gör tjänsten till en av nätets rikaste realtidskällor för nyheter. Men det är en sak som sällan sägs rakt ut: Google lade ner sitt officiella News API redan 2011 och har aldrig ersatt det.
Det sätter PR-team som bevakar varumärkesomnämnanden, säljteam som följer branschsignaler och analytiker som bygger dashboards för konkurrensbevakning i en knepig sits. Du behöver strukturerad nyhetsdata — rubriker, källor, datum, artikeltext — men Google försvårar automatiserad scraping med CAPTCHA, hastighetsbegränsning och ständigt förändrade sidlayouter. Jag har lagt år på att bygga och testa verktyg för datautvinning på Thunderbit, och jag kan säga att gapet mellan "jag kan väl bara skrapa Google News snabbt" och att faktiskt få fram tillförlitlig, strukturerad data är mycket större än de flesta tror.
I den här guiden går vi igenom de 10 bästa Google News-scraprarna jag hittat inom API:er, no-code-verktyg och gratisnivåer — med raka prisjämförelser, genomgång av anti-bot-skydd och den typ av detaljnivå på fältnivå som faktiskt hjälper dig välja rätt verktyg.
Prova Thunderbit för Google News-scraping
Varför Google News är svårt att skrapa (och varför det inte finns något officiellt API)
Google avvecklade sitt News API 2011. Sedan dess är alla verktyg som kallar sig "Google News API" i praktiken tredjepartslösningar — de skrapar eller proxar Google News-resultat åt dig. Det närmaste officiella programmatiska alternativet är Custom Search JSON API, som ger 100 gratisfrågor per dag och kostar 5 USD per 1 000 frågor. Men det kräver att du sätter upp en egen sökmotor och är inte en direkt ersättning för Google News.
Samtidigt är Googles anti-scraping-försvar rätt tufft:
- IP-baserad hastighetsbegränsning: Kör du för många förfrågningar mot Google News för snabbt får du 429-fel eller CAPTCHA-utmaningar.
- Samtyckes- och mellanliggande sidor: Beroende på var du befinner dig kan Google visa cookie-samtycke som stoppar många parsers.
- JavaScript-renderat innehåll: Mycket av Google News laddas dynamiskt, så enkla HTTP-förfrågningar ger ofullständig HTML.
- Omdirigeringslindade länkar: Google News-länkar går ofta via Googles egen omdirigeringslager innan de når publicistens sida.
- Layoutförändringar: Google ändrar regelbundet hur nyhetskort, story-kluster och ämnessektioner är uppbyggda.
I mars 2025 gick Google dessutom helt över till automatiskt genererade publikationsidor, vilket gör plattformen ännu mer dynamisk. Trådar i communityn på GitHub och Stack Overflow är fulla av utvecklare som delar workarounds för samtyckessidor, trasiga selectors och ändrade URL-format.
Så varför skrapar folk det ändå? För att miljarder sökningar görs på Google varje dag, och 15 % av dem är frågor som Google aldrig sett tidigare. För varumärkesbevakning, trendanalys, identifiering av leadsignaler och konkurrensanalys är Google News fortfarande en av de bredaste och mest flexibla nyhetskällorna som finns.
RSS vs. API vs. no-code scraping: välj rätt metod
Alla Google News-scraprar fungerar inte på samma sätt. Innan du väljer verktyg är det bra att förstå de tre huvudspåren — och när varje metod passar bäst.
| Tillvägagångssätt | Passar bäst för | Begränsningar | Exempel på verktyg |
|---|---|---|---|
| Google News RSS-flöden | Enkel bevakning av rubriker, gratis, låg volym | Ingen fulltext, max cirka 100 resultat, begränsad filtrering | Inbyggda RSS-läsare, n8n |
| SERP-/News-API | Skalbar bevakning av nyckelord, strukturerad metadata | Löpande kostnad, oftast bara rubriker + utdrag | SerpApi, Scrapingdog, Newsdata.io |
| Direkt scraping (no-code) | Full artikeltext, egna datafält, engångsresearch | Kräver hantering av anti-bot-skydd, mindre skalbart än API:er | Thunderbit, Octoparse, Apify |
| Direkt scraping (kod) | Maximal kontroll, egna pipelines | Hög underhållskostnad, CAPTCHA-hantering, går ofta sönder | Scrapy, BeautifulSoup + Selenium |
De flesta jämförelseartiklar fokuserar bara på API:er och Python-bibliotek. Men den användarintention jag ser säger något annat: en stor andel av dem som söker efter "bästa Google News-scraprar" är inte utvecklare — det är PR-chefer, verksamhetsansvariga och säljteam som vill ha en lösning med klick, inte ett kodprojekt. Därför finns både webbläsartillägg och no-code-plattformar med i den här listan, sida vid sida med de stora API-aktörerna.
Värt att notera: Google News RSS-flöden är fortfarande gratis och användbara för lättare rubrikbevakning. Du kan prenumerera på ett ämnes- eller nyckelordsflöde och få cirka 100 resultat med titlar, länkar och publiceringsdatum. Men om du behöver full artikeltext, författarnamn, sentiment eller fler än hundra resultat behöver du ett av verktygen nedan.
Så utvärderade vi de bästa Google News-scraprarna
Jag använde samma kriterier för varje verktyg i listan:
- Användarvänlighet: no-code, kodkrävande eller enbart API
- Anti-bot-/CAPTCHA-hantering: avgörande för Google
- Extraherade datafält: rubrik, källa, datum, utdrag, URL, full artikeltext, författare, bilder, sentiment
- Tillgänglighet och begränsningar i gratisnivå
- Normaliserad kostnad per 1 000 förfrågningar: eftersom varje leverantör prissätter olika (per månad, per kredit, per förfrågan) standardiserade jag till kostnad per 1 000 lyckade resultat på lägsta betalda nivå
- Exportformat: JSON, CSV, Google Sheets, Airtable, Notion med mera
- Skalbarhet: dagliga volymgränser, hastighetsgränser, samtidighet
- Bäst lämpade användningsfall
Prisnormalisering spelar större roll än man tror. Ett verktyg tar betalt per "sökning" (som ger 10 resultat), ett annat per "kredit" (där 1 kredit = 1 rad), och ett tredje per "förfrågan" (där JavaScript-rendering kostar extra). Utan normalisering jämför du äpplen med orangutanger.
De 10 bästa Google News-scraprarna i korthet
Här är huvudjämförelsetabellen. Jag går djupare på varje verktyg längre ner, men den här ska hjälpa dig att snabbt snäva in alternativen.
| Verktyg | Typ | Gratisnivå | Ca kostnad per 1K resultat | Anti-bot-hantering | Full artikelutvinning | Exportformat | Bäst för |
|---|---|---|---|---|---|---|---|
| Thunderbit | Chrome-tillägg / AI no-code | Gratisnivå (6 sidor) | ~$6–$30 per 1K rader (beroende på plan) | Webbläsarläge (din session) + molnläge | Ja (utvinning av undersidor) | Excel, CSV, Sheets, Airtable, Notion, JSON | Icke-tekniska användare, affärsteam |
| SerpApi | SERP API | 250 sökningar/mån | ~$5–$15 per 1K resultat | SERP-specifik anti-detektion | Nej (rubriker + utdrag) | JSON | Utvecklare, strukturerade API-pipelines |
| ScraperAPI | Generell scraping-API | 5 000 krediter (7-dagars test) | ~$0.10–$0.49 per 1K förfrågningar | Proxyrotation, JS-rendering | Ingen dedikerad parser | JSON, HTML | Budgetutvecklare, generell scraping |
| Apify | Molnbaserad scrapingplattform | Gratisplan ($5/mån i kredit) | Varierar beroende på actor/beräkning | JS-rendering, headless browser | Beror på actor | JSON, CSV, Excel, API | Tekniska team, färdiga arbetsflöden |
| Bright Data | Enterprise-scraper/dataset | 5 000 krediter/mån gratis | ~$1.30–$2.50 per 1K poster | Proxies, CAPTCHA-lösning, browser rendering | Ja (News Scraper-produkt) | JSON, CSV | Enterprise-pipelines |
| Octoparse | Visuell no-code-plattform | Gratisplan (begränsad) | ~$9–$25 per 1K rader (amorterat) | Molnkörning, antiblockering | Ja (mallen inkluderar brödtext) | CSV, Excel, JSON, databaser | Visuella arbetsflödesbyggare |
| ScrapingBee | Scraping-API | Testkrediter | Varierar (kreditbaserat, JS kostar mer) | Headless Chrome, proxyrotation, CAPTCHA | Ingen dedikerad parser | JSON, HTML | Utvecklare som behöver JS-rendering |
| Oxylabs | SERP-/scraper-API | Upp till 2 000 resultat i test | ~$1.00–$2.35 per 1K resultat | 100M+ proxies, CAPTCHA-lösning | Nej (SERP-data) | JSON | Storskalig, geoanpassad scraping |
| Scrapingdog | Budget-SERP API | 200 gratis krediter | ~$0.20 per 1K förfrågningar | SERP-specifik anti-detektion | Nej (rubriker + utdrag) | JSON | Prispressade utvecklare |
| Newsdata.io | Dedikerat nyhets-API | 200 req/dag | Varierar beroende på plan | Ej tillämpligt (skrapar inte Google direkt) | Ja (premiumplaner) | JSON | Nyhetsspecifika NLP-funktioner |
Några saker sticker ut. Lägst kostnad per förfrågan? Scrapingdog och ScraperAPI. Enklast no-code-setup? Thunderbit och Octoparse. Enterprise-nivå med geoanpassning? Bright Data och Oxylabs.
Nu till de mer detaljerade genomgångarna.
1. Thunderbit — bästa no-code Google News-scrapern för affärsanvändare
 Thunderbit är verktyget vi har byggt på vårt företag, så jag är öppen med det. Men jag ska också vara tydlig med vad det gör och inte gör, eftersom jag tycker att ärlighet är mer värdefullt än hype.
Thunderbit är ett AI-drivet Chrome-tillägg för personer som behöver strukturerad data från webbplatser utan att skriva kod. För Google News ser arbetsflödet ut så här:
- Öppna Google News-sökresultaten i Chrome.
- Klicka på "AI Suggest Fields" — AI:n läser sidan och känner automatiskt igen kolumner som rubrik, källa, datum, utdrag och URL.
- Klicka på "Scrape" för att extrahera strukturerad data till en tabell.
Detta gäller listningssidan. Den verkliga styrkan för nyhetsanvändning kommer sedan: efter att du skrapat Google News-resultaten kan du klicka på "Scrape Subpages" för att besöka varje artikel-URL och extrahera full artikeltext, författare, bilder och mer. Det löser direkt problemet "jag har länkar, men behöver fortfarande crawla och extrahera själva innehållet", vilket dyker upp hela tiden i forum.
Field AI Prompt låter dig lägga till egna AI-instruktioner per kolumn. Till exempel kan du lägga till en kolumn för "Sentiment" med en prompt som "Klassificera den här artikeln som positiv, negativ eller neutral gentemot [varumärke]." Det betyder att du både extraherar data och berikar den i samma körning — något inga rena API-verktyg erbjuder.
Thunderbit stöder både Browser Scraping (körs i din Chrome-session och använder dina cookies och inloggade läge, vilket undviker många bot-detektioner) och Cloud Scraping (hanterar upp till 50 sidor åt gången med inbyggd anti-bot-infrastruktur). Du kan också ställa in schemalagd scraping för återkommande nyhetsbevakning.
Nyckelfunktioner
- AI Suggest Fields känner automatiskt igen kolumner för rubrik, källa, datum och URL
- Utvinning av undersidor för full artikeltext, författare och bilder
- Field AI Prompt för sentimentanalys, översättning eller egen märkning
- Moln- och webbläsarlägen för scraping
- Schemalagd scraping för daglig/veckovis bevakning
- Gratis export till Google Sheets, Airtable, Notion, Excel, CSV, JSON
Pris
- Gratisnivå: 6 sidor
- Gratis test: 10 sidor
- Betalda planer från cirka 9 USD/månad (kreditbaserat, 1 kredit = 1 utgående rad)
- Normaliserad kostnad per 1K rader: ungefär $6–$30 beroende på plan
Bäst för
Säljteam, PR-specialister, operationschefer och alla som behöver strukturerad Google News-data utan att skriva en rad kod. Särskilt starkt när du behöver full artikeltext plus AI-berikade fält som sentiment.
2. SerpApi — bästa strukturerade Google News-API:t för utvecklare
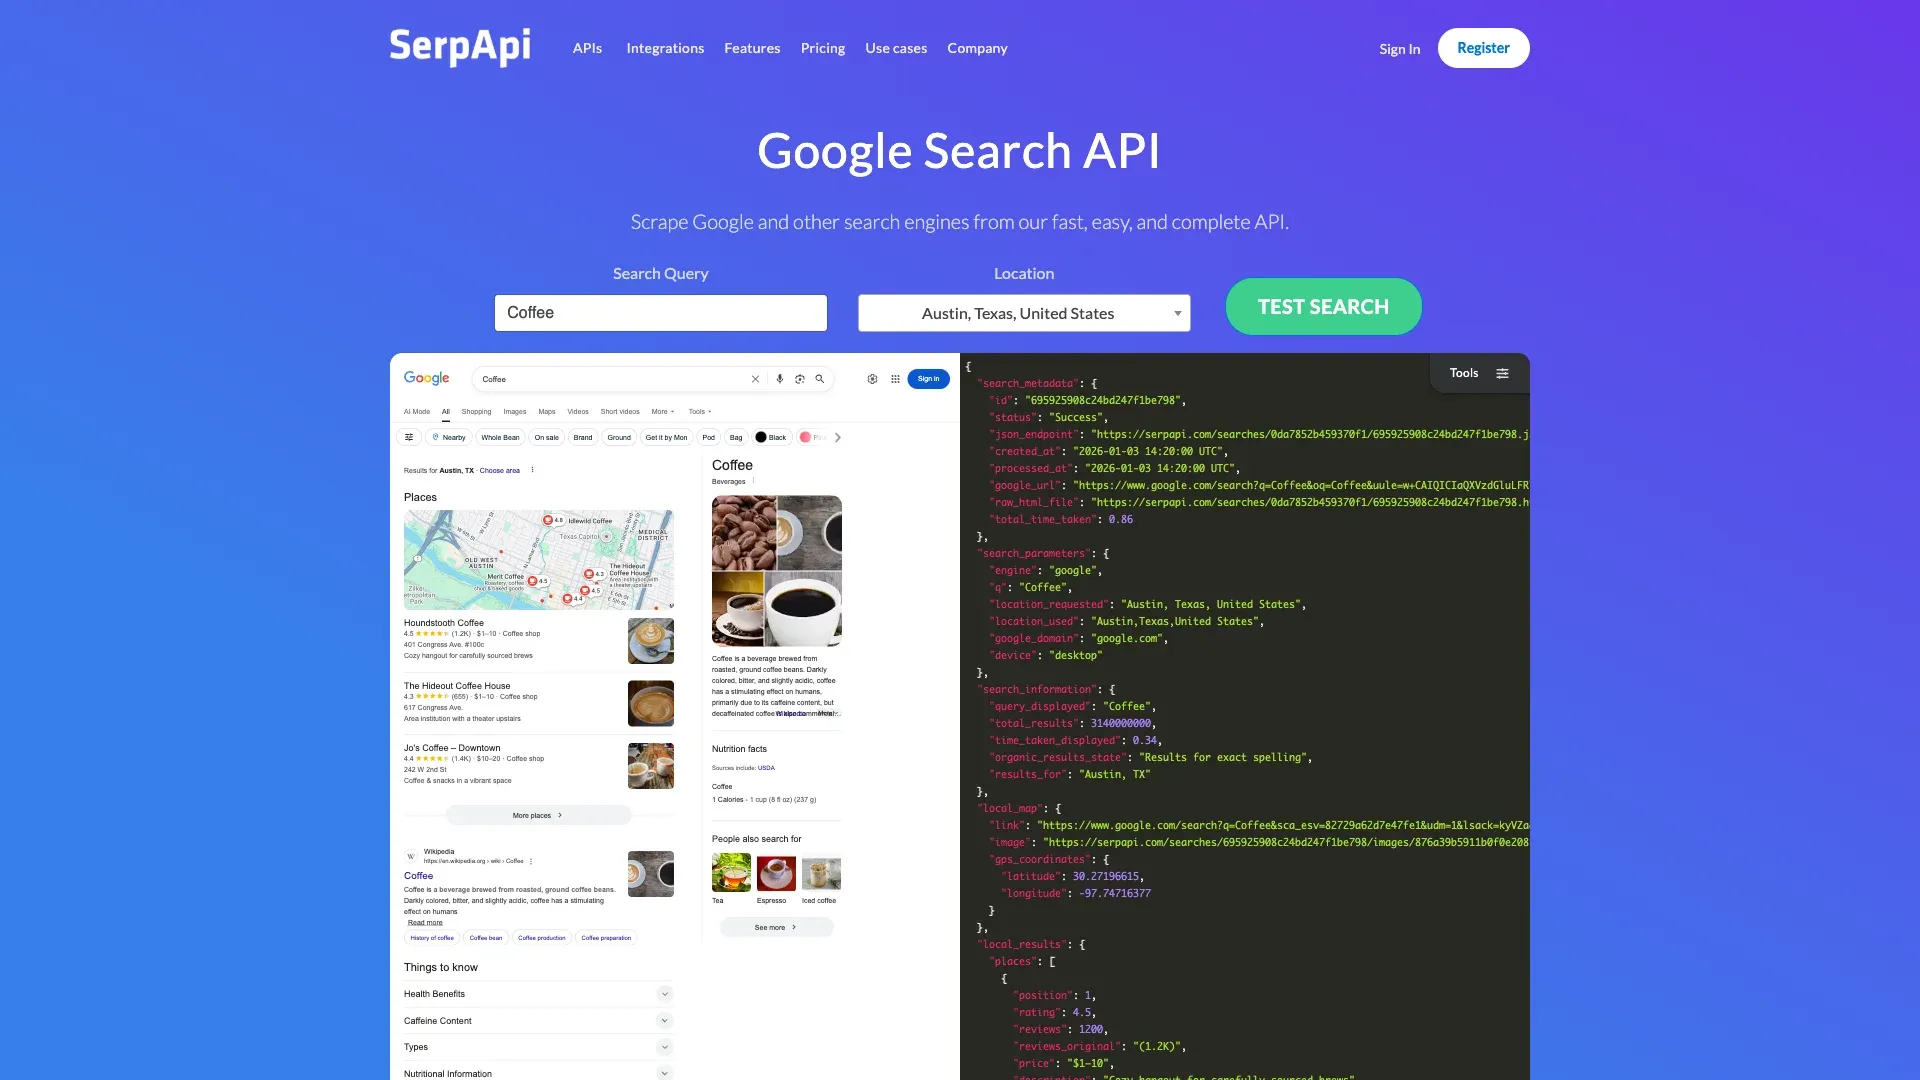 SerpApi är förstahandsvalet om du vill ha ett dedikerat Google News-API som returnerar ren, strukturerad JSON. Det finns två relevanta endpoints: en för
news.google.com (Google News-sidan) och en för nyhetsfliken tbm=nws i vanliga Google Search.
Fältdokumentationen är ovanligt detaljerad — du får title, source, authors, link, thumbnail, topic_token, story_token, related_topics och related_publications. Stöd för story-token och topic-token är faktiskt väldigt användbart för att avduplicera klustrade nyheter, vilket är ett smärtområde som många verktyg hoppar över.
Enligt min erfarenhet är SerpApis svarstid snabb (vanligtvis under 2 sekunder) och drifttiden stabil. Den största begränsningen: det är bara API, så du behöver kod eller en no-code-integration för att använda datan. Ingen full artikeltext — bara rubriker, utdrag och metadata.
Nyckelfunktioner
- Dedikerad sökendpoint för Google News med strukturerad JSON
- Målning mot plats och språk
- Historiska nyhetsfrågor via
tbs-parametern - Stöd för story- och topic-tokens för klustring
Pris
- Gratis: 250 sökningar/månad
- Developer: 75 USD/månad för 5 000 sökningar
- Production: 150 USD/månad för 15 000 sökningar
- Normaliserad kostnad per 1K resultat: cirka $5–$15 (antaget ~10 resultat per sökning)
Bäst för
Utvecklare som bygger automatiserade nyhetsbevakningspipeliner och behöver tillförlitlig, strukturerad SERP-data med bra fältutbud.
3. ScraperAPI — bästa budget-API:t för generell Google News-scraping
 ScraperAPI är en allmän scraping-API — inte ett Google News-specifikt verktyg. Men det är med här eftersom det är ett av de billigaste sätten att nå Google News-sidor i stor skala om du är bekväm med att skriva din egen parser.
ScraperAPI hanterar proxyrotation, JavaScript-rendering och CAPTCHA-lösning bakom ett enkelt REST-API. Du skickar en URL, och får tillbaka den renderade HTML:n. Nackdelen är att det inte finns någon dedikerad parser för Google News, så du måste extrahera fälten själv (eller kombinera med ett parserbibliotek).
Vissa användare rapporterar långsammare svarstider (7–23 sekunder i benchmarktester), och kreditmodellen gör att olika typer av förfrågningar kostar olika mycket. Men för utvecklare som redan kan parsa Google News-HTML är prissättningen svårslagen.
Nyckelfunktioner
- Automatisk proxyrotation och geoanpassning
- JavaScript-rendering
- Kreditbaserad modell (100K krediter i grundplanen)
- 5 000 gratis testkrediter, 7 dagar, inget kort krävs
Pris
- Gratis test: 5 000 krediter (7 dagar)
- Hobby: 49 USD/månad (100 000 krediter)
- Startup: 149 USD/månad (1 000 000 krediter)
- Normaliserad kostnad per 1K förfrågningar: cirka $0.10–$0.49 beroende på plan
Bäst för
Prispressade utvecklare som vill ha ett billigt lager för proxy/rendering och gärna bygger sin egen Google News-parser.
4. Apify — bästa molnplattformen med färdiga Google News-actors
 Apify är en molnbaserad scrapingplattform med en marknadsplats för "Actors" — färdiga scrapers som du kan köra utan kod. Det finns flera community-bidragna Google News Scraper-actors, och plattformen sköter molnkörning, schemaläggning och lagring.
Du kan komma igång snabbt med en färdig actor. Avvägningen är att community-actors varierar i kvalitet och underhåll. Vissa kan gå sönder när Google ändrar layout, och du är beroende av att författaren uppdaterar dem. Apifys egen infrastruktur är stabil, men upplevelsen för just Google News beror på vilken actor du väljer.
Nyckelfunktioner
- Google News-specifika actors i Apify Store
- Schemalagda körningar i molnet
- API- och webhook-integrationer
- Export till JSON, CSV, Excel och via API
Pris
- Gratisplan: 0 USD/månad (5 USD i användningskredit)
- Betalda planer från 29 USD/månad
- Normaliserad kostnad per 1K förfrågningar: varierar beroende på actor och beräkningsförbrukning
Bäst för
Tekniska team som vill ha färdiga scrapingflöden utan att bygga från grunden, och som behöver molnbaserad schemaläggning och API-integrationer




