
Бизнес-мир в 2026 году похож на настоящую золотую лихорадку данных — только вместо кирок и лопат все вооружились API, ИИ и расширениями для Chrome. С каждой командой продаж, операционки и e-commerce, с которой я общаюсь, слышу одно и то же: всем нужны структурированные, актуальные данные, чтобы принимать более умные решения, находить лиды и оставаться впереди конкурентов. Но вот в чем загвоздка: когда вокруг столько компаний по извлечению данных, выбрать подходящую — это почти как пытаться найти лучший пончик в пекарне со ста вкусами. (Спойлер: я всегда беру тот, что с посыпкой, но вашему бизнесу, возможно, нужно что-то посерьезнее… и надежнее.)
В этом материале я разберу 6 ведущих компаний по извлечению данных в 2026 году — у каждой свой подход, сильные стороны и особенности. Неважно, ты маркетолог без технического бэкграунда, разработчик, который строит кастомные пайплайны, или крупная компания с жесткими требованиями к комплаенсу — я помогу сориентироваться в вариантах, сравнить возможности и найти решение, которое подойдет именно твоим задачам.
Почему выбор правильной компании по извлечению данных так важен для бизнеса
Что такое data scraping и как его делать в 2025 году Get Started Free
Будем честны: извлечение данных — это не просто выдернуть цифры с сайта. Речь о том, чтобы заправить бизнес правильным топливом — точной, своевременной и полезной информацией. Компании, которые принимают решения на основе данных, в 23 раза чаще привлекают клиентов, а 70% руководителей считают, что доверенные данные критически важны для их стратегии.
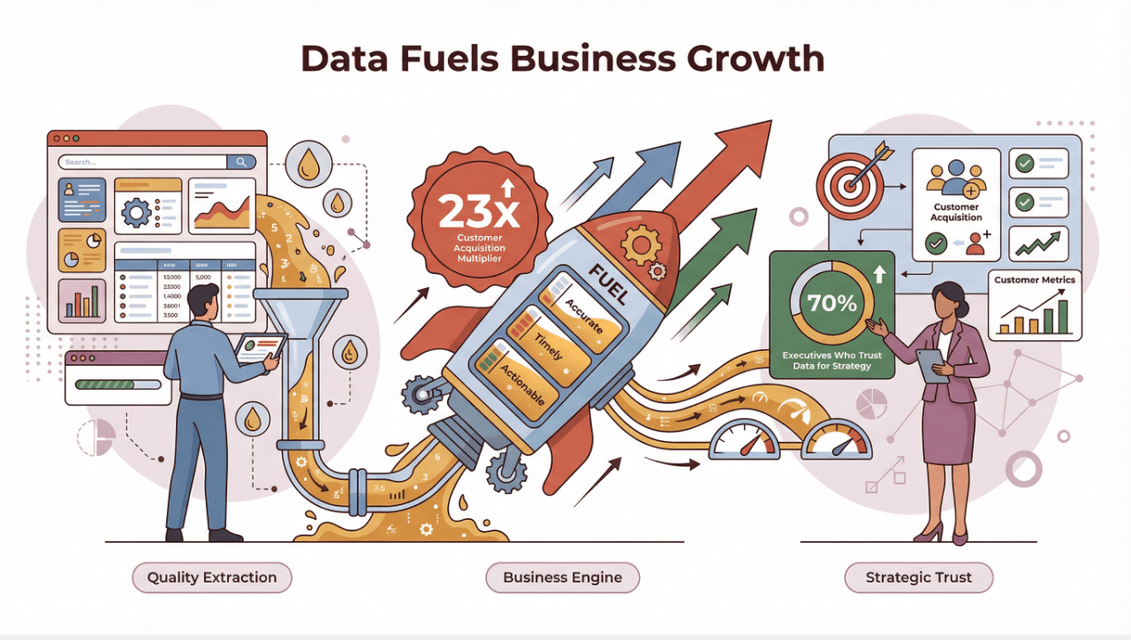 Но есть и обратная сторона: выбери не того поставщика — и рискуешь получить низкое качество данных, проблемы с комплаенсом, пустую трату ресурсов и упущенные возможности. Я видел, как команды неделями разбирали кривые выгрузки или, что еще хуже, попадали на нарушение правил конфиденциальности из-за того, что подрядчик срезал углы. Ставки высоки, и правильный партнер может либо усилить твои data-driven амбиции, либо похоронить их.
Как мы выбирали лучшие компании по извлечению данных
Я не просто кидал дротики в доску (хотя соблазн был). Чтобы попасть в этот список, я смотрел на:
- Точность и качество данных: выдает ли инструмент надежные, структурированные данные — даже с запутанных или динамических сайтов?
- Комплаенс и конфиденциальность: как компания работает с защитой данных, безопасностью и регуляторными требованиями?
- Масштабируемость: справляется ли решение как с разовыми задачами, так и с крупными постоянными проектами?
- Простота использования: рассчитано ли оно на пользователей без кода, разработчиков или на обе категории?
- ИИ и автоматизация: насколько хорошо инструмент работает с неструктурированными данными, PDF, изображениями и сложной версткой?
- Цена и ценность: прозрачна ли стоимость и соответствует ли она набору возможностей?
- Соответствие бизнес-задачам: подходит ли решение SMB, enterprise-сегменту или всем сразу?
Также я изучил отзывы пользователей, экспертные мнения и реальные кейсы, чтобы убедиться, что каждый участник списка заслуживает свое место.
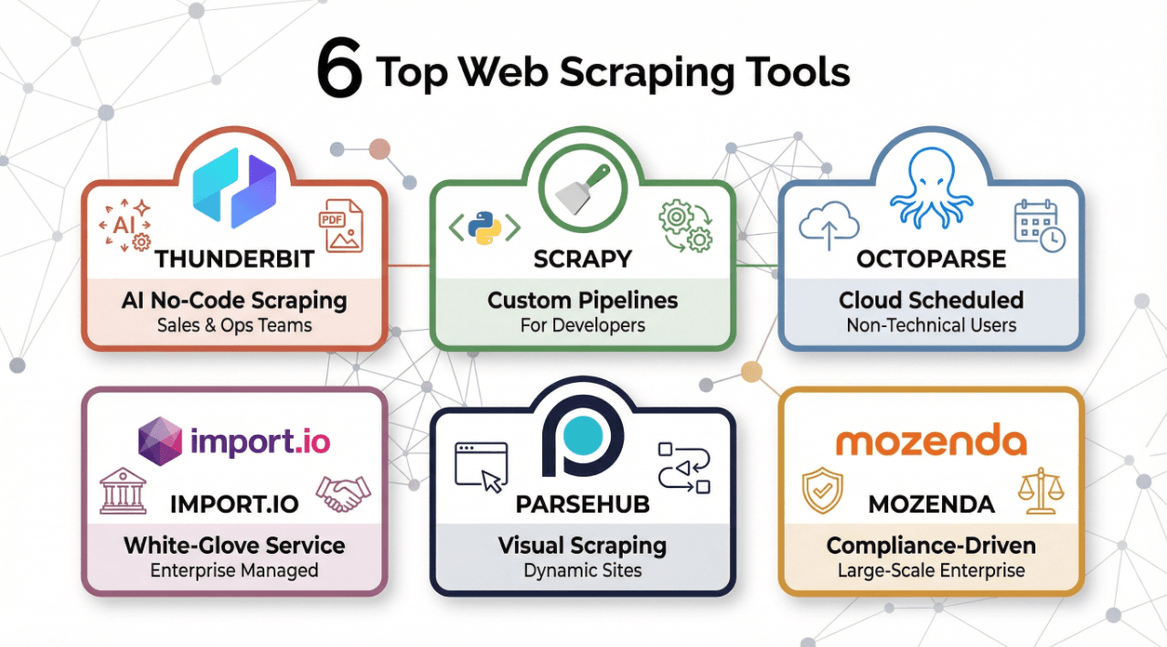
1. Thunderbit
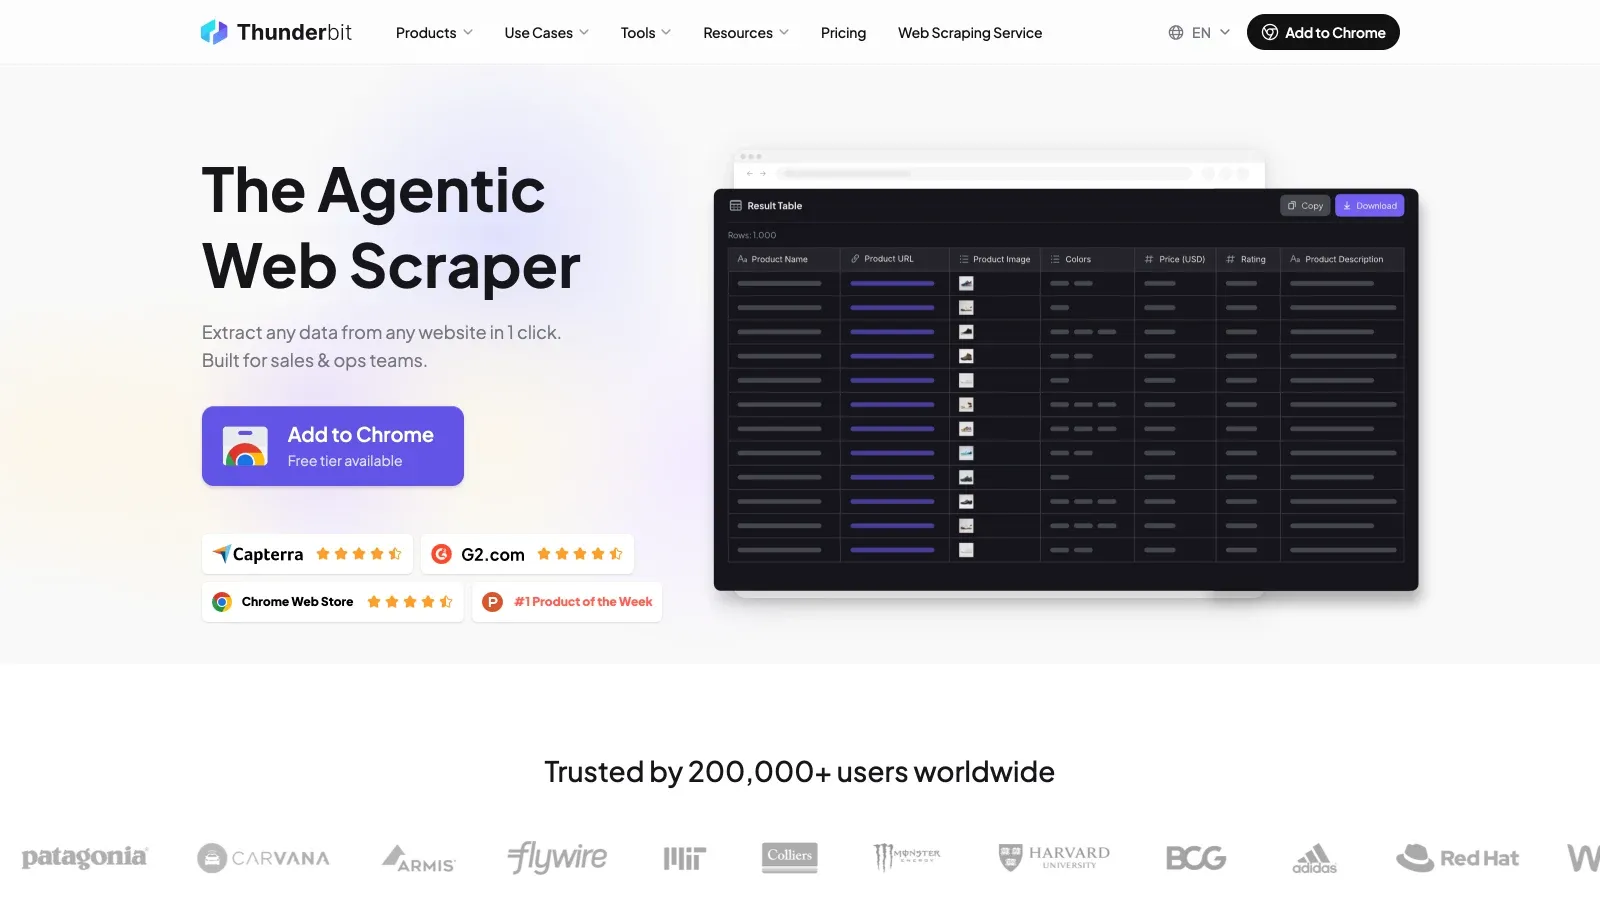
Thunderbit — это AI-powered расширение для Chrome, которое мы с командой создали для бизнес-пользователей, желающих превратить веб в структурированные данные — без единой строчки кода. Да, я предвзят, но послушай: Thunderbit создан для отделов продаж, e-commerce и операционных команд, которым нужны быстрые, точные и практичные данные с любого сайта, PDF или изображения.
Ключевые возможности Thunderbit
- AI Suggest Fields: просто нажми «AI Suggest Fields», и ИИ Thunderbit прочитает страницу, предложит столбцы и даже создаст кастомные подсказки для извлечения. Больше не нужно гадать, какие данные ты получишь.
- Извлечение подстраниц и пагинации: нужно собрать детали со всех карточек товара или пройти по ссылкам на вложенные страницы? ИИ Thunderbit сам перейдет по ним и объединит данные.
- Мгновенные шаблоны: для популярных сайтов вроде Amazon, Zillow или Shopify используй готовые шаблоны для скрейпинга в один клик — без настройки.
- Экспорт на разные платформы: выгружай данные прямо в Excel, Google Sheets, Airtable, Notion или скачивай в CSV/JSON. И да, экспорт бесплатный.
- ИИ-обработка данных: переводи, категоризируй, суммируй или размечай данные прямо в процессе сбора — идеально для грязных, неструктурированных источников.
- Облачный и браузерный скрейпинг: выбирай быстрый облачный режим для открытых сайтов или браузерный режим для страниц, где нужен логин.
- Плановый сбор: настраивай повторяющиеся задачи с помощью естественного языка (например, «каждый понедельник в 8 утра»), чтобы данные всегда оставались свежими.
- Бесплатные экстракторы данных: извлекай email, телефоны и изображения с любого сайта одним кликом.
Thunderbit доверяют более чем 200 000 пользователей по всему миру, а цены простые: бесплатно до 6 страниц, далее тарифы от $15 в месяц за 500 кредитов (1 кредит = 1 строка результата).
Почему Thunderbit выделяется
Thunderbit особенно хорош, когда нужно:
- Собирать сложные, нестандартные или нишевые сайты, где шаблоны не помогают.
- Извлекать структурированные данные из PDF или изображений (например, счета, характеристики товаров или листовки по недвижимости).
- Дать нетехническим командам возможность строить скрейперы, запускать задания по расписанию и экспортировать данные без узкого горлышка в IT.
- Соблюдать комплаенс: Thunderbit поддерживает ответственное извлечение данных, уважает robots.txt и предлагает безопасные, управляемые пользователем сценарии.
Попробовать AI Web Scraper от Thunderbit бесплатно
2. Scrapy
Scrapy — это мощный open-source инструмент, который обожают разработчики и data engineers. Если тебе нужен полный контроль, кастомные пайплайны и возможность масштабировать веб-скрейпинг на тысячи сайтов, Scrapy — один из лучших вариантов.
Технические преимущества Scrapy
- Расширяемость: создавай собственные spiders, pipelines и middlewares под любой сценарий извлечения данных.
- Масштабируемость: эффективно сканирует и собирает данные с крупных сайтов, включая встроенную поддержку распределенного crawling.
- Поддержка сообщества: активное open-source сообщество, множество плагинов и постоянное развитие (более 55 000 звезд на GitHub).
- Интеграции: легко встраивается в Python-пайплайны, ML-воркфлоу и облачную инфраструктуру.
Где Scrapy особенно силен
- Кастомные крупные проекты со сложной логикой и требованиями к интеграции.
- Команды с сильными навыками Python, которые хотят полностью контролировать процесс извлечения.
- Enterprise-компании, строящие собственные data pipelines или интегрирующиеся с внутренними системами.
Ограничения: Scrapy — не для слабонервных: здесь есть порог входа, нужна регулярная поддержка, и нет встроенного интерфейса для пользователей без кода. Но для технических команд это настоящий монстр (Scrapfly).
3. Octoparse
Octoparse — это no-code SaaS-платформа, которая делает извлечение веб-данных доступным широкой аудитории. Интерфейс drag-and-drop, облачное планирование и готовые шаблоны делают ее популярной среди бизнес-пользователей, которым нужна мощь без программирования.
Бизнес-функции Octoparse
- Извлечение point-and-click: визуально выбирай элементы, настраивай workflow и смотри результат в реальном времени.
- Облачный скрейпинг и расписание: запускай задания в облаке, ставь их на повтор и не упирайся в ограничения локального компьютера.
- Готовые шаблоны: собирай данные с популярных сайтов с помощью уже настроенных шаблонов — отлично для e-commerce, job boards и соцсетей.
- Экспорт данных: скачивай результаты в CSV, Excel или отправляй напрямую в базы данных и API.
Где Octoparse особенно хорош
- Нетехнические пользователи, которым нужно собирать данные со стандартных или умеренно сложных сайтов.
- Команды, которым нужны регулярные автоматические выгрузки без участия IT.
- SMB и маркетинговые команды, ищущие баланс между мощностью и удобством.
Отзывы пользователей: некоторые отмечают непростой вход в продвинутые функции, но в целом Octoparse хвалят за то, что он делает веб-данные доступными для всех.
Цена: есть бесплатный тариф; платные планы начинаются примерно от $69 в месяц ([Octoparse Pricing](https://www.oct



