
Сбор данных из Facebook по-прежнему актуален в 2026 году, но только если выбрать правильную модель извлечения. Pew Research Center сообщил 20 ноября 2025 года, что 71% взрослых в США используют Facebook, а Meta 29 апреля 2026 года заявила, что ее семейство приложений достигло 3,56 млрд ежедневных активных пользователей в марте 2026 года. Такой масштаб делает Facebook полезным для мониторинга Marketplace, исследования публичных страниц, генерации лидов и отслеживания конкурентов. Сложность не в том, чтобы найти сценарии применения. Сложность — получить чистые данные, не уткнувшись в логин-барьеры, динамическую подгрузку, временные блокировки или хрупкие схемы парсинга.
Этот ежегодный шортлист создан для быстрого выбора. В августе 2026 года я заново проверил официальные страницы продуктов, документацию и сигналы по ценам, а затем оставил в списке только те инструменты, которые действительно подходят реальным бизнес-пользователям. Если вам нужна инфраструктура на уровне API, в верхней части списка должны быть Bright Data, Apify и Nimble by Nimbleway. Если ваша работа включает облачную автоматизацию или последующие действия после сбора данных, стоит внимательнее посмотреть на PhantomBuster.
Быстрый выбор по задаче
- Нужен официальный путь для ресурса, которым вы управляете? Начните с инструментов управления Meta и одобренных API.
- Нужен специализированный API для публичных данных? Сравните Bright Data или Apify с учетом конкретной цели и разрешенного использования.
- Нужен универсальный инфраструктурный слой для веб-данных? Оцените Nimble или ScrapingBot через ограниченный proof of concept.
- Нужен визуальный сценарий для разрешенного источника вне Meta? Octoparse может подойти для процесса, который ведет аналитик.
Почему собирать данные Facebook все еще сложно в 2026 году
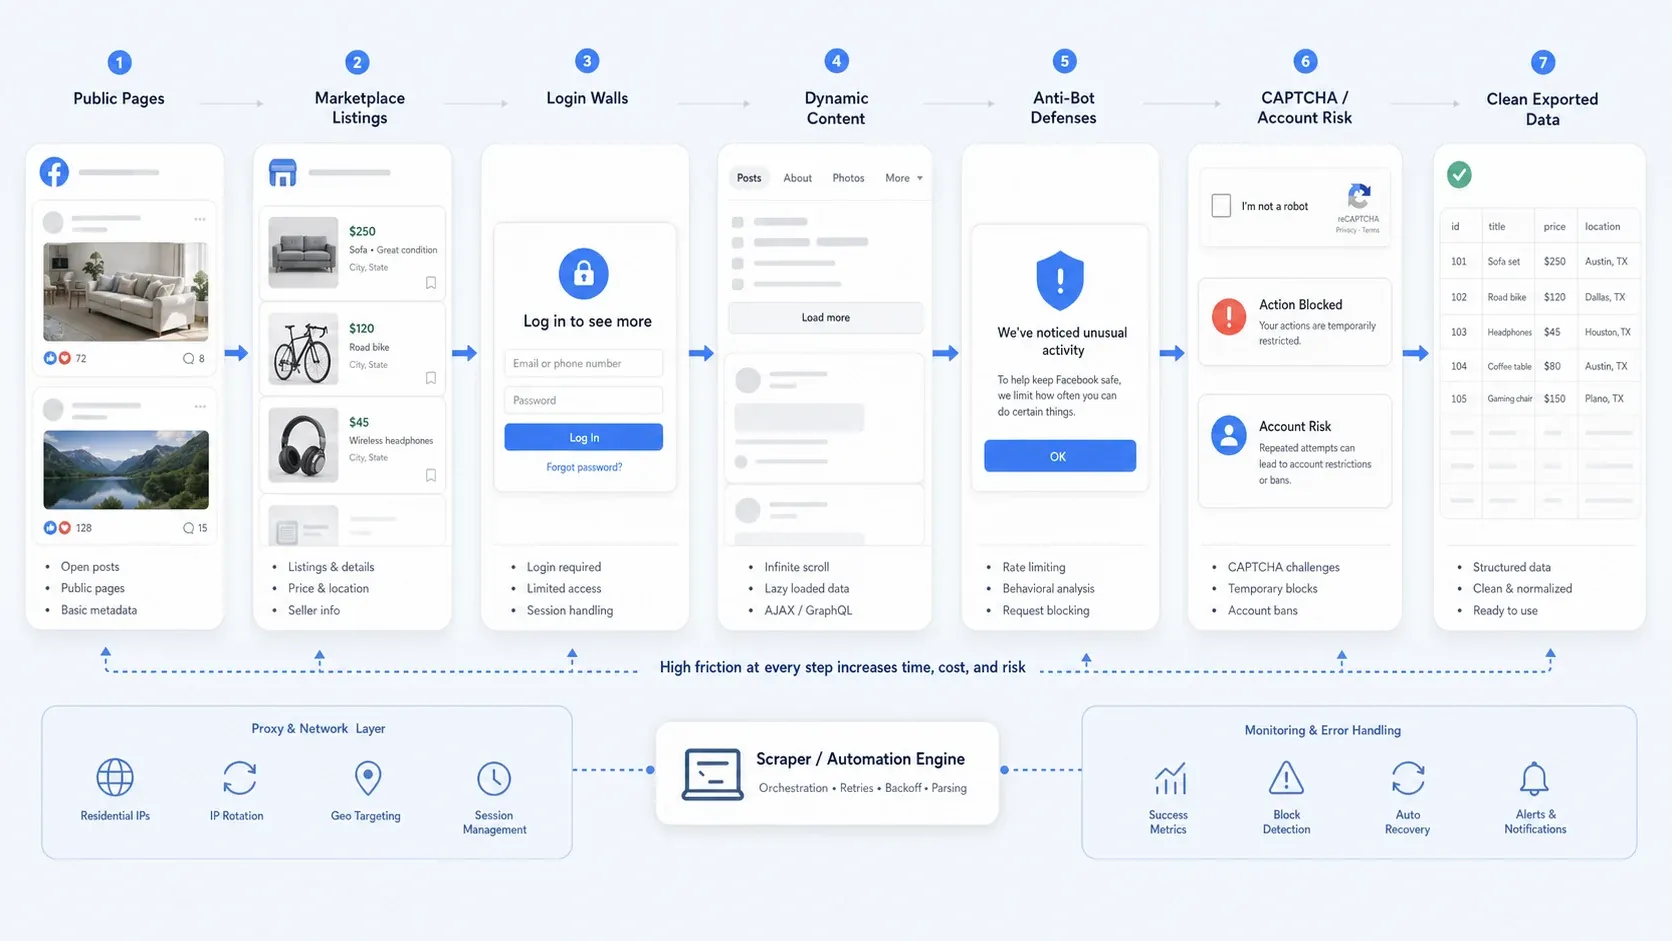
Сбор данных Facebook сегодня — это уже редко просто вопрос селекторов. На практике команды чаще всего сталкиваются с одной или несколькими из этих проблем:
- Частичный публичный доступ: одни страницы остаются открытыми, а другие сценарии все равно уводят к авторизации, чтобы увидеть больше деталей.
- Динамический контент: данные Marketplace, длинные ветки комментариев и содержимое страниц часто загружаются поэтапно.
- Антибот-защита: ограничения по частоте запросов, поведенческие проверки, CAPTCHA и временные блокировки действий ломают наивную автоматизацию.
- Операционные риски: сбор данных через логин гораздо рискованнее, чем парсинг публичных страниц, особенно если важны безопасность аккаунта и воспроизводимость.
Как я оценивал эти инструменты
Я оптимизировал эту страницу под выбор шортлиста, а не под перечисление всех возможных функций. Инструменты ниже сравнивались по следующим критериям:
- Соответствие рабочему процессу: действительно ли продукт подходит для задач сбора данных из Facebook и Marketplace, с которыми работают реальные команды?
- Простота использования: могут ли нетехнические пользователи или небольшие команды быстро получить пригодный результат?
- Масштаб и надежность: сохраняет ли инструмент смысл, когда вы выходите за рамки разового сбора?
- Антибот-механизмы и работа с сессиями: сколько инфраструктурной боли снимает продукт?
- Качество результата: можно ли без серьезной доработки получить структурированные данные в CSV, Sheets или во внешние системы?
- Сигнал по цене: удобно ли продукт тестировать, или он требует сложного enterprise-подхода?
- Позиция в отношении комплаенса: явно ли инструмент ориентирован на сбор публичных данных и ответственное использование?
Какой тип Facebook Scraper вам нужен?
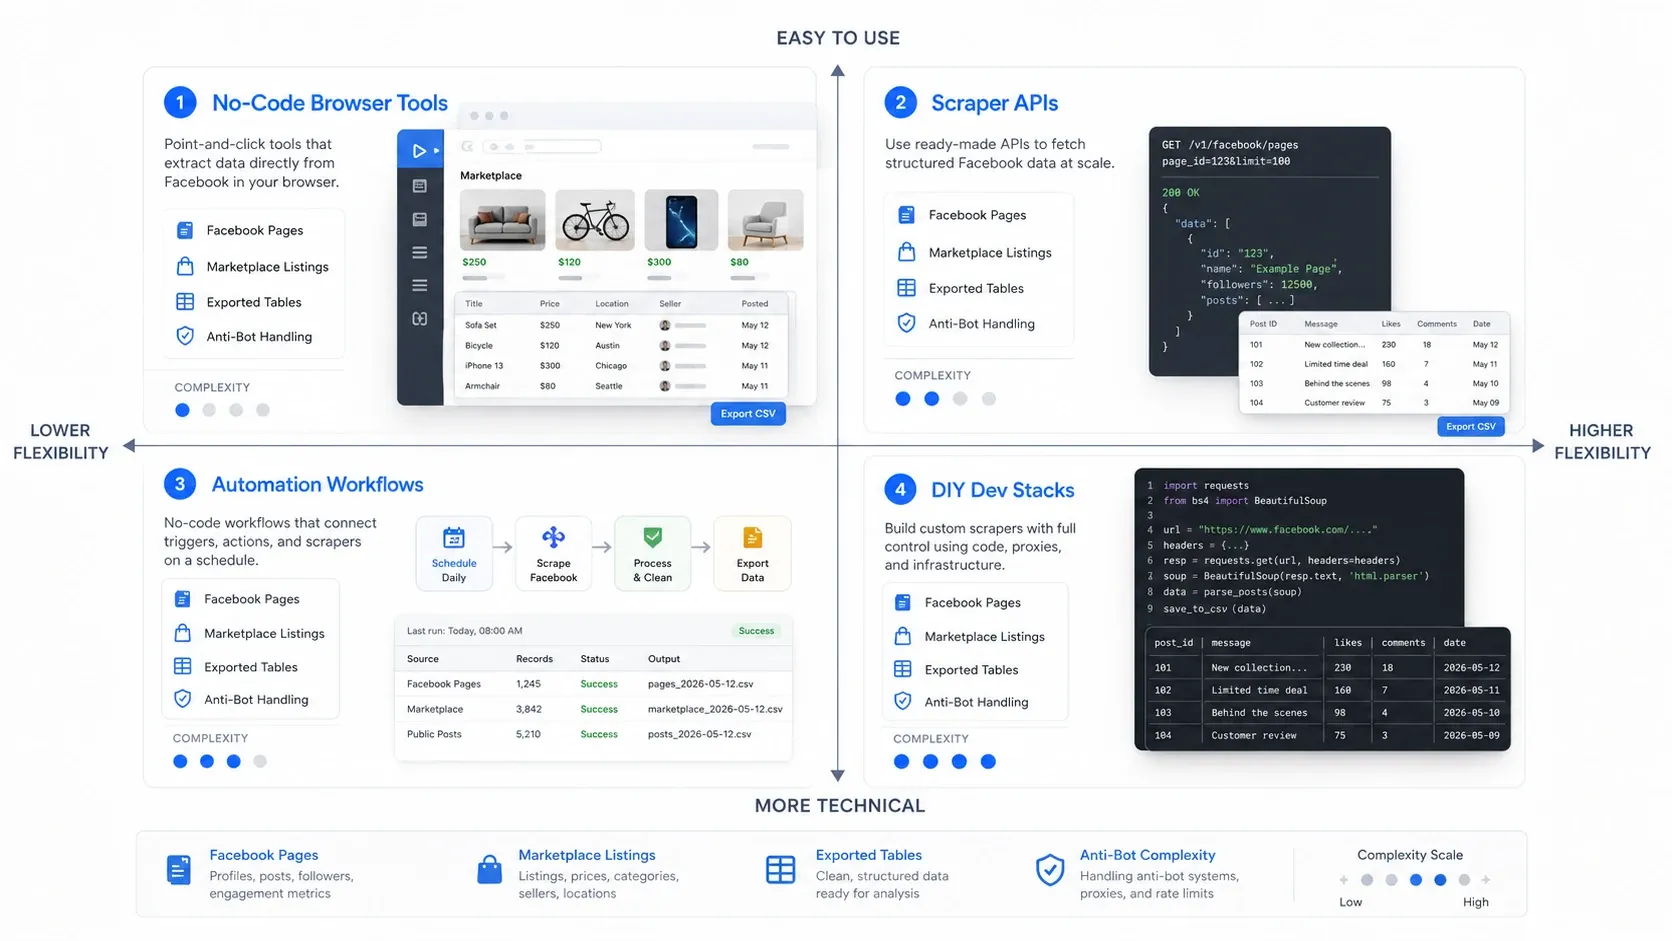
Самый быстрый путь к хорошему выбору — сначала выбрать правильную категорию. Инструменты для сбора данных из Facebook обычно делятся на четыре операционные модели:
- No-code браузерные инструменты: лучше всего подходят, когда нужно быстро извлечь данные со страницы, которая уже открыта перед вами.
- Scraper API: лучший вариант, если нужен надежный и повторяемый сбор в большом объеме.
- Автоматизированные рабочие процессы: подходят, когда парсинг — лишь один из шагов более широкого go-to-market-процесса.
- DIY-стек для разработчиков: оптимален, когда команде нужен максимальный контроль и она готова взять на себя поддержку.
Сравнительная таблица
| Инструмент | Лучший сценарий | Модель работы |
|---|---|---|
| Bright Data | Управляемый API-процесс для публичных данных | Специализированный API и слой доставки |
| Apify | Повторяемая задача для Page или Profile | Cloud actor и вывод в dataset |
| Nimble | Оценка для инженерной команды | Универсальный API для публичного веба |
| ScrapingBot | Тест с поддержкой рендеринга | Универсальный API для парсинга |
| PhantomBuster | GTM-процесс с использованием собственного аккаунта | Автоматизация prospecting |
| Octoparse | Визуальная задача под управлением аналитика | No-code визуальный workflow |
1. Bright Data
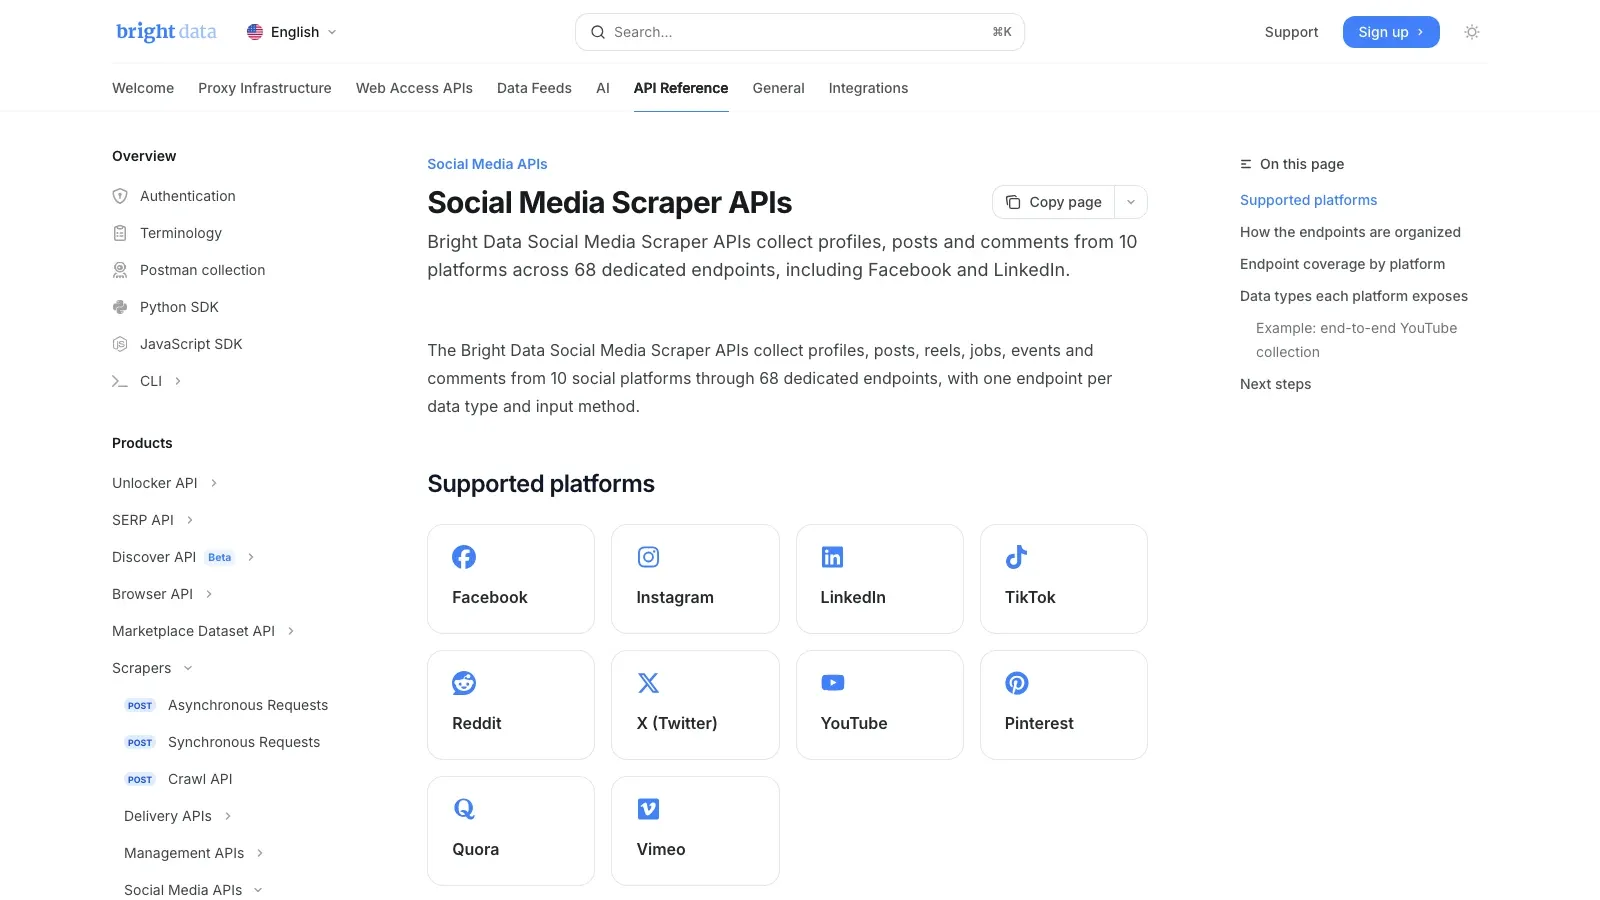
Bright Data — выбор с упором на инфраструктуру. В собственной документации Bright Data указано, что его Social Media Scraper APIs охватывают 10 платформ и 68 специализированных endpoint’ов, включая Facebook. Если ваша задача — массовый сбор публичных данных, такой управляемый API-стек обычно гораздо реалистичнее, чем попытки масштабировать браузерное расширение или самописный парсер.
Почему он попал в шортлист:
- Специализированные endpoint’ы для сбора данных из соцсетей
- Управляемое обходное извлечение и сбор данных
- Структурированная доставка результатов в data pipeline
- Лучше всего подходит для мониторинга и аналитики, где особенно важна надежность
Лучше всего для: аналитиков, data-команд, крупных мониторинговых проектов и масштабных наборов данных из соцсетей.
Сигнал по цене: стоимость зависит от продукта и объема. Актуальные цены смотрите на странице тарифов Bright Data.
2. Apify
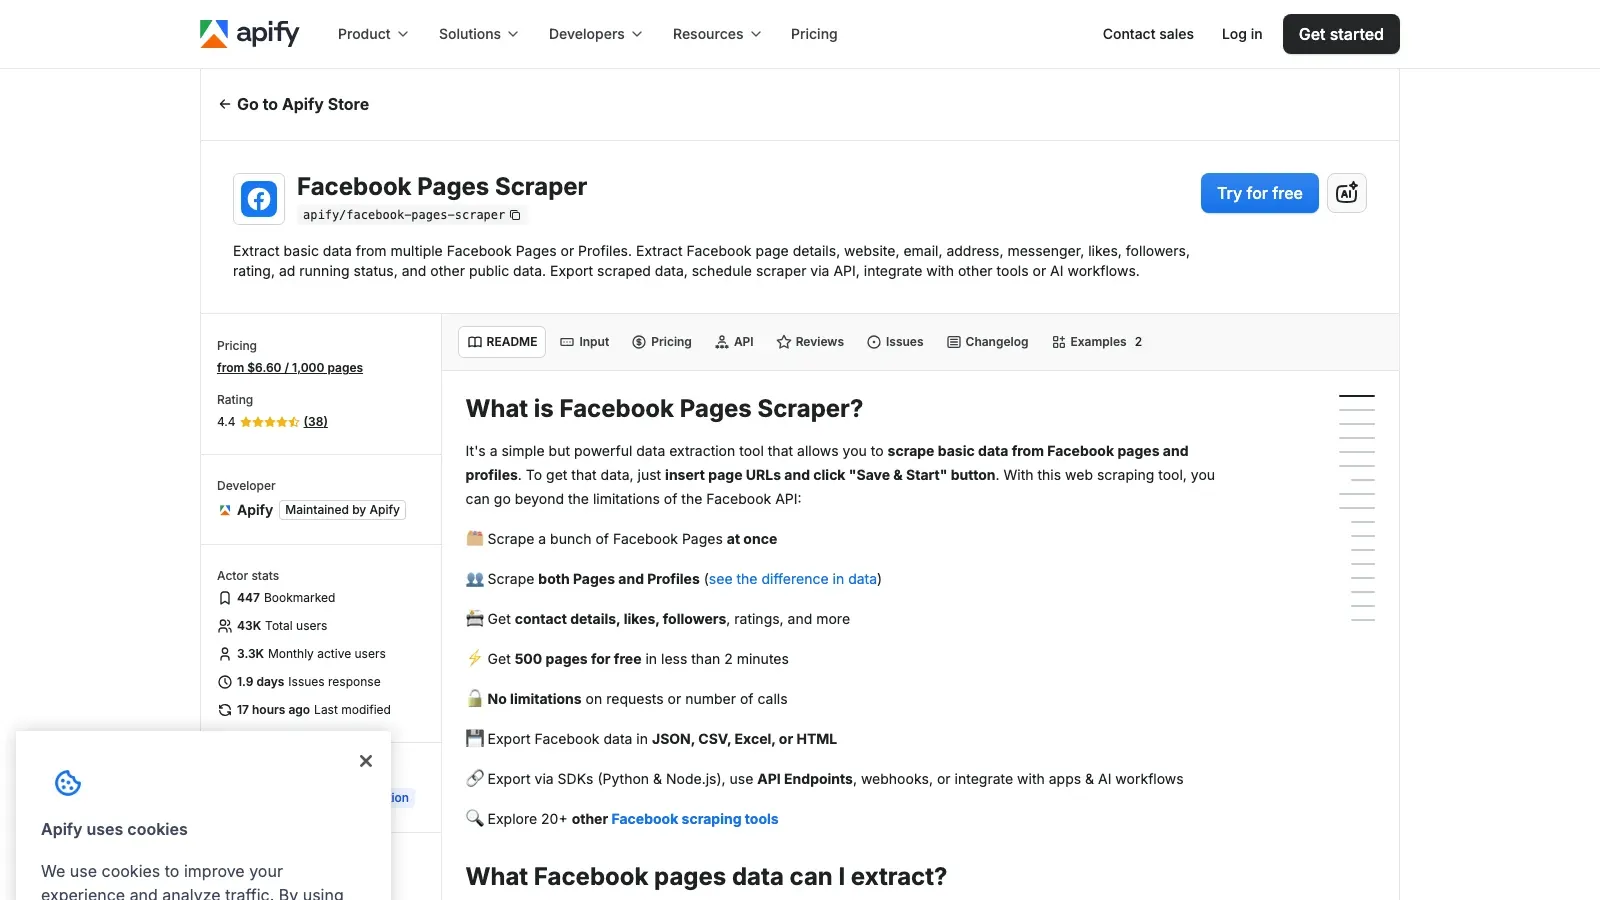
Apify остается актуальным, потому что предлагает хороший баланс между шаблонами и полной кастомизацией. Actor для сбора данных со страниц Facebook — удобная отправная точка, а сама платформа Apify дает облачные запуски, расписания, API и пространство для расширения процесса, если требования станут сложнее.
Почему он в списке:
- Готовые Facebook actors
- Облачное выполнение и повторяющиеся расписания
- Гибкий экспорт и доступ через API
- Проще расширять, чем чисто no-code браузерный workflow
Лучше всего для: технических маркетологов, агентств, ops-команд и повторяющихся задач сбора данных с нескольких сайтов.
Сигнал по цене: тарифы платформы платные, а использование actor’ов оплачивается отдельно по метрам. Проверьте цены Apify.
3. Nimble by Nimbleway
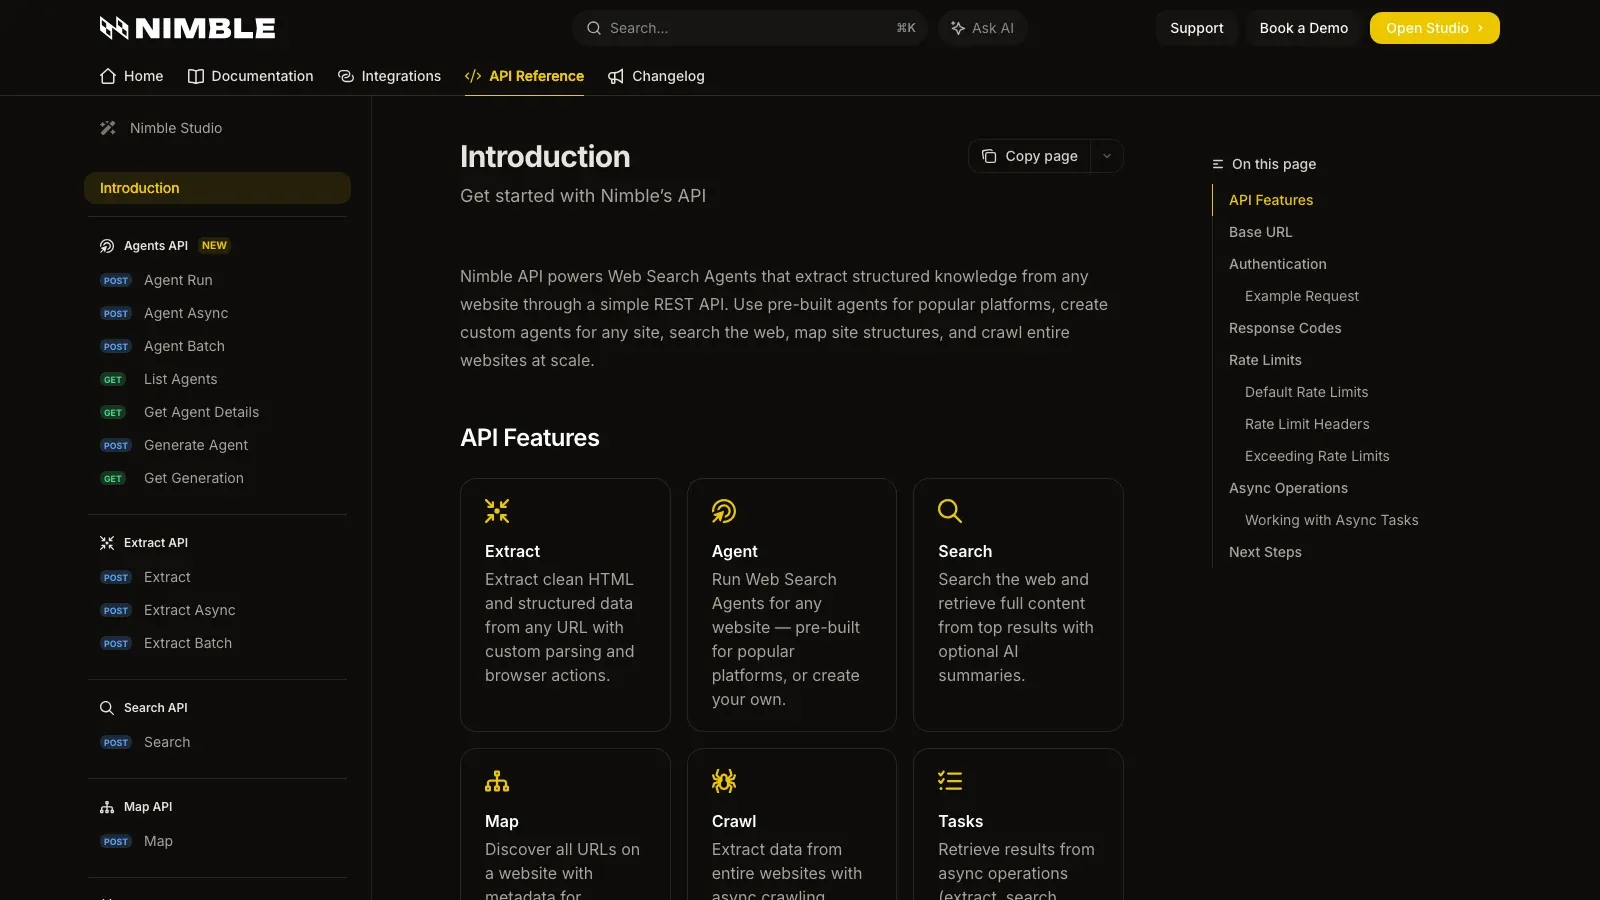
Nimble by Nimbleway — API-first вариант для команд, которые хотят передать URL и доверить платформе доступ, рендеринг и доставку результата. Nimble позиционирует свой Web Scraper API как end-to-end решение для сбора публичных веб-данных, поэтому он особенно полезен, когда сбор данных из Facebook — лишь часть более широкой data-архитектуры.
Почему стоит оценить:
- API-воркфлоу, ориентированный на URL
- Меньше нагрузки на поддержку парсеров для инженерных команд
- Хорошо подходит для устойчивого извлечения публичных веб-данных
- Полезен, если собранные данные питают внутренние продукты или дашборды
Лучше всего для: команд под руководством инженеров, продуктовых data-pipeline и организаций, которым нужен инфраструктурный слой вместо точечных инструментов.
Сигнал по цене: Nimble не делает акцент на публичных self-serve тарифах на основных страницах API, поэтому ожидайте sales-led pricing и уточняйте напрямую у Nimble by Nimbleway.
4. ScrapingBot
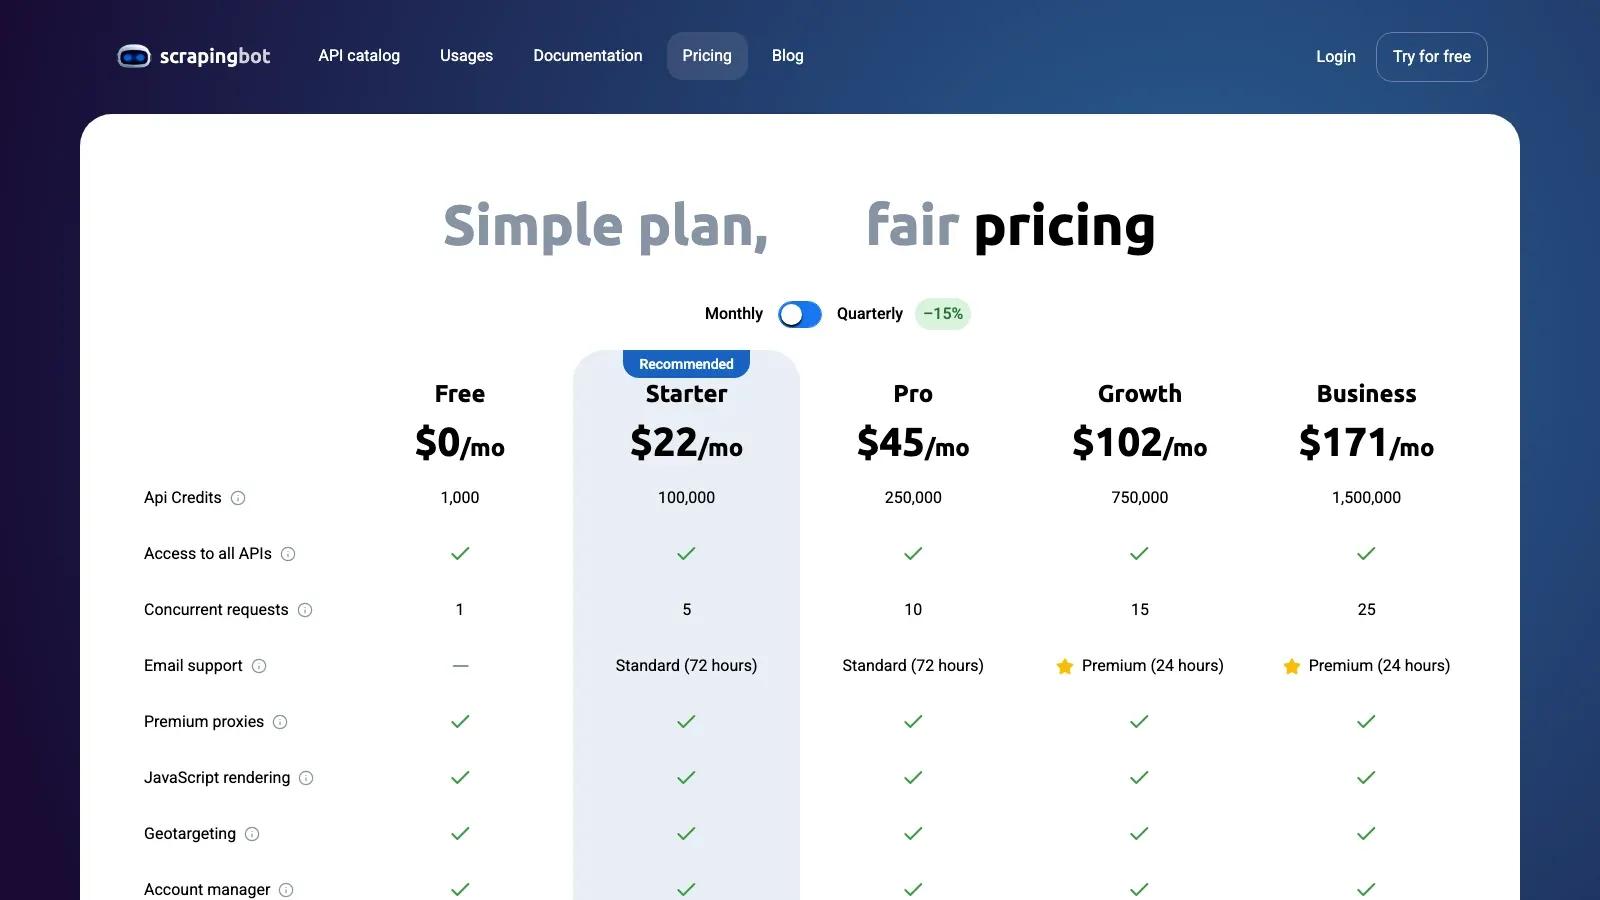
ScrapingBot — самый экономичный API-вариант в этом списке. Это не самая глубоко специализированная платформа именно для Facebook, но она все равно имеет смысл для небольших задач по публичным данным, когда вам нужен API, поддержка рендеринга и более низкий порог входа по цене, чем у enterprise-инфраструктуры для парсинга.
Где он подходит:
- Простой API-подход к сбору публичных данных
- Низкая стартовая цена
- Встроенная поддержка рендеринга и прокси
- Лучше для прототипов и легких повторяющихся выгрузок, чем для крупных аналитических программ
Лучше всего для: стартапов, малого бизнеса и разработчиков, тестирующих более простые сценарии сбора данных со страниц.
Сигнал по цене: есть бесплатный тариф; на текущей публичной странице цен платные планы начинаются примерно с $22 в месяц.
5. PhantomBuster
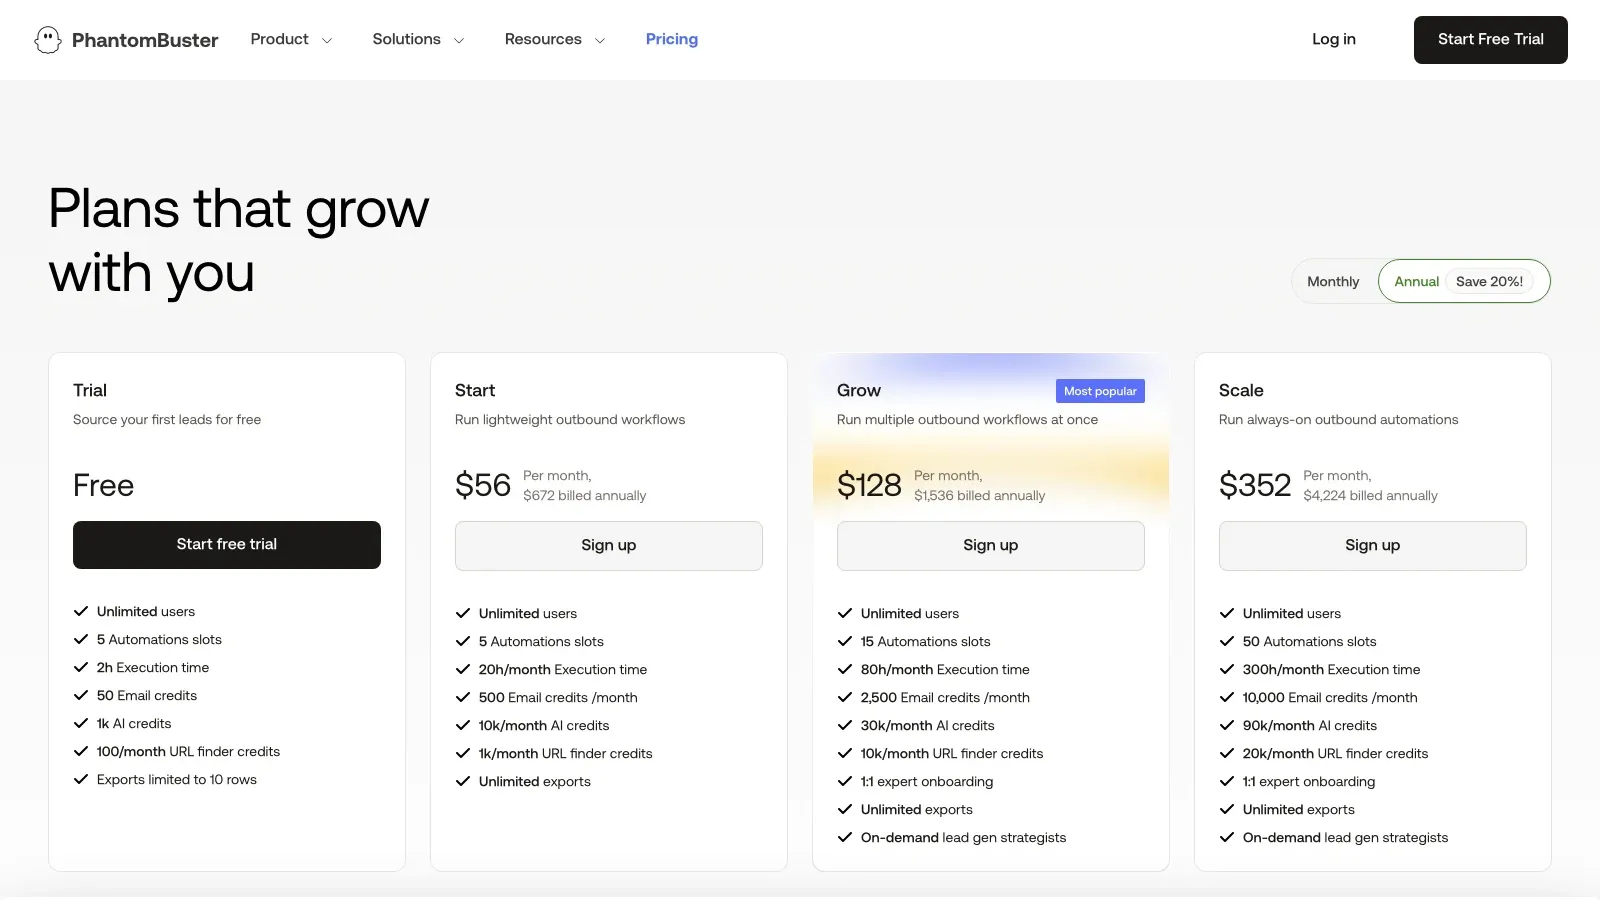
PhantomBuster — это меньше про «чистую» инфраструктуру для парсинга и больше про то, что происходит после сбора данных. Если ваш сценарий звучит как «собрать данные, а затем запустить outreach, enrichment или follow-up действия», PhantomBuster часто полезнее простого экстрактора, потому что он построен вокруг облачной автоматизации и workflow с браузерными действиями.
Почему команды по-прежнему включают его в shortlist:
- Облачные сценарии автоматизации
- Полезен для генерации лидов и GTM-операций
- Лучше подходит, когда парсинг — лишь один шаг более широкого процесса
- Практичен для операторов, которым важны действия, а не только экспорт
Лучше всего для: GTM-команд, growth-команд, рекрутеров и операторов, которые связывают сбор данных с последующими действиями.
Сигнал по цене: есть бесплатная пробная версия; платные планы на текущей странице тарифов начинаются примерно с $56 в месяц.
6. Octoparse
Octoparse по-прежнему остается одним из лучших no-code визуальных инструментов для пользователей, которым нужны повторяемые workflows и облачные запуски по расписанию. Он дает нетехническим пользователям более явный контроль над тем, как строится и повторяется логика извлечения, но требует больше настройки, чем легкий одноразовый сценарий.
Почему он остается актуальным:
- Визуальный конструктор workflow с управлением через point-and-click
- Облачное извлечение и планирование
- Хорошо подходит для структурированных повторяющихся задач
- Лучше всего для аналитиков, которым нужна повторяемость без кода
Лучше всего для: нетехнических аналитиков, SMB ops-команд и повторяющихся задач сбора с более явной логикой workflow.
Сигнал по цене: на публичной странице цен Octoparse указано, что платные планы начинаются примерно с $69 в месяц за план Standard при ежегодной оплате.
Шортлист по командам
- API-ориентированный workflow: Bright Data или Apify
- Оценка публичного веба под управлением инженеров: Nimble или ScrapingBot
- Prospecting workflow под собственным аккаунтом: PhantomBuster
- Визуальный, редактируемый workflow: Octoparse
Перед выбором любого варианта проверьте точный тип страницы и поля, которые вашей команде разрешено использовать. Видимость в Facebook отличается в зависимости от Pages, Profiles, Marketplace, Groups, геолокации и состояния аккаунта.
Итог
Правильный путь зависит от данных, модели доступа и ответственности команды за проверку результата. Для ресурсов, которыми вы управляете, начинайте с официальных инструментов Meta и одобренных API. Для исследований вне этой зоны выбирайте провайдера или источник только после того, как подтвердите тип страницы, разрешенное использование, обязательства по конфиденциальности и текущее поведение продукта.
FAQ
С какого варианта нетехническому пользователю стоит начать?
Если речь идет о ресурсе, которым управляет ваша организация, начните с собственных инструментов Meta для управления и аналитики. Для более широких исследовательских задач определите разрешенный источник, workflow и права на данные которого можно проверить.
Какой вариант лучше всего подходит для интеграции с софтом или data-pipeline?
Оцените специализированный Facebook API, например Bright Data, платформу на основе actor’ов, например Apify, или общий API для публичного веба — через ограниченный тест на конкретной цели.
Могут ли эти инструменты обходить ограничения доступа Facebook?
Нет. Не используйте инструмент для обхода платформенных ограничений, логин-барьеров или защит приватности.




