
Если ты когда-нибудь пробовал requests.get("https://www.youtube.com/...") и разбирал ответ через BeautifulSoup в поисках названий видео, ты уже знаешь, чем всё обычно заканчивается: перед тобой стена пустых <div>-тегов и ровно ноль полезных данных.
Это самая частая проблема, с которой я сталкиваюсь у разработчиков, которые впервые пытаются парсить YouTube. YouTube — это одностраничное приложение, и почти всё на нём рендерится на стороне клиента через JavaScript. HTML, который получает твой Python-скрипт, — это всего лишь оболочка. А настоящие заголовки видео, счётчики просмотров и метаданные? Они спрятаны в огромном JSON-блоке под названием ytInitialData, который внедряется JS уже после загрузки страницы.
Поэтому вполне логичный soup.find("div", class_="ytd-video-renderer") возвращает None, потому что такого элемента буквально нет в сыром HTTP-ответе. Когда я это понял, пазл наконец сложился — а четыре метода ниже стали результатом множества тестов, сломанных попыток и слишком долгого чтения GitHub issue. Я проведу тебя по каждому подходу, покажу, когда именно использовать тот или иной вариант, и в конце дам no-code альтернативу для тех, кому нужны просто данные без настройки проекта.
Зачем вообще парсить YouTube на Python?
YouTube — это не просто видеоплатформа, а источник данных с 2,58 млрд ежемесячно активных пользователей. На платформе размещено более 5,1 млрд видео, а каждую минуту загружается более 500 часов контента. В этом массиве открытой информации бизнес, исследователи и авторы контента видят огромный потенциал для анализа.
Но есть нюанс: встроенная аналитика YouTube показывает данные только по твоему каналу. Если ты хочешь понять частоту публикаций конкурента, отследить тренды в своей нише или проанализировать реакцию аудитории в комментариях к чужим видео, без парсинга не обойтись.
Вот самые типичные сценарии, с которыми я сталкивался на практике:
| Сценарий | Кому нужно | Какие данные |
|---|---|---|
| Анализ конкурентов | Маркетинговым командам, контент-стратегам | Просмотры, частота публикаций, уровень вовлечённости |
| Генерация лидов | Отделам продаж, B2B outreach | Контакты канала, рабочие email в описаниях |
| Исследование рынка | Продакт-менеджерам, аналитикам | Трендовые темы, настроение аудитории по комментариям |
| Контент-стратегия | YouTube-авторам, агентствам | Форматы с высокой отдачей, лучшие шаблоны заголовков и тегов |
| SEO / keyword research | SEO-специалистам | Заголовки, теги, описания, сигналы ранжирования |
| Мониторинг бренда | PR-командам, бренд-менеджерам | Упоминания в заголовках, комментариях и описаниях |
| Академические исследования | Исследователям, data scientist’ам | Датасеты комментариев для анализа тональности (одно исследование 2025 года показало точность 93,1% при дообучении BERT на 45 тыс. комментариев YouTube) |
Например, конкурентный анализ DJI vs. GoPro vs. Insta360 показал, что охват YouTube у DJI (390 млн просмотров) превысил суммарный результат обоих конкурентов — такой вывод невозможно увидеть внутри YouTube Studio.
Почему одного requests + BeautifulSoup недостаточно для парсинга YouTube
Прежде чем перейти к рабочим методам, важно понять, почему очевидный путь не срабатывает. Это не теория — это экономия часов на отладке.
Выглядит «очевидный» подход примерно так:
import requests
from bs4 import BeautifulSoup

response = requests.get("https://www.youtube.com/@somechannel/videos")
soup = BeautifulSoup(response.text, "html.parser")
videos = soup.find_all("a", id="video-title-link")
print(len(videos))  # 0 — каждый раз
Результат всегда нулевой. Как пишет ScrapeOps в своём гайде по отладке: «Страница загружена динамически, а requests это не поддерживает». Руководство Teclado для новичков говорит ещё прямее: «Используя только requests и BeautifulSoup, вы не можете выполнить JavaScript».
Разбор Scrapfly за 2026 год объясняет механику: YouTube построен как Single Page Application (SPA). При обычном HTTP-запросе ты получаешь только стартовую HTML-оболочку — реальный контент ещё не отрендерен. Данные о видео спрятаны внутри JavaScript-объектов, которые браузер обычно исполняет и вставляет в DOM.
Хорошая новость: YouTube действительно встраивает все нужные данные в сырой HTML. Просто не в DOM-элементы, а в два JSON-блока внутри <script>-тегов:
ytInitialData— структура страницы, списки видео, метрики вовлечённости, токены продолжения комментариевytInitialPlayerResponse— основная метаинформация о видео (заголовок, описание, длительность, форматы, субтитры)
Оба блока доступны через обычный requests.get() — браузер не нужен — если знать, как их извлечь и распарсить. Именно это и есть Метод 1 ниже.
4 способа парсить YouTube на Python: сравнение рядом
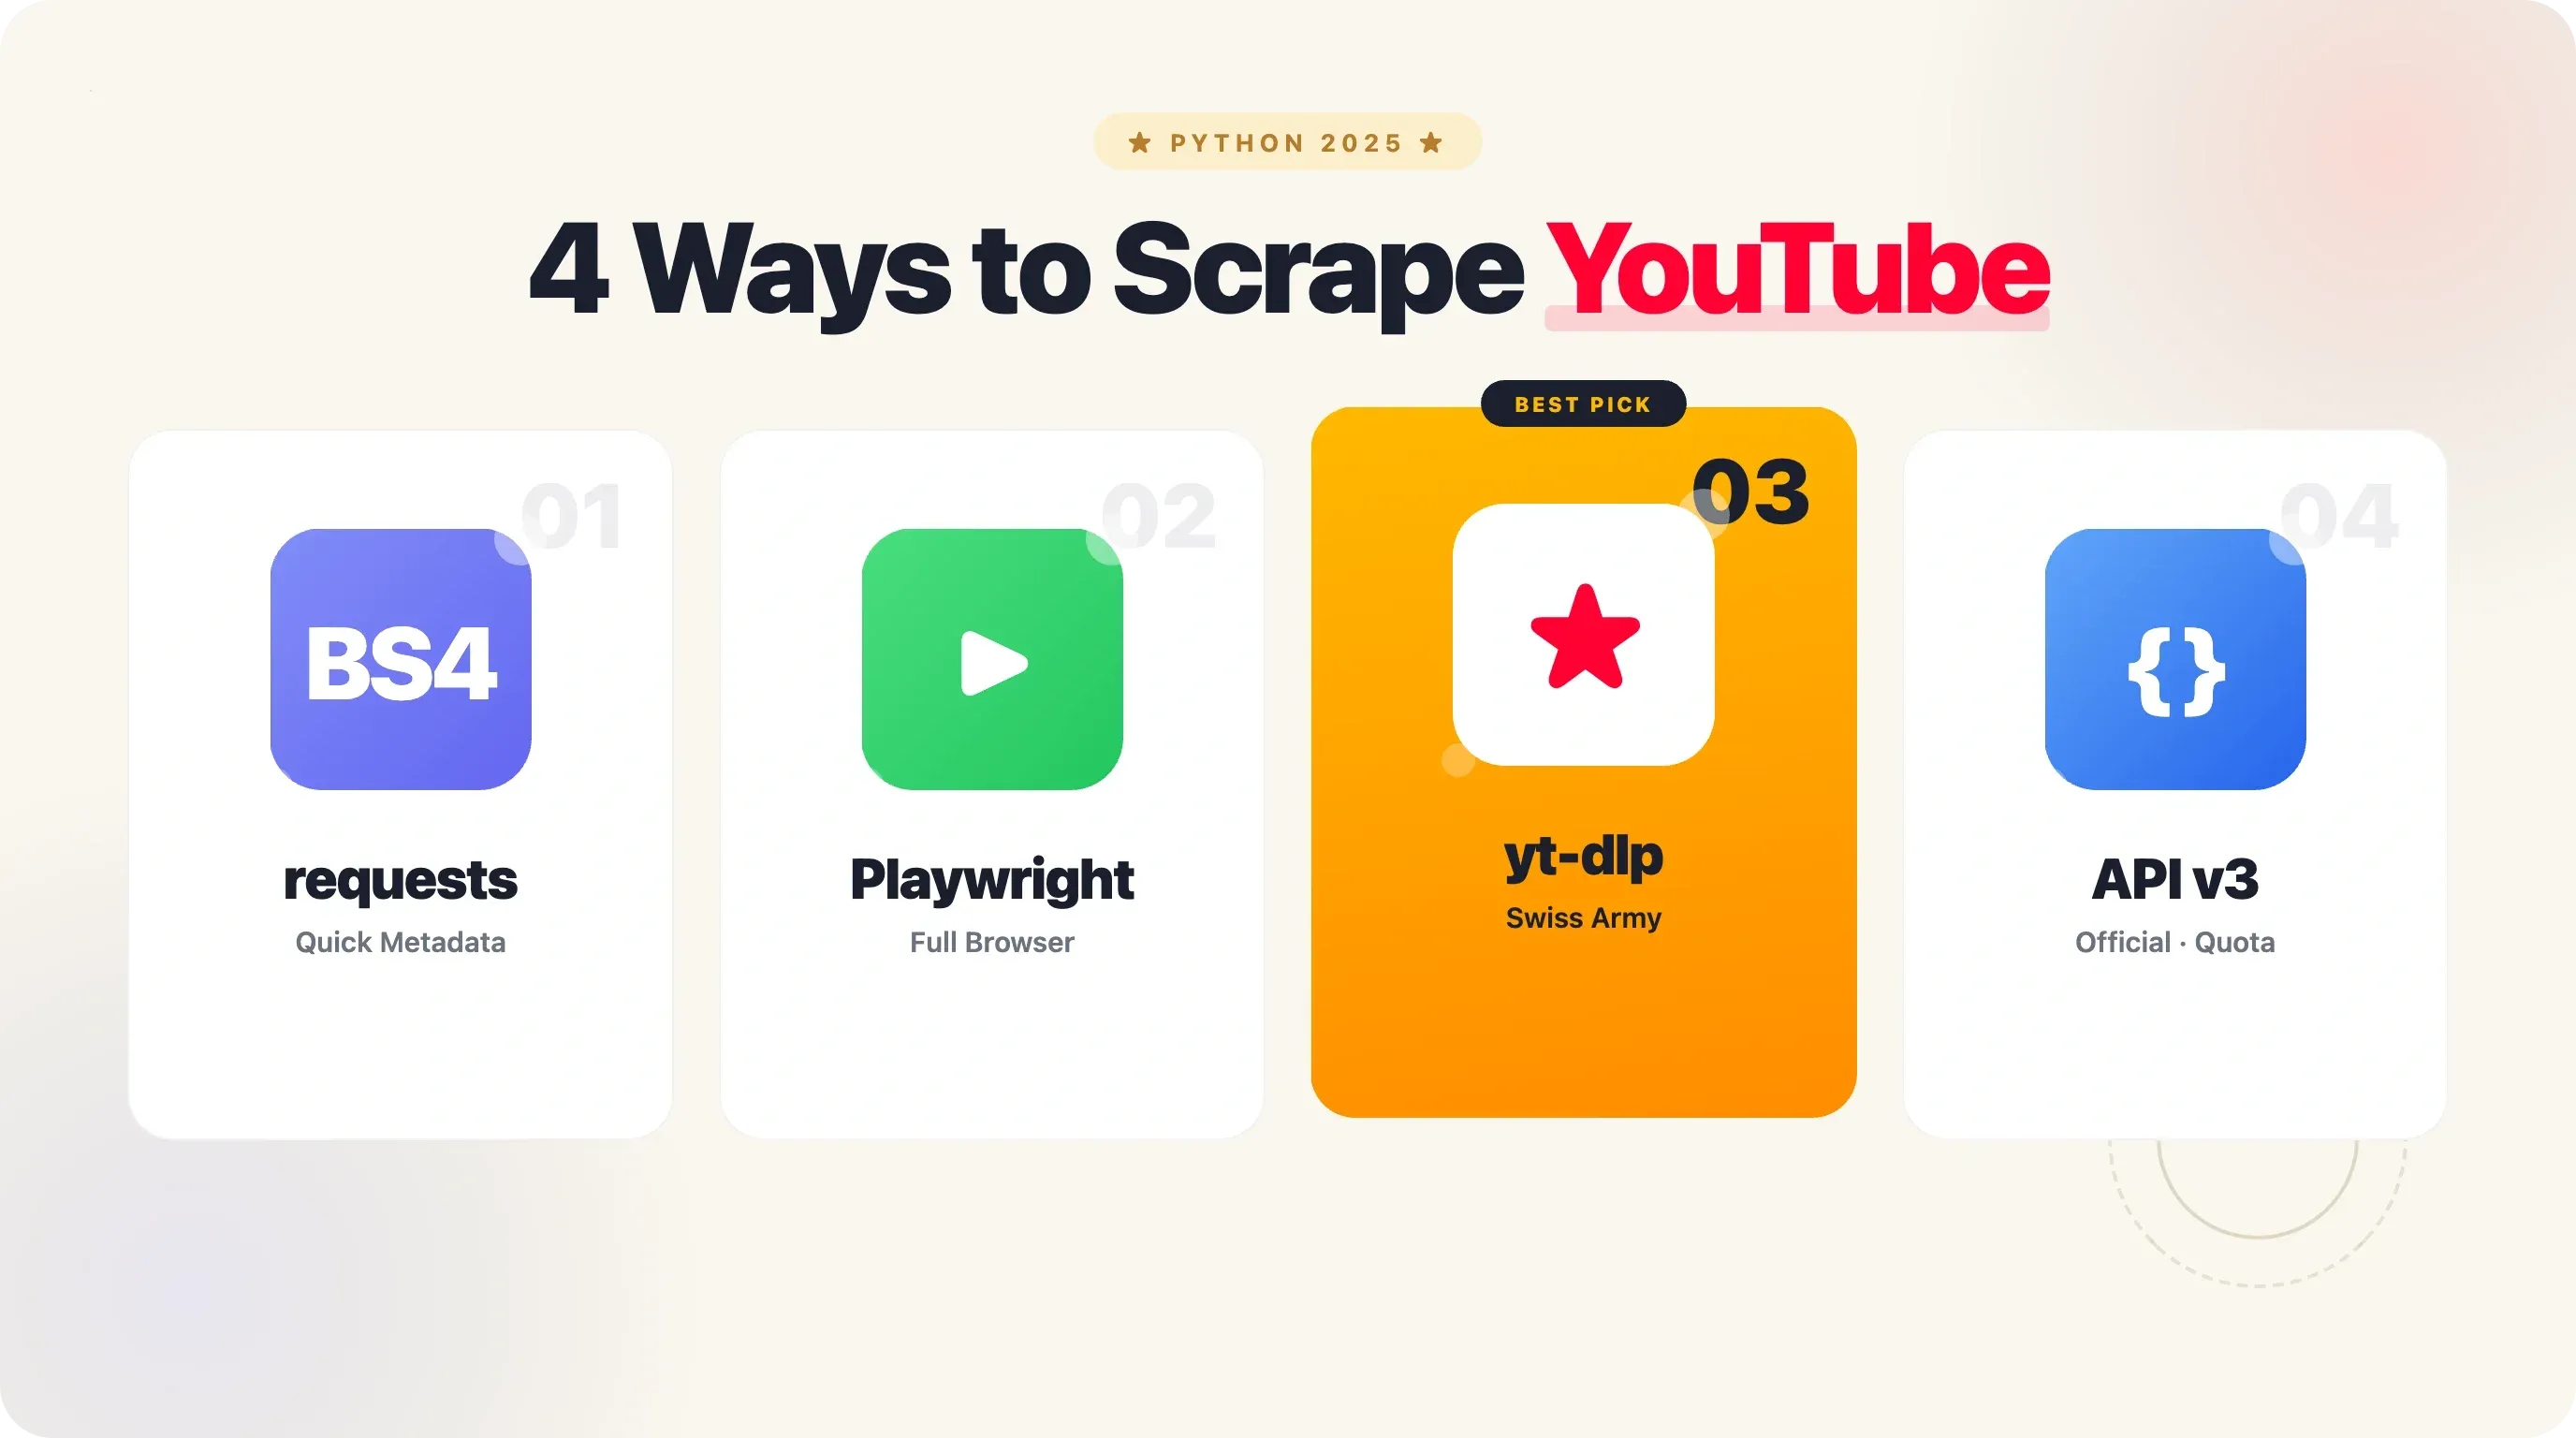
Прежде чем разбирать методы по отдельности, вот матрица выбора. Я протестировал все четыре подхода и сравнил их по тем критериям, которые реально важны при выборе инструмента для рабочего проекта.
| Критерий | requests + BS4 (ytInitialData) | Selenium / Playwright | yt-dlp | YouTube Data API | No-code (Thunderbit) |
|---|---|---|---|---|---|
| Сложность настройки | Низкая | Средняя | Низкая | Средняя (API key) | Нет |
| Работа с JS | Частично (парсинг JSON) | Да | Да | Н/Д (структурированный API) | Да |
| Скорость | Быстро | Медленно | Быстро | Быстро | Быстро (облако) |
| Риск антибот-защиты | Средний | Высокий | Низкий | Нет | Обрабатывается |
| Квоты / лимиты | Нет (но возможны блокировки IP) | Нет (но есть детект) | Нет | 10 000 единиц/день | На основе кредитов |
| Извлечение комментариев | Сложно | Возможно, но непросто | Встроено | Встроено | Зависит от страницы |
| Транскрипты | Нет | Сложно | Да | Нет | Нет |
| Лучший вариант для | Быстрых метаданных | Поиска, динамических страниц | Массовых метаданных и комментариев | Структурированных данных в масштабе | Не-программистов, быстрых экспортов |
Краткий обзор:
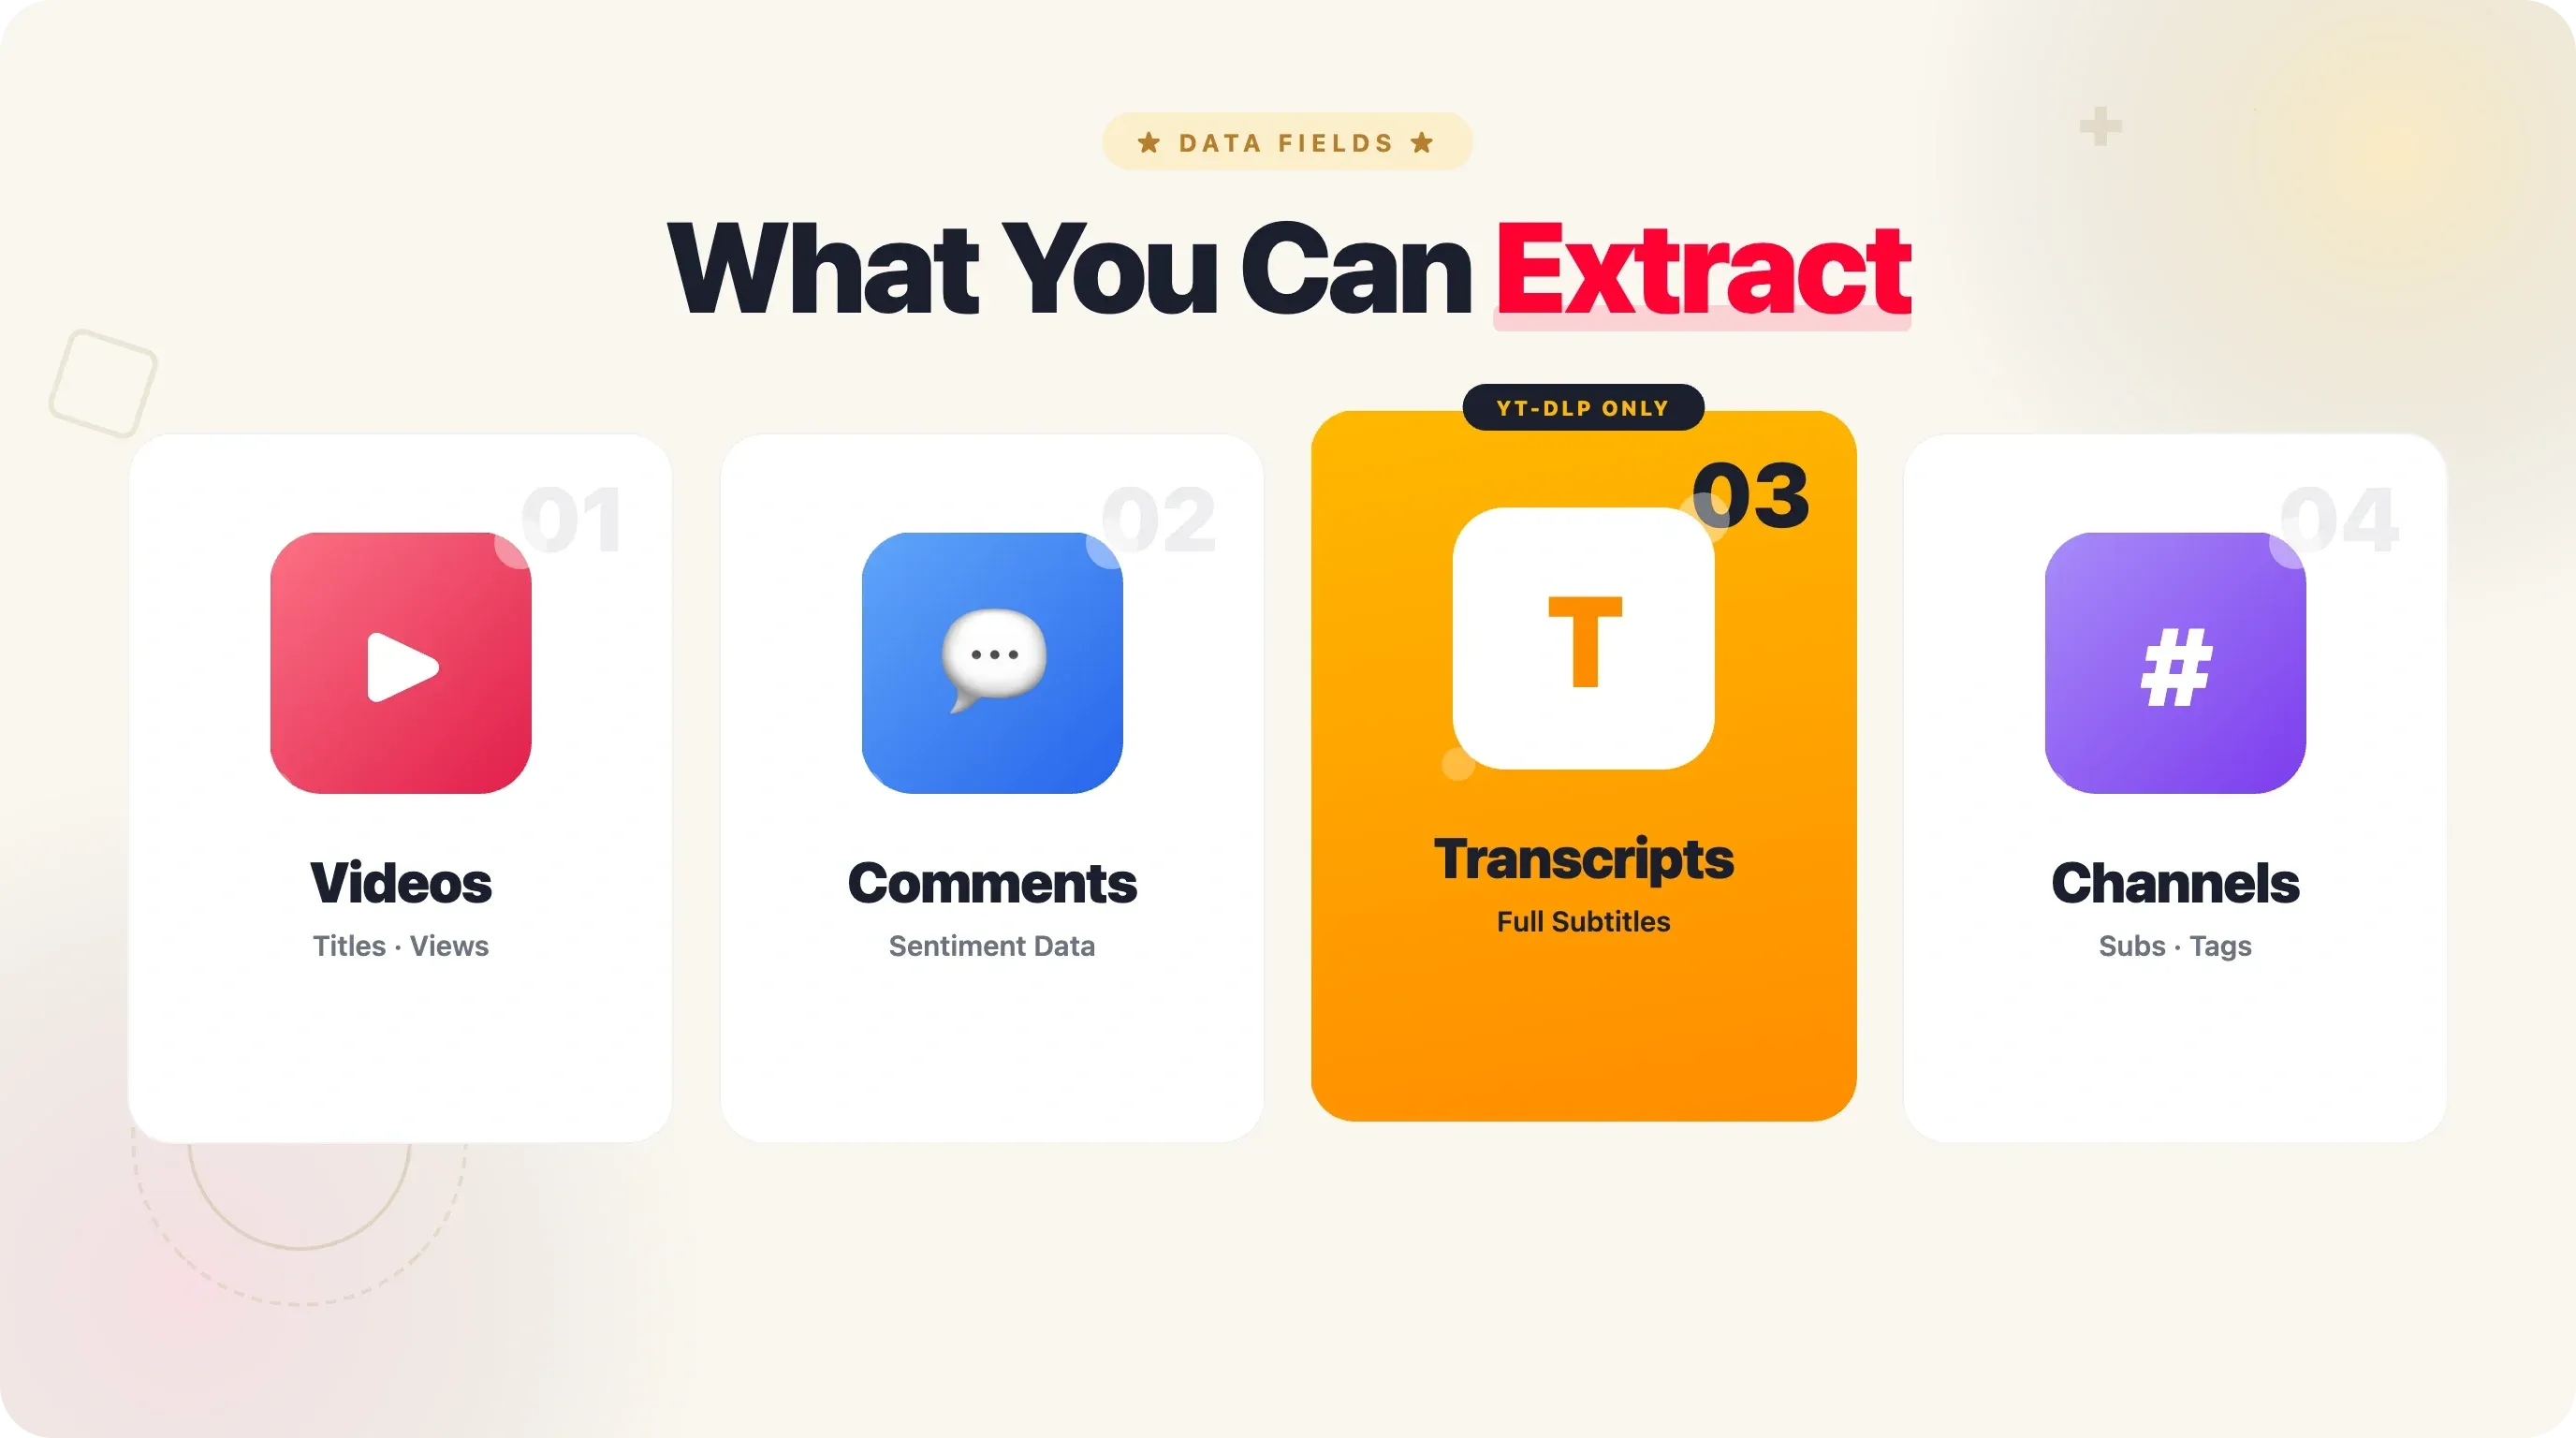
Какие данные YouTube вообще можно извлечь и каким методом?
Это та справочная таблица, которой мне не хватало в начале. Ни один метод не покрывает все поля — именно поэтому статья и разбирает четыре подхода.
| Поле данных | BS4 (ytInitialData) | Selenium/Playwright | yt-dlp | YouTube API | Thunderbit |
|---|---|---|---|---|---|
| Название видео | ✅ | ✅ | ✅ | ✅ | ✅ |
| Просмотры | ✅ | ✅ | ✅ | ✅ | ✅ |
| Количество лайков | ⚠️ Нестабильно | ✅ | ✅ | ✅ | ✅ |
| Комментарии (текст) | ❌ | ⚠️ Сложно | ✅ | ✅ | ⚠️ |
| Транскрипт / субтитры | ❌ | ⚠️ | ✅ | ❌ | ❌ |
| Теги | ✅ | ✅ | ✅ | ✅ | ⚠️ |
| URL миниатюр | ✅ | ✅ | ✅ | ✅ | ✅ |
| Число подписчиков канала | ⚠️ | ✅ | ✅ | ✅ | ✅ |
| Дата загрузки | ✅ | ✅ | ✅ | ✅ | ✅ |
| Длительность видео | ✅ | ✅ | ✅ | ✅ | ✅ |
| Данные по Shorts | ❌ | ⚠️ | ✅ | ⚠️ | ⚠️ |
Выбирай метод по тому, какие строки для тебя важнее всего. Если нужны комментарии и транскрипты — безусловный фаворит yt-dlp. Если нужны структурированные метрики в умеренном объёме — лучше всего API. Если данные нужны за две минуты — переходи к разделу про Thunderbit.
Метод 1: парсинг YouTube на Python через requests + BeautifulSoup (извлечение ytInitialData)
Этот способ использует тот факт, что YouTube встраивает все данные страницы в JSON внутри сырого HTML. Браузер не нужен — нужно лишь знать, где искать.
- Сложность: Начальный уровень
- Время: примерно 15 минут
- Что понадобится: Python 3.10+,
requests,beautifulsoup4
Шаг 1: отправьте GET-запрос на страницу YouTube
Отправляй запрос с реалистичным User-Agent. Стандартный заголовок python-requests/2.x блокируется почти мгновенно — гид ScrapeOps по заголовкам подтверждает, что это самая частая ошибка новичков.
import requests

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/114.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9",
    "Cookie": "CONSENT=YES+cb",  # обходит EU consent wall
}

url = "https://www.youtube.com/@mkbhd/videos"
response = requests.get(url, headers=HEADERS)
print(response.status_code)  # Должно быть 200
Cookie CONSENT критически важен — без него запросы из региона ЕС перенаправляются на consent.youtube.com, который отдаёт HTML вообще без ytInitialData.
Шаг 2: распарсьте HTML и найдите скрипт ytInitialData
Используйте BeautifulSoup или regex, чтобы найти тег <script> с var ytInitialData =:
import re
import json

# Извлекаем JSON ytInitialData
match = re.search(
    r"var ytInitialData\s*=\s*({.*?});</script>",
    response.text,
    re.DOTALL
)
if match:
    data = json.loads(match.group(1))
    print("ytInitialData успешно извлечён")
else:
    print("ytInitialData не найден — проверьте заголовки и cookies")
Частая ошибка — использовать не жадный .*? и заканчивать захват просто на };. Внутри JSON постоянно встречаются вложенные закрывающие скобки, и захват обрежется слишком рано. Используй };</script>, как делает scrapfly в своём разборе 2026 года — это последнее присваивание в отдельном script-блоке.
Шаг 3: пройдите по JSON и извлеките данные о видео
JSON глубоко вложен. Вместо того чтобы жёстко прописывать путь, который сломается при любом изменении структуры YouTube (а это происходит регулярно — трекер ошибок yt-dlp фиксирует множество изменений формата с 2023 года), лучше использовать рекурсивный поиск по ключу:
def search_dict(partial, search_key):
    stack = [partial]
    while stack:
        cur = stack.pop()
        if isinstance(cur, dict):
            for k, v in cur.items():
                if k == search_key:
                    yield v
                else:
                    stack.append(v)
        elif isinstance(cur, list):
            stack.extend(cur)

# Извлекаем информацию о видео со страницы канала
videos = []
for vr in search_dict(data, "videoRenderer"):
    videos.append({
        "video_id": vr.get("videoId"),
        "title": vr["title"]["runs"][0]["text"],
        "views": vr.get("viewCountText", {}).get("simpleText", "N/A"),
        "published": vr.get("publishedTimeText", {}).get("simpleText", "N/A"),
    })

print(f"Найдено видео: {len(videos)}")
for v in videos[:5]:
    print(f"  {v['title']} — {v['views']}")
Именно к такому рекурсивному подходу пришли scrapetube, yt-dlp и Scrapfly — он переживает частые изменения JSON-структуры YouTube.
Шаг 4: экспортируйте данные в CSV или Excel
import csv

with open("youtube_videos.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["video_id", "title", "views", "published"])
    writer.writeheader()
    writer.writerows(videos)

print("Данные экспортированы в youtube_videos.csv")
Когда использовать этот метод, а когда нет
Лучше всего для: быстрого получения метаданных с нескольких страниц канала или видео. Лёгких SEO-инструментов. Разовых анализов, где нужны заголовок, просмотры и дата публикации.
Ограничения: структура JSON меняется — среди известных поломок были рефакторинг кнопки лайка (2023: toggleButtonRenderer → segmentedLikeDislikeButtonViewModel), рефакторинг описания (2023: description.runs[] → attributedDescription.content) и переработка вкладки Videos канала (2022–2023: gridRenderer → richGridRenderer). IP из дата-центров обычно получают soft-block уже после 50–200 запросов. Комментариев нет, транскриптов нет.
Метод 2: парсинг YouTube на Python через Selenium или Playwright
Когда нужно взаимодействовать со страницей — прокручивать результаты поиска, нажимать вкладки, раскрывать описание — лучше всего подходит браузерная автоматизация.
- Сложность: Средний уровень
- Время: примерно 30 минут
- Что понадобится: Python 3.10+, Playwright (
pip install playwright && playwright install) или Selenium + ChromeDriver
Для новых проектов я рекомендую Playwright вместо Selenium. Сравнение TestDino за 2026 год показывает, что Playwright примерно в 1,85 раза быстрее на одно действие, использует примерно в 2,1 раза меньше памяти и даёт примерно в 4 раза больше параллельной ёмкости по сравнению с Selenium. Playwright использует постоянное WebSocket-соединение через Chrome DevTools Protocol, а Selenium работает через WebDriver поверх HTTP, добавляя слой преобразования на каждую команду.
Шаг 1: настройте Playwright
pip install playwright
playwright install chromium
from playwright.sync_api import sync_playwright

pw = sync_playwright().start()
browser = pw.chromium.launch(headless=False)  # headful снижает риск детекта
context = browser.new_context()

# Предустановим cookie consent, чтобы обойти EU wall
context.add_cookies([{
    "name": "SOCS",
    "value": "CAISNQgDEitib3FfaWRlbnRpdHlmcm9udGVuZHVpc2VydmVyXzIwMjMwODI5LjA3X3AxGgJlbiACGgYIgJnPpwY",
    "domain": ".youtube.com",
    "path": "/",
}])

page = context.new_page()
Шаг 2: перейдите на страницу YouTube и дождитесь загрузки контента
page.goto("https://www.youtube.com/@mkbhd/videos")
page.wait_for_selector("a#video-title-link", timeout=15000)
print("Страница загружена — элементы видео видны")
Если ты парсишь результаты поиска, переходи на https://www.youtube.com/results?search_query=your+query.
Шаг 3: обработайте бесконечную прокрутку, чтобы загрузить больше видео
На страницах каналов и поиска YouTube использует бесконечную прокрутку. Вот классический цикл по scrollHeight, адаптированный из гайда Scrapfly по прокрутке:
prev_height = -1
max_scrolls = 20  # ограничьте — канал с 10K видео будет скроллиться бесконечно
scroll_count = 0

while scroll_count < max_scrolls:
    page.evaluate("window.scrollTo(0, document.body.scrollHeight)")
    page.wait_for_timeout(1500)  # ждём загрузки нового контента
    new_height = page.evaluate("document.body.scrollHeight")
    if new_height == prev_height:
        break  # новый контент не подгрузился
    prev_height = new_height
    scroll_count += 1

print(f"Прокрутка выполнена {scroll_count} раз")
Шаг 4: извлеките данные о видео из отрендеренной страницы
video_elements = page.query_selector_all("a#video-title-link")
videos = []

for el in video_elements:
    title = el.inner_text()
    href = el.get_attribute("href")
    video_id = href.split("v=")[-1] if href else None
    videos.append({"title": title, "video_id": video_id, "url": f"https://www.youtube.com{href}"})

print(f"Извлечено видео: {len(videos)}")
Для просмотров и даты публикации нужно доставать соседние элементы. Гайд Crawlee за 2025 год предупреждает, что id="video-title-link" не универсален — у YouTube есть несколько вариантов страниц. Более надёжный запасной вариант — a[href*="watch"].
Шаг 5: экспортируйте в CSV или Google Sheets
import csv

with open("youtube_playwright.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["title", "video_id", "url"])
    writer.writeheader()
    writer.writerows(videos)

browser.close()
pw.stop()
Когда использовать этот метод, а когда нет
Лучше всего для: парсинга результатов поиска, работы с динамическими элементами страницы (клики по вкладкам, раскрытие описаний), любых задач, где нужен полностью отрендеренный DOM.
Ограничения: медленно (примерно 1,5–3 секунды на видео в потоке scroll-extract). Высокий риск антибот-детекта — обычный Selenium выставляет navigator.webdriver === true, и любая JS-проверка это мгновенно видит. Требует много ресурсов: каждый экземпляр браузера потребляет 200–500 МБ RAM. Для 100 видео рассчитывай на 3–8 минут вместо секунд, как у yt-dlp.
Метод 3: парсинг YouTube на Python через yt-dlp
yt-dlp — это швейцарский нож для скрапинга YouTube. Это форк youtube-dl с сообществом, у которого 157 000+ звёзд на GitHub, активные nightly-релизы и встроенная поддержка метаданных, комментариев, транскриптов и пакетного парсинга — без браузера и без API key.
- Сложность: от начального до среднего уровня
- Время: примерно 10 минут
- Что понадобится: Python 3.10+,
pip install yt-dlp
Шаг 1: установите yt-dlp
pip install yt-dlp
Никаких браузерных драйверов, никаких API-ключей, никаких конфигов.
Шаг 2: извлеките метаданные видео без скачивания
import yt_dlp

opts = {
    "quiet": True,
    "skip_download": True,      # без видеофайлов — только метаданные
    "no_warnings": True,
}

with yt_dlp.YoutubeDL(opts) as ydl:
    info = ydl.extract_info(
        "https://www.youtube.com/watch?v=dQw4w9WgXcQ",
        download=False
    )

print(f"Название: {info['title']}")
print(f"Просмотры: {info['view_count']:,}")
print(f"Лайки: {info.get('like_count', 'N/A')}")
print(f"Длительность: {info['duration']}s")
print(f"Дата загрузки: {info['upload_date']}")
print(f"Канал: {info['channel']} ({info.get('channel_follower_count', 'N/A')} подписчиков)")
print(f"Теги: {info.get('tags', [])[:5]}")
Типичный вызов extract_info возвращает 80–120 полей в зависимости от состояния видео: id, title, channel, channel_id, channel_follower_count, view_count, like_count, comment_count, upload_date, duration, tags, categories, description, thumbnails, is_live, availability, automatic_captions, subtitles, chapters, heatmap и многое другое.
Шаг 3: извлеките комментарии из видео YouTube
opts = {
    "quiet": True,
    "skip_download": True,
    "getcomments": True,
    "extractor_args": {
        "youtube": {
            "max_comments": ["200", "50", "50", "10"],  # всего, родителей, ответов на родителя, всего ответов
            "comment_sort": ["top"],
        }
    },
}

with yt_dlp.YoutubeDL(opts) as ydl:
    info = ydl.extract_info(
        "https://www.youtube.com/watch?v=dQw4w9WgXcQ",
        download=False
    )

comments = info.get("comments", [])
print(f"Получено комментариев: {len(comments)}")
for c in comments[:3]:
    print(f"  [{c.get('like_count', 0)} лайков] {c['author']}: {c['text'][:80]}...")
Извлечение комментариев идёт медленно. В Issue #3532 yt-dlp указана скорость около 30 КБ/с — для видео со 100 тыс. комментариев это может занять часы. Issue #11849 описывает случаи, когда URL форматов истекают (~через 6 часов) ещё до завершения пагинации комментариев. Для больших видео задавай max_comments максимально агрессивно.
Шаг 4: извлеките транскрипты и субтитры
Ни YouTube Data API, ни разбор BS4 не дадут тебе полный транскрипт. Это уникальное преимущество yt-dlp.
opts = {
    "quiet": True,
    "skip_download": True,
    "writesubtitles": True,
    "writeautomaticsub": True,
    "subtitleslangs": ["en", "en-orig"],
    "subtitlesformat": "json3",   # удобно для парсинга: start/dur в ms + текст
    "outtmpl": "%(id)s.%(ext)s",
}

with yt_dlp.YoutubeDL(opts) as ydl:
    info = ydl.extract_info(
        "https://www.youtube.com/watch?v=dQw4w9WgXcQ",
        download=False
    )

# Получаем данные субтитров напрямую из info dict
auto_captions = info.get("automatic_captions", {})
manual_subs = info.get("subtitles", {})
print(f"Языки автосубтитров: {list(auto_captions.keys())[:10]}")
print(f"Языки ручных субтитров: {list(manual_subs.keys())}")
Формат json3 лучше всего подходит для машинного парсинга — каждый сегмент содержит start/dur в миллисекундах и текстовые фрагменты. Коды языков используют BCP-47 (en, en-US, zh-Hans, ja, es).
Шаг 5: пакетно парсите несколько видео или весь канал
opts = {
    "quiet": True,
    "skip_download": True,
    "extract_flat": "in_playlist",  # быстро — только ID видео и заголовки
    "sleep_interval": 2,
    "max_sleep_interval": 6,
}

with yt_dlp.YoutubeDL(opts) as ydl:
    info = ydl.extract_info(
        "https://www.youtube.com/@mkbhd/videos",
        download=False
    )

entries = info.get("entries", [])
print(f"Найдено видео на канале: {len(entries)}")
for e in entries[:5]:
    print(f"  {e.get('title', 'N/A')} — {e.get('id')}")
Передай URL канала, плейлиста или даже поисковый запрос (ytsearch10:python scraping) — и yt-dlp сам обработает пагинацию.
Когда использовать этот метод, а когда нет
Лучше всего для: массового извлечения метаданных, комментариев, транскриптов, скачивания видео, скрапа всего канала, когда нужен полный набор полей.
Ограничения: не лучший вариант для поиска по страницам результатов поиска (для этого Selenium/Playwright удобнее). В 2024–2026 годы антибот-гонка усложнила масштабный запуск yt-dlp — YouTube теперь на некоторых клиентах требует BotGuard attestation и PO Tokens. Для production используй плагин bgutil-ytdlp-pot-provider и --cookies-from-browser chrome (с одноразовым аккаунтом — команда yt-dlp предупреждает, что cookies от настоящего Google-аккаунта могут привести к бану этого аккаунта).
Метод 4: парсинг YouTube на Python через YouTube Data API
Официальный YouTube Data API v3 — самый надёжный и структурированный способ получить данные YouTube. Ответы приходят в чистом JSON, поля документированы, и никакой игры в кошки-мышки с антиботом нет. Но есть нюанс, который часто замалчивают в туториалах: система квот.
- Сложность: Средний уровень
- Время: примерно 20 минут (включая настройку API key)
- Что понадобится: Python 3.10+, проект в Google Cloud,
pip install google-api-python-client
Шаг 1: получите ключ YouTube Data API
- Перейди в Google Cloud Console
- Создай новый проект или выбери существующий
- Открой APIs & Services → Library → найди "YouTube Data API v3" → Enable
- Перейди в APIs & Services → Credentials → Create Credentials → API Key
- Скопируй ключ — он понадобится в коде ниже
Шаг 2: выполните первый API-запрос
from googleapiclient.discovery import build

API_KEY = "YOUR_API_KEY_HERE"
youtube = build("youtube", "v3", developerKey=API_KEY)

# Получаем данные конкретного видео
response = youtube.videos().list(
    part="snippet,statistics,contentDetails",
    id="dQw4w9WgXcQ"
).execute()

video = response["items"][0]
print(f"Название: {video['snippet']['title']}")
print(f"Просмотры: {video['statistics']['viewCount']}")
print(f"Лайки: {video['statistics'].get('likeCount', 'скрыты')}")
print(f"Комментарии: {video['statistics'].get('commentCount', 'отключены')}")
print(f"Длительность: {video['contentDetails']['duration']}")
print(f"Теги: {video['snippet'].get('tags', [])[:5]}")
Ответ чистый, типизированный и документированный. Никакой археологии по JSON не требуется.
Шаг 3: извлеките детали видео, информацию о канале и комментарии
# Поиск видео
search_response = youtube.search().list(
    part="snippet",
    q="python web scraping tutorial",
    type="video",
    maxResults=10,
    order="viewCount"
).execute()

for item in search_response["items"]:
    print(f"  {item['snippet']['title']} — {item['id']['videoId']}")

# Комментарии
comments_response = youtube.commentThreads().list(
    part="snippet",
    videoId="dQw4w9WgXcQ",
    maxResults=20,
    order="relevance"
).execute()

for item in comments_response["items"]:
    comment = item["snippet"]["topLevelComment"]["snippet"]
    print(f"  [{comment['likeCount']} лайков] {comment['authorDisplayName']}: {comment['textDisplay'][:80]}")
Реальность квот YouTube API (о чём обычно не говорят)
Это тот раздел, который отличает действительно полезный гайд от обычного copy-paste туториала. Стандартная квота — 10 000 единиц в день, сбрасывается в полночь по тихоокеанскому времени. Вот сколько стоит каждый вызов:
| API endpoint | Стоимость за вызов | Максимум результатов за вызов |
|---|---|---|
search.list | 100 единиц | 50 результатов |
videos.list | 1 единица | 50 ID видео (батчем) |
channels.list | 1 единица | 50 ID каналов |
commentThreads.list | 1 единица | 100 комментариев |
captions.list | 50 единиц | Н/Д |
Теперь математика. Допустим, ты хочешь собрать 1000 результатов поиска:
- Поисковые запросы: 1000 результатов ÷ 50 на страницу = 20 вызовов × 100 единиц = 2000 единиц (20% дневного бюджета — и это только поиск)
- Детали видео для этих 1000 роликов: 1000 ID ÷ 50 за батч = 20 вызовов × 1 единица = 20 единиц (дёшево — batched
videos.listреально спасает) - Комментарии к этим 1000 видео (если взять по одной странице на видео): 1000 вызовов × 1 единица = 1000 единиц
Итого: около 3020 единиц на умеренный сбор. Но если у видео глубокие ветки комментариев (50+ страниц каждое), оставшиеся 7000 единиц исчезнут очень быстро. Видео с 50 000 комментариев = примерно 500 страниц = 500 единиц. Собери 20 таких видео — и на сегодня всё.
Процесс увеличения квоты требует полноценной проверки соответствия: URL политики конфиденциальности, URL Terms of Service, видеодемонстрация приложения, обоснование расчёта квот. По сообщениям сообщества, обычный ответ Google приходит за 3–5 рабочих дней, полное одобрение может занять недели или месяцы, а многие заявки отклоняют — особенно если причина звучит как «нужны дополнительные данные для аналитики».
Когда использовать API: небольшие и средние объёмы, когда нужны структурированные и надёжные данные, когда важны комментарии и статистика канала, и когда вас устраивает потолок квоты.
Когда парсинг лучше: крупные проекты (>10K видео/день), поля, которых нет в API (полные транскрипты — captions.download требует OAuth и разрешения владельца видео), или когда нужно больше 500 результатов поиска на один запрос (жёсткий лимит API, независимо от totalResults).
No-code альтернатива: парсинг YouTube через Thunderbit без Python
Если Python нужен тебе как часть data pipeline — используй методы 1–4 выше. Но если данные из YouTube нужны за 2 минуты — например, ты маркетолог и собираешь статистику по конкурентам, или разработчик, которому нужен быстрый выгруз без настройки окружения, — есть более быстрый путь.
Thunderbit — это AI web scraper в виде расширения для Chrome, которое мы создали именно для случаев, когда писать код слишком затратно. Оно работает прямо на страницах YouTube в твоём браузере.
Как парсить YouTube с Thunderbit за 3 шага
Шаг 1: установи расширение Thunderbit для Chrome и открой страницу канала YouTube, результаты поиска или страницу видео.
Шаг 2: нажми "AI Suggest Fields" в боковой панели Thunderbit. AI прочитает страницу и предложит столбцы вроде названия видео, просмотров, даты загрузки, длительности, названия канала и URL миниатюры. При необходимости ты можешь добавлять, удалять и переименовывать столбцы.
Шаг 3: нажми "Scrape" и экспортируй данные в Google Sheets, Excel, CSV, Airtable или Notion. Данные попадут в аккуратную таблицу, готовую к работе.
Попробовать Thunderbit для парсинга YouTube
Кому это подойдёт
- Маркетологам, которым нужны данные по каналам конкурентов, но они не пишут код
- Разработчикам, которым нужен быстрый выгруз без настройки virtual environment и установки зависимостей
- Тем, кто упирается в антибот-защиту — Thunderbit работает в твоём собственном авторизованном браузерном сеансе и использует твои cookies и PO tokens. Это помогает обойти многие блокировки, с которыми сталкиваются серверные скрапер-решения
- Thunderbit также может использовать subpage scraping, чтобы заходить на каждую страницу видео и обогащать таблицу дополнительными полями (лайки, описание, теги)
Если хочешь глубже разобраться, как Thunderbit работает именно с YouTube, загляни в шаблон Thunderbit YouTube Channel Scraper и на канал Thunderbit на YouTube.
Как парсить YouTube на Python и не получить блокировку
Эти советы подходят для всех четырёх Python-методов. Антибот-защита YouTube оценивается как 6/10 по сложности в ScrapeOps, и основные сигналы детекта — это поведение IP, необходимость исполнять JS и часто меняющаяся HTML-структура.
Для всех методов:
- Меняй User-Agent и весь набор заголовков целиком —
Accept,Accept-Language,Sec-CH-UAи client hints должны совпадать с заявленным UA. Гид ScraperAPI за 2026 год содержит актуальный список. - Добавляй случайные паузы 2–8 секунд между запросами. Фиксированные интервалы — это сигнал для детекта.
- Используй residential proxies, если работаешь не с парой страниц. IP из дата-центров (AWS, GCP, Hetzner) к 2025–2026 годам фактически бесполезны для скрапинга YouTube.
- Меняй сессию и IP одновременно — YouTube связывает сессии с IP, и один и тот же session cookie на двух IP выглядит подозрительно.
Для requests + BS4: задай cookie CONSENT=YES+cb. Без него запросы из ЕС будут редиректиться на страницу согласия без данных.
Для Selenium/Playwright: на Linux-серверах запускай headful с xvfb, а не --headless=new — headless Chrome всё ещё выдаёт достаточно фингерпринтов, чтобы продвинутые детекторы его распознали. Можно рассмотреть playwright-stealth, который применяет около 17 обходов.
Для yt-dlp: используй sleep_interval и max_sleep_interval. Установи плагин bgutil-ytdlp-pot-provider для генерации PO Token. Используй --cookies-from-browser chrome с одноразовым аккаунтом.
Для API: отслеживай расход квоты в Google Cloud Console и эффективно батчь запросы. Один вызов videos.list с 50 ID через запятую стоит 1 единицу — используй это.
Для Thunderbit: антибот-защита обрабатывается автоматически, потому что скрапинг происходит в твоём браузерном сеансе. По сути, ты просто автоматизируешь то, что и так делал бы вручную.
Законно ли парсить YouTube на Python?
Это зависит от того, что именно ты парсишь, как ты это делаешь и что потом делаешь с данными.
Юридический ландшафт изменился в 2024 году после дела Meta Platforms v. Bright Data (Северный округ Калифорнии, январь 2024), где судья Chen постановил, что ToS Meta запрещает только парсинг для вошедших в аккаунт пользователей, но не для неавторизованного (публичного) доступа. После этого сбор публично доступных данных стал «значительно менее рискованным». С другой стороны, дело hiQ v. LinkedIn завершилось решением о выплате 500 000 долларов против hiQ за нарушение ToS, нарушение CFAA (фальшивые аккаунты) и trespass to chattels — плюс постоянный судебный запрет.
Собственные Условия использования YouTube сформулированы жёстко: «Вам запрещено использовать автоматизированные средства (например, роботы, ботнеты или скраперы) для доступа к сервису», кроме случаев, когда есть письменное разрешение или это разрешено действующим законодательством. Официально одобренный способ доступа к данным — это YouTube Data API.
Несколько практических правил:
- Сбор открыто видимых данных для личного исследования или некоммерческого анализа обычно менее рискован
- API — самый безопасный путь, потому что он прямо разрешён
- Не парси приватный или закрытый за логином контент, не скачивай защищённые авторским правом видео для дальнейшего распространения и не нарушай GDPR, если обрабатываешь персональные данные из комментариев
- Комментарии YouTube содержат персональные данные в смысле GDPR Art. 4(1) — обращайся с информацией об участниках из ЕС осторожно
- Для коммерческих scraping-проектов проконсультируйся с юристом
Это не юридическая консультация. Ситуация быстро меняется — новая волна исков по DMCA §1201 от авторов против AI-компаний, которые скрапили YouTube для обучающих данных, уже меняет рынок в 2025–2026 годах.
Какой метод выбрать для парсинга YouTube на Python?
Короткий гид по выбору:
- Нужны быстрые метаданные с нескольких страниц? → Метод 1 (requests + BS4). Быстро, легко, почти без зависимостей, кроме
requestsиbeautifulsoup4. - Нужно парсить результаты поиска или работать с динамическими страницами? → Метод 2 (Selenium/Playwright). Полный рендеринг браузером, поддержка бесконечной прокрутки, но медленно и заметно для детекторов.
- Нужны массовые метаданные, комментарии или транскрипты? → Метод 3 (yt-dlp). Самый мощный одиночный инструмент — и 157K+ звёзд не случайно.
- Нужны структурированные и надёжные данные в умеренном масштабе? → Метод 4 (YouTube Data API). Официально, чисто, но ограничено квотой 10 000 единиц в день.
- Нужны данные за 2 минуты без кода? → Thunderbit. Браузерное решение на AI, экспорт в Google Sheets в пару кликов.
Ни один метод не закрывает все кейсы. Добавь в закладки таблицу сравнения и справку по извлекаемым полям выше — это сэкономит время в следующем проекте. А если хочешь изучить ещё больше подходов к web scraping, в блоге Thunderbit есть много материалов: от гайдов по Python scraping до сбора данных в Google Sheets.
Попробовать Thunderbit для парсинга YouTube Get Started Free
FAQ
Можно ли парсить YouTube без API key?
Да. Методы 1 (requests + BS4), 2 (Selenium/Playwright) и 3 (yt-dlp) не требуют API key. Он нужен только для Метода 4 (YouTube Data API). Thunderbit тоже работает без API key — он скрапит данные прямо в твоём браузере.
Какой самый быстрый способ парсить YouTube на Python?
Для Python самыми быстрыми будут yt-dlp и requests + BS4 — оба обходятся без браузера и могут получать метаданные за считанные секунды на видео. yt-dlp особенно быстр для пакетной обработки, потому что сам управляет пагинацией. Для тех, кто не пишет на Python, Thunderbit — самый быстрый вариант в целом, потому что настройка вообще не нужна.
Как парсить комментарии YouTube на Python?
yt-dlp имеет встроенное извлечение комментариев через опцию getcomments — это самый простой путь. YouTube Data API тоже поддерживает комментарии через commentThreads.list (1 единица квоты за вызов, до 100 комментариев на страницу). Selenium/Playwright технически тоже могут это сделать через прокрутку и извлечение отрендеренных элементов, но это медленно и ненадёжно.
Можно ли парсить YouTube Shorts на Python?
Да. yt-dlp хорошо обрабатывает метаданные Shorts — он воспринимает их как обычные видео с дополнительными полями, специфичными для Shorts. YouTube Data API поддерживает Shorts частично (подсчёт просмотров Shorts изменился 30 апреля 2025 года — теперь просмотром считается любое начало воспроизведения/повтор). У BS4 и Selenium/Playwright поддержка Shorts ограничена, потому что shelf Shorts использует другую DOM-структуру.
Сколько видео YouTube можно парсить в день?
С YouTube Data API ты ограничен примерно 10 000 единицами квоты в день. При использовании batched videos.list (50 ID за вызов и 1 единица) это теоретически даёт до 500 000 проверок статусов видео в день — но search.list по 100 единиц за вызов быстро съедает бюджет. Для scraping-методов (BS4, Selenium, yt-dlp) лимит скорее практический, чем жёстко прописанный: блокировки IP обычно начинаются после нескольких сотен или нескольких тысяч запросов на IP в день, в зависимости от прокси и паттерна запросов. Thunderbit использует систему кредитов, зависящую от твоего плана.
Узнать больше



