
Есть что-то странно приятное в том, как скрипт молнией проходит по сайту и собирает данные, пока вы пьёте кофе. Если вы похожи на меня, то наверняка не раз задавались вопросом: «Как сделать web scraping быстрее, умнее и без лишней головной боли?»
Именно это и привело меня в мир web scraping с OpenClaw. В цифровой среде, где более 90% компаний полагаются на извлечение веб-данных для всего — от лидов до рыночной аналитики, — владение правильными инструментами уже не просто технарский понт, а бизнес-необходимость.
OpenClaw быстро стал любимцем в сообществе скрейпинга, особенно у тех, кто работает с динамичными, насыщенными изображениями или сложными сайтами, от которых традиционные скрейперы начинают задыхаться.
В этом руководстве я проведу вас через всё: от настройки OpenClaw до построения продвинутых автоматизированных рабочих процессов. А ещё, поскольку я люблю экономить время, покажу, как усилить ваш scraping с помощью AI-функций Thunderbit — получится не просто мощный, а по-настоящему удобный и даже увлекательный процесс.
Попробуйте Thunderbit для более умного web scraping
Что такое web scraping с OpenClaw?
Начнём с основ. Web scraping с OpenClaw — это использование платформы OpenClaw, self-hosted open-source шлюза для агентов, чтобы автоматизировать извлечение данных с сайтов. OpenClaw — это не просто ещё один скрейпер; это модульная система, которая связывает ваши любимые каналы общения, вроде Discord или Telegram, с набором инструментов для агентов: веб-загрузчиками, поисковыми утилитами и даже управляемым браузером для тех сайтов на JavaScript, от которых другие инструменты начинают потеть.
Что делает OpenClaw особенно сильным инструментом для извлечения веб-данных? Он спроектирован так, чтобы быть одновременно гибким и надёжным. Вы можете использовать встроенные инструменты вроде web_fetch для простого HTTP-извлечения, запускать управляемый агентом браузер Chromium для динамического контента или подключать навыки, созданные сообществом, например openclaw-plugin-web-scraper, для более сложных сценариев. Это open-source решение (лицензия MIT), которое активно поддерживается и имеет живую экосистему плагинов и навыков, что делает его отличным выбором для тех, кто серьёзно занимается масштабным скрейпингом.
OpenClaw работает с широким спектром типов данных и форматов сайтов, включая:
- Текст и структурированный HTML
- Изображения и ссылки на медиа
- Динамический контент, рендерящийся с помощью JavaScript
- Сложные многоуровневые DOM-структуры
А поскольку система построена вокруг агентов, вы можете организовывать задачи по сбору данных, автоматизировать отчётность и даже взаимодействовать с данными в реальном времени — и всё это прямо из любимого чата или терминала.
Почему OpenClaw — мощный инструмент для извлечения веб-данных
Почему же столько специалистов по данным и любителей автоматизации тянутся к OpenClaw? Разберём технические сильные стороны, которые делают его настоящей машиной для web scraping:
Скорость и совместимость
Архитектура OpenClaw создана для скорости. Его основной инструмент web_fetch использует HTTP GET-запросы с умным извлечением контента, кэшированием и обработкой редиректов. В внутренних и сообществом проведённых тестах OpenClaw стабильно обходит классические инструменты вроде BeautifulSoup или Selenium при извлечении больших объёмов данных со статичных и полу-динамичных сайтов (docs.openclaw.ai).
Но по-настоящему OpenClaw раскрывается в совместимости. Благодаря режиму управляемого браузера он справляется с сайтами, которые полагаются на JavaScript при рендеринге — именно на этом часто спотыкаются многие традиционные скрейперы. Неважно, работаете ли вы с насыщенным изображениями каталогом e-commerce или с одностраничным приложением с бесконечной прокруткой, управляемый агентом профиль Chromium в OpenClaw справится с задачей.
Устойчивость к изменениям сайта
Одна из самых больших головных болей в web scraping — это обновления сайта, которые ломают ваши скрипты. Система плагинов и навыков OpenClaw спроектирована так, чтобы быть устойчивой к таким изменениям. Например, обёртки вокруг библиотеки Scrapling обеспечивают адаптивное извлечение, то есть ваш скрейпер может «подстраивать» элементы, даже если структура сайта изменилась — это огромный плюс для долгосрочных проектов.
Реальная производительность
В сравнительных тестах рабочие процессы на базе OpenClaw показали:
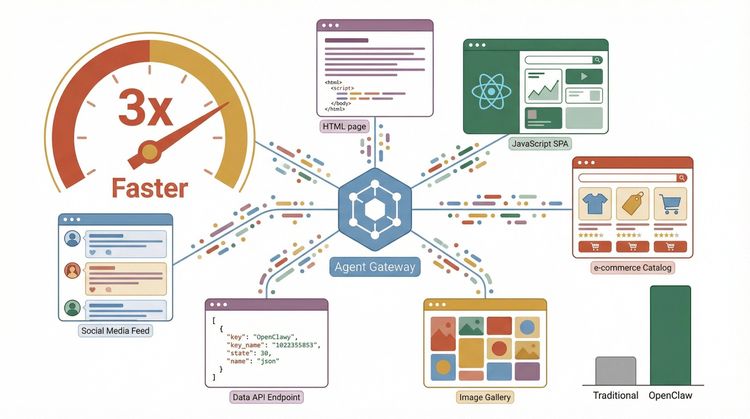
- До 3 раз более быструю обработку сложных многостраничных сайтов по сравнению с традиционными Python-скрейперами (scrapling.readthedocs.io)
- Более высокую успешность на динамичных страницах с интенсивным использованием JavaScript благодаря управляемому браузеру
- Лучшую работу со страницами со смешанным контентом (текст, изображения, фрагменты HTML)
Отзывы пользователей часто подчёркивают способность OpenClaw «просто работать» там, где другие инструменты терпят неудачу, особенно при сборе данных с сайтов со сложной вёрсткой или антибот-защитой.
С чего начать: настройка OpenClaw для web scraping
Готовы погрузиться? Вот как запустить OpenClaw у себя.
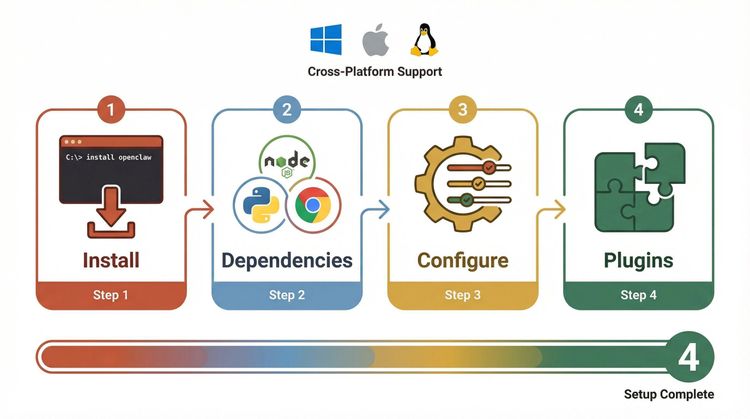
Шаг 1: Установите OpenClaw
OpenClaw поддерживает Windows, macOS и Linux. В официальной документации рекомендуют начать с пошагового onboarding-процесса:
openclaw onboard
Эта команда проведёт вас через начальную настройку, включая проверку окружения и базовую конфигурацию.
Шаг 2: Установите необходимые зависимости
В зависимости от вашего сценария вам могут понадобиться:
- Node.js — для основного шлюза
- Python 3.10+ — для плагинов и навыков, использующих Python, например обёрток над Scrapling
- Chromium/Chrome — для режима управляемого браузера
В Linux, возможно, придётся установить дополнительные пакеты для поддержки браузера. В документации есть отдельный раздел по устранению неполадок для типичных проблем.
Шаг 3: Настройте веб-инструменты
Укажите поставщика веб-поиска:
openclaw configure --section web
Это позволит выбрать одного из провайдеров, например Brave, DuckDuckGo или Firecrawl.
Шаг 4: Установите плагины или навыки (необязательно)
Чтобы открыть доступ к продвинутому scraping, установите плагины или навыки сообщества. Например, чтобы добавить openclaw-plugin-web-scraper:
git clone https://github.com/hvkeyn/openclaw-plugin-web-scraper.git
cd openclaw-plugin-web-scraper
openclaw plugins install .
openclaw gateway restart
Полезные советы для новичков
- После установки новых плагинов запускайте
openclaw security audit, чтобы проверить наличие уязвимостей (docs.openclaw.ai). - Если вы используете Node через nvm, ещё раз проверьте CA-сертификаты — их несоответствие может ломать HTTPS-запросы (docs.openclaw.ai).
- Всегда изолируйте плагины и браузерные компоненты в VM или контейнере для дополнительной безопасности.
Руководство для новичков: ваш первый проект по scraping в OpenClaw
Давайте соберём простой проект для извлечения данных — для этого не нужна степень PhD по компьютерным наукам.
Шаг 1: Выберите целевой сайт
Выберите сайт со структурированными данными, например каталог товаров или справочник. Для примера возьмём извлечение названий товаров с демо-страницы e-commerce.
Шаг 2: Разберитесь со структурой DOM
Используйте инструмент браузера «Просмотреть элемент», чтобы найти HTML-теги, в которых находятся нужные вам данные (например, <h2 class="product-title">).
Шаг 3: Настройте фильтры извлечения
С помощью навыков OpenClaw на базе Scrapling можно использовать CSS-селекторы для выбора элементов. Вот пример скрипта с навыком openclaw-ultra-scraping:
PYTHON=/opt/scrapling-venv/bin/python3
$PYTHON scripts/scrape.py fetch "https://example.com/products" --css "h2.product-title::text"
Эта команда загружает страницу и извлекает все названия товаров.
Шаг 4: Безопасная работа с данными
Экспортируйте результаты в CSV или JSON для удобного анализа:
$PYTHON scripts/scrape.py fetch "https://example.com/products" --css "h2.product-title::text" -f csv -o products.csv
Ключевые понятия
- Схемы инструментов: определяют, что может делать каждый инструмент или навык — загружать, извлекать, обходить сайт.
- Регистрация навыков: добавление новых возможностей scraping в OpenClaw через ClawHub или ручную установку.
- Безопасная работа с данными: всегда проверяйте и очищайте результаты перед использованием в продакшене.
Автоматизация сложных рабочих процессов scraping с OpenClaw
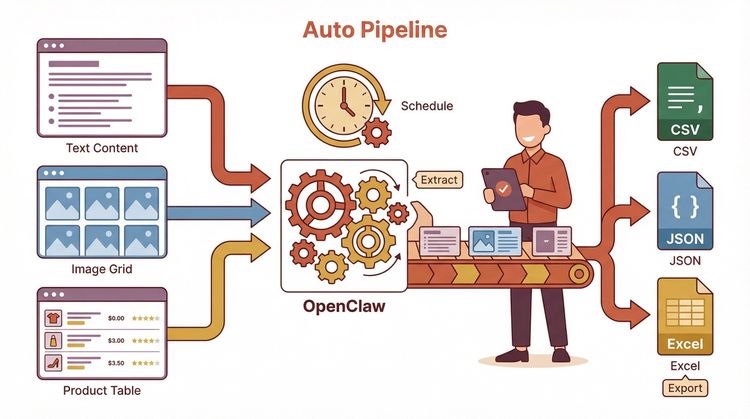
Когда вы освоили основы, пора автоматизировать процесс. Вот как построить рабочий процесс, который работает сам, пока вы занимаетесь чем-то более важным — например, обедом.
Шаг 1: Создайте и зарегистрируйте собственные навыки
Напишите или установите навыки, которые соответствуют вашим задачам извлечения. Например, вам может понадобиться собирать данные о товарах и изображения, а затем отправлять ежедневный отчёт.
Шаг 2: Настройте расписание задач
В Linux или macOS используйте cron, чтобы запускать скрипты scraping по расписанию:
0 6 * * * /usr/bin/python3 /path/to/scrape.py fetch "https://example.com/products" --css "h2.product-title::text" -f csv -o /data/products_$(date +\%F).csv
В Windows можно использовать Task Scheduler с аналогичными параметрами.
Шаг 3: Интегрируйте с другими инструментами
Для динамической навигации (например, кликов по кнопкам или входа в систему) сочетайте OpenClaw с Selenium или Playwright. Многие навыки OpenClaw могут вызывать эти инструменты или принимать скрипты браузерной автоматизации.
Сравнение ручного и автоматизированного процесса
| Шаг | Ручной процесс | Автоматизированный процесс OpenClaw |
|---|---|---|
| Извлечение данных | Запускать скрипт вручную | По расписанию через cron/Task Scheduler |
| Динамическая навигация | Кликать вручную | Автоматически с Selenium/навыками |
| Экспорт данных | Копировать/вставлять или скачивать | Автоэкспорт в CSV/JSON |
| Отчётность | Ручная сводка | Автогенерация и отправка отчётов |
| Обработка ошибок | Исправлять по ходу | Встроенные повторные попытки и логирование |
Итог? Больше данных, меньше рутины и рабочий процесс, который масштабируется вместе с вашими амбициями.
Повышаем эффективность: интеграция AI-функций Thunderbit с OpenClaw
А вот здесь начинается самое интересное. Как сооснователь Thunderbit, я искренне верю в сочетание лучшего из двух миров: гибкого движка для scraping в OpenClaw и AI-функций Thunderbit для определения полей и экспорта.
Как Thunderbit усиливает OpenClaw
- AI Suggest Fields: Thunderbit может автоматически анализировать веб-страницу и рекомендовать лучшие столбцы для извлечения — больше не нужно гадать с CSS-селекторами.
- Мгновенный экспорт данных: выгружайте собранные данные прямо в Excel, Google Sheets, Airtable или Notion одним кликом (Thunderbit Docs).
- Гибридный workflow: используйте OpenClaw для сложной навигации и логики scraping, а затем передавайте результаты в Thunderbit для сопоставления полей, обогащения и экспорта.
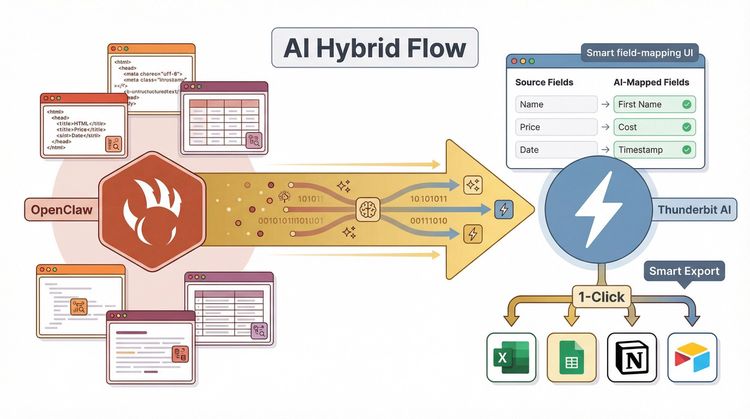
Пример гибридного workflow
- Используйте управляемый браузер OpenClaw или навык Scrapling, чтобы извлечь сырые данные с динамического сайта.
- Импортируйте результаты в Thunderbit.
- Нажмите «AI Suggest Fields», чтобы автоматически сопоставить данные.
- Экспортируйте в нужный формат или платформу.
Такое сочетание меняет правила игры для команд, которым нужны и мощность, и простота использования — например, для sales ops, e-commerce-аналитиков и всех, кто устал разбираться с хаотичными таблицами.
Попробуйте AI Suggest Fields в Thunderbit
Устранение неполадок в реальном времени: частые ошибки OpenClaw и способы их исправить
Даже лучшие инструменты иногда дают сбой. Вот короткое руководство по диагностике и исправлению типичных проблем OpenClaw при scraping:
Частые ошибки
- Проблемы с аутентификацией: некоторые сайты блокируют ботов или требуют входа. Используйте управляемый браузер OpenClaw или интеграцию с Selenium для сценариев авторизации (docs.openclaw.ai).
- Блокировка запросов: ротируйте user-agent, используйте прокси или снизьте частоту запросов, чтобы избежать банов.
- Ошибки парсинга: ещё раз проверьте селекторы CSS/XPath; структура сайта могла измениться.
- Ошибки плагинов/навыков: запустите
openclaw plugins doctor, чтобы диагностировать проблемы с установленными расширениями (docs.openclaw.ai).
Диагностические команды
openclaw status— проверка состояния шлюза и инструментов.openclaw security audit— поиск уязвимостей.openclaw browser --browser-profile openclaw status— проверка состояния browser automation.
Ресурсы сообщества
Лучшие практики для надёжного и масштабируемого scraping с OpenClaw
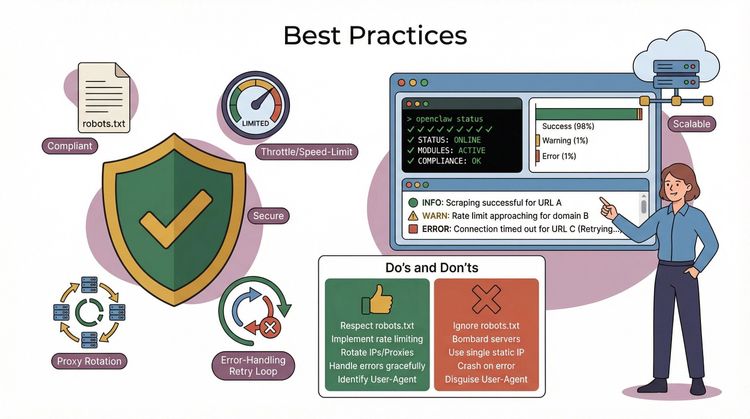
Хотите, чтобы ваш scraping был стабильным и устойчивым? Вот мой чеклист:
- Уважайте robots.txt: собирайте только те данные, которые вам разрешено собирать.
- Ограничивайте частоту запросов: не обрушивайте сайты слишком большим числом запросов в секунду.
- Проверяйте результаты: всегда убеждайтесь в полноте и точности данных.
- Отслеживайте использование: ведите логи запусков и следите за ошибками или банами.
- Используйте прокси для масштаба: ротируйте IP, чтобы не упираться в лимиты скорости.
- Разворачивайте в облаке: для крупных задач запускайте OpenClaw в VM или в контейнерной среде.
- Корректно обрабатывайте ошибки: закладывайте в скрипты повторные попытки и fallback-логику.
| Что делать | Чего не делать |
|---|---|
| Использовать официальные плагины/навыки | Без проверки ставить непроверенный код |
| Регулярно проводить аудит безопасности | Игнорировать предупреждения об уязвимостях |
| Тестировать на staging перед продакшеном | Собирать чувствительные или приватные данные |
| Документировать рабочие процессы | Полагаться на жёстко зашитые селекторы |
Продвинутые советы: настройка и расширение OpenClaw под уникальные задачи
Если вы готовы работать на максимум, OpenClaw позволяет создавать собственные навыки и плагины под специальные задачи.
Разработка собственных навыков
- Следуйте документации OpenClaw по SDK навыков, чтобы создавать новые инструменты извлечения.
- Используйте Python или TypeScript — в зависимости от того, что вам удобнее.
- Зарегистрируйте свой навык в ClawHub, чтобы его было легко делиться и переиспользовать.
Продвинутые возможности
- Цепочки навыков: комбинируйте несколько этапов извлечения, например сначала собирайте список страниц, а затем переходите на каждую страницу деталей.
- Безголовые браузеры: используйте управляемый Chromium от OpenClaw или интегрируйте Playwright для сайтов с активным использованием JavaScript.
- Интеграция AI-агентов: подключайте OpenClaw к внешним AI-сервисам для более умного парсинга и обогащения данных.
Обработка ошибок и управление контекстом
- Закладывайте в навыки надёжную обработку ошибок (try/except в Python, callbacks ошибок в TypeScript).
- Используйте контекстные объекты, чтобы передавать состояние между шагами scraping.
Для вдохновения загляните в навыки, созданные сообществом и в справочник API Scrapling.
Выводы и ключевые тезисы
Мы прошли большой путь — от установки OpenClaw и первого запуска до построения автоматизированных гибридных workflow с Thunderbit. Вот что, надеюсь, вы запомните:
- OpenClaw — это гибкий open-source-мощный инструмент для извлечения веб-данных, особенно на сложных и динамичных сайтах.
- Его экосистема плагинов и навыков позволяет решать всё — от простого fetch до продвинутого многошагового scraping.
- Сочетание OpenClaw с AI-функциями Thunderbit делает сопоставление полей, экспорт данных и автоматизацию рабочих процессов максимально простыми.
- Соблюдайте безопасность и комплаенс: проверяйте окружение, следуйте правилам сайта и валидации данных.
- Не бойтесь экспериментировать: сообщество OpenClaw активно и открыто — подключайтесь, пробуйте новые навыки и делитесь результатами.
Если вы хотите ещё сильнее повысить эффективность scraping, Thunderbit готов помочь. А если хотите продолжить обучение, загляните в блог Thunderbit за новыми глубокими разборами и практическими гайдами.
Удачного scraping — и пусть ваши селекторы всегда попадают точно в цель.
FAQ
1. Чем OpenClaw отличается от традиционных web-скрейперов вроде BeautifulSoup или Scrapy?
OpenClaw построен как шлюз для агентов с модульными инструментами, поддержкой управляемого браузера и системой плагинов/навыков. Благодаря этому он гибче для динамичных, насыщенных JavaScript или изображениями сайтов и проще для полной автоматизации end-to-end-процессов по сравнению с традиционными, сильно завязанными на код фреймворками (docs.openclaw.ai).
2. Можно ли использовать OpenClaw, если я не разработчик?
Да! Процесс onboarding и экосистема плагинов у OpenClaw дружелюбны к новичкам. Для более сложных задач можно использовать навыки, созданные сообществом, или сочетать OpenClaw с no-code-инструментами вроде Thunderbit для удобного сопоставления полей и экспорта.
3. Как устранить типичные ошибки OpenClaw?
Начните с openclaw status и openclaw security audit. Если проблема в плагинах, используйте openclaw plugins doctor. Смотрите официальную документацию и GitHub Issues для решения распространённых проблем.
4. Безопасно и законно ли использовать OpenClaw для web scraping?
Как и с любым скрейпером, всегда соблюдайте условия использования сайта и robots.txt. OpenClaw — open-source и работает локально, но вам всё равно нужно проверять плагины на безопасность и не собирать чувствительные или приватные данные без разрешения (github.com).
5. Как объединить OpenClaw с Thunderbit для лучших результатов?
Используйте OpenClaw для сложной логики scraping, а затем импортируйте сырые данные в Thunderbit. AI Suggest Fields автоматически сопоставит ваши данные, а затем вы сможете напрямую экспортировать их в Excel, Google Sheets, Notion или Airtable — и ваш workflow станет быстрее и надёжнее (Thunderbit Docs).
Хотите увидеть, как Thunderbit может вывести ваш scraping на новый уровень? Скачайте расширение Chrome и уже сегодня начинайте строить более умные гибридные workflow. И не забудьте заглянуть на YouTube-канал Thunderbit за практическими уроками и советами.
Попробуйте Thunderbit для более умного web scraping Get Started Free
Узнать больше
- Как установить расширение Claude для Chrome: простое руководство
- Что такое Markdown for Agents в Cloudflare? Подробный обзор
- Топ-10 лучших инструментов для data crawling и эффективного извлечения веб-данных
- Топ-10 лучших программ для web scraper в 2026 году
- Как эффективно искать email-адрес в 2026 году




