
MarkItDown часто относят к веб-скраперам — и это ошибка. У него нет краулера, JavaScript-движка и возможности открыть URL, забрать страницу и очистить её от лишней обвязки. Его задача другая: взять уже имеющиеся у вас байты — PDF, Word-документ, таблицу, презентацию — и преобразовать всё это в Markdown, который может читать языковая модель.
В течение пары недель я прогонял Microsoft MarkItDown через набор реальных документов на одном Mac, сверяя каждую таблицу с заранее подготовленным манифестом и замеряя время каждого преобразования. Коротко: на чистых данных он быстрый и точный, в установочный пакет незаметно входит 73 МБ машинного обучения, которое вы не просили, а таблицы ломаются так, что проверку «текст уцелел?» они проходят, а проверку «данные стоят в нужном столбце?» — нет. Ниже — полная картина с цифрами.
Что такое MarkItDown на самом деле
MarkItDown — это Python-утилита от Microsoft, которая преобразует файлы и офисные документы в Markdown, оптимизированный для LLM. Дай ему PDF, .docx, .xlsx, .pptx, изображение, HTML-файл или несколько других форматов — и на выходе получишь Markdown. Запустить его можно тремя способами: через CLI (markitdown file.pdf -o out.md или через stdin), через Python API (MarkItDown().convert(...)) и через опциональный MCP-сервер для агентных сценариев.
Самое важное здесь — то, чего он не делает. И это не просто моя интерпретация: в README этого нет, и тесты подтвердили это на практике. Никакого сканирования сайтов, никакого рендеринга JS, переходов по ссылкам, пагинации или извлечения основного контента в стиле readability. Это конвертер целых документов. Вы приносите байты — он приводит их к единому виду. Именно это различие решает, место ли этому инструменту в вашем стеке, поэтому я ещё не раз к нему вернусь.
С точки зрения GitHub-метрик репозиторий тяжеловесный: по состоянию на середину июля 2026 года у него 165 282 звезды и 11 790 форков, лицензия MIT, а свежий релиз (v0.1.6) вышел 2026-05-26. Но это, скорее, отражение популярности Microsoft и общего хайпа вокруг LLM-инструментов, чем зрелости внутренних механизмов конвертации. Там же 833 открытых issue, и часть из них стоит учитывать ещё до установки.
HTML в Markdown: быстро, полно, но с лишней обвязкой
Поскольку в остальной части моей серии обзоров скраперов используются одни и те же четыре веб-фикстуры, я подал MarkItDown те же локальные HTML-файлы — не для того, чтобы оценивать его как скрапер, а чтобы посмотреть, насколько хорошо он конвертирует HTML в Markdown. На хорошо размеченных страницах он действительно хорош.
Все четыре страницы конвертировались на базовой установке без дополнительных компонентов, и все контрольные точки основного текста сохранились. Статья Wikipedia про Web scraping (226 КБ) сохранила дерево заголовков — один h1, семь h2 и двенадцать h3, что соответствует реальной структуре разделов статьи — а также 418 ссылок в корректном формате [текст](url). Таблица хоккейной статистики 25×9 на странице Scrape This Site forms превратилась в аккуратную GFM-таблицу из 27 строк (заголовок + разделитель + 26 строк данных), включая пустые ячейки. По скорости тоже всё было отлично: от медианы 48 мс для небольшой страницы Quotes до 352 мс для Wikipedia на 226 КБ.
Но есть нюанс — и это именно осознанное решение, а не баг. MarkItDown не вырезает служебную обвязку страницы. Он конвертирует весь <body>, так что вместе с контентом тянется и интерфейс сайта — причём чем больше его на странице, тем заметнее след.
| Страница | Кол-во символов на выходе | Заголовки (h1/h2/h3) | Ссылки | Строк с обвязкой сайта |
|---|---|---|---|---|
| Books to Scrape | 10,478 | 1 / 0 / 0 | 94 | 0.6% (1/159) |
| Quotes to Scrape | 2,973 | 1 / 1 / 0 | 55 | 1.2% (1/86) |
| ScrapeThisSite forms | 3,385 | 1 / 0 / 0 | 31 | 6.7% (5/75) |
| Wikipedia Web scraping | 60,159 | 1 / 7 / 12 | 418 | 12.4% (42/338) |
На почти лишённой обвязки домашней странице Books 0,6% строк вывода — это интерфейс сайта. На Wikipedia — уже 12,4%: 42 из 338 непустых строк — это «jump to content», переключение оглавления, «22 languages», «retrieved from», cookie- и license-footers. Даже сервисные баннеры Wikipedia вроде «This article needs additional citations» корректно превращаются в двухколоночные pipe-таблицы — именно оттуда на странице без реальной таблицы данных берутся девять строк таблицы.
Но это не значит, что MarkItDown делает что-то неправильно. Это конвертер целого документа, а не инструмент для извлечения только основного текста: честный HTML-to-Markdown — это совсем другая задача, чем чистое извлечение статьи. Trafilatura и инструменты в духе Firecrawl стараются вернуть только основной контент; MarkItDown возвращает страницу целиком. Внутри его _html_converter.py удаляет <script> и <style>, а потом передаёт весь body в библиотеку markdownify — без каких-либо эвристик для поиска основного текста. Если нужна только статья, это не тот уровень.
Родная стихия: PDF, DOCX, XLSX, PPTX
Именно для документов MarkItDown и создавался. Я проверил его на реальных публичных файлах: arXiv-статье с текстовым слоем, whitepaper Bitcoin, отсканированном PDF без текстового слоя, а также на DOCX/XLSX/PPTX из собственного набора тестов MarkItDown (с UUID-маркерами, чтобы отлавливать скрытую потерю контента).
| Документ | Входной размер | Кол-во символов на выходе | Точки проверки | Медианное время | Примечания |
|---|---|---|---|---|---|
| arXiv 1706.03762 (PDF с текстовым слоем) | 2.2 MB | 40,174 | 7/7 | 3.7 s (warm) | title, "Transformer", "BLEU", "References" на месте |
| Bitcoin whitepaper (9 стр. PDF) | 184 KB | 22,485 | 6/6 | 1.4 s | присутствуют "Satoshi Nakamoto", "proof-of-work", "Conclusion" |
| Сканированный PDF (без текстового слоя) | 89 KB | 0 | 0/4 | 15 ms | пустой результат, без ошибки, без OCR |
| DOCX (test.docx) | 136 KB | 4,651 | — | 70 ms | заголовки + GFM-таблица; встроенные UUID на месте |
| DOCX с формулами | 15 KB | 240 | — | 101 ms | Office Math сохранён как LaTeX |
| XLSX (test.xlsx) | 12 KB | 808 | — | 57 ms | каждый лист → ## SheetName + GFM-таблица |
| PPTX (test.pptx) | 278 KB | 2,047 | — | 52 ms | маркеры номеров слайдов, таблицы, график → таблица |
На PDF с текстовым слоем полнота извлечения текста была отличной — 7 из 7 заранее заданных контрольных точек на статье arXiv Attention Is All You Need, 6 из 6 на whitepaper Bitcoin — и ни один офисный файл не потерял ни одного UUID-маркера, то есть скрытой потери контента в собственных регрессионных фикстурах мейнтейнеров я не увидел. Ещё один приятный, но узкий плюс: путь DOCX (через mammoth) сохраняет офисные формулы как LaTeX, превращая equations.docx в настоящий математический блок $$...$$. Если вы скармливаете LLM Word-документы с большим количеством математики, это реальное, пусть и нишевое, преимущество, которое мне больше нигде не попадалось.
На этой территории есть два наблюдения, которые особенно важно отметить — они с наибольшей вероятностью создадут проблемы.
Сканированный PDF, который просто исчезает
Если подать MarkItDown PDF только с изображением и без текстового слоя, он вернёт пустую строку. Ноль символов, без исключения, без предупреждения — и сделает это примерно за 15 мс, потому что извлекать нечего. Путь обработки PDF у MarkItDown — это только извлечение текста (под капотом pdfminer и pdfplumber), и OCR не входит ни в базовую установку, ни в какие-либо pip extra.
Для пакетной обработки это критично. Разработчик, который отдаёт на вход папку с PDF, где часть файлов — сканы, получит по этим файлам молча пустой результат, без какого-либо сигнала, что что-то пропущено. Я проверил, что это не сломанная фикстура, запустив extract_text из pdfminer напрямую — ноль символов, текста нет, всё подтвердилось — так что пустой вывод действительно является реальным поведением MarkItDown на реальном скане. Это повторяет давно открытую проблему с отсутствием OCR-fallback (#1268), которую уже какое-то время отслеживают upstream. Описанный путь — это опциональный бэкенд Azure Document Intelligence или плагин; ни один из них не входит в базовую установку.
PDF выходит плоским текстом, а не структурой
На обоих PDF с текстовым слоем MarkItDown не создал ни одного Markdown-маркера заголовка. У PDF нет семантических тегов заголовков, а MarkItDown не пытается выводить их из размера шрифта, поэтому каждая строка оказывается на уровне обычного текста. Полнота извлечения текста высокая; структура — плоская.
И это не только мой вывод. Внешние публичные бенчмарки оценивают иерархию заголовков PDF у MarkItDown примерно в 0.0, а качество таблиц — около 0.27, что заметно ниже 0.88 у Docling с TableFormer (см. сравнение MarkItDown vs Docling vs Marker и бенчмарк READoc). Мои фикстуры воспроизводят эти результаты, а это усиливает доказательную базу — мои цифры совпали с внешним источником. При этом те же бенчмарки показывают, что MarkItDown работает примерно в 100 раз быстрее, чем Docling, и это хорошо согласуется с моими измерениями: секунды вместо минут на документах, которые инструментам с layout-моделями приходится обрабатывать минутами. Вывод простой: MarkItDown даёт вам чистый и быстрый PDF-текст, но не даёт PDF-структуру. Если заголовки и таблицы должны сохраниться, нужен инструмент уровня layout-модели — например Docling или Marker.
Таблицы: текст сохраняется всегда, структура — не всегда
Таблицы как раз тот случай, где «текст уцелел?» и «данные можно использовать?» расходятся, поэтому я собрал матрицу из 13 кейсов — по одному <table> на кейс, каждый сравнивался с манифестом, созданным до запуска, — чтобы точно понять, какие формы держатся, а какие ломаются.
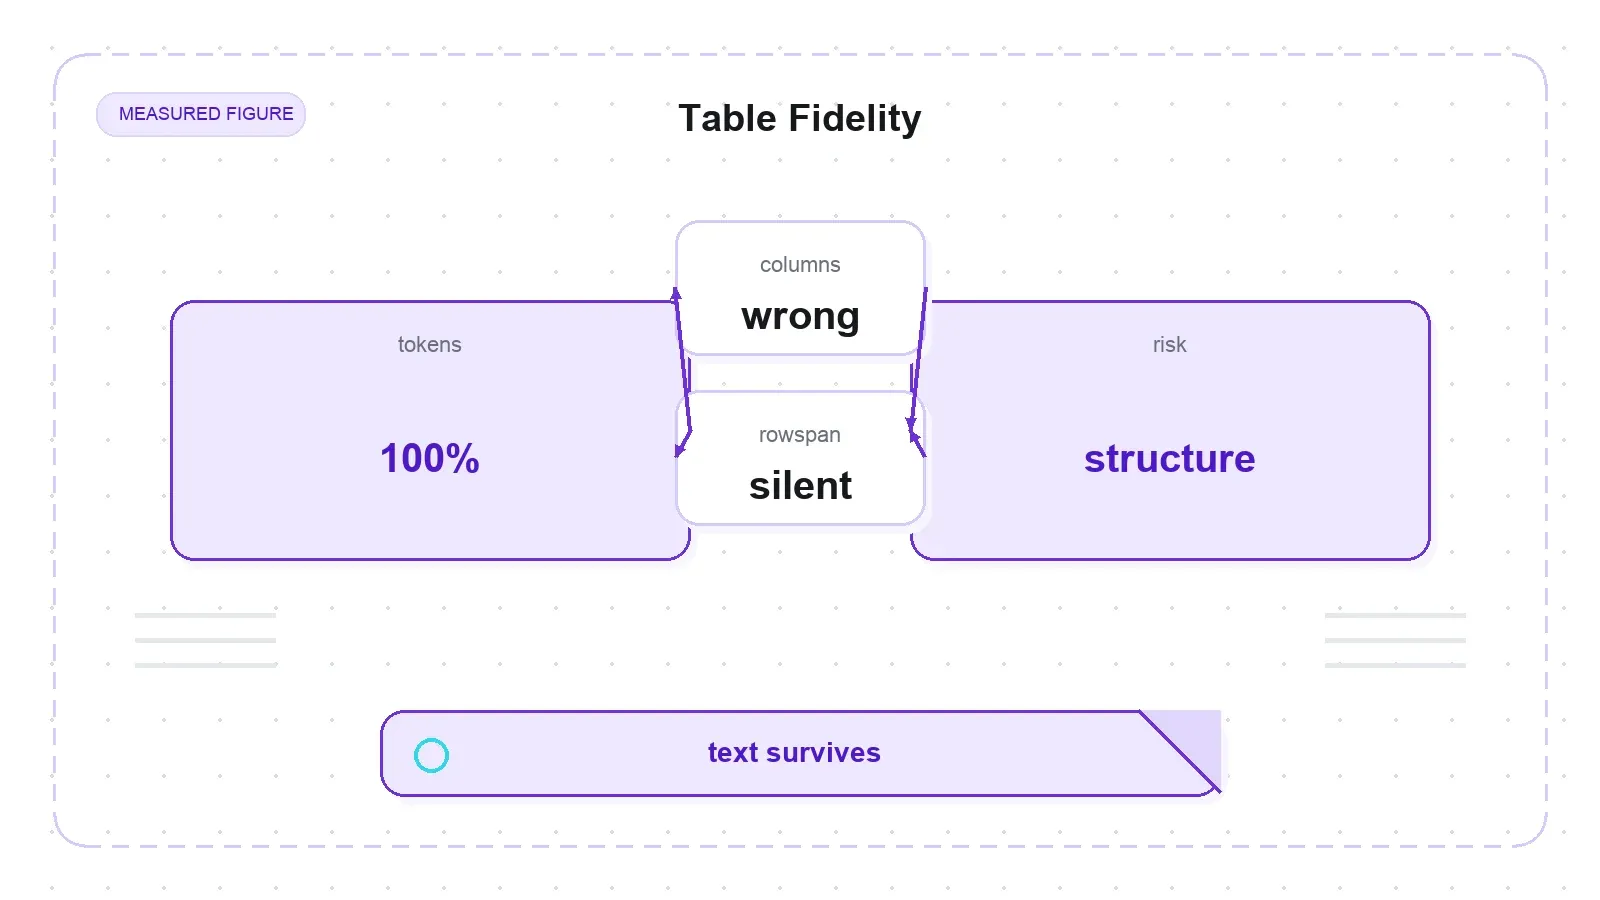
Главный вывод: MarkItDown ни разу не потерял содержимое таблиц. Во всех 13 случаях сохранилось 100% заранее заданных токенов. Но структурная точность распалась на три сценария. Семь из тринадцати кейсов дали корректную GFM-сетку (обычная, с colspan в заголовке, очень широкая на 24 столбца, без заголовка, с пустыми ячейками, с блоком внутри ячейки и арабскую справа налево). Четыре случая вышли рваными, потому что в Markdown нет понятия ячейки, растянутой на несколько строк или столбцов, а также из-за некорректных исходников. И ещё два были откровенно сломаны.
О двух сломанных сценариях стоит сказать отдельно. Вложенная таблица (<table> внутри <td>) схлопывается в строку, её собственные pipe-символы и строка-разделитель попадают в родительскую ячейку, и в итоге получается мусорная строка с 14 «столбцами». А литеральный | внутри ячейки не экранируется — текст a | b превращается в два столбца, x || y — в три, так что двухколоночная таблица в выводе даёт строки с двумя, тремя и четырьмя столбцами, а любой downstream Markdown-парсер прочитает границы неверно. Любопытно, что звёздочки и обратные кавычки внутри ячеек экранируются, а вот pipes — нет. Корень проблемы в том, что HTML-путь MarkItDown использует стандартную обработку таблиц markdownify, а его кастомный подкласс переопределяет ссылки, изображения и заголовки, но не ячейки таблиц. Та же ошибка с экранированием pipe-сиволов уже отмечена как открытая проблема для CSV-конвертера (#2019), хотя это исправление не затрагивает HTML-путь, который я тестировал.
Самое тонкое наблюдение — то, что я бы хотел показать data engineer в первую очередь, — это rowspan. Кейс t03 не просто выходит рваным; он молча сбивает данные по колонкам. Метка с rowspan=2 («Fruit») выводится один раз, а строка под ней становится короткой двухколоночной строкой (| Banana | 8 |), поэтому «Banana» попадает в столбец Group вместо Item. Все токены на месте. Наивный потребитель, который читает второй столбец, получит неверное значение. Это именно тот баг, который проходит проверку на сохранность текста и тихо портит датасет.
Само ограничение на span — это известный и зафиксированный компромисс дизайна (#1211, #1248): плоская GFM-сетка действительно не может выразить ни объединённые ячейки, ни вложенность, поэтому конвертер жертвует структурой ради полноты текста. При этом есть и хорошие сценарии: таблицы без заголовка получают сгенерированную пустую строку заголовка (так данные не «повышаются» в заголовок незаметно), пустые ячейки сохраняются, а <caption> выводится как строка текста над таблицей.
Установка и запуск: налог, о котором «лёгкая утилита» не предупреждает
Ничто в этом обзоре не удивило меня сильнее, и именно здесь формулировка «лёгкая Python-утилита» тихо завышает ожидания.
Во-первых, не ставь pip install 'markitdown[all]'. На Python 3.14 он молча откатывается на markitdown 0.0.2 — релиз двухлетней давности — и я воспроизвёл это в чистом venv. Если зафиксировать версию, причина становится очевидной: pip install 'markitdown[all]==0.1.6' падает с ошибкой, потому что extra [all] фиксирует youtube-transcript-api~=1.0.0, а на текущем PyPI все сборки из этого диапазона ограничены Python <3.14, тогда как единственные сборки, совместимые с 3.14, не попадают в этот pin. В итоге резолвер откатывается до последнего релиза, зависимости которого можно удовлетворить. Это совпадает с открытой upstream-проблемой (#2179). Исправление простое: зафиксировать версию и ставить extras по отдельности — pip install 'markitdown==0.1.6', затем pip install 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. Каждый из этих пакетов ставится без проблем; отравленным является только общий бандл [all]. (Этот подвох зависит от версии Python — на Python 3.13 и ниже ограничение может не сработать, и тогда [all] резолвится иначе.)
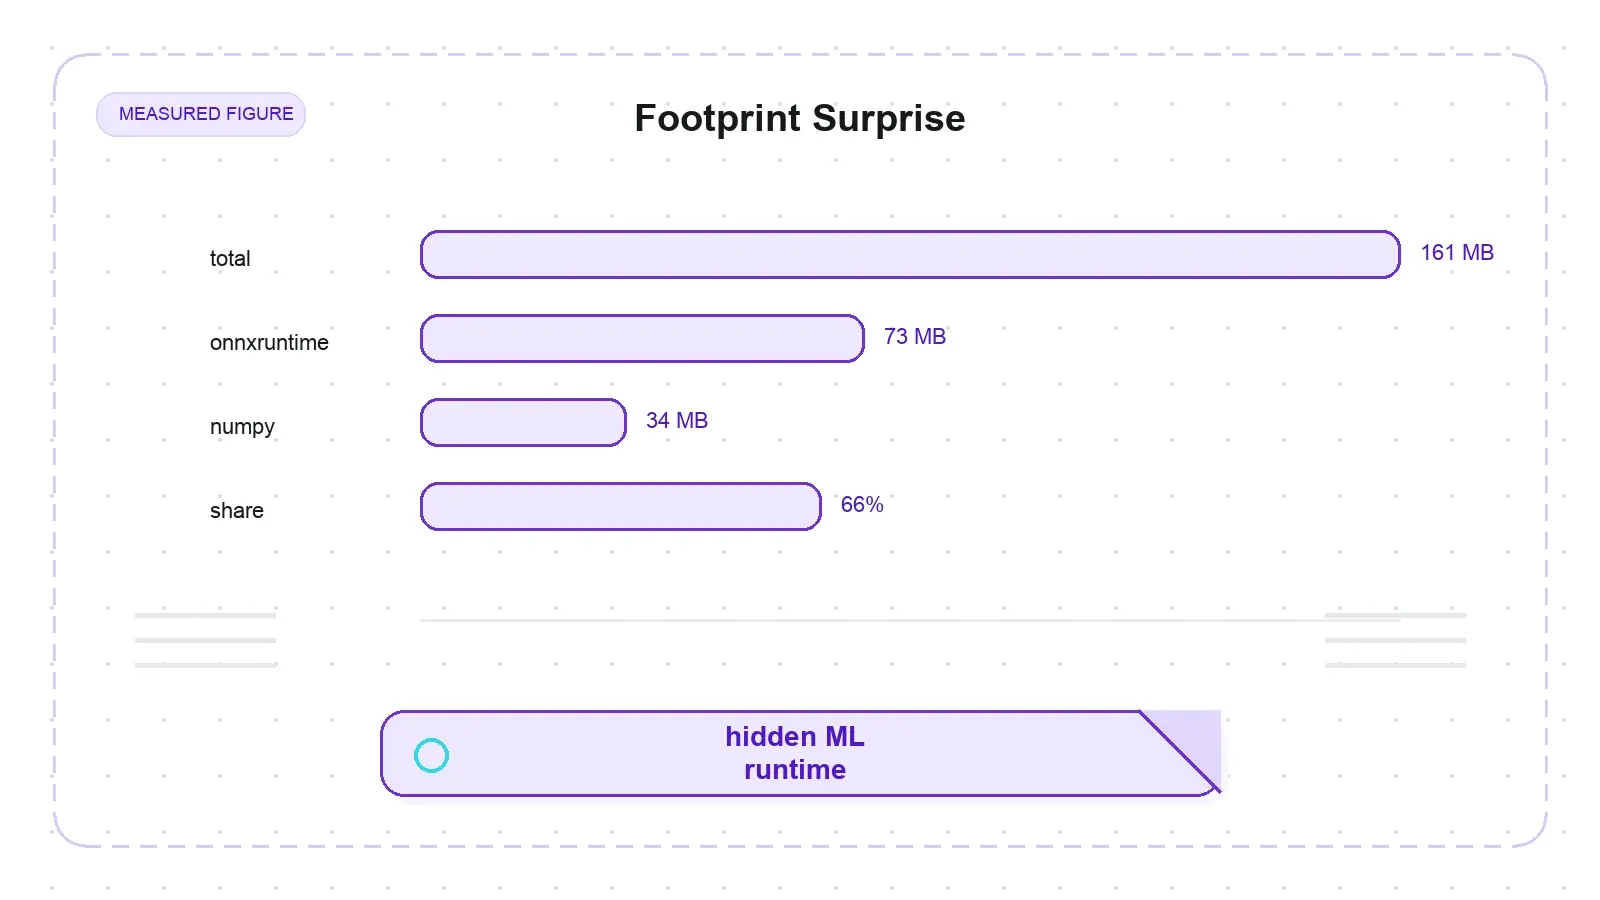
Во-вторых, вес установки. Базовая установка занимает 161 МБ: пустой venv на 13 МБ плюс ещё 148 МБ. Из этого на onnxruntime (73 МБ) и numpy (34 МБ) вместе приходится 107 МБ — 66% всей базовой массы — и оба пакета подтягиваются одной жёсткой зависимостью: magika, ML-детектор типов файлов от Google. То есть текстовый конвертер в базовой поставке тащит за собой 73-МБ runtime для ONNX-инференса ещё до того, как ты поставишь хотя бы одно расширение для документов. Если добавить все document extras, venv разрастается до 310 МБ. Это намного легче, чем стек на headless-браузере, но если ты ожидал микроутилиту в стиле «поставил и забыл», учти: ONNX runtime уже едет в комплекте.
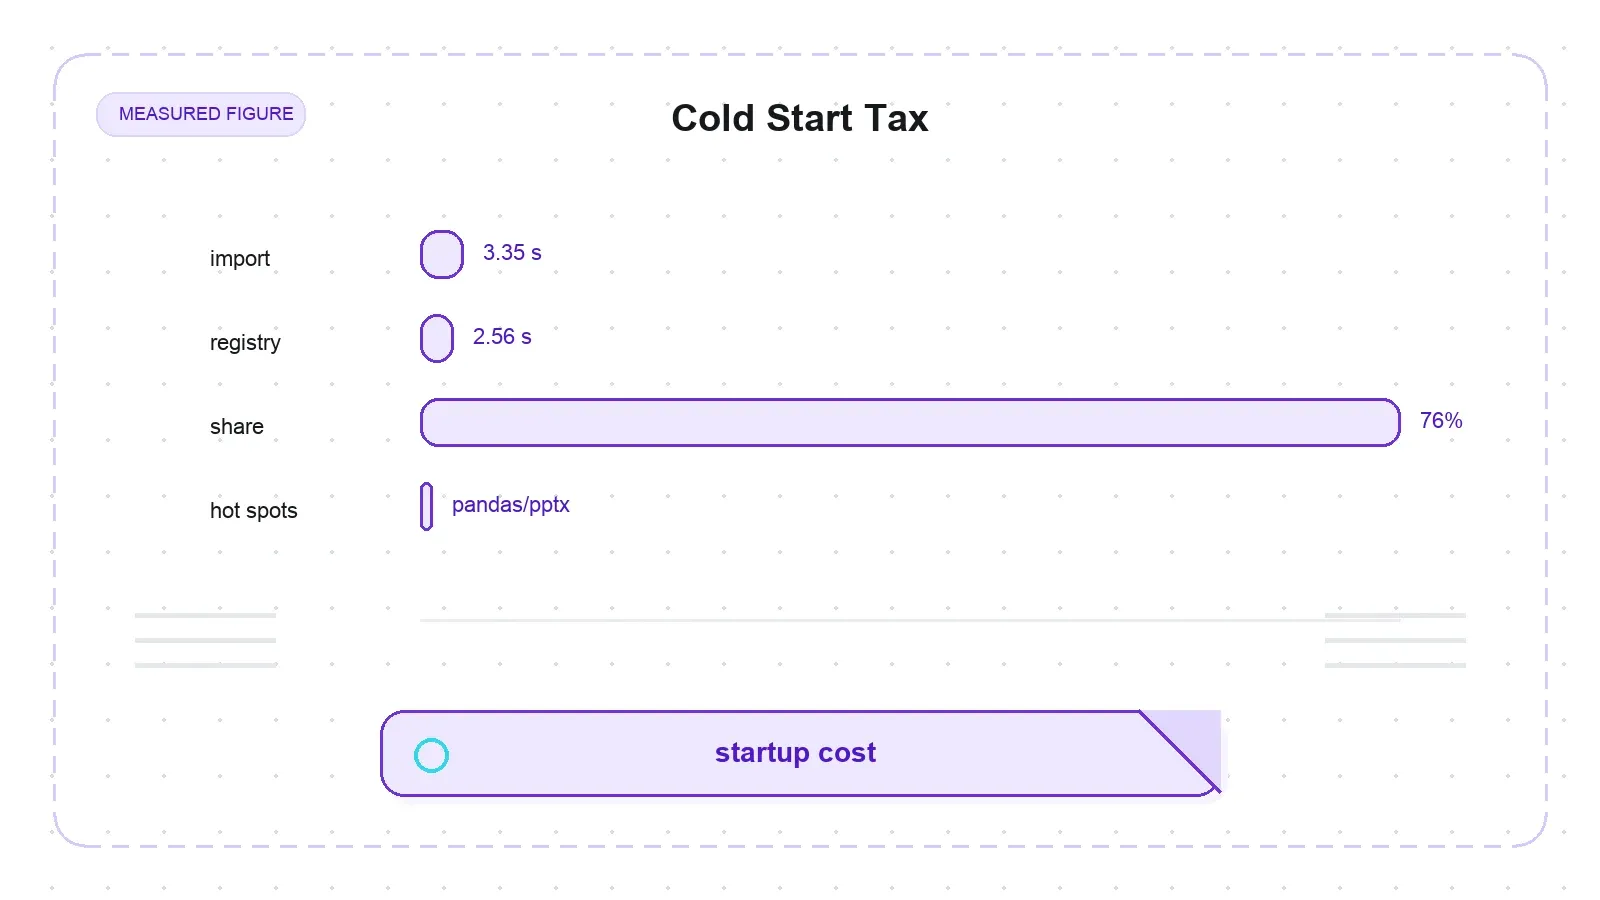
В-третьих — и это единственный результат во всём моём наборе, который прошёл все проверки на новизну, которые я сделал, — даже после чистой установки import markitdown стоит на этой машине около 3,35 секунды. Почти вся цена платится на этапе импорта: markitdown._markitdown заранее импортирует весь реестр конвертеров (2,56 с суммарно, то есть 76% от общего времени), что тянет за собой pandas (1,21 с, через XLSX-конвертер), python-pptx (427 мс), magika (354 мс) и requests (270 мс) — независимо от того, будешь ли ты вообще конвертировать эти форматы. Для долгоживущего сервиса это разовая амортизация и не проблема. Для CLI-вызова или serverless cold start это реальный налог на каждый процесс, которого от маркировки «лёгкая утилита» совсем не ждёшь. (Справедливое замечание: это один профильный прогон, одно наблюдение, а не распределение по множеству запусков.)
Масштаб: не падает, но для PDF закладывайте CPU, а для таблиц — RAM
Я прогнал четыре крупных кейса в отдельных процессах, чтобы пиковая память не была искажена предыдущими запусками. Ничего не упало. Но профиль затрат оказался очень неравномерным.
| Объект | Входной размер | Кол-во символов на выходе | Медианное время | Пик RSS Δ |
|---|---|---|---|---|
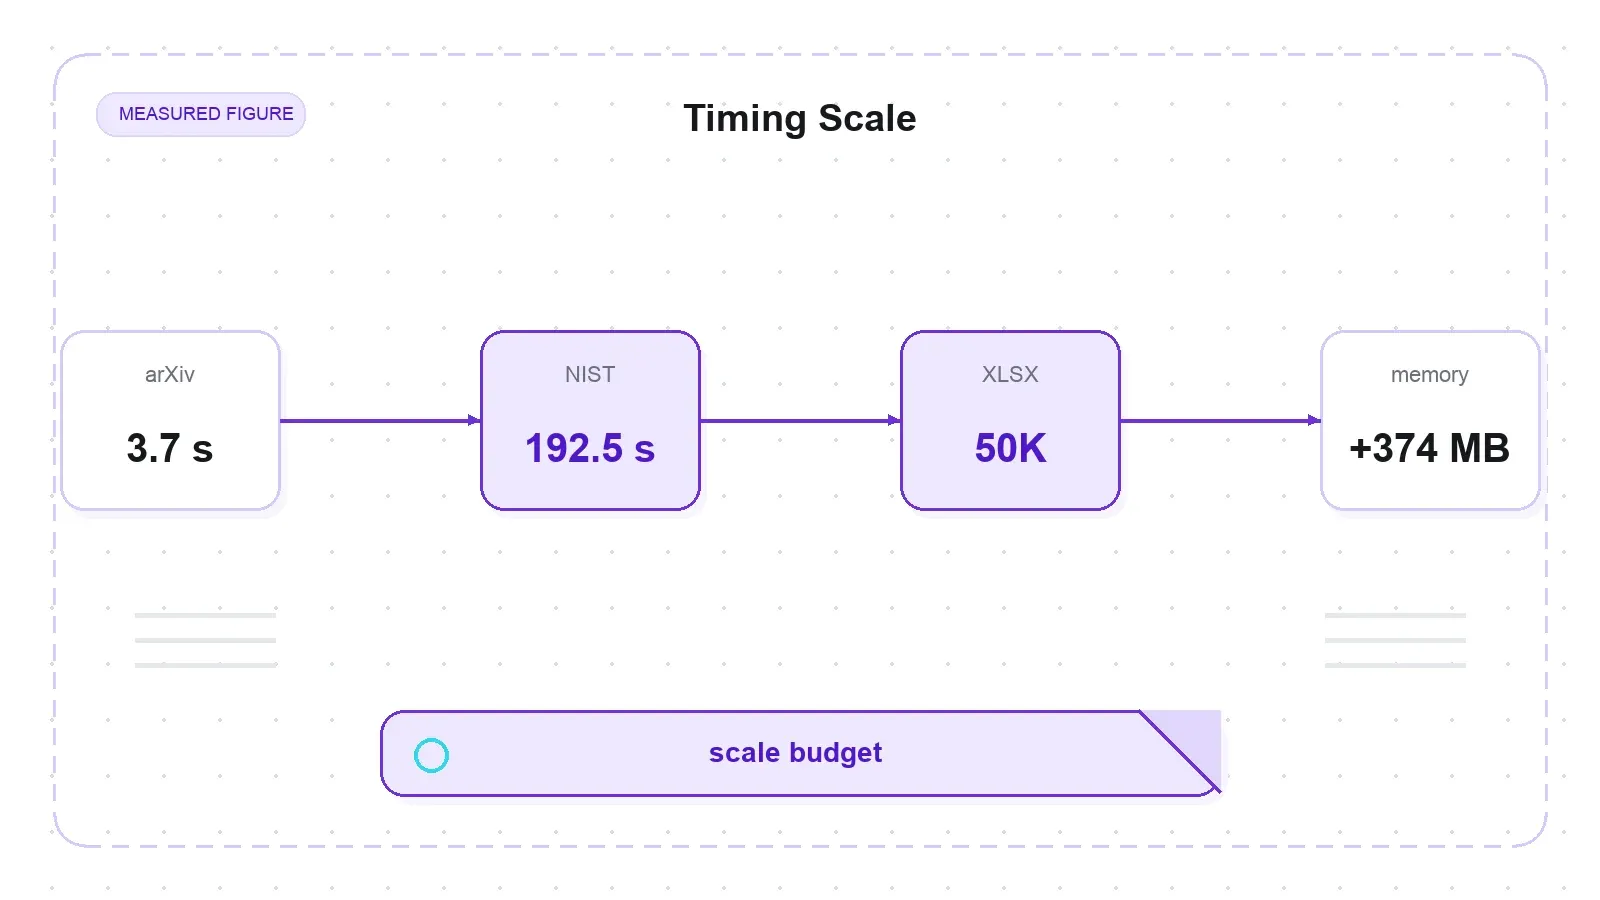
| NIST SP 800-53r5 (PDF на 492 страницы) | 6.07 MB | 1,625,365 | 192.5 s | +40 MB |
| XLSX 50,000 строк × 8 столбцов | 2.1 MB | 3,722,955 | 62.1 s | +374 MB |
| arXiv 1706.03762 (~15 страниц PDF) | 2.2 MB | 40,174 | 12.6 s | +25 MB |
| XLSX 200 строк × 64 столбца | 46 KB | 120,129 | 2.9 s | +22 MB |
PDF NIST на 492 страницы занял медианно 192,5 секунды — примерно 3,2 минуты, или 0,39 с/страницу — потому что pdfplumber выполняет на каждой странице обнаружение форм на основе положения слов. Пиковый RSS остался на уровне +40 МБ, так что это CPU-bound, а не memory-bound задача. Даже 15-страничный arXiv PDF в изолированном процессе занял 12,6 секунды — примерно в 3,4 раза дольше, чем 3,7 секунды на том же файле в тёплом прогоне внутри моего набора документов. Этот разрыв — цена холодного процесса, и он подтверждает, что основная нагрузка идёт от покадровой/постраничной работы, а не от размера байтов как такового. Если нужен один переносимый показатель для этого PDF, берите изолированные 12,6 с.
У таблиц бутылочное горлышко другое. XLSX на 2,1 МБ с 50 000 строк раздувается до +374 МБ пикового RSS (и 3,7 млн символов на выходе), потому что конвертер загружает весь лист и собирает одну огромную Markdown-строку. Поэтому практический совет прямой: для больших PDF закладывайте минуты CPU, для больших таблиц — сотни мегабайт RAM. Это цифры с одной машины на macOS arm64 и Python 3.14, а константы на страницу и на строку зависят от платформы — но сама форма зависимости (PDF медленный и CPU-bound, XLSX прожорлив по памяти, ничего не падает) переносится.
Где здесь место Thunderbit — и где его нет
Попробовать Thunderbit для извлечения веб-данных
Это как раз та часть сравнения, где легко уйти в преувеличение, поэтому границу проведу аккуратно. MarkItDown и Thunderbit решают соседние задачи, но не одну и ту же.
MarkItDown преобразует файлы, которые у тебя уже есть. Thunderbit сначала забирает страницу. Эндпоинт Thunderbit /distill превращает живую веб-страницу в чистый Markdown, пригодный для LLM — обрабатывая JS-рендеринг, антибот-защиту и динамический контент, для которых у MarkItDown просто нет механизма — а эндпоинт /extract возвращает структурированный JSON, согласованный со схемой, а не только сырой Markdown. Для разработчиков это доступно через API (POST /distill / POST /extract), MCP-сервер и CLI (npx @thunderbit/thunderbit-cli) — всё на одном AI-движке, том же, что стоит за расширением с 100 000+ пользователями.
Так что они пересекаются ровно в одном — оба умеют выдавать «LLM-ready Markdown» — но домен входных данных разный: Thunderbit distill принимает URL из открытого веба, а MarkItDown — локальный файл. Это не взаимозаменяемые инструменты, и делать вид, что это так, я не буду. Реальный стек часто использует оба: сначала забирает и краулит веб с помощью Thunderbit (или сервиса в духе Firecrawl), а затем нормализует локальные документы — PDF, презентации, таблицы — через MarkItDown. Один работает с сетью, другой — с файловым шкафом.
Плюсы и минусы
Сильные стороны
- Полное извлечение основного текста из чистого HTML (4/4 страниц), с корректным сохранением дерева заголовков и ссылок
- Высокая полнота извлечения текста из PDF/DOCX (arXiv 7/7 контрольных точек, Bitcoin 6/6) и отсутствие скрытой потери контента на собственных офисных фикстурах мейнтейнеров
- Формулы Office Math сохраняются как LaTeX — редкое и очень полезное преимущество
- Ни разу не упал ни на одном крупном кейсе, вплоть до PDF на 492 страницы и XLSX на 50k строк
- Прост в вызове: CLI,
convert(), stdin и опциональный MCP-сервер - MIT-лицензия, активная поддержка Microsoft, живой issue tracker
Слабые стороны
- Сохраняет лишнюю обвязку — до 12,4% строк в Wikipedia; это не извлекатель статьи
- Таблицы ломаются на span, вложенности и символах
|внутри ячеек (2/13 сломаны, 4/13 рваные), а rowspan может молча смещать данные - Сканированные PDF без текстового слоя возвращаются пустыми, без OCR и без ошибки
- В PDF отсутствует структурирование заголовков (это совпадает с публичными бенчмарками)
- Базовая установка весит 161 МБ и тащит 73-МБ ONNX runtime; холодный импорт ~3,35 с
- Extra
[all]на Python 3.14 молча откатывается на устаревшую 0.0.2
Кому стоит использовать, а кому — нет
MarkItDown стоит брать, если вам нужно привести в единый Markdown-формат смешанный набор локальных документов — Word, Excel, PowerPoint, PDF с текстовым слоем — для LLM-пайплайна, и вы больше цените полноту текста, чем сохранение структуры. Как последний этап пакетной обработки, когда нужно быстро подать модели чистый текст, он быстрый, точный и бесплатный.
Лучше обойтись без него или использовать вместе с другим инструментом, если ваша задача относится к одному из этих случаев: вам нужен только основной текст со страницы сайта (тогда берите инструмент для readability или в духе Firecrawl); вам нужно, чтобы заголовки и таблицы PDF сохранились без искажений (тогда это территория Docling или Marker); или среди входных данных есть отсканированные документы, где требуется OCR (вам понадобится бэкенд Azure или другой инструмент). И если ты думал, что покупаешь скрапер — то есть инструмент, который и забирает страницу, и краулит её, — это совсем не он.
Предварительная оценка, которую я прогнал по рубрике, похожей на скраперную, даёт MarkItDown 60/100, но этот низкий итог — артефакт того, что конвертер оценивают по тесту краулера. На своей территории у него высокие оценки за точность текста; слабые места здесь структурные (таблицы, заголовки PDF) и упаковочные (размер, импорт, ловушка [all]), а не качество текста. Если судить его как то, чем он является — конвертером файлов в Markdown — это добротный, хорошо поддерживаемый инструмент с несколькими острыми углами, о которых стоит знать до того, как вы отправите его в продакшен.
Часто задаваемые вопросы
MarkItDown — это веб-скрапер?
Нет. У него нет краулера, рендеринга JavaScript, переходов по ссылкам и пагинации. Он преобразует уже имеющиеся у тебя файлы и документы — PDF, DOCX, XLSX, PPTX, изображения, HTML — в Markdown. Если тебе нужно забрать и обойти живые веб-страницы, тебе нужен инструмент для скрапинга вроде Thunderbit или Firecrawl; MarkItDown — это следующий шаг, когда уже полученные или локальные файлы нужно превратить в чистый Markdown.
Почему pip install markitdown[all] ставит старую версию?
На Python 3.14 extra [all] фиксирует youtube-transcript-api~=1.0.0, а все сборки из этого диапазона доступны только для Python ниже 3.14. Резолвер не может удовлетворить этот pin и поэтому молча откатывается на markitdown 0.0.2 — релиз двухлетней давности. Исправление такое: зафиксировать версию и ставить extras по отдельности — pip install 'markitdown==0.1.6', затем добавить 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. Это отслеживается в issue #2179.
Делает ли MarkItDown OCR для сканированных PDF?
Не в базовой установке. Его PDF-путь — только извлечение текста, поэтому PDF только с изображением и без текстового слоя возвращается пустой строкой — без ошибки, без предупреждения. OCR требует опционального бэкенда Azure Document Intelligence или плагина, ни один из которых не входит в поставку по умолчанию. Это давняя известная проблема (issue #1268).
Насколько хорошо MarkItDown работает с таблицами?
По содержимому — очень хорошо: в моём тесте из 13 кейсов он сохранил 100% содержимого таблиц во всех случаях. Но структурно всё зависит от формы: простые, широкие, без заголовков и с пустыми ячейками таблицы выходят как аккуратные GFM-сетки, а вот rowspan и colspan начинают ломать сетку (и rowspan может молча сместить данные в неправильный столбец), вложенные таблицы расплющиваются в мусорные строки, а символ pipe внутри ячеек не экранируется. Плоский формат таблиц Markdown просто не умеет корректно описывать span и вложенность.
Достаточно ли MarkItDown быстр для больших документов?
Он не падает на больших файлах, но ресурсы нужно планировать по типу данных. PDF на 492 страницы занял около 3,2 минуты (примерно 0,39 с/страницу), потому что на каждой странице выполняется поиск форм, и это CPU-bound задача. Таблица XLSX на 50 000 строк завершилась примерно за минуту, но потребовала +374 МБ RAM, потому что конвертер собирает одну огромную Markdown-строку в памяти. Для больших PDF планируй минуты CPU, для больших таблиц — сотни мегабайт RAM.
Попробовать Thunderbit для извлечения веб-данных Get Started Free




