
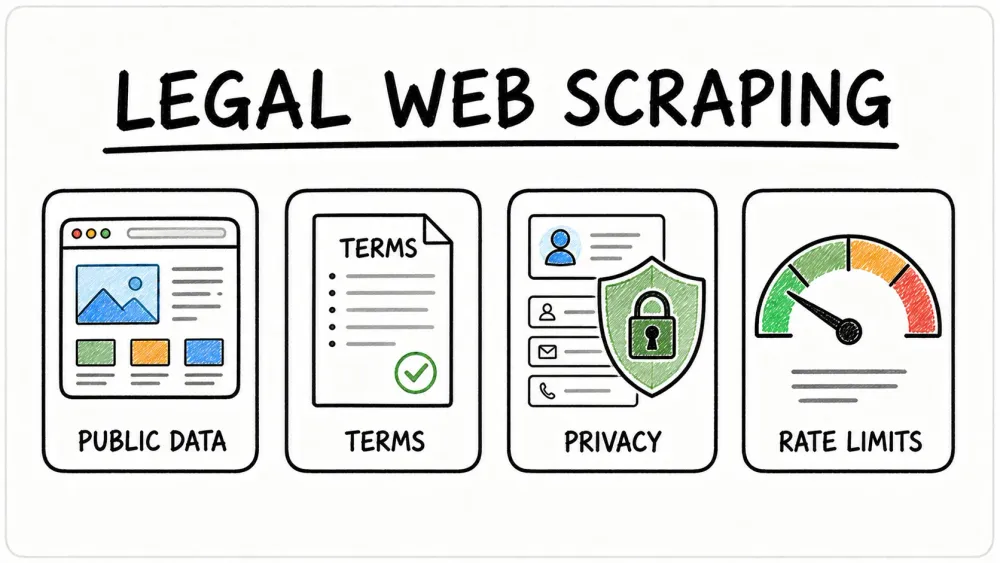
«законно ли собирать данные с сайтов?» — этот вопрос мне почти каждую неделю задают команды продаж, операционного блока и маркетинга. Сегодня веб-скрейпинг лежит в основе всего: от генерации лидов до конкурентной разведки, так что неудивительно, что всем нужен понятный ответ. Но реальность такая: юридическая картина прозрачна примерно как вчерашний кофе в чашке. Достаточно взглянуть на заголовки: один суд говорит, что сбор публичных данных допустим, а другой предупреждает о «незаконном сборе данных». Неудивительно, что многие команды боятся перейти черту.
Вот что важно: более двух третей организаций уже используют веб-скрейпинг для аналитики и AI-проектов, а целых 78% e-commerce-компаний применяют его для мониторинга цен. Но на фоне громких дел вроде LinkedIn vs. hiQ Labs ставки никогда не были выше. Так как же получать пользу из веб-данных — и при этом не влипнуть в юридические проблемы? Разберём правовые рамки, чек-листы по комплаенсу и лучшие практики, которые должен знать каждый бизнес-пользователь. И да, я покажу, как Thunderbit делает комплаенс-скрейпинг заметно проще.
Разбираемся в правовой картине: законно ли собирать данные с сайтов?
Попробуйте compliant web scraper от Thunderbit Агентный веб-скрейпер Thunderbit сам читает публичные страницы и извлекает данные в один клик, с учётом требований комплаенса. Get Started Free
Сразу к сути: законность веб-скрейпинга зависит от того, какие данные вы собираете, как именно вы это делаете и в какой стране вы находитесь. Единого универсального закона, который бы прямо говорил: «скрейпинг разрешён» или «скрейпинг запрещён», не существует. Вместо этого приходится учитывать целый набор правил — антихакерские нормы, законы о защите персональных данных, авторское право и даже условия использования сайта (Thunderbit Blog).
Вот ключевые факторы, которые определяют, находится ли ваш проект в правовом поле:
- Публичные или закрытые данные: Сбор данных, доступных всем без логина и платного доступа, обычно безопаснее. Если вы пытаетесь попасть в контент за авторизацией, это уже похоже на незаконное получение доступа.
- Тип данных: Персональные данные, например имена, email, профили в соцсетях, а также контент, защищённый авторским правом, вроде статей и изображений, несут куда больше рисков, чем факты вроде цен, характеристик товаров или бизнес-каталогов.
- Цель использования: Использовать собранные данные внутри компании — для анализа или исследований — намного безопаснее, чем публиковать или продавать их.
- Соблюдение правил сайта: Нарушение условий использования или игнорирование robots.txt может привести к проблемам, даже если данные публичные.
- Технический подход: Сбор данных в темпе, похожем на человеческий, без обхода защитных мер вроде CAPTCHA или IP-блокировок, заметно снижает риски.
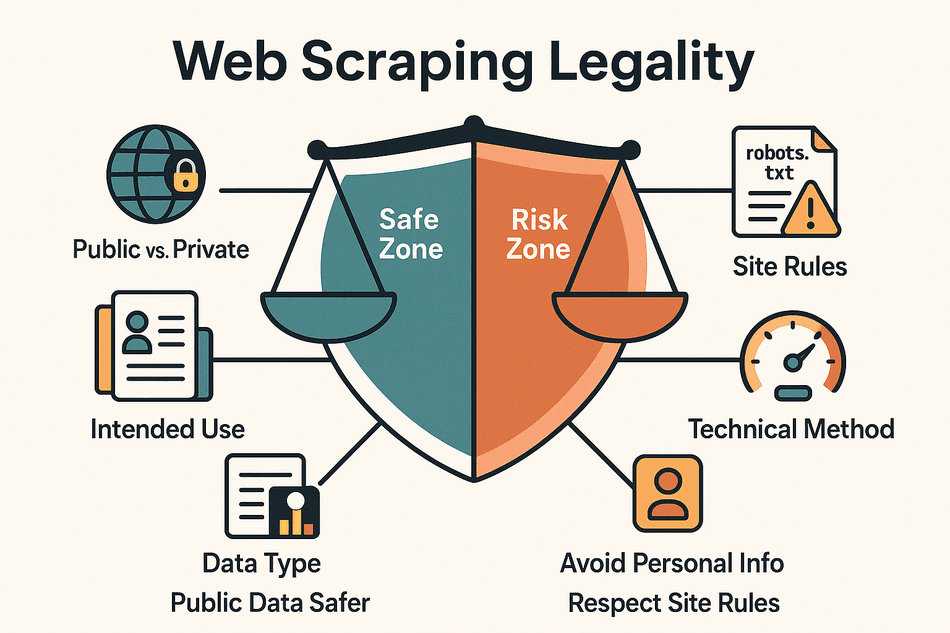

Главный вывод: сбор публичных неперсональных данных для внутреннего использования во многих регионах в целом допустим, но есть важные оговорки — особенно когда речь идёт о приватности, авторском праве и слишком агрессивном скрейпинге (Thunderbit Blog).
Правовые рамки сбора данных: обзор ключевых мировых регуляций
 Давайте быстро пройдёмся по основным правовым режимам, которые регулируют веб-скрейпинг в мире:
США: CFAA, авторское право и договорные обязательства
- Computer Fraud and Abuse Act (CFAA): Этот антихакерский закон запрещает доступ к компьютерным системам «без разрешения». Но суды уточнили, что сбор данных с публичных сайтов не нарушает CFAA, поскольку специальное «разрешение» для этого не требуется (California Lawyers Association).
- Знаковое дело: В деле hiQ Labs v. LinkedIn Девятый окружной суд постановил, что сбор данных с публичных профилей LinkedIn не является нарушением CFAA. Однако LinkedIn всё равно мог подать иск за нарушение договора (несоблюдение условий использования) или авторских прав.
- Другие риски: Если вы собираете данные слишком агрессивно — как бот в деле eBay v. Bidder’s Edge, который отправлял 100 000 запросов в день, — вас могут привлечь за «trespass to chattels», то есть за неправомерное вмешательство в работу чужих серверов (Wikipedia).
Европейский союз: GDPR и права на базы данных
- GDPR: Общий регламент ЕС по защите данных применяется даже к публичным персональным данным. Если вы собираете что-либо, что позволяет идентифицировать человека, вам нужно законное основание, например согласие или законный интерес, и строгое соблюдение правил приватности.
- Directive on Database Rights: ЕС также защищает базы данных как единые структурированные объекты. Сбор «существенной части» базы данных — например, всех объявлений с сайта недвижимости — может нарушить права на базу данных, даже если отдельные факты не охраняются авторским правом (Thunderbit Blog).
Великобритания: UK GDPR и Data Protection Act
- UK GDPR: После Brexit правила Великобритании во многом повторяют нормы ЕС. Сбор публичных неперсональных данных обычно допустим, но сбор персональных данных жёстко регулируется.
- Computer Misuse Act: Похож на CFAA и может рассматривать несанкционированный доступ как уголовное правонарушение.
Китай: PIPL и Закон о безопасности данных
- Personal Information Protection Law (PIPL): Требует согласия на сбор персональных данных. Собирать персональную информацию с китайских сайтов без разрешения — серьёзное нарушение.
- Data Security Law: Используется для пресечения скрейпинга, который наносит вред владельцам данных или создаёт недобросовестную конкуренцию.
Другие регионы
- Канада, Австралия, APAC: В большинстве стран действуют антихакерские и privacy-нормы, похожие на правила ЕС и Великобритании. Перед скрейпингом всегда проверяйте местное законодательство.
Ключевой вывод: Самый безопасный вариант — собирать публичные неперсональные данные для внутреннего использования и обязательно проверять правила своей юрисдикции (Thunderbit Blog).
Чек-лист комплаенса: как убедиться, что сбор данных законен?
Прежде чем запускать скрейпинг, пройдитесь по этому чек-листу:
- Прочитайте условия использования сайта: Если в ToS сказано «скрейпинг запрещён», лучше остановиться или сначала запросить разрешение (Thunderbit Blog).
- Ограничьтесь публичными данными: Не собирайте информацию за логином или paywall без явного разрешения.
- Проверьте robots.txt: Откройте
site.com/robots.txt, чтобы понять, не запрещён ли доступ ботам к нужным разделам. Это не закон, но хороший тон — уважать эти правила. - Избегайте персональных данных: Не собирайте имена, email и другую PII, если у вас нет законного основания и продуманной политики конфиденциальности.
- Не копируйте креативный контент: Держитесь фактов и структурированных данных. Републикация статей, изображений или больших фрагментов текста может привести к претензиям по авторскому праву.
- Используйте официальные API, если они есть: Если сайт предлагает API, лучше использовать его — это безопаснее и стабильнее.
- Скрейпьте аккуратно: Не перегружайте серверы. Работайте в темпе, похожем на человеческий, и не обходите технические ограничения.
- Документируйте процесс: Фиксируйте, что именно вы собирали, когда и зачем. Это поможет, если позже возникнут вопросы.
- Будьте готовы остановиться: Если вы получили письмо с требованием прекратить действия, немедленно остановите скрейпинг и пересмотрите проект.
Как Thunderbit помогает соблюдать комплаенс: делаем извлечение данных безопаснее и надёжнее
Когда мы создавали Thunderbit, комплаенс был в центре внимания. Вот как Thunderbit помогает оставаться в правовом поле:
- Сбор через браузер: Thunderbit извлекает только то, что вы видите в браузере — без скрытых API-вызовов и без обхода логина. Если вы не видите данные, Thunderbit их не соберёт (Thunderbit Blog).
- Встроенные предупреждения: Если вы пытаетесь собирать данные с сайта с жёсткими антискрейпинговыми правилами, Thunderbit покажет предупреждение. Это как если бы рядом с вами был специалист по комплаенсу.
- Извлечение в один клик: AI Thunderbit анализирует страницу и предлагает только релевантные поля — это помогает не собирать случайно лишние или чувствительные данные (Thunderbit Blog).
- Человеческий темп работы: Будь то локальный режим или облако, Thunderbit работает с ограничением скорости, чтобы не перегружать серверы.
- Данные не хранятся на наших серверах: Собранная информация сразу передаётся вам — Thunderbit не сохраняет копию, что особенно важно для privacy-compliance.
- Экспорт, удобный для комплаенса: Выгружайте данные напрямую в Google Sheets, Excel, Airtable или Notion — идеально для внутренней аналитики.
- Работа с подстраницами и пагинацией: Thunderbit переходит по страницам как обычный пользователь — без грубого перебора endpoint’ов.
- Плановый скрейпинг с ограничениями: Настраивайте регулярные сборы данных с разумными интервалами, а не «долбите» сайт каждую минуту.
- Мультиязычная поддержка: Интерфейс Thunderbit теперь доступен на 55 языках в Chrome Web Store, поэтому подсказки по комплаенсу и полям остаются понятными для команд, не говорящих по-английски (Chrome Web Store listing).
Иными словами, Thunderbit «вшивает комплаенс в продукт», поэтому вам проще собирать данные ответственно — даже если вы не юрист (Thunderbit Blog).
Попробуйте Thunderbit для комплаенс-скрейпинга Установите бесплатное расширение Thunderbit для Chrome и извлекайте данные с любой публичной страницы в один клик. Get Started Free
Сбор данных и повторное использование: где проходит юридическая граница?
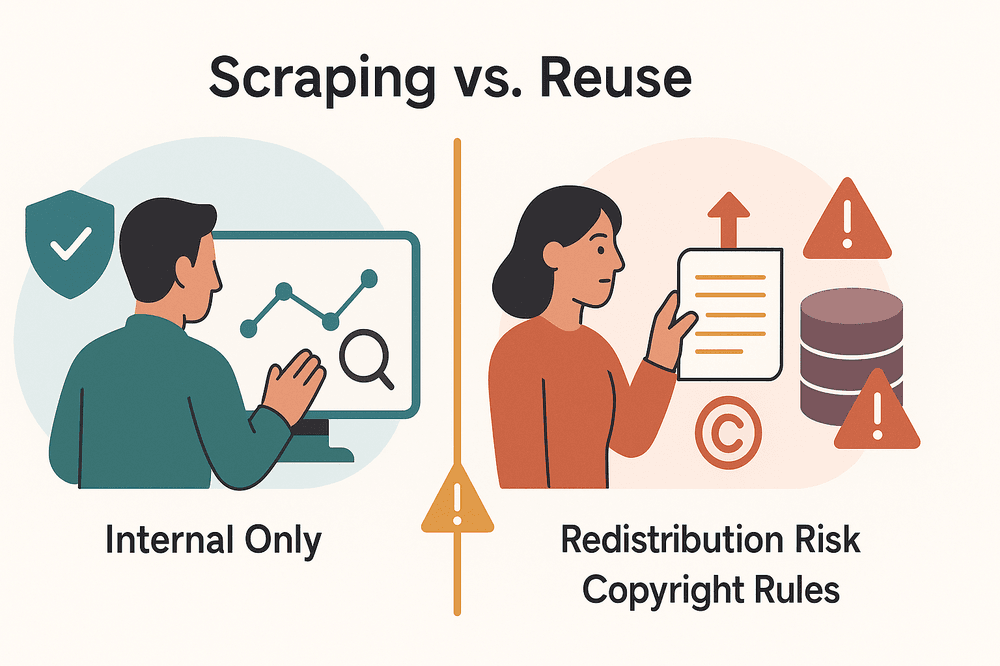 Одно дело — собирать данные для собственного внутреннего использования, и совсем другое — публиковать, перепродавать или использовать их повторно. Вот где юридическая граница становится особенно тонкой:
- Внутреннее использование: Сбор публичных данных для внутреннего анализа — например, для лидов в продажах или мониторинга цен — обычно безопасен, если это не персональные данные и не нарушение privacy-законов.
- Распространение или перепродажа: Публикация собранных данных на своём сайте, в продукте или их продажа может привести к искам о нарушении авторских прав, прав на базы данных или условий договора.
- Авторское право и права на базы данных: В США факты не защищаются авторским правом, но способ отбора или структурирования данных может быть защищён. В ЕС и Великобритании сбор «существенной части» базы данных может нарушать sui generis rights на базы данных.
- Fair use: В США в некоторых случаях допускается fair use, например для комментария или анализа, но простое копирование больших фрагментов контента почти никогда под него не попадает.
- Атрибуция: Если вы публично используете собранные данные, всегда указывайте источник. Но помните: ссылка на источник не делает использование законным, если вы нарушаете другие права.
- Не продавайте сырые данные: Особенно рискованна продажа не изменённых, «сырых» датасетов. Лучше использовать собранные данные для получения инсайтов, а не как готовый продукт.
Совет: Используйте собранные данные для внутренней аналитики и принятия решений. Если нужно делиться ими наружу, агрегируйте или преобразуйте их и обязательно проверяйте, не требуется ли разрешение (Thunderbit Blog).
Кейсы из индустрии: как снизить юридические риски
Рассмотрим реальные примеры — ведь ничто не учит комплаенсу лучше, чем чужие ошибки:
LinkedIn против hiQ Labs
- Что произошло: hiQ Labs собирала публичные профили LinkedIn, чтобы строить аналитику текучести кадров. LinkedIn пыталась это заблокировать, но суд решил, что сбор публичных данных не нарушает CFAA.
- Урок: В США сбор публичных данных юридически защищаем, но по-прежнему нужно учитывать условия использования сайта и претензии по приватности (California Lawyers Association).
eBay против Bidder’s Edge
- Что произошло: Bidder’s Edge агрессивно собирал данные с аукционов eBay — до 100 000 запросов в день, нарушая условия использования и robots.txt. Суд выдал injunction за trespass to chattels.
- Урок: Даже сбор публичных данных может быть незаконным, если он слишком агрессивный или нарушает прямые правила сайта (Wikipedia).
Facebook (Meta) против Power Ventures
- Что произошло: Power Ventures собирал данные Facebook с согласия пользователей, но после того как Facebook отозвал доступ и заблокировал IP-адреса, компания продолжила скрейпинг. Суд признал это «несанкционированным доступом».
- Урок: Если владелец сайта требует прекратить сбор данных, вы обязаны остановиться — иначе рискуете нарушить антихакерские законы.
Успешные примеры комплаенса
Многие сервисы сравнения цен в ЕС работают легально, собирая только фактические данные, уважая отказ от участия и не выгружая целые базы данных. Отсутствие исков против таких компаний показывает, что работает именно модель «публичные неперсональные данные + соблюдение правил сайта».
Чем помогает Thunderbit
Встроенные предупреждения Thunderbit, лимиты скорости и браузерный подход помогли бы избежать многих подобных ошибок — предупреждая о рискованных сайтах и по умолчанию задавая вежливый, аккуратный режим скрейпинга.
Самопроверка комплаенса для сбора данных в бизнес-сценариях
Вот практичный чек-лист для вашего следующего проекта по сбору данных:
- Данные публичные? (Логин не требуется)
- Что говорят условия использования сайта? (Есть ли запреты на скрейпинг?)
- Проверяли robots.txt? (Не запрещён ли нужный раздел?)
- Собираете персональные данные? (Если да, есть ли у вас privacy-plan?)
- Собираете большую часть сайта? (Лучше не тянуть целые базы данных)
- Какова цель? (Внутреннее использование = безопаснее; публичное повторное использование = больше рисков)
- Скрейпите аккуратно? (Человеческий темп, без технического обхода)
- Есть ли API? (Если есть — используйте его)
- Готовы остановиться по требованию? (Нужен план на случай cease-and-desist)
- Как вы будете хранить и защищать данные? (Ограничьте доступ, защитите приватность)
- Документируете процесс? (Сохраняйте записи для комплаенса)
Если на любой из этих пунктов вы отвечаете «нет» или сомневаетесь, лучше сделать паузу и прояснить вопрос до начала работы (Thunderbit Blog).
Пример рабочего процесса для комплаенс-скрейпинга с Thunderbit
 Разберём типичный безопасный для комплаенса сценарий работы в Thunderbit:
- Проверка до скрейпинга: Откройте robots.txt и условия использования сайта. Нет антискрейпинговых формулировок? Значит, можно двигаться дальше.
- Откройте Thunderbit: Перейдите на нужную страницу и запустите расширение Thunderbit для Chrome.
- Извлечение в один клик: Позвольте AI Thunderbit предложить релевантные, не чувствительные поля. Проверьте, что персональные данные не включены, если у вас нет законного основания.
- Настройте поля: При необходимости измените колонки и типы данных — собирайте только то, что действительно нужно.
- Запустите сбор: Нажмите «Scrape». Thunderbit извлекает данные в человеческом темпе, учитывая структуру сайта.
- Сбор подстраниц: Если нужно, используйте функцию subpage, чтобы обогатить данные — снова только публичной информацией.
- Экспорт: Отправьте данные напрямую в Google Sheets, Excel, Airtable или Notion для внутреннего анализа.
- Планирование (опционально): Настройте регулярный сбор с разумными интервалами — не слишком часто.
- Документация: Сохраняйте запись о том, что вы собрали, когда и зачем.
Интерфейс Thunderbit будет подсказывать на каждом шаге, если возникают вопросы комплаенса — так вы никогда не работаете вслепую.
Узнайте больше о функциях комплаенса в Thunderbit Бесплатный план включает 6 страниц в месяц, кредитная карта не нужна — это низкорисковый способ протестировать извлечение данных с публичных страниц. Get Started Free
Заключение и ключевые рекомендации: как получать ценность из данных безопасно и в рамках закона
Веб-скрейпинг — мощный инструмент для роста бизнеса, но это не «безлимитная зона». Правовая картина сложная, однако базовые принципы понятны:
- По возможности собирайте публичные неперсональные данные только для внутреннего использования.
- Всегда проверяйте условия сайта, robots.txt и применимые законы перед стартом.
- Не собирайте персональные данные и креативный контент без законного основания и privacy-плана.
- Используйте комплаенс-ориентированные инструменты вроде Thunderbit, чтобы выстроить безопасный рабочий процесс и снизить риски.
- Документируйте свои действия и будьте готовы остановиться по требованию.
Если сделать комплаенс привычкой, можно раскрыть ценность веб-данных — без юридических головных болей. А если хотите увидеть, насколько простым может быть законный скрейпинг, попробуйте Thunderbit. Ваши юристы — и вы сами в будущем — скажете спасибо.
Больше материалов о веб-скрейпинге, комплаенсе и автоматизации ищите в Thunderbit Blog.
Попробуйте агентный веб-скрейпер для безопасного извлечения данных Get Started Free
FAQ
1. Законно ли собирать данные с любого сайта?
Не всегда. Сбор публичных неперсональных данных для внутреннего использования во многих регионах обычно законен, но сбор персональных данных, защищённого авторским правом контента или данных за логином может быть рискованным или прямо незаконным. Всегда проверяйте условия сайта и местные законы перед скрейпингом (Thunderbit Blog).
2. В чём разница между сбором и повторным использованием данных?
Сбор данных — это сам факт извлечения информации; повторное использование — это публикация, продажа или иное распространение этих данных. Внутреннее использование намного безопаснее. Публикация или продажа собранных данных может вызвать претензии по авторскому праву, правам на базы данных или нарушению договора (Thunderbit Blog).
3. Как Thunderbit помогает соблюдать комплаенс?
Thunderbit собирает только то, что видно в браузере, предупреждает о рискованных сайтах, предлагает релевантные и не чувствительные поля, а также ограничивает скорость запросов, чтобы не перегружать серверы. Кроме того, он не хранит ваши данные, а варианты экспорта рассчитаны на внутреннее использование (Thunderbit Blog).
4. Что делать, если я получил письмо с требованием прекратить действия?
Немедленно остановите скрейпинг и пересмотрите проект. Продолжение после прямого требования прекратить работу может превратить «серую зону» в явное нарушение антихакерских законов или условий договора (Thunderbit Blog).
5. Можно ли собирать персональные данные, если они публичные?
Не без законного основания. Законы о приватности, такие как GDPR и CCPA, применяются даже к публичным персональным данным. Вам понадобится согласие или весомый законный интерес, а также ответственная обработка данных (Thunderbit Blog).
Это руководство носит информационный характер и не является юридической консультацией. Для сложных или высокорисковых проектов обратитесь к квалифицированному юристу, который хорошо знаком с законами о данных и приватности в вашей юрисдикции.
Читать далее




