
Объем веб-данных стремительно растет, а вместе с ним растет и давление на команды, которым нужно успевать за этим потоком. Я не раз видел, как отделы продаж и операционные команды тратят больше времени на таблицы и копирование данных с сайтов, чем на реальные решения. По данным Salesforce, специалисты по продажам теперь тратят до 70% своего времени на задачи, не связанные напрямую с продажами, а Asana пишет, что 60% работы - это просто "работа вокруг работы". Это огромное количество часов, потерянных на ручной сбор данных, хотя их можно было бы потратить на сделки или запуск кампаний.
Но есть и хорошая новость: веб-скрапинг давно стал массовым инструментом, и вам не обязательно быть разработчиком, чтобы использовать его силу. Ruby много лет остается любимым языком для автоматизации извлечения данных с сайтов, а в паре с современными AI web scraper вроде Thunderbit он дает лучшее из двух миров: гибкость для разработчиков и no-code простоту для всех остальных. Если вы маркетолог, ecommerce-менеджер или просто устали от бесконечного copy-paste, это руководство покажет, как освоить веб-скрапинг с Ruby и AI без необходимости писать код.
Попробовать Thunderbit для веб-скрапинга без кода
Что такое веб-скрапинг на Ruby? Ваш вход в автоматический сбор данных
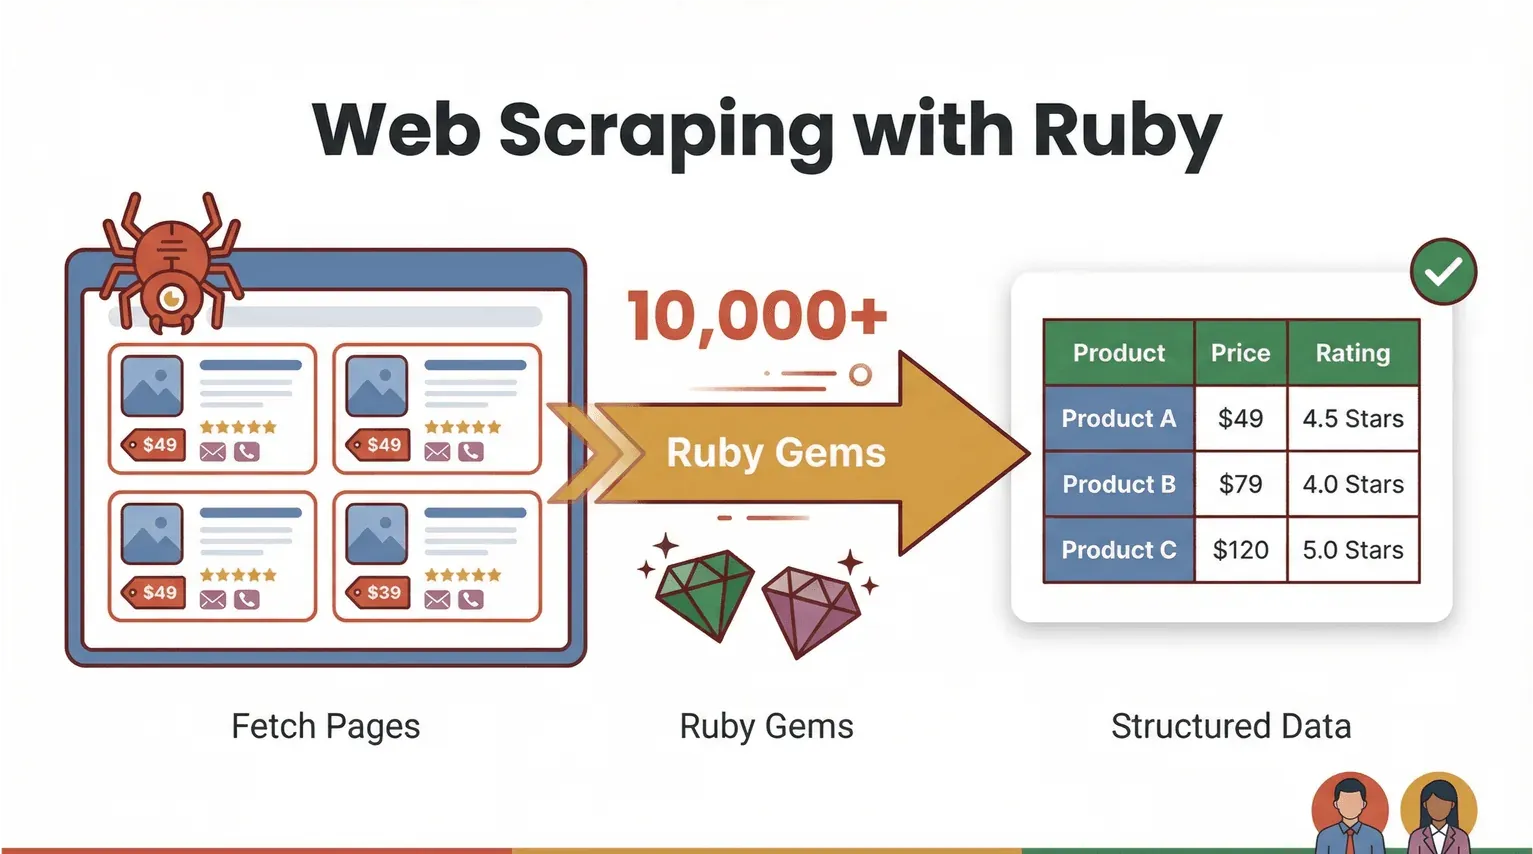
Начнем с основ. Веб-скрапинг - это процесс, при котором программа загружает веб-страницы и извлекает из них нужную информацию: цены товаров, контакты, отзывы и другие данные, а затем складывает результат в структурированный формат вроде CSV или Excel. С Ruby веб-скрапинг получается одновременно мощным и довольно понятным. Язык известен читаемым синтаксисом и большим набором “gems” (библиотек), которые заметно упрощают автоматизацию (Ruby Programming Language).
Как выглядит “веб-скрапинг на Ruby” на практике? Допустим, вам нужно собрать названия и цены всех товаров с ecommerce-сайта. С Ruby можно написать скрипт, который:
- Загружает веб-страницу (например, через библиотеку HTTParty)
- Разбирает HTML и находит нужные данные (с помощью Nokogiri)
- Экспортирует результат в таблицу или базу данных
Но здесь начинается самое интересное: писать код нужно не всегда. AI-инструменты для no-code веб-скрапинга, такие как Thunderbit, уже умеют брать на себя тяжелую часть работы: читать страницы, определять поля и экспортировать аккуратные таблицы данных буквально за пару кликов. Ruby по-прежнему отлично работает как “клей” для кастомной автоматизации, но AI web scraper открывает эту возможность и для бизнес-пользователей.
Что такое скрапинг данных? Get Started Free
Почему веб-скрапинг на Ruby важен для бизнес-команд
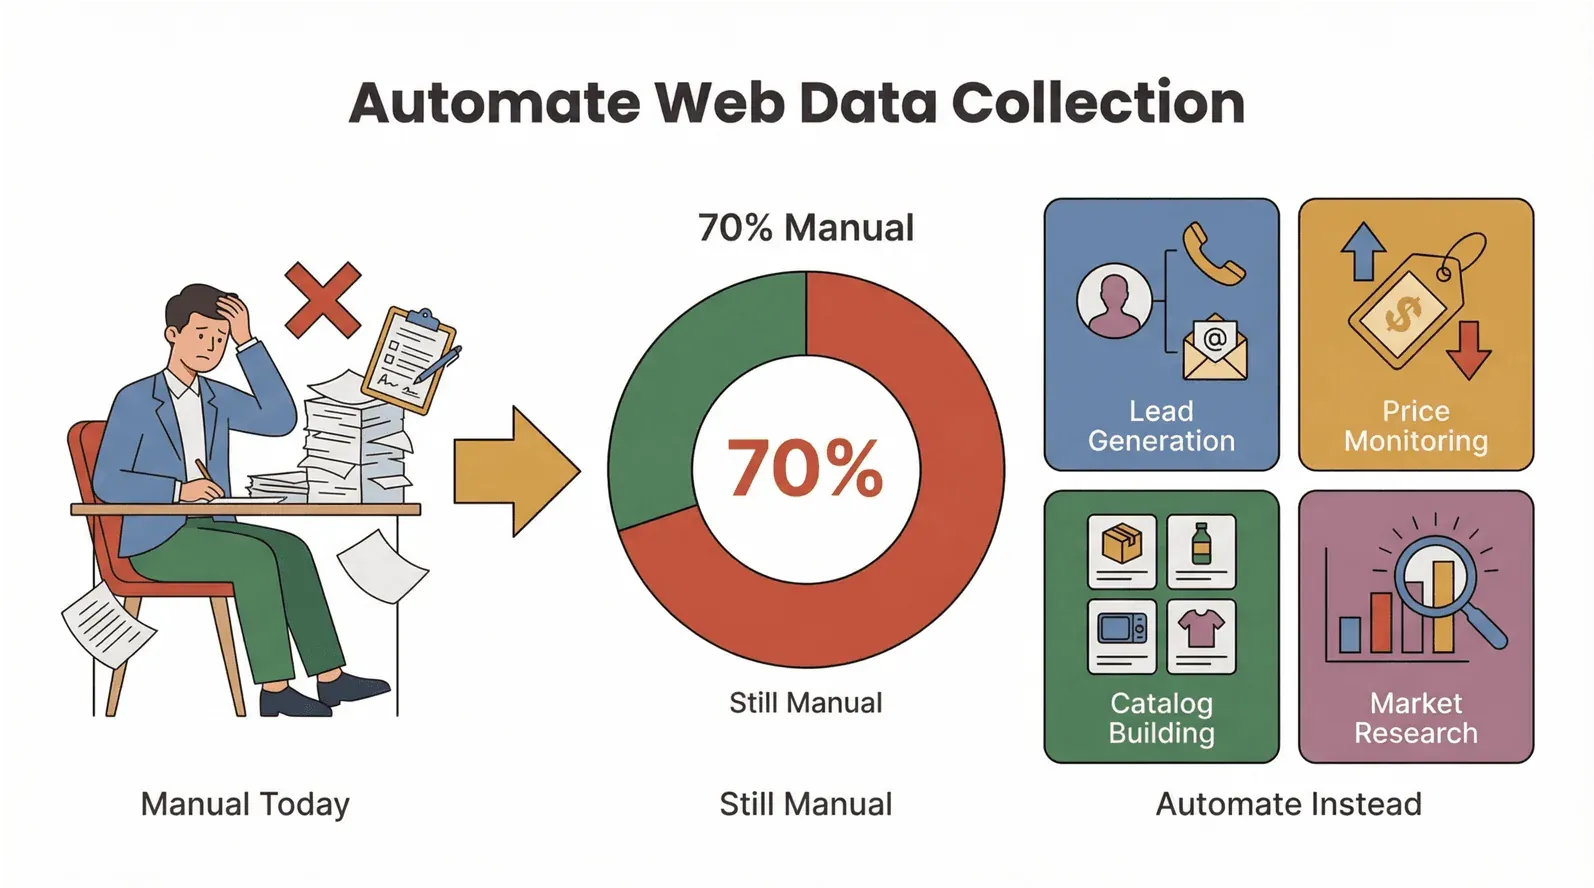
Скажем честно: никто не хочет проводить день, копируя и вставляя данные. Спрос на автоматическое извлечение веб-данных быстро растет, и причина понятна. Вот как веб-скрапинг на Ruby и AI-инструменты меняют бизнес-процессы:
- Лидогенерация: быстро собирайте контакты из каталогов или LinkedIn для вашей воронки продаж.
- Мониторинг цен конкурентов: отслеживайте изменения цен по сотням ecommerce SKU без ручных проверок.
- Создание товарного каталога: собирайте характеристики и изображения товаров для своего магазина или маркетплейса.
- Исследование рынка: собирайте отзывы, рейтинги или новостные статьи для анализа трендов.
ROI здесь понятен: команды, которые автоматизируют сбор веб-данных, экономят часы каждую неделю, сокращают ошибки и получают более свежие и надежные данные. Например, в производстве 70% компаний все еще собирают данные вручную, хотя объем данных всего за два года удвоился. Это огромная зона для автоматизации.
Коротко о том, какую ценность дают веб-скрапинг на Ruby и AI-инструменты:
| Сценарий | Боль ручной работы | Польза автоматизации | Типичный результат |
|---|---|---|---|
| Лидогенерация | Копирование email по одному | Сбор тысяч контактов за минуты | В 10 раз больше лидов, меньше рутины |
| Мониторинг цен | Ежедневные проверки сайтов | Плановый автоматический сбор цен | Актуальная ценовая аналитика |
| Создание каталога | Ручной ввод данных | Массовое извлечение и форматирование | Более быстрые запуски, меньше ошибок |
| Исследование рынка | Ручное чтение отзывов | Сбор и анализ в масштабе | Более глубокие и свежие инсайты |
И дело не только в скорости: автоматизация означает меньше ошибок и более стабильные данные, что критично, когда 58% руководителей говорят, что их решения зависят от неточных или несогласованных данных.
Обзор решений для веб-скрапинга: Ruby-скрипты против AI Web Scraper
Что выбрать: написать собственный Ruby-скрипт или использовать AI-инструмент для веб-скрапинга без кода? Разберем варианты.
Ruby-скрипты: полный контроль, но больше поддержки
В экосистеме Ruby есть gems почти для любой задачи скрапинга:
- Nokogiri: основной инструмент для разбора HTML и XML.
- HTTParty: удобен для загрузки веб-страниц и работы с API.
- Mechanize: подходит для сайтов с cookies, формами и навигацией.
- Selenium / Watir: для автоматизации настоящего браузера, особенно на сайтах с большим количеством JavaScript.
Ruby-скрипты дают максимальную гибкость: собственная логика, очистка данных, интеграция с внутренними системами. Но вместе с этим вы берете на себя поддержку. Если сайт меняет верстку, скрипт может сломаться. А если код для вас не привычная среда, придется пройти кривую обучения.
AI Web Scraper и no-code инструменты: быстро, удобно и адаптивно
Современные no-code web scraper вроде Thunderbit меняют подход. Вместо кода вы:
- Открываете расширение Chrome
- Нажимаете “AI Suggest Fields”, чтобы AI определил, какие данные извлекать
- Нажимаете “Scrape” и экспортируете данные
AI в Thunderbit адаптируется к изменениям на страницах, умеет работать с подстраницами вроде карточек товаров и экспортирует данные напрямую в Excel, Google Sheets, Airtable или Notion. Это хороший вариант для бизнес-пользователей, которым нужен результат без лишней технической возни.
Вот сравнение бок о бок:
| Подход | Плюсы | Минусы | Лучше всего подходит для |
|---|---|---|---|
| Ruby-скрипты | Полный контроль, кастомная логика, гибкость | Более крутая кривая обучения, поддержка | Разработчики, продвинутые пользователи |
| AI Web Scraper | Без кода, быстрый старт, адаптация к изменениям | Меньше точечного контроля, есть ограничения | Бизнес-пользователи, ops-команды |
Тренд очевиден: по мере того как сайты становятся сложнее и активнее защищаются от автоматизации, AI web scraper все чаще становится основным выбором для большинства бизнес-сценариев.
Начало работы: настройка среды для веб-скрапинга на Ruby
Если вы готовы попробовать Ruby-скрипты, начнем с настройки среды. Хорошая новость: Ruby легко устанавливается и работает на Windows, macOS и Linux.
Шаг 1: установите Ruby
- Windows: скачайте RubyInstaller и следуйте инструкциям. Обязательно включите MSYS2 для сборки native extensions, которые нужны для gems вроде Nokogiri.
- macOS/Linux: используйте rbenv для управления версиями. В Terminal:
brew install rbenv ruby-build
rbenv install 4.0.4
rbenv global 4.0.4
(Последнюю стабильную версию можно проверить на странице загрузок Ruby.)
Шаг 2: установите Bundler и основные gems
Bundler помогает управлять зависимостями:
gem install bundler
Создайте Gemfile для проекта:
source 'https://rubygems.org'
gem 'nokogiri'
gem 'httparty'
Затем выполните:
bundle install
Так вы получите стабильную среду, готовую к скрапингу.
Шаг 3: проверьте настройку
Попробуйте выполнить это в IRB, интерактивной оболочке Ruby:
require 'nokogiri'
require 'httparty'
puts Nokogiri::VERSION
Если видите номер версии, все готово.
Пошагово: создаем первый Ruby Web Scraper
Разберем реальный пример: сбор данных о товарах с сайта Books to Scrape, который специально создан для практики скрапинга.
Вот простой Ruby-скрипт для извлечения названий книг, цен и статуса наличия:
require "net/http"
require "uri"
require "nokogiri"
require "csv"

BASE_URL = "https://books.toscrape.com/"

def fetch_html(url)
  uri = URI.parse(url)
  res = Net::HTTP.get_response(uri)
  raise "HTTP #{res.code} for #{url}" unless res.is_a?(Net::HTTPSuccess)
  res.body
end

def scrape_list_page(list_url)
  html = fetch_html(list_url)
  doc  = Nokogiri::HTML(html)
  products = doc.css("article.product_pod").map do |pod|
    title = pod.css("h3 a").first["title"]
    price = pod.css(".price_color").text.strip
    stock = pod.css(".availability").text.strip.gsub(/\s+/, " ")
    { title: title, price: price, stock: stock }
  end
  next_rel = doc.css("li.next a").first&.[]("href")
  next_url = next_rel ? URI.join(list_url, next_rel).to_s : nil
  [products, next_url]
end

rows = []
url  = "#{BASE_URL}catalogue/page-1.html"
while url
  products, url = scrape_list_page(url)
  rows.concat(products)
end

CSV.open("books.csv", "w", write_headers: true, headers: %w[title price stock]) do |csv|
  rows.each { |r| csv << [r[:title], r[:price], r[:stock]] }
end

puts "Wrote #{rows.length} rows to books.csv"
Этот скрипт загружает каждую страницу, разбирает HTML, извлекает данные и записывает их в CSV-файл. Затем books.csv можно открыть в Excel или Google Sheets.
Типичные проблемы:
- Если появляются ошибки о недостающих gems, проверьте
Gemfileи запуститеbundle install. - Для сайтов, которые загружают данные через JavaScript, понадобится инструмент автоматизации браузера вроде Selenium или Watir.
Усиливаем Ruby-скрапинг с Thunderbit: AI Web Scraper в действии
Теперь посмотрим, как Thunderbit может вывести скрапинг на новый уровень без кода.
Thunderbit - это AI web scraper Chrome extension, которое позволяет извлекать структурированные данные с любого сайта всего за два клика. Работает это так:
- Откройте расширение Thunderbit на странице, которую хотите собрать.
- Нажмите “AI Suggest Fields”. AI Thunderbit просканирует страницу и предложит лучшие колонки для извлечения, например “Product Name”, “Price”, “Stock”.
- Нажмите “Scrape”. Thunderbit соберет данные, обработает пагинацию и при необходимости перейдет по подстраницам за дополнительными деталями.
- Экспортируйте данные напрямую в Excel, Google Sheets, Airtable или Notion.
Thunderbit особенно полезен тем, что справляется со сложными динамическими страницами без хрупких селекторов и без кода. А если вы хотите совместить подходы, можно сначала извлечь данные через Thunderbit, а затем обработать или обогатить их Ruby-скриптом.
Совет: скрапинг подстраниц в Thunderbit очень выручает ecommerce- и real estate-команды. Соберите список ссылок на товары, а затем дайте Thunderbit открыть каждую страницу и автоматически извлечь характеристики, изображения или отзывы, обогащая ваш датасет.
Как собрать данные с любого сайта с помощью AI Get Started Free
Реальный пример: сбор ecommerce-данных о товарах и ценах с Ruby и Thunderbit
Соберем все вместе на практическом workflow для ecommerce-команды.
Сценарий: вам нужно отслеживать цены конкурентов и сведения о товарах по сотням SKU.
Шаг 1: используйте Thunderbit для сбора основного списка товаров
- Откройте страницу каталога конкурента.
- Запустите Thunderbit и нажмите “AI Suggest Fields” (например, Product Name, Price, URL).
- Нажмите “Scrape” и экспортируйте результат в CSV.
Шаг 2: обогатите данные через скрапинг подстраниц
- В Thunderbit используйте функцию “Scrape Subpages”, чтобы открыть страницу каждого товара и извлечь дополнительные поля, например описание, наличие или изображения.
- Экспортируйте обогащенную таблицу.
Шаг 3: обработайте или проанализируйте данные с Ruby
- Используйте Ruby-скрипт для дополнительной очистки, преобразования или анализа данных. Например, можно:
- Привести цены к одной валюте
- Отфильтровать товары не в наличии
- Посчитать сводную статистику
Вот простой фрагмент Ruby, который оставляет только товары в наличии:
require 'csv'

rows = CSV.read('products.csv', headers: true)
in_stock = rows.select { |row| row['stock'].include?('In stock') }

CSV.open('in_stock_products.csv', 'w', write_headers: true, headers: rows.headers) do |csv|
  in_stock.each { |row| csv << row }
end
Результат:
Вы превращаете сырые веб-страницы в чистую, пригодную к работе таблицу данных, готовую для анализа цен, планирования запасов или маркетинговых кампаний. И все это без единой строки кода для скрапинга.
No-Code? Не проблема: автоматизация веб-данных для всех
Одна из вещей, которые мне больше всего нравятся в Thunderbit, - он дает автоматизацию людям без технического бэкграунда. Вам не нужно знать Ruby, HTML или CSS: просто откройте расширение, дайте AI сделать свою работу и экспортируйте данные.
Кривая обучения: с Ruby-скриптами нужно освоить основы программирования и структуру веб-страниц. С Thunderbit настройка занимает минуты, а не дни.
Интеграции: Thunderbit экспортирует данные напрямую в инструменты, которыми бизнес-команды уже пользуются: Excel, Google Sheets, Airtable, Notion. Можно даже настроить регулярные запуски скрапинга для постоянного мониторинга.
Отзывы пользователей: я видел, как маркетинговые команды, sales ops и ecommerce-менеджеры автоматизируют с Thunderbit все: от сбора списков лидов до отслеживания цен, не обращаясь в IT.
Лучшие практики: как сочетать Ruby и AI Web Scraper для масштабируемой автоматизации
Хотите построить надежный и масштабируемый процесс скрапинга? Вот мои главные советы:
- Учитывайте изменения сайтов: AI web scraper вроде Thunderbit адаптируются автоматически, но если вы используете Ruby-скрипты, будьте готовы обновлять селекторы при изменении сайтов.
- Планируйте запуски: используйте планировщик Thunderbit для регулярного сбора данных. Для Ruby настройте cron job или другой task scheduler.
- Обрабатывайте данные пакетами: большие датасеты лучше делить на партии, чтобы снизить риск блокировок и не перегружать систему.
- Форматируйте данные: всегда очищайте и проверяйте данные перед анализом. Экспорт Thunderbit уже структурирован, но кастомным Ruby-скриптам могут потребоваться дополнительные проверки.
- Соблюдайте правила: собирайте только публично доступные данные, уважайте
robots.txtи учитывайте законы о приватности, особенно в EU, где GDPR применяется к персональным данным, полученным через скрапинг. - Готовьте запасные варианты: если сайт становится слишком сложным или блокирует скрапинг, ищите официальные API или альтернативные источники данных.
Когда что использовать?
- Используйте Ruby-скрипты, когда нужен полный контроль, кастомная логика или интеграция с внутренними системами.
- Используйте Thunderbit, когда важны скорость, простота и адаптивность, особенно для разовых или регулярных бизнес-задач.
- Сочетайте оба подхода для продвинутых workflow: пусть Thunderbit отвечает за извлечение, а Ruby - за обогащение, QA или интеграции.
Заключение и ключевые выводы
Веб-скрапинг на Ruby всегда был суперсилой для автоматизации сбора данных, но теперь благодаря AI web scraper вроде Thunderbit эта сила доступна всем. Если вы разработчик и хотите гибкости или бизнес-пользователь, которому просто нужен результат, вы можете автоматизировать извлечение веб-данных, экономить часы ручной работы и принимать решения быстрее и точнее.
Вот что стоит запомнить:
- Ruby - отличный инструмент для веб-скрапинга и автоматизации, особенно с gems вроде Nokogiri и HTTParty.
- AI web scraper вроде Thunderbit делают извлечение данных доступным людям без кода благодаря функциям вроде “AI Suggest Fields” и скрапинга подстраниц.
- Сочетание Ruby и Thunderbit дает лучшее из двух миров: быстрое no-code извлечение плюс кастомная автоматизация и анализ.
- Автоматизация сбора веб-данных - сильный план для sales, marketing и ecommerce-команд: меньше ручной работы, выше точность, больше новых инсайтов.
Готовы начать? Скачайте Thunderbit, попробуйте простой Ruby-скрипт и посмотрите, сколько времени можно сэкономить. А если хотите углубиться, загляните в Thunderbit Blog, где есть больше руководств, советов и реальных примеров.
Скачать расширение Thunderbit для Chrome
FAQs
1. Нужно ли уметь программировать, чтобы использовать Thunderbit для веб-скрапинга?
Нет. Thunderbit создан для пользователей без технического бэкграунда. Откройте расширение, нажмите “AI Suggest Fields” и дайте AI сделать остальное. Данные можно экспортировать в Excel, Google Sheets, Airtable или Notion без кода.
2. В чем главные преимущества Ruby для веб-скрапинга?
Ruby предлагает мощные библиотеки вроде Nokogiri и HTTParty для гибких кастомных scraping workflow. Он отлично подходит разработчикам, которым нужен полный контроль, собственная логика и интеграция с другими системами.
3. Как работает функция “AI Suggest Fields” в Thunderbit?
AI Thunderbit сканирует веб-страницу, определяет самые релевантные поля данных, например названия товаров, цены или email, и предлагает вам структурированную таблицу. Перед скрапингом колонки можно настроить.
4. Можно ли сочетать Thunderbit с Ruby-скриптами для продвинутых workflow?
Да. Многие команды используют Thunderbit для извлечения данных, особенно со сложных или динамических сайтов, а затем дополнительно обрабатывают или анализируют их Ruby-скриптами. Такой гибридный подход хорошо подходит для кастомной отчетности и обогащения данных.
5. Законен и безопасен ли веб-скрапинг для бизнеса?
Веб-скрапинг законен, когда вы собираете публично доступные данные и соблюдаете условия использования сайта и законы о приватности. Всегда проверяйте robots.txt и не собирайте персональные данные без надлежащего согласия, особенно для пользователей из EU в рамках GDPR.
Хотите увидеть, как веб-скрапинг может изменить ваш workflow? Попробуйте бесплатный тариф Thunderbit или поэкспериментируйте с Ruby-скриптом уже сегодня. А если застрянете, в Thunderbit Blog и на Thunderbit YouTube Channel есть много обучающих материалов и советов, которые помогут освоить автоматизацию веб-данных без кода.
Попробовать Thunderbit AI Web Scraper Get Started Free
Learn More



