
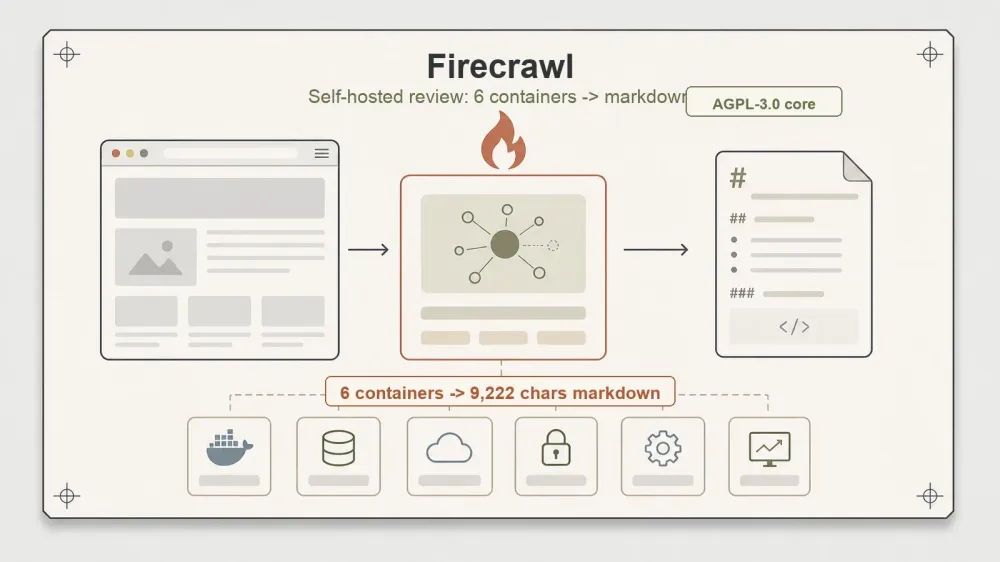
Большинство людей считают Firecrawl обычной библиотекой для веб-скрапинга — ну, знаете, из тех, что устанавливаются через pip install, требуют написания скрипта и сразу готовы к работе. Но это не совсем так, и разница тут принципиальная, ещё до того, как вы введёте первую команду. Firecrawl в режиме самостоятельного хостинга — это не библиотека, которую вы просто импортируете; это целый сервис, которым вы управляете, и для его запуска нужно поднять шесть Docker-контейнеров, которые взаимодействуют друг с другом.
Я запустил этот стек на своём Mac (arm64, Docker через colima) без облачного ключа, направил его конечную точку /v1/scrape на пару тестовых сайтов, удобных для скрапинга, и посмотрел, что получится. Если коротко: основное обещание выполнено — страница обрабатывается, и на выходе получается чистый Markdown, готовый для LLM, — но вот настройка оказалась самой сложной из всех инструментов, что я тестировал в рамках этого исследования. Это предварительный обзор, а не окончательная оценка, и я чётко укажу, что именно я тестировал, а что нет.
Firecrawl — это сервис, а не библиотека
Вот какую ментальную модель нужно усвоить в первую очередь. Инструменты для скрапинга, к которым обычно обращаются разработчики, — это библиотеки: вы добавляете зависимость, вызываете функцию, получаете HTML или разобранные данные прямо в своём процессе. Firecrawl в режиме самостоятельного хостинга — это совсем другое. Это полноценная платформа со своим собственным API, и вы взаимодействуете с ней по HTTP.
Официально это позиционируется как «API для поиска, скрапинга и взаимодействия с вебом в масштабе», и продукт именно такой — страницы поступают, а на выходе чистый Markdown или структурированные данные. При самостоятельном хостинге вы не связываетесь с Firecrawl как с библиотекой. Вы поднимаете стек docker compose и обращаетесь к его конечной точке, точно так же, как к любому внутреннему микросервису.
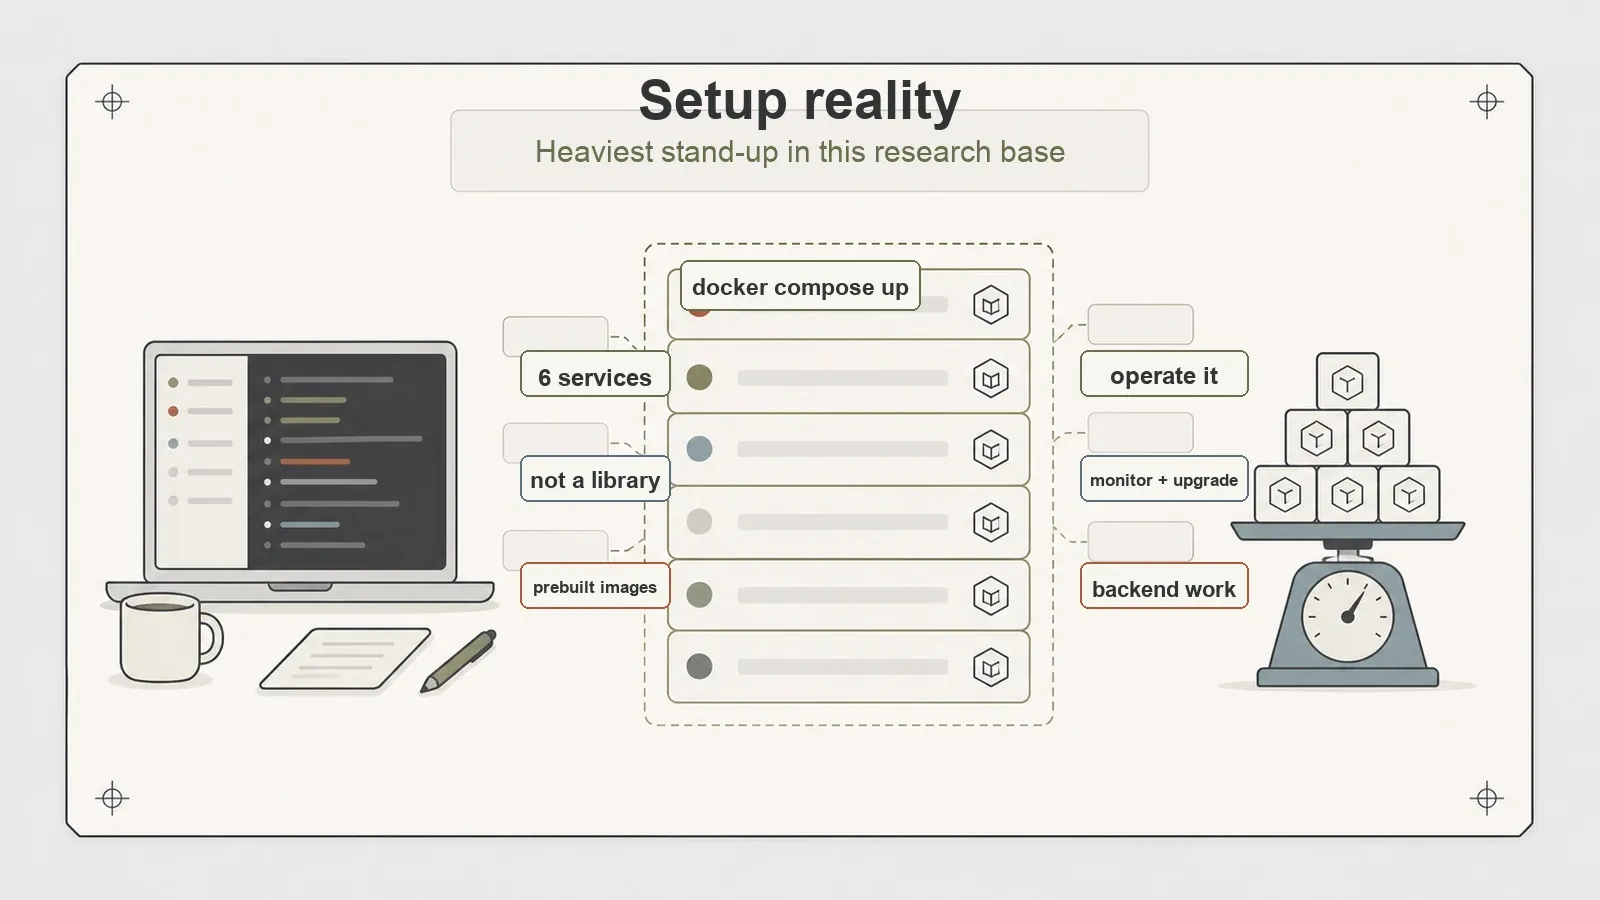
Стек, который я запустил, состоял из шести сервисов:
- api — HTTP-интерфейс, к которому вы, собственно, и обращаетесь
- playwright-service — безголовый браузер для рендеринга JavaScript
- redis — очередь и кэш
- rabbitmq — брокер сообщений
- nuq-postgres — версия Postgres для хранения состояния задач
- foundationdb — распределённое хранилище ключ-значение
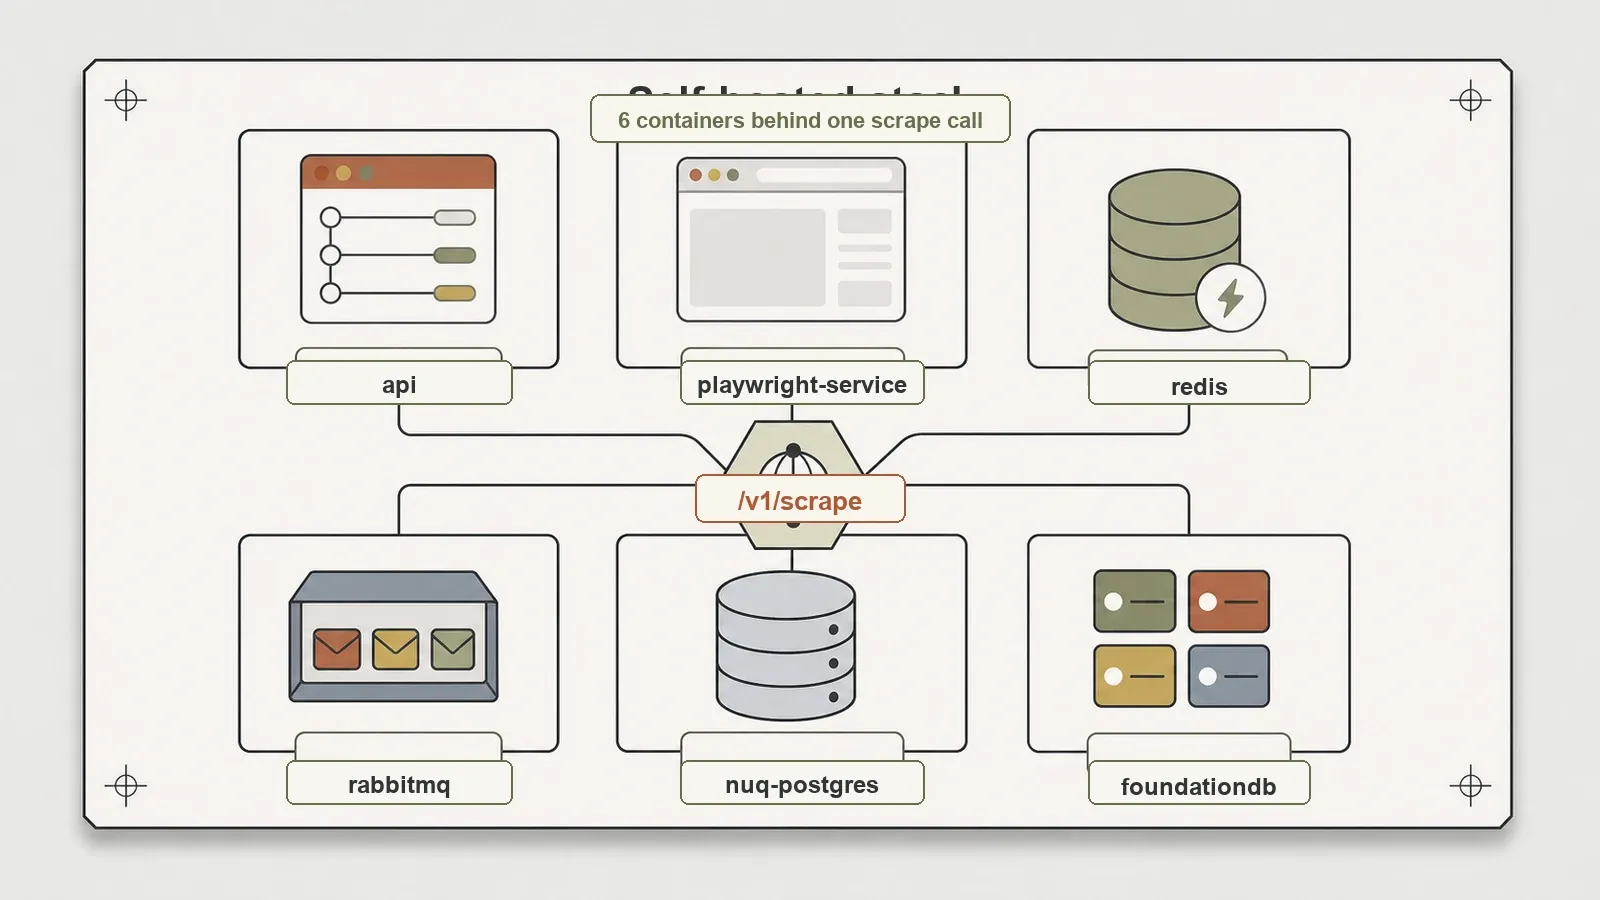
Это настоящий бэкенд, а не просто вспомогательный скрипт. Redis, RabbitMQ, Postgres и FoundationDB сами по себе являются серьёзными инфраструктурными решениями. Преимущество в том, что Firecrawl берёт на себя сложные части скрапинга — постановку в очередь, рендеринг, повторные попытки — всё это за один вызов API. Цена за это — необходимость управлять всеми шестью контейнерами. Помните об этом компромиссе; это ключевая мысль всего обзора.
Для справки, я тестировал с использованием SDK firecrawl-py 4.32.0 и firecrawl-js 4.30.0, используя официальный предварительно собранный образ ghcr.io/firecrawl/firecrawl:latest от 09.07.2026. Репозиторий на эту дату имеет примерно 148 тысяч звёзд (назовём это метаданными, а не оценкой качества) под лицензией AGPL-3.0 — деталь, к которой я ещё вернусь, потому что она меняет расклад для коммерческого использования.
Основной тест: страница превращается в чистый Markdown
Вся суть Firecrawl в том, чтобы превратить веб-страницу в Markdown, который может прочитать LLM. Это первое, что я проверил.
Я направил /v1/scrape на books.toscrape.com, статический каталог, созданный специально для тренировки скрапинга. Результат: 9 222 символа чистого Markdown, готового для LLM, с правильно разобранным заголовком страницы All products | Books to Scrape. Это не просто выгруженный в строку необработанный HTML, а структурированный Markdown с заголовками, ссылками и ссылками на изображения. Такой вывод можно сразу использовать в конвейере извлечения или подавать модели без дополнительной очистки.
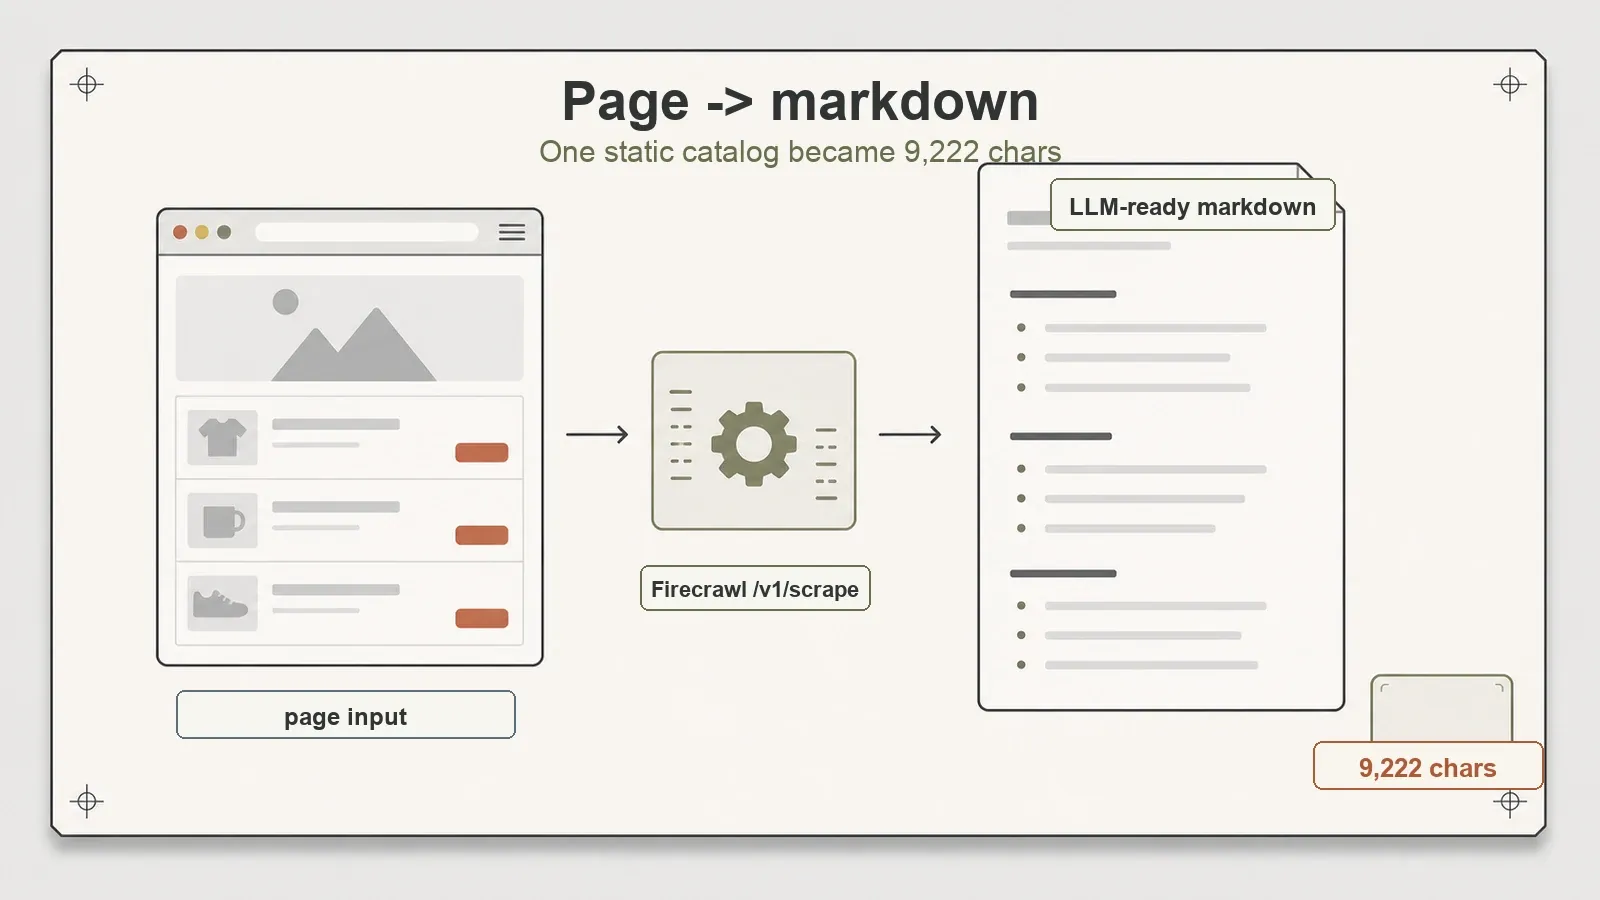
Это главная сильная сторона Firecrawl, и самостоятельный хостинг обеспечил её без проблем. Если ваша задача — «дайте мне читаемое содержимое этой страницы в виде Markdown», статическая страница возвращалась именно так, как было заявлено. Это действительно полезный примитив, и именно поэтому инструмент так популярен.
Стоит уточнить область применения: я использовал путь /v1/scrape для одной страницы. Я не тестировал /v1/crawl, многостраничный краулер, который обходит весь сайт. Это отдельная функция со своими собственными режимами отказа, и я не буду утверждать, что она работает, если я её не запускал.
Страницы JavaScript: встроенный браузер оправдывает свой контейнер
Статическая страница — это простой случай. Более сложный вопрос для любого скрапера — что происходит, когда контент появляется только после выполнения JavaScript — что в современном вебе происходит большую часть времени.
Именно здесь контейнер playwright-service перестаёт быть накладными расходами и становится смыслом. Я направил скрапер на quotes.toscrape.com/js/, версию демонстрационного сайта, которая рендерит свои цитаты на стороне клиента. Если бы Firecrawl просто извлекал необработанный HTML, цитат там не было бы — они не существуют, пока браузер не выполнит скрипт страницы.
Скрапинг вернул 1 574 символа Markdown, и цитата Эйнштейна была в нём. Эта цитата является контентом после JavaScript: её присутствие является доказательством того, что playwright-service фактически отрендерил страницу в реальном движке браузера перед извлечением текста, а не просто взял пустую оболочку до рендеринга.
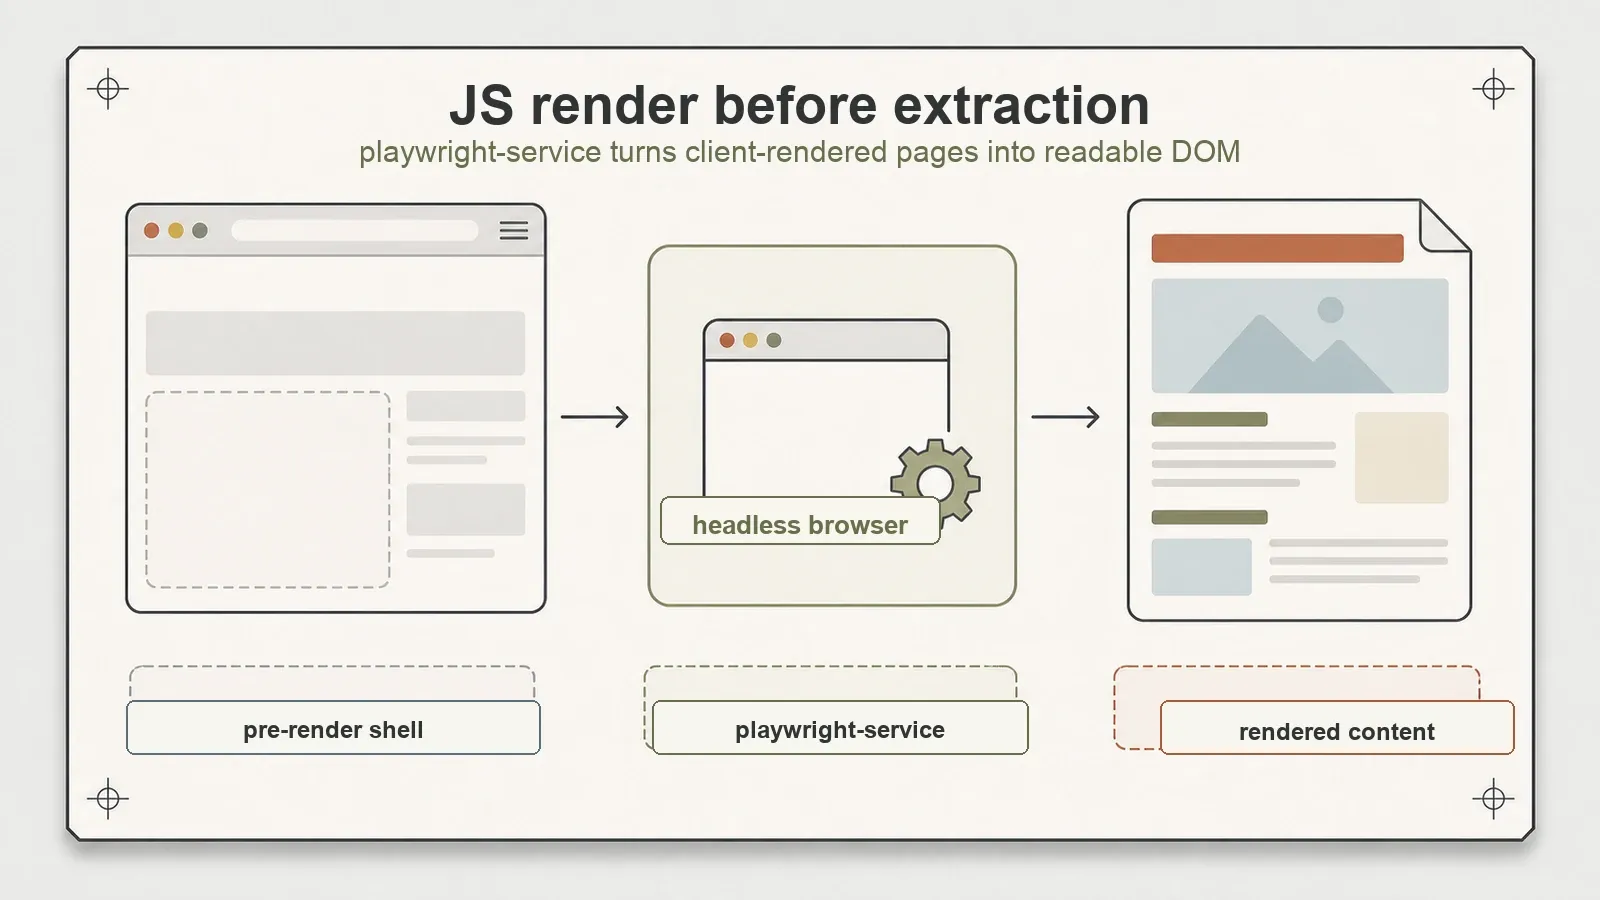
Таким образом, один из шести контейнеров — это безголовый браузер, и он выполняет ту работу, для которой вы его наняли. Это конкретное обоснование более тяжёлой архитектуры: вы платите не просто за контейнеры, вы платите за возможность рендеринга страниц с большим количеством JS без необходимости настраивать собственную автоматизацию браузера. Для многих реальных целей это разница между пригодным для использования результатом и пустыми div'ами.
Когда цель плоха: структурированные ошибки, без сбоев
Скраперы удивительно много времени проводят, работая с тем, что не работает — мёртвыми хостами, ошибочными URL-адресами, зависающими серверами. То, как инструмент терпит неудачу, так же показательно, как и то, как он преуспевает.
Я намеренно подал API неверный хост. Он вернул структурированный HTTP 500 и продолжил работу — никаких трассировок стека, вываливающихся клиенту, никаких падающих контейнеров, никаких зависших процессов. Ошибка вернулась в виде чистого ответа, на который вызывающий объект может отреагировать.
Это скучное, правильное поведение, которое вы хотите от того, что вы поместите в конвейер. Скрапер, который паникует при плохой цели, — это скрапер, который вы не можете автоматизировать. Этот вернул ошибку, которую вы можете перехватить и продолжить работу. Я тестировал только один случай ошибки, поэтому читайте это как «правильно обработал одну ошибку, которую я ему подбросил», а не как исчерпывающий аудит устойчивости — но одна точка данных была правильным результатом.
Реальность настройки: самый тяжёлый подъём в базе
Теперь та часть, которую никто не скриншотит для твита о запуске. Firecrawl с самостоятельным хостингом был, без преувеличения, самой сложной настройкой из всех инструментов в этой исследовательской базе — а я их много устанавливал.
Шесть контейнеров — это базовая стоимость. Но я также столкнулся с двумя проблемами на пути, и я хочу точно указать, чья это была вина — как оказалось, не Firecrawl.
Проблема первая: сборка из исходников. Сборка образов из исходников завершилась неудачей внутри моей виртуальной машины colima из-за ошибки снимка containerd. Это известное нестабильное взаимодействие между сборкой и уровнем хранения colima — инфраструктурный сбой в моей среде, а не ошибка в Firecrawl. Файл compose документирует альтернативу: использовать официальные предварительно собранные образы ghcr.io/firecrawl/* вместо локальной сборки. Я переключился на них, и весь стек запустился чисто. Если вы используете стандартный демон Docker, а не colima, вы можете вообще этого не увидеть; я отмечаю это как предостережение по окружению, и проверка сборки участника на чистом демоне находится в моём списке пробелов.
Проблема вторая: защита от SSRF. Мои первые скрапинги были заблокированы защитой Firecrawl от частных IP-адресов / SSRF. Почему? Сеть colima сопоставляет публичные имена хостов с адресами 198.18.x.x, которые находятся в зарезервированном диапазоне, который Firecrawl правильно считает частным — поэтому его уровень безопасности выполнил свою работу и отказался извлекать то, что выглядело как внутренняя цель. Чтобы обойти это только для локального тестирования, я установил ALLOW_LOCAL_WEBHOOKS=true.
Этот флаг копируется в продакшн и вызывает инциденты, поэтому будьте точны в том, что это такое: защита от SSRF — это функция, а не препятствие. Именно она не позволяет сервису скрапинга быть обманутым и попасть в вашу внутреннюю сеть. Я отключил её, потому что особенность DNS colima заставила мои законные публичные цели выглядеть частными внутри виртуальной машины. Не отключайте защиту от SSRF в реальном развёртывании. Если вы возьмёте одну операционную заметку из этого обзора, возьмите эту.
Обе проблемы, прямо скажем, были артефактами запуска Docker через colima на ноутбуке — а не дефектами в программном обеспечении. С другой стороны, сам вес настройки реален и является частью дизайна Firecrawl. Это не тот инструмент, к которому вы обращаетесь, когда вам нужен быстрый локальный скрипт; это инструмент, который вы устанавливаете, когда вам нужен сервис скрапинга с возможностью рендеринга, и вы готовы запускать для него инфраструктуру.
Что я не тестировал и что он не делает
Вот что я не охватил и что инструмент не предоставляет.
Самостоятельный хостинг не имеет Fire-engine. Облачный продукт Firecrawl включает Fire-engine, его проприетарный слой для обхода защиты от ботов. Согласно собственному файлу проекта SELF_HOST.md, экземпляры с самостоятельным хостингом его не получают. Так что, если вы представляете, что Firecrawl с самостоятельным хостингом пробивается через агрессивные антиботовые системы из коробки, скорректируйте картину — эта возможность находится в облачном уровне, и она не была частью того, что я запускал.
Облачный API здесь не тестировался. У меня не было облачного ключа, поэтому всё вышеперечисленное относится только к стеку с самостоятельным хостингом. Управляемый облачный сервис — с Fire-engine, масштабированием, размещённым на сервере, и функциями ИИ — это другой продукт, и я не собираюсь характеризовать его производительность извне. Считайте любые утверждения об облаке выходящими за рамки этого обзора.
Функции ИИ требуют ключа. Формат структурированного вывода json и конечная точка /extract опираются на LLM, что означает необходимость использования ключа OpenAI или подключения Ollama. Это добавляет выбор модели в список материалов: прежде чем приступить к настройке, сравните текущие цены API поставщиков, которых вы могли бы использовать. Я не использовал эти пути, поэтому /extract и структурированный вывод json также находятся в столбце нетестированных.
Прокси — это предостережение, а не заголовок. Firecrawl поддерживает настройку прокси, но я намеренно указываю это как сноску — это ручка, которую вы можете повернуть, а не причина выбирать инструмент, и самостоятельный хостинг по-прежнему не имеет антиблокировочного слоя облака, независимо от этого.
AGPL-3.0 — это реальное решение о соответствии. Это заслуживает отдельного рассмотрения.
Лицензия: прочитайте AGPL-3.0 перед отправкой
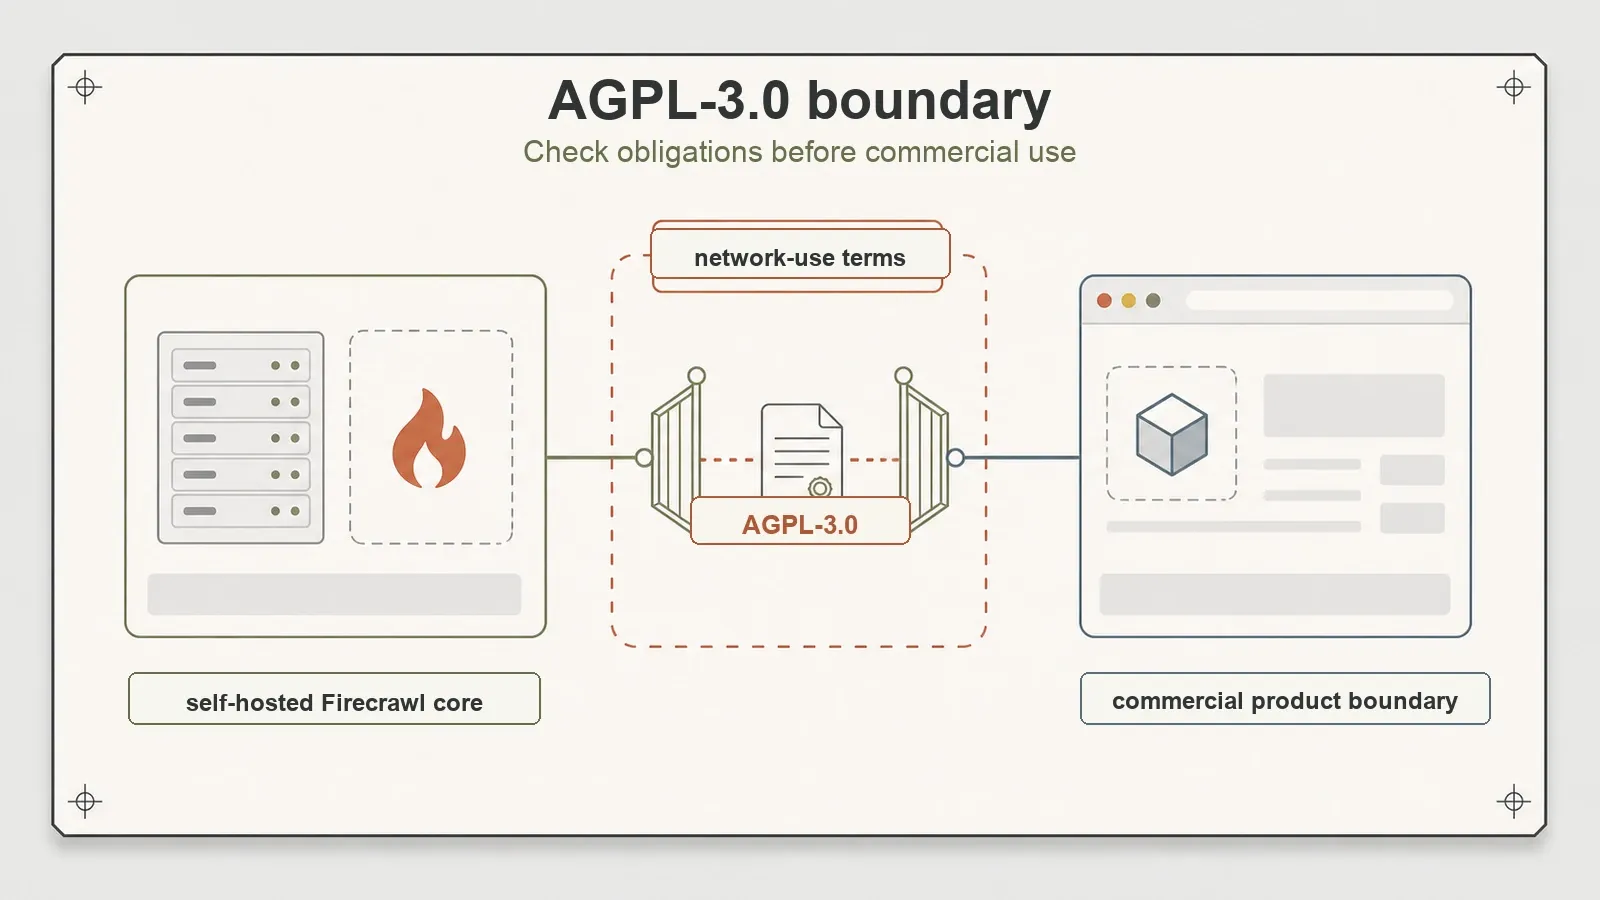
Firecrawl лицензируется под AGPL-3.0. Это не просто строка в конце README — это сильный копилефт с пунктом об использовании сети, и он может напрямую влиять на то, сможете ли вы создать коммерческий продукт на основе самостоятельно размещённого экземпляра.
Коротко: стандартные обязательства GPL возникают при распространении. AGPL идёт дальше — положение об использовании сети означает, что предоставление функциональности программного обеспечения пользователям по сети может считаться таким использованием, которое влечёт за собой обязательства по доступности исходного кода. Если вы встраиваете Firecrawl с самостоятельным хостингом в сервис, к которому ваши клиенты обращаются через Интернет, этот пункт находится в полной мере в сфере действия, и «мы никогда не поставляли бинарный файл» не является лазейкой, которую люди предполагают.
Я не ваш юрист, и интерпретация лицензии зависит от того, как именно вы развёртываете. Но для любой коммерческой рекомендации AGPL-3.0 является первостепенным соображением, а не мелким шрифтом. Привлеките того, кто отвечает за лицензирование в вашей компании, прежде чем строить на этом. Отметка об этом не является критикой Firecrawl — многие отличные инструменты являются AGPL — это просто факт, который вам нужно иметь в виду с самого начала.
Где подходит стек разработчика Thunderbit
Попробуйте Thunderbit для извлечения веб-данных
Если ваша реальная цель — «страница → Markdown, готовый для LLM» или «страница → структурированные данные», и шестиконтейнерный операционный налог плюс вопрос AGPL не являются тем, чем вы хотите владеть, то именно для этого создан стек разработчика Thunderbit. Тот же движок ИИ, который используется нашими более чем 100 000 пользователями расширений, представлен тремя способами для технической работы — с инфраструктурой, оставленной на нашей стороне.
- Открытый API (REST).
POST /distillпреобразует страницу в чистый Markdown, готовый для LLM;POST /extractвозвращает структурированные данные в соответствии с определённой вами JSON Schema. Рендеринг JS, обработка антиботов и динамический контент обрабатываются на стороне сервера — вам не нужно запускать контейнер браузера. ФлагrenderMode(none/basic/full) контролирует интенсивность рендеринга, а пакетные конечные точки обрабатывают до 100 URL-адресов для дистилляции. - Сервер MCP. Официальный сервер Model Context Protocol, чтобы агент ИИ внутри Claude или Cursor мог выполнять скрапинг в процессе выполнения задачи:
thunderbit_suggest_fieldsдля планирования извлечения (бесплатно),thunderbit_distillдля Markdown,thunderbit_extractдля структурированных данных. Агент решает, когда извлекать данные, не покидая своей среды. - CLI.
npx -y @thunderbit/thunderbit-cliзапускает скрапинг из терминала, скриптов, CI или cron — без браузера, без необходимости присматривать за стеком. Передайте его прямо другим инструментам:thunderbit distill "$URL" -f markdown | claude -p "summarise".
Контраст с Firecrawl с самостоятельным хостингом очевиден. Firecrawl с самостоятельным хостингом даёт вам полный контроль и полное операционное владение: шесть контейнеров, вес настройки, условия AGPL и отсутствие Fire-engine для антиблокировки. API/MCP/CLI Thunderbit обменивает этот контроль на размещённый движок, который возвращает структурированный JSON, соответствующий схеме — не просто необработанный Markdown — с контейнерами, антиботовым слоем и обязательствами копилефта, снятыми с вас. Разные инструменты для разных потребностей в инфраструктуре.
Вот компромисс в одном представлении:
| Соображение | Firecrawl с самостоятельным хостингом | Стек разработчика Thunderbit (API · MCP · CLI) |
|---|---|---|
| Форма развертывания | Сервис, которым вы управляете (6 контейнеров) | Размещённый API, который вы вызываете |
| Для запуска | docker compose поднимает стек из 6 сервисов | Ключ API, затем запрос |
| Рендеринг JS | Встроенный playwright-service (вы его запускаете) | На стороне сервера, флаг renderMode |
| Структурированный вывод | Требуется ключ LLM (/extract, json) | POST /extract с JSON Schema |
| Антиботовый слой | Нет самостоятельного хостинга (Fire-engine только в облаке) | Обрабатывается на стороне сервера |
| Лицензия | AGPL-3.0 (копилефт с использованием сети) | Коммерческий API, без копилефта на ваш код |
| Лучше всего, когда | Вы хотите полный контроль и будете запускать инфраструктуру | Вам нужен Markdown/структурированные данные без операций |
Ни один из них не является универсально «лучшим». Если запуск платформы является для вас целью — полный контроль над данными, отсутствие внешней зависимости и AGPL соответствует вашей ситуации — Firecrawl с самостоятельным хостингом является мощным, активно поддерживаемым выбором. Если вы предпочитаете сделать вызов API и пропустить жизнь с шестью контейнерами, это предложение для стека Thunderbit.
Кому на самом деле стоит самостоятельно размещать Firecrawl
Отбросьте шумиху, и картина достаточно ясна, чтобы отсортировать по потребностям.
Самостоятельно размещайте Firecrawl, если вы хотите полный контроль над своей инфраструктурой скрапинга, вам удобно работать с Redis / RabbitMQ / Postgres / FoundationDB в продакшене, ваши потребности в рендеринге оправдывают контейнер playwright-service, и AGPL-3.0 подходит для того, как вы развёртываете. Основная возможность реальна: я получил чистый, структурированный Markdown, готовый для LLM, как со статической, так и с JS-рендеренной страницы, и весь стек работал на предварительно собранных образах.
Ищите другое решение, если вам нужен быстрый локальный скрипт (это самая тяжёлая настройка в базе, точка), вам нужна антиблокировка облачного уровня без самостоятельного управления ею (самостоятельный хостинг не имеет Fire-engine), или пункт об использовании сети AGPL противоречит вашим коммерческим планам. Для случая «мне просто нужен Markdown или структурированные данные из URL, без операций» размещённый API, такой как /distill и /extract Thunderbit, охватывает ту же область без контейнеров.
Моё предварительное заключение: сильное ядро, тяжёлые операционные обязательства и лицензия, которую вы должны согласовать перед коммерческим использованием. Он занимает своё место для команд, которые хотят владеть всем конвейером — и он многого требует от всех остальных. Я вернусь к этому, как только запущу /v1/crawl, использую /extract с ключом LLM и проверю сборку из исходников на демоне, отличном от colima; это открытые вопросы между этим и окончательным вердиктом.
Попробуйте Thunderbit для извлечения веб-данных Get Started Free
Часто задаваемые вопросы
Является ли Firecrawl с самостоятельным хостингом тем же, что и облачная версия?
Нет. Самостоятельный хостинг предоставляет вам основной движок для скрапинга в Markdown и рендеринг JavaScript через встроенный playwright-service, но он не включает Fire-engine, проприетарный антиблокировочный слой облачного продукта. Функции ИИ, такие как конечная точка /extract и вывод json, также требуют вашего собственного ключа LLM (OpenAI или Ollama). В этом обзоре я тестировал только стек с самостоятельным хостингом; облачный API был вне сферы действия.
Сколько контейнеров на самом деле требуется Firecrawl с самостоятельным хостингом? Шесть: api, playwright-service, redis, rabbitmq, nuq-postgres и foundationdb. Это полноценный сервисный стек, а не один бинарный файл — поэтому это была самая сложная настройка из всех инструментов в этой исследовательской базе. Планируйте операционные накладные расходы на запуск брокера сообщений, кэша и инфраструктуры базы данных, а не просто скрипта.
Может ли Firecrawl обрабатывать страницы с большим количеством JavaScript при самостоятельном хостинге? Да, по моим тестам. Встроенный playwright-service рендерит страницы в реальном движке браузера перед извлечением. Я подтвердил это на quotes.toscrape.com/js/, где цитата Эйнштейна — контент, который существует только после выполнения JavaScript — появилась в возвращённом Markdown. Эта возможность рендеринга — именно то, почему один из шести контейнеров является безголовым браузером.
Влияет ли лицензия AGPL-3.0 на коммерческое использование? Может, и вы должны рассматривать это как первостепенный вопрос. AGPL-3.0 — это сильный копилефт с пунктом об использовании сети, что означает, что предоставление функциональности программного обеспечения пользователям по сети может влечь за собой обязательства по доступности исходного кода — даже если вы никогда не распространяете бинарный файл. Если вы планируете создавать коммерческий продукт на самостоятельно размещённом экземпляре, поговорите с тем, кто занимается лицензированием в вашей компании, прежде чем принимать решение. Этот обзор отмечает лицензию; это не юридическая консультация.
В чём разница между Firecrawl и инструментами разработчика Thunderbit?
Firecrawl с самостоятельным хостингом — это сервис, которым вы управляете — шесть контейнеров, которые вы запускаете сами, с условиями AGPL-3.0 и без встроенного антиблокировочного слоя. Стек разработчика Thunderbit (Open API, сервер MCP, CLI) — это размещённый движок, который вы вызываете: POST /distill для Markdown, POST /extract для структурированных данных JSON-Schema, с рендерингом JS и обработкой антиботов на стороне сервера и без обязательств копилефта на ваш собственный код. Firecrawl подходит командам, которые хотят полный контроль над инфраструктурой; Thunderbit подходит тем, кто хочет получить результат без операционной нагрузки.




