
Docling часто ставят в один ряд с веб-скраперами, но это не он. Это инструмент для конвертации документов от IBM Research — а теперь ещё и проект LF AI & Data Foundation — который берёт уже имеющиеся у вас файлы (PDF, DOCX, PPTX, XLSX, HTML, изображения) и преобразует их в Markdown или JSON. Его слоган буквально звучит так: «Подготовьте ваши документы для gen AI».
Так что перед вами практический обзор конвертера, а не краулера. Всё ниже проверялось на одной машине только с CPU (macOS arm64, Python 3.14.2, Docling 2.111.0), результаты оценивались по скриптам, а сбои фиксировались как сбои. Репозиторий огромный и меняется ежедневно — 63 069 звёзд, 4 449 форков и коммит в тот же день, когда я выгрузил метаданные — поэтому воспринимайте любые цифры по версиям и количеству проблем как снимок на конкретный момент, а не как постоянную величину.
Что такое Docling на самом деле — и чем он не является
Базовая сущность Docling — это DoclingDocument: сначала файл парсится в эту структуру, затем экспортируется в Markdown, HTML, DocTags или без потерь в JSON. Код распространяется по лицензии MIT (отдельные модели могут иметь свои лицензии), проект вырос из IBM Research Zurich, а на момент написания актуальный релиз — v2.112.0, опубликованный за два дня до этого теста.
Главная фишка — обработка PDF и изображений. И это не «разбор строк» — а целый стек ML-моделей: модель разметки RT-DETR, модель структуры таблиц TableFormer, опциональная vision-language model и RapidOCR для сканов. Эти модели восстанавливают структуру страницы, порядок чтения и таблицы. Именно это и стоит проверять в обзоре; HTML-only тест такого не покажет.
Есть одно важное различие, которое экономит неделю путаницы. Docling ничего не загружает из интернета. Он не рендерит JavaScript, не пробивает антибот-защиту и не краулит сайты. Вы приносите файл — он его понимает. За краулинг отвечает другой инструмент, и это станет важно позже, когда люди начнут спрашивать, заменяет ли Docling Firecrawl (нет — они дополняют друг друга, и дальше я объясню почему).
Первый запуск, о котором никто не предупреждает
pip install docling проходит без проблем на Python 3.14.2. А потом вы открываете виртуальное окружение и видите 1,3 ГБ. Docling тянет весь ML-стек как жёсткие зависимости, даже если вы собираетесь конвертировать только HTML:
| Зависимость | Размер на диске (MiB, du) |
|---|---|
| torch (2.13.0) | 536 |
| opencv (cv2) | 119 |
| transformers (5.8.1) | 101 |
| scipy | 99 |
| sympy | 76 |
| pandas | 72 |
| rapidocr (+ bundled models) | 72.1 |
| docling_parse | 30 |
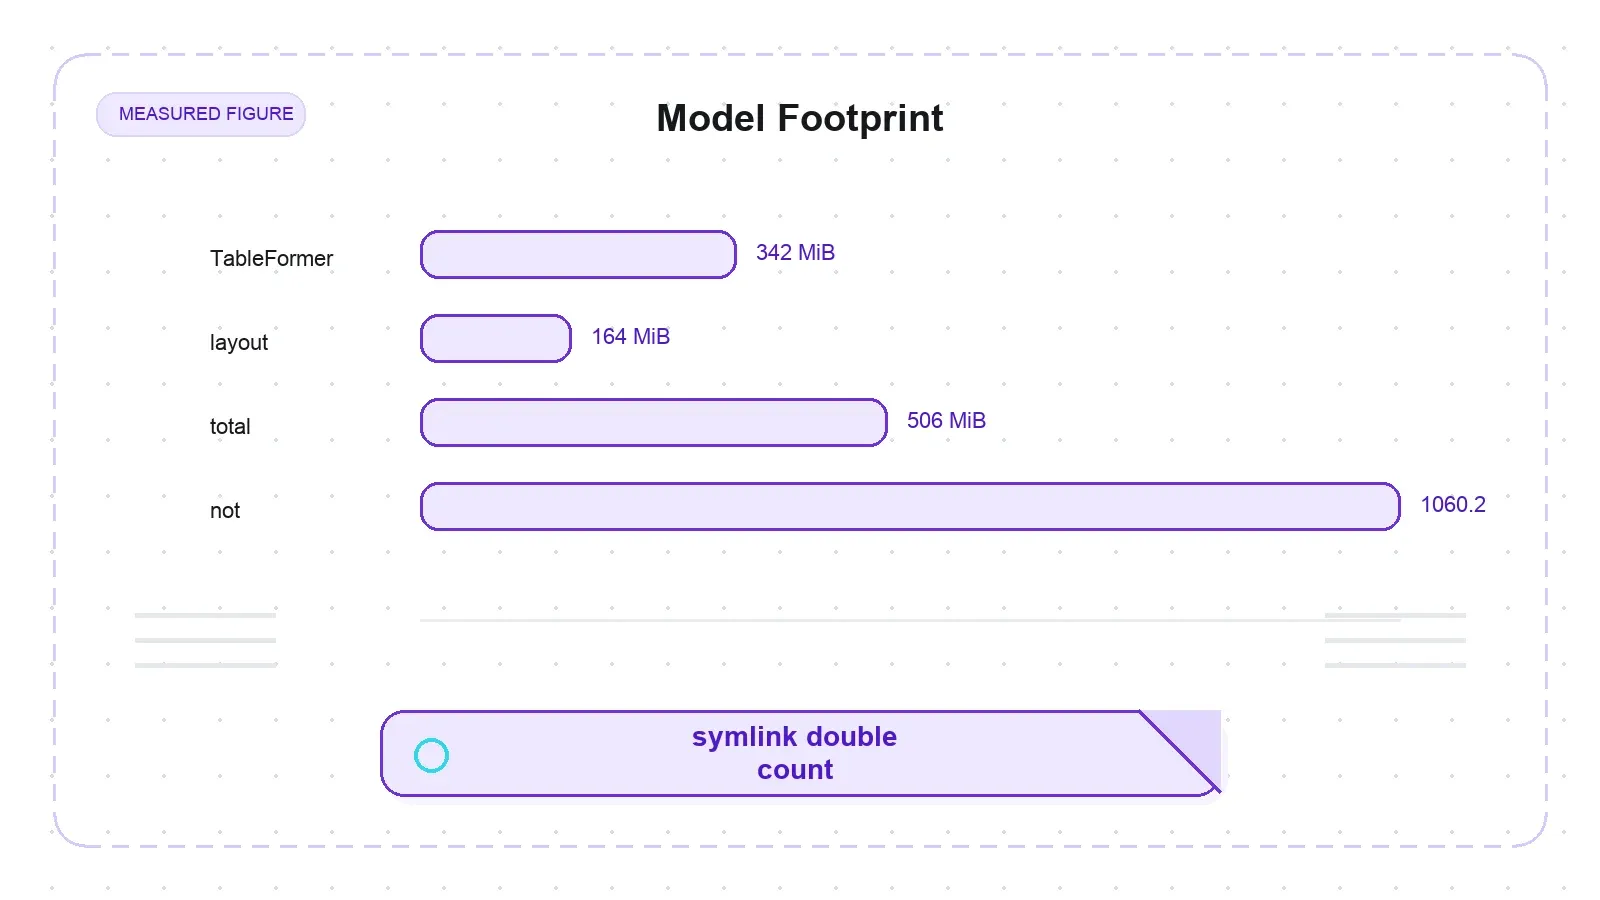
И это ещё до первой конвертации PDF. Настоящая боль начинается именно там, потому что в этот момент скачиваются модели. На свежем, изолированном HuggingFace cache первая конвертация PDF заняла примерно 224 секунды — и почти всё это было временем загрузки, а не вычислений. Модели layout + TableFormer занимают около 506 МиБ на диске (342 МиБ TableFormer + 164 МиБ layout, подтверждено через du), а RapidOCR забирает примерно 40 МБ весов PP-OCRv4 в site-packages. Вторая конвертация того же файла? 0,55 секунды. Модели уже в кэше, и платите вы за это только один раз.
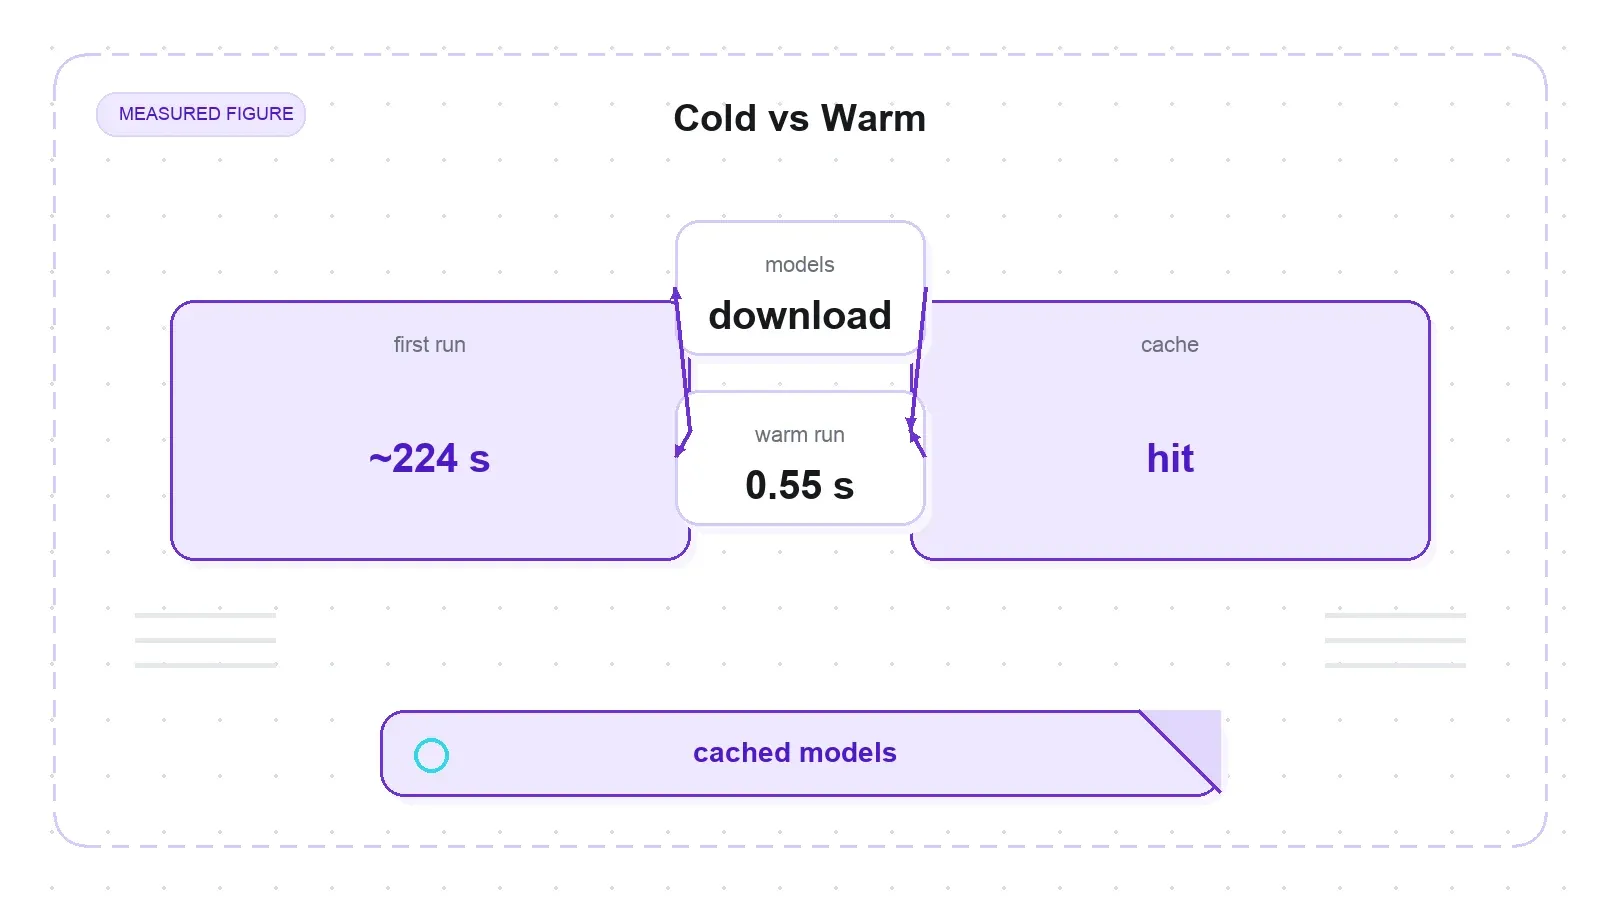
Одно число лучше игнорировать: coldstart-скрипт показывает model_download_mb как 1060.2. Не цитируйте это как реальный размер. Это результат os.walk, который проходит по симлинкам, а HuggingFace cache хранит каждый файл модели один раз в blobs/, а затем повторно открывает его через симлинки в snapshots/ — из-за этого обход дважды считает 14 файлов модели. Корректная, не завышенная цифра, совпадающая с du, — около 506 МиБ (только blobs — 505,4 МиБ). Вывод для тех, кто бенчмарит Docling: отдельно указывайте объём загрузки и фактический размер на диске, потому что это разные вещи.
Есть и второй нюанс, который может испортить жизнь тем, кто собирает контейнер с Docling. Вес моделей разбросан по двум местам и скачивается по двум сценариям. Модели layout и TableFormer соблюдают HF_HOME и скачиваются при первой PDF-конвертации. А вот модели RapidOCR — нет: они ложатся в …/site-packages/rapidocr/models/, полностью игнорируя настройки кэша. Если вы заранее собираете образ или работаете в air-gapped-среде, придётся учитывать оба кэша, и никакой HF_HOME не спасёт от второго.
Теперь справедливый момент. В более ранних релизах Docling проект выпустил docling-slim — облегчённое ядро примерно на 50 МБ, которое позволяет ставить pip install docling-slim[format-html] для HTML без тяжёлого torch. Так что вес в 1,3 ГБ — это реальность для стандартного метапакета docling, но теперь это уже не обязательная плата. Я тестировал именно дефолтный пакет, потому что именно его даёт pip install docling, но тяжеловесность — это не игнорируемый дефект, а решённая модульно задача, которую уже ведут в issue #2393.
Во время настройки я столкнулся с небольшим, но неприятным мелким багом: import docling; docling.__version__ вызывает AttributeError: module 'docling' has no attribute '__version__'. Модуль просто не экспортирует эту информацию. Рабочий способ — importlib.metadata.version("docling"), который возвращает '2.111.0'. Это мелкое раздражение для DX, которое висит в upstream с июля 2026 года в issue #3733.
Точность таблиц: где TableFormer действительно оправдывает себя
Таблицы — главная причина, по которой люди выбирают Docling вместо обычного PDF-to-text дампа, поэтому я сгенерировал семь PDF с таблицами и машинно проверяемой эталонной разметкой и оценивал результат по ячейкам. Здесь важны две метрики, и это не одно и то же: cell recall — это доля эталонных значений, которые вообще попали в обнаруженную таблицу; in-row rate — доля значений, оказавшихся в правильной строке. Смешивать эти метрики — значит приукрашивать инструмент, поэтому привожу обе:
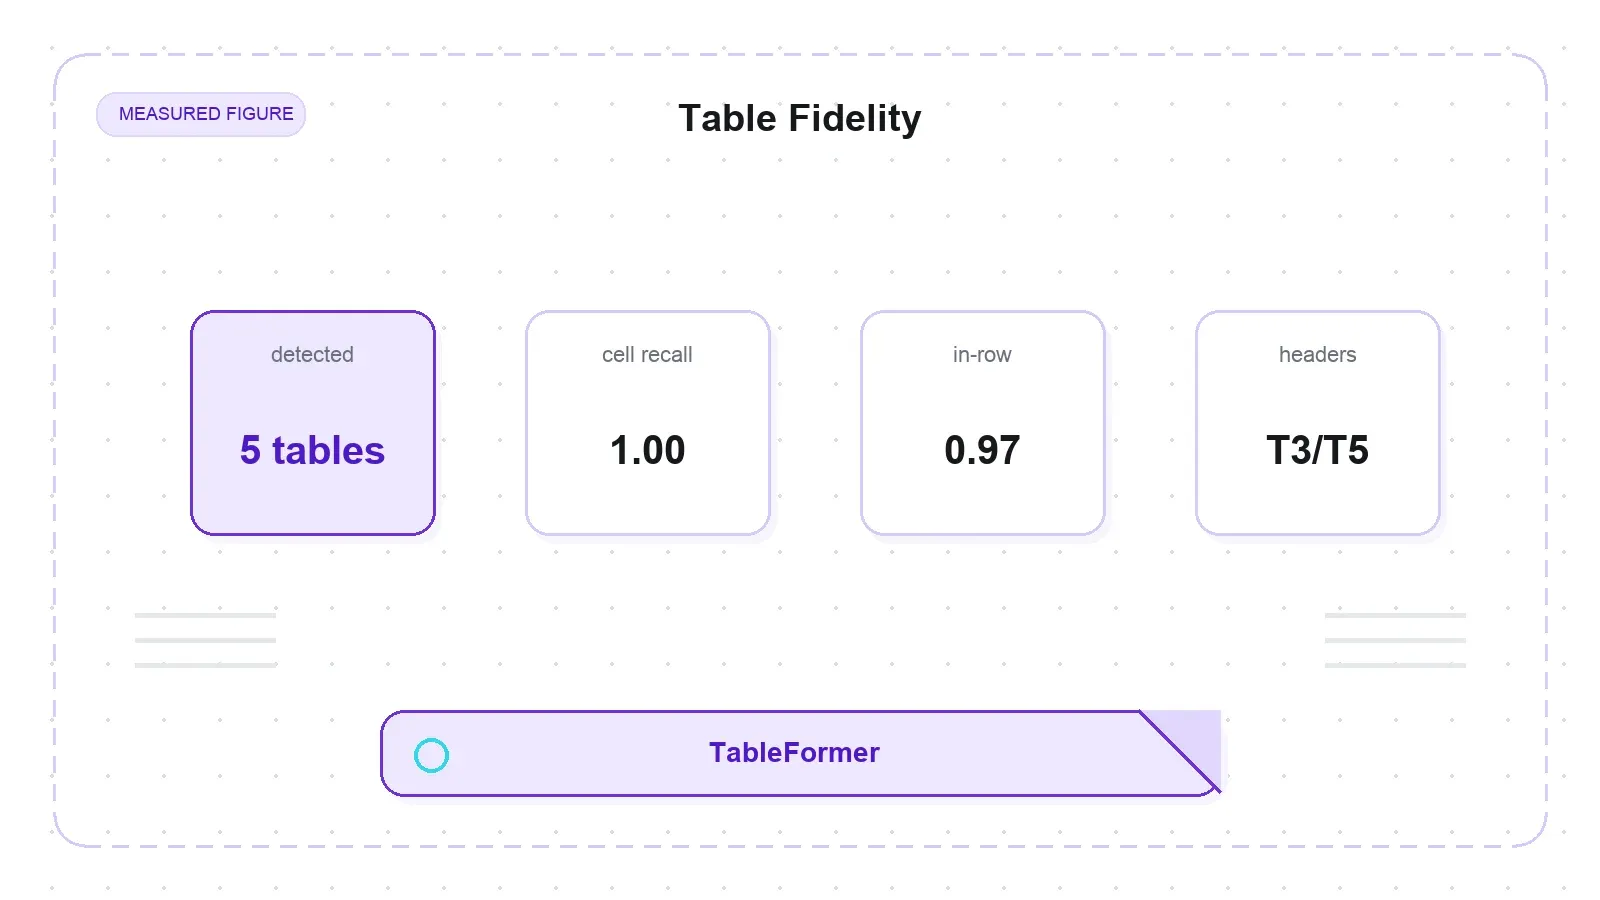
| Таблица (стресс-тест) | Обнаружена | Cell recall | In-row rate | Примечание |
|---|---|---|---|---|
| T1 простая таблица с рамками (8 строк × 5 столбцов), одна на странице | Нет | 0.0 | — | распознана как <!-- image -->, все ячейки потеряны |
| T2 без границ (только линия под заголовком) | Да | 1.00 | 1.00 | идеально, точная сетка |
| T3 с объединённым заголовком colspan на 2 уровня | Да | 1.00 | 0.97 | все значения найдены; одно значение заголовка смещается на строку |
| T4 объединённая строка-заголовок rowspan, одна на странице | Нет | 0.0 | — | распознана как <!-- image --> |
| T5 заголовок colspan + без границ | Да | 1.00 | 0.97 | все значения найдены; тот же сдвиг строки заголовка, что и в T3 |
| T6 финансовая таблица, пустой столбец, выравнивание по правому краю | Да | 1.00 | 1.00 | пустой столбец сохранён, не сдвинут |
| T7 широкая сетка на 12 столбцов | Да | 1.00 | 1.00 | нет смещения столбцов в широкой таблице |
Из пяти таблиц, которые Docling всё-таки обнаружил, каждое эталонное значение было восстановлено — cell recall 1.00 во всех случаях. У трёх из этих пяти все значения ещё и попали в правильную строку. В двух случаях с многоуровневым заголовком (T3 и T5) одно значение заголовка «сползает» со своей строки, из-за чего in-row rate падает до 0.97 — все данные на месте, но привязка к строке слегка плывёт на сложном многоуровневом заголовке.
Сложные структурные случаи оказались стабильнее, чем я ожидал. Двухуровневый заголовок colspan корректно расплющился в GitHub-flavored Markdown (метка «Q1 2026» повторилась над двумя охваченными столбцами, что и должно происходить при сворачивании colspan в GFM). Безрамочная сетка только с верхней линией заголовка (T2) прошла идеально. Широкая таблица на 12 столбцов (T7) не съехала. А полностью пустой финансовый столбец (T6) сохранился как пустые ячейки, а не был удалён или схлопнут. Это согласуется с официальными TEDS-оценками TableFormer — 95.4 simple, 90.1 complex, 93.6 all-tables — и в карточке модели они заметно выше, чем у Camelot (73.0) и EDD (88.3).
Но с объединёнными ячейками нужен осторожный вывод, потому что есть открытая проблема, которая говорит об обратном. Issue #3698 сообщает, что V1 и V2 некорректно обрабатывают объединённые строки и столбцы. В моих тестовых файлах простые colspan (T3/T5) и значения rowspan были расплющены корректно, за исключением уже упомянутого сдвига строки в многоуровневых заголовках. Но проблемные кейсы из #3698 — это нерегулярные объединения по нескольким строкам и столбцам и многостраничные таблицы, то есть уже патологические случаи. У меня были простые случаи. Поэтому корректная формулировка такая: простые colspan и rowspan здесь восстановились (многоуровневые заголовки могут сдвинуть строку); сложные и нерегулярные объединения остаются известной открытой проблемой. Не «объединённые ячейки работают», но и не «объединённые ячейки сломаны».
Ловушка: таблица, стоящая одна на странице, может исчезнуть
Посмотрите снова на таблицу — T1 и T4 вообще не были обнаружены. Docling вывел <!-- image --> и выбросил все ячейки без ошибки. T1 — это совершенно обычная таблица с рамками, 8 строк и 5 столбцов. Это достаточно тревожно, чтобы я не стал списывать всё на слабость парсинга таблиц, пока не понял, что именно запускает сбой, поэтому я сделал скриптовый A/B-тест.
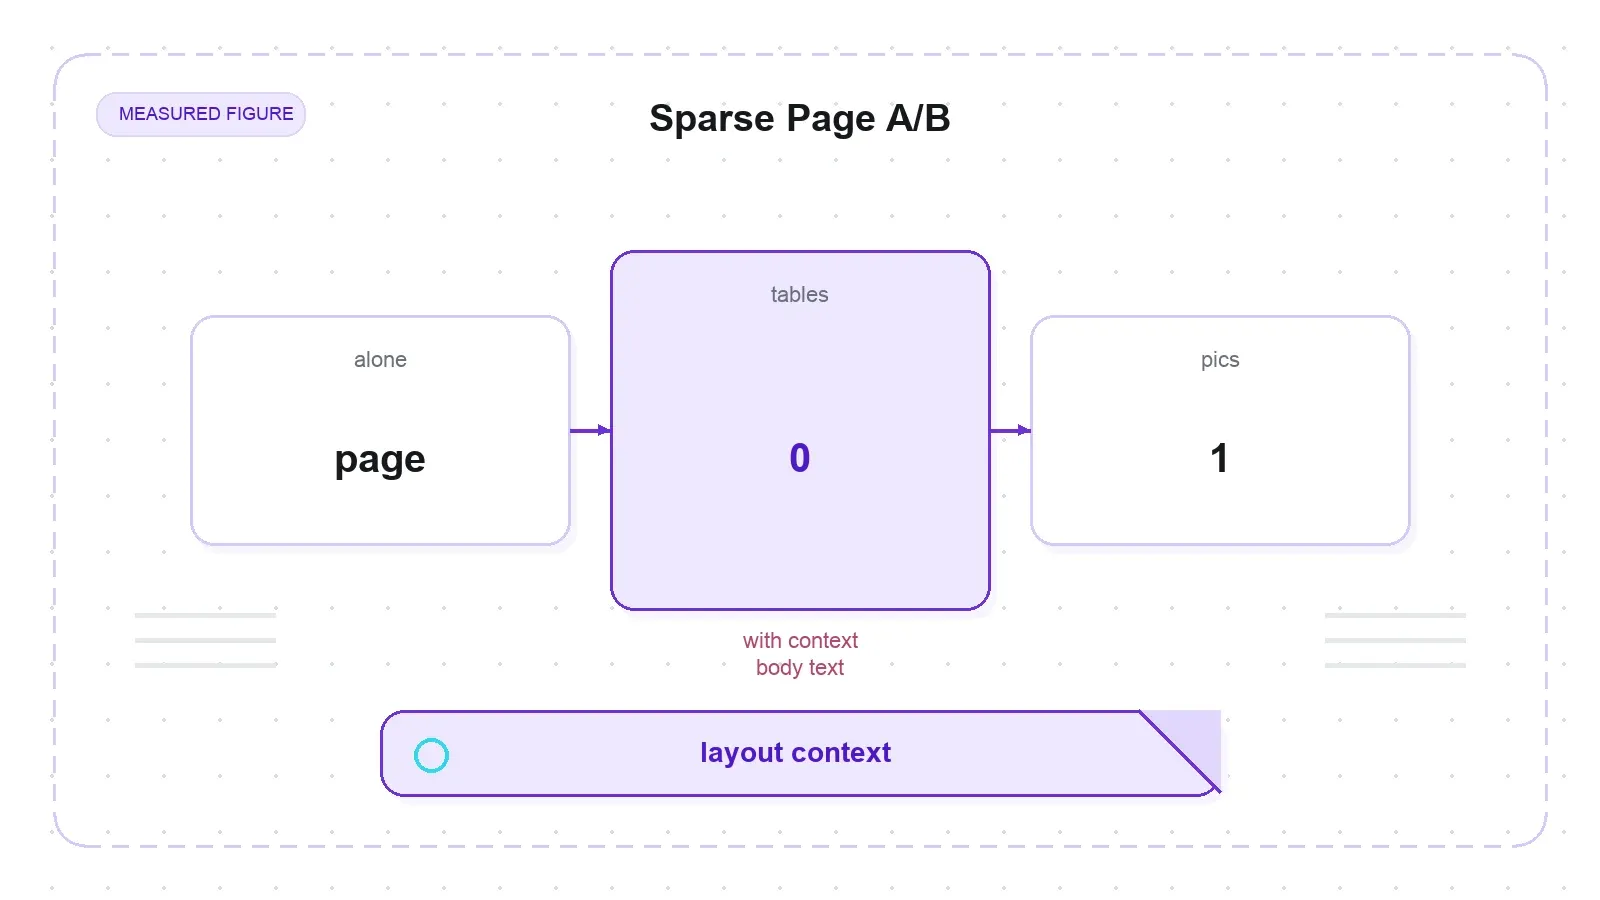
Сначала я исключил очевидные объяснения. Текстовый слой цел — pypdfium2 читает 327 символов из T1 и 221 из T4, то есть это настоящие цифровые PDF, а не сканы. Отключение OCR (do_ocr=False) не помогает; таблицы всё равно исчезают. А при прямом просмотре DoclingDocument видно, что len(doc.tables) == 0, тогда как len(doc.pictures) == 1 — модель разметки классифицировала всю область таблицы как Picture.
Затем решающий тест. Я заново отрендерил те же самые таблицы T1 и T4, но теперь окружил их обычными абзацами текста и снова прогнал конвертацию. Обе таблицы прошли идеально: len(doc.tables) == 1, корректно был выведен GFM-табличный формат, а метка rowspan у T4b — «North» — правильно повторилась на трёх строках. Та же таблица. Изменилось только одно: стояла ли она одна на пустоватой странице или была встроена в текст.
Так что настоящий caveat не в том, что TableFormer слишком хрупок, а в том, что модель разметки RT-DETR в Docling использует контекст страницы, и маленькая таблица на почти пустой странице легко может быть прочитана как Picture и тихо отброшена. В реальной жизни это встречается очень легко, потому что именно так выглядят счета, спецификации и обрезанные выгрузки: одна таблица на страницу, без окружающего текста. Практичный и эффективный способ борьбы скучный — дайте модели контекст страницы или после конвертации проверяйте doc.tables и отмечайте страницы, где количество таблиц равно нулю. Это близко к issue #3495 (таблица, распознанная и как Table, и как Picture), но именно триггер пустой страницы — одна и та же таблица пропадает в изоляции и нормально конвертируется в тексте — я нигде в публикациях не нашёл. Измерено, ранее не документировано; не баг, о котором никто не знал.
OCR на реальных сканах: RapidOCR, а не EasyOCR
Сканированные PDF — это то место, где многие конвертеры тихо ломаются, поэтому я прогнал Docling через два настоящих скана с измеренным текстовым слоем в 0 символов — pypdfium2 подтверждает, что восстановить нечего, а значит любой результат — это OCR, а не скрытый текстовый слой рядом.
Одностраничный ocr_test.pdf вернулся без проблем за 14,3 секунды на CPU: «Docling bundles PDF document conversion to JSON and Markdown in an easy self contained package» был восстановлен дословно. Четырёхстраничный nemotron_multipage.pdf запустил OCR на всех четырёх страницах и уложился в 70,1 секунды суммарно (17,5 с/страница), выводя повторяющуюся тестовую фразу на каждой странице. OCR по умолчанию сработал автоматически — без флага и без дополнительной настройки.
Вот деталь, которую большинство обзоров путает: движок OCR по умолчанию — RapidOCR, а не EasyOCR. Я подтвердил это по загрузке весов PP-OCRv4 .pth при первом запуске. Многие старые статьи и даже прежние тексты FAQ по Docling до сих пор пишут, что по умолчанию используется EasyOCR; это уже устарело. EasyOCR теперь — это дополнительная опция, которую нужно подключать отдельно. Но верным остаётся одно: OCR — это медленный путь при масштабировании, а всё сказанное здесь — это предел для CPU-only; на GPU время заметно уменьшилось бы.
Настоящие PDF, порядок чтения и время на страницу
Синтетические тесты доказывают конкретные поведения; реальные PDF показывают, что штука вообще работает. Я прогнал две «родные» цифровые академические статьи — 9-страничный технический отчёт по Docling и 15-страничную статью «Attention Is All You Need», обе в две колонки, с таблицами и формулами.
В 15-страничной статье Attention все пять меток разделов — Abstract, Introduction, Background, Conclusion, References — идут в порядке документа в линейризованном Markdown, несмотря на двухколоночную верстку. Все ключевые маркеры содержимого (Transformer, encoder, BLEU, multi-head) на месте, а знаменитые многостолбцовые таблицы результатов распознаны как четыре отдельные таблицы. Это настоящее восстановление порядка чтения и слияния колонок — то, что действительно важно для chunking в RAG, потому что нормально нарезать документ невозможно, если линейризатор превращает двухколоночную страницу в мешанину из перемешанных строк.
Тайминг даёт неочевидный вывод. Время на страницу определяется тем, сколько структуры находится на странице, а не тем, сколько страниц в документе. Более плотный 9-страничный отчёт шёл со скоростью 14,95 секунды на страницу — медленнее на страницу, чем 15-страничная статья с 5,99 секунды на страницу — потому что на каждой странице там больше таблиц и фигур — 3 таблицы на 9 страниц против 4 на 15 — и каждая из них запускает дополнительные вычисления layout и TableFormer. При этом это тонкий запас, и в абсолютных числах более плотный документ вовсе не содержит больше таблиц. Так что «секунды на страницу» на CPU зависят от структурной плотности, а не от длины документа. И это один запуск только на CPU; это верхняя граница, а не production-цифра.
Мультиформатность и заявка на lossless JSON
Docling рекламирует единый парсинг для разных форматов, поэтому я сгенерировал DOCX, XLSX и PPTX с известным содержимым и контрольными маркерами, а затем проверил две вещи: попадают ли эти маркеры в Markdown и сохраняются ли они при обратном проходе в JSON через export_to_dict().
| Файл | Время конвертации, с | Контрольные маркеры в MD | Таблицы в MD | Маркеры пережили JSON |
|---|---|---|---|---|
report.docx (заголовки + таблица с объединённым "Total" + списки) | 0.137 | 7/7 | 1 | Да |
workbook.xlsx (2 листа, пустой столбец) | 0.016 | 6/6 | 2 | Да |
deck.pptx (3 слайда, списки + таблица) | 0.038 | 6/6 | 1 | Да |
Все контрольные маркеры попали в Markdown, таблицы восстановились (включая объединённую строку "Total" в DOCX и оба листа XLSX), и каждый маркер пережил export_to_dict() в JSON — это как раз и есть подтверждение заявления о lossless-DoclingDocument, по крайней мере на чистых входных файлах. Эти форматы обрабатываются через нативные backend'и, а не через ML-модели, поэтому работают за десятки миллисекунд и полностью офлайн. Важно честно понимать границы: по одному чистому файлу на формат можно судить о широте поддержки, но не о стресс-тесте проблемных Office-файлов.
HTML: верно, но не чисто
Это тот caveat, от которого зависит, попадёт ли Docling в ваш RAG-пайплайн, так что читайте внимательно. Docling конвертирует весь HTML-документ. Он не делает извлечение основного контента в стиле readability. Я измерил, сколько служебной «обвязки» сайта остаётся в выводе Docling, посчитав строки навигации, оглавления, cookie и футера в собственном выводе инструмента.
| Страница | Непустых строк MD | Строк с шаблонной обвязкой | % обвязки | Статья начинается со строки |
|---|---|---|---|---|
| Wikipedia "Web scraping" | 255 | 34 | 13.3% | 28 |
| scrapethissite/forms | 63 | 1 | 1.6% | — |
| books.toscrape | 65 | 0 | 0.0% | — |
| quotes.toscrape | 35 | 0 | 0.0% | — |
На странице с тяжёлой обвязкой, как Wikipedia, около 13% строк Markdown — это навигация/оглавление/футер, а настоящая статья начинается только с 28-й строки — вывод открывается фразами вроде «move to sidebar / Contents / Toggle the table of contents» и заканчивается «CS1 maint… / Search Wikipedia». На чистых страницах с контентом (books, quotes) это примерно 0%, так что проблема здесь в шаблонной оболочке сайта, а не в штрафе за каждую страницу. Docling даёт честный Markdown всего документа, а не чистое извлечение основного текста. Upstream уже отслеживает проблему HTML-обвязки в issue #1865 (закрыто) и #1930 (открыто).
Два момента, которые делают вывод справедливым. Во-первых, для HTML Docling вообще не использует ML-модели — он работает на BeautifulSoup в простой пайплайновой схеме. История про «vision-модели, читающие вашу страницу», относится только к PDF и изображениям; если подать Docling HTML, никакие layout- или TableFormer-механизмы не запускаются. Во-вторых, PDF-путь всё же пытается классифицировать header и footer, так что утверждать «вообще никакой очистки от мусора нет» было бы слишком сильно — именно HTML-backend, в частности, и возвращает всю эту обвязку.
Как он смотрится на фоне других решений — и где здесь Thunderbit
Попробовать Thunderbit для извлечения веб-данных
Инструмент, с которым Docling чаще всего сравнивают, — это Firecrawl, поэтому ниже таблица позиционирования. Сразу оговорюсь: это сравнение на уровне документации, а не бенчмарк на одной и той же машине. Firecrawl на этих тестовых файлах я не запускал. В столбце Firecrawl приведены данные из публичной документации; измерения здесь относятся только к Docling.
| Параметр | Firecrawl (по документации) | Docling (измерено здесь) |
|---|---|---|
| Основная задача | Краулинг и скрейпинг живого веба → Markdown | Конвертация уже имеющегося документа → Markdown/JSON |
| Fetch / рендер JS / антибот | Да (hosted browser) | Нет — вы сами передаёте файл |
| Извлечение основного контента | Да | Нет — честный полный документ (~13% обвязки на Wikipedia) |
| Структура таблиц в PDF (ML) | ограниченно | Да — TableFormer (официальный TEDS 93.6; cell recall 1.00, in-row 0.97–1.00 на обнаруженных тестах) |
| Сканированный PDF / OCR | ограниченно | Да — RapidOCR по умолчанию (восстановлен скан с нулевым текстовым слоем) |
| Широта форматов | веб-страницы | PDF/DOCX/PPTX/XLSX/HTML/EPUB/изображения |
| Развёртывание | hosted API (+ self-host) | локальная pip-библиотека, офлайн, без API key |
| Вес при установке | API key / лёгкий клиент | дефолтная установка 1.3 ГБ + ~506 МиБ моделей (или docling-slim) |
| Лицензия | коммерческая / source-available | MIT |
Если коротко: Firecrawl — это то, что нужно, когда ваши данные живут в интернете, и вам нужно краулить, рендерить JS и убирать основное содержимое страницы. Docling — это то, что нужно, когда документ уже у вас на руках — особенно PDF, сканы и Office-файлы с таблицами — и вам нужна честная, офлайн-конвертация с сохранением структуры и реальным пониманием таблиц и OCR. Они дополняют друг друга. Реалистичный пайплайн использует один инструмент для краулинга и другой — для конвертации документов.
И тут я прямо скажу о Thunderbit, поскольку я работаю здесь, и вы были бы правы, если бы заподозрили попытку выдать одно за другое. Thunderbit и Docling не делают одну и ту же работу, и я не буду искусственно приравнивать их. Для разработчиков Thunderbit — это AI scraping API плюс MCP server плюс CLI, а единица работы у него — живая веб-страница: POST /distill превращает URL в чистый Markdown, готовый для LLM (обрабатывая JS-рендеринг, антибот и CAPTCHA, к которым Docling явно не прикасается), а POST /extract возвращает структурированный JSON, совпадающий со схемой, которую вы задаёте через JSON Schema. Это часть пайплайна, отвечающая за fetch-and-clean в RAG. Docling — это локальная часть работы с документами: PDF, сканы, таблицы и файлы, которые уже лежат у вас на диске. Если ваш корпус — это веб-страницы, используйте Thunderbit API, MCP-инструменты (thunderbit_suggest_fields, thunderbit_distill, thunderbit_extract) или CLI (npx @thunderbit/thunderbit-cli). Если это PDF и сканы — берите Docling. Если и то и другое, что и бывает в реальных пайплайнах, — используйте их вместе; ни один не пытается заменить другой.
Вердикт: предварительный, с домашкой на потом
Я не буду ставить одну общую оценку от 0 до 100, потому что взвешенный итог здесь смешал бы штрафы за вещи, которые Docling никогда не обещал делать (например, краулинг), и делал бы вид, что это сопоставимые вещи. По отдельным направлениям на тестовых файлах:
- Настройка / первый запуск: тяжёлые — виртуальное окружение 1,3 ГБ, модели ~506 МиБ, первый PDF ~224 с, тёплый запуск ~0,55 с — но
docling-slimпозволяет уйти от этой тяжести. - Точность таблиц: сильная, если таблица вообще обнаружена (cell recall 1.00 на 5/5, in-row 0.97–1.00), что совпадает с официальной картиной TEDS на этих тестах.
- Надёжность обнаружения таблиц: ловушка пустой страницы — изолированная таблица может исчезнуть как Picture. Проверяйте
doc.tablesпосле конвертации. - Скан / OCR: работает, RapidOCR по умолчанию; на масштабах медленно.
- Мультиформатность: хорошая, round-trip в JSON сохраняется.
- HTML: честно, но не чисто — основное содержимое не выделяется.
- Developer experience: аккуратный API в три строки и понятный
DoclingDocument, но без__version__.
Кому это нужно: командам, которые строят RAG или data pipeline поверх PDF, сканов и Office-файлов и хотят офлайн-конвертацию с сохранением структуры и настоящим пониманием таблиц и OCR. Кому это не нужно: всем, кому нужен краулинг живого веба или чистое извлечение главного текста из HTML — это задача другого инструмента.
И поскольку это обзор, а не пресс-релиз, ограничения остаются на виду. Это целевой набор проверок — 7 синтетических таблиц плюс 2 реальные PDF на одной CPU-only машине — а не бенчмарк точности масштаба TEDS. Я не тестировал, и вам тоже стоит проверить перед тем, как ставить на Docling пайплайн: опциональный путь VLM (GraniteDocling), реальный вес docling-slim, любой запуск на GPU, сложные и нерегулярные объединённые ячейки плюс многостраничные таблицы, точность переноса формул в LaTeX и — что, скорее всего, удивит в продакшене сильнее всего — устойчивость к росту памяти в батчах, масштабированию потоков / GIL и жизненному циклу объектов на тысячах конвертаций. Docling силён там, где он это обещает, и это измерено, а не просто красиво описано; но у него есть реальные границы, которые стоит изучить до того, как доверять ему весь корпус. Знайте про ловушку пустой страницы, закладывайте время на первую загрузку и сами проверьте поведение на больших объёмах.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
FAQ
Docling — это веб-скрапер или краулер? Нет. Docling преобразует документы, которые у вас уже есть — PDF, DOCX, PPTX, XLSX, HTML, изображения — в Markdown или JSON. Он не загружает URL, не рендерит JavaScript и не работает с антибот-защитой. Краулинг живого веба — это отдельная задача, которую решают инструменты вроде Firecrawl или веб-API Thunderbit; Docling стартует с файла, который ты ему передаёшь.
Сколько весит установка Docling и первая загрузка моделей?
Стандартный метапакет docling создаёт виртуальное окружение примерно на 1,3 ГБ, потому что тянет весь ML-стек в жёстких зависимостях (только torch занимает 536 МиБ). Первая конвертация PDF скачивает примерно 506 МиБ моделей layout и TableFormer на диск плюс около 40 МБ весов RapidOCR и занимает около 224 секунд — почти всё это время уходит на загрузку. Вторая конвертация — около 0,55 секунды. Если вам нужны только лёгкие форматы, docling-slim (ядро около 50 МБ) отключает тяжёлый путь.
Делает ли Docling OCR, и каким движком? Да. На сканированном PDF без текстового слоя OCR срабатывает автоматически, и в моём тесте текст был восстановлен чисто. Движок по умолчанию — RapidOCR, а не EasyOCR — это частая ошибка в старых обзорах. EasyOCR теперь подключается как дополнительная опция. OCR — медленный путь при масштабировании, особенно на CPU.
Почему Docling превратил мою таблицу в изображение или просто её потерял?
Скорее всего, сработал эффект пустой страницы. Модель разметки RT-DETR в Docling использует контекст страницы, и маленькая таблица, стоящая одна на почти пустой странице, может быть классифицирована как Picture и тихо отброшена. Та же таблица, если вокруг неё есть обычный текст, конвертируется нормально. Решение — дать модели больше контекста страницы или после конвертации проверять doc.tables и отмечать любые страницы, где таблиц нет.
Docling vs Firecrawl — что выбрать? У них разные задачи, так что обычно это не выбор «или-или». Firecrawl краулит живой веб, рендерит JavaScript и извлекает основной контент. Docling конвертирует документы, которые у вас уже есть, и умеет настоящую структуру таблиц в PDF и OCR, полностью офлайн. Если источник — веб-страницы, используйте веб-инструмент (Firecrawl или API/MCP/CLI Thunderbit). Если это PDF, сканы или Office-файлы, берите Docling. В большинстве реальных пайплайнов используют оба.




