
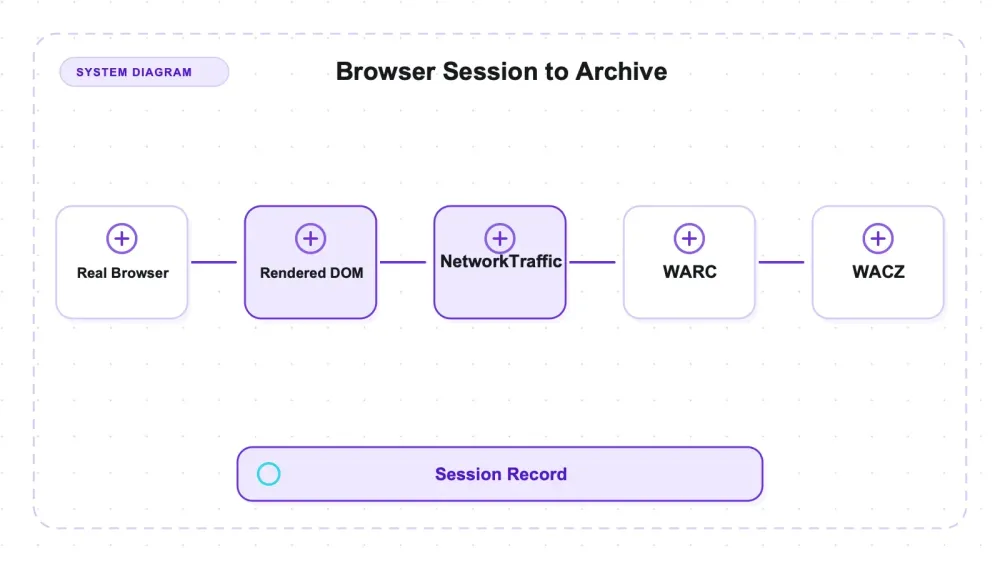
Browsertrix Crawler — это архивирующий краулер от Webrecorder: один Docker-образ, который запускает настоящий Chromium через Puppeteer, записывает всё, что этот браузер загрузил, и сохраняет это в WARC — стандартный формат веб-архива. При желании результат дополнительно упаковывается в WACZ с индексом, списком страниц и логами. Именно назначение и отличает его от инструментов для сбора данных, на которые он лишь внешне похож. Скрейпер приходит за данными и выбрасывает страницу, когда получает нужные поля; архиватор сохраняет сам визит — байты, заголовки, порядок их получения — чтобы страницу можно было открыть снова, даже если сайт уже изменился или исчез. Webrecorder давно поддерживает этот слой веб-инфраструктуры, включая форматы и стек воспроизведения, задолго до того, как архивирование стало похоже на отдельную категорию продукта, и им пользуются библиотеки, редакции и исследователи.
Я запустил v1.14.0 в Docker на локальном тестовом стенде с четырьмя специально разными типами эндпоинтов и измерял обе стороны обхода: записи WARC для содержимого архива и серверный счётчик обращений для фактических запросов. Важное различие было не просто между статикой и динамикой. Browsertrix зафиксировал ссылку, созданную во время выполнения, и fetch(), вызванный самой страницей, но не стал запрашивать два URL-литерала внутри JavaScript-функции, которая так и не была вызвана.
Связанный файл app.js был целиком сохранён в архиве, включая оба литеральных пути, но ни один из этих эндпоинтов не дал ни записи ответа, ни записи запроса, ни серверного хита. Функция, где они находились, никогда не запускалась. Поэтому в этой статье Browsertrix рассматривается как архиватор браузерной сессии, а не как инструмент, который инвентаризирует каждый URL, упомянутый в исходном коде.
Что Browsertrix Crawler собой представляет на самом деле
Многие приходят сюда в ожидании скрейпера и уходят разочарованными. В стандартном пайплайне вы не получите CSV с ценами на товары, и ожидать этого — всё равно что ждать от автомобильного видеорегистратора полноценного отчёта по ДТП. На выходе получается запись сеанса просмотра, пригодная для воспроизведения, и все последующие решения вытекают именно из этого.
Я тестировал v1.14.0 27 июля 2026 года: webrecorder/browsertrix-crawler:latest с digest sha256:9d6800a8…, а crawl --version подтвердил сборку. Проект распространяется под AGPL-3.0. Все измерения выполнялись в Docker через Colima на macOS arm64 против контролируемого локального стенда; серверный счётчик дал независимое от логов Browsertrix и разбора архива подтверждение.
AGPL-3.0 заслуживает отдельного замечания. Это сильный copyleft с условиями для сетевого использования. Если Browsertrix Crawler будет встроен в коммерческий продукт, а не запускаться как отдельный инструмент, обязательно дайте юристу прочитать лицензию до релиза. Это сигнал к проверке, а не юридическая консультация.
Архив фиксирует сеанс, а не исходный код
Мой стенд выдавал четыре типа эндпоинтов, специально разделённых, потому что архиватор работает с ними совершенно по-разному:
- Класс A — обычный
<a href>в HTML. Четыре страницы плюс цепочка глубиной в три уровня. Любой краулер это находит. - Класс B — URL-литералы внутри функции, которая не запускается. Два пути,
/api/js-endpoint-7и/api/js-endpoint-8, как строки внутри невызваннойloadData()в подключённомapp.js. - Класс C — ссылка, собранная во время выполнения.
<a href>, склеенный из фрагментов в JavaScript ('endpoint' + (6 * 7)) и добавленный в DOM. Непрерывный путь/runtime-only/endpoint42не присутствует ни в одном из отданных байтов как готовая строка. - Класс D —
fetch(), который страница действительно выполняет. Путь собирается так же ('runtime-xhr-' + (33 * 3)), после чего реально запрашивается при загрузке.
Для классов C и D полные пути отсутствовали как непрерывные строки в отданных файлах. Их серверные хиты и записи ответов подтверждают, что в этом стенде были реально выполнены и runtime-сборка, и сетевые запросы.
Что было захвачено, а что нет
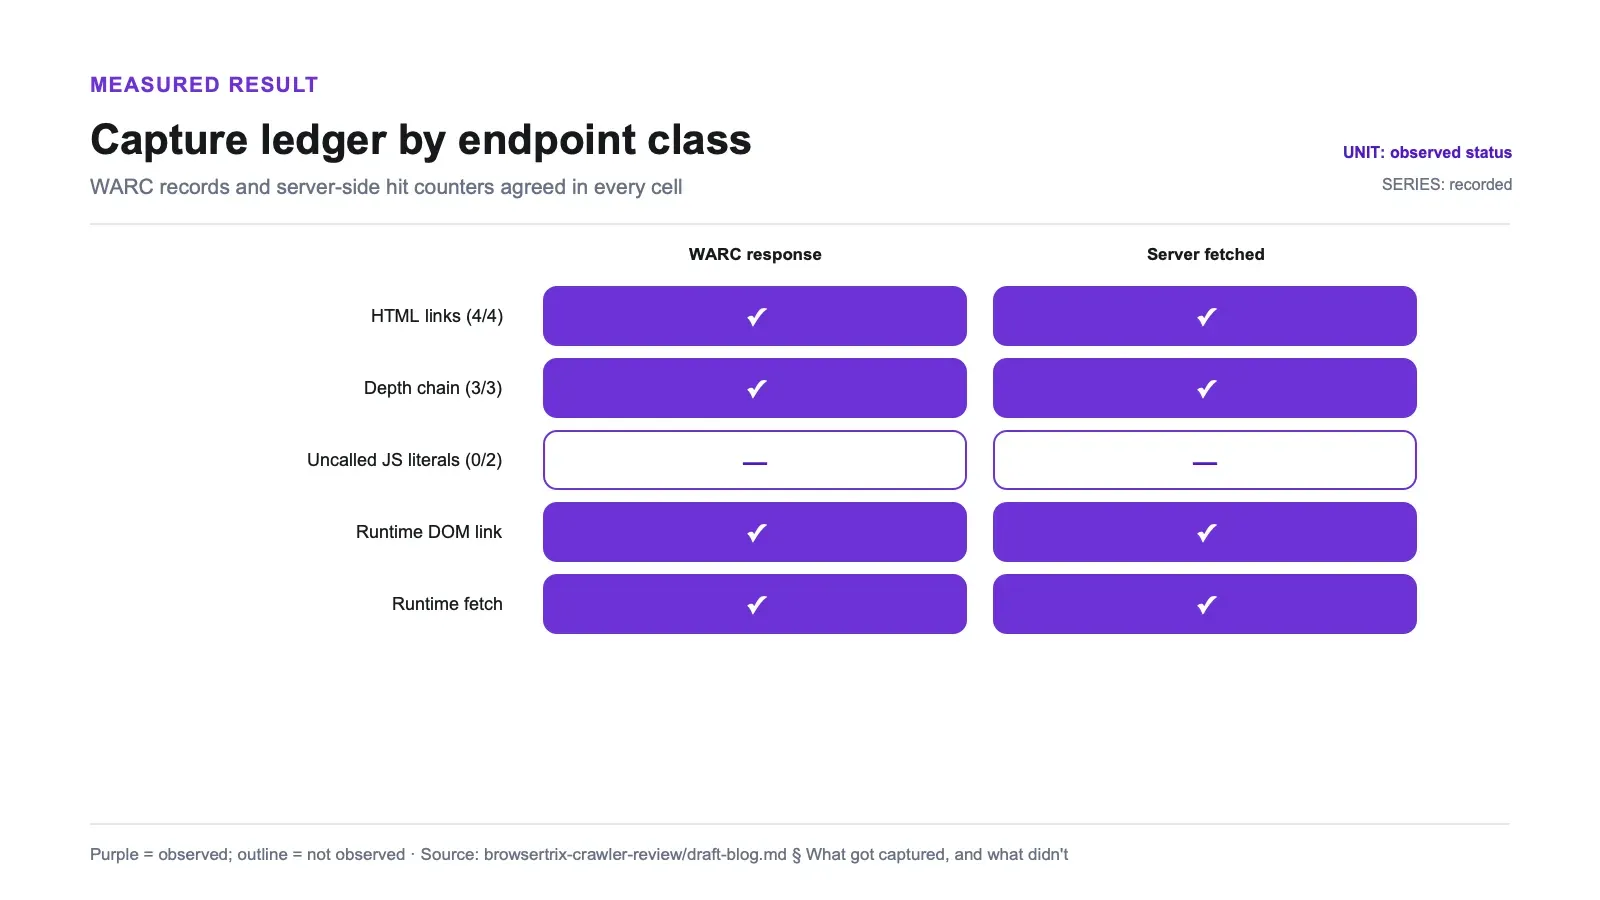
Два инструмента, сверенные друг с другом в каждой ячейке: записи ответов WARC (что попало в архив) и серверный счётчик обращений по (Host header, path) (что реально запрашивалось). Везде они совпали.
| Класс эндпоинта | Запись ответа в WARC | Фактически запрошено (на стороне сервера) | Итог |
|---|---|---|---|
A — HTML <a href> | 4/4 | 4/4 | захвачено |
| A — цепочка глубины (3 уровня) | 3/3 | 3/3 | захвачено |
| B — URL-литерал в невызванном JS | 0/2 | 0/2 | не захвачено |
| C — ссылка, вставленная во время выполнения | yes | yes | захвачено |
D — runtime fetch() | yes | yes | захвачено |
Класс C — это то, что отделяет настоящий браузер от статического обхода. Стандартное извлечение ссылок читает отрендеренный DOM (a[href]->href, согласно документации по common options), поэтому ссылка, которая появляется только после выполнения JavaScript, всё равно попадает в очередь, загружается и архивируется. Класс D попадает по другой причине — сама страница отправила запрос, а архиватор стоит на сетевом пути и записывает всё, что проходит мимо.
Есть важное ограничение по классу C: моя ссылка была вставлена синхронно при загрузке страницы. Ссылки, которые появляются позже — во время behaviors Browsertrix, — это отдельный случай, и для него уже есть открытая проблема: #723, "Links on pages that are discovered during behaviors are not extracted". Я этот сценарий не тестировал, поэтому ничего не утверждаю ни в одну, ни в другую сторону.
Файл был архивирован. Эндпоинты — нет.
Подтвердить пропуск по классу B можно было только через покадровую проверку WARC, а не по сводному счётчику.
app.js есть в архиве — одна запись ответа, JavaScript-тело объёмом 222 байта — и оба литерала класса B присутствуют в нём буквально. При этом ни /api/js-endpoint-7, ни /api/js-endpoint-8 не являются целевым URI ни одной записи во всём файле: ноль записей ответа, ноль записей запроса. Каждая из этих строк встречается в архиве ровно один раз, и оба раза — внутри сохранённого тела app.js.
Это исключает скучное объяснение вроде «app.js вообще не был загружен». Архиватор сохранил файл, который ссылается на эти эндпоинты, но не стал запрашивать их, потому что loadData() так и не была вызвана. Встроенные behaviors Browsertrix были активны — autoplay, autofetch, autoscroll, siteSpecific — но autofetch тоже их не спас, и это логично, если посмотреть, что именно делает autofetch: он забирает img srcset, таблицы стилей и data-* URLs, а не строковые литералы, спрятанные в телах функций.
Для наглядного сравнения на том же стенде я также запускал Katana v1.6.1 как katana -u <seed> -jc -silent -nc -d 4. Его сырой discovery summary показывает противоположный результат по двум специально созданным JavaScript-классам:
| Что нужно найти | Browsertrix v1.14.0 | Katana v1.6.1, стандартный -jc |
|---|---|---|
| Ссылки в отданном HTML | найдено | найдено |
| Ссылка, вставленная в DOM во время выполнения | найдено (извлечение из rendered DOM) | пропущено без headless-режима |
fetch(), который страница реально вызывает | найдено (записано как трафик) | пропущено — ничего не исполняется |
| URL-литерал в JS, который никогда не выполняется | пропущено (0/2) | найдено (2/2 на том же стенде) |
| JS-файл, содержащий этот литерал | сохранён целиком | разобран, но не сохранён |
Обе команды использовали один и тот же стенд и одни и те же имена эндпоинтов. Эта таблица — не общий рейтинг браузерных и статических краулеров; она показывает, почему для инвентаризации эндпоинтов и для сохранения сессии нужны разные тесты покрытия.
Фраза «настоящий браузер, значит, он ловит всё, что делает JavaScript» часто повторяется в обзорах. Это преувеличение. Он фиксирует только тот трафик, который был реально выполнен. Код, который ссылается на URL, но никогда его не вызывает, не создаёт трафик, а без трафика нет и записи.
Тела для воспроизведения есть, но одну вещь я не проверял
Для двух эндпоинтов, созданных во время выполнения, я извлёк из WARC архивированные HTTP-ответы и подтвердил, что там лежит отданный JSON: 206 байт для цели ссылки, созданной runtime, и 201 байт для цели fetch() из страницы. То есть это не пустые заглушки в индексе — сам контент есть в архиве, а значит, он может быть воспроизведён.
Чего я не делал — так это не поднимал pywb или replayweb.page, чтобы визуально воспроизвести архив. Наличие тела в архиве и корректный отрендеренный replay — это разные утверждения, и этот тест проверяет только первое. Поведение replay, контроль подлинности, цепочка хранения и допустимость в качестве доказательства требуют отдельной проверки.
Для production-сбора нужен более широкий acceptance test
Этот стенд чётко отвечает только на узкий вопрос: стала ли синхронно созданная runtime-ссылка и запрос, отправленный страницей, сетевым трафиком и архивной записью? В реальном проекте сохранения данных есть ещё несколько способов провалиться, даже если на выходе получится валидный WACZ.
Начните с replay. Откройте пакет в той системе воспроизведения, которую реально будет использовать коллекция, и сравните фиксированный набор страниц с эталоном, снятым в момент захвата. Проверьте отрисованный текст, изображения, стили, навигацию и все взаимодействия, которые важны для записи. Затем посмотрите в сетевую панель replay-браузера: нет ли пропавших подресурсов. Ответ в WARC может существовать, а воспроизведение всё равно сломается из-за несовпадения переписывания URL, индексов, таймингов, origin'ов или зависимостей. Этот обзор не пересекал эту границу.
Динамическое поведение заслуживает отдельного набора тестов. Ссылка класса C здесь появилась синхронно при загрузке страницы. В реальных приложениях контент может проявляться после таймеров, прокрутки, закрытия баннера согласия, смены маршрута, работы кастомных элементов или длинных цепочек API-вызовов. Поместите известную цель за каждым поведением, на которое вы рассчитываете, и проверьте и серверный хит, и сохранённое тело. Встроенные behaviors Browsertrix полезны как входные условия для такого теста, но не как доказательство того, что достигнуто каждое отложенное состояние. Проблема #723 особенно важна, если ссылки появляются именно во время behaviors, а не в ходе первичного исполнения страницы.
Для авторизованных захватов появляются вопросы по сессии. Убедитесь, что состояние входа попадает в профиль браузера, сохраняется через нужные переходы и не перетекает в коллекции, которые должны быть изолированы. Проверьте обновление токенов и выход из системы. Если в архиве есть приватные или персональные данные, доступ к результатам и срок хранения нужно тестировать как часть того же плана приемки. Технически корректный захват всё равно может быть обработан неправильно уже после сбора.
Service workers, потоковое видео, WebSockets, загрузки файлов, cross-origin frames и подписанные URL требуют отдельных тестовых страниц, если они важны для целевого сайта. Одиннадцатистраничный стенд ничего не говорит о них. Он также не показывает, что будет, если страница остаётся активной несколько минут, отправляет запросы после обычного окна ожидания или требует действий пользователя. Не превращайте «реальный Chromium» в безусловное обещание покрытия; определите, какие именно браузерные сценарии коллекция должна сохранять, и сделайте каждый из них наблюдаемым.
И, наконец, сохраняйте доказательства, нужные для разбирательства по пропускам. Фиксируйте точный digest образа и команду запуска, логи Browsertrix, списки страниц, индексы, контрольные суммы WARC/WACZ, серверные доказательства запросов там, где они доступны, и небольшой манифест с истиной по стенду. Для повторных захватов записывайте время, конфигурацию и окружение вместе с артефактом. Эти данные не делают результат юридически допустимым доказательством, но позволяют воспроизвести техническое утверждение и понять, возникло ли различие позже из-за цели, краулера или replay-стека.
Во что обошёлся этот стенд с крошечными телами страниц в байтах
На этом стенде каждая страница отдаёт лишь несколько сотен байт, поэтому его коэффициенты накладных расходов не стоит переносить на сайты с тяжёлыми ассетами. В этом узком режиме я измерял не только финальный размер, но и состав архива:
| Тип записи WARC | Кол-во | Байты содержимого | Доля |
|---|---|---|---|
request | 14 | 6,912 | 40.6% |
response (реальная полезная нагрузка страницы) | 13 | 5,339 | 31.4% |
resource (JSON urn:pageinfo:, по одному на страницу) | 11 | 4,527 | 26.6% |
revisit (дедуплицированная мёртвая ссылка) | 1 | 154 | 0.9% |
warcinfo | 1 | 92 | 0.5% |
| Итого содержимого записей | 40 | 17,024 | 100% |
Подсчёт по типам и суммарные байты есть в публичном capture-summary.json; доли рассчитаны от общего объёма содержимого записей 17,024 байта.
В этом маленьком прогоне запросы занимали больше места, чем содержимое ответов, а байты запросов плюс urn:pageinfo: были примерно в 2.1 раза больше payload ответа. Это характеристика именно этого набора записей, а не универсальное соотношение WARC.
На диске, за три изолированных прогона:
| Метрика | min | median | max |
|---|---|---|---|
| Общее время обхода (с) | 28.22 | 29.75 | 30.27 |
| WARC.gz, байт | 24,174 | 24,250 | 24,262 |
| WACZ, байт | 53,446 | 53,523 | 53,533 |
| Захваченная полезная нагрузка ответа (байт) | 5,339 | 5,339 | 5,339 |
Если взять медианы, получаются четыре отношения:
| Производная метрика (по медианам) | Значение |
|---|---|
| Сжатый WARC к полезной нагрузке ответа | 4.5× |
| WACZ к полезной нагрузке ответа | 10× |
| WARC на страницу | ~2.2 KB |
| WACZ на страницу | ~4.9 KB |
А внутри самого WACZ:
| Компонент WACZ | Доля от пакета |
|---|---|
| WARC | 45% |
| CDX index | 16% |
| Лог обхода | 30% |
Последняя строка меня и удивила. Почти треть архивного пакета на маленьком крауле — это не сам веб, а запись о том, как он был собран.
Измерение было стабильным: полезная нагрузка ответа совпадала байт-в-байт во всех трёх прогонах (каждый раз 5,339 B), а WARC.gz и WACZ отличались менее чем на 0.4%.
Эти коэффициенты нельзя переносить на реальные страницы с картинками, шрифтами и большими JS-бандлами. Но структурный вывод сохраняется: записи запросов и page-info создают накладные расходы, не зависящие от размера payload. Перед планированием production-хранилища измерьте репрезентативную выборку; не умножайте fixture-коэффициент 10× на весь корпус.
Настройка и какой диск нужно закладывать
Когда Docker или Colima уже установлены и запущены, специфичная для Browsertrix настройка сводится к docker pull webrecorder/browsertrix-crawler:latest, а затем к docker run … crawl --url … --generateWACZ. В образ уже включён Chromium, так что отдельный браузер или Python-окружение не нужны.
Чем именно оборачивается это удобство в измеренных прогонах:
| На что закладывать бюджет | Измерено |
|---|---|
| Скачивание образа | ~1 GB |
| Распакованный образ на диске | 3.51 GB |
Дерево crawls/ (WARCs, WACZ, данные профиля браузера) после нескольких 11-страничных прогонов на стенде, который отдаёт несколько килобайт контента | ~116 MB |
| Время, краул 11-страничного стенда | 28–30 s |
Контейнер и создаёт основную часть трения, а строка про скачивание и распаковку — это и есть цена упакованного браузера. Я запускал с --shm-size 1g, а поскольку мой стенд жил на хосте, пока краул шёл в контейнере, мне понадобились --add-host=host.docker.internal=host-gateway и стенд, привязанный к 0.0.0.0, а не к loopback. Если вы краулите публичный интернет, этот сетевой шаг вам не нужен, но если архивируете что-то на своей машине или на внутреннем staging-хосте, закладывайте на это полдня.
Самая недооценённая строка — это каталог с результатами. Если экстраполировать этот рост на реальный краул, сначала спланируйте хранилище, а уже потом запускайте сбор, а не в тот момент, когда диск закончится в три часа ночи.
Старт браузера, вероятно, заметно влияет на 28–30 секунд для всего лишь одиннадцати страниц, но я не отделял время запуска от навигации и упаковки. Из этого прогона нельзя делать вывод о производительности на страницу.
Как планировать хранилище, не злоупотребляя коэффициентами этого стенда
Правильный способ оценить объём коллекции — эмпирический. Возьмите страницы, которые отражают реальное распределение на целевом сайте: тонкие оболочки приложений, тяжёлые лендинги с картинками, скачиваемые документы, длинные статьи и авторизованные представления, если они входят в охват. Снимите каждый класс с теми behaviors и настройками упаковки, которые вы собираетесь использовать. Измерьте полезную нагрузку ответа, WARC, WACZ, индексы, логи, остатки профиля браузера и всё временное пространство, которое остаётся после прогона. Пиковое использование диска важно не меньше, чем итоговый пакет, если упаковка на время хранит несколько копий одновременно.
Разделяйте фиксированные и переменные компоненты. Контейнерный образ на 3.51 GB — это накладные расходы развёртывания, которые можно разделить между множеством захватов на одном worker'е. Записи запросов, page-info, индексы и списки страниц растут вместе с активностью краула. Тела ответов сильно зависят от цели, а логи — от длительности и подробности запуска. Хранение и репликация затем умножают итоговый объём коллекции независимо от поведения краулера. Модель вместимости, которая сводит всё к «байтам на страницу», будет хрупкой.
Сжатие и дедупликацию тоже нужно проверять на репрезентативном контенте. Полезная нагрузка ответа на этом стенде была байт-в-байт одинаковой в трёх прогонах, но это не описывает страницы с меняющейся рекламой, временными метками, персонализированными ответами или URL ассетов с cache busting. Если повторные захваты входят в программу, измеряйте последовательные прогоны одних и тех же страниц и смотрите на revisit-записи, а не предполагайте, что страницы, которые выглядят неизменными, хорошо дедуплицируются. И отдельно проверьте, сохраняются ли логи и индексы на том же уровне репликации, что и сам preservation payload.
В операционном плане задайте пороги предупреждений до начала сбора. Мониторьте свободное место, рост по каждой коллекции, сбои упаковки и размер профилей браузера или временных директорий. Проводите упражнение по восстановлению именно из сохранённого WACZ, а не только проход по контрольной сумме. Приведённые выше коэффициенты полезны тем, что показывают, какие именно компоненты вообще существуют; а репрезентативная выборка говорит, насколько большими они будут на вашем сайте.
Зафиксируйте эти допущения рядом с оценкой вместимости и пересмотрите их после пилотного краула.
Дисциплина области охвата, проверенная двумя контролями
Архивирующие краулеры, которые выходят за пределы, — реальный операционный риск: можно одновременно получить и юридическую проблему, и счёт за хранение. Моя домашняя страница ссылалась на http://outofscope.test:<port>/page/out, то есть на другой hostname, указывающий на тот же стенд. Значит, запрос с таким Host header доказал бы выход за пределы без какого-либо обращения к реальному интернету.
| Конфигурация | Внеобластной host запрошен? | Серверные хиты |
|---|---|---|
--scopeType prefix (по умолчанию) | нет | 0 |
--scopeType any | да | 2 |
Вторая строка и делает первую значимой. При any ссылка была достигнута дважды, значит, до неё можно было добраться — ноль при стандартной prefix-области означает реальную дисциплину области, а не то, что краулер просто не заметил ссылку. В upstream есть открытый отчёт о выходе за область в других конфигурациях, #788, но на этом стенде я не воспроизвёл его при стандартном prefix scope. Полезно знать, что проблема существует; не полезно утверждать, что я её видел.
Надёжность приятно ничем не выделялась. Маршрут, возвращавший HTTP 500, и мёртвая ссылка оба были запрошены, краул завершился корректно с валидными WARC и WACZ, а мёртвая ссылка сохранилась как дедуплицированная запись revisit, а не сломала всё вокруг.
Плюсы и минусы
Плюсы
- Захватывает ссылки, вставленные в DOM во время выполнения, и
fetch()-запросы, инициированные страницей — и то и другое подтверждено и в архиве, и на стороне сервера, на путях, которых нигде нет как литералов. - Статический HTML и обход по глубине работают полностью: 4/4 ссылок, 3/3 по цепочке глубины, пропусков нет.
- Когда Docker/Colima уже запущены, одна команда
docker runсоздаёт WARC и WACZ; Chromium идёт внутри образа. - Стандартный
prefixscope выдержал тест без единого внеобластного запроса;anyрасширил его ровно так, как обещано, так что переключатель работает как заявлено. - Выход — это архив в стандарте WARC, упакованный как WACZ с CDX-индексом и списком страниц, а не проприетарный blob.
- Почти детерминированные архивы: полезная нагрузка совпадает байт-в-байт в трёх прогонах, а размер на диске меняется менее чем на 0.4%.
- Корректное поведение при ошибках: маршрут с 500 и сломанная ссылка не прервали краул.
Минусы
- URL-литералы в неисполняемом JavaScript просто не обнаруживаются (0/2), даже если сам файл с ними был архивирован. Это корректно по замыслу, но остаётся реальным пробелом покрытия, если ваша цель — инвентаризация эндпоинтов.
- Тяжёлый footprint: около 1 GB на загрузку, 3.51 GB на диске и быстро растущие каталоги с результатами.
- Байтовые накладные расходы существенны на маленьких страницах — запросы плюс pageinfo превысили сам payload, и примерно 30% WACZ составил лог обхода.
- AGPL-3.0 означает реальную работу по соблюдению лицензии, если встраивать это в коммерческий продукт.
- Это не инструмент для структурированных данных. Здесь нет схемы, маппинга полей и аккуратных строк на выходе.
- Пропускная способность на страницу умеренная по задумке, потому что каждая страница проходит через настоящий браузер.
Кому он подойдёт, а кому — нет
Browsertrix рассчитан на команды, которым нужен архив ресурсов, загруженных браузером, а не извлечённые строки таблицы. В этом стенде тела ответов, полученные во время выполнения, присутствовали в WARC и были упакованы в WACZ. Библиотеки, редакции и исследователи — вполне вероятные пользователи, но для production-внедрения отдельно нужно проверить replay, авторизацию, service workers, сценарии согласия, отложенные behaviors, потоковые ассеты, контроль хранения и любые требования к обращению с доказательствами.
Он вам не нужен, если на самом деле требуются данные. Если задача звучит как «собери мне все товары и цены со 400 страниц в таблицу», архиватор — странный путь к результату: вы сначала сохраните гигабайты, а потом всё равно будете писать код извлечения поверх WARC. Не стоит брать его и тогда, когда вы картируете API приложения, потому что результат по классу B прямо говорит: статический парсер JS найдёт эндпоинты, до которых Browsertrix никогда не дотрагивается. И если вы не любите Docker или работаете там, где образ на 3.5 GB — это проблема, этот инструмент не из тех, что подстроятся под вас.
Авторизация и хранение
Контроль области не равен авторизации. До начала краула определите разрешённые hosts, срок хранения и доступ к архиву, особенно если долговременные захваты могут содержать персональные данные. Тест prefix/any показывает, что настройка меняет сетевую достижимость; но он не доказывает, что такая достижимость законна для конкретной коллекции.
Связанный обзор: правовые аспекты веб-скрейпинга и архивирования.
Альтернативы в зависимости от требуемого результата
Выбирайте по артефакту. Browsertrix ориентирован на сохранение в WARC/WACZ. Библиотека браузерной автоматизации вроде Playwright даёт программируемую страницу, но упаковку захвата вы организуете сами. Краулеры для поиска эндпоинтов перечисляют URL, а инструменты извлечения возвращают текст или структурированные записи. Эти категории могут использовать один и тот же браузер, но решают разные задачи.
Связанный обзор: обзор Heritrix.
Раскрытие: Thunderbit — продукт издателя и в этом тесте Browsertrix не проверялся. Он относится к категории управляемого извлечения и выдаёт текст страницы или структурированные данные, а не стандартный архив. Этот обзор подтверждает только границу формата выхода, а не сравнительные заявления о производительности или возможностях.
Попробовать Thunderbit для извлечения веб-данных
Вердикт
Используйте Browsertrix Crawler, когда вам нужен именно захват в формате WARC/WACZ, а контейнерный Chromium подходит для вашей среды развёртывания. На этом стенде архивные записи и серверные хиты совпали для синхронно созданных DOM-элементов и fetch, инициированного страницей; default prefix scope отсёк второй host, а ошибки на маршрутах не помешали получить валидный архив.
Перед использованием в production проверьте replay, отложенное поведение, авторизованные сессии, service workers, состав хранилища на репрезентативных страницах и обязательства по лицензии. Проверенная граница уже: ссылки на код, который никогда не исполняется, не породили ни запроса, ни архивной записи для своих целей, хотя сам скрипт был сохранён.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
FAQ
В чём разница между WARC и WACZ здесь? WARC содержит захваченные запросы, ответы и связанные записи. WACZ упаковывает WARC вместе с индексами, списками страниц, метаданными и логами для распространения и инструментов воспроизведения. В этом обзоре проверялись оба пакета, но replay не визуализировался.
Как оценивать объём хранилища? Измеряйте репрезентативные страницы и сохраняйте в выборке полную структуру WACZ, включая логи и индексы. Коэффициенты в этой статье получены на очень маленьких телах ответов и не подходят для простого умножения на количество URL в production.
Не уйдёт ли он с сайта, который я указал?
В моём тесте — нет, если использовать настройку по умолчанию. При --scopeType prefix ссылка на другой hostname была запрошена ноль раз; переход на --scopeType any привёл к двум запросам, что доказывает достижимость ссылки и показывает, что ноль при default — это реальная дисциплина области. В upstream есть открытый отчёт о выходе за область в других конфигурациях, который я на этом стенде не воспроизвёл при default, так что лучше проверяйте свои настройки scope, а не полагайтесь на предположения.
Что нужно проверить перед заявлением о качестве replay? Загрузите WACZ в ту систему воспроизведения, которую будете использовать, и сравните отрисованные страницы, взаимодействия и необходимые подресурсы с живым сайтом или эталонным захватом. Наличие тела в WARC необходимо, но само по себе не подтверждает корректность rendered replay.
Превращает ли Browsertrix архивную страницу в структурированные строки? Нет. Его результат — архивный пакет, а не таблица с выбранными полями. Если нужен итог в виде товаров, цен, контактов или другой схемы, после захвата всё равно нужен этап извлечения — либо другой инструмент, чья основная задача состоит именно в структурированных данных.




