
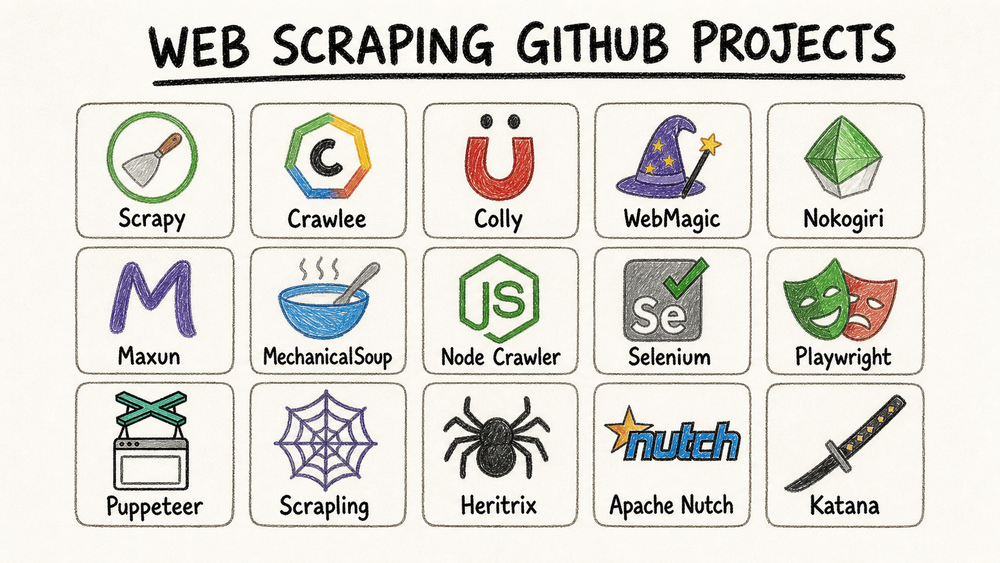
В 2026 году в интернете по-прежнему полно ценных данных, но большинству команд нужен не просто «какой-то скрапер», а практичный ответ на один из трёх вопросов: какой open-source проект всё ещё стоит брать за основу, какой стек справится с современными сайтами, насыщенными JavaScript, и стоит ли вообще отказываться от GitHub, если не разработчик хочет работать без кода.
Этот обновлённый обзор выстроен именно вокруг такого сценария выбора. 6 августа 2026 года я заново проверил публичные страницы репозиториев GitHub, количество звёзд и активность в ленте коммитов, а затем сравнил проекты ниже по сложности настройки, поддержке JavaScript, признакам живого развития, удобству выгрузки данных и тому, для кого они лучше всего подходят.
Короткий ответ
- Выбирайте Scrapy, если вам нужен самый зрелый Python-фреймворк для структурированного скрапинга на большом масштабе.
- Выбирайте Crawlee, если ваша команда работает на JavaScript или TypeScript и хочет один стек для HTTP-скрапинга и браузерного скрапинга.
- Выбирайте Playwright или Puppeteer, если сайт сильно завязан на JavaScript и по-настоящему нужен именно браузерный автоматизированный сценарий.
- Выбирайте Maxun, если вам нужен open-source визуальный no-code-слой с возможностью self-hosting вместо написания скрапинга с нуля.
- Выбирайте Heritrix, Apache Nutch или Katana только если у вас специализированная задача: архивный краулинг, распределённый краулинг или security-разведка.
- Выбирайте Thunderbit, если вы вообще не хотите строить решение на GitHub и вам нужно быстро получить данные в Sheets, Airtable, Notion, CSV или JSON.
Попробуйте no-code скрапер, прежде чем связываться с кодовым стеком
Сравнение в двух словах
Ниже приведены звёзды GitHub и сигналы последнего коммита, проверенные по публичным страницам репозиториев и лентам коммитов 6 августа 2026 года.
| Проект | Язык / модель | Сложность настройки | Поддержка JS | Лучший сценарий | Звёзды GitHub | Сигнал последнего коммита |
|---|---|---|---|---|---|---|
| Scrapy | Python framework | Средняя | Нет нативной поддержки JS | Крупномасштабные spider-задачи, e-commerce, новости | 63.7k | 6 августа 2026 |
| Crawlee | Node.js / TypeScript framework | Средняя | Да | Один стек для статического и динамического скрапинга | 25.2k | 6 августа 2026 |
| Maxun | Open-source no-code платформа | Развёртывание средней сложности, для пользователя — просто | Да | Бизнес-пользователи, которым важен open-source-контроль | 17.1k | 5 августа 2026 |
| MechanicalSoup | Python library | Легко | Нет | Формы, сессии и простые статические сайты | 4.9k | 4 августа 2026 |
| Node Crawler | Node.js crawler | Средняя | Нет | Быстрый статический краулинг и агрегация лент | 6.8k | 18 июня 2026 |
| Heritrix | Java archival crawler | Продвинутая | Нет | Веб-архивирование и захват на уровне домена | 3.3k | 5 августа 2026 |
| Apache Nutch | Java distributed crawler | Продвинутая | Нет | Поисковый и big-data краулинг | 3.3k | 5 августа 2026 |
| Selenium | Browser automation на нескольких языках | Средняя | Да | Сценарии с большим количеством действий и максимальная близость к реальному браузеру | 34.3k | 6 августа 2026 |
| Playwright | Browser automation на нескольких языках | Средняя | Да | Современные динамические сайты и надёжный скриптинг | 94.1k | 6 августа 2026 |
| Puppeteer | Node.js browser automation | Средняя | Да | Автоматизация и скрапинг, ориентированные на Chrome | 95.4k | 6 августа 2026 |
| Scrapling | Python stealth scraping toolkit | Средняя | Да | Скрапинг через браузер там, где важна устойчивость к антибот-защите | 72.8k | 30 июля 2026 |
| Katana | Go crawler / CLI | Средняя | Опционально headless | Security-краулинг и поиск URL | 17.3k | 5 августа 2026 |
| Colly | Go framework | Средняя | Нет | Высокопроизводительный статический скрапинг | 25.4k | 18 июня 2026 |
| WebMagic | Java framework | Средняя | Нет нативной поддержки JS | Типовые Java-пайплайны для скрапинга | 11.7k | 20 декабря 2025 |
| Nokogiri | Ruby parser | Легко | Нет | Ruby-приложения и кастомные сценарии парсинга | 6.3k | 3 августа 2026 |
| Thunderbit | AI no-code расширение для Chrome | Подключил и работаешь | Да | Непрограммистам, которым нужны данные быстро | N/A | Управляемый продукт, постоянно обновляется |
Прежде чем выбрать GitHub-проект, подумайте: вам вообще нужен кодовый workflow?
Thunderbit — не GitHub-проект, и именно поэтому он должен быть в этом гайде. Многие, кто ищет «лучшие GitHub-проекты для веб-скрапинга», на самом деле не хотят поддерживать стек краулинга. Им нужен структурированный результат с живого сайта прямо сейчас.
Thunderbit — самый короткий путь от code-first исследования в скрапинге к рабочему бизнес-процессу:
- Лучше всего подходит для: лидогенерации в продажах, мониторинга e-commerce, сбора данных по недвижимости, ресёрча в рекрутинге и браузерных операционных задач.
- Почему выделяется: AI-подсказки для полей, обогащение подстраниц, работа с динамическими страницами и экспорт в Sheets, Airtable, Notion, CSV и JSON без написания логики скрапинга.
- На что обратить внимание: если вам нужен долгоживущий внутренний краулинг-платформенный контур с собственной инфраструктурой, open-source фреймворк всё ещё даст больше контроля.
Если хотите увидеть no-code путь до того, как окончательно погружаться в GitHub, это актуальное демо Thunderbit — самый быстрый способ проверить реальность:
Попробовать Thunderbit AI Web Scraper бесплатно
Как я оценивал эти GitHub-проекты для скрапинга
Не все GitHub-проекты для скрапинга можно сравнивать напрямую. Одни — полноценные фреймворки. Другие — библиотеки для браузерной автоматизации. Третьи — парсеры. Четвёртые — узкоспециализированные краулеры для архивов или security-команд.
Чтобы список был действительно полезным, я отобрал проекты, которые проходят четыре практических фильтра:
- За ними всё ещё стоит рыночная реальность.
Одних звёзд мало, но низкая популярность плюс мёртвое сопровождение — почти всегда плохой знак. - У них всё ещё есть видимое движение.
Для этого обновления я заново проверял активность публичной ленты коммитов 6 августа 2026 года, а не полагался на старые подборки. - Они решают реальную задачу скрапинга.
Я исключил красивые, но малоизвестные репозитории, которые слабо соотносятся с реальными бизнес- или исследовательскими сценариями. - Они достаточно различаются, чтобы попасть в шортлист.
Цель не в том, чтобы вывалить 50 репозиториев. Цель — помочь выбрать между фреймворками, browser stack, no-code open-source инструментами и специализированными краулерами.
Параметры сравнения — это те же факторы, которые обычно определяют успех или провал на практике:
- Сложность настройки: как быстро новый пользователь сможет получить рабочий скрапинг.
- Поддержка JavaScript: может ли проект справляться с современными сайтами, где контент рендерится на клиенте.
- Состояние проекта: выглядит ли репозиторий достаточно живым, чтобы ему доверять.
- Работа с данными: выдаёт ли проект структурированный результат или оставляет больше работы вам.
- Соответствие аудитории: действительно ли проект рассчитан на новичков, data engineers, security-команды или нетехнических пользователей.
Сложность настройки: как быстро можно стартовать?
Такая классификация по сложности по-прежнему работает, но в 2026 году полезнее смотреть на неё проще:
- Подключил и работаешь: Thunderbit для бизнес-пользователей; MechanicalSoup или Nokogiri для лёгких code-first скриптов.
- Средняя сложность: Scrapy, Crawlee, Maxun, Selenium, Playwright, Puppeteer, Colly, Katana, Scrapling, WebMagic и Node Crawler — всем им нужны хотя бы немного кода, CLI или развёртывание.
- Продвинутый уровень: Heritrix и Apache Nutch имеют смысл только тогда, когда вам действительно нужен Java-архивный или распределённый краулинг.
Maxun заслуживает отдельного упоминания, потому что он находится где-то посередине. Саму платформу нужно развернуть, но пользовательский сценарий заметно проще, чем работа напрямую с Scrapy или Playwright.
Поддержка динамического контента: какие проекты справятся с современным вебом?
Современные сайты переполнены React, Vue, бесконечной прокруткой, фоновыми API-запросами и логин-зависимыми сценариями. Именно здесь и проходит грань между «я получил HTML» и «я получил нужные мне данные».
Проекты в этом списке можно разделить на три группы:
- Полная браузерная автоматизация: Selenium, Playwright и Puppeteer полноценно исполняют JavaScript и по-прежнему остаются самыми надёжными вариантами для сайтов с большим количеством взаимодействий.
- Гибридные решения или обёртки: Crawlee умеет переключаться между лёгким HTTP-краулингом и браузерным скрапингом. Scrapling добавляет stealth-инструменты для более сложных целей. Maxun использует браузерный подход за визуальным интерфейсом.
- По умолчанию только статический HTML: Scrapy, MechanicalSoup, Node Crawler, Colly, WebMagic, Nokogiri, Heritrix и Apache Nutch сами по себе не решают проблему современного рендеринга.
Если ваш главный вопрос звучит так: «Справится ли этот стек с JavaScript-heavy страницами без ручной сборки каждого шага браузера?», то вот актуальный Playwright-урок, который лучше всего показывает реальность:
Состояние проектов: какие репозитории в 2026 году выглядят надёжными?
Версия этой статьи за 2025 год опиралась на число звёзд и несколько устаревших пометок об обновлениях. Этого уже недостаточно. Я сверил и текущие звёзды, и недавние сигналы коммитов 6 августа 2026 года.
Картина в целом такая:
- Явно активны прямо сейчас: Scrapy, Crawlee, Maxun, MechanicalSoup, Heritrix, Apache Nutch, Selenium, Playwright, Puppeteer, Scrapling, Katana и Nokogiri публиковали коммиты в течение двух недель до проверки.
- Живые, но развиваются медленнее: Colly и Node Crawler последний раз коммитили 18 июня 2026 года. Они по-прежнему выглядят рабочими, но обновляются рывками, а не с еженедельной регулярностью, как Playwright или Crawlee.
- Требуют большей осторожности: у WebMagic здесь самый заметный разрыв. Последний публичный сигнал коммита, который я нашёл, датирован 20 декабря 2025 года, поэтому я бы воспринимал его скорее как стабильный проект, чем как активно развивающийся.
Это важно, потому что стиль сопровождения должен влиять на шортлист:
- Если вам нужен безопасный дефолт для нового инженерного проекта, отдавайте приоритет более явно активным репозиториям.
- Если инструмент простой и задача узкая, медленное развитие допустимо.
- Если проект нишевый, сначала оценивайте соответствие задаче, а не то, выходит ли он каждую неделю.
15 лучших GitHub-проектов для веб-скрапинга в 2026 году
Фреймворки для крупномасштабного и универсального скрапинга
1. Scrapy
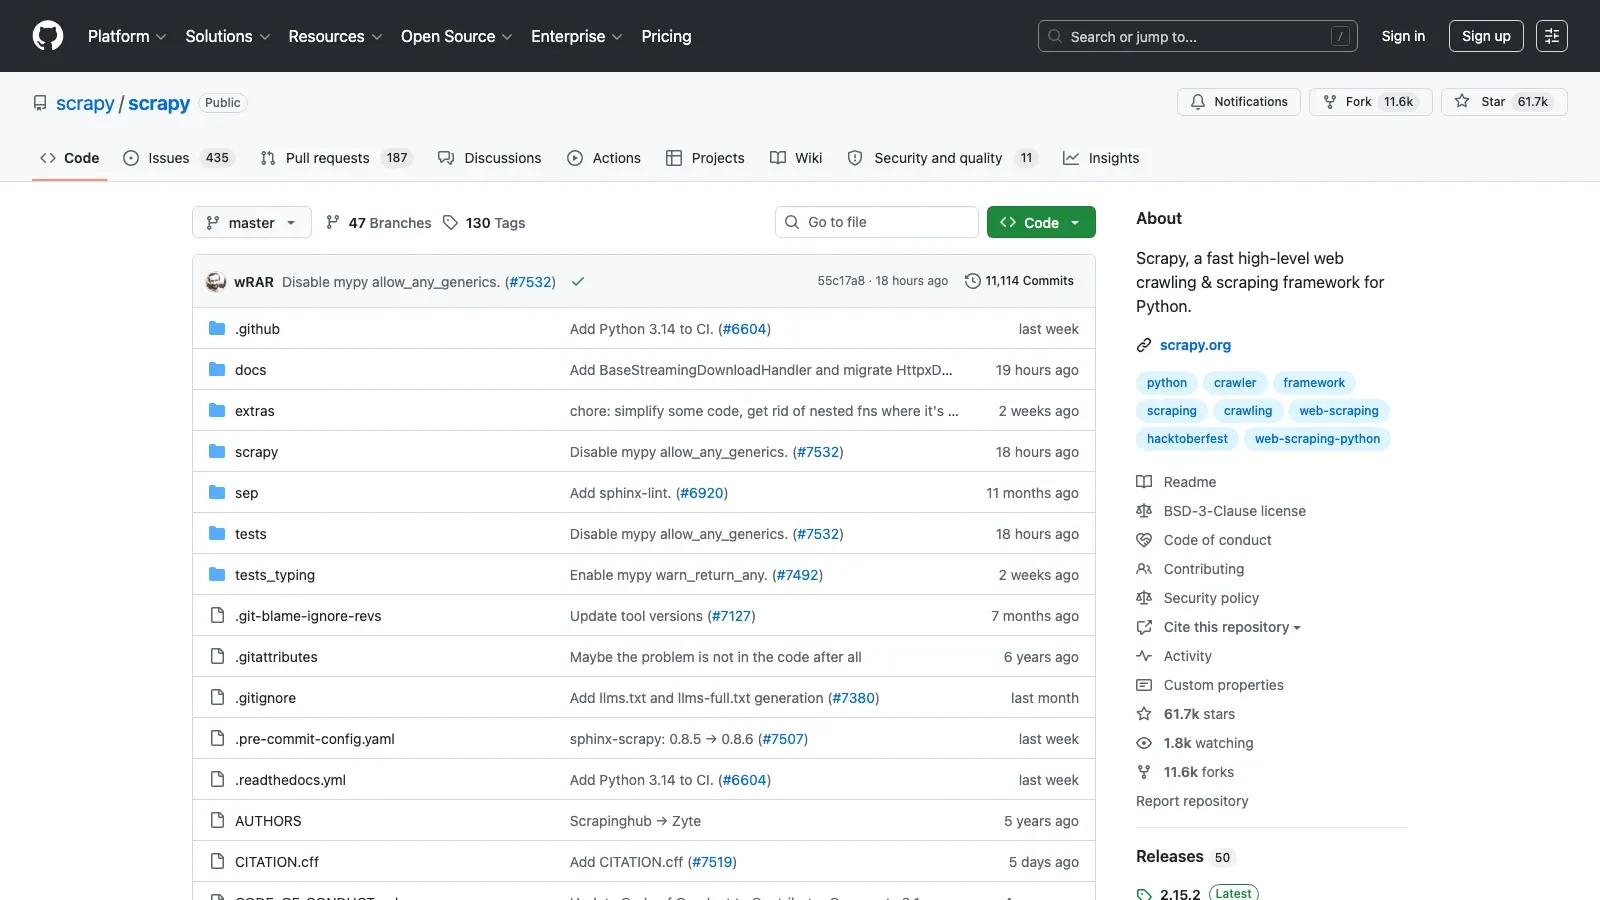
Scrapy по-прежнему остаётся стандартным Python-ответом, когда задача крупнее, чем просто быстрый скрипт. Если вам нужны spiders, pipeline, middleware, throttling, retries и зрелая экосистема, это самый безопасный open-source выбор на этом списке.
- Сложность настройки: Средняя
- Лучше всего подходит для: e-commerce-каталогов, скрапинга каталогов и справочников, новостных сайтов и долгоживущих внутренних систем скрапинга
- Поддержка JS: Нативного рендеринга нет; при необходимости подключайте Playwright или Selenium
- Почему стоит выбрать: зрелая архитектура, сильная документация и одно из лучших соотношений мощности к сообществу в open-source скрапинге
- На что обратить внимание: если вы раньше не работали с crawler-фреймворками, кривая обучения будет ощутимой
Если хотите понять, подходит ли вам путь Scrapy, прежде чем окончательно на него перейти, этот актуальный обзор для новичков по-прежнему полезен:
2. Crawlee
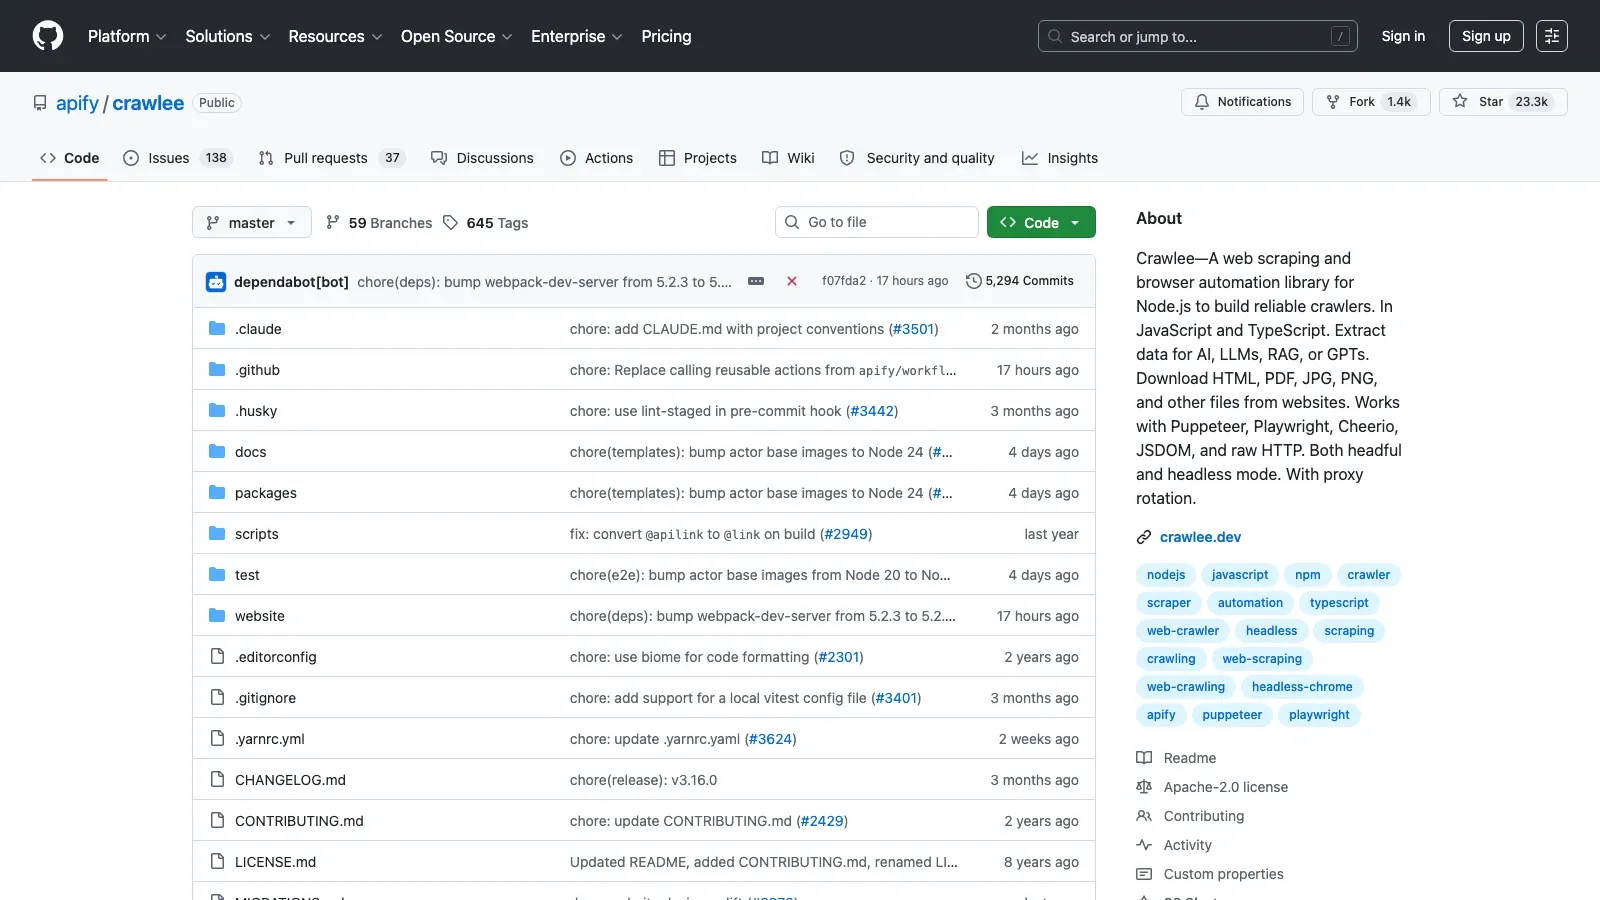
Crawlee стал самым привлекательным вариантом для JavaScript- или TypeScript-команд, которым нужен один проект и для лёгкого краулинга, и для браузерного скрапинга. Умение переключаться между HTTP-first подходом и workflow на базе Playwright или Puppeteer — его главное преимущество.
- Сложность настройки: Средняя
- Лучше всего подходит для: команд на JS и TS, гибридных статических и динамических целей, а также внутренних автоматизированных инструментов
- Поддержка JS: Да
- Почему стоит выбрать: гибкая модель выполнения, помощники против блокировок и более удобный browser-story UX по сравнению со старыми crawler-only стеками
- На что обратить внимание: больше всего смысла он имеет, если ваша команда и так уверенно работает в Node.js
3. Colly
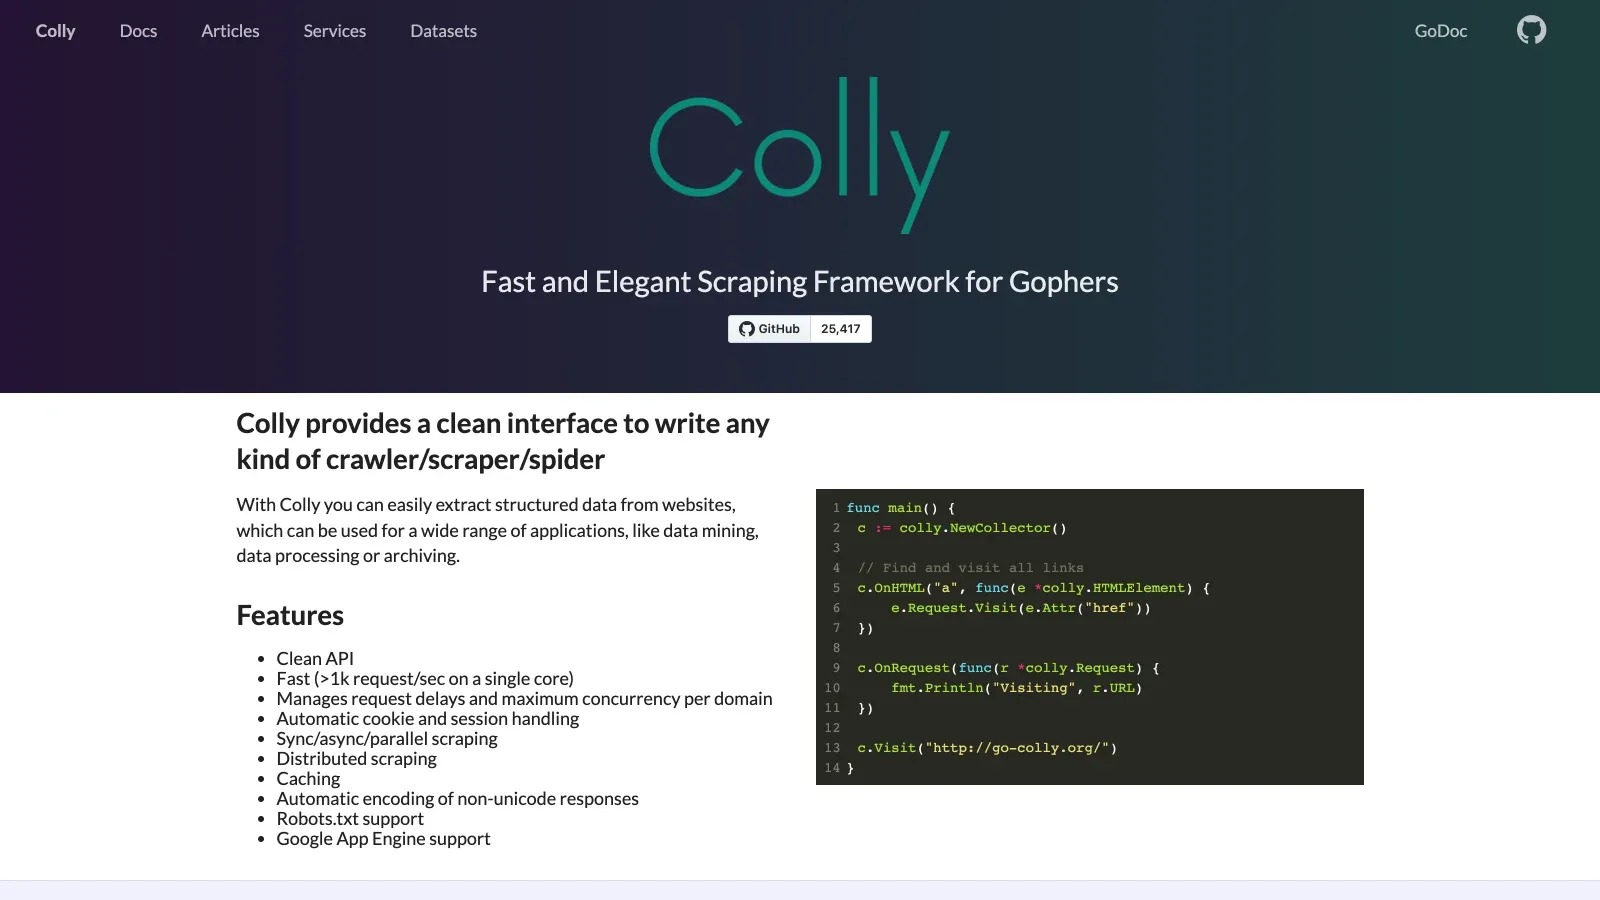
Colly по-прежнему остаётся одним из самых аккуратных и высокопроизводительных вариантов для Go-команд, которым по умолчанию не нужен браузерный рендеринг. Он быстрый, элегантный и хорошо подходит, когда узкое место — объём, а не сложность интерфейса.
- Сложность настройки: Средняя
- Лучше всего подходит для: Go-разработчиков, которым нужен быстрый статический краулер
- Поддержка JS: Нативного рендеринга нет
- Почему стоит выбрать: параллелизм, лимитирование скорости и приятный API для задач с высокой пропускной способностью
- На что обратить внимание: это не лучший выбор, если по-настоящему нужен браузерный automation
4. WebMagic
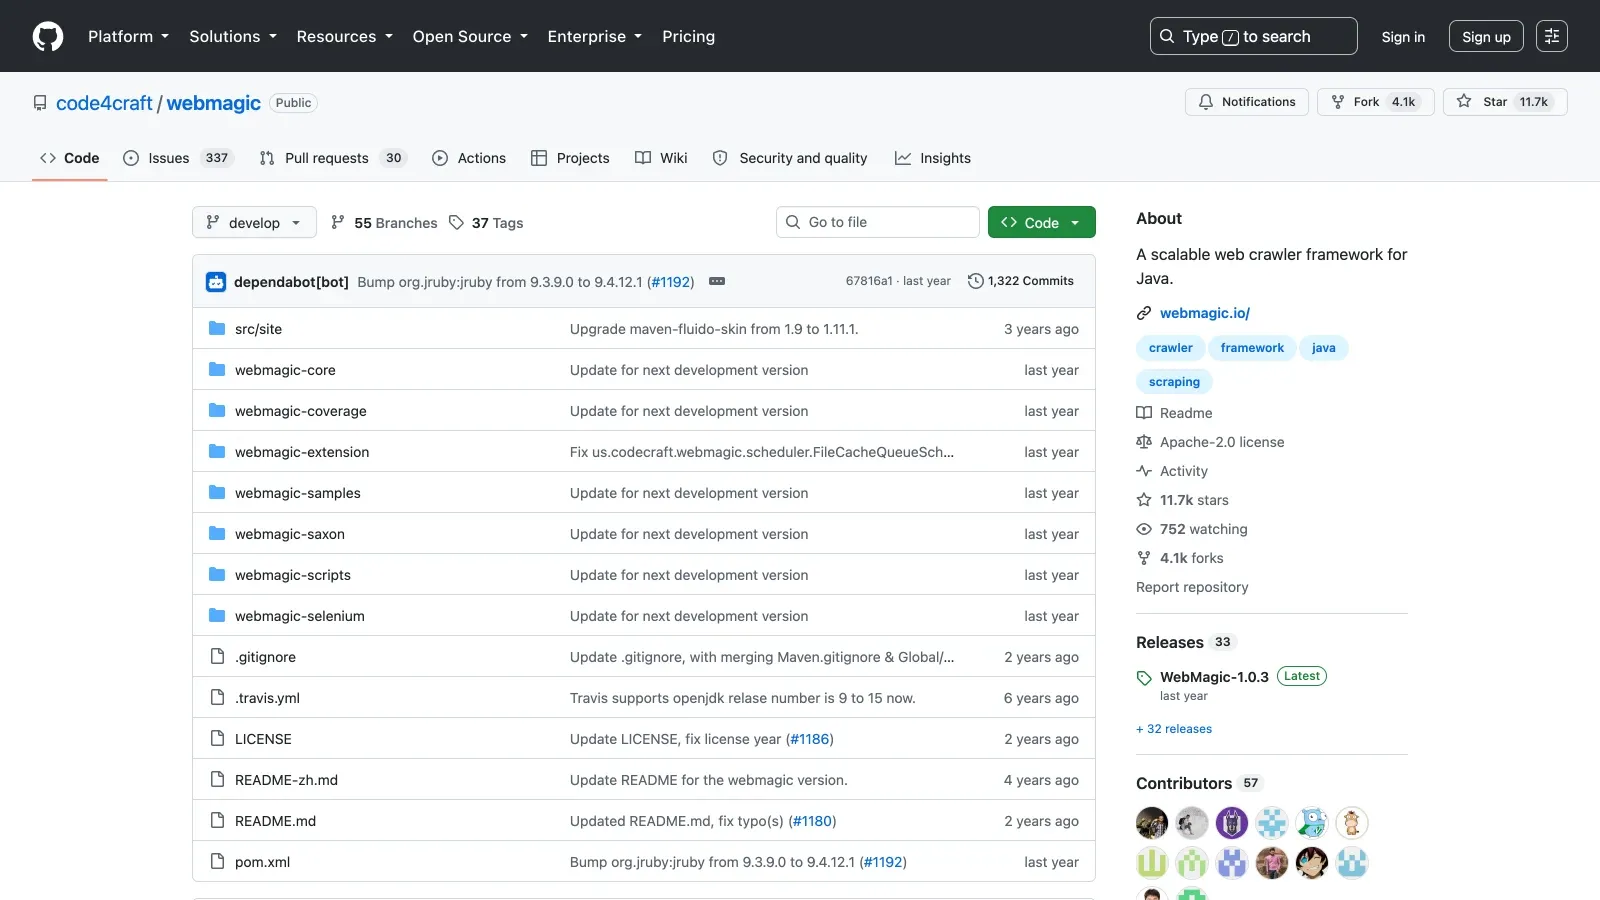
WebMagic остаётся Java-аналогом для команд, которым нравится модель Scrapy, но хочется остаться в экосистеме JVM. Он всё ещё имеет смысл для Java-стека, даже если вокруг него меньше внимания, чем вокруг Python- или Node-решений.
- Сложность настройки: Средняя
- Лучше всего подходит для: Java-пайплайнов для скрапинга
- Поддержка JS: Нативного рендеринга нет
- Почему стоит выбрать: scheduler, pipeline и понятная структура фреймворка
- На что обратить внимание: экосистема тише, чем у крупных Python- и Node-решений, а последний публичный сигнал коммита, который я нашёл, датирован 20 декабря 2025 года, поэтому воспринимайте его скорее как стабильный проект, чем как активно развивающийся
5. Nokogiri
Nokogiri — это не crawler-фреймворк. Это парсер, к которому Ruby-разработчики по-прежнему обращаются, когда им нужна аккуратная работа с HTML или XML внутри собственного скрипта или приложения.
- Сложность настройки: Легко
- Лучше всего подходит для: Ruby- и Rails-приложений, где нужен парсинг, а не полноценный crawler framework
- Поддержка JS: Нет
- Почему стоит выбрать: быстрый, стабильный и безопасный по умолчанию парсинг
- На что обратить внимание: HTTP-слой, сессии или браузерную часть придётся подключать отдельно
Лёгкие статические и дружелюбные к новичкам проекты
6. Maxun
Maxun — это open-source ответ для тех, кому нравится идея no-code-скрапинга, но при этом важны self-hosting и контроль уровня GitHub. Для нетехнических пользователей он намного доступнее, чем чистый фреймворк, но это всё ещё реальный open-source проект, а не закрытый SaaS.
- Сложность настройки: Развернуть — средне, для конечного пользователя после настройки — проще
- Лучше всего подходит для: команд, которым нужен визуальный интерфейс с open-source-контролем
- Поддержка JS: Да
- Почему стоит выбрать: извлечение данных через интерфейс, многошаговые сценарии и меньший порог входа по сравнению с написанием кода с нуля
- На что обратить внимание: этап развёртывания всё ещё тяжелее, чем у полностью управляемого браузерного расширения
7. MechanicalSoup
MechanicalSoup по-прежнему заслуживает места в списке, потому что не каждый скрапинг требует headless-браузера. Если настоящая проблема — управление сессиями, отправка форм или прохождение статического сценария после логина, инструмент остаётся приятно компактным и понятным.
- Сложность настройки: Легко
- Лучше всего подходит для: простых форм, статических страниц с авторизацией и быстрых Python-скриптов автоматизации
- Поддержка JS: Нет
- Почему стоит выбрать: минимум трения, читаемый код и мягкий вход для Python-пользователей
- На что обратить внимание: на JS-heavy сайтах его полезность быстро заканчивается
8. Node Crawler
Node Crawler всё ещё имеет смысл, если ваша цель — статический HTML и вам важны в первую очередь параллелизм, очереди и парсинг в стиле Cheerio. Для нового проекта, завязанного на браузер, я бы его не выбирал, но для сбора лент и статических сайтов он всё ещё может быть хорошим вариантом.
- Сложность настройки: Средняя
- Лучше всего подходит для: быстрого статического краулинга и агрегации
- Поддержка JS: Нет
- Почему стоит выбрать: управление параллелизмом и привычный jQuery-подобный workflow парсинга
- На что обратить внимание: последний публичный сигнал коммита, который я нашёл, датирован 18 июня 2026 года, а интервалы между обновлениями большие, поэтому для нового долгоживущего dynamic-site стека я бы с него не начинал
Проекты для динамических сайтов и браузерной автоматизации
9. Selenium
Selenium старше Playwright, но он по-прежнему важен там, где точность поведения браузера и достоверность взаимодействий важнее элегантности. Он особенно актуален там, где скрапинг пересекается с QA, регрессионной автоматизацией или сайтами, требующими очень буквального поведения браузера.
- Сложность настройки: Средняя
- Лучше всего подходит для: сценариев с большим количеством взаимодействий, legacy browser automation и команд, которые уже используют Selenium для тестирования
- Поддержка JS: Да
- Почему стоит выбрать: широкая поддержка браузеров, огромное сообщество и многолетняя зрелость
- На что обратить внимание: более новые стеки автоматизации часто кажутся чище и быстрее для новых скрапинг-проектов
10. Playwright
Playwright — мой базовый современный выбор для команд разработчиков, которым нужен скрапинг динамических страниц. Сочетание поддержки нескольких браузеров, надёжного ожидания и чистых API делает его самым простым браузерным automation-проектом в этом списке для широких рекомендаций.
- Сложность настройки: Средняя
- Лучше всего подходит для: современных веб-приложений, сценариев с логином и JavaScript-heavy целей
- Поддержка JS: Да
- Почему стоит выбрать: кросс-браузерный контроль, надёжные примитивы автоматизации и активное сопровождение
- На что обратить внимание: селекторы, инфраструктура браузеров, retries и качество результата остаются на вашей стороне
11. Puppeteer
Puppeteer по-прежнему остаётся классикой Chrome-first. Если ваша команда уже работает на Node.js и в основном нацелена на совместимые с Chromium сценарии, это остаётся практичным и хорошо понятным вариантом.
- Сложность настройки: Средняя
- Лучше всего подходит для: автоматизации под Chrome, скриншотов, PDF и извлечения динамического контента
- Поддержка JS: Да
- Почему стоит выбрать: богатый контроль над браузером и огромное количество примеров от сообщества
- На что обратить внимание: Playwright стал более сильным дефолтом, если вам нужен более широкий охват браузеров и современный кросс-браузерный подход
12. Scrapling
Scrapling — самый специализированный современный участник этой группы. Он для тех, кто уже понимает, что браузерный рендеринг — не единственная проблема. Нужны ещё stealth-механики, awareness к прокси и более сильная антибот-позиция.
- Сложность настройки: Средняя
- Лучше всего подходит для: stealth-скрапинга, целей с жёсткой антибот-защитой и Python-first работы с динамическими сайтами
- Поддержка JS: Да
- Почему стоит выбрать: активная разработка и более точечный фокус на тех трудностях скрапинга, которые более простые фреймворки игнорируют
- На что обратить внимание: это избыточно для обычных статических сайтов и менее дружелюбно к новичкам, чем MechanicalSoup или Scrapy
Специализированные краулеры для исследований, security и инфраструктуры
13. Heritrix
Heritrix — это не скрапер для сравнения товаров. Это архивный краулер, созданный для организаций, которым важны сохранение всего сайта и корректный с точки зрения стандартов захват контента.
- Сложность настройки: Продвинутая
- Лучше всего подходит для: архивов, библиотек и масштабных workflows по сохранению веб-контента
- Поддержка JS: Нет
- Почему стоит выбрать: наследие Internet Archive и архивные процессы, ориентированные на WARC
- На что обратить внимание: не тот инструмент для целевого сбора списков или цен
14. Apache Nutch
Apache Nutch по-прежнему имеет смысл для команд, которые мыслят в категориях распределённого краулинга, индексирования или сбора данных в стиле поисковой системы, а не разовых бизнес-задач по скрапингу.
- Сложность настройки: Продвинутая
- Лучше всего подходит для: распределённого краулинга, исследовательских датасетов и сбора данных в стиле поисковых систем
- Поддержка JS: Нет
- Почему стоит выбрать: plugin-модель и привычность для enterprise-среды Apache
- На что обратить внимание: слишком тяжёл для большинства задач, ориентированных на таблицы или браузер
15. Katana
Katana попал сюда потому, что security-краулинг — это отдельный сценарий. Если задача — разведка, поиск endpoint’ов или быстрое построение структуры цели, Katana подходит куда лучше, чем универсальный фреймворк для скрапинга.
- Сложность настройки: Средняя
- Лучше всего подходит для: security reconnaissance, поиска ссылок и составления инвентаря URL
- Поддержка JS: Опциональный headless-режим
- Почему стоит выбрать: скорость, параллелизм и security-ориентированная модель краулинга
- На что обратить внимание: он не создан как polished-стек для извлечения бизнес-данных
Мой шортлист по типу команды
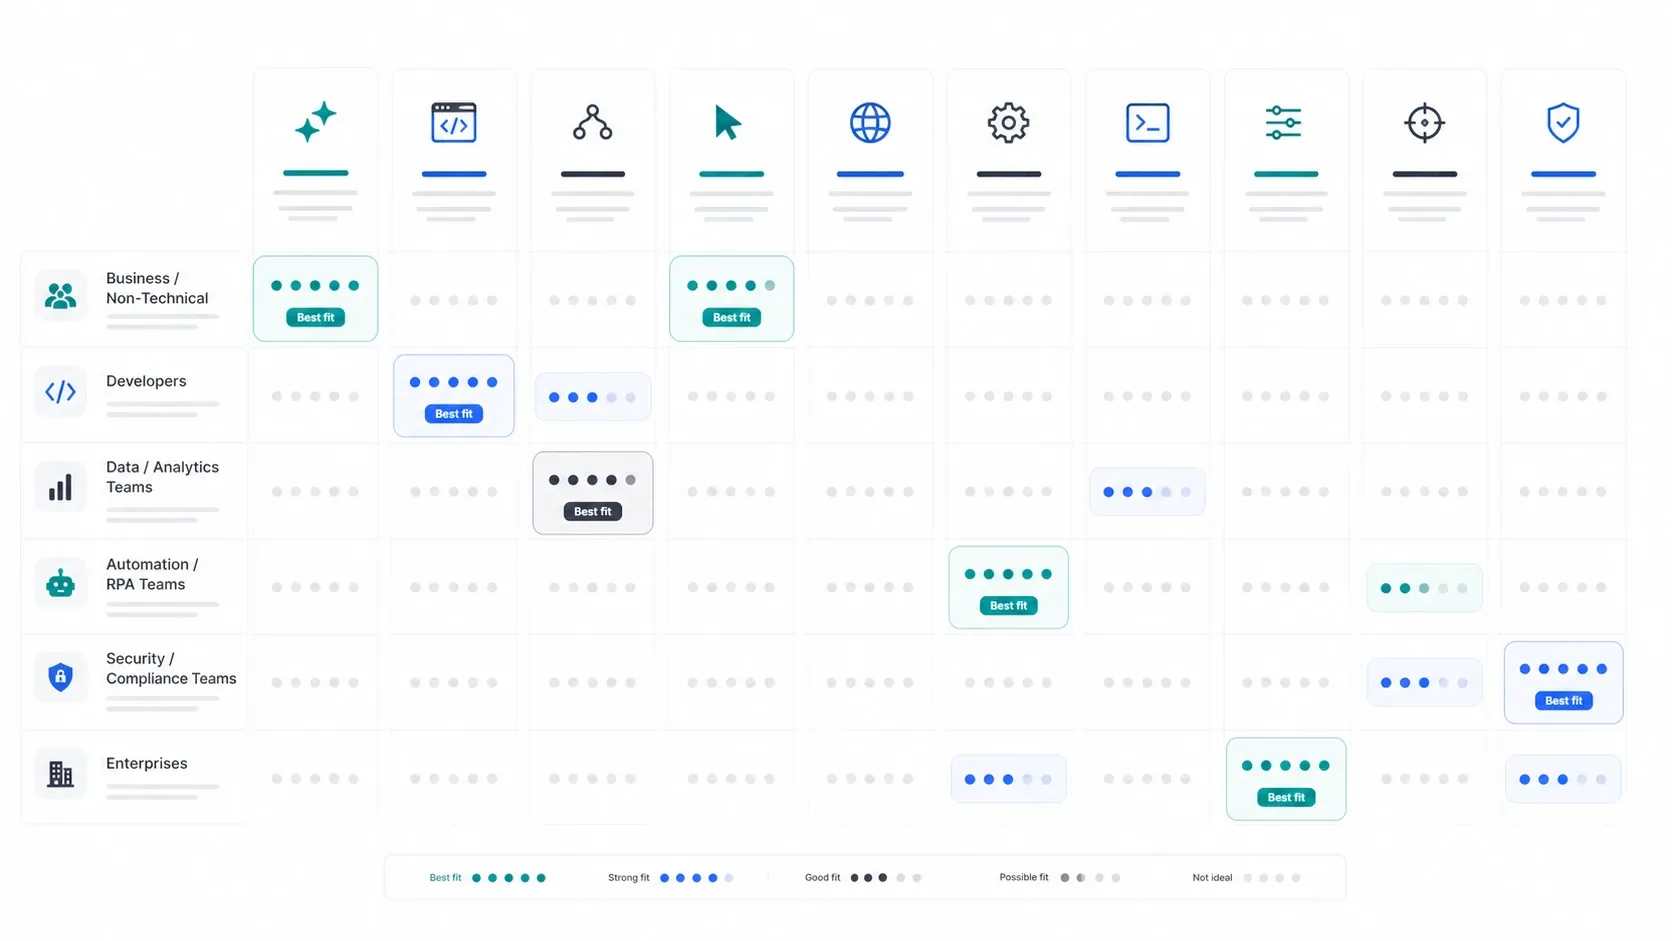
- Python-разработчики: начните со Scrapy для фреймворков, с MechanicalSoup для небольших статических сценариев и с Scrapling, если stealth или антибот-сложность уже являются частью проблемы.
- Команды на JavaScript или TypeScript: начните с Crawlee как с фреймворка, с Playwright для браузерной автоматизации и с Puppeteer, если достаточно Chrome-first workflow.
- Go-команды: Colly для скрапинга, Katana для security-краулинга с упором на discovery.
- Java-команды: WebMagic для общего краулинга, Heritrix для архивного захвата, Apache Nutch для распределённого поиска и краулинга в поисковом стиле.
- Нетехнические пользователи: Maxun, если нужен open-source self-hosting, или Thunderbit, если нужен управляемый no-code workflow с быстрым выходом на рабочий результат.
С чего большинству людей стоит начать на самом деле?
Практичный ответ такой:
- Если вы хотите создать свой скрапер и владеть им, начните с Scrapy или Crawlee.
- Если вам нужно управлять настоящим браузером, начните с Playwright.
- Если вам нужен визуальный open-source слой, начните с Maxun.
- Если вам нужен специализированный архивный или security-краулинг, выбирайте Heritrix, Nutch или Katana только тогда, когда ваш сценарий действительно этого требует.
- Если вы хотите обойтись без кода и получить данные прямо сейчас, не загоняйте себя сначала в GitHub. Используйте Thunderbit.
Итог
Лучший GitHub-проект для веб-скрапинга в 2026 году зависит не столько от числа звёзд, сколько от того, какую ответственность вы готовы на себя взять. Scrapy по-прежнему остаётся самым безопасным дефолтом среди Python-фреймворков. Crawlee — лучший современный выбор для JavaScript. Playwright — сильнейшая база для браузерной автоматизации. Maxun — самый интересный open-source путь без кода. Heritrix, Apache Nutch и Katana — это специализированные инструменты, которые великолепны только в своей нише.
Самое важное — не путать «самый мощный» с «самым подходящим». Если вашей команде нужны лишь чистые данные в таблице, GitHub может вообще не быть правильной отправной точкой.
Избавьтесь от затрат на поддержку и начните скрапить быстрее Get Started Free



