
Какой язык программирования лучше использовать для веб-скрейпинга? Всё зависит от твоего проекта — и я не раз видел, как разработчики в сердцах бросали начатое, потому что выбрали не тот инструмент.
Рынок программного обеспечения для веб-скрейпинга достиг $1.01 млрд в 2024 году и, как ожидается, более чем удвоится к 2032 году. Правильно выбранный язык означает более быстрый результат и меньше хлопот с поддержкой. Неправильный — это сломанные скрейперы и потерянные выходные.
Я много лет занимаюсь созданием инструментов автоматизации. Ниже — семь языков, которые я использовал для скрейпинга: с примерами кода, честным разбором компромиссов и объяснением, когда лучше вообще не писать код, а сразу взять Thunderbit.
Как мы выбирали лучшие языки для веб-скрейпинга
В веб-скрейпинге не все языки программирования одинаково полезны. Я видел, как проекты взлетают — и как так же быстро проваливаются — в зависимости от нескольких ключевых факторов:
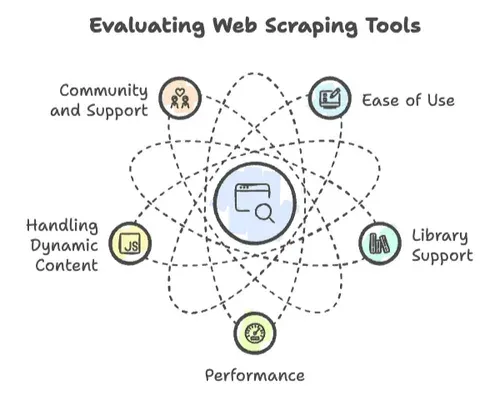
- Простота использования: Как быстро можно стартовать? Синтаксис дружелюбный или для того, чтобы вывести «Hello, World», нужен почти PhD по компьютерным наукам?
- Поддержка библиотек: Есть ли мощные библиотеки для HTTP-запросов, разбора HTML и работы с динамическим контентом? Или придётся изобретать велосипед?
- Производительность: Справится ли язык со скрейпингом миллионов страниц или сдастся уже после пары сотен?
- Работа с динамическим контентом: Современные сайты обожают JavaScript. Успевает ли за этим твой язык?
- Сообщество и поддержка: Когда ты упрёшься в стену — а это неизбежно — найдётся ли, кто поможет?
С учётом этих критериев — и множества ночных тестов — вот семь языков, о которых пойдёт речь:
- Python: лучший выбор и для новичков, и для профессионалов.
- JavaScript и Node.js: король динамического контента.
- Ruby: чистый синтаксис, быстрые скрипты.
- PHP: простота серверной стороны.
- C++: когда нужна сырая скорость.
- Java: готовность к enterprise-нагрузкам и масштабированию.
- Go (Golang): быстро и параллельно.
А если ты думаешь: «Чёрт, я вообще не хочу писать код», — дочитай до конца: в финале будет Thunderbit.
Веб-скрейпинг на Python: мощный и дружелюбный к новичкам
Начнём с любимца публики — Python. Если спросить зал, полный специалистов по данным: «Какой язык лучше для веб-скрейпинга?» — Python прозвучит почти как хором на концерте Taylor Swift.
Почему Python?
- Понятный для новичков синтаксис: Код на Python почти можно читать вслух как обычный английский.
- Непревзойдённая экосистема библиотек: От BeautifulSoup для разбора HTML до Scrapy для крупномасштабного краулинга, Requests для HTTP и Selenium для автоматизации браузера — у Python есть всё.
- Огромное сообщество: Только по теме веб-скрейпинга — более 33 000 вопросов на Stack Overflow.
Пример кода на Python: извлечение заголовка страницы
import requests
from bs4 import BeautifulSoup

response = requests.get("<https://example.com>")
soup = BeautifulSoup(response.text, 'html.parser')
title = soup.title.string
print(f"Page title: {title}")
Преимущества:
- Быстрая разработка и прототипирование.
- Море туториалов и ответов на вопросы.
- Отлично подходит для анализа данных — собирайте данные на Python, анализируйте с pandas, визуализируйте с matplotlib.
- Библиотеки продолжают развиваться: релиз Scrapy 2.14 (январь 2026) принёс нативную поддержку
async/awaitво весь фреймворк, так что история с асинхронностью — это уже не только про Selenium/Playwright.
Ограничения:
- Медленнее компилируемых языков на очень больших объёмах.
- Работа с крайне динамическими сайтами может быть громоздкой (хотя Selenium и Playwright сильно помогают).
- Не лучший выбор, если нужно выкачать миллионы страниц на максимальной скорости.
Вывод:
Если ты только начинаешь или просто хочешь быстро получить результат, Python — лучший язык для веб-скрейпинга. Точка. Почему Python так доминирует в веб-скрейпинге.
JavaScript и Node.js: лёгкий скрейпинг динамических сайтов
Если Python — это швейцарский нож, то JavaScript (и Node.js) — это дрель, особенно когда речь идёт о современных сайтах с большим количеством JavaScript.
Почему JavaScript/Node.js?
- Нативная работа с динамическим контентом: Он работает в браузере и видит то же, что видит пользователь, даже если сайт собран на React, Angular или Vue.
- Асинхронность по умолчанию: Node.js легко обрабатывает сотни запросов одновременно.
- Привычен веб-разработчикам: Если ты делал сайты, ты уже знаешь хотя бы часть JavaScript.
Ключевые библиотеки:
- Playwright: мультибраузерный инструмент (Chromium, Firefox, WebKit) с автодожиданием и прокси на уровне контекста. Если ты начинаешь новый Node-скрейпер в 2026 году, это выбор по умолчанию.
- Puppeteer: headless Chrome через Chrome DevTools Protocol. По-прежнему отличный вариант для задач только под Chrome и с меньшим количеством зависимостей.
- Cheerio: HTML-парсер в стиле jQuery для Node, когда полноценный браузер не нужен.
Пример кода на Node.js: извлечение заголовка страницы с Puppeteer
const puppeteer = require('puppeteer');

(async () => {
  const browser = await puppeteer.launch();
  const page = await browser.newPage();
  await page.goto('<https://example.com>', { waitUntil: 'networkidle2' });
  const title = await page.title();
  console.log(`Page title: ${title}`);
  await browser.close();
})();
Преимущества:
- Нативно работает с контентом, отрисованным JavaScript.
- Отлично подходит для бесконечной прокрутки, всплывающих окон и интерактивных сайтов.
- Эффективен для крупномасштабного параллельного скрейпинга.
Ограничения:
- Асинхронное программирование может быть непростым для новичков.
- Headless-браузеры потребляют много памяти, если запускать слишком много одновременно.
- Инструментов для анализа данных меньше, чем у Python.
Когда JavaScript/Node.js — лучший язык для веб-скрейпинга?
Когда целевой сайт динамический или тебе нужно автоматизировать действия в браузере. Подробнее о Node.js для скрейпинга динамического контента.
Ruby: чистый синтаксис для быстрых скриптов веб-скрейпинга
Ruby — это не только Rails и красивый код. Это вполне сильный вариант для веб-скрейпинга, особенно если тебе нравится, когда код читается почти как хайку.
Почему Ruby?
- Читаемый и выразительный синтаксис: На Ruby можно написать скрейпер, который почти так же легко читать, как список покупок.
- Отлично для прототипирования: Быстро писать, легко дорабатывать.
- Ключевые библиотеки: Nokogiri для разбора HTML, Mechanize для автоматизации навигации.
Пример кода на Ruby: извлечение заголовка страницы
require 'open-uri'
require 'nokogiri'

html = URI.open("<https://example.com>")
doc = Nokogiri::HTML(html)
title = doc.at('title').text
puts "Page title: #{title}"
Преимущества:
- Очень читаемый и лаконичный код.
- Отлично подходит для небольших проектов, одноразовых скриптов или если ты уже работаешь с Ruby.
Ограничения:
- Медленнее Python и Node.js на больших объёмах.
- Меньше библиотек именно для скрейпинга и слабее сообщество по этой теме.
- Не лучший выбор для сайтов с тяжёлым JavaScript (хотя можно использовать Watir или Selenium).
Лучший сценарий:
Если ты Ruby-разработчик или хочешь быстро собрать рабочий скрипт — Ruby очень приятен в работе. Для массового и динамического скрейпинга лучше посмотреть в другую сторону.
PHP: простая серверная сторона для извлечения веб-данных
PHP может казаться реликтом раннего интернета, но он всё ещё жив — особенно если тебе нужно собирать данные прямо на сервере.
Почему PHP?
- Работает почти везде: На большинстве веб-серверов PHP уже установлен.
- Легко интегрируется с веб-приложениями: Можно собрать данные и сразу показать их на сайте.
- Ключевые библиотеки: cURL для HTTP, Guzzle для запросов, Symfony Panther для автоматизации headless-браузера.
Пример кода на PHP: извлечение заголовка страницы
<?php
$ch = curl_init("<https://example.com>");
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
$html = curl_exec($ch);
curl_close($ch);

$dom = new DOMDocument();
@$dom->loadHTML($html);
$title = $dom->getElementsByTagName("title")->item(0)->nodeValue;
echo "Page title: $title\n";
?>
Преимущества:
- Легко разворачивается на веб-серверах.
- Хорошо подходит для скрейпинга как части веб-процесса.
- Быстр для простых серверных задач.
Ограничения:
- Ограниченная экосистема библиотек для продвинутого скрейпинга.
- Не рассчитан на высокую параллельность и масштаб.
- Сайтами с большим количеством JavaScript работать сложнее (хотя Panther помогает).
Лучший сценарий:
Если твой стек уже на PHP или ты хочешь собирать и сразу отображать данные на сайте, PHP — практичный выбор. Подробнее о PHP vs Python для скрейпинга.
C++: высокопроизводительный веб-скрейпинг для масштабных проектов
C++ — это мускулистый спорткар среди языков программирования. Если тебе нужна сырая скорость и полный контроль, а ручная работа тебя не пугает, C++ может далеко завести.
Почему C++?
- Очень быстрый: На CPU-bound задачах обгоняет большинство языков.
- Тонкий контроль: Управление памятью, потоками и производительностью вручную.
- Ключевые библиотеки: libcurl для HTTP, htmlcxx для разбора HTML.
Пример кода на C++: извлечение заголовка страницы
#include <curl/curl.h>
#include <iostream>
#include <string>

size_t WriteCallback(void* contents, size_t size, size_t nmemb, void* userp) {
    std::string* html = static_cast<std::string*>(userp);
    size_t totalSize = size * nmemb;
    html->append(static_cast<char*>(contents), totalSize);
    return totalSize;
}

int main() {
    CURL* curl = curl_easy_init();
    std::string html;
    if(curl) {
        curl_easy_setopt(curl, CURLOPT_URL, "<https://example.com>");
        curl_easy_setopt(curl, CURLOPT_WRITEFUNCTION, WriteCallback);
        curl_easy_setopt(curl, CURLOPT_WRITEDATA, &html);
        CURLcode res = curl_easy_perform(curl);
        curl_easy_cleanup(curl);
    }

    std::size_t startPos = html.find("<title>");
    std::size_t endPos = html.find("</title>");
    if(startPos != std::string::npos && endPos != std::string::npos) {
        startPos += 7;
        std::string title = html.substr(startPos, endPos - startPos);
        std::cout << "Page title: " << title << std::endl;
    } else {
        std::cout << "Title tag not found" << std::endl;
    }
    return 0;
}
Преимущества:
- Непревзойдённая скорость для больших задач скрейпинга.
- Отлично подходит для встроенного использования в высокопроизводительных системах.
Ограничения:
- Крутая кривая обучения — запасайся кофе.
- Необходимо вручную управлять памятью.
- Мало высокоуровневых библиотек; для динамического контента подходит плохо.
Лучший сценарий:
Когда нужно собрать миллионы страниц или производительность абсолютно критична. Во всех остальных случаях ты, вероятно, потратишь больше времени на отладку, чем на сам скрейпинг.
Java: enterprise-решения для веб-скрейпинга
Java — рабочая лошадка корпоративного мира. Если ты строишь что-то, что должно работать годами, обрабатывать тонны данных и пережить зомби-апокалипсис, Java — твой друг.
Почему Java?
- Надёжный и масштабируемый: Отлично подходит для больших, долго работающих проектов по скрейпингу.
- Строгая типизация и обработка ошибок: Меньше сюрпризов в продакшене.
- Ключевые библиотеки: Jsoup для разбора HTML, Selenium WebDriver для автоматизации браузера, Apache HttpClient для HTTP.
Пример кода на Java: извлечение заголовка страницы
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;

public class ScrapeTitle {
    public static void main(String[] args) throws Exception {
        Document doc = Jsoup.connect("<https://example.com>").get();
        String title = doc.title();
        System.out.println("Page title: " + title);
    }
}
Преимущества:
- Высокая производительность и хорошая работа с параллельностью.
- Отлично подходит для больших, легко поддерживаемых кодовых баз.
- Неплохая поддержка динамического контента (через Selenium или HtmlUnit).
Ограничения:
- Многословный синтаксис; больше настройки, чем у скриптовых языков.
- Для маленьких одноразовых скриптов — избыточен.
Лучший сценарий:
Крупные enterprise-проекты по сбору данных или задачи, где важны надёжность и масштабируемость.
Go (Golang): быстрый и параллельный веб-скрейпинг
Go — сравнительно новый игрок, но уже успел наделать шума, особенно в задачах высокоскоростного параллельного скрейпинга.
Почему Go?
- Скорость компилируемого языка: Почти так же быстр, как C++.
- Встроенная конкурентность: Goroutines делают параллельный скрейпинг очень удобным.
- Ключевые библиотеки: Colly для скрейпинга, Goquery для разбора HTML.
Пример кода на Go: извлечение заголовка страницы
package main

import (
    "fmt"
    "github.com/gocolly/colly"
)

func main() {
    c := colly.NewCollector()
    c.OnHTML("title", func(e *colly.HTMLElement) {
        fmt.Println("Page title:", e.Text)
    })
    err := c.Visit("<https://example.com>")
    if err != nil {
        fmt.Println("Error:", err)
    }
}
Преимущества:
- Молниеносный и эффективный для больших объёмов.
- Прост в развёртывании (один бинарный файл).
- Отлично подходит для параллельного краулинга.
Ограничения:
- Сообщество меньше, чем у Python или Node.js.
- Меньше высокоуровневых библиотек для скрейпинга.
- Для сайтов с тяжёлым JavaScript нужна дополнительная настройка (Chromedp или Selenium).
Лучший сценарий:
Когда нужно скрейпить на масштабе или Python просто недостаточно быстрый. Go vs Python для скрейпинга: сравнение производительности.
Сравнение лучших языков программирования для веб-скрейпинга
Сведём всё вместе. Ниже — сравнение, которое поможет выбрать лучший язык для веб-скрейпинга в 2026 году:
| Язык/инструмент | Простота использования | Производительность | Поддержка библиотек | Работа с динамическим контентом | Лучший сценарий |
|---|---|---|---|---|---|
| Python | Очень высокая | Средняя | Отличная | Хорошая (Selenium/Playwright) | Универсальные задачи, новичкам, анализ данных |
| JavaScript/Node.js | Средняя | Высокая | Сильная | Отличная (нативно) | Динамические сайты, асинхронный скрейпинг, веб-разработчики |
| Ruby | Высокая | Средняя | Достаточная | Ограниченная (Watir) | Быстрые скрипты, прототипирование |
| PHP | Средняя | Средняя | Умеренная | Ограниченная (Panther) | Серверная сторона, интеграция с веб-приложениями |
| C++ | Низкая | Очень высокая | Ограниченная | Очень ограниченная | Критично к производительности, огромный масштаб |
| Java | Средняя | Высокая | Хорошая | Хорошая (Selenium/HtmlUnit) | Enterprise, долгоживущие сервисы |
| Go (Golang) | Средняя | Очень высокая | Растущая | Средняя (Chromedp) | Высокоскоростной параллельный скрейпинг |
Когда лучше не писать код: Thunderbit как no-code решение для веб-скрейпинга
Попробуй агентный веб-скрейпер Thunderbit No-code веб-скрейпинг на базе ИИ для бизнес-пользователей, маркетологов и sales-команд. Get Started Free
Ладно, давай честно: иногда тебе нужны просто данные — без кода, без отладки и без мучений из серии «почему этот селектор опять не работает». Вот тут и приходит на помощь Thunderbit.
Как сооснователь Thunderbit, я хотел создать инструмент, который делает веб-скрейпинг таким же простым, как заказ еды на доставку. Вот чем Thunderbit отличается:
- Настройка в один клик: Просто нажми «One Click Extract». Никакой возни с HTTP-запросами, прокси или антибот-защитой.
- Умные шаблоны: Один шаблон скрейпера может подстраиваться под разные макеты страниц. Не нужно переписывать скрейпер каждый раз, когда сайт меняет структуру.
- Скрейпинг в браузере и в облаке: Выбирай между запуском в браузере (удобно для сайтов с авторизацией) или в облаке (очень быстро для открытых данных).
- Работает с динамическим контентом: ИИ Thunderbit управляет настоящим браузером, поэтому справляется с бесконечной прокруткой, всплывающими окнами, логинами и многим другим.
- Экспорт куда угодно: Скачивай в Excel, Google Sheets, Airtable, Notion или просто копируй в буфер обмена.
- Без обслуживания: Если сайт изменился, просто заново запусти AI suggestion. Больше никаких ночных сессий отладки.
- Планирование и автоматизация: Настрой запуск скрейперов по расписанию — без cron-задач и настройки серверов.
- Специализированные извлекатели: Нужны email, телефоны или изображения? В Thunderbit есть и такие инструменты в один клик.
И самое приятное? Тебе не нужно знать ни строчки кода. Thunderbit создан для бизнес-пользователей, маркетологов, sales-команд, специалистов по недвижимости — для всех, кому нужны данные быстро.
Хотите увидеть Thunderbit в деле? Скачайте расширение Chrome или загляните на наш YouTube-канал с демонстрациями.
Попробуй агентный веб-скрейпер Thunderbit бесплатно Вообще не выбирай язык: агентный веб-скрейпер Thunderbit читает любую страницу и извлекает данные в один клик, без кода. Get Started Free
Итог: как выбрать лучший язык для веб-скрейпинга в 2026 году
Посмотри, как agentic web scraping сравнивается с кодом ИИ Thunderbit сам читает страницу и выбирает поля, выполняя в один клик то, на что у скрипта ушли бы часы разработки. Get Started Free
Веб-скрейпинг в 2026 году стал доступнее — и мощнее — чем когда-либо. Вот чему я научился за годы в автоматизации:
- Python по-прежнему лучший язык для веб-скрейпинга, если ты хочешь быстро стартовать и иметь под рукой массу ресурсов.
- JavaScript/Node.js незаменим для скрейпинга динамических сайтов с большим количеством JavaScript.
- Ruby и PHP отлично подходят для быстрых скриптов и интеграции с вебом, особенно если ты уже ими пользуешься.
- C++ и Go — твои союзники, когда важны скорость и масштаб.
- Java — выбор по умолчанию для enterprise-проектов и долгосрочных систем.
- А если ты хочешь вообще не писать код? Thunderbit — твоё секретное оружие.
Перед тем как начинать, спроси себя:
- Насколько велик мой проект?
- Нужно ли обрабатывать динамический контент?
- Какой у меня технический уровень?
- Я хочу строить решение или просто получить данные?
Попробуй один из примеров кода выше или дай шанс Thunderbit в следующем проекте. А если хочешь углубиться, загляни в наш блог Thunderbit — там есть ещё больше гайдов, советов и реальных историй про скрейпинг.
Удачного скрейпинга — и пусть твои данные всегда будут чистыми, структурированными и доступными в один клик.
P.S. Если однажды в 2 часа ночи ты застрянешь в кроличьей норе веб-скрейпинга, просто помни: Thunderbit всегда рядом. Или кофе. Или и то и другое.
Попробуй агентный веб-скрейпер Thunderbit прямо сейчас Get Started Free
Часто задаваемые вопросы
1. Какой язык программирования лучше всего подходит для веб-скрейпинга в 2026 году?
Python остаётся главным выбором благодаря читаемому синтаксису, мощным библиотекам (таким как BeautifulSoup, Scrapy и Selenium) и большому сообществу. Он отлично подходит и новичкам, и профессионалам, особенно если ты совмещаешь скрейпинг с анализом данных.
2. Какой язык лучше всего подходит для скрейпинга сайтов с тяжёлым JavaScript?
JavaScript (Node.js) — лучший выбор для динамических сайтов. Такие инструменты, как Puppeteer и Playwright, дают полный контроль над браузером и позволяют работать с контентом, загружаемым через React, Vue или Angular.
3. Есть ли no-code вариант для веб-скрейпинга?
Да — Thunderbit — это no-code агентный веб-скрейпер, который берёт на себя всё: от динамического контента до расписания запусков. Просто нажми «One Click Extract» и начни сбор данных. Это идеальное решение для sales-, marketing- и ops-команд, которым нужны структурированные данные быстро.
4. Нужно ли вообще выбирать язык, если AI-агент для кодинга может написать скрейпер за меня?
В 2026 году это вполне справедливый вопрос. Инструменты вроде Claude Code, Cursor и OpenAI Codex без проблем сгенерируют Scrapy-спайдер, Playwright-скрипт или краулер на Go + Colly по одному абзацу запроса — так что барьер «какой язык учить первым» действительно стал ниже, чем два года назад. Но агент всё равно выдаёт код на каком-то языке, а тебе — или тому, кто унаследует проект — придётся его читать, отлаживать и разворачивать. Так что выбор всё ещё важен; просто теперь он больше влияет на сопровождение, чем на первые 30 строк. Если ты вообще не хочешь трогать код, здесь и помогает Thunderbit — он полностью снимает вопрос выбора языка.
Подробнее:




