
Битые ссылки. Сиротские страницы. Страница с пометкой «test» из 2019 года, которую Google каким-то образом проиндексировал. Если вы управляете сайтом, вы знаете, как это больно.
Хороший website crawler находит всё это — и строит карту всего сайта, чтобы вы реально могли исправить проблемы. Но многие путают «web crawler» и «web scraper». Это не одно и то же.
Я протестировал 10 бесплатных краулеров на реальных сайтах. Какие-то отлично подходят для SEO-аудита, другие — лучше для извлечения данных. Вот что сработало, а что нет.
Что такое веб-краулер? Разбираем основы
Сначала давайте внесём ясность: website crawler — это не то же самое, что web scraper. Да, эти термины часто кидают направо и налево, но по сути они совсем разные. Представьте краулер как картографа вашего сайта: он обходит все уголки, переходит по ссылкам и строит карту всех страниц. Его задача — поиск и обход: находить URL, показывать структуру сайта и индексировать контент. Именно так работают поисковые системы вроде Google, и именно для этого SEO-инструменты проверяют здоровье сайта (Thunderbit Blog: What Is a Web Crawler?).
Web scraper, наоборот, — это добытчик данных. Ему не нужна вся карта — ему нужно только выкопать золото: цены на товары, названия компаний, отзывы, email-адреса и всё остальное. Скрейперы извлекают конкретные поля со страниц, которые находят краулеры (Thunderbit Blog: How to Web Crawl a Site?).
Аналогия:
- Краулер: человек, который проходит по всем рядам супермаркета и составляет список всех товаров.
- Скрейпер: человек, который сразу идёт к полке с кофе и выписывает цены на каждый органический бленд.
Почему это важно? Потому что если вам нужно просто найти все страницы на сайте (например, для SEO-аудита), вам нужен краулер. Если же вы хотите собрать все цены на товары с сайта конкурента, вам нужен скрейпер — или, в идеале, инструмент, который умеет и то и другое.
Зачем использовать онлайн-краулер? Ключевые бизнес-преимущества
Так зачем вообще нужен веб-краулер? Потому что интернет не становится меньше. Более того, свыше 54% корпоративных брендов используют специализированные платформы для обхода сайтов для оптимизации своих сайтов, а некоторые SEO-инструменты ежедневно обходят 7 миллиардов страниц.
Вот что краулеры могут для вас сделать:
- SEO-аудит: находят битые ссылки, отсутствующие заголовки, дубли контента, сиротские страницы и многое другое (SEO.ai).
- Проверка ссылок и QA: ловят 404-ошибки и циклы редиректов раньше, чем их увидят пользователи (Screaming Frog).
- Генерация sitemap: автоматически создают XML-карты сайта для поисковых систем и планирования (PowerMapper).
- Контент-инвентаризация: формируют список всех страниц, их иерархии и метаданных.
- Соответствие нормам и доступность: проверяют каждую страницу на WCAG, SEO и юридическое соответствие (SiteOne Crawler).
- Производительность и безопасность: отмечают медленные страницы, слишком тяжёлые изображения и уязвимости (SiteOne Crawler).
- Данные для ИИ и аналитики: передают собранные данные в аналитику или AI-инструменты (Thunderbit Blog: Crawl4AI Review).
Вот краткая таблица, где сценарии использования сопоставлены с бизнес-ролями:
| Сценарий использования | Кому подходит | Польза / результат |
|---|---|---|
| SEO и аудит сайта | Маркетологи, SEO-специалисты, владельцы малого бизнеса | Найти технические проблемы, улучшить структуру, поднять позиции |
| Инвентаризация контента и QA | Контент-менеджеры, веб-мастера | Проверить или мигрировать контент, найти битые ссылки и изображения |
| Лидогенерация (скрейпинг) | Продажи, развитие бизнеса | Автоматизировать поиск клиентов, наполнять CRM свежими лидами |
| Анализ конкурентов | E-commerce, product-менеджеры | Отслеживать цены конкурентов, новые товары и изменения наличия |
| Клонирование sitemap и структуры | Разработчики, DevOps, консультанты | Воспроизвести структуру сайта для редизайна или бэкапа |
| Агрегация контента | Исследователи, медиа, аналитики | Собрать данные с разных сайтов для анализа и отслеживания трендов |
| Исследование рынка | Аналитики, команды по обучению AI | Собирать большие наборы данных для анализа или обучения моделей ИИ |
(Thunderbit Blog: How to Web Crawl a Site?)
Как мы выбирали лучшие бесплатные инструменты для краулинга сайтов
Я провёл немало поздних вечеров (и выпил куда больше кофе, чем хотелось бы признавать), разбираясь в инструментах для краулинга, читая документацию и запуская тестовые обходы. Вот на что я смотрел:
- Технические возможности: справляется ли инструмент с современными сайтами (JavaScript, логины, динамический контент)?
- Удобство использования: подойдёт ли он нетехническим пользователям, или без командной строки не обойтись?
- Ограничения бесплатного плана: он действительно бесплатный или это просто демо-версия?
- Онлайн-доступность: это облачный сервис, десктопное приложение или кодовая библиотека?
- Уникальные функции: есть ли что-то особенное — например, AI-извлечение, визуальные sitemap или событийный обход?
Я протестировал каждый инструмент, изучил отзывы пользователей и сравнил функции бок о бок. Если от инструмента мне хотелось выбросить ноутбук в окно, в список он не попадал.
Краткая таблица сравнения: 10 лучших бесплатных веб-краулеров
| Инструмент и тип | Основные функции | Лучший сценарий | Технические требования | Условия бесплатного плана |
|---|---|---|---|---|
| Bright Data (Cloud/API) | Корпоративный краулинг, прокси, рендеринг JS, обход CAPTCHA | Сбор данных в большом масштабе | Полезны базовые технавыки | Бесплатный уровень: 5 000 записей в месяц в Web Scraper API, карта не нужна |
| Crawlbase (Cloud/API) | API-краулинг, антибот, прокси, рендеринг JS | Разработчики, которым нужна backend-инфраструктура для обхода | Интеграция через API | Бесплатно: до 20 000 запросов для старта, карта не нужна; далее оплата за запрос |
| ScraperAPI (Cloud/API) | Ротация прокси, рендеринг JS, асинхронный краулинг, готовые endpoints | Разработчики, мониторинг цен, SEO-данные | Минимальная настройка | Бесплатно: 5 000 API-запросов на 7 дней, затем 1 000/месяц |
| Diffbot Crawlbot (Cloud) | AI-краулинг и извлечение, knowledge graph, рендеринг JS | Структурированные данные в масштабе, AI/ML | Интеграция через API | Бесплатно: 10 000 кредитов в месяц для extraction API; для Crawl нужен план Plus |
| Screaming Frog (Desktop) | SEO-аудит, анализ ссылок и метаданных, sitemap, кастомное извлечение | SEO-аудит, управление сайтом | Десктопное приложение, GUI | Бесплатно: 500 URL на один обход, только базовые функции |
| SiteOne Crawler (Desktop) | SEO, производительность, доступность, безопасность, офлайн-экспорт, Markdown | Разработчики, QA, миграция, документация | Desktop/CLI, GUI | Бесплатно и с открытым кодом, 1 000 URL в отчёте GUI (настраивается) |
| Crawljax (Java, OpenSrc) | Событийный обход JS-ориентированных сайтов, статический экспорт | Разработчики, QA для динамических веб-приложений | Java, CLI/конфиг | Бесплатно и с открытым кодом, без лимитов |
| Apache Nutch (Java, OpenSrc) | Распределённый обход, плагинная архитектура, интеграция с Hadoop, собственный поиск | Поисковые системы на заказ, крупномасштабный краулинг | Java, командная строка | Бесплатно и с открытым кодом, оплачивается только инфраструктура |
| YaCy (Java, OpenSrc) | P2P-краулинг и поиск, приватность, индексация веба и интранета | Приватный поиск, децентрализация | Java, браузерный интерфейс | Бесплатно и с открытым кодом, без лимитов |
| PowerMapper (Desktop/SaaS) | Визуальные sitemap, доступность, QA, совместимость с браузерами | Агентства, QA, визуальное картирование | GUI, просто в использовании | Бесплатная пробная версия: 30 дней, 100 страниц (desktop) или 10 страниц (online) за один скан |
Небольшая оговорка, прежде чем вы продолжите: слово «бесплатно» в последнем столбце означает совершенно разные вещи. SiteOne, Crawljax, Nutch и YaCy — open source, то есть бесплатно без жёсткого лимита, кроме возможностей вашего железа. Screaming Frog бесплатен навсегда, но ограничен 500 URL за один обход. Bright Data, ScraperAPI и Diffbot предлагают реальные, но небольшие free tier-планы, и в случае Diffbot именно краулер как раз не входит в бесплатный уровень. Crawlbase даёт один стартовый пакет бесплатных запросов, а потом берёт оплату за каждый запрос. PowerMapper — единственный чисто trial-вариант в списке: когда 30 дней заканчиваются, нужно платить.
Bright Data: облачный веб-краулер корпоративного уровня
Bright Data — это тяжёлая артиллерия в мире web crawling. Это облачная платформа с огромной прокси-сетью, рендерингом JavaScript, обходом CAPTCHA и IDE для кастомных обходов. Если вы собираете данные в больших объёмах — например, отслеживаете цены на сотнях e-commerce-сайтов, — с инфраструктурой Bright Data трудно конкурировать (aimultiple.com).
Сильные стороны:
- Уверенно работает со сложными сайтами с антибот-защитой
- Масштабируется под задачи enterprise-уровня
- Есть готовые шаблоны для популярных сайтов
Ограничения:
- Бесплатный уровень есть, но он небольшой: 5 000 записей в месяц в Web Scraper API
- Для простого аудита может быть избыточным
- Нужен определённый порог входа для нетехнических пользователей
Если вам нужно обходить веб в больших масштабах, Bright Data — это как арендовать болид Формулы-1. Бесплатные 5 000 записей в месяц позволят просто прокатиться вокруг квартала; дальше начинается тарификация (Bright Data Pricing).
Crawlbase: бесплатный API-краулер для разработчиков
Crawlbase (ранее ProxyCrawl) — это про программный краулинг. Вы отправляете URL в их API, а в ответ получаете HTML — при этом прокси, геотаргетинг и CAPTCHA обрабатываются на их стороне (Capterra).
Сильные стороны:
- Высокий процент успешных запросов (99%+)
- Умеет работать с JavaScript-страницами
- Отлично встраивается в ваши приложения и workflow
Ограничения:
- Нужна хотя бы базовая интеграция через API или SDK
- Бесплатный план: до 20 000 запросов для старта (без карты), затем оплата за запрос
Если вы разработчик и хотите масштабно краулить сайты (а, возможно, и скрейпить их), не возясь с прокси, Crawlbase — очень хороший вариант (Crawlbase Pricing).
ScraperAPI: упрощённый краулинг динамических сайтов
ScraperAPI — это API в стиле «просто достань мне страницу». Вы даёте URL, а оно само разбирается с прокси, headless-браузерами и антибот-защитой и возвращает HTML (или структурированные данные для некоторых сайтов). Особенно хорошо подходит для динамических страниц, хотя бесплатная часть довольно скромная: 5 000 API-кредитов на первые 7 дней без карты, а затем 1 000 кредитов в месяц на постоянном бесплатном плане (ScraperAPI Pricing).
Сильные стороны:
- Очень просто для разработчиков: один API-вызов
- Умеет обходить CAPTCHA, IP-баны и JavaScript
- Бесплатно: 5 000 API-вызовов на 7 дней, затем 1 000 в месяц
Ограничения:
- Нет визуальных отчётов по краулингу
- Если нужно переходить по ссылкам, логику обхода придётся писать самому
Если вы хотите за пару минут встроить краулинг в свой код, ScraperAPI — очевидный выбор.
Diffbot Crawlbot: автоматическое обнаружение структуры сайта
Diffbot Crawlbot — это уже следующий уровень интеллекта. Он не просто обходит страницы, а использует ИИ, чтобы классифицировать их и извлекать структурированные данные (статьи, товары, события и т. д.) в JSON. Это как стажёр-робот, который действительно понимает, что читает (Diffbot Free Plan).
Сильные стороны:
- Извлекает данные с помощью ИИ, а не просто краулит
- Умеет работать с JavaScript и динамическим контентом
- Бесплатно: 10 000 кредитов в месяц, без карты, включая Extract, Natural Language, Knowledge Graph и Search
Ограничения:
- Ориентирован на разработчиков (интеграция через API)
- Это не визуальный SEO-инструмент, а скорее решение для data-проектов
- Сам Crawlbot — часть, которая сканирует весь сайт, — доступен только в плане Plus и выше; бесплатные кредиты покрывают extraction API (Diffbot Pricing)
Если вам нужны структурированные данные в масштабе, особенно для AI или аналитики, Diffbot — настоящий монстр.
Screaming Frog: бесплатный десктопный SEO-краулер
Screaming Frog — классика среди десктопных краулеров для SEO-аудита. Бесплатная версия сканирует до 500 URL за один запуск и показывает всё: битые ссылки, метатеги, дубли контента, sitemap и многое другое (Screaming Frog User Guide).
Сильные стороны:
- Быстрый, подробный и заслуживший доверие в SEO-сообществе
- Код не нужен — просто введите URL и запускайте
- Бесплатно до 500 URL за один обход
Ограничения:
- Только десктоп (облачной версии нет)
- Продвинутые функции (рендеринг JS, планирование) требуют платной лицензии
Если вы серьёзно занимаетесь SEO, Screaming Frog — must-have. Только не рассчитывайте бесплатно проползти через сайт на 10 000 страниц.
SiteOne Crawler: экспорт и документация статических сайтов
SiteOne Crawler — это швейцарский нож для технических аудитов. Он open-source, кроссплатформенный и умеет не только краулить и проверять сайт, но и экспортировать его в Markdown для документации или офлайн-использования (SiteOne Crawler).
Сильные стороны:
- Покрывает SEO, производительность, доступность и безопасность
- Экспортирует сайты для архивирования или миграции
- Бесплатный и с открытым кодом, без ограничений по использованию
Ограничения:
- Более технический, чем некоторые GUI-инструменты
- Отчёт в GUI по умолчанию ограничен 1 000 URL (но это можно настроить)
Если вы разработчик, QA-специалист или консультант и любите open source, SiteOne — очень недооценённая находка.
Crawljax: open-source Java-краулер для динамических страниц
Crawljax — это специализированный инструмент: он создан для обхода современных веб-приложений с JavaScript, имитируя действия пользователя (клики, заполнение форм и т. д.). Он событийно-ориентированный и даже может вывести статическую версию динамического сайта (Wikipedia: Crawljax).
Сильные стороны:
- Отлично подходит для SPA и сайтов с большим количеством AJAX
- Open-source и расширяемый
- Без ограничений по использованию
Ограничения:
- Требуется Java и немного программирования/настройки
- Не для нетехнических пользователей
Если вам нужно обходить React- или Angular-приложение так, как это делает реальный пользователь, Crawljax — ваш вариант.
Apache Nutch: масштабируемый распределённый краулер сайтов
Apache Nutch — это дедушка среди open-source-краулеров. Он рассчитан на огромные распределённые обходы: например, если вы строите собственную поисковую систему или индексируете миллионы страниц (Martechvibe).
Сильные стороны:
- Масштабируется до миллиардов страниц с Hadoop
- Очень гибкий и расширяемый
- Бесплатный и с открытым исходным кодом
Ограничения:
- Высокий порог входа (Java, командная строка, конфиги)
- Не подходит для небольших сайтов и случайных пользователей
Если вам нужно краулить веб в больших масштабах и вы не боитесь командной строки, Nutch — это ваш инструмент.
YaCy: пиринговый веб-краулер и поисковая система
YaCy — это необычный децентрализованный краулер и поисковик. Каждый экземпляр обходит сайты и создаёт индекс, а затем можно подключиться к peer-to-peer сети и делиться индексами с другими (TechRadar: YaCy).
Сильные стороны:
- Ориентация на приватность, без центрального сервера
- Отлично подходит для создания приватного поиска или поиска по интранету
- Бесплатный и с открытым кодом
Ограничения:
- Результаты зависят от охвата сети
- Нужна базовая настройка (Java, браузерный интерфейс)
Если вам интересна децентрализация или вы хотите свою поисковую систему, YaCy — очень любопытный вариант.
PowerMapper: визуальный генератор sitemap для UX и QA
PowerMapper помогает визуализировать структуру сайта. Он обходит сайт и строит интерактивные sitemap, а также проверяет доступность, совместимость с браузерами и базовые SEO-настройки (Slickplan Review).
Сильные стороны:
- Визуальные sitemap отлично подходят агентствам и дизайнерам
- Проверяет доступность и соответствие требованиям
- Простой GUI, технические навыки не нужны
Ограничения:
- Только пробная версия (30 дней, 100 страниц в desktop или 10 страниц online за скан)
- Полная версия платная
Если вам нужно показать клиенту карту сайта или проверить соответствие требованиям, PowerMapper будет очень кстати.
Как выбрать подходящий бесплатный веб-краулер
Когда вариантов так много, как выбрать? Вот мой быстрый ориентир:
- Для SEO-аудита: Screaming Frog (небольшие сайты), PowerMapper (визуализация), SiteOne (глубокий аудит)
- Для динамических веб-приложений: Crawljax
- Для крупномасштабного или кастомного поиска: Apache Nutch, YaCy
- Для разработчиков, которым нужен API-доступ: Crawlbase, ScraperAPI, Diffbot
- Для документации или архивирования: SiteOne Crawler
- Для enterprise-масштаба с небольшим постоянным бесплатным лимитом: Bright Data, Diffbot
Ключевые факторы, на которые стоит смотреть:
- Масштабируемость: насколько большой у вас сайт или задача обхода?
- Удобство использования: вам комфортнее код или интерфейс «клик-и-готово»?
- Экспорт данных: нужны CSV, JSON или интеграция с другими инструментами?
- Поддержка: есть ли сообщество или документация, если вы застрянете?
Когда web crawling встречается с web scraping: почему Thunderbit — более умный выбор
Извлекайте данные с любого сайта с помощью ИИ Агентный web scraper Thunderbit читает любой сайт, который нужно обойти, и в один клик извлекает структурированные данные — бесплатно для 6 страниц в месяц. Get Started Free
Вот реальность: большинство людей краулят сайты не ради красивых карт. Настоящая цель обычно — получить структурированные данные: список товаров, контактную информацию или инвентарь контента. Именно здесь появляется Thunderbit.
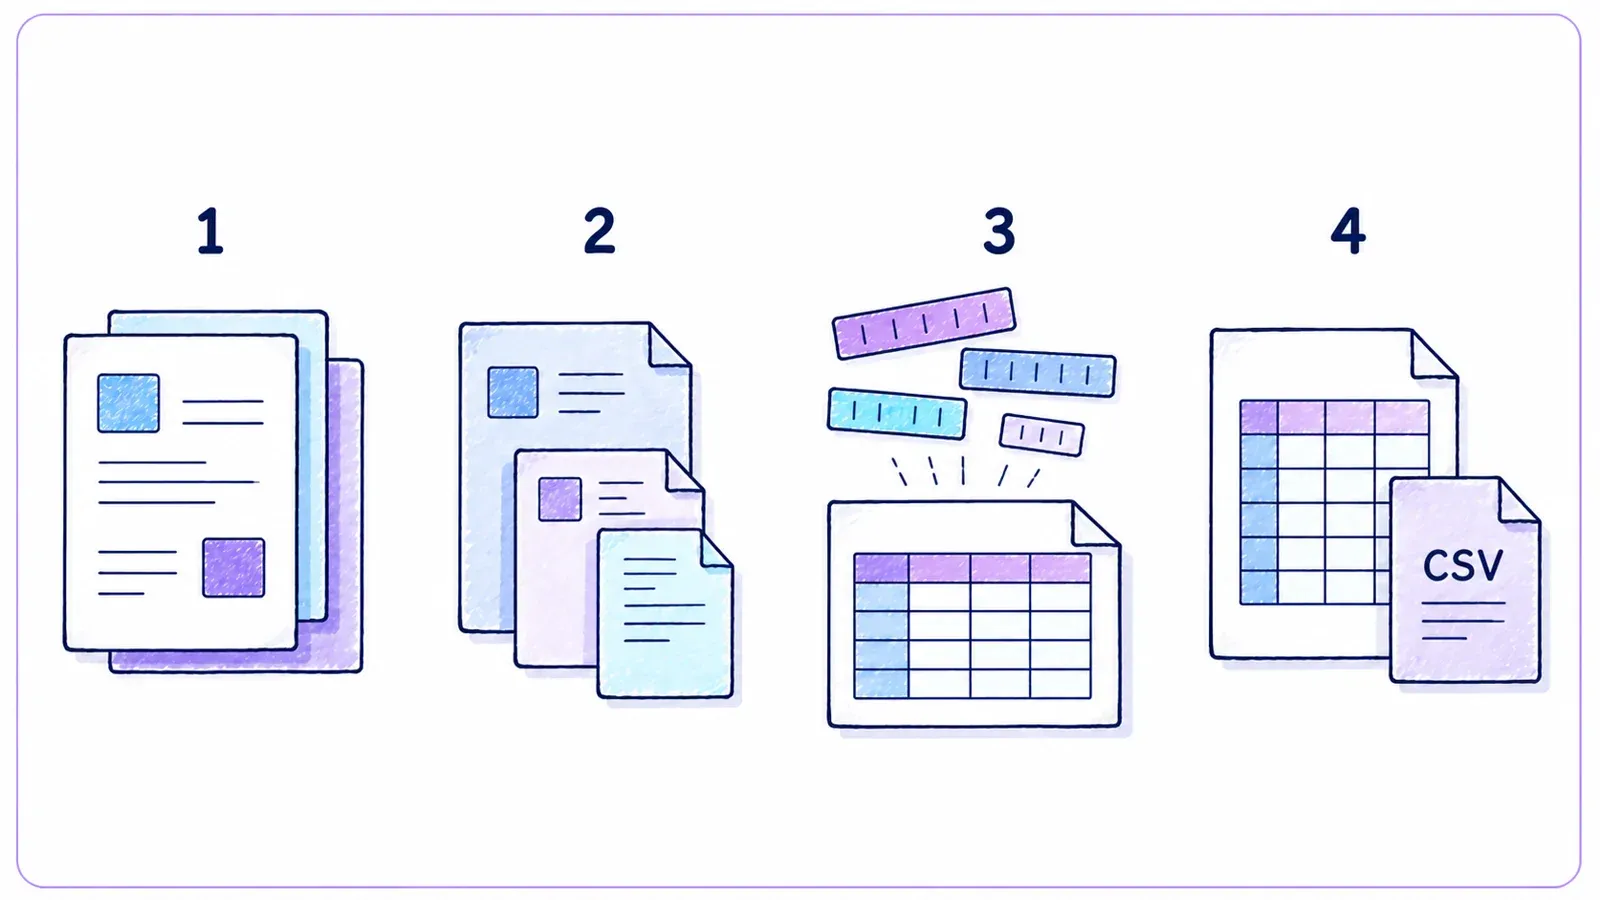
Thunderbit — это не просто краулер и не просто скрейпер, а AI-расширение для Chrome, которое объединяет оба подхода. Вот как это работает:
- AI-краулер: Thunderbit обходит сайт, как обычный краулер.
- Waterfall Crawling: если собственный движок Thunderbit не может получить страницу (например, из-за жёсткой антибот-защиты), он автоматически переключается на сторонние сервисы краулинга — без ручной настройки.
- AI-структурирование данных: как только HTML получен, ИИ Thunderbit предлагает подходящие колонки и извлекает структурированные данные (названия, цены, email и т. д.) без единого селектора с вашей стороны.
- Скрапинг подстраниц: нужно собрать детали со всех страниц товаров? Thunderbit может автоматически заходить на каждую подстраницу и дополнять таблицу.
- Очистка и экспорт данных: он может суммировать, категоризировать, переводить и экспортировать данные в Excel, Google Sheets, Airtable или Notion в один клик.
- Простота без кода: если вы умеете пользоваться браузером, вы умеете пользоваться Thunderbit. Без кода, без прокси, без головной боли.
Когда стоит выбрать Thunderbit вместо классического краулера?
- Когда конечная цель — чистая, удобная таблица, а не просто список URL.
- Когда вы хотите автоматизировать весь процесс: обход, извлечение, очистку и экспорт в одном месте.
- Когда вы цените своё время и нервы.
Вы можете скачать расширение Thunderbit для Chrome здесь и сами увидеть, почему так много бизнес-пользователей переходят на него.
Попробуйте Thunderbit бесплатно — агентный web scraper Установите бесплатное расширение для Chrome и начните обходить любые сайты в один клик — без кода. Get Started Free
Заключение: как выжать максимум из бесплатных web crawler
Посмотрите, как работает агентный web scraping ИИ Thunderbit читает страницу как человек и сам решает, что извлекать, заменяя ручную настройку краулера. Get Started Free
Веб-краулеры сильно эволюционировали. Независимо от того, маркетолог вы, разработчик или просто человек, которому важно поддерживать сайт в порядке, для вас найдётся бесплатный — или хотя бы доступный на пробу — инструмент. От корпоративных платформ вроде Bright Data и Diffbot до open-source-решений вроде SiteOne и Crawljax и визуальных картографов вроде PowerMapper — выбор сейчас как никогда широк.
Но если вы ищете более умный и цельный способ пройти путь от «мне нужны эти данные» до «вот моя таблица», попробуйте Thunderbit. Он создан для бизнес-пользователей, которым нужны результаты, а не просто отчёты.
Готовы начать краулинг? Скачайте инструмент, запустите скан и посмотрите, чего вам не хватало. А если хотите перейти от обхода к полезным данным в один клик, загляните в Thunderbit.
За новыми разборками и практическими гайдами заходите в Thunderbit Blog.
Извлекайте данные с сайта с помощью ИИ в один клик Настройте Thunderbit на переход по подстраницам и запуск по расписанию, чтобы ваши данные всегда оставались актуальными без повторных ручных запусков. Get Started Free
Попробуйте агентный web scraper Get Started Free
FAQ
В чём разница между веб-краулером и веб-скрейпером?
Краулер находит и отображает все страницы сайта — по сути, строит оглавление. Скрейпер извлекает конкретные данные со страниц: цены, email, отзывы. Краулеры находят, скрейперы добывают (Thunderbit Blog: What Is a Web Crawler?).
Какой бесплатный веб-краулер лучше всего подходит для нетехнических пользователей?
Для небольших сайтов и SEO-аудита хорошо подойдёт Screaming Frog. Для визуального картирования — PowerMapper (на время trial). Если ваша цель — структурированные данные и вам нужен no-code-инструмент в браузере, Thunderbit будет самым простым вариантом.
Есть ли сайты, которые блокируют веб-краулеры?
Да — некоторые сайты используют robots.txt или антибот-защиту, например CAPTCHA или IP-блокировки. Инструменты вроде ScraperAPI, Crawlbase и Thunderbit (с waterfall crawling) часто помогают обойти такие барьеры, но всегда краульте ответственно и соблюдайте правила сайта (Bright Data Pricing).
Есть ли у бесплатных веб-краулеров ограничения по страницам или функциям?
У большинства — да. Например, бесплатная версия Screaming Frog ограничена 500 URL за один обход, а trial PowerMapper — 100 страниц. API-инструменты часто имеют месячные лимиты кредитов. Open-source-решения вроде SiteOne или Crawljax обычно не имеют жёстких ограничений, но вы ограничены возможностями своего оборудования.
Законно ли использовать веб-краулер и соответствует ли это требованиям конфиденциальности?
Как правило, обход публичных веб-страниц законен, но всегда проверяйте условия использования сайта и robots.txt. Никогда не обходите закрытые или защищённые паролем данные без разрешения и учитывайте законы о конфиденциальности, если извлекаете персональные данные (Crawlbase Guide).



