
Если ты когда-нибудь смотрел на горы веб-страниц, таблиц или PDF-файлов и думал: «Ну должен же быть способ вытаскивать эти данные проще», — ты не один. Я много лет делаю инструменты автоматизации и постоянно общаюсь с бизнес-командами, которым уже надоел бесконечный копипаст. Правда в том, что к 2026 году объем неструктурированных данных стал просто огромным: 80–90% новых корпоративных данных — это неструктурированные данные, и лишь небольшая часть компаний реально умеет извлекать из них пользу (Docsumo). Ручной сбор данных — это не просто скучно. Это дорого, чревато ошибками и сильно просаживает продуктивность.
Собирайте данные с любого сайта с помощью AI Get Started Free
Именно тут в дело и вступают инструменты для извлечения данных. Неважно, работаешь ты в продажах, операциях, eCommerce или аналитике — правильный инструмент может сэкономить тебе часы, а то и дни, повысить точность и освободить команду для действительно важной работы. Но как выбрать лучший вариант среди десятков решений — AI-расширений для Chrome, no-code платформ и фреймворков для разработчиков? Я подробно разобрал 10 лучших data extractor для 2026 года: их сильные и слабые стороны, а также сценарии применения. Поехали.
Почему бизнесу нужны инструменты для извлечения данных, чтобы работать эффективнее
Будем честны: 94% компаний вязнут в повторяющихся и отнимающих время задачах, вроде ручного ввода данных (ServiceNow). И потери касаются не только времени — ручное получение данных может обходиться в $1,500 на одного сотрудника в месяц (ResolvePay). Инструменты для извлечения данных автоматизируют рутину и позволяют:
- Сэкономить до 77% времени на сбор данных (ServiceNow).
- Повысить операционную эффективность на 40% (PerfectDataEntry).
- Сократить время обработки на 50% и более (Docsumo).
- Достичь точности до 99,9% при извлечении данных из документов (Docsumo).
Итог? Быстрее принимаются решения, данные чище, а команды — спокойнее. Собираешь ли ты лиды, отслеживаешь цены конкурентов или загружаешь данные в BI-системы — хороший extractor работает как цифровой помощник, который никогда не устает и не просит прибавку.
Как выбрать лучший data extractor: ключевые критерии
Не все инструменты для извлечения данных одинаково хороши. Вот на что я смотрю, когда рекомендую решение:
- Простота использования: смогут ли нетехнические пользователи быстро начать работу? Есть ли AI или настройка в формате point-and-click?
- Кастомизация и гибкость: получится ли работать со сложными сайтами, авторизацией или динамическим контентом? Можно ли использовать скрипты для продвинутых задач?
- Поддерживаемые типы данных: извлекает ли инструмент текст, числа, изображения, email, телефоны, PDF и другое?
- Масштабируемость и производительность: способен ли он обработать тысячи страниц? Есть ли облачный режим или многопоточное scraping-решение?
- Интеграции и автоматизация: можно ли напрямую экспортировать данные в Excel, Google Sheets, Airtable, Notion или подключаться через API?
- Цена и ценность: есть ли бесплатный тариф? Насколько доступны платные планы для твоих задач?
- Поддержка и сообщество: есть ли нормальная документация, обучающие материалы и быстрая поддержка?
Для разных команд приоритеты будут разными. Например, sales ops важнее простота и быстрый экспорт, а разработчикам нужна глубокая настройка и доступ к API.
Data extractor для eCommerce и маркетинговых исследований
eCommerce и команды по исследованию рынка живут и умирают на актуальных данных — отслеживание цен, анализ отзывов о товарах, мониторинг конкурентов. Для таких задач нужны инструменты, которые умеют собирать данные в большом объеме, обходить антибот-защиту и запускаться по расписанию.
- Octoparse: известен мощным no-code интерфейсом и сотнями готовых шаблонов для Amazon, eBay и других сайтов. Отлично подходит для мониторинга цен и сбора отзывов.
- Import.io: делает упор на интеграцию веб-данных в BI-инструменты, а также на планирование запусков и отслеживание изменений. Идеален для исследовательских компаний, которым нужен постоянный поток данных.
- Dexi.io: решение enterprise-уровня с автоматизацией рабочих процессов и преобразованием данных. Используется крупными ритейлерами для конкурентной аналитики и отслеживания цен.
Эти инструменты рассчитаны на большие объемы и справляются с антискрапинговыми механизмами, которые часто встречаются на крупных eCommerce-площадках.
Data extractor для технических команд и кастомных workflows
Если у вас в команде есть разработчики или ты сам не боишься кода, подойдут инструменты с максимальной гибкостью:
- Scrapy: золотой стандарт Python-scraping. Open-source, отлично настраивается и подходит для масштабных проектов. Идеален для создания собственных crawlers или встраивания сбора данных в приложение.
- ParseHub: визуальный конструктор workflow, который хорошо работает с динамическими сайтами на JavaScript. Поддерживает условную логику, кастомный JS и доступ к API.
- Apify: облачная платформа для запуска собственных scraping-скриптов (“Actors”) на JavaScript или Python. Отлично подходит для цепочек процессов, автоматизации через headless-браузеры и масштабирования в облаке.
Эти решения я советую, когда нужно собирать сложные сайты, автоматизировать многошаговые процессы или реализовывать сценарии, которые просто невозможны в обычном point-and-click инструменте.
Data extractor для интеграции данных и автоматизации процессов
Некоторым командам нужен не просто сырой массив данных, а полноценный автоматизированный цикл — от извлечения до анализа:
- Import.io: как уже говорилось, отлично подходит для интеграции веб-данных в аналитические и BI-дашборды, с возможностью планирования и доставки через API.
- Dexi.io: создан для сквозной автоматизации, включая очистку, преобразование и интеграцию данных с CRM, базами данных и другими системами.
Если твой рабочий процесс состоит из нескольких этапов или тебе нужно, чтобы данные сразу падали в уже существующие системы, стоит присмотреться именно к этим инструментам.
Сравнительная таблица: 10 лучших data extractor в одном взгляде
Вот короткое сравнение, которое поможет сузить выбор:
| Название инструмента | Простота использования | Лучший сценарий | Цена | Кастомизация | Поддерживаемые типы данных |
|---|---|---|---|---|---|
| Thunderbit | ⭐ Очень просто | Все отрасли, без технавыков | Бесплатно и платно | AI-подсказки с low-code | Текст, числа, даты, URL, email, телефоны, изображения, PDF |
| Octoparse | 🙂 Средний уровень | eCommerce, маркетинговые исследования | Бесплатно и платно | Высокая (визуально, regex) | Текст, числа, URL, изображения |
| ParseHub | 🙂 Средний уровень | Динамические сайты, технические пользователи | Платно | Высокая (JS, логика) | Текст, числа, URL, изображения |
| Import.io | 😀 Просто | Интеграция данных, BI | Платно (Enterprise) | Средняя | Текст, таблицы, списки |
| Scrapy | 😐 Сложно | Кастомная разработка, большие объемы | Бесплатно (open-source) | Очень высокая (код) | Любые (по определению разработчика) |
| Apify | 😐 Сложно | Автоматизация процессов, разработчики | Бесплатно и платно | Очень высокая (код) | Любой веб-контент |
| Dexi.io | 🙂 Средний уровень | Enterprise, workflow | Платно (Enterprise) | Высокая (визуально, скрипты) | Текст, изображения, файлы |
| WebHarvy | 😀 Просто | Малый бизнес, статические сайты | Разовая лицензия | Низкая–средняя | Текст, числа, URL, изображения |
| Data Miner | 😀 Просто | Быстрый web-to-sheet, продажи | Бесплатно и платно | Средняя (recipes) | Текст, таблицы, списки |
| Helium Scraper | 🙂 Средний уровень | Кастомная логика, реляционные данные | Разовая лицензия | Высокая (JS, SQL) | Текст, URL, изображения, файлы |
Двух названий, которые ты мог ожидать увидеть, в этой таблице нет. Visual Web Ripper больше не доступен — Sequentum закрыл лицензионный сервер в 2022 году. Content Grabber был включён в Sequentum Enterprise ещё в 2020 году, а старый продукт больше не продаётся и не поддерживается.
Легенда: 😀 Просто (подходит нетехническим пользователям), 🙂 Средний уровень (нужен небольшой опыт), 😐 Сложно (требуется код)
1. Thunderbit
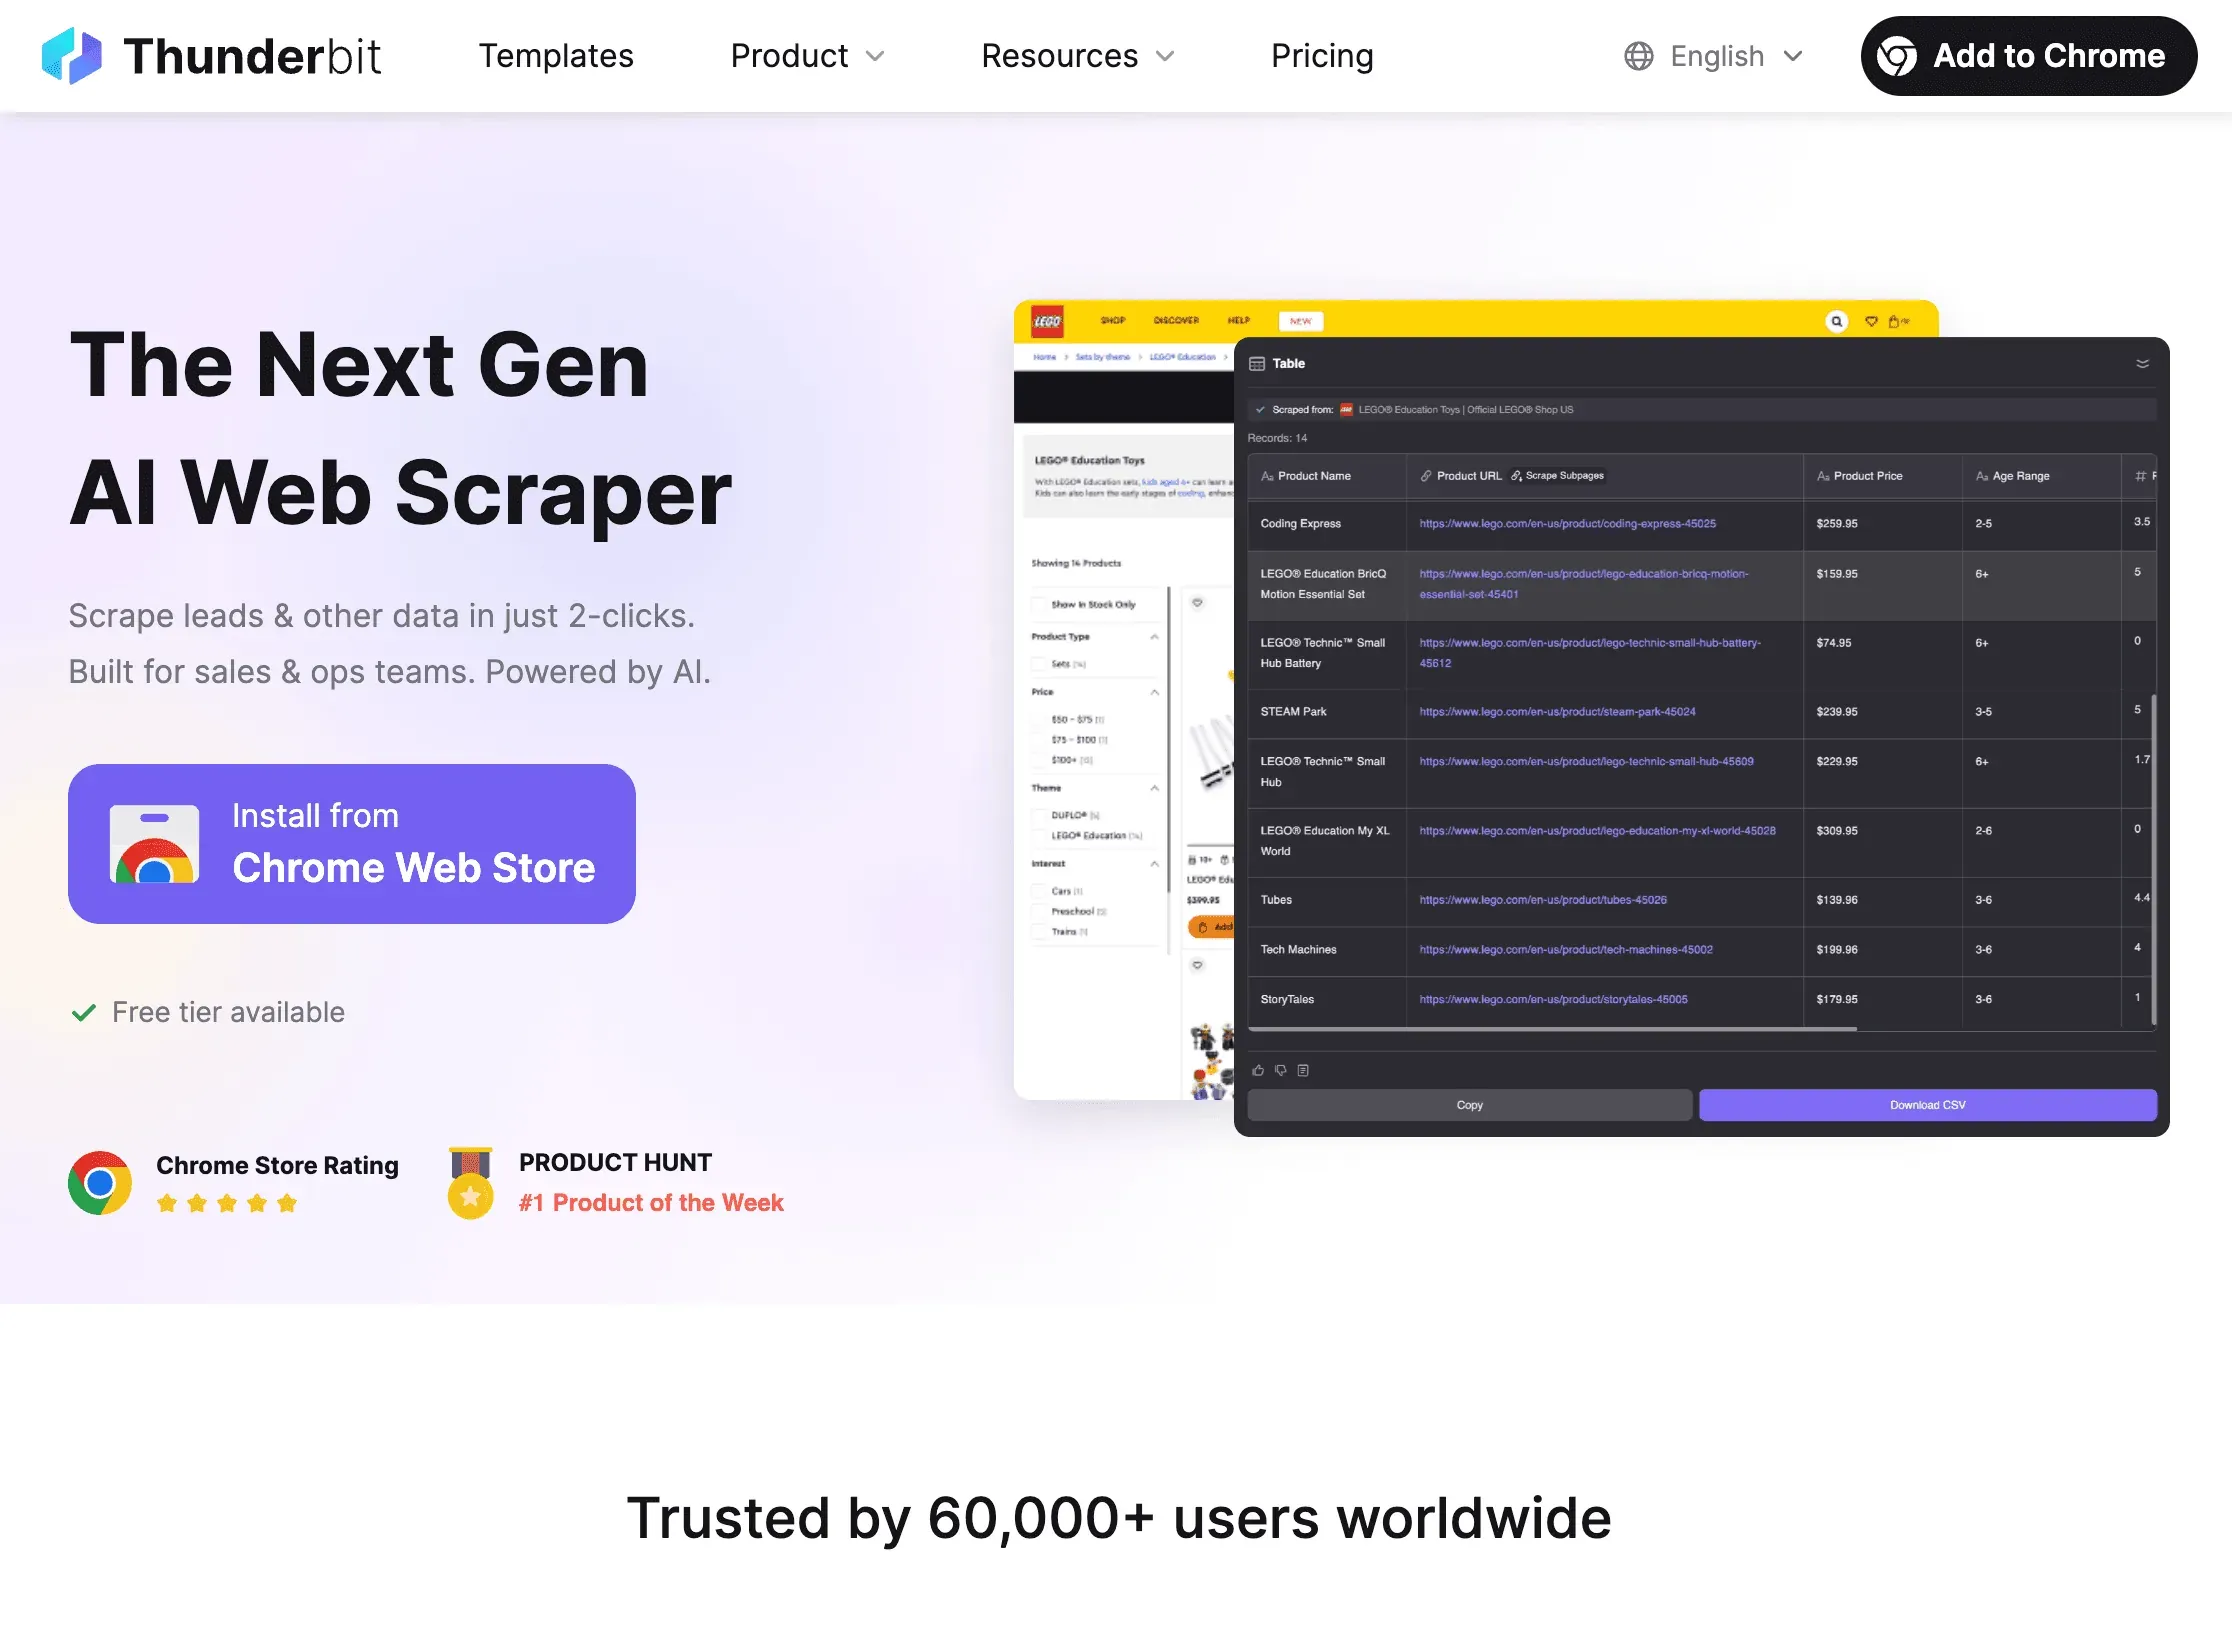 Thunderbit — мой главный выбор для нетехнических пользователей, которым нужна максимальная эффективность без лишней возни. Как AI-расширение для Chrome, оно сделано для бизнес-пользователей — продаж, операционных команд, недвижимости, eCommerce, то есть для тех, кому нужны данные, а не головная боль.
Ключевые возможности:
- AI Suggest Columns: нажми один раз, и AI Thunderbit проанализирует страницу и предложит лучшие поля для извлечения — без ручной настройки.
- Скрапинг в 2 клика: подтверди поля, нажми «Scrape» — и готово. Даже моя мама справится, хотя она до сих пор звонит мне, когда у неё пропадает Wi‑Fi.
- Скрапинг подстраниц: нужны более подробные данные? Thunderbit может автоматически переходить на каждую подстраницу, например карточку товара или профиль, и дополнять таблицу.
- Бесплатный экспорт данных: отправляй результаты прямо в Excel, Google Sheets, Airtable или Notion без доплат.
- Извлечение email, телефонов и изображений в один клик: идеально для лидогенерации и сбора контактов с любого сайта.
- Облачный или браузерный режим: выбирай быстрый cloud scraping для открытых сайтов или браузерный режим для страниц с авторизацией.
- Поддержка 34 языков: международные команды, это для вас.
Плюсы: невероятно прост в использовании, не требует кода, умеет работать с неструктурированными данными и автоматически подстраивается под изменения сайтов. Есть бесплатный тариф для небольших задач и доступные платные планы для более серьезных объемов.
Минусы: менее гибок, чем инструменты для разработчиков, если сайт очень сложный. Для больших объемов используется кредитная модель оплаты.
Лучше всего подходит для: команд продаж, eCommerce-операций, риелторов и всех, кто хочет перейти от «мне нужны эти данные» к «вот моя таблица» меньше чем за пять минут. Попробуйте Thunderbit бесплатно.
Попробовать Thunderbit бесплатно
2. Octoparse
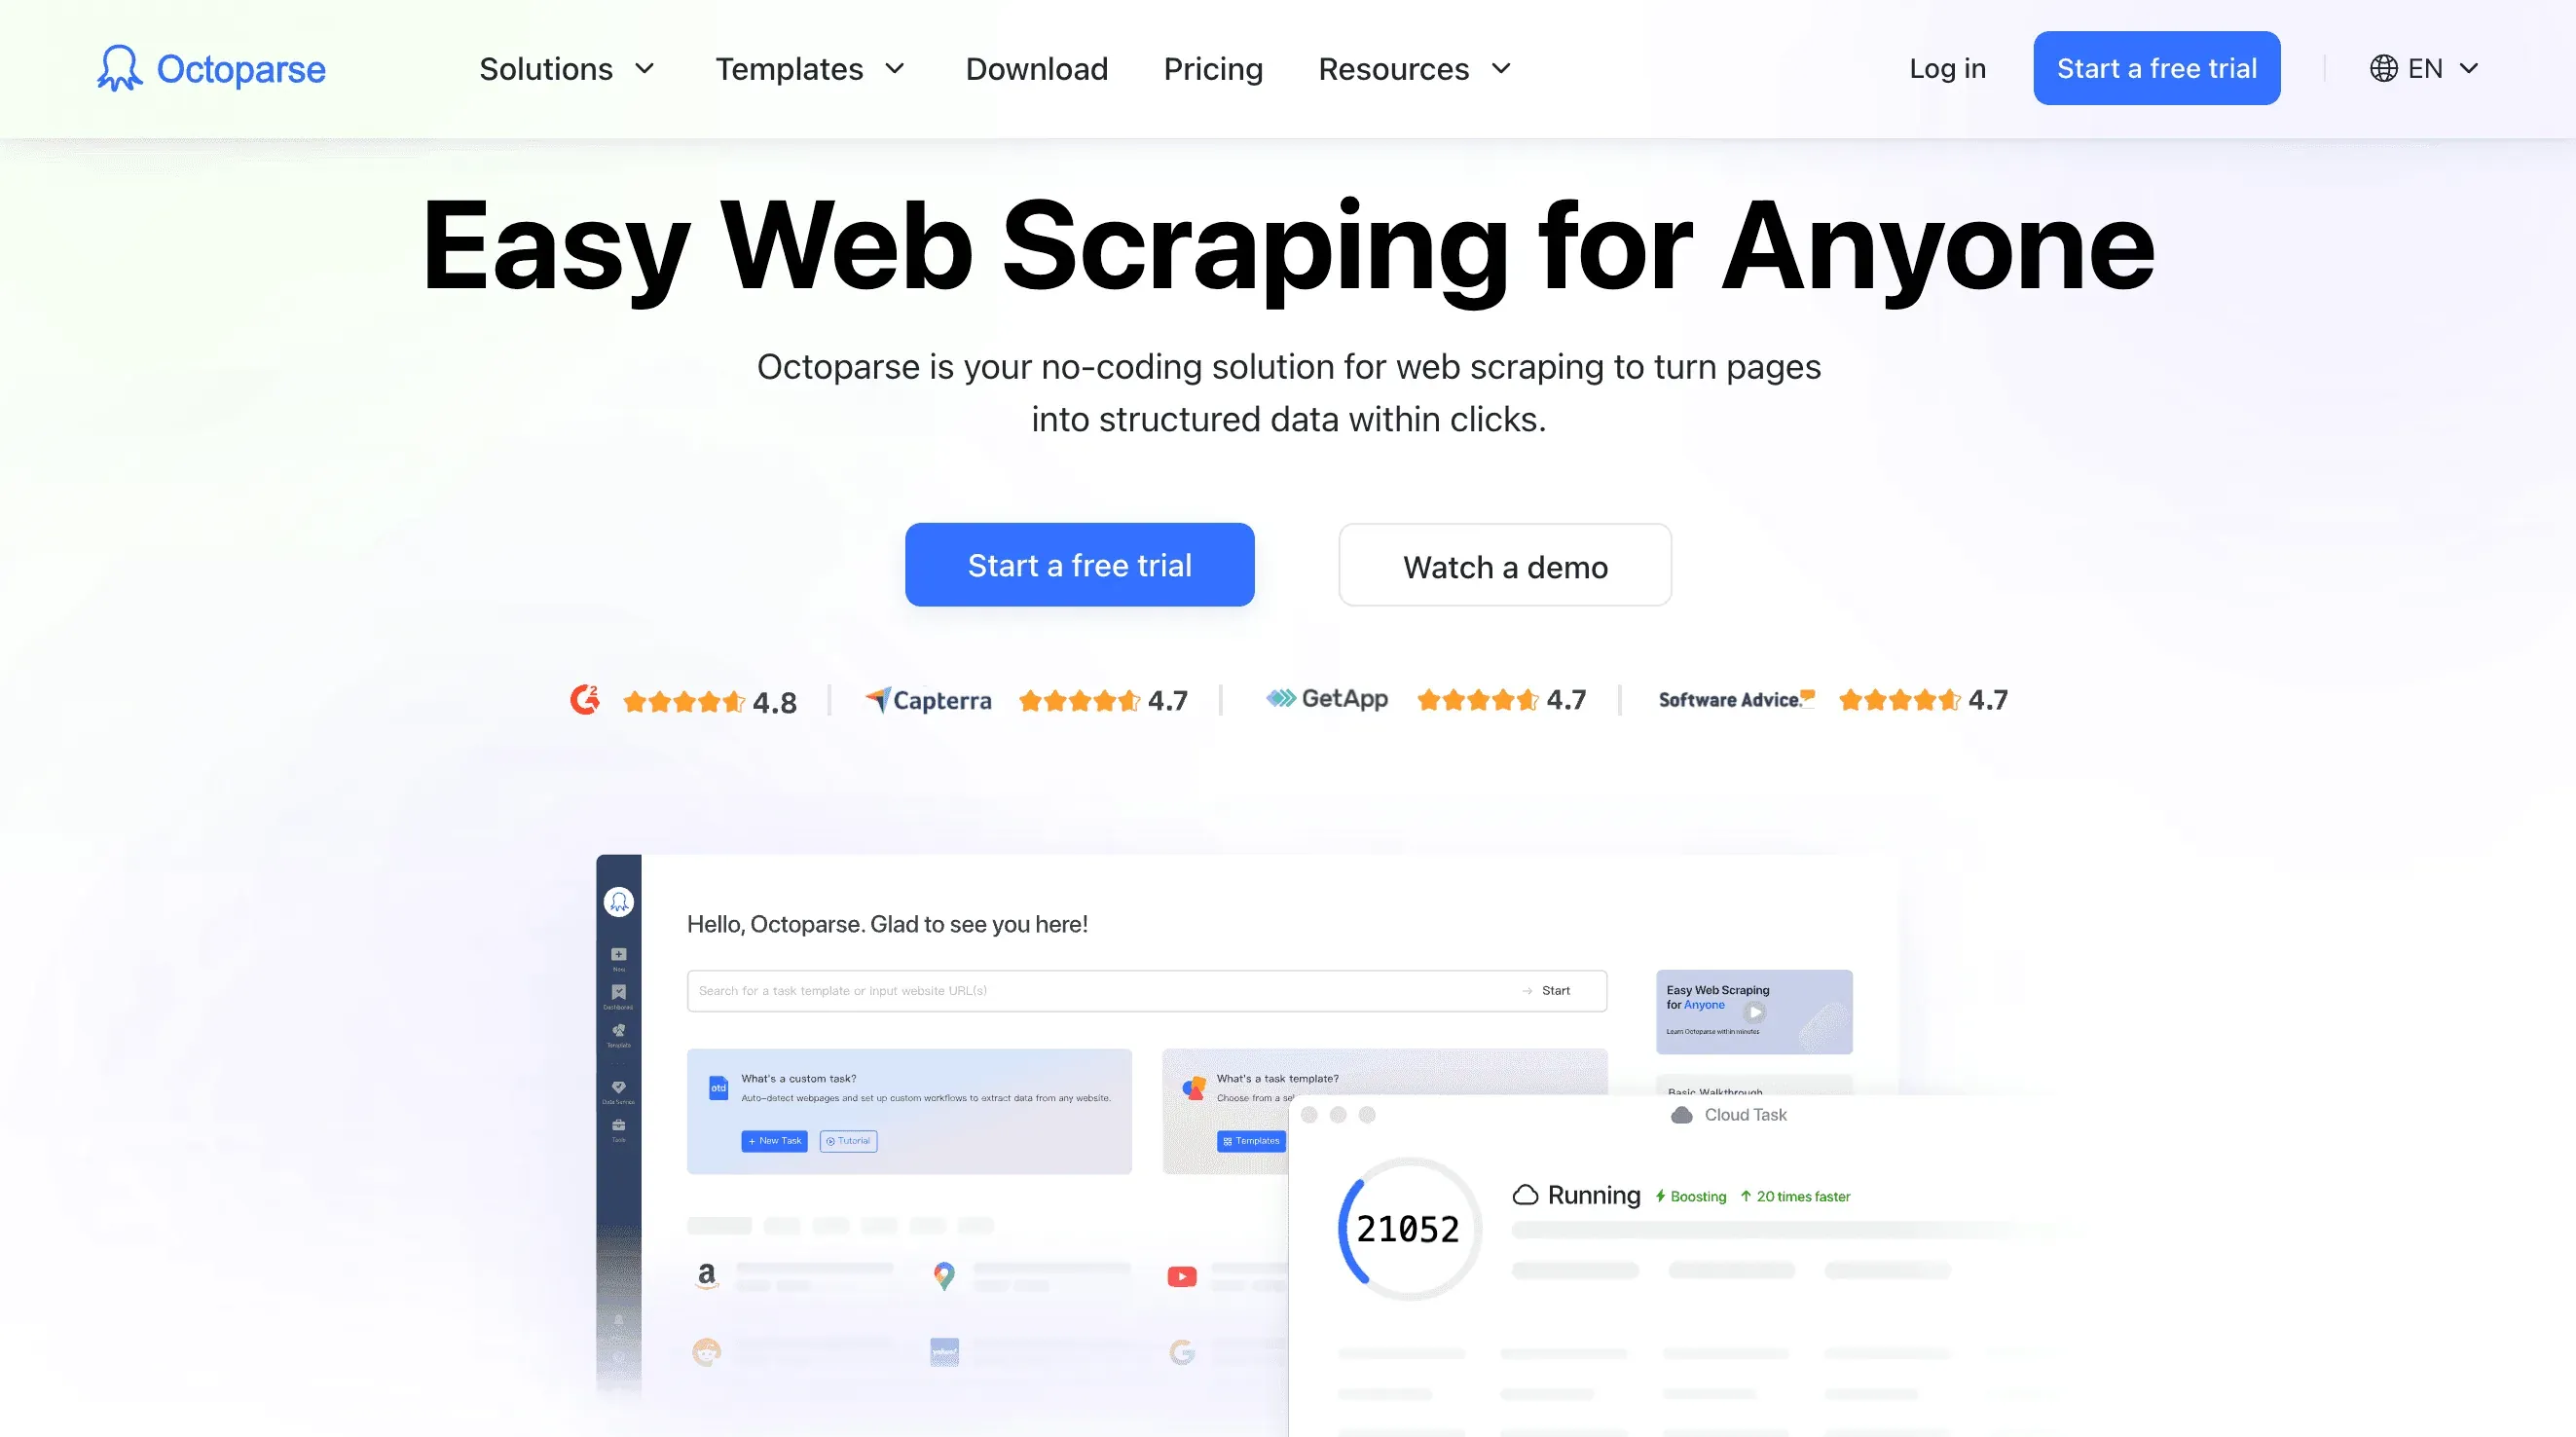 Octoparse — мощное решение для команд eCommerce и маркетинговых исследований. Это no-code desktop-приложение для Windows с визуальным конструктором workflow и сотнями готовых шаблонов для Amazon, eBay, Zillow и других сайтов.
Ключевые возможности:
- Интерфейс point-and-click: создавай задачи скрапинга, просто нажимая на элементы страницы.
- Облачный скрапинг и расписание: платные тарифы позволяют запускать задачи в облаке и планировать регулярный сбор данных.
- Ротация IP и антибот-защита: справляется с сайтами, которые блокируют скраперы, благодаря встроенным прокси и капча-решениям.
- Библиотека шаблонов: более 500 готовых шаблонов для популярных сайтов.
- Многоуровневый и постраничный скрапинг: подходит для сложной навигации и извлечения данных со страниц деталей.
Плюсы: отлично подходит для масштабного мониторинга цен, анализа отзывов и отслеживания eCommerce-площадок. Для большинства задач не нужен код.
Минусы: работает только на desktop, может быть дорогим для активных пользователей, а сложные workflows требуют времени на освоение.
Лучше всего подходит для: аналитиков eCommerce, исследователей рынка и всех, кому нужно отслеживать много товаров или конкурентов.
3. ParseHub
 ParseHub — гибкий визуальный scraper, который особенно хорош для динамических сайтов с большим количеством JavaScript. Это desktop-приложение для Windows, Mac и Linux с конструктором workflow, поддерживающим условную логику, кастомный JS и доступ к API.
Ключевые возможности:
- Работа с динамическим контентом: поддерживает single-page apps, AJAX и интерактивные сайты.
- Workflow и скрипты: строй многошаговые процессы, добавляй свой JS и используй regex для тонкой настройки.
- Облачный и локальный запуск: запускай задачи на своем компьютере или в облаке (платно).
- Доступ к API: интегрируй сбор данных в собственные приложения или автоматизируй через webhooks.
Плюсы: высокая гибкость для тех, кто понимает технологии, хорошо справляется со сложными сайтами и поддерживает логику.
Минусы: медленнее на больших объемах, есть умеренный порог входа, а облачный запуск оплачивается отдельно.
Лучше всего подходит для: технических аналитиков, разработчиков и всех, кому нужно собирать данные с интерактивных сайтов.
4. Import.io
 Import.io создан прежде всего для интеграции веб-данных в бизнес-аналитику. Это веб-платформа с интерфейсом point-and-click, а также мощными возможностями планирования и API.
Ключевые возможности:
- Автоопределение таблиц: вставь URL, и Import.io попробует автоматически извлечь структурированные данные.
- Планирование и отслеживание изменений: настрой регулярный запуск задач и получай уведомления при изменениях данных.
- Интеграция через API: получай данные программно или передавай их в BI-инструменты.
- Преобразование данных: очищай и форматируй данные внутри платформы.
Плюсы: удобен в использовании, отлично подходит бизнес-аналитикам и хорошо интегрируется с аналитическими инструментами.
Минусы: enterprise-ценообразование, ограниченные возможности для очень интерактивных сайтов и меньше контроля для продвинутых пользователей.
Лучше всего подходит для: команд маркетинговых исследований, бизнес-аналитиков и операционных команд, которым нужен постоянный поток данных.
5. Scrapy
 Scrapy — это open-source Python-фреймворк, который любят разработчики. Если тебе нужен полный контроль, масштабируемость и возможность строить собственные crawlers, Scrapy — твой лучший союзник.
Ключевые возможности:
- Асинхронный crawling: быстро, эффективно и подходит для крупных проектов.
- Полный контроль через код: пиши spiders на Python, настраивай каждый шаг и интегрируй с любой системой.
- Middleware и плагины: ротация прокси, обработка логинов и расширение через плагины сообщества.
- Структурированный вывод: экспорт в JSON, CSV, базы данных или собственные форматы.
Плюсы: бесплатно, очень гибко и поддерживается огромным сообществом.
Минусы: нужны навыки Python, нет GUI, а обслуживание полностью на тебе.
Лучше всего подходит для: разработчиков, data engineers и всех, кто встраивает scraping в собственные приложения или data pipeline.
6. Apify
 Apify — облачная платформа для запуска и обмена scraping-скриптами (“Actors”) на JavaScript или Python. Она создана для автоматизации, выстраивания цепочек процессов и масштабирования в облаке.
Ключевые возможности:
- Actors и SDK: пиши собственные скрипты или используй готовые actors из Apify Store.
- Автоматизация через headless browser: собирай данные с динамических сайтов, работай с логинами и автоматизируй веб-задачи.
- Цепочки workflow: запускай один actor за другим и автоматизируй многошаговые сценарии.
- API и интеграции: подключайся к Zapier, Make, Google Drive, AWS и другим сервисам.
Плюсы: мощный инструмент для разработчиков, хорошо масштабируется и отлично подходит для автоматизации сложных workflows.
Минусы: для кастомных задач нужен код, оплата по использованию может быстро расти, и есть определенный порог входа.
Лучше всего подходит для: стартапов, команд разработчиков и всех, кому нужен облачный автоматизированный scraping в больших масштабах.
7. Dexi.io
 Dexi.io (ранее CloudScrape) — enterprise-платформа для автоматизации сбора и интеграции данных. Ее сильная сторона — построение end-to-end workflows: от извлечения данных до их преобразования и доставки.
Ключевые возможности:
- Визуальный дизайнер роботов: собирай многошаговые workflows с логикой point-and-click.
- Облачное выполнение и расписание: запускай роботов в облаке, планируй регулярные задачи и обрабатывай большие объемы.
- Обработка и интеграция данных: очищай, преобразовывай и экспортируй данные в CRM, базы данных или API.
- Enterprise-функции: управление пользователями, соответствие требованиям и варианты on-premise.
Плюсы: масштабируемость, мощь для сложных workflows и сильные возможности интеграции.
Минусы: enterprise-цены, не для новичков, а для продвинутого использования потребуется обучение.
Лучше всего подходит для: крупных организаций, команд retail intelligence и всех, кто автоматизирует многоэтапные data pipeline.
8. WebHarvy
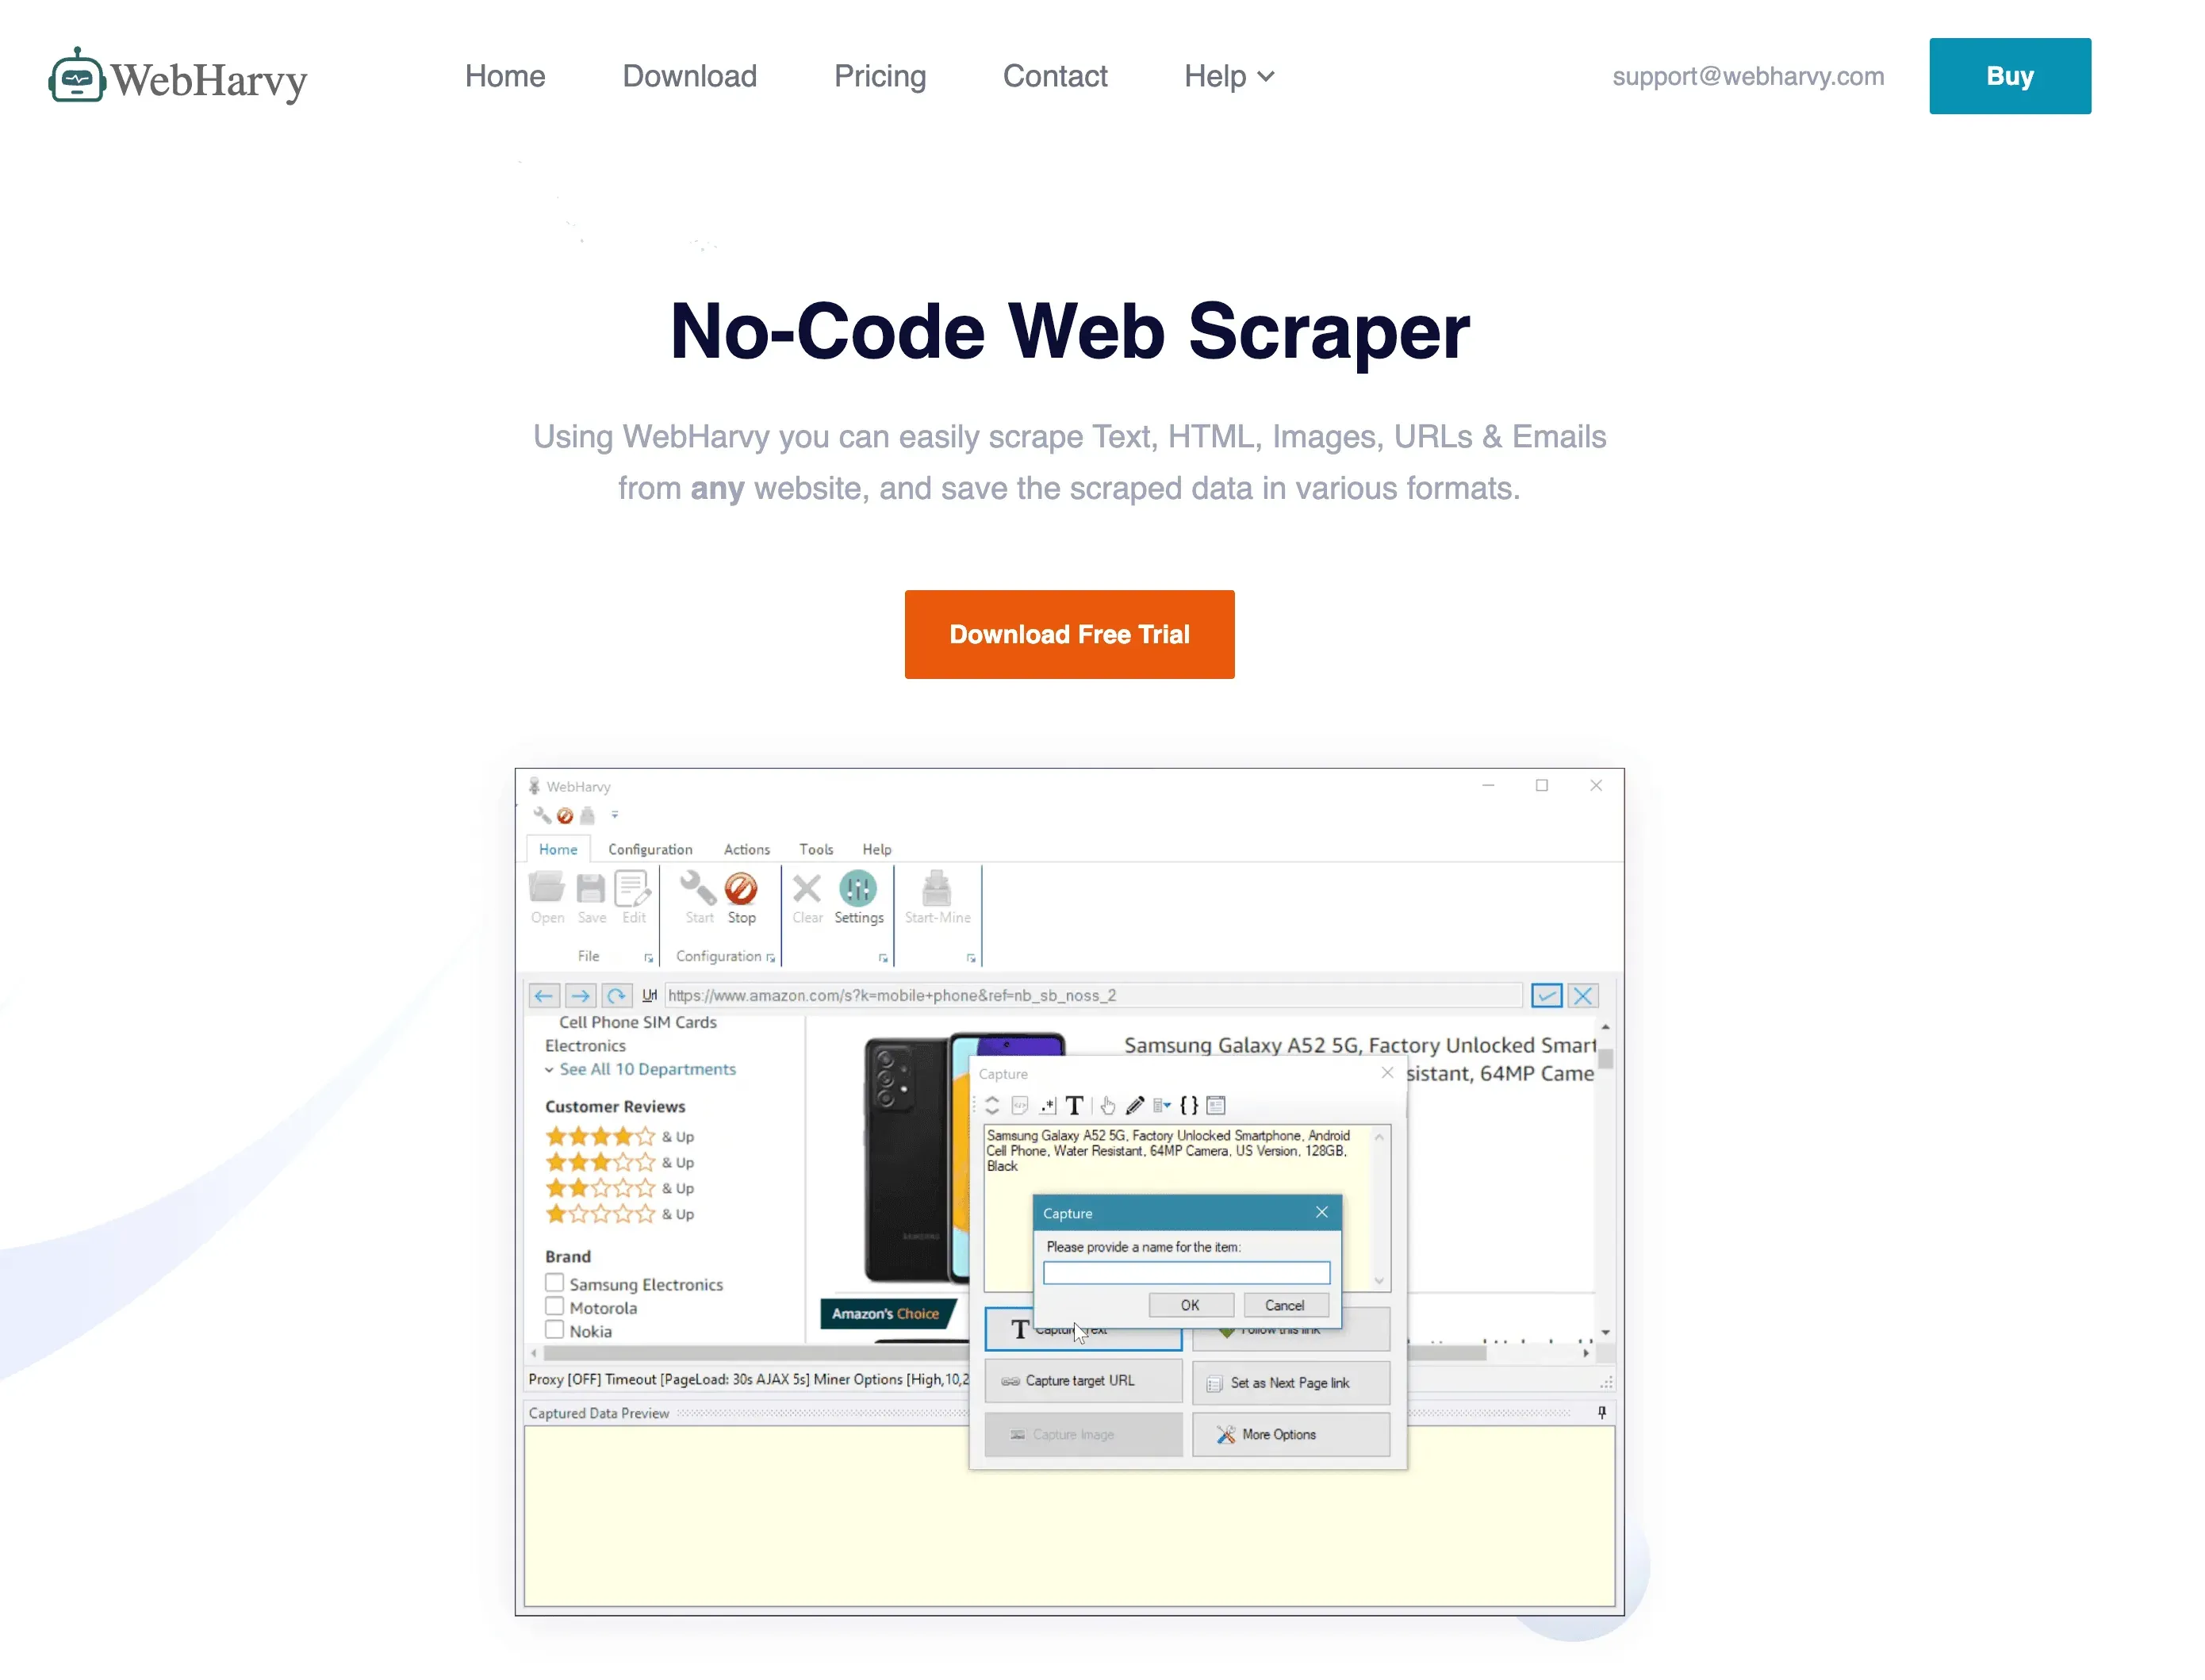 WebHarvy — Windows desktop scraper, известный своей максимально простой логикой point-and-click и моделью разовой лицензии.
Ключевые возможности:
- Визуальный выбор: нажимай на элементы во встроенном браузере, чтобы задавать поля.
- Автоматическое распознавание шаблонов: сам находит списки и таблицы.
- Скачивание изображений и файлов: извлекает не только текст, но и изображения с документами.
- Планирование: автоматизируй запуск через Windows Task Scheduler.
Плюсы: доступная разовая оплата, прост для несложных сайтов и работает офлайн.
Минусы: плохо справляется с тяжелым JavaScript и антибот-защитой, только для Windows, и у него ограничены продвинутые настройки.
Лучше всего подходит для: малого бизнеса, исследователей и тех, кому нужен недорогой и простой scraper для статических сайтов.
9. Data Miner
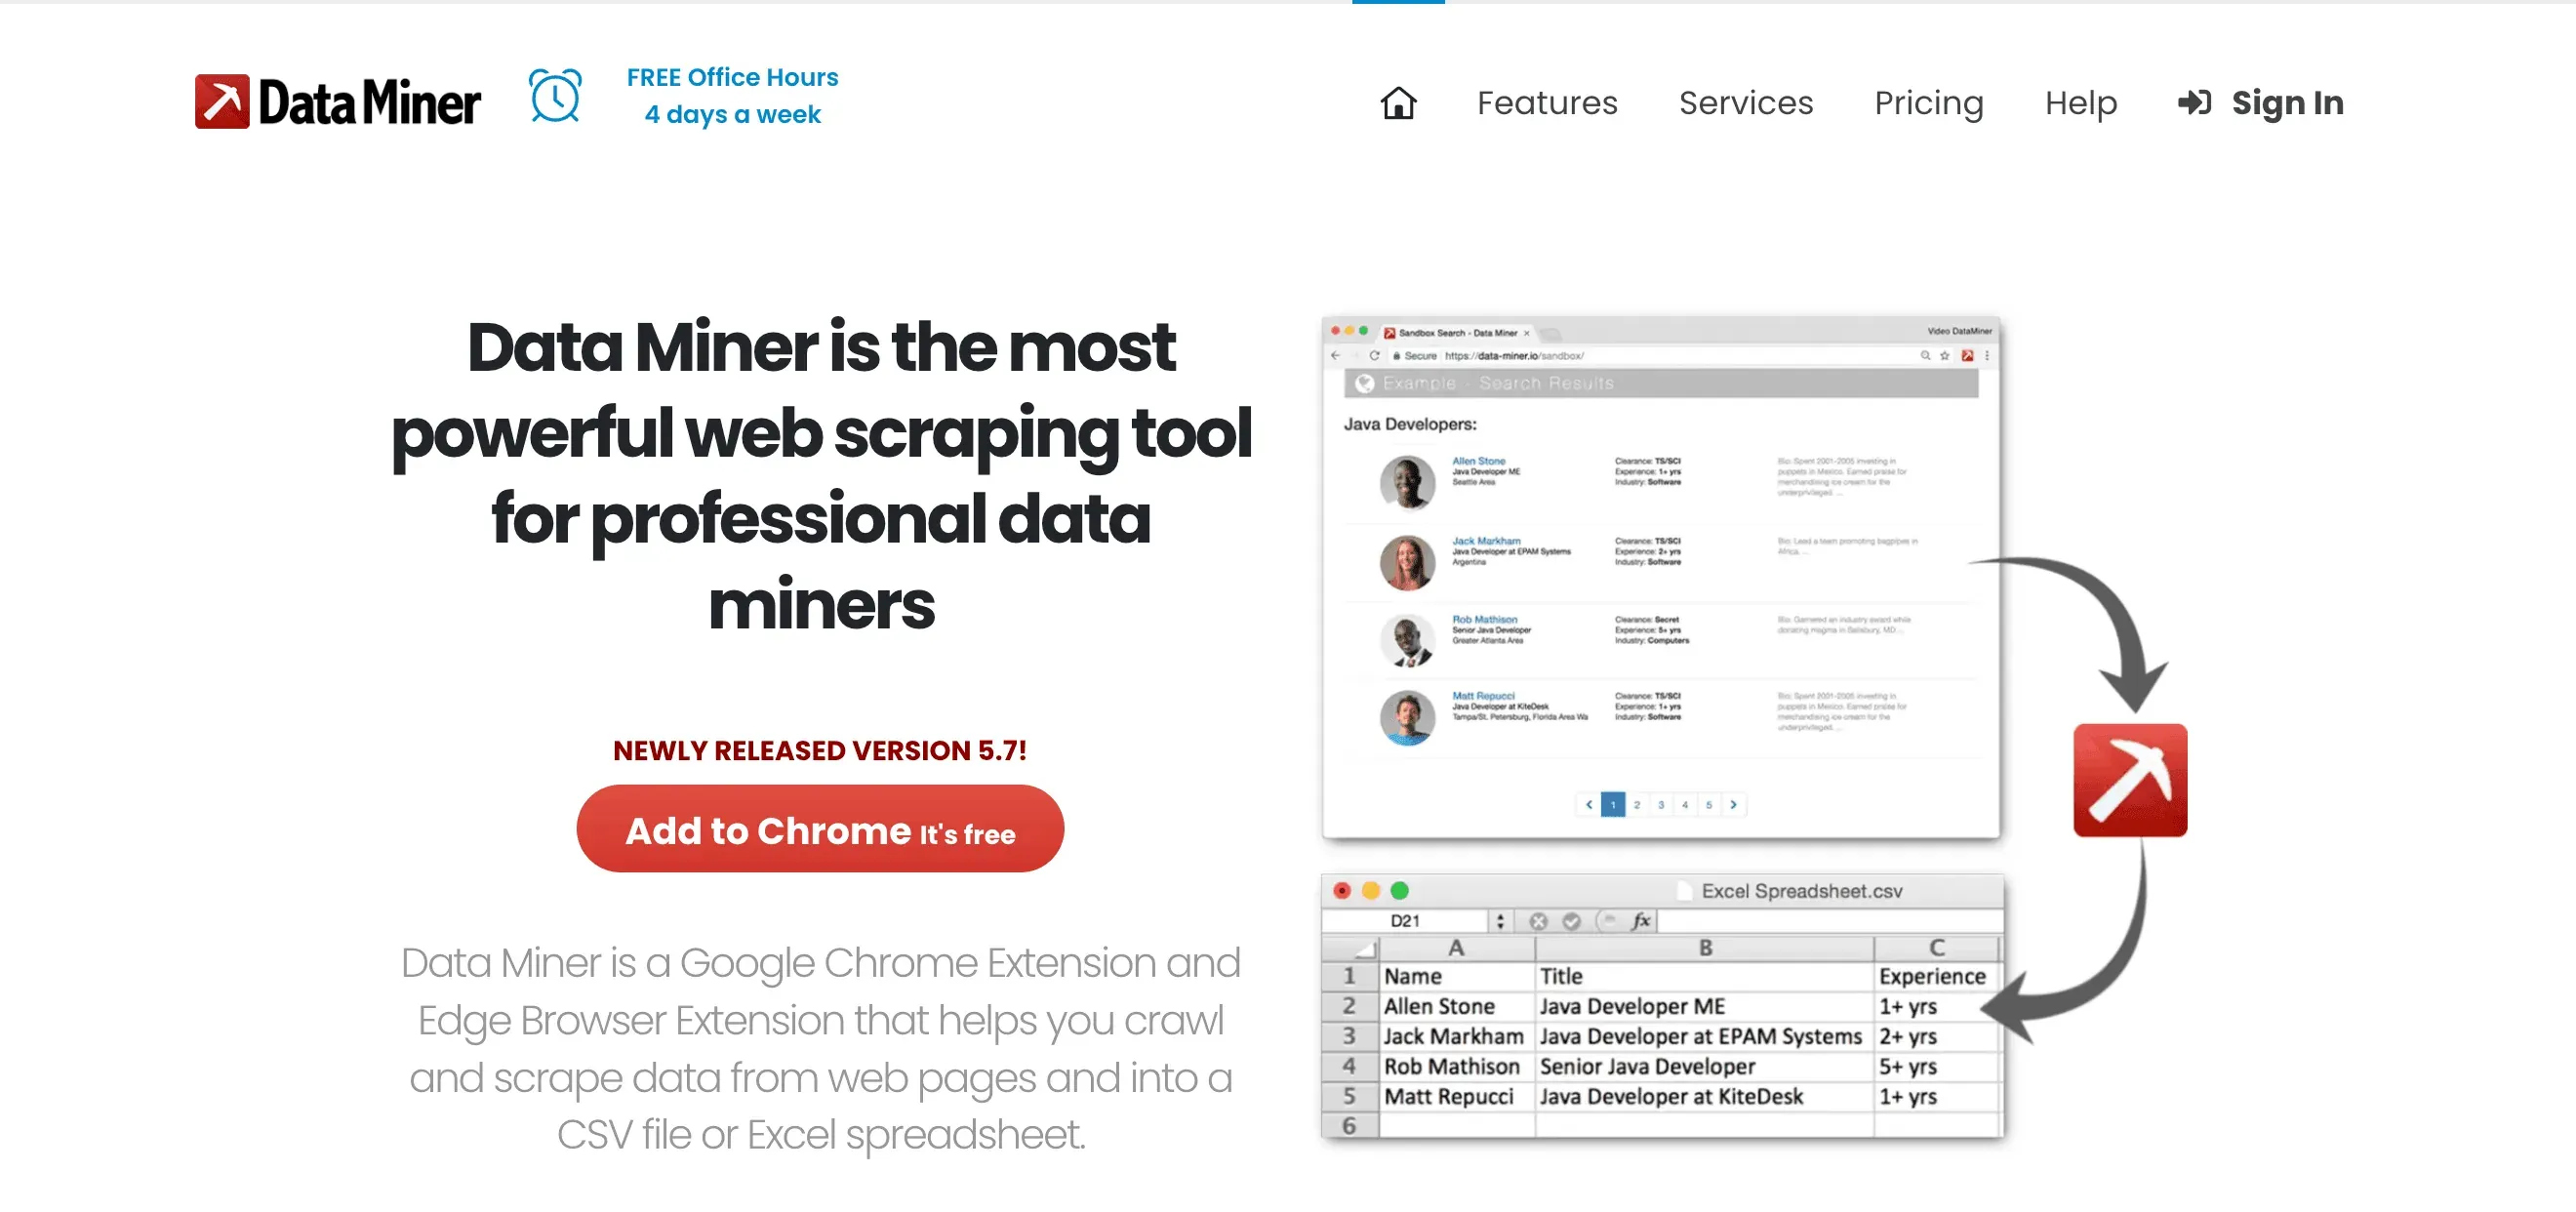 Data Miner — расширение для Chrome/Edge, которое идеально подходит для быстрого шаблонного извлечения данных из веб-страниц, особенно для sales и operations-команд.
Ключевые возможности:
- 50,000+ публичных рецептов: scraping популярных сайтов в один клик.
- Конструктор рецептов point-and-click: создавай собственные правила извлечения.
- Мгновенное извлечение таблиц: доставай HTML-таблицы или списки за секунды.
- Прямой экспорт: отправляй данные в Google Sheets, Excel или CSV.
Плюсы: быстро, работает в браузере, не требует кода и отлично подходит для сайтов с авторизацией.
Минусы: ограничен скоростью браузера, лимитами страниц в бесплатных и платных планах и не подходит для очень больших задач.
Лучше всего подходит для: поиска лидов, быстрых исследовательских задач и всех, кому нужна кнопка «Экспорт в Excel» для веба.
10. Helium Scraper
 Helium Scraper — это Windows-приложение, которое удачно сочетает простоту drag-and-drop с глубокой кастомизацией.
Ключевые возможности:
- Модель Kinds и Actions: визуально определяй структуры данных, а затем настраивай действия для извлечения.
- Многоуровневые и реляционные данные: формируй связи parent-child, выполняй SQL-запросы по собранным данным.
- Кастомные скрипты: добавляй JavaScript или SQL для продвинутой логики.
- Многопоточность: собирай данные с нескольких страниц параллельно для большей скорости.
Плюсы: гибкий, поддерживает сложные структуры данных и доступен по модели разовой оплаты.
Минусы: нужно время, чтобы освоить концепцию Kinds, работает только на Windows и имеет менее широкую поддержку на рынке.
Лучше всего подходит для: аналитиков и тех, кто хочет больше возможностей, чем дают базовые point-and-click инструменты, но пока не готов писать код с нуля.
Какой data extractor подойдет именно вам? Сценарии и рекомендации
- Лидогенерация для продаж: Thunderbit (AI, простой экспорт), Data Miner (браузерный, быстрые recipes).
- Мониторинг eCommerce: Octoparse (шаблоны, расписание), Dexi.io (enterprise, интеграции).
- Техническая кастомизация: Scrapy (Python, open-source), Apify (облако, автоматизация workflow), ParseHub (визуально, динамические сайты).
- Интеграция данных и автоматизация: Import.io (BI workflows).
- Быстрые задачи небольшого масштаба: WebHarvy (point-and-click, разовая оплата), Helium Scraper (drag-and-drop, кастомная логика).
Полезный совет: большинство инструментов дают бесплатный пробный период или бесплатный тариф — протестируй несколько вариантов на своих реальных данных, прежде чем принимать решение.
Что такое data scraping и как делать это в 2025 году Get Started Free
Вывод: добейтесь максимальной эффективности с правильным инструментом для извлечения данных
Времена ручной возни с данными подходят к концу. С правильным data extractor ты сможешь убрать часы рутинной работы, повысить точность и принимать более взвешенные решения — независимо от того, ты solo founder, команда продаж или операционный менеджер в Fortune 500. Главное — подобрать инструмент под свой сценарий, технический уровень и бюджет.
Если ты ищешь самый быстрый путь от «мне нужны эти данные» до «они уже в моей таблице», Thunderbit — отличная точка старта. Но какие бы у тебя ни были задачи, в этом списке найдется инструмент, который поможет работать умнее, а не тяжелее.
Готов вывести работу с данными на новый уровень? Попробуй несколько из этих extractors и посмотри, сколько времени и нервов можно сэкономить.
Получить расширение Thunderbit для Chrome
FAQ
1. Что такое data extractor и зачем он нужен?
Data extractor — это инструмент, который автоматизирует сбор структурированной информации с сайтов, документов или баз данных. Он экономит время, снижает количество ошибок и позволяет сосредоточиться на анализе вместо ручного копирования и вставки.
2. Какой data extractor лучше всего подходит для нетехнических пользователей?
Thunderbit выделяется AI-логикой, настройкой в 2 клика и подсказками на естественном языке. Он сделан для бизнес-пользователей, которым нужен результат без кода и сложной настройки.
3. Могут ли data extractor работать с динамическими сайтами или сайтами на JavaScript?
Да — такие инструменты, как ParseHub, Apify и Scrapy (с поддержкой headless browser), отлично справляются с динамическим контентом и интерактивными сайтами.
4. Как выбрать между бесплатным и платным data extractor?
Бесплатные инструменты хороши для небольших и редких задач. Для регулярной, масштабной или критически важной работы платные тарифы дают больше функций, более высокие лимиты и лучшую поддержку. Всегда начинай с бесплатного теста, чтобы проверить, подходит ли решение.
5. Законно ли использовать data extractor?
Как правило, сбор общедоступных данных законен, но всегда проверяй условия использования сайта и соблюдай законы о конфиденциальности. Если речь идет о чувствительных или персональных данных, убедись в соответствии требованиям, например GDPR.
Хочешь больше советов по web scraping, автоматизации и продуктивности? Загляни в блог Thunderbit — там есть подробные разборы, инструкции и свежие материалы об AI-извлечении данных.
Узнать больше
- Как извлекать данные из PDF с помощью AI
- Как извлечь данные с сайта: понятное руководство для новичков
- Как извлечь данные с веб-страницы с помощью Thunderbit
- Топ-12 бесплатных инструментов для сбора данных в 2025 году
Попробовать AI Web Scraper Get Started Free




