Raspador do Tumblr





Desbloqueie os dados do Tumblr com a Thunderbit
Extraia facilmente dados do Tumblr, como conteúdo de posts e contagem de curtidas.
Tenha a história completa do Tumblr
As páginas de lista do Tumblr mostram apenas trechos. Para ter a visão completa, você precisa do conteúdo integral do post, dos detalhes do autor e de todos os metadados associados. A Thunderbit visita automaticamente cada página de post vinculada, extrai os detalhes completos e os adiciona como novas colunas — assim você captura IDs de posts, datas de publicação e muito mais sem precisar clicar manualmente.
Automatize sua coleta de dados do Tumblr
Os dados do Tumblr mudam o tempo todo. Voltar manualmente aos mesmos blogs para refazer a extração é cansativo e sujeito a erros. Com a extração agendada da Thunderbit, você pode configurar coletas recorrentes no piloto automático. Receba novas contagens de curtidas e conteúdo de posts diretamente no Google Sheets — sem trabalho manual.
Extraia posts do Tumblr em dois cliques
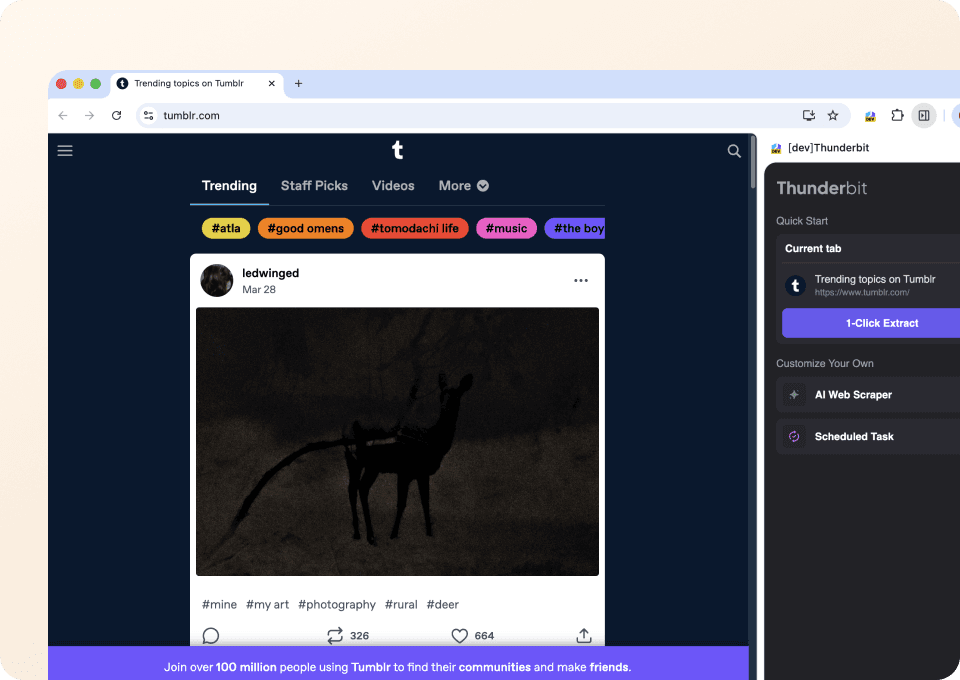
Sem código e sem seletores CSS. A Thunderbit permite extrair dados do Tumblr em apenas dois cliques. Basta apontar para o que você quer — tipo do post, autor, conteúdo, contagem de curtidas — e a IA semântica da Thunderbit identifica os campos relevantes e extrai tudo automaticamente.
Por que a Thunderbit é diferente dos scrapers tradicionais para Tumblr?
Extraia dados do Tumblr sem esforço, mesmo quando os layouts mudam ou sofrem alterações inesperadas.
Scrapers tradicionais
A forma antiga de fazer as coisasThunderbit com IA
A abordagem mais inteligente



Perguntas frequentes
Relacionados casos de uso
Explore mais casos de uso do web scraper da Thunderbit.

Scraper da United Airlines
Em 2 cliques, extraia números de voos, horários de partida, aeroportos de chegada e preços da United Airlines — depois exporte instantaneamente para Excel, Google Sheets ou Notion. O Thunderbit AI cuida do resto.
Saiba mais ->
Raspador Tieba
O Raspador Web Tieba da Thunderbit permite extrair dados do Baidu Tieba, incluindo tópicos em alta e categorias de fóruns. Aproveite sugestões inteligentes de campos com IA para coletar rapidamente nomes de tópicos, URLs, número de postagens e atividade de usuários, seja para pesquisa, marketing ou criação de conteúdo. Perfeito para analisar tendências e discussões nas redes sociais do Tieba.
Saiba mais ->
Raspador Web BestPrice GR
O Raspador Web BestPrice GR com IA da Thunderbit permite extrair listas de produtos, preços e informações detalhadas do BestPrice.gr em poucos cliques. Ideal para equipes de vendas, marketing e e-commerce que precisam coletar dados estruturados de forma rápida e eficiente.
Saiba mais ->
Raspador Web Tradera
O Raspador Web Tradera da Thunderbit permite extrair dados de anúncios e páginas de produtos do Tradera de forma simples. Com sugestões inteligentes de campos via IA, você coleta nomes de produtos, preços, categorias, imagens e descrições para análise ou gestão de estoque. Ideal para vendedores de e-commerce, colecionadores e pesquisadores que buscam dados estruturados do Tradera.
Saiba mais ->
Raspador Web HKTVmall
Extraia nomes de produtos, preços, avaliações e muito mais dos anúncios da HKTVmall em 2 cliques — sem precisar programar. Exporte diretamente para Excel, Google Sheets ou Notion e transforme os dados da HKTVmall em insights acionáveis.
Saiba mais ->
Raspador Amarillas.com
O Raspador Web Amarillas.com da Thunderbit permite extrair dados estruturados do Amarillas.com, incluindo listagens de motéis e restaurantes. Aproveite sugestões inteligentes de campos com IA para coletar rapidamente nomes de empresas, endereços, telefones, avaliações e comentários para pesquisas, marketing ou geração de leads.
Saiba mais ->Pronto para turbinar sua extração de dados?
Junte-se a mais de 200.000 profissionais que já usam a Thunderbit para automatizar seus fluxos de trabalho de extração web.
O teste grátis oferece créditos ilimitados para 8 páginas web.


