
Pozyskiwanie danych z Facebooka nadal ma sens w 2026 roku, ale tylko wtedy, gdy wybierzesz właściwy model zbierania. Pew Research Center podał 20 listopada 2025 r., że 71% dorosłych mieszkańców USA korzysta z Facebooka, a Meta poinformowała 29 kwietnia 2026 r., że jej rodzina aplikacji osiągnęła 3,56 miliarda dziennych aktywnych użytkowników w marcu 2026 r. Taka skala nadal sprawia, że Facebook jest przydatny do monitorowania Marketplace, badań publicznych stron, generowania leadów i śledzenia konkurencji. Problemem nie jest brak zastosowań. Problemem jest uzyskanie czystych danych bez utknięcia na ekranach logowania, dynamicznym ładowaniu, tymczasowych blokadach czy kruchych konfiguracjach facebook scraping.
Ta coroczna lista została przygotowana z myślą o szybkim wyborze. W sierpniu 2026 r. ponownie sprawdziłem oficjalne strony produktów, dokumentację i sygnały cenowe, a potem zawęziłem zestaw do narzędzi, które nadal mają sens dla realnych użytkowników biznesowych. Jeśli potrzebujesz infrastruktury na poziomie API, Bright Data, Apify i Nimble by Nimbleway powinny znaleźć się wysoko na liście. Jeśli Twoja praca obejmuje automatyzacje w chmurze lub działania następcze po zebraniu danych, PhantomBuster zasługuje na bliższe spojrzenie.
Szybkie rekomendacje według zadania
- Potrzebujesz oficjalnej ścieżki dla zasobu, którym zarządzasz? Zacznij od narzędzi administracyjnych Meta i zatwierdzonych API.
- Potrzebujesz specjalistycznego API do danych publicznych? Porównaj Bright Data lub Apify z dokładnym celem i dozwolonym sposobem użycia.
- Potrzebujesz ogólnej warstwy infrastruktury do danych z internetu? Oceń Nimble lub ScrapingBot w ramach ograniczonego proof of concept.
- Potrzebujesz wizualnego workflow dla dozwolonego źródła spoza Meta? Octoparse może dobrze pasować do procesu prowadzonego przez analityka.
Dlaczego pozyskiwanie danych z Facebooka w 2026 roku wciąż jest trudne
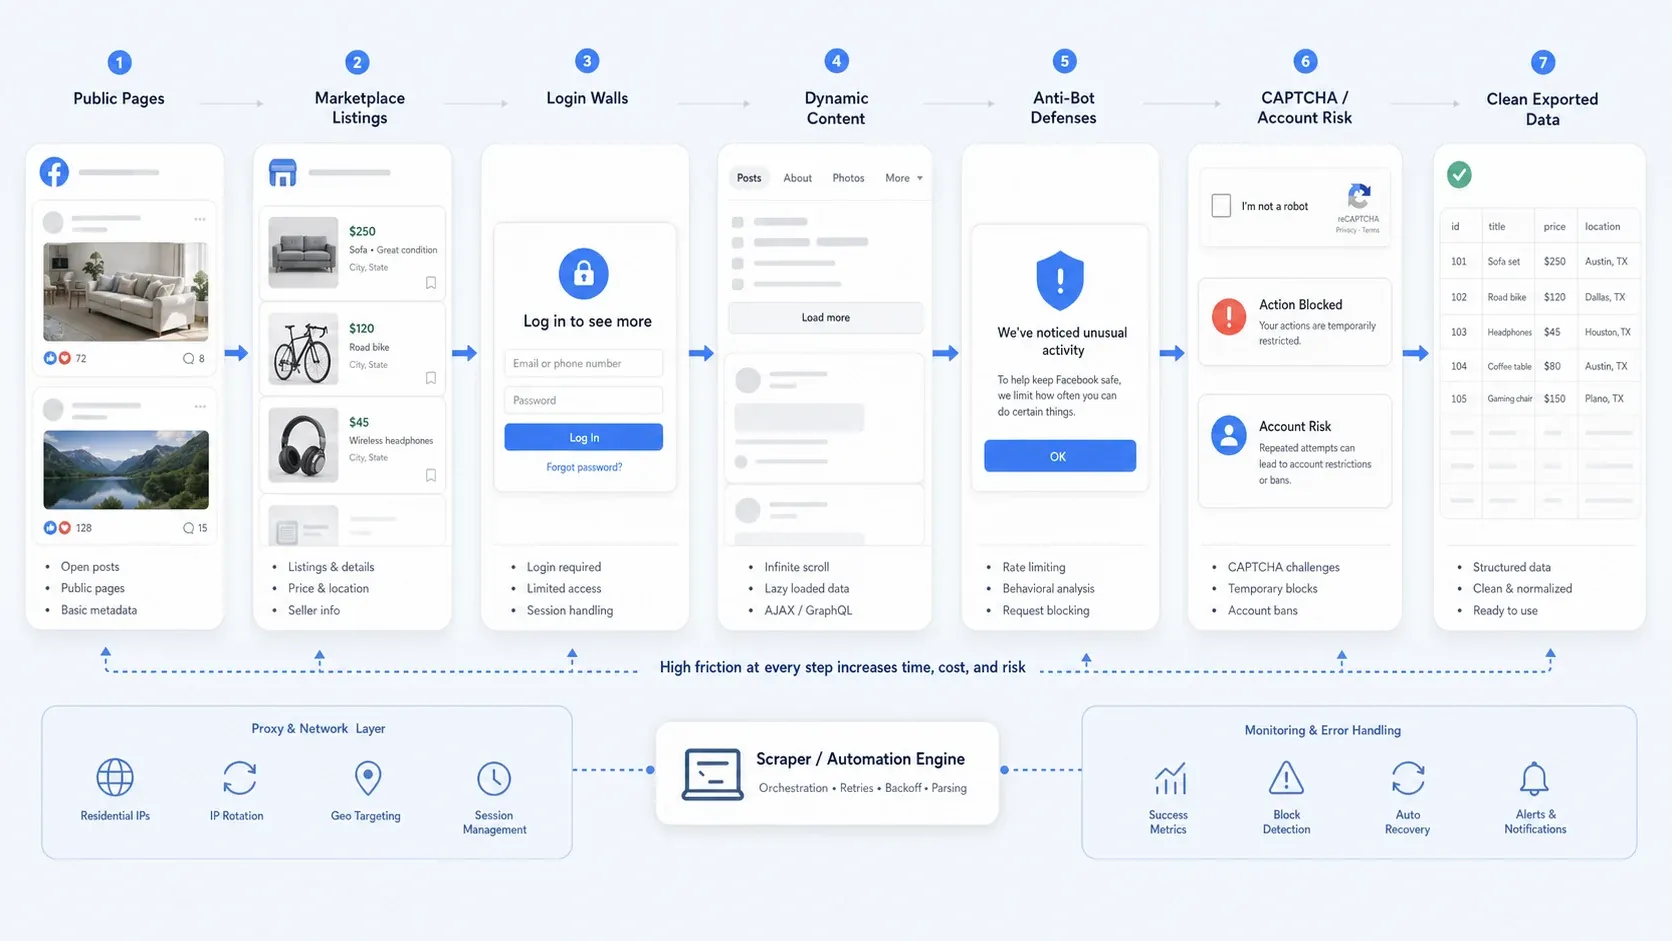
Zbieranie danych z Facebooka rzadko sprowadza się już tylko do ustawienia selektora. W praktyce większość zespołów napotyka jedną lub kilka z tych przeszkód:
- Częściowy dostęp publiczny: Niektóre strony pozostają publiczne, ale w innych przepływach trzeba się zalogować, aby zobaczyć więcej szczegółów.
- Dynamiczna zawartość: Widoki Marketplace, długie wątki komentarzy i treści stron często ładują się stopniowo.
- Zabezpieczenia antybotowe: Limitowanie żądań, testy behawioralne, CAPTCHA i tymczasowe blokady działań psują proste automatyzacje.
- Ryzyko operacyjne: Zbieranie danych po zalogowaniu jest znacznie bardziej ryzykowne niż web scraping facebook stron publicznych, zwłaszcza jeśli zależy Ci na bezpieczeństwie konta i powtarzalności.
Jak oceniłem te narzędzia
Ta strona jest zoptymalizowana pod szybkie stworzenie shortlisty, a nie pod sztuczne rozdmuchiwanie liczby funkcji. Porównywałem narzędzia pod kątem:
- Dopasowania do procesu: Czy produkt rzeczywiście pasuje do zadań związanych z Facebookiem i Marketplace, które realizują prawdziwe zespoły?
- Łatwości użycia: Czy osoby nietechniczne lub małe zespoły mogą szybko uzyskać użyteczny wynik?
- Skali i niezawodności: Czy narzędzie nadal ma sens, gdy wyjdziesz poza jednorazowe pobranie danych?
- Obsługi antybota i sesji: Ile problemów infrastrukturalnych produkt usuwa z Twojej drogi?
- Jakości eksportu: Czy można bez większego czyszczenia uzyskać dane w CSV, Sheets lub w systemach downstream?
- Sygnału cenowego: Czy produkt da się sensownie przetestować, czy wymaga ciężkiego procesu enterprise?
- Podejścia do zgodności: Czy narzędzie jest wyraźnie nastawione na zbieranie danych publicznych i odpowiedzialne użycie?
Jaki typ Facebook Scrapera jest Ci potrzebny?
Najszybszy sposób na dobry wybór to najpierw wybrać właściwą kategorię. Narzędzia do scrapingu Facebooka zwykle mieszczą się w czterech modelach działania:
- Narzędzia no-code w przeglądarce: Najlepsze, gdy chcesz szybko wyciągnąć dane z aktualnie otwartej strony.
- API do scrapingu: Najlepsze, gdy potrzebujesz niezawodnego, powtarzalnego zbierania na większą skalę.
- Automatyzacje workflow: Najlepsze, gdy scraping jest tylko jednym krokiem w szerszym procesie go-to-market.
- Własne stacki dla developerów: Najlepsze, gdy zespół chce maksymalnej kontroli i jest gotowy przejąć ciężar utrzymania.
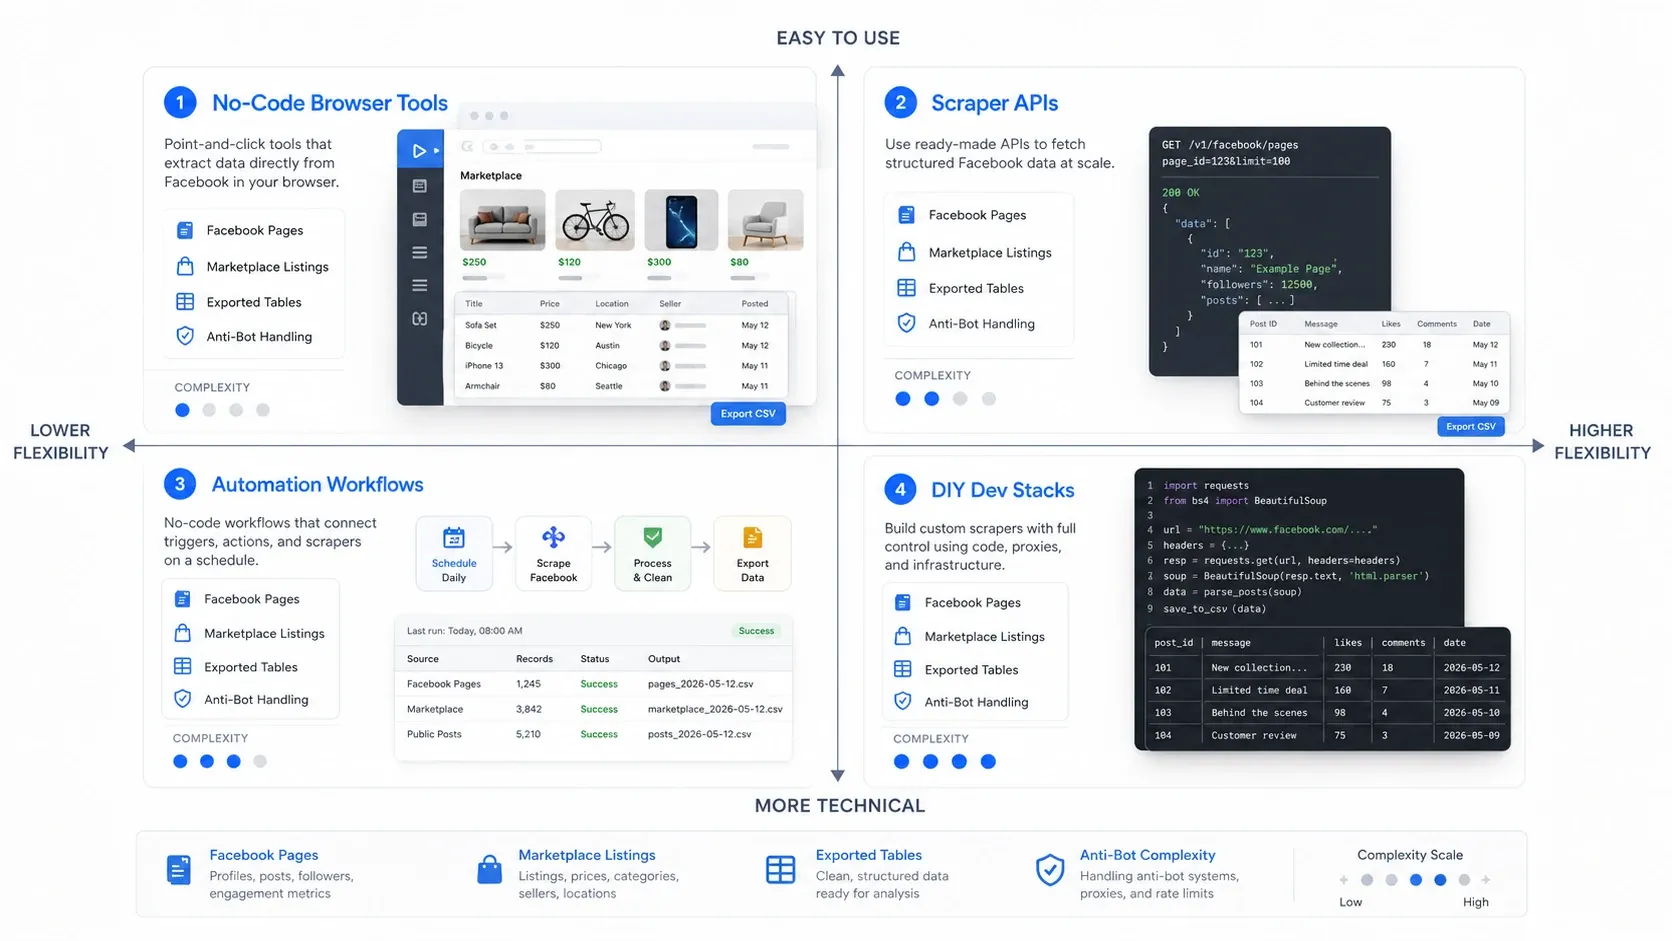
Tabela porównawcza
| Narzędzie | Najlepsze zastosowanie | Model działania |
|---|---|---|
| Bright Data | Zarządzany workflow API do danych publicznych | Specjalistyczne API i warstwa dostarczania |
| Apify | Powtarzalne zadania na stronach lub profilach | Cloud actor i eksport do datasetów |
| Nimble | Ocena pod kątem potrzeb zespołu inżynieryjnego | Ogólne API do publicznego webu |
| ScrapingBot | Testy z renderowaniem | Ogólne API do scrapingu |
| PhantomBuster | Workflow GTM na własnym koncie | Automatyzacja prospectingu |
| Octoparse | Wizualne zadania prowadzone przez analityka | No-code, wizualny workflow |
1. Bright Data
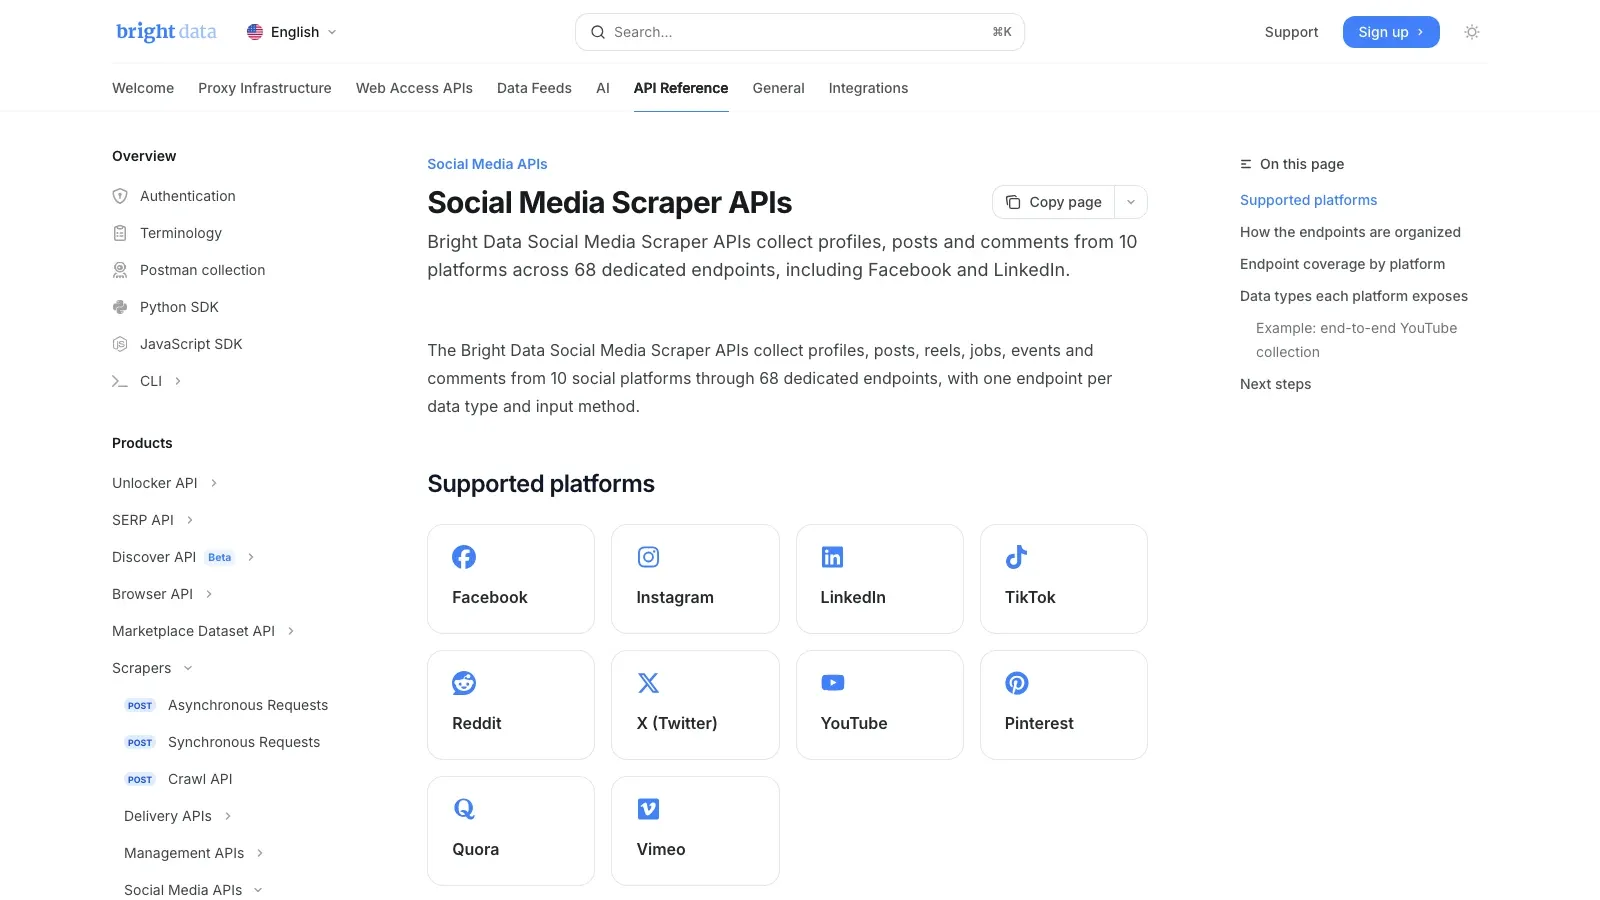
Bright Data to wybór, który przede wszystkim stawia na infrastrukturę. W dokumentacji Bright Data znajduje się informacja, że ich Social Media Scraper APIs obejmują 10 platform i 68 dedykowanych endpointów, w tym Facebooka. Jeśli Twoim zadaniem jest zbieranie danych publicznych na dużą skalę, taki zarządzany stack API jest zwykle bardziej realistyczny niż próba skalowania rozszerzenia przeglądarkowego albo własnoręcznie napisanego scrapera.
Dlaczego warto uwzględnić je na liście:
- Dedykowane endpointy do scrapingu social mediów
- Zarządzane odblokowywanie i ekstrakcja danych
- Strukturalne dostarczanie wyników do potoków danych
- Lepsze dopasowanie do monitoringu i analityki wymagających niezawodności
Najlepsze dla: analityków, zespołów data, dużych projektów monitoringu i publicznych zbiorów danych social media na dużą skalę.
Sygnał cenowy: ceny zależą od produktu i wolumenu. Sprawdź aktualny cennik Bright Data.
2. Apify
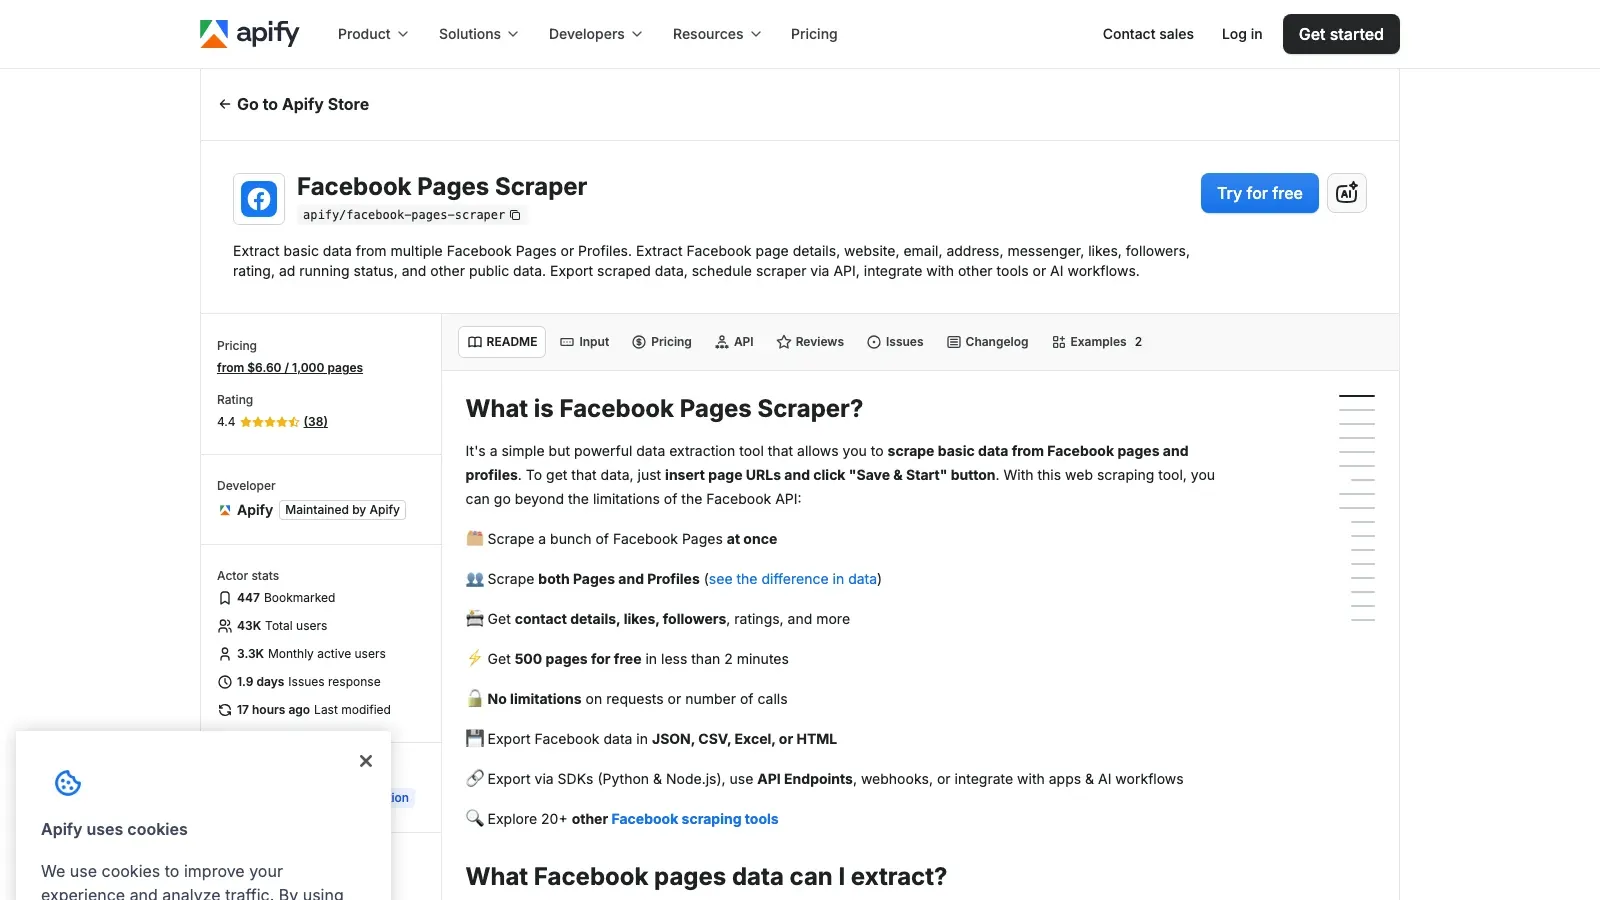
Apify pozostaje istotne, bo zapewnia dobry kompromis między gotowymi szablonami a pełną możliwością dostosowania. Jego Facebook Pages Scraper actor to dobre miejsce startowe, a szersza platforma Apify daje cloud execution, harmonogramy, API i przestrzeń do rozbudowy workflow, jeśli potrzeby staną się bardziej złożone.
Dlaczego znalazł się na liście:
- Gotowe aktory do Facebooka
- Uruchamianie w chmurze i cykliczne harmonogramy
- Elastyczne eksporty i dostęp przez API
- Łatwiejsza rozbudowa niż czysty no-code w przeglądarce
Najlepsze dla: marketerów technicznych, agencji, zespołów operacyjnych i cyklicznych zadań zbierania danych z wielu stron.
Sygnał cenowy: plany platformy są płatne, a użycie actorów rozliczane osobno. Sprawdź cennik Apify.
3. Nimble by Nimbleway
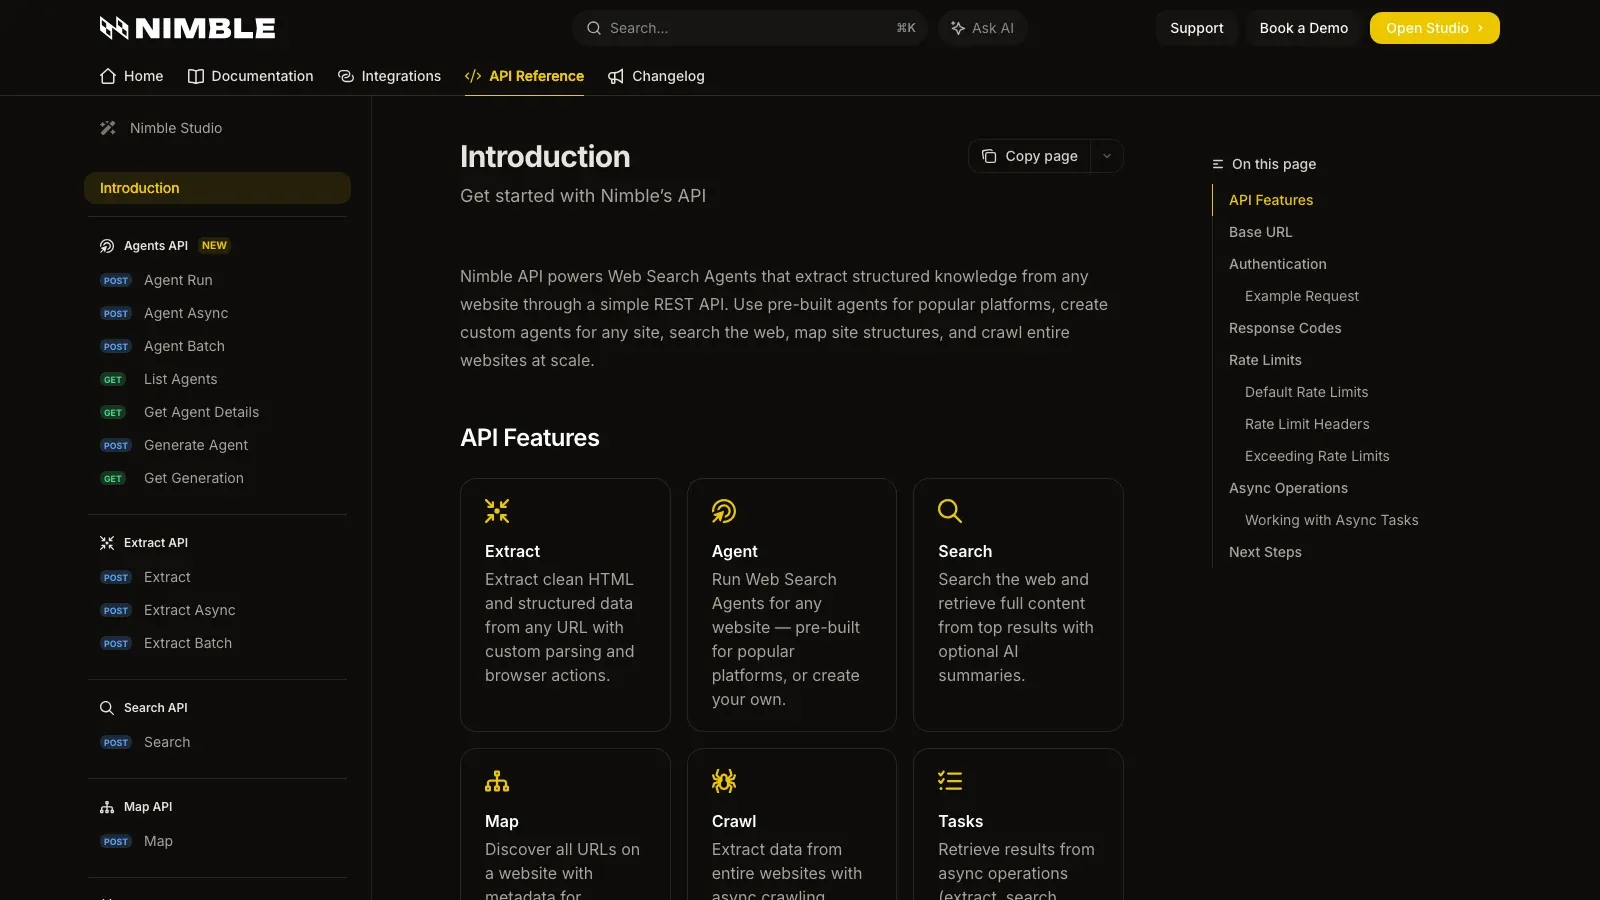
Nimble by Nimbleway to opcja API-first dla zespołów, które chcą wkleić URL i pozwolić platformie zająć się dostępem, renderowaniem oraz dostarczeniem danych. Nimble pozycjonuje swoje Web Scraper API jako kompleksowe rozwiązanie do zbierania publicznych danych z internetu, co czyni je przydatnym wtedy, gdy facebook scraping jest tylko jednym elementem większego stosu danych.
Dlaczego warto je ocenić:
- Workflow API oparty na URL-ach
- Mniejszy ciężar utrzymania scrapera dla zespołów inżynieryjnych
- Dobre dopasowanie do odpornego pozyskiwania danych z publicznego webu
- Przydatne, gdy dane trafiają do wewnętrznych produktów lub dashboardów
Najlepsze dla: zespołów prowadzonych przez inżynierów, potoków danych produktowych i organizacji, które wolą abstrakcję infrastruktury zamiast narzędzi punktowych.
Sygnał cenowy: Nimble nie eksponuje publicznie samoobsługowych cen na głównych stronach API, więc należy spodziewać się wyceny sprzedażowej i potwierdzić ją bezpośrednio w Nimble by Nimbleway.
4. ScrapingBot
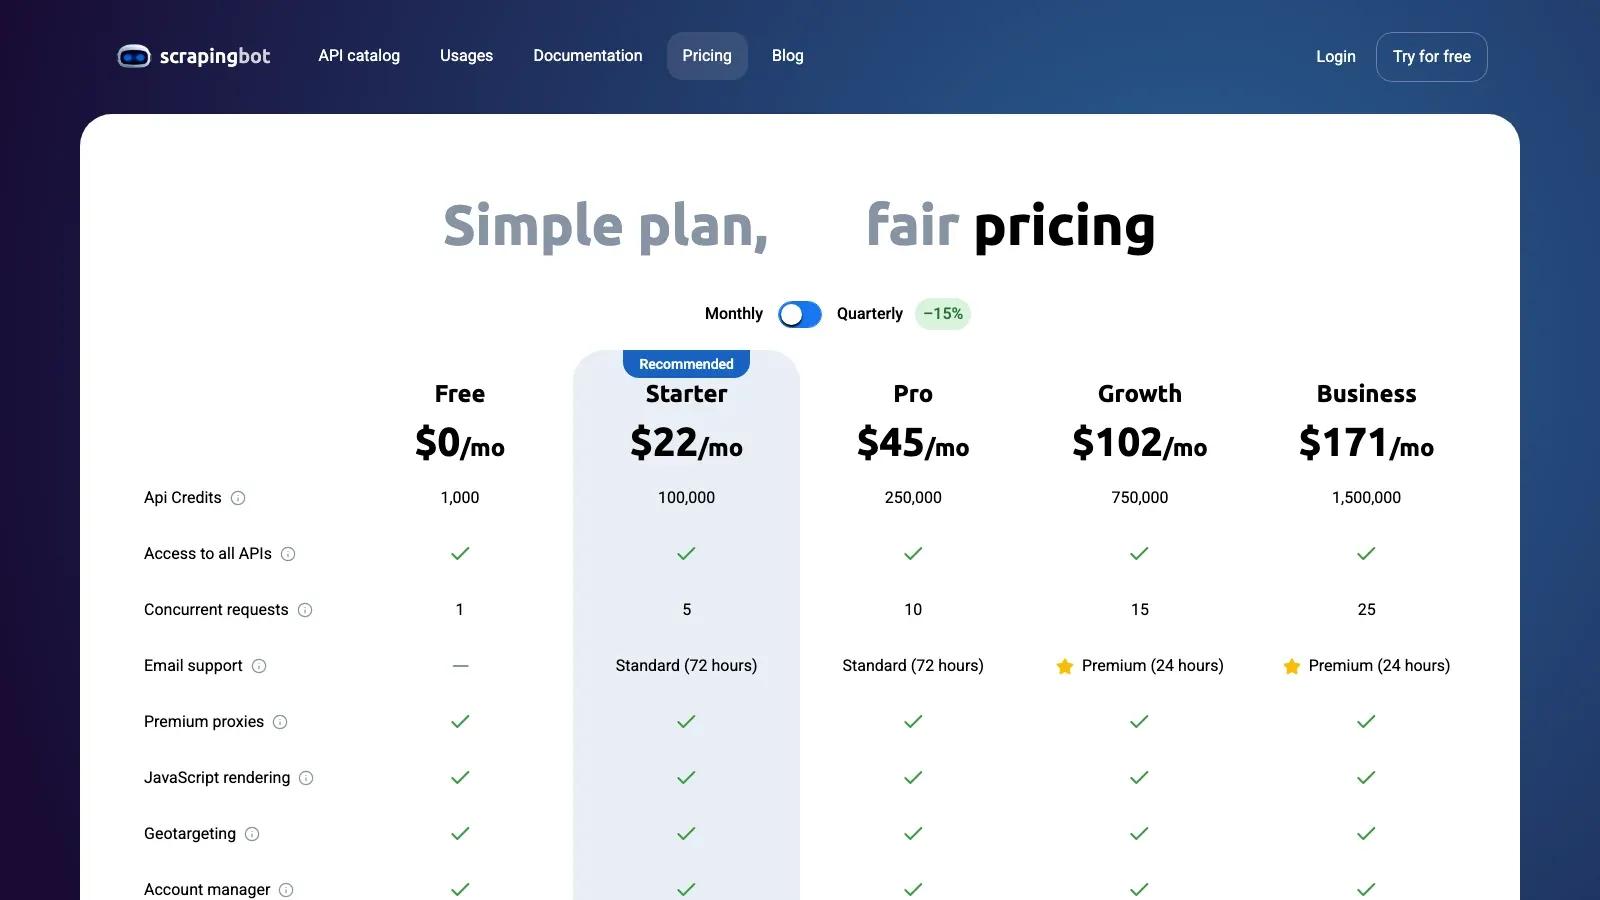
ScrapingBot to najbardziej budżetowa opcja API w tym zestawieniu. Nie jest to najbardziej wyspecjalizowana platforma dla Facebooka, ale nadal ma sens przy mniejszych zadaniach związanych z danymi publicznymi, gdy potrzebujesz API, wsparcia renderowania i niższego progu kosztowego niż w przypadku enterprise’owej infrastruktury scrapingowej.
Gdzie pasuje najlepiej:
- Proste publiczne scrapingi oparte o API
- Niższy koszt wejścia
- Wbudowane renderowanie i obsługa proxy
- Lepsze do prototypów i lekkich cyklicznych pobrań niż do dużych programów analitycznych
Najlepsze dla: startupów, małych firm i developerów testujących lżejsze przypadki użycia związane z publicznymi stronami.
Sygnał cenowy: dostępny darmowy plan; aktualna publiczna strona z cennikiem pokazuje plany płatne od około $22/miesiąc.
5. PhantomBuster
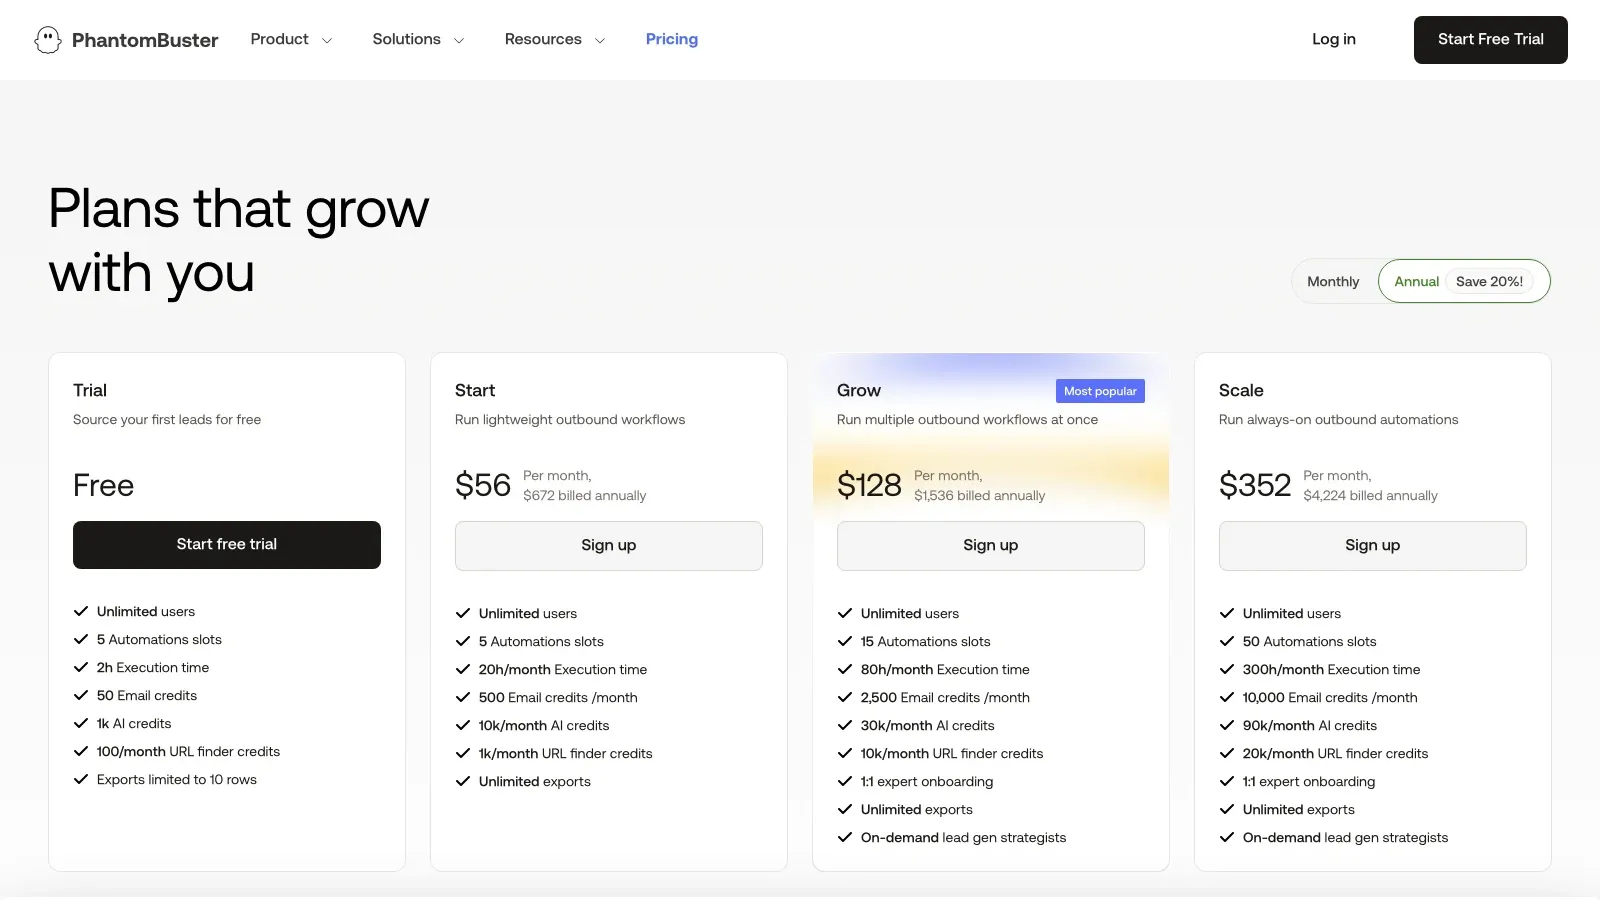
PhantomBuster mniej skupia się na samej infrastrukturze scrapingu, a bardziej na tym, co dzieje się po zebraniu danych. Jeśli Twój scenariusz brzmi: „zbierz dane, a potem uruchom outreach, enrichment albo działania następcze”, PhantomBuster bywa bardziej użyteczny niż zwykły ekstraktor, ponieważ został zaprojektowany wokół automatyzacji w chmurze i workflow opartych na akcjach w przeglądarce.
Dlaczego zespoły nadal biorą go pod uwagę:
- Automatyzacje oparte na chmurze
- Przydatne do generowania leadów i działań GTM
- Lepsze dopasowanie, gdy scraping jest jednym krokiem w szerszym procesie
- Praktyczne dla osób, którym zależy na działaniach, a nie tylko na eksporcie
Najlepsze dla: zespołów GTM, growth, rekruterów i operatorów łączących zbieranie danych z dalszym działaniem.
Sygnał cenowy: dostępny darmowy okres próbny; płatne plany na aktualnej stronie cennika zaczynają się od około $56/miesiąc.
6. Octoparse
Octoparse nadal pozostaje jednym z lepszych wizualnych narzędzi no-code do scrapingu dla użytkowników, którzy chcą powtarzalnych workflow i zaplanowanych uruchomień w chmurze. Daje osobom nietechnicznym większą kontrolę nad tym, jak logika ekstrakcji jest budowana i powtarzana, kosztem większej ilości konfiguracji niż w lekkim, jednorazowym workflow.
Dlaczego nadal jest aktualny:
- Wizualny kreator workflow typu point-and-click
- Ekstrakcja w chmurze i harmonogramowanie
- Dobre rozwiązanie do uporządkowanych, powtarzalnych zadań
- Lepsze dla analityków, którzy chcą powtarzalności bez kodowania
Najlepsze dla: analityków bez zaplecza technicznego, zespołów operacyjnych SMB i powtarzalnych zadań zbierania danych z bardziej jawnie zdefiniowaną logiką workflow.
Sygnał cenowy: publiczny cennik Octoparse pokazuje plany płatne od około $69/miesiąc za plan Standard, rozliczany rocznie.
Krótka lista według zespołu
- Workflow oparty na API: Bright Data lub Apify
- Ocena publicznego webu prowadzona przez inżynierów: Nimble lub ScrapingBot
- Workflow prospectingowy na własnym koncie: PhantomBuster
- Wizualny, edytowalny workflow: Octoparse
Zanim wybierzesz jakąkolwiek opcję, przetestuj dokładny typ strony i pola, których Twój zespół ma prawo używać. Widoczność na Facebooku różni się między Stronami, Profilami, Marketplace, Grupami, lokalizacjami i stanem konta.
Wniosek końcowy
Właściwa ścieżka zależy od danych, modelu dostępu i odpowiedzialności zespołu za weryfikację. W przypadku zasobów, którymi zarządzasz, zacznij od oficjalnych narzędzi Meta i zatwierdzonych API. W przypadku badań wykraczających poza ten zakres, wybierz dostawcę lub źródło dopiero po potwierdzeniu typu strony, dozwolonego użycia, obowiązków prywatności oraz aktualnego zachowania produktu.
FAQ
Jaką ścieżkę powinien rozważyć najpierw użytkownik nietechniczny?
Jeśli chodzi o zasób, którym zarządza Twoja organizacja, zacznij od własnych narzędzi Meta do zarządzania i analityki. W przypadku szerszego potrzeby badawczej określ dozwolone źródło, którego workflow i prawa do danych możesz zweryfikować.
Która opcja jest najlepsza do integracji z oprogramowaniem lub potokiem danych?
Oceń Facebook-specific API, takie jak Bright Data, platformę opartą na actorach, taką jak Apify, albo ogólne API do publicznego webu — najlepiej po ograniczonym teście dokładnie wybranego celu.
Czy te narzędzia mogą ominąć ograniczenia dostępu Facebooka?
Nie. Nie używaj narzędzi do obchodzenia mechanizmów platformy, ekranów logowania ani zabezpieczeń prywatności.




