
Dwie osoby wpisują w Google hasło „Thunderbit vs ZenRows” tego samego popołudnia, ale każda szuka zupełnie innej odpowiedzi. Jedna to menedżerka ds. sales ops, która potrzebuje listy leadów z katalogu do 15:00 i nigdy w życiu nie otwierała terminala. Druga to backend engineer, który próbuje pobrać 40 000 stron produktowych z witryny chronionej przez Cloudflare, nie dostając przy okazji bana na IP. Google, z całym szacunkiem, pokazuje im ten sam ranking siedmiu narzędzi, który ledwo wspomina o Thunderbit, a o ZenRows pisze w jednym wierszu arkusza kalkulacyjnego.
Prowadzę Thunderbit, więc oczywiście mam w tym swoje preferencje. Ale spędziłem też wystarczająco dużo lat w SaaS i automatyzacji (pozdrowienia dla czasów w Automation Anywhere, gdzie nauczyłem się, że „no-code” i „naprawdę użyteczne dla osoby bez kodowania” to dwie zupełnie różne obietnice), żeby wiedzieć, że większość artykułów porównawczych piszą ludzie, którzy nie używali żadnego z tych produktów do realnej pracy. Dlatego spróbuję podejść do tematu uczciwie: pełna tabela funkcji, rekomendacja oparta na zadaniu i poziomie technicznym zamiast fałszywego „zwycięzcy”, konkretny przykład cen z użyciem rzeczywistych mnożników kredytów ZenRows oraz szczere wyjaśnienie, dlaczego porównywanie „success rate” tych dwóch narzędzi jest trochę jak porównywanie scyzoryka szwajcarskiego z lawetą.
Czym są Thunderbit i ZenRows? (Szybkie definicje)
Zanim przejdziemy do funkcji, warto wiedzieć, że te dwa narzędzia zwykle nie konkurują o dokładnie to samo zadanie. Pojawiają się obok siebie w wynikach wyszukiwania tylko dlatego, że wiele osób zakłada, iż „web scraper” to jedna kategoria produktu. A nie jest.
Thunderbit: bezkodowy AI Web Scraper dla zespołów biznesowych
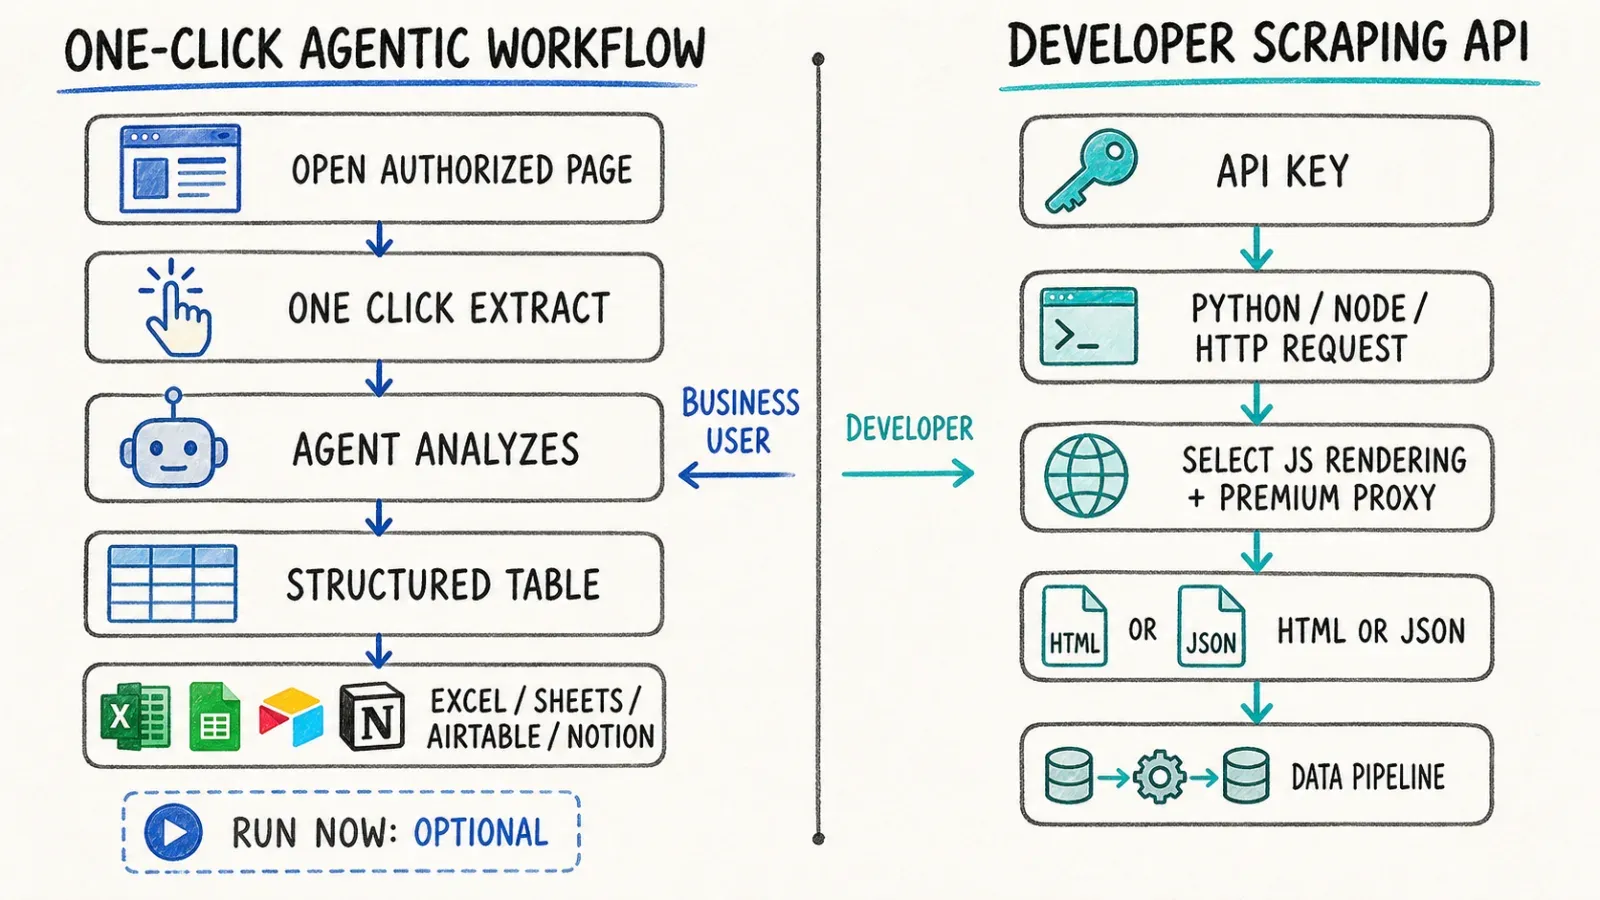
Thunderbit zaczął jako rozszerzenie do przeglądarki stworzone dla osób, które potrzebują danych ze strony internetowej i nie mają najmniejszej ochoty pisać parsera. Całe doświadczenie opiera się na rozszerzeniu Thunderbit do Chrome: otwierasz stronę, klikasz One Click Extract, a agent sam analizuje stronę, rozpoznaje, jakie dane mają sens do pobrania, i samodzielnie przygotowuje pola. Jest też przycisk Run Now, jeśli chcesz uruchomić wszystko od razu, ale jeśli po prostu siedzisz i pijesz kawę, ekstrakcja i tak startuje automatycznie. Jedno kliknięcie, bez budowania schematu, bez selektorów CSS.

To właśnie ten widok większość osób ma na myśli, gdy słyszy „Thunderbit”. Ale mój zespół zbudował też Open API, MCP Server oraz CLI dla deweloperów, którzy chcą tę samą inteligencję ekstrakcji podpiąć do backendowego pipeline’u albo agenta AI zamiast karty w przeglądarce. Chcę to powiedzieć wprost: rozszerzenie i API to nie jest ten sam produkt w różnych przebraniach. To różne interfejsy do różnych zadań — i wrócę do tej różnicy jeszcze niżej, bo ma ogromne znaczenie przy pytaniu „którego narzędzia naprawdę potrzebuję?”.
ZenRows: API do scrapingu webowego stworzone z myślą o deweloperach
ZenRows to infrastruktura. To nie jest coś, w czym klikasz przycisk i eksportujesz arkusz kalkulacyjny — to API wywoływane z Pythona lub Node, a zwracany wynik to HTML, Markdown albo dane ustrukturyzowane, zależnie od konfiguracji requestu. Rodzina produktów obejmuje Universal Scraper API, Scraping Browser do automatyzacji interaktywnej (klikanie, wpisywanie, nawigacja), Residential Proxies do geotargetingu oraz własny MCP Server do workflowów agentowych.
Obietnica jest prosta: wysyłasz URL, określasz, czy potrzebujesz renderowania JavaScriptu albo premium proxy, a ZenRows zajmuje się walką z systemami anty-bot — fingerprintingiem, rotacją nagłówków, wyzwaniami Cloudflare i całym tym bałaganem — tak żeby Twój scraper nie został zablokowany. To naprawdę trudna inżynieria i właśnie dlatego ZenRows w ogóle istnieje. Ale wymaga kodu. Każde żądanie przechodzi przez klucz API i zestaw parametrów. Nie ma tam opcji „kliknij tutaj” dla kogoś z marketingu, kto po prostu chce CSV.
Thunderbit vs ZenRows: pełna tabela porównawcza
Przejrzałem strony, które rankują najwyżej na frazę „Thunderbit vs ZenRows”, zanim zacząłem pisać ten tekst, i szczerze mówiąc, jest tam sporo chaosu. Własny wpis ZenRows wrzuca Thunderbit jako jedną z siedmiu pozycji w ogólnym zestawieniu narzędzi. Strona porównawcza na Slashdot pokazuje pusty widget ocen dla obu produktów, co niczego nie wyjaśnia. Artykuł benchmarkowy Scrapeway w ogóle nie uwzględnia Thunderbit. Nikt nie przygotował dotąd bezpośredniej, funkcja-po-funkcji tabeli dla tych dwóch konkretnych produktów, więc oto moja próba.
| Kategoria | ZenRows | Thunderbit |
|---|---|---|
| Główny workflow | Request API + kod (Python/Node) | One Click Extract w rozszerzeniu do przeglądarki — wykrywanie przez agenta, opcjonalny Run Now |
| Najlepsze zastosowanie | Deweloperzy budujący pipeline’y do scrapingu | Użytkownicy biznesowi / jednorazowe lub cykliczne zadania ekstrakcji |
| Anti-bot / CAPTCHA / Cloudflare | Rozwiązanie stworzone do tego celu: rotacja proxy + headless infra | Ekstrakcja w autoryzowanej sesji przeglądarki na zgodnych stronach; nie jest pozycjonowane jako API do omijania zabezpieczeń |
| Strony renderowane przez JS | Tak, przez headless rendering | Tak, na obsługiwanych / kompatybilnych stronach |
| Miejsca eksportu | JSON/CSV przez odpowiedź API | Eksport do Excel, Google Sheets, Airtable, Notion (sprawdź aktualną listę) |
| Czas konfiguracji | Wymaga kodu i ustawienia klucza API | Brak konfiguracji schematu w domyślnym workflow przeglądarkowym |
| Model cenowy | Oparty na kredytach, mnożniki zależne od typu requestu | Przed zakupem sprawdź aktualny plan i strukturę kredytów |
Krótka uwaga, bo już nieraz sparzyłem się na nieaktualnych tabelach cenowych: te dane są zweryfikowane na sierpień 2026. Ceny, jednostki kredytowe i lista integracji eksportu zmieniają się po obu stronach częściej, niż pewnie chciałyby przyznać same firmy. Zanim podejmiesz decyzję zakupową na podstawie tych liczb, sprawdź aktualną stronę cenową ZenRows i stronę cenową Thunderbit.
Jak działa workflow One Click Extract w Thunderbit
Sens całego rozszerzenia do przeglądarki polega na tym, że właściwie nie trzeba się niczego uczyć. Otwierasz stronę, z której chcesz pobrać dane — katalog, listę produktów, tablicę ofert pracy, cokolwiek — i klikasz One Click Extract. Agent analizuje strukturę strony, rozpoznaje, jakie pola mają sens (nazwy, ceny, e-maile, wszystko to, co faktycznie jest dostępne), i przygotowuje je bez Twojego ręcznego wskazywania, czego ma szukać.
Run Now pojawia się jako opcja, ale naprawdę jest opcjonalny. Jeśli nic nie klikniesz, ekstrakcja i tak uruchomi się sama. Rozmawiałem z użytkownikami, którzy nie zdawali sobie z tego sprawy i zakładali, że trzeba kliknąć dwa razy — co zresztą jest zrozumiałe, bo większość programów przyzwyczaja nas do kroku potwierdzenia. Gdy wszystko się zakończy, możesz doprecyzować pola prostymi instrukcjami po ludzku (np. formatowanie numeru telefonu, tłumaczenie kolumny, kategoryzacja wpisów) i wysłać wyniki do Excel, Google Sheets, Airtable albo Notion.
Czym ten workflow nie jest: backendowym pipeline’em. Jeśli potrzebujesz ekstrakcji osadzonej w zadaniu harmonogramowym, systemie RAG albo agencie działającym bez człowieka patrzącego na kartę przeglądarki, do tego służą Open API i MCP Server. Wspominam o tym, bo widziałem już próby wciskania rozszerzenia przeglądarkowego w rolę, do której nie zostało stworzone — to trochę jak próba uruchomienia linii produkcyjnej nożyczkami kuchennymi. Dobre narzędzie, złe zadanie.
Jak działa workflow API do scrapingu w ZenRows
Typowy proces w ZenRows zaczyna się od wygenerowania klucza API, a potem od napisania requestu — zwykle przez ich SDK do Pythona lub Node, choć zwykłe wywołanie HTTP też działa bez problemu. Podajesz docelowy URL i zestaw parametrów: czy potrzebujesz renderowania JavaScriptu, czy chcesz użyć premium proxy, czy odpowiedź ma być w surowym HTML, czy może przekonwertowana do Markdown albo zwykłego tekstu. API wykonuje żądanie przez własną infrastrukturę i zwraca to, o co poprosiłeś.
To właśnie tutaj zaczyna mieć znaczenie system kredytów i warto o tym wspomnieć od razu, bo wrócimy do tego w sekcji cenowej: podstawowy request do statycznej strony kosztuje jeden mnożnik kredytów, ale gdy dodasz renderowanie JavaScriptu albo premium proxy, mnożnik rośnie. Za chwilę pokażę konkretne liczby.
Dla zespołów, które nie chcą budować wokół tego pełnego backendu, ZenRows integruje się też z platformami low-code, takimi jak Zapier, Make i n8n, więc zebrane dane mogą trafić tam, gdzie trzeba, bez konieczności utrzymywania przez lata glue code przez dedykowanego inżyniera. To rozsądny kompromis, choć nadal poruszasz się w świecie API i parametrów, a nie w świecie point-and-click.
Thunderbit vs ZenRows: które narzędzie pasuje do Twojej pracy i poziomu technicznego?
Każdy artykuł porównawczy, jaki czytałem, przedstawia to jak konkurs checklisty funkcji — więcej haczyków wygrywa. Tylko że tak nikt naprawdę nie wybiera narzędzia do scrapingu. Prawdziwe pytanie brzmi: kim jesteś i co właściwie chcesz pobierać, więc tak bym to rozbił, gdyby ktoś zapytał mnie o to przy lunchu.
Wybierz ZenRows, jeśli:
- Jesteś deweloperem scrapującym tysiące stron chronionych przez Cloudflare lub CAPTCHA w kodowanym pipeline’ie
- Twój zespół ma już infrastrukturę do parsowania, retry i składowania danych, a Tobie zależy głównie na niezawodnym dostępie do stron
- Równoległość, precyzyjna kontrola nad proxy i renderingiem są ważniejsze niż szybkość startu
Wybierz Thunderbit, jeśli:
- Jesteś osobą nietechniczną z działu sprzedaży, operacji lub researchu i potrzebujesz listy leadów, katalogu produktów albo danych z ogłoszeń pobranych z otwartej, uprawnionej strony
- Chcesz ominąć pisanie kodu i przejść od „otwieram stronę” do „mam dane w arkuszu”
- Workflow One Click Extract w rozszerzeniu do przeglądarki lepiej pasuje do Twojej codziennej pracy niż edytor kodu
Wybierz Open API albo MCP Server Thunderbit, jeśli:
- Chcesz backendowego, RAG-owego albo zautomatyzowanego dostępu do pipeline’u, ale nie chcesz samodzielnie budować infrastruktury scrapingu na poziomie ZenRows
- Pracujesz już w Claude, Cursor albo innym agencie AI zgodnym z MCP i chcesz mieć ekstrakcję jako wywoływalne narzędzie
Zauważ, że „Thunderbit” pojawia się tu dwa razy w różnych formach — i to celowe. To naprawdę inna decyzja, czy wybierasz rozszerzenie, czy API, a udawanie, że są wymienne, byłoby nie fair wobec czytelników.
Porównanie cen: co tak naprawdę znaczy „taniej” w skali
Tutaj robi się naprawdę ciekawie — i właśnie tu większość artykułów porównawczych albo pomija matematykę, albo liczy ją źle. ZenRows nie pobiera stałej opłaty za request — używa wspólnego salda kredytów z mnożnikami zależnymi od typu strony. Plan reklamowany jako „250 000 requestów” brzmi hojnie, dopóki nie zorientujesz się, że ta liczba zakłada, iż każda strona jest podstawowym, statycznym requestem, a to w realnym świecie prawie nigdy nie ma miejsca.
Jak działa pricing ZenRows oparty na mnożnikach kredytów
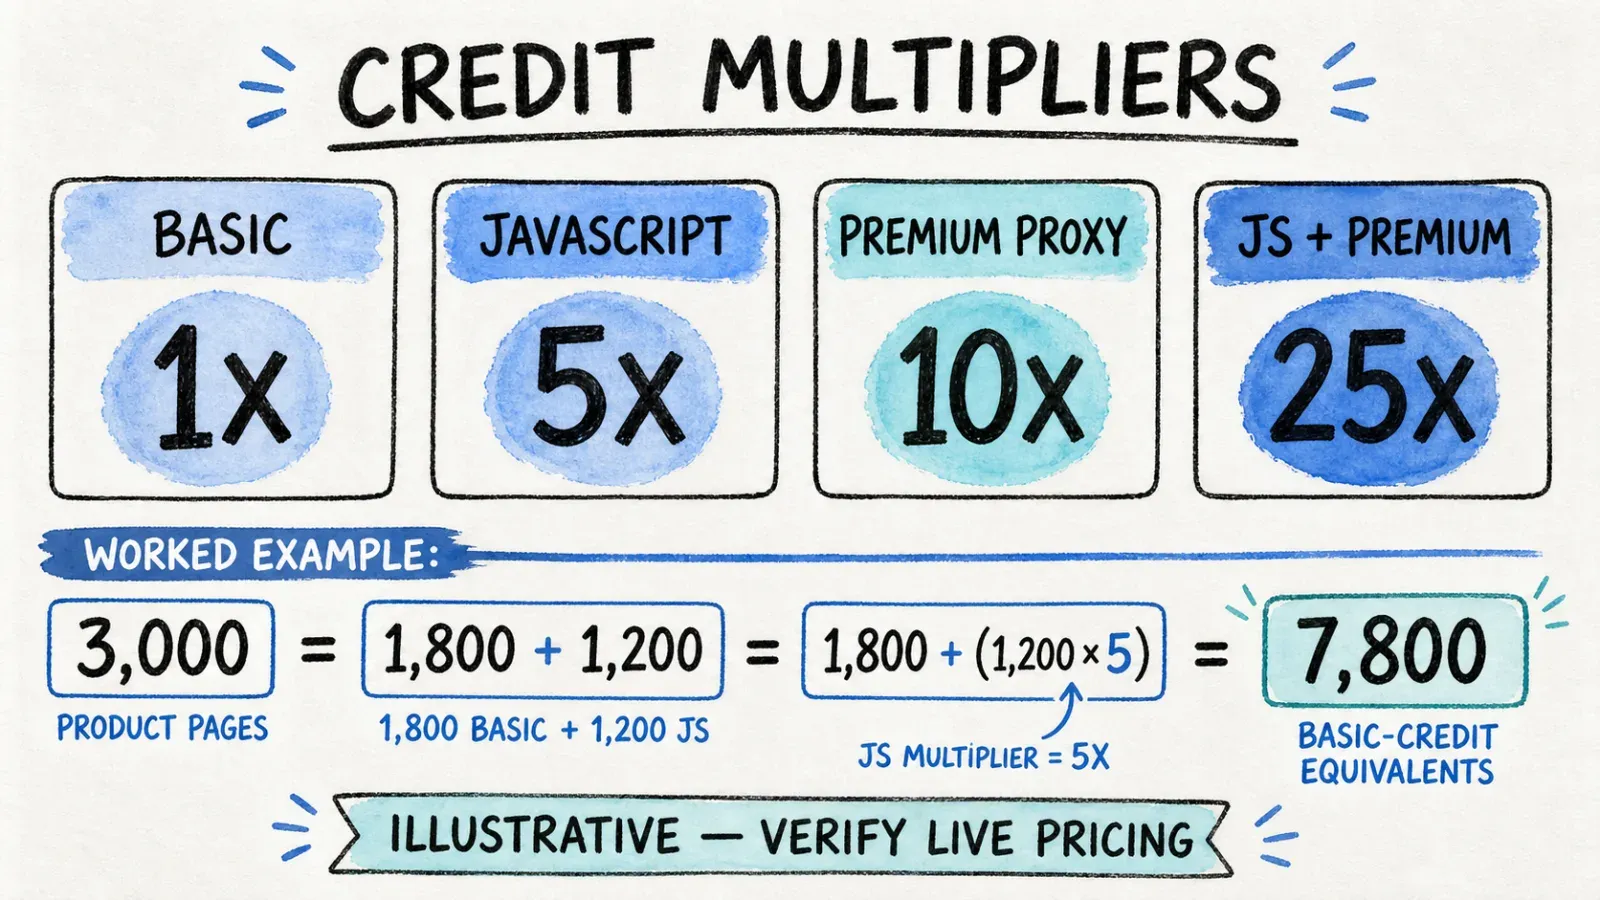
Zgodnie z oficjalną dokumentacją cenową ZenRows aktualne mnożniki dla Universal Scraper API wyglądają następująco: podstawowy request kosztuje 1x kredytów, renderowanie JavaScriptu 5x, premium proxy 10x, a połączenie renderowania JavaScriptu z premium proxy 25x. To naprawdę duża różnica — strona wymagająca jednocześnie JS i premium proxy kosztuje 25 razy więcej niż zwykła statyczna strona.
Jeszcze jeden szczegół, który często umyka: nieudane lub ponawiane requesty nie są rozliczane, co jest uczciwe, ale odpowiedzi HTTP 404 i 410 są nadal uznawane za sukces i są fakturowane. Jeśli więc na Twojej liście trafiają się martwe linki, płacisz również za nie.
Aktualne standardowe plany, według tych samych dokumentów: Trial daje $1 wspólnego limitu (mniej więcej 1000 podstawowych requestów, 200 tylko z JS, 100 tylko z premium proxy albo 40 w pełni chronionych wyników). Developer kosztuje $69.99 miesięcznie za 250 000 podstawowych requestów albo 10 000 chronionych wyników z 20 równoległymi połączeniami. Startup rośnie do $129.99 miesięcznie za 1 milion podstawowych albo 40 000 chronionych, przy 50 równoległościach. Business zaczyna się od $299.99 miesięcznie za 3 miliony podstawowych albo 120 000 chronionych requestów, przy 100 równoległościach, a wyższe poziomy Business mieszczą się w przedziale od $499.99 do $2,999.99 miesięcznie, zanim wejdziesz w cenę Enterprise ustalaną indywidualnie.
Model cenowy Thunderbit
Struktura Thunderbit działa inaczej — opiera się na poziomach planów powiązanych z workflowem w przeglądarce, a nie na systemie mnożników per request, ponieważ większość użytkowników uruchamia zadania ekstrakcji na pojedynczych stronach, a nie wykonuje tysiące programowych wywołań API. Nie chcę podawać tu konkretnych liczb kredytów, bo plany potrafią się zmieniać, a nie chciałbym, żeby nieaktualne dane źle wpłynęły na budżet. Aktualne poziomy sprawdź bezpośrednio na stronie cenowej Thunderbit przed podjęciem decyzji.
To, co mogę powiedzieć z pełnym przekonaniem: w workflowie przeglądarkowym nie ma ukrytego mnożnika 25x. Nie płacisz dramatycznie więcej tylko dlatego, że strona załadowała JavaScript. I właśnie na tym polega sens narzędzia opartego o przeglądarkę — ekstrakcja dzieje się w prawdziwej sesji przeglądarki, więc pytanie „czy ta strona renderuje się przez JS” nie jest tu kwestią cenową w taki sam sposób, jak w API, które musi uruchamiać headless rendering na żądanie.
Przykład praktyczny: scrapowanie 1000–5000 stron produktowych
Załóżmy, że potrzebujesz danych produktowych z 3000 stron e-commerce i mniej więcej 40% z nich wymaga renderowania JavaScriptu, żeby załadować ceny (co jest bardzo częste w nowoczesnych sklepach). W ZenRows oznacza to około 1800 stron w podstawowej stawce i 1200 stron z mnożnikiem 5x za JS — czyli Twoje „3000 stron” zużywa kredyty odpowiadające mniej więcej 7800 podstawowym requestom (1800 + 1200×5). Jeśli którakolwiek z tych stron jest dodatkowo chroniona przez anti-bot wymagający premium proxy, liczba rośnie bardzo szybko, bo mnożnik dla połączenia JS + premium proxy wynosi 25x.
W rozszerzeniu Thunderbit uruchamiałbyś One Click Extract strona po stronie (albo korzystał z paginacji / wzbogacania podstron w kompatybilnych workflowach list-to-detail), a model kosztowy nie zmienia się drastycznie tylko dlatego, że dana strona akurat renderuje JavaScript — wszystko zależy od poziomu planu, a nie od mnożnika per strona. Przy takim zadaniu to zupełnie inna rozmowa o kosztach.
Chcę podkreślić bardzo wyraźnie: to tylko przykład, nie wycena. Realne koszty zależą od poziomu zabezpieczeń konkretnej strony, Twojego planu i tego, co pokazują aktualne strony z cennikiem w dniu sprawdzenia. Traktuj ten przykład jako sposób na zrozumienie problemu mnożników, a nie jako liczbę, na której powinieneś budować budżet.
Success rate i obsługa anti-bot: dlaczego to nie jest porównanie 1:1
Kilka stron benchmarkowych (między innymi Scrapeway i numerous.ai) publikuje procenty skuteczności ZenRows przeciwko wyjątkowo trudnym celom, takim jak Amazon, Zillow czy Walmart. Te liczby są przydatne, jeśli porównujesz między sobą API do omijania zabezpieczeń. O Thunderbit mówią jednak bardzo niewiele, bo Thunderbit nigdy nie był budowany do rozwiązania tego samego problemu.
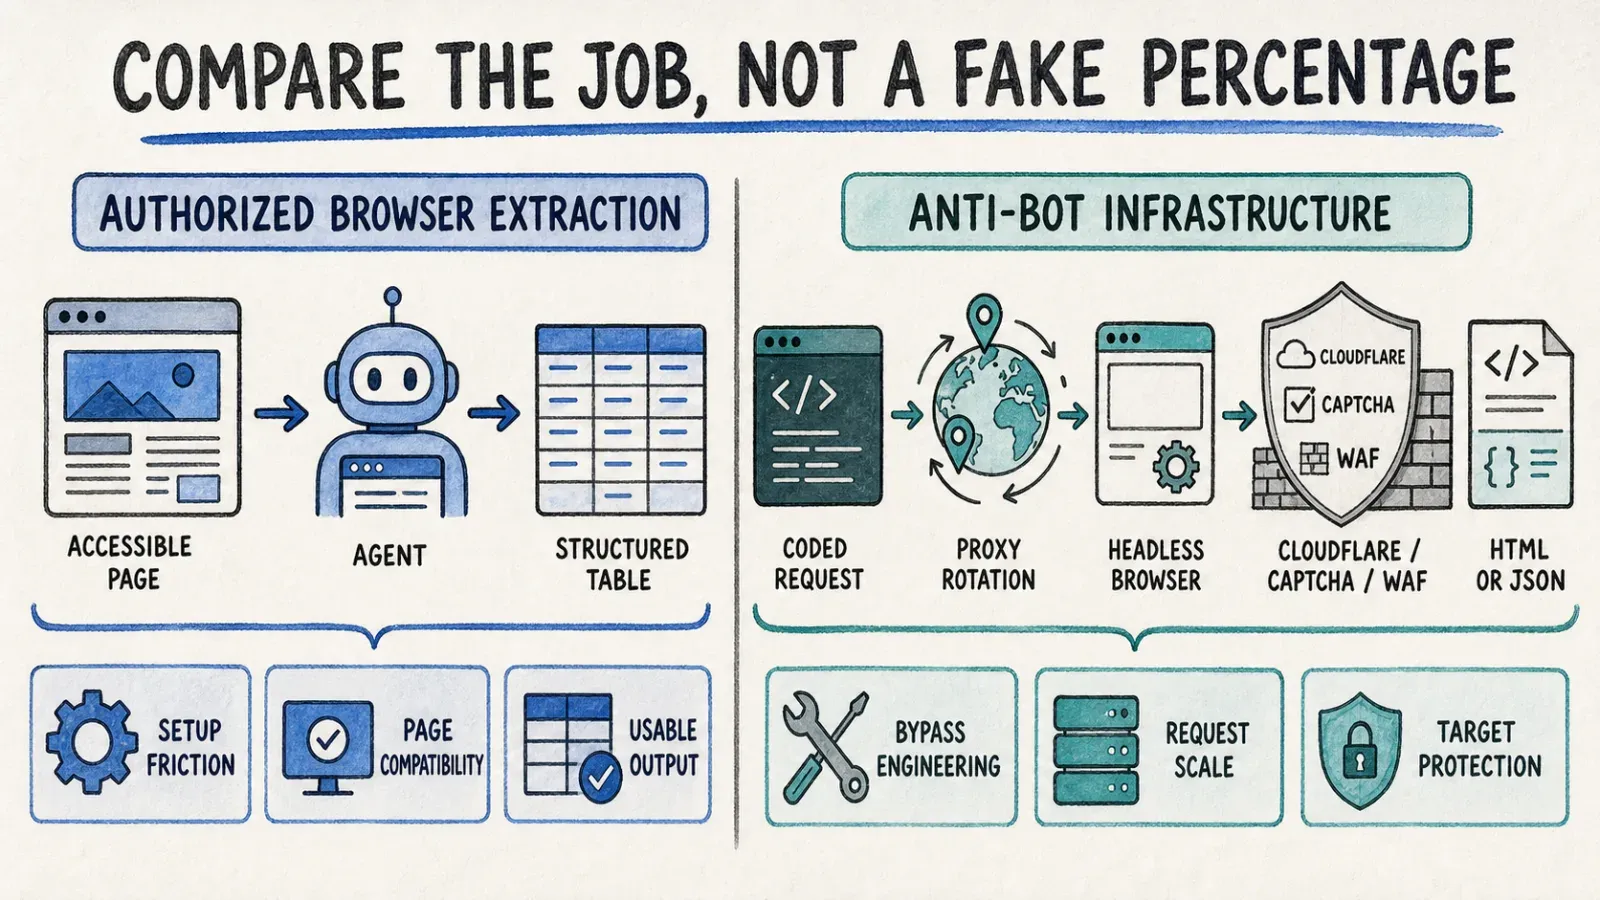
ZenRows istnieje po to, by na dużą skalę pokonywać CAPTCHA, wyzwania Cloudflare i web application firewalle, korzystając z rotacji proxy oraz headless infrastruktury zaprojektowanej dokładnie do tej walki. Thunderbit wykonuje ekstrakcję w autoryzowanej sesji przeglądarki na stronach, do których i tak masz dostęp — to agentowy scraper do wyciągania ustrukturyzowanych danych ze strony, a nie usługa stworzona do przebijania się przez zabezpieczenia witryn aktywnie blokujących boty. Publikowanie fikcyjnego „success rate Thunderbit przeciwko systemowi anti-bot Amazona” byłoby nieuczciwe, bo to po prostu nie jest zadanie, do którego ten produkt został stworzony.
Uczciwsze porównanie dotyczy tarcia przy konfiguracji, modelu autoryzacji i zgodności z typem strony docelowej. One-click w Thunderbit naprawdę oznacza jedno kliknięcie — ale tylko na kompatybilnych, autoryzowanych stronach, a nie jako gwarancja działania na każdej witrynie czy w każdym środowisku anti-bot w internecie. Jeśli próbujesz scrapować stronę, która aktywnie walczy z automatycznym dostępem przy użyciu reguł enterprise-grade WAF, to jest terytorium ZenRows, i udawanie czegoś innego byłoby robieniem krzywdy czytelnikom.
Eksport, integracje i to, gdzie trafiają Twoje dane
ZenRows zwraca JSON lub HTML w odpowiedzi API, co oznacza, że to Ty (albo podłączone narzędzie automatyzujące) odpowiadasz za przekierowanie tego dalej — do bazy danych, arkusza kalkulacyjnego czy data warehouse. To nie zarzut wobec ZenRows; po prostu tak działa infrastrukturalne API. Daje Ci surowy materiał i zakłada, że resztę zbudujesz sam.
Thunderbit eksportuje bezpośrednio do miejsc, w których zespoły biznesowe już pracują na co dzień: Excel, Google Sheets, Airtable i Notion — bez pisania choćby jednej linijki kodu. Dla osób zajmujących się lead generation albo pobieraniem danych produktowych e-commerce, różnica jest taka, jak między „mam teraz plik JSON” a „mam arkusz, który mogę od razu wysłać managerowi”.
Oba narzędzia można też podpiąć pod szersze platformy automatyzacji, takie jak Zapier, Make czy n8n, jeśli routing ma być bardziej złożony, więc żadne z nich nie jest ograniczone tylko do domyślnej ścieżki eksportu, jeśli potrzebujesz bardziej wyszukanego workflowu.
Aspekty prawne i compliance przy wyborze scrapera
Będę krótki, bo to wymaga wzmianki, a nie wykładu. Oba narzędzia powinny być używane do zbierania danych publicznych albo w inny sposób autoryzowanych, z poszanowaniem regulaminu serwisu, zasad robots oraz obowiązujących przepisów o prywatności, takich jak GDPR czy CCPA, w zależności od tego, gdzie znajdują się Twoje dane i użytkownicy. Ani Thunderbit, ani ZenRows — i mówiąc szczerze, żadne narzędzie do scrapingu — nie gwarantuje automatycznej zgodności prawnej. Odpowiedzialność spoczywa na osobie uruchamiającej zadanie, a nie na oprogramowaniu.
Podsumowanie: Thunderbit czy ZenRows — co wybrać?
Szczera odpowiedź brzmi: te dwa narzędzia powstały do rozwiązywania różnych problemów, a wybieranie „zwycięzcy” byłoby trochę jak pytanie, czy lepszy jest rower, czy ciężarówka dostawcza. Thunderbit to bezkodowa, przeglądarkowa ścieżka dla użytkowników biznesowych, którzy chcą szybkiej, autoryzowanej ekstrakcji bez dotykania edytora kodu — a jeśli potrzebujesz tej samej inteligencji w backendzie, Open API albo MCP Server obsłuży to bez konieczności budowania infrastruktury na poziomie ZenRows. ZenRows to API stworzone dla deweloperów budujących kodowane pipeline’y do chronionych, dużych wolumenów danych, gdzie obejście anti-bot jest faktycznym problemem inżynieryjnym do rozwiązania.
Dobierz narzędzie do zadania, które masz przed sobą, a nie do ogólnej listy funkcji. Jeśli nadal nie masz pewności, do której grupy należysz, to zwykle dobry znak, że nie potrzebujesz jeszcze cięższej infrastruktury — a mój zespół zbudował rozszerzenie Thunderbit do Chrome właśnie dla osób, które wolą kliknąć przycisk niż pisać scraper od zera.
FAQ
Czy Thunderbit nadaje się dla osób bez kodowania? Tak — to cały fundament tego produktu. Workflow One Click Extract w rozszerzeniu do przeglądarki oznacza, że agent sam analizuje stronę i przygotowuje pola; nie piszesz selektorów, nie budujesz schematu i nie dotykasz kodu. Run Now jest opcjonalny, bo ekstrakcja startuje automatycznie, jeśli nic nie klikniesz. Właśnie dlatego Thunderbit dobrze pasuje do zespołów sprzedaży, operacji i researchu, które potrzebują danych bez pisania kodu.
Czy ZenRows omija Cloudflare i CAPTCHA? Tak, to kluczowy element jego projektu. ZenRows korzysta z rotacji proxy, zarządzania nagłówkami i fingerprintem oraz Adaptive Stealth Mode, żeby przechodzić przez systemy anti-bot, takie jak Cloudflare i CAPTCHA. Najnowsze szczegóły dotyczące działania na konkretnych warstwach ochrony sprawdzaj bezpośrednio w dokumentacji Universal Scraper API ZenRows, bo taktyki anti-bot po obu stronach stale się zmieniają.
Co jest tańsze: Thunderbit czy ZenRows? To bardzo zależy od typu zadania i skali. Mnożniki kredytów w ZenRows oznaczają, że strony renderowane przez JavaScript lub chronione proxy mogą kosztować nawet 25 razy więcej niż podstawowe strony statyczne, co może po cichu bardzo zmniejszyć realną przepustowość „taniego” planu. Plany Thunderbit oparte na przeglądarce nie mają takiej struktury mnożników per strona. Policz to na własnym przykładzie, korzystając z przykładu powyżej i zawsze sprawdzaj aktualne ceny na stronie cenowej ZenRows oraz stronie cenowej Thunderbit, zanim podejmiesz decyzję.
Czy Thunderbit może zastąpić API w backendowych pipeline’ach danych? Sam rozszerzeniowy interfejs nie jest do tego przeznaczony — został stworzony do bezkodowej ekstrakcji z aktualnie otwartej strony, gdy użytkownik klika przycisk. Do pracy backendowej, harmonogramowej albo agentowej właściwym interfejsem są Open API lub MCP Server, które dają deweloperom programowy dostęp bez konieczności budowania infrastruktury w stylu ZenRows od zera.
Czy mogę używać Thunderbit i ZenRows razem? Tak, i wcale nie jest to dziwne połączenie. Niektóre zespoły używają ZenRows do obsługi surowego dostępu do mocno chronionych, dużych wolumenów danych w customowym pipeline’ie, a Thunderbit do ad hocowych zadań biznesowych, szybkich list leadów czy zadań dla agentów, które nie wymagają aż tak rozbudowanej inżynierii anti-bot. Te narzędzia rozwiązują różne warstwy tego samego szerszego problemu, więc nic nie stoi na przeszkodzie, by używać obu — zależnie od zadania, które akurat masz przed sobą.




