
Dostaję o te dwa narzędzia pytania bardzo często i szczerze mówiąc, to jeden z ciekawszych tematów, bo oba produkty korzystają dziś z AI w zupełnie różnych częściach workflow, a użytkownicy wciąż próbują zrozumieć, co te różnice oznaczają w praktyce. Zamiast powtarzać marketingowe hasła, przyjrzyjmy się temu naprawdę.
Krótko mówiąc: Thunderbit jest stworzone dla osoby, która otwiera stronę i chce jednym kliknięciem wyciągnąć z niej uporządkowane dane — bez selektorów i bez konfiguracji. Simplescraper opiera się na wielokrotnego użytku „Recipes” — konfigurujesz ekstrakcję raz (coraz częściej z pomocą AI), zapisujesz ją i uruchamiasz ponownie przez API, harmonogramy albo integracje. Oba narzędzia są sensowne. Po prostu optymalizują różne momenty pracy.
Krótka odpowiedź
Jeśli należysz do osób, które w tygodniu otwierają dziesięć różnych stron i po prostu potrzebują z nich danych — list sprzedażowych, katalogów produktów, spisów firm — jednoklikowy proces Thunderbit będzie wydawał się szybszy, bo prawie nic nie trzeba konfigurować.
Jeśli budujesz cykliczny pipeline danych, który ma działać według harmonogramu, wywoływać webhooki albo zasilać szerszy system oparty o API, model Recipes w Simplescraper daje Ci bardziej wielorazową infrastrukturę.
I uczciwie wobec Simplescraper — widziałem wiele porównań opisujących je jako narzędzie tylko z ręcznymi selektorami, a to już nie jest prawdą. Simplescraper ma teraz Smart Extract, gdzie opisujesz po angielsku, czego potrzebujesz, a narzędzie generuje za Ciebie selektory CSS. AI też jest tu obecne. Prawdziwa różnica nie polega więc na „AI vs brak AI” — tylko na tym, co dzieje się po pierwszej ekstrakcji i ile struktury do ponownego użycia musisz utrzymywać.
Thunderbit vs Simplescraper w pigułce
| Kategoria | Thunderbit | Simplescraper |
|---|---|---|
| Główny model | Agentowy — interpretuje bieżącą stronę w czasie działania | Oparty na Recipes — buduje wielokrotnego użytku selektory, z pomocą AI lub ręcznie |
| Pierwsze uruchomienie | Kliknij One Click Extract; agent wykrywa pola i uruchamia się automatycznie (Run Now jest opcjonalne) | Utwórz Recipe metodą point-and-click albo przez Smart Extract (opisz pola prostym językiem) |
| Ekstrakcja AI | Tak — agentowe wykrywanie na poziomie strony | Tak — Smart Extract generuje selektory na podstawie opisu schematu |
| Zapisana konfiguracja do ponownego użycia | Nie jest to rdzeń modelu (ekstrakcja jest za każdym razem interpretowana od nowa) | Tak — Recipes to główny wielokrotnego użytku element |
| Przeglądarka + chmura | Tak | Tak |
| Głębokie scrapowanie / podstrony | Obsługiwane na kompatybilnych stronach | Obsługiwane (deep scraping, infinite scroll, logowanie) |
| Dedykowane API | Open API | Scrape API z zarządzaniem Recipes, uruchomieniami zbiorczymi i bezpośrednią ekstrakcją |
| Integracja MCP / z agentami AI | MCP Server + CLI | Nie pozycjonowane jako narzędzie natywnie MCP |
| Zrzuty ekranu / wyjście Markdown | Nie jest to podstawowa funkcja | Tak — dedykowane API do screenshotów i ekstrakcji Markdown |
| AI po ekstrakcji | Instrukcje na poziomie pól podczas ekstrakcji | AI Enhance — osobny etap podsumowania / transformacji po scrape |
| Model kredytów / cen | Zobacz cennik Thunderbit | Model kredytowy: 1 kredyt/strona (bez JS), 2 kredyty/strona (z JS, domyślnie włączone) |
⚠️ Krótka uwaga o szczerości: takie tabele funkcji bardzo szybko się dezaktualizują. Obaj dostawcy regularnie aktualizują dokumentację i ceny, więc traktuj to jako migawkę z badań wykonanych w połowie 2026 roku, a nie niezmienną prawdę.
Czym jest Thunderbit?
Thunderbit to agentowy web scraper stworzony dla użytkowników biznesowych — dla osób, które potrzebują danych ze strony, ale nie chcą myśleć o selektorach CSS, strukturze DOM ani schematach API. Nasz zespół oparł to na dość prostej idei: większość osób chce po prostu spojrzeć na stronę, kliknąć przycisk i dostać czystą tabelę.

Tak wygląda rzeczywisty, aktualny proces — nie stary interfejs, który nadal opisują niektóre starsze recenzje:
- Otwierasz stronę, do której masz uprawniony dostęp.
- Klikasz One Click Extract.
- Agent Thunderbit wykrywa strukturę strony, czyta ją, analizuje, co jest przydatne, i automatycznie przygotowuje pola.
- Uruchamia się sam. Run Now jest dostępne, jeśli chcesz start natychmiast, ale to opcja — jeśli nic nie zrobisz, ekstrakcja i tak wystartuje sama.
To wszystko. Żadnego wieloetapowego tańca typu „zasugeruj pola, potem sprawdź, potem edytuj, potem scrapuj”, który opisują starsze wersje i część nieaktualnych recenzji. Na kompatybilnej stronie naprawdę wystarczy jeden klik.
Poza tym pojedynczym scenariuszem Thunderbit obsługuje też paginację i wzbogacanie danych z podstron na kompatybilnych witrynach, uruchamianie w przeglądarce i w chmurze w zależności od zadania, Web App, Open API dla developerów, MCP Server dla agentów AI takich jak Claude czy Cursor, CLI do pracy w terminalu oraz eksport do Excel, Google Sheets, Airtable i Notion.
Czym jest Simplescraper?
Simplescraper to rozszerzenie przeglądarki oraz platforma cloud/API, a cała architektura kręci się wokół czegoś, co nazywa się Recipe — zapisaną konfiguracją ekstrakcji, którą tworzysz raz i używasz wielokrotnie.
Dziś Recipe możesz zbudować na dwa sposoby:
- Point-and-click: ręcznie zaznaczasz na stronie elementy, które chcesz przechwycić, a Simplescraper generuje selektory CSS w tle.
- Smart Extract: opisujesz prostym angielskim, jakie dane chcesz dostać, a AI proponuje schemat i generuje wielokrotnego użytku selektory.
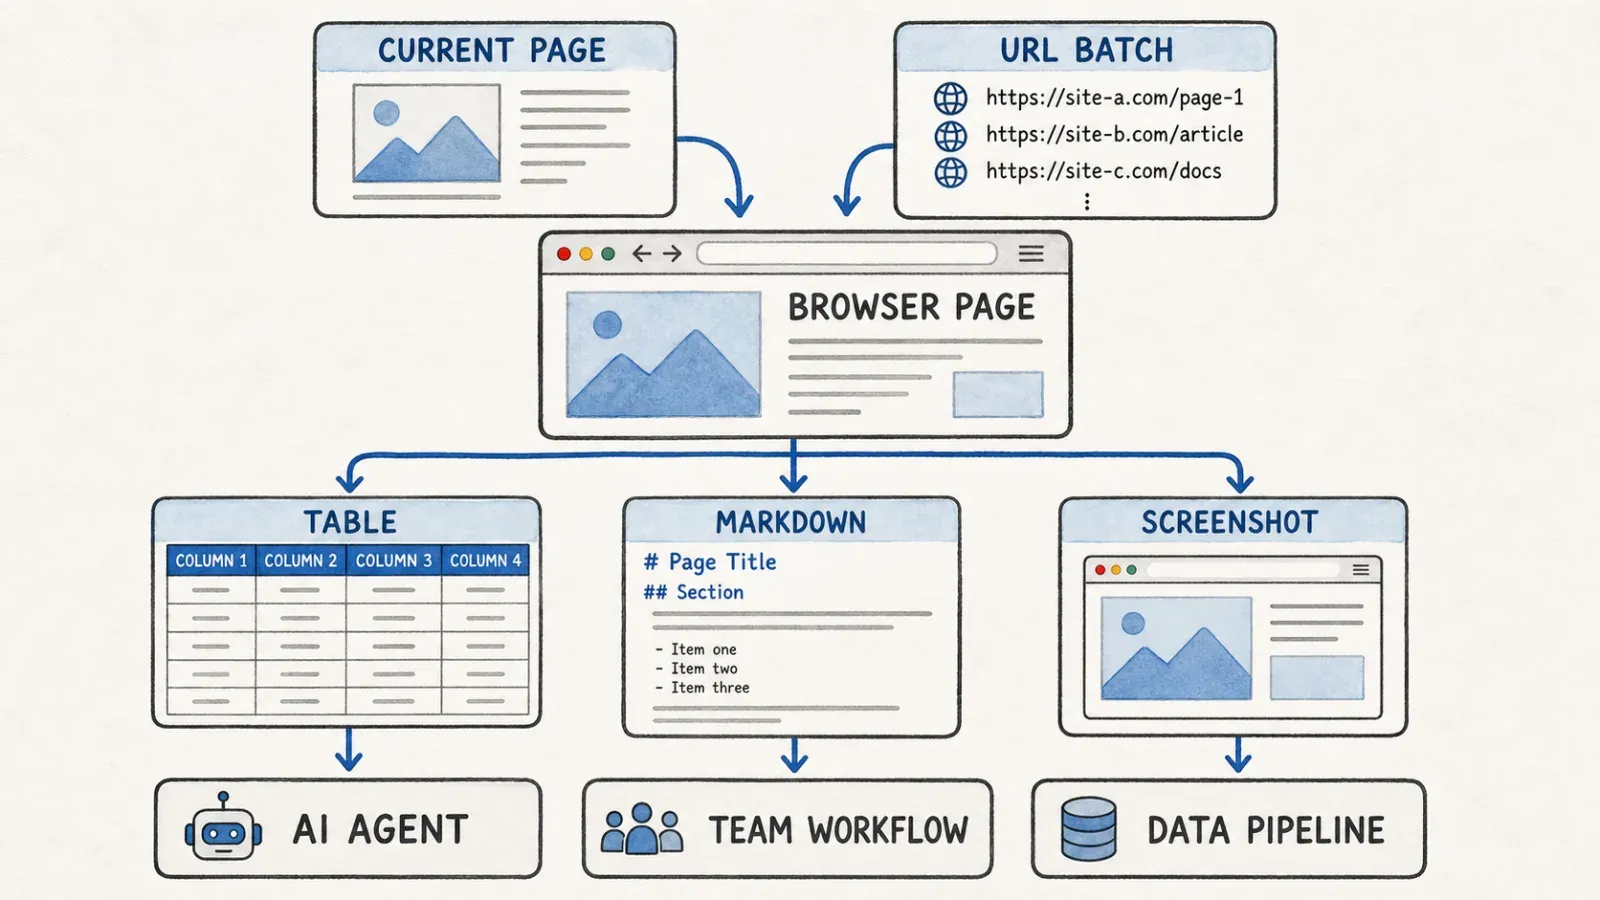
Gdy masz już Recipe, możesz uruchamiać je na listach URL-i, planować cykliczne uruchomienia, wyzwalać webhooki po zakończeniu, wysyłać wyniki do Google Sheets lub Airtable albo używać ich programowo przez Scrape API. Jest też API do screenshotów, ekstrakcja Markdown (przydatna, jeśli karmisz treściami pipeline LLM), scrapowanie wyników wyszukiwania oraz funkcje deep scraping, takie jak obsługa infinite scroll i sesji logowania.
Jest również AI Enhance, niezależne od Smart Extract — to etap po ekstrakcji, który przekształca, podsumowuje lub wzbogaca dane, które już zostały pobrane. Traktuj to jako warstwę czyszczenia i analizy po scrapowaniu, a nie podczas wstępnego wykrywania pól.
Kluczowa różnica: agentowa interpretacja w czasie działania vs wielokrotnego użytku Recipes generowane przez AI
Jednoklikowy workflow Thunderbit oparty na bieżącej stronie
Thunderbit tak naprawdę nie buduje trwałego „recipe” w tradycyjnym sensie. Za każdym razem, gdy klikasz One Click Extract, agent na świeżo analizuje stronę, rozpoznaje, co jest uporządkowane i użyteczne, i wyciąga dane. Możesz dodać naturalne instrukcje doprecyzowujące („uwzględnij tylko oferty z ceną”, „przetłumacz kolumnę opisu na angielski”), ale nie utrzymujesz osobnego artefaktu, który trzeba aktualizować przy zmianach układu strony — agent interpretuje wszystko od nowa za każdym uruchomieniem.
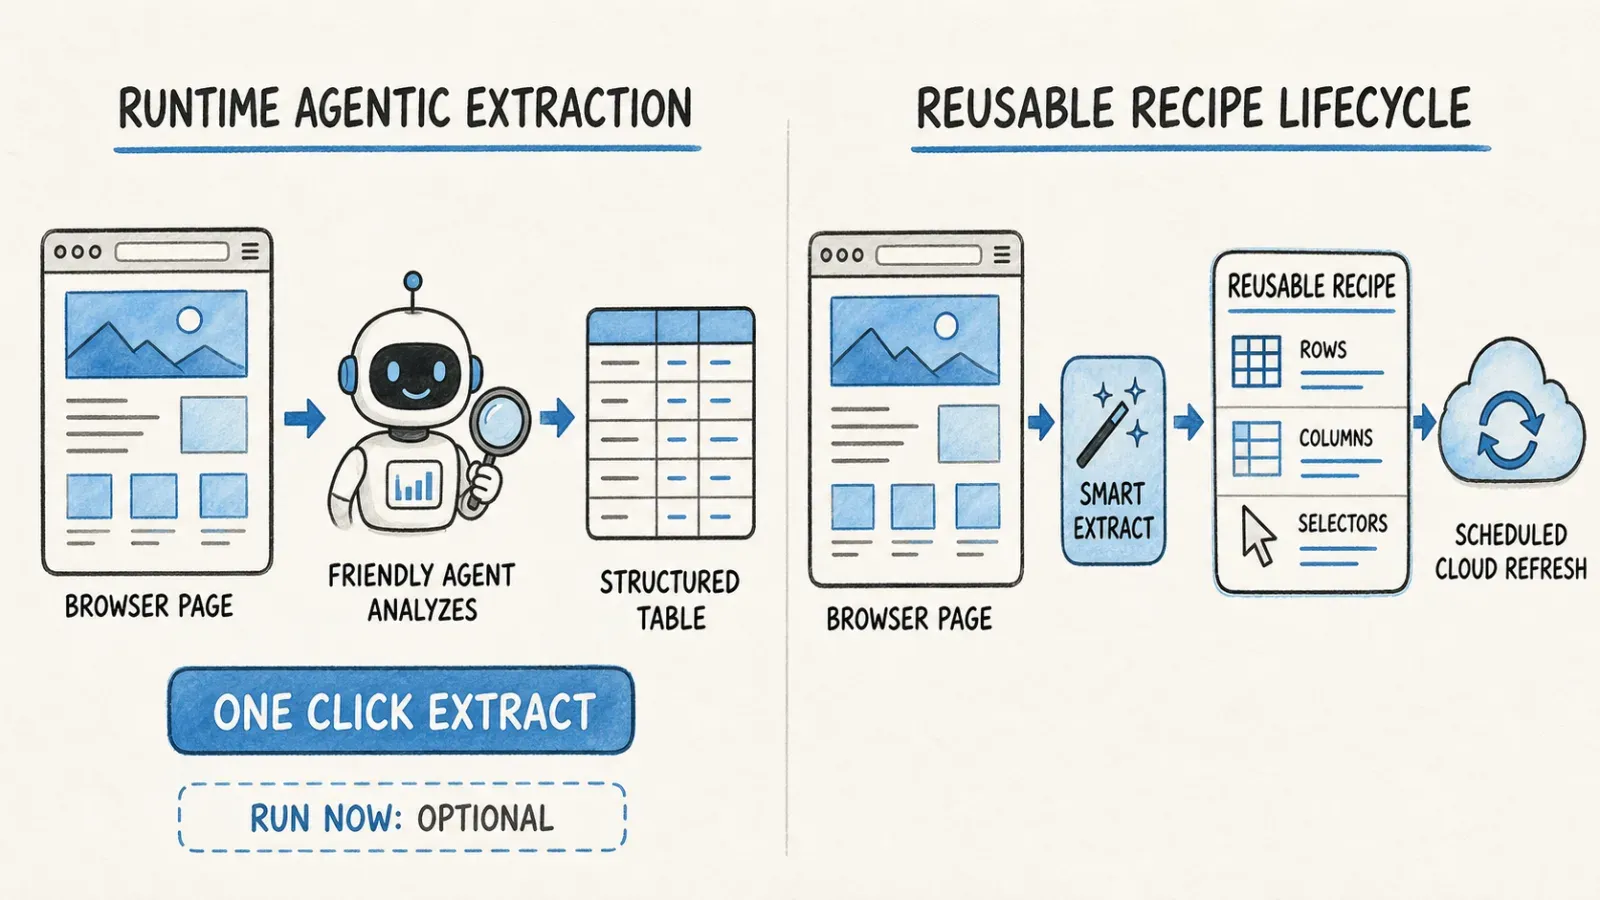
Smart Extract i cykl życia Recipe w Simplescraper
Model Simplescraper jest zbudowany przede wszystkim wokół tworzenia czegoś, co da się używać wielokrotnie. Nawet jeśli Smart Extract generuje selektory przy pomocy AI, końcowy efekt nadal jest Recipe — zapisaną konfiguracją opartą o konkretne selektory CSS, które Simplescraper będzie ponownie uruchamiać. To staje się zasobem w Twoim koncie: można to zaplanować, uruchamiać zbiorczo, udostępniać i wersjonować.
Co się dzieje, gdy strona się zmienia
Tu robi się ciekawie. Jeśli docelowa strona zmieni układ, zapisane selektory CSS w Recipe Simplescraper mogą się zepsuć — nawet te wygenerowane przez AI, bo zostały zamrożone w momencie tworzenia. Zwykle trzeba ponownie uruchomić Smart Extract albo ręcznie poprawić Recipe.
Podejście agentowe Thunderbit oznacza, że każda ekstrakcja interpretuje stronę od nowa, więc teoretycznie lepiej radzi sobie ze zmianami układu — ale to nie magia. Przy nietypowych layoutach, mocno zaciemnionym HTML-u albo stronach chronionych agresywnymi zabezpieczeniami anti-bot agentowe wykrywanie również nie daje gwarancji. Żadne z tych podejść nie jest niezawodne; po prostu zawodzą inaczej. Recipes w Simplescraper psują się przewidywalnie (łatwo zdiagnozować uszkodzony selektor). Runtime interpretation w Thunderbit czasem może zaproponować inną strukturę niż się spodziewasz, więc warto szybko sprawdzić wynik ręcznie.
Porównanie workflow w praktyce
Ad hoc ekstrakcja listy / tabeli
Thunderbit: otwierasz stronę, klikasz One Click Extract i gotowe. Simplescraper: otwierasz rozszerzenie, tworzysz lub uruchamiasz Recipe (Smart Extract, jeśli to nowe zadanie, albo wybierasz zapisane), i ekstrahujesz.
W jednorazowym zadaniu na stronie, której nigdy wcześniej nie scrapowałeś, proces Thunderbit ma mniej kroków, bo nic nie trzeba zapisywać ani konfigurować.
Powtarzalne scrapowanie według harmonogramu
To naturalne środowisko Simplescraper. Zapisujesz Recipe, przypisujesz harmonogram, pozwalasz mu działać cyklicznie na tej samej strukturze strony i kierujesz wyniki przez webhook albo integrację z Sheets. Thunderbit obsługuje harmonogramy tam, gdzie plan i zakres funkcji to umożliwiają, ale główny kierunek projektu to interaktywna ekstrakcja strona po stronie, a nie długotrwały, bezobsługowy Recipe.
Wiele URL-i i workflow z podstronami szczegółów
Oba narzędzia to obsługują — Simplescraper przez listy URL-i i deep scraping do podstron szczegółowych z poziomu strony listy; Thunderbit przez wzbogacanie podstron na kompatybilnych stronach (najpierw wyciągasz listę, a potem automatycznie odwiedzasz stronę szczegółową każdego elementu, aby pobrać więcej pól).
Ustrukturyzowana ekstrakcja przez API
API guide Simplescraper opisuje uruchamianie Recipes, bezpośrednią ekstrakcję Markdown/HTML/screenshotów, Smart Extract przez API oraz batch runs do 5,000 URL-i na żądanie (zależnie od kredytów). Open API Thunderbit dokumentuje ustrukturyzowaną ekstrakcję oraz asynchroniczne workflow batchowe dla developerów, którzy chcą wbudować ekstrakcję we własne aplikacje.
Screenshoty lub Markdown dla dalszego przetwarzania przez AI
Simplescraper ma do tego dedykowane endpointy — jeśli karmisz strony do LLM i potrzebujesz czystego Markdown albo wizualnych screenshotów, to jest to dobrze opisany, pierwszoplanowy use case. Główną mocną stroną Thunderbit jest ustrukturyzowana ekstrakcja pól, a nie surowa konwersja strony do Markdown.
Integracja API i agentów
Jeśli jesteś developerem, ta sekcja prawdopodobnie ma większe znaczenie niż porównanie interfejsu wyżej.
API Simplescraper jest naprawdę szerokie: można tworzyć, listować, odczytywać i aktualizować Recipes; pobierać najnowsze albo historyczne wyniki; uruchamiać batch jobs na listach URL-i; korzystać z endpointów do bezpośredniej ekstrakcji Markdown/HTML/screenshotów; wywoływać Smart Extract programowo; a nawet odkrywać URL-e z mapy witryny. Asynchroniczne uruchomienia zwracają identyfikator wyniku, który można odpytywać, a webhooki służą do powiadomień o zakończeniu.
Thunderbit ma inne podejście po stronie developerów i agentów. Oprócz Open API jest też dedykowany MCP Server — to ważne, jeśli pracujesz w Claude, Cursor albo innym hoście AI kompatybilnym z MCP i chcesz, by funkcja ekstrakcji Thunderbit była dostępna jako natywne narzędzie, z którego agent może korzystać bezpośrednio, zamiast pisać własną integrację API. Jest też CLI do skryptów w terminalu albo środowisku agentowym.
Jeśli Twoim priorytetem jest „dojrzałe, uniwersalne API do scrapowania z dużą liczbą możliwości”, dokumentacja Simplescraper obejmuje dziś więcej obszarów. Jeśli priorytetem jest „chcę, żeby mój agent AI korzystał z narzędzia scrapującego natywnie, bez klejenia integracji”, MCP jest bardziej bezpośrednią odpowiedzią — i to jest teren Thunderbit.
Cennik i matematyka kredytów
Zróbmy tu prawdziwe obliczenia, zamiast cytować nominalne liczby, bo właśnie w tym miejscu strony marketingowe potrafią wprowadzać w błąd — nie ze złej woli, tylko dlatego, że „do X stron” zawsze zakłada warunki idealne.
Według oficjalnego cennika Simplescraper zebranych w badaniu:
| Plan | Cena | Kredyty |
|---|---|---|
| Free | $0 | Darmowe scrapowanie w przeglądarce + 100 kredytów startowych w chmurze |
| Plus | $39/mies. | 6,000 kredytów |
| Pro | $70/mies. | 15,000 kredytów |
| Premium | $150/mies. | 40,000 kredytów |
| Scale | $249/mies. | 100,000 kredytów |
A teraz najważniejsza część dla realnego planowania budżetu, z ich dokumentacji kredytów:
- 1 kredyt za stronę bez renderowania JavaScript
- 2 kredyty za stronę z renderowaniem JavaScript — a renderowanie JS jest włączone domyślnie
- AI Enhance kosztuje 1 kredyt za każde 500 słów przetworzonych (licząc łącznie input i output)
Czyli te „6,000 stron” w planie Plus? Jeśli Twoje strony docelowe wymagają renderowania JavaScript (a szczerze mówiąc, większość nowoczesnych stron tego wymaga), realnie mówimy raczej o około 3,000 stron za te same $39. Jeśli do tego dołożysz AI Enhance, liczba spada jeszcze bardziej w zależności od tego, ile tekstu przetwarzasz na jeden wiersz. To nie jest zarzut wobec Simplescraper — ich dokumentacja jest w tej kwestii przejrzysta — po prostu wiele artykułów porównawczych pomija te obliczenia, bo liczenie jest bardziej pracochłonne niż skopiowanie tabeli cen.
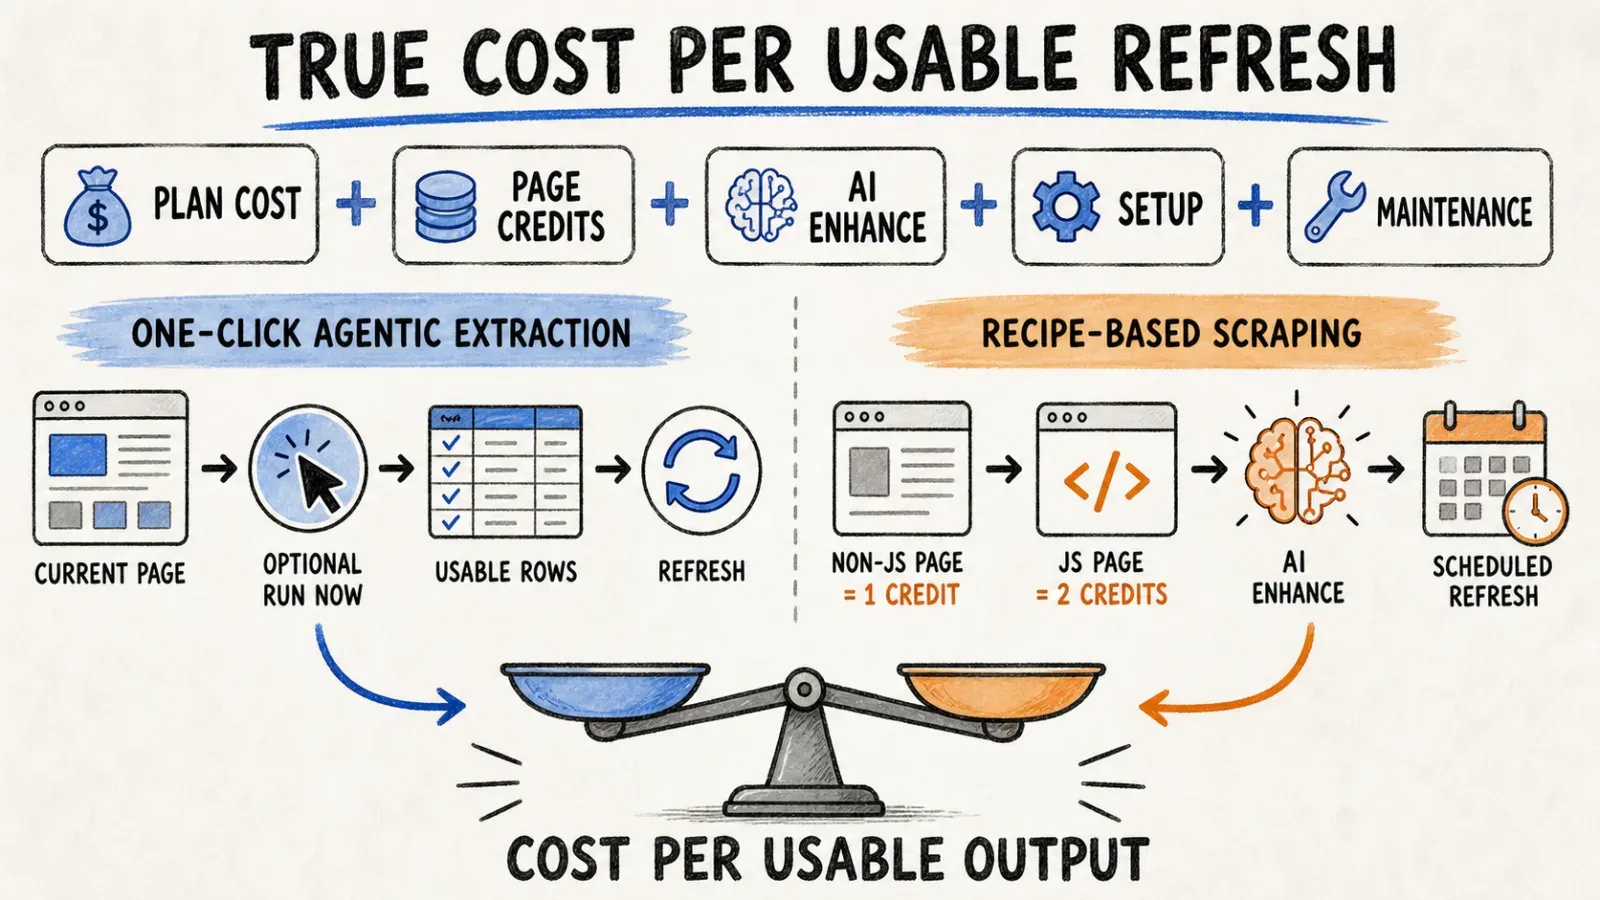
Jeśli chodzi o aktualne ceny Thunderbit, sprawdzaj bezpośrednio stronę z cenami, zamiast ufać skopiowanej liczbie z późniejszego okresu — cenniki się zmieniają, a ja wolę odesłać Cię do źródła niż pracować na nieaktualnym numerze.
Szczera rada: niezależnie od tego, jaki masz faktyczny workload — ta sama strona docelowa, ta sama liczba wierszy, te same pola — przetestuj oba narzędzia na realnym koszcie kredytów lub jednostek, zanim wybierzesz plan. Nominalnej liczby kredytów od różnych dostawców nie da się porównywać 1:1, bo „koszt za jednostkę pracy” zależy od zasad renderowania JS, użycia funkcji AI i tego, jak dana platforma definiuje działanie rozliczane.
Automatyzacja, eksport i przekazanie pracy w zespole
Simplescraper mocno idzie w stronę modelu „ustaw raz i niech działa wiecznie”: harmonogramy, webhooki, natywne integracje z Google Sheets/Airtable/Zapier, a w planie Scale nawet pomoc w konfiguracji Recipes i Live Data Feeds. Jeśli Twój zespół ma stałe potrzeby danych — na przykład cotygodniowy monitoring cen konkurencji — ta infrastruktura jest dokładnie do tego stworzona.
Historia automatyzacji Thunderbit koncentruje się bardziej na tym, by sam moment ekstrakcji był na tyle szybki, że automatyzacja nie zawsze jest potrzebna — ale tam, gdzie ma sens, harmonogramy są obsługiwane w odpowiednich planach, a połączenie browser/cloud/API/MCP pozwala przekazać tę samą bazową funkcję osobie nietechnicznej (przez rozszerzenie przeglądarki) albo developerowi (przez API/MCP), zależnie od tego, kto akurat wykonuje pracę w danym tygodniu.
Prawdziwe pytanie dla Twojego zespołu brzmi: czy utrzymujecie Recipe jako długoterminowy zasób, czy uruchamiacie interpretacyjną ekstrakcję za każdym razem, gdy potrzebujecie świeżych danych? Oba podejścia są dobre — ale generują inne obowiązki utrzymaniowe.
Co wybrać?
Wybierz Thunderbit, jeśli...
Jesteś użytkownikiem biznesowym, handlowcem, osobą pracującą w ecommerce albo researcherem, który potrzebuje danych z konkretnej strony już teraz, nie chce budować ani utrzymywać konfiguracji selektorów i woli, żeby agent za każdym razem interpretował stronę od nowa zamiast zarządzać biblioteką Recipes. To także bardzo dobry wybór, jeśli budujesz workflow z agentem AI i chcesz natywnej integracji MCP zamiast własnego kodu łączącego API.
Wybierz Simplescraper, jeśli...
Budujesz produkcyjny pipeline danych, który ma działać według harmonogramu, wywoływać webhooki, integrować się natywnie z Zapier/Airtable/Sheets albo potrzebujesz screenshotów i ekstrakcji Markdown jako pełnoprawnych wyników. To także lepsze dopasowanie, jeśli Twój zespół swobodnie utrzymuje Recipes i potrzebuje szerokiego, dojrzałego API do własnego developmentu.
Użyj obu, jeśli...
Szczerze? Wiele zespołów kończy właśnie tutaj. Thunderbit sprawdza się przy ad hoc, jednorazowych potrzebach ekstrakcji z dowolnej strony, którą ktoś akurat ogląda danego dnia, a Simplescraper przy dwóch czy trzech powtarzalnych pipeline’ach, które naprawdę korzystają z zaplanowanych Recipes i automatyzacji webhookami. Widziałem ten wzorzec więcej niż raz — różne narzędzia do różnych momentów tego samego workflow, a nie jedna decyzja „zwycięzca bierze wszystko”.
Ostateczny werdykt
Zarówno Thunderbit, jak i Simplescraper to sensowne, nowoczesne narzędzia do scrapowania wspierane przez AI — i chcę to powiedzieć wprost, bo wiele starszych porównań przedstawia ten temat jako „nowe narzędzie AI kontra stary manualny scraper”, a to już nie jest uczciwe wobec Simplescraper. Mają realne możliwości AI extraction dzięki Smart Extract, a AI Enhance to naprawdę użyteczna warstwa post-processingu.
Prawdziwa decyzja sprowadza się do tego: czy chcesz najkrótszej możliwej drogi od „znalazłem stronę z danymi” do „mam czystą tabelę” — to jest filozofia Thunderbit. Czy może chcesz budować wielokrotnego użytku, planowalną, opartą o API infrastrukturę ekstrakcji, którą zespół może utrzymywać w czasie — to jest mocna strona Simplescraper.
Moja szczera rekomendacja: wybierz jedno prawdziwe zadanie, które faktycznie musisz wykonać — realną stronę docelową, realny zestaw pól, realną częstotliwość odświeżania — i przepuść je przez oba narzędzia w darmowych planach. Zmierz czas konfiguracji, policz rzeczywistą liczbę użytecznych wierszy, sprawdź, co się stanie przy ponownym uruchomieniu po tygodniu i policz prawdziwy koszt kredytów za zakończoną ekstrakcję, zamiast ufać nominalnym liczbom. Te piętnaście minut testów powie Ci więcej niż jakikolwiek artykuł porównawczy, włącznie z tym.
A jeśli wybierzesz Thunderbit, rozszerzenie Chrome możesz przetestować za darmo — bez karty kredytowej, wystarczy kliknąć One Click Extract na stronie, która Cię interesuje, i zobaczyć, co zwróci.
FAQ
Czy Simplescraper używa AI?
Tak. Funkcja Smart Extract w Simplescraper pozwala opisać pożądaną strukturę danych prostym językiem, a AI generuje schemat oraz wielokrotnego użytku selektory CSS. Jest też AI Enhance — osobna funkcja po ekstrakcji służąca do transformowania, podsumowywania lub wzbogacania już zebranych danych.
Czy Thunderbit wymaga selektorów CSS?
Nie. Agentowy model Thunderbit interpretuje stronę w momencie ekstrakcji — klikasz One Click Extract, a agent wykrywa i proponuje pola bez pisania czy konfigurowania selektorów. Działa to na kompatybilnych stronach; nietypowe układy lub mocno zaciemnione witryny mogą nadal wymagać ręcznej weryfikacji wyników.
Czym jest Recipe w Simplescraper?
Recipe to zapisana, wielokrotnego użytku konfiguracja ekstrakcji w Simplescraper — tworzona albo przez ręczne wybieranie elementów na stronie, albo przez AI-generated selectors z Smart Extract. Recipes można planować, uruchamiać zbiorczo na listach URL-i oraz wyzwalać przez API lub webhooki.
Jak działają kredyty w Simplescraper?
Zgodnie z dokumentacją kredytów, strony bez renderowania JavaScript kosztują 1 kredyt, strony z renderowaniem JavaScript (włączonym domyślnie) kosztują 2 kredyty, a AI Enhance kosztuje 1 kredyt za każde 500 przetworzonych słów (łącznie input i output).
Które narzędzie ma lepsze API?
To zależy od priorytetu. API Simplescraper ma dziś szerszy opisany zakres — zarządzanie Recipes, batch runs do 5,000 URL-i, bezpośrednią ekstrakcję Markdown/HTML/screenshotów i odkrywanie URL-i z sitemap. Open API Thunderbit wraz z MCP Server to lepszy wybór, jeśli zależy Ci konkretnie na natywnej integracji z agentami AI (Claude, Cursor itp.), a nie na własnym kodzie łączącym API.
Czy oba obsługują scrapowanie podstron szczegółów i JavaScript?
Tak, oba narzędzia potrafią pobierać dane z list i przechodzić do podstron szczegółów na kompatybilnych witrynach, i oba obsługują treści renderowane przez JavaScript — choć Simplescraper domyślnie rozlicza renderowanie JS podwójną liczbą kredytów, co warto uwzględnić w kalkulacji użycia.
Czy któreś narzędzie potrafi zeskrobać każdą stronę?
Nie. Żadne z tych narzędzi nie gwarantuje pełnej kompatybilności ze wszystkimi witrynami. Wymagania uwierzytelniania, zabezpieczenia anti-bot, nietypowa struktura stron i ograniczenia dostępu specyficzne dla danej witryny mogą ograniczyć działanie obu platform. Zawsze testuj na konkretnych stronach docelowych i zbieraj tylko te dane, do których masz uprawniony dostęp.




