
Co kilka miesięcy ktoś z naszego zespołu rzuca na Slacku to samo pytanie: „A może po prostu napiszemy do tego spidera w Scrapy?”. I za każdym razem moja odpowiedź brzmi trochę inaczej — wszystko zależy od tego, kto pyta i co tak naprawdę chce osiągnąć. W gruncie rzeczy to już byłby cały artykuł, ale pozwól, że jednak trochę zarobię na chleb i wyjaśnię, dlaczego.
Przez prawie dekadę pracowałem w SaaS i automatyzacji — najpierw w Automation Anywhere, gdzie patrzyłem, jak firmy automatyzują wszystko oprócz tego jednego momentu, kiedy ktoś i tak musiał ręcznie kopiować dane ze strony internetowej, a teraz budując Thunderbit, gdzie „kopiuj-wklej z witryny” to dokładnie problem, który próbujemy wyeliminować. Scrapy z kolei od lat napędza internetowe pipeline’y danych — jeszcze zanim „agentic AI” stało się hasłem rzucanym przy kolacji. Porównywanie tych dwóch narzędzi nie polega na szukaniu jednego zwycięzcy. To raczej jak zestawienie scyzoryka z w pełni wyposażonym warsztatem maszynowym — oba doprowadzą cię do pociętego metalu, ale droga, potrzebne umiejętności i bałagan do sprzątania po wszystkim są zupełnie inne.
Szybka odpowiedź
Jeśli chcesz skrót przed wejściem w szczegóły: Thunderbit to zarządzany, agentowy web scraper — wskazujesz mu stronę, klikasz raz i narzędzie samo rozpoznaje strukturę, niezależnie od tego, czy pracujesz w przeglądarce, w Web App, przez Open API, MCP Server czy w CLI. Scrapy to dojrzały, open-source’owy framework do crawlowania w Pythonie — piszesz spidera, definiujesz selektory, budujesz pipeline i odpowiadasz za każdą linijkę kodu, która dotyka twoich danych.
Żadne z nich nie jest „lepsze” w uniwersalnym sensie. Każde powstało z myślą o innych użytkownikach i innych problemach. I szczerze mówiąc, fakt, że konkurencyjne artykuły wciąż sprowadzają to do jednego werdyktu, jest jednym z powodów, dla których chciałem napisać ten tekst porządnie.
Na pierwszy rzut oka
Oto tabela, którą sam chciałbym znaleźć za pierwszym razem. Każdy artykuł „Thunderbit vs Scrapy”, jaki znalazłem, albo wrzucał oba narzędzia do większego przeglądu Scrapy kontra BeautifulSoup, albo dawał ci płytki, niezbyt użyteczny widget katalogowy. Więc zbudowaliśmy coś konkretnego.
| Wymiar | Scrapy | Thunderbit |
|---|---|---|
| Czym jest | Open-source’owy framework w Pythonie (spidery, pipeline’y, middleware, silnik asynchroniczny) | Agentowy web scraper bez kodowania — rozszerzenie do przeglądarki, Web App, Open API, MCP Server, CLI |
| Konfiguracja | Instalujesz środowisko Python, piszesz spidera, definiujesz selektory, konfigurujesz pipeline | Otwierasz docelową stronę, klikasz One Click Extract — ekstrakcja startuje automatycznie (opcjonalnie Run Now) na zgodnych, autoryzowanych stronach |
| Wymagane umiejętności | Python, selektory XPath/CSS, podstawy asynchroniczności | Do workflow w przeglądarce nie trzeba kodu; API/CLI/MCP wymagają standardowej konfiguracji developerskiej |
| Treści JS/dynamiczne | Wymaga scrapy-playwright albo integracji w stylu Selenium | Działa na już wyrenderowanej stronie otwartej w przeglądarce, także w obsługiwanych sesjach logowania — ale nie ma gwarancji na każdej witrynie |
| Obsługa anty-botów | Ręcznie przez middleware (rotacja proxy, wykrywanie blokad), bez gwarancji obejścia | Zarządzane renderowanie na obsługiwanych, autoryzowanych stronach; również bez gwarancji obejścia |
| Skala / zadania cykliczne | Stworzony do dużych, skryptowalnych, planowanych crawlów | Planowanie dostępne tam, gdzie wspiera je plan/środowisko; lepszy do zadań celowanych lub o umiarkowanej skali |
| Eksport | Własny kod (JSON, CSV, baza danych, pipeline’y) | Eksport do obsługiwanych miejsc, takich jak Excel, Google Sheets, Airtable czy Notion, plus formaty pobierania |
| Utrzymanie | Spider psuje się przy zmianach layoutu; naprawy wymagają czasu devów | Ekstrakcja wspierana przez AI częściowo dostosowuje się do zmian układu, ale nie jest odporna na zmiany struktury |
| Model kosztów | Darmowy/open-source + czas devów + hosting + proxy | Subskrypcja / model kredytowy — sprawdź stronę cennika, zanim podasz liczby |
Czym jest Thunderbit?
Thunderbit powstał z dość frustrującej obserwacji: większość ludzi potrzebujących danych z internetu nie jest programistami, a większość narzędzi do scrapowania zakłada, że nimi są. Ta luka to właściwie cały powód, dla którego istniejemy.
Podstawowy workflow w przeglądarce jest celowo prosty — i to w najlepszym możliwym znaczeniu. Otwierasz stronę, z której chcesz pobrać dane, klikasz One Click Extract, a agent robi resztę: czyta stronę, rozpoznaje, co da się wyciągnąć (listy produktów, oferty pracy, dane kontaktowe — cokolwiek jest na ekranie) i automatycznie przygotowuje pola. Jest przycisk Run Now, jeśli chcesz wystartować od razu, ale jeśli po prostu siedzisz i pijesz kawę, ekstrakcja i tak uruchomi się sama. Bez selektorów, bez pisania schematu, bez archeologii typu „inspect element”.

Poza jednorazowym workflow w przeglądarce Thunderbit działa też na kilku innych poziomach, zależnie od tego, co budujesz:
- Chrome Extension obsługuje przypadek „właśnie patrzę na tę stronę i chcę te dane”.
- Web App służy do zbierania danych w chmurze i zadań cyklicznych dla użytkowników biznesowych, którzy nie chcą dotykać kodu.
- Open API udostępnia endpointy Distill i strukturalny Extract do backendu oraz workflow aplikacyjnych.
- MCP Server pozwala agentom AI w Claude, Cursorze lub Windsurf wywoływać Thunderbit bezpośrednio jako narzędzie.
- CLI jest dla developerów i agentów kodujących, którzy żyją w terminalu.
Obsługuje też paginację i wzbogacanie podstron na zgodnych witrynach, a pola można doprecyzować zwykłymi instrukcjami tekstowymi zamiast regexów. Nic z tego nie gwarantuje perfekcyjnego działania na każdej stronie świata — do tego wrócę w sekcji o uczciwym spojrzeniu — ale projekt jest tak zrobiony, żeby osoba z sales ops albo analityk nieruchomości nie musieli otwierać edytora kodu.
Czym jest Scrapy w 2026 roku?
Scrapy to nie żaden zabytek pokryty kurzem. Oficjalna strona Scrapy podaje wersję 2.17.0 jako aktualne stabilne wydanie, a projekt nadal regularnie wypuszcza nowe aktualizacje — najnowsza dodała nawet obsługę HTTP/2 i SOCKS proxy w ścieżce handlera pobierania. To nie jest historia o tym, że AI zabiło stary framework. Scrapy nadal żyje i, szczerze mówiąc, wciąż robi to, do czego został stworzony, naprawdę dobrze.
W swojej istocie Scrapy to framework do crawlowania w Pythonie oparty na asynchronicznym silniku crawlującym. Tworzysz klasę Spider, definiujesz startowe adresy URL (albo metodę start), a Scrapy wysyła Requesty z funkcjami callback, które przetwarzają odpowiedź. Dalej wybierasz dane selektorami CSS lub XPath (albo zwykłym regexem, jeśli masz ochotę na oldschool), pakujesz je do Items i przepuszczasz przez pipeline’y odpowiedzialne za czyszczenie, walidację i zapis. Oficjalna dokumentacja przeglądowa prowadzi przez cały ten proces i naprawdę jest to elegancki system, kiedy już go poznasz.
To, co dostajesz w zamian za naukę, to realna kontrola: cookies i sesje, przepływy uwierzytelniania, cache, respektowanie robots.txt, limity głębokości crawlów oraz AutoThrottle, żeby nie skończyć z zablokowanym IP po stronie wściekłego admina serwera. Do tego dochodzi ogromny ekosystem middleware i rozszerzeń — rotacja proxy, własne download handlery, hooki monitorujące, a ostatnio także dodatki do renderowania opartego o Playwright oraz nawet narzędzia wspierające agenty kodujące AI, które generują za ciebie szablony spiderów.
Jedna ważna rzecz, którą warto powiedzieć precyzyjnie: rdzeń Scrapy to crawler HTTP, a nie przeglądarka. Sam z siebie nie renderuje JavaScriptu. Jeśli tego potrzebujesz, sięgasz po scrapy-playwright, middleware w stylu Selenium albo zewnętrzną usługę renderującą. To nie jest wada sama w sobie — to świadoma decyzja projektowa, która utrzymuje core frameworka lekki i szybki — ale oznacza, że „obsługa strony mocno opartej na JS” jest decyzją projektową, a nie domyślnym zachowaniem.
Kluczowa różnica: zarządzany workflow agentowy kontra framework, który w pełni posiadasz kodowo
Czas do pierwszego zbioru danych
Nie będę tu wymyślał liczb ze stoperem — widziałem zbyt wiele artykułów, które twierdzą, że Scrapy ma „stromą krzywą uczenia się”, nigdy tego nie pokazując. Zamiast tego policzmy realne kroki.
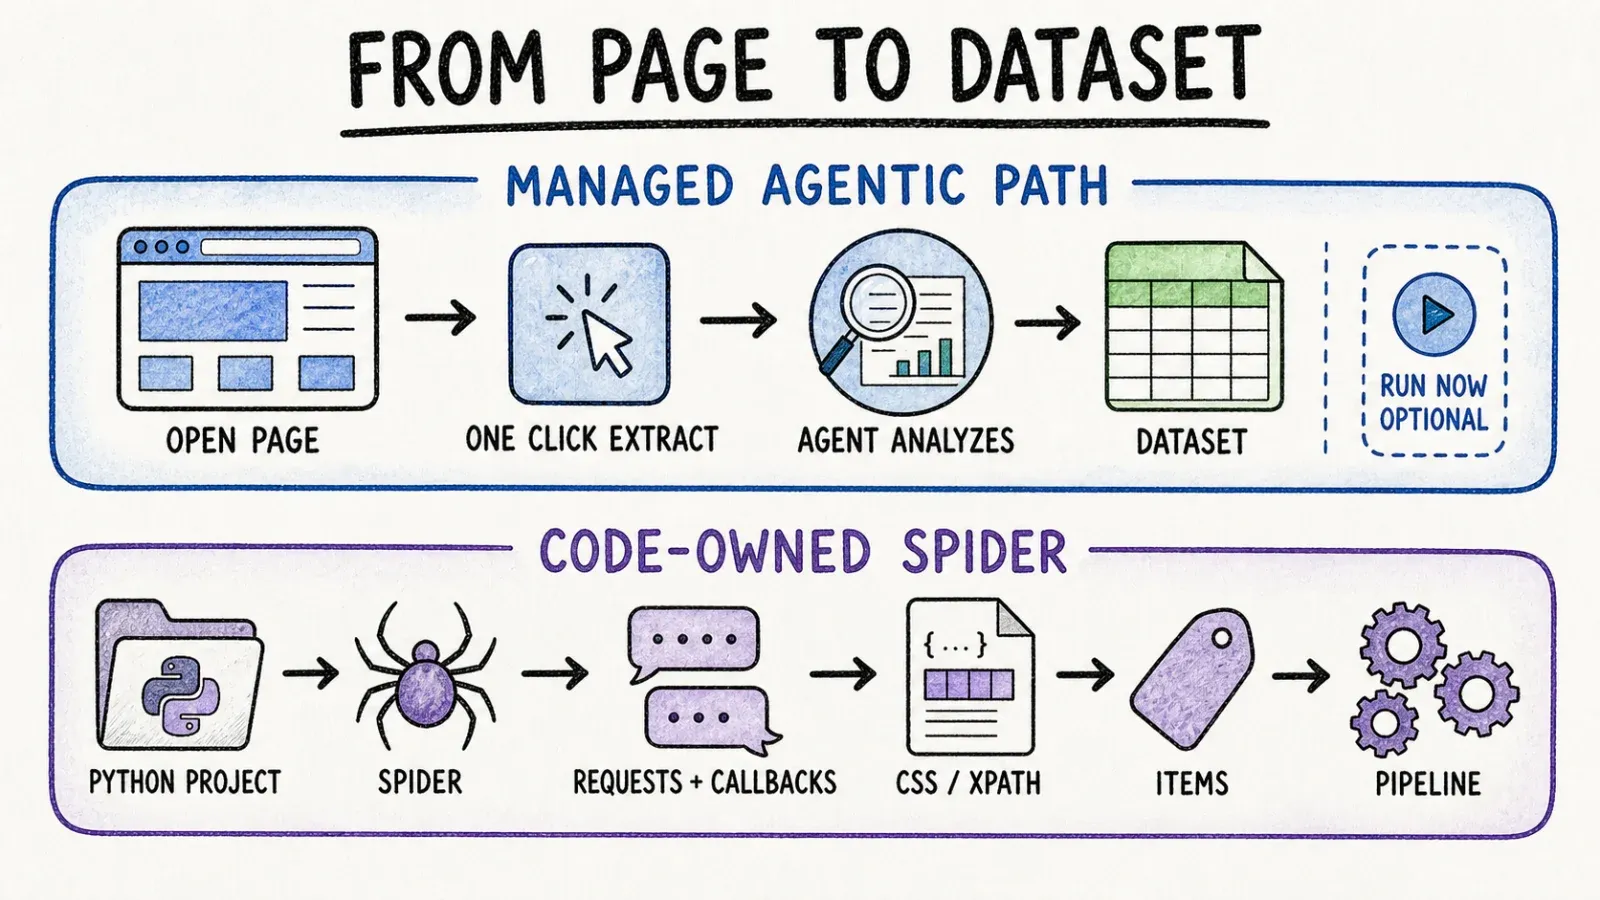
Ścieżka Scrapy dla przykładu: scrapowania strony z listą produktów:
- Ustawiasz wirtualne środowisko Python i instalujesz Scrapy.
- Generujesz spidera z szablonu.
- Sprawdzasz HTML strony i piszesz selektory XPath/CSS dla każdego pola.
- Konfigurujesz pipeline do czyszczenia i eksportu danych.
- Uruchamiasz spidera, debugujesz rozjazdy selektorów, uruchamiasz ponownie.
Ścieżka Thunderbit dla tego samego zadania:
- Otwierasz stronę w przeglądarce.
- Klikasz One Click Extract.
- Agent rozpoznaje pola do pobrania i startuje (albo naciskasz Run Now).
To pięć kroków z dołączonym środowiskiem Python kontra trzy kroki bez żadnej konfiguracji środowiska. Nie twierdzę, że sama liczba kroków jest jedyną ważną metryką — pięć kroków w Scrapy daje ci znacznie większą kontrolę nad tym, co się dzieje — ale jeśli twoim celem jest po prostu „mieć tę tabelę dziś w arkuszu”, różnica w liczbie kroków mówi praktycznie wszystko.
Kontrola i możliwość rozbudowy
Tutaj Scrapy wychodzi na prowadzenie i zrobiłbym ci krzywdę, udając coś innego. Ponieważ posiadasz kod źródłowy, możesz zbudować dosłownie wszystko: własną logikę retry, nietypowe wzorce paginacji, wieloetapowe uwierzytelnianie, integrację z istniejącym data warehouse, cokolwiek wymaga twoja architektura. Podejście agentowe Thunderbit optymalizuje pod kątem „szybko dostać uporządkowane dane bez pisania kodu”, co z definicji oznacza, że narzędzie podejmuje część decyzji za ciebie zamiast wystawiać wszystkie dźwignie. Dla 80% biznesowych zadań ekstrakcji to świetny kompromis. Dla pozostałych 20% — tych naprawdę dziwnych, niestandardowych przypadków crawlowania — chcesz frameworka, który można naginać do własnej woli.
Utrzymanie i odpowiedzialność operacyjna
Spidery się psują. To nie zarzut wobec Scrapy — każdy scraper, agentowy czy ręcznie napisany, zależy od strony, do której jest skierowany. Ale kiedy spider w Scrapy przestaje działać, bo witryna przebudowała HTML, ktoś w twoim zespole musi to zauważyć, zdiagnozować i naprawić. To jest realny czas devów, za każdym razem.
Thunderbit z pomocą AI potrafi dostosować się do części zmian w układzie strony automatycznie, bo analizuje strukturę strony, a nie sztywno dopasowuje wcześniej zapisany selektor. Chcę jednak powiedzieć to jasno: to nie jest odporność absolutna. Wystarczająco duże zmiany strukturalne nadal mogą go wyłożyć. Różnica polega bardziej na tym, kto dokonuje adaptacji — algorytm próbujący najlepszego zgadnięcia czy developer przepisujący XPath o 23:00.
Scenariusze z życia
Jednorazowa lista katalogowa lub tabela produktów
Jeśli potrzebujesz tabeli z ofertami restauracji, cenami produktów albo szczegółami wydarzeń z jednej strony lub krótkiej listy stron, stawianie projektu Scrapy to zwyczajnie przerost formy nad treścią — pisałbyś spidera, którego użyjesz raz i nigdy więcej nie ruszysz. To jest dokładnie teren Thunderbit: otwierasz, klikasz, wyciągasz, eksportujesz do Google Sheets, gotowe.
Duży własny crawl z regułami biznesowymi
Teraz wyobraź sobie, że musisz przejść przez 50 000 stron produktowych w kilkunastu domenach, zastosować własną logikę deduplikacji i zasilić tym autorski model cenowy. To jest naturalne środowisko Scrapy. Architektura pipeline’ów, kontrola współbieżności, ekosystem middleware — wszystko to istnieje właśnie po to, by obsługiwać zadania tej skali i z tak dużą ilością własnej logiki.
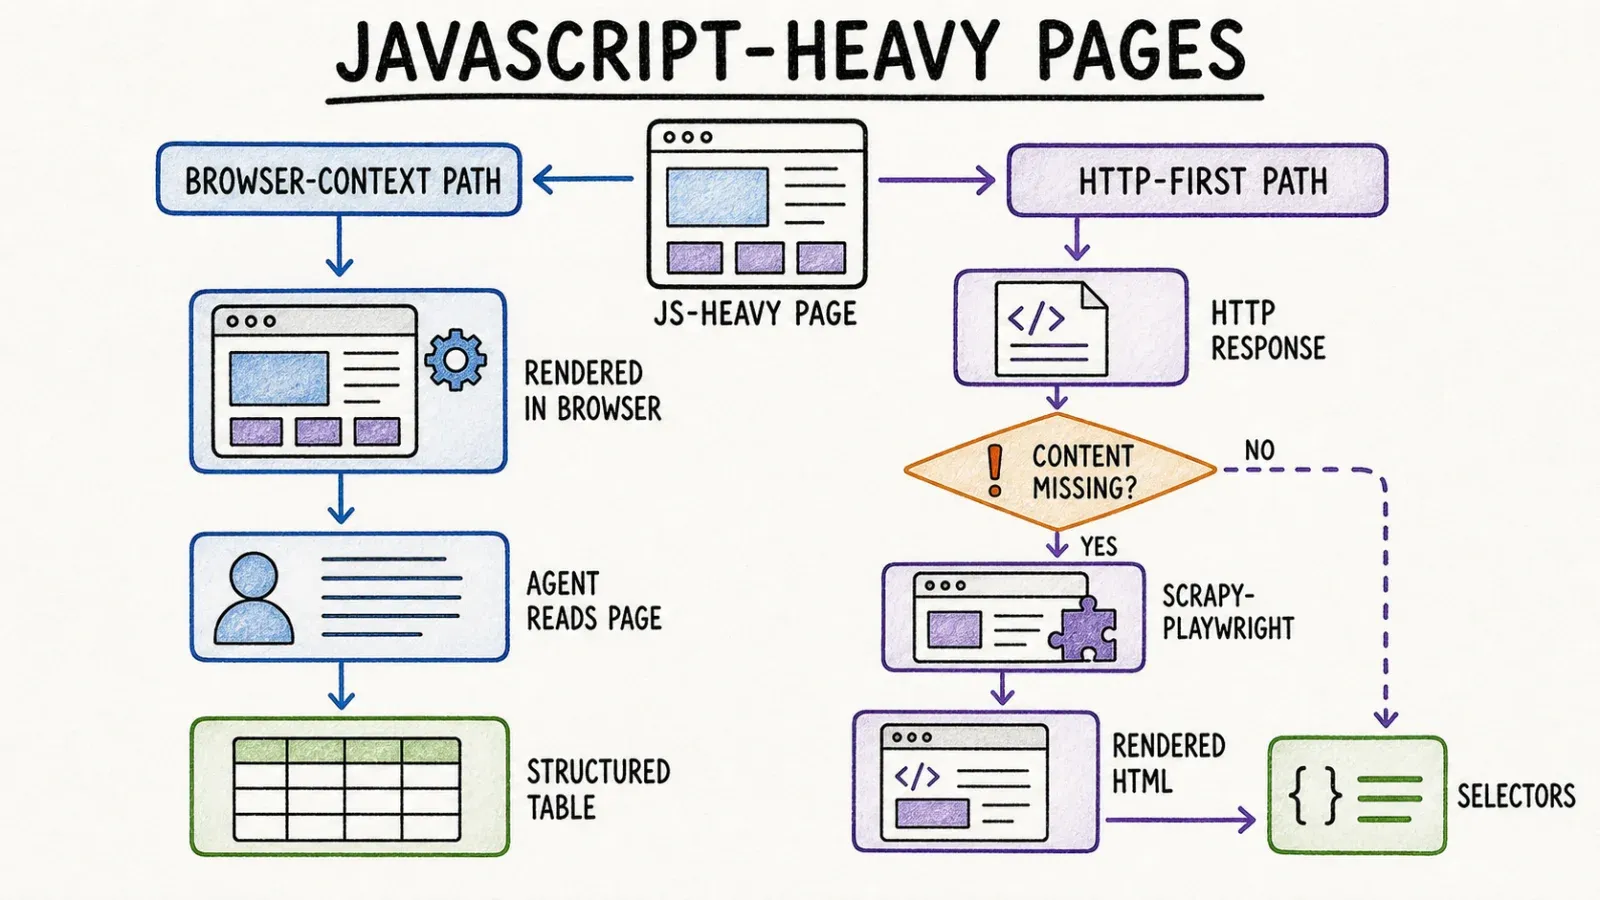
Dynamiczna strona mocno oparta na JavaScript
Tutaj oba narzędzia potrzebują pomocy, tylko każda innego rodzaju. Scrapy potrzebuje jawnie dołączonej integracji renderującej, takiej jak scrapy-playwright, co dokłada zależność i kolejną warstwę utrzymania. Rozszerzenie Thunderbit działa na stronie tak, jak już została wyrenderowana w twojej przeglądarce — także w niektórych obsługiwanych sesjach logowania — co omija sporą część tej konfiguracji. Ale chcę być precyzyjny: żadne z tych podejść nie daje gwarantowanego zwycięstwa przeciw agresywnym systemom anty-botowym albo nietypowym wzorcom dynamicznej treści. Każdy, kto mówi ci inaczej, coś ci sprzedaje.
Integracja z agentem AI lub aplikacją
Jeśli budujesz workflow agenta AI w Claude albo Cursorze i chcesz, żeby pobierał bieżące dane z sieci jako część procesu rozumowania, napisanie własnej integracji ze Scrapy to spory wysiłek. MCP Server w Thunderbit został stworzony właśnie do tego — udostępnia ekstrakcję jako narzędzie, które agent może wywołać bezpośrednio.
Dokładność, skala i utrzymanie
Dokładność Scrapy jest deterministyczna w najlepszym możliwym sensie — dobrze napisany selektor pobiera dokładnie to pole, które mu wskazałeś, za każdym razem, dopóki HTML się nie zmieni. Ta przewidywalność jest naprawdę cenna w produkcyjnych pipeline’ach, gdzie chcesz dokładnie wiedzieć, dlaczego coś się nie udało.
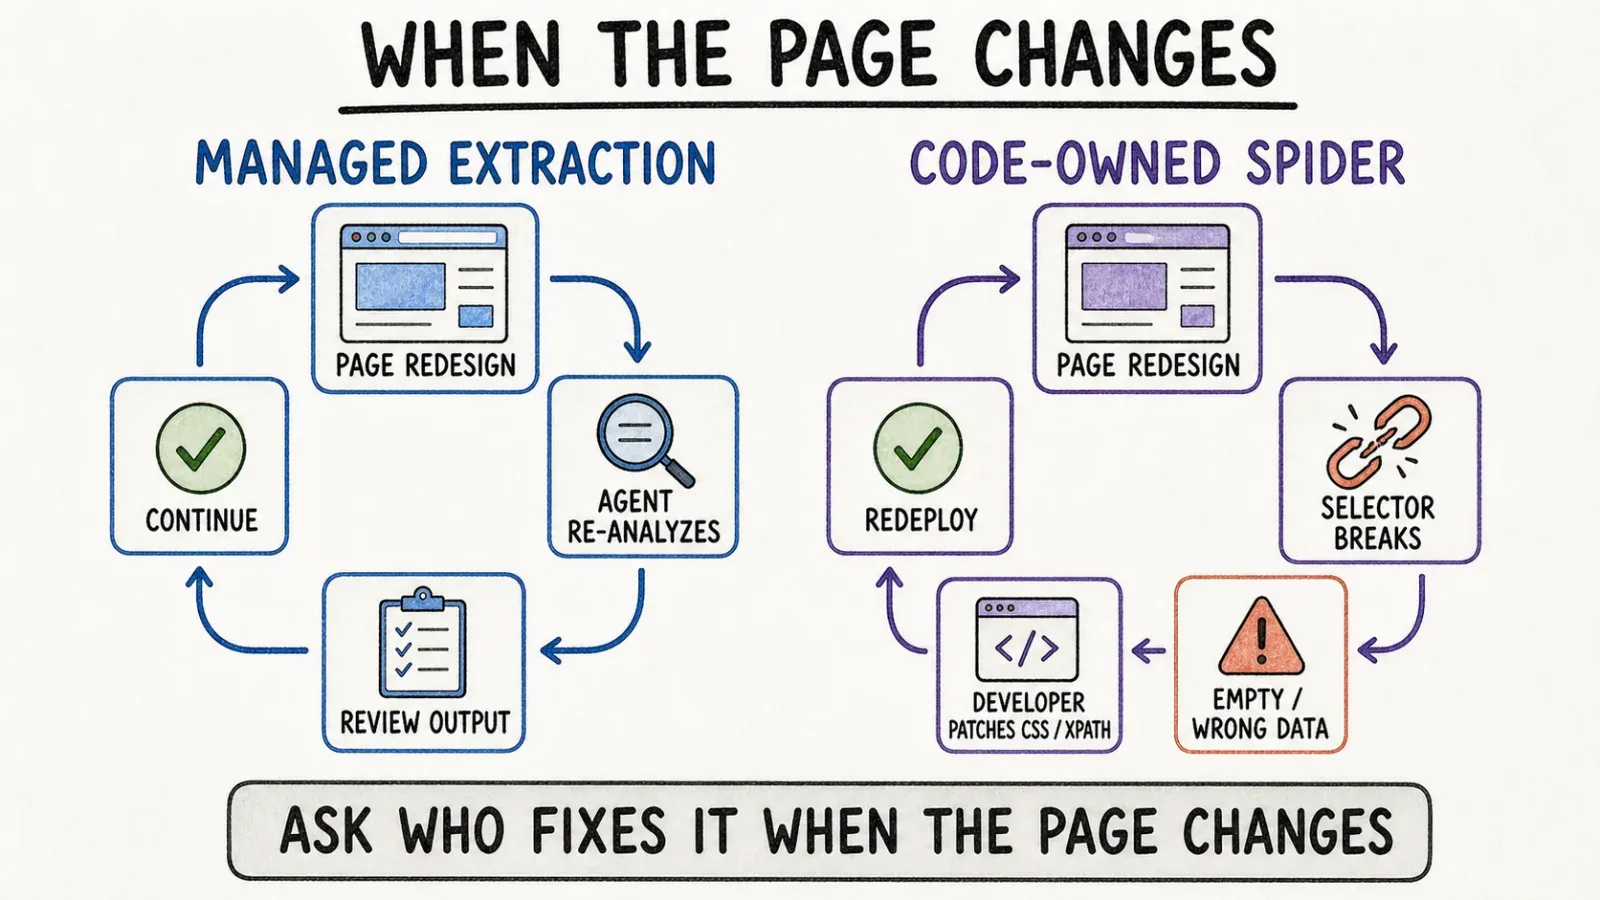
Agentowe wykrywanie w Thunderbit działa inaczej. Narzędzie interpretuje stronę tak, jak zrobiłby to człowiek, i decyduje, co prawdopodobnie jest ceną, tytułem czy opisem. To jest bardzo użyteczne pod względem szybkości i elastyczności, ale to inny model dokładności — bliżej „zwykle trafia, czasem potrzebuje lekkiego popchnięcia” niż „zawsze dokładnie to, co mówi selektor”. Wolę powiedzieć to wprost, niż udawać, że ekstrakcja oparta na AI jest bezbłędna.
Jeśli chodzi o samą przepustowość, asynchroniczny silnik Scrapy jest zaprojektowany tak, by bardzo wydajnie przepalać ogromne wolumeny requestów — to naprawdę część jego DNA. Thunderbit jest bardziej nastawiony na zadania celowane i umiarkowanej skali, gdzie szybkie uzyskanie czystego, strukturalnego wyniku jest ważniejsze niż crawl miliona stron przez noc. Jeśli planujesz naprawdę ogromny crawl, sprawdź aktualne limity planu, zanim założysz, że któreś z narzędzi skaluje się dokładnie tak, jak potrzebujesz.
Jedna ważna rzecz, która dotyczy obu: autoryzowane użycie ma znaczenie. Niezależnie od tego, które narzędzie wybierzesz, respektowanie robots.txt, warunków serwisu i obowiązującego prawa nie jest opcjonalne — to po prostu część odpowiedzialnego działania.
Cennik, licencja i całkowity koszt
Jest tu pułapka, w którą ludzie wpadają nagminnie: traktowanie „darmowe” i „bez kosztów” jak synonimów. Scrapy nie ma opłaty licencyjnej — jest open source i koniec kropka. Ale „darmowe” oprogramowanie nadal potrzebuje środowiska, w którym będzie działać, a to kosztuje: hosting, proxy przy większej skali, narzędzia do automatyzacji przeglądarki, jeśli potrzebujesz renderowania JS, monitoring, żeby wiedzieć, kiedy spider cicho padnie, i — najważniejsze — czas developerów na zbudowanie, przetestowanie i naprawianie tego, gdy się rozsypie.
Thunderbit działa w modelu subskrypcji / kredytów i odesłałbym cię raczej do oficjalnej strony cennika, niż podawał tu jakąkolwiek liczbę z pamięci, bo struktury cenowe się zmieniają, a lepiej, żebyś widział aktualne warunki bezpośrednio. Za tę subskrypcję dostajesz w praktyce zdjęcie z siebie większości ciężaru konfiguracji i utrzymania — przynajmniej w obsługiwanych workflowach.
Prawdziwe pytanie nie brzmi: „co jest tańsze na papierze?”. Brzmi: „jakiej waluty ma więcej twój zespół — godzin developerów czy budżetu na subskrypcje?”. Pięcioosobowy zespół data engineering z wolnym slotem może uznać, że całkowity koszt Scrapy jest niższy, jeśli doliczy własne kompetencje. Trzyosobowy zespół operacyjny bez ani jednego inżyniera na pokładzie odkryje raczej, że „darmowy” framework oznacza rachunek od kontraktora i trzy tygodnie opóźnienia, zanim zobaczą pierwszy wiersz danych.
Kto powinien wybrać Thunderbit?
Thunderbit ma najwięcej sensu, jeśli jesteś osobą nietechniczną pracującą operacyjnie — w sprzedaży, marketingu, ecommerce, nieruchomościach czy rekrutacji — i potrzebujesz danych strukturalnych od razu, bez zgłaszania ticketu do zespołu inżynieryjnego. To też dobry wybór dla developerów, którzy chcą dostępu programowego bez pisania logiki ekstrakcji od zera, bo Open API i CLI przejmują tę warstwę za nich. Jeśli twoje workflowy obejmują lead generation, monitoring ecommerce albo scraping profili LinkedIn do researchu rekrutacyjnego, to zwykle najszybsza ścieżka.
Kto powinien wybrać Scrapy?
Scrapy będzie właściwym wyborem, jeśli masz w zespole programistów Pythona, budujesz infrastrukturę crawlowania na lata i potrzebujesz pełnej kontroli nad logiką requestów, zachowaniem retry i pipeline’ami danych. To też lepsza opcja, jeśli wymagania compliance albo architektury oznaczają, że kod musi być w 100% twój — audytowalny, self-hosted, bez zewnętrznych zależności.
Czy zespoły mogą korzystać z obu?
Wiele zespołów tak robi i nie uważam, że to wymijająca odpowiedź. Developerzy mogą utrzymywać trwałe, wielkoskalowe spidery Scrapy dla infrastruktury crawlowania, która musi działać stale, a reszta organizacji może używać Thunderbit do ad hoc researchu, jednorazowych pobrań danych i pracy eksploracyjnej, która nie uzasadnia pełnego sprintu inżynieryjnego. Nie ma oficjalnej integracji między tymi narzędziami — chcę to jasno zaznaczyć — ale operacyjnie nic nie stoi na przeszkodzie, żeby używać ich równolegle, zależnie od tego, które zadanie lepiej pasuje do którego narzędzia.
Werdykt
Gdybym miał to sprowadzić do jednego pytania kontrolnego, brzmiałoby ono: optymalizujesz pod kontrolę czy pod szybkość? Scrapy daje pełną kontrolę kosztem czasu konfiguracji i bieżącego utrzymania. Thunderbit daje szybkość i dostępność kosztem części elastyczności. Żadna z tych odpowiedzi nie jest obiektywnie poprawna — wszystko zależy od tego, czy osoba robiąca scraping zna Pythona, czy zna swój lejek sprzedażowy. Jeśli chcesz szerzej zobaczyć, jak ekstrakcja oparta na AI wypada na tle tradycyjnych metod, nasze omówienie AI web scraping oraz web scraping bez kodowania pokazuje szerszy kontekst poza tym jednym porównaniem.
FAQ
Czy Scrapy jest darmowe? Sam framework Scrapy jest open source i nie ma opłaty licencyjnej, zgodnie z oficjalną stroną Scrapy. Twoje realne koszty wynikają z hostingu, proxy, narzędzi do renderowania, jeśli potrzebujesz wsparcia JS, oraz czasu developerów na budowę i utrzymanie spiderów.
Czy Scrapy samo renderuje JavaScript? Nie. Rdzeń Scrapy to crawler HTTP, a nie przeglądarka, więc nie wykonuje JavaScriptu od razu po instalacji. Zespoły zwykle dodają scrapy-playwright albo middleware w stylu Selenium, gdy chcą scrapować strony mocno oparte na JS, zgodnie z oficjalną dokumentacją Scrapy.
Czy Thunderbit obsługuje API i MCP? Tak. Thunderbit oferuje Open API z endpointami Distill i strukturalnym Extract do użycia programistycznego oraz MCP Server, który pozwala agentom AI w narzędziach takich jak Claude i Cursor wywoływać Thunderbit bezpośrednio.
Co jest szybsze dla użytkowników biznesowych? Thunderbit — z założenia. Workflow One Click Extract w rozszerzeniu przeglądarkowym uruchamia ekstrakcję automatycznie po analizie strony, bez selektorów i bez konfiguracji schematu — to znacznie krótsza droga niż instalowanie Pythona i pisanie spidera.
Co jest lepsze do mocno spersonalizowanych crawlów? Scrapy. Jego middleware, architektura pipeline’ów i pełny dostęp do kodu źródłowego dają developerom kontrolę potrzebną do bardzo specyficznej logiki crawlowania, dużych zaplanowanych zadań i niestandardowych pipeline’ów danych, których narzędzie agentowe nie ma zastępować.




