
To dokładnie to pytanie trafia do mojej skrzynki częściej, niż jestem w stanie zliczyć: „Czy do pobierania danych wybrać Thunderbit czy ScrapeStorm?” I szczerze mówiąc, to całkiem sensowne pytanie — oba narzędzia obiecują uporządkowane dane ze stron internetowych bez zatrudniania programisty. Problem w tym, że działają w zupełnie inny sposób, a wybór niewłaściwego rozwiązania do Twojego procesu oznacza albo marnowanie godzin na budowanie reguł, których nie potrzebujesz, albo utknięcie w miejscu wtedy, gdy naprawdę potrzebujesz precyzyjnej kontroli.
Przeanalizowałem oba produkty, przeczytałem oficjalną dokumentację i sprawdziłem, w czym każde z nich naprawdę błyszczy. Oto uczciwe porównanie — bez marketingowego nadęcia, tylko to, co faktycznie oferuje każde narzędzie i dla kogo ma sens.
Krótka odpowiedź
Jeśli chcesz wersję w skrócie: Thunderbit jest stworzone dla osób, które wolą, żeby agent spojrzał na stronę i sam ogarnął dane, zamiast samodzielnie projektować logikę ekstrakcji. Klikasz One Click Extract, narzędzie analizuje stronę i zaczyna pobieranie danych — Run Now jest dostępne, jeśli chcesz uruchomić wszystko od razu, ale nie jest obowiązkowe, bo zadanie i tak startuje automatycznie.
ScrapeStorm z kolei oferuje Smart Mode do automatycznego wykrywania na typowych stronach list i treści, a także Flowchart Mode, w którym możesz zbudować dokładną logikę kliknięć, przewijania, czekania i pętli, gdy witryna wymaga czegoś więcej niż tylko rozpoznawania wzorca.
Żadne z nich nie jest „w pełni ręczne” i żadne nie jest „w pełni automatyczne”. To zresztą największe nieporozumienie, jakie ciągle widzę w artykułach porównawczych — przedstawiają ScrapeStorm jako czystą, regułową mordęgę, co umniejsza możliwości Smart Mode, a Thunderbit pokazują jak magiczne rozwiązanie działające na każdej stronie, co też nie jest realistyczne. Kompatybilność i autoryzacja nadal mają znaczenie w obu przypadkach.
Thunderbit kontra ScrapeStorm w skrócie
Zanim wejdziemy w szczegóły, oto tabela, którą chciałbym mieć pod ręką, kiedy sam po raz pierwszy porównywałem te dwa narzędzia:
| Cecha | Thunderbit | ScrapeStorm |
|---|---|---|
| Wdrożenie | Rozszerzenie do przeglądarki Chrome/Edge, aplikacja webowa, Open API, serwer MCP, CLI | Aplikacja desktopowa (Windows/macOS/Linux) |
| Sposób konfiguracji | Agentowy — kliknij One Click Extract, strona jest automatycznie analizowana, Run Now jest opcjonalne | Smart Mode (automatyczny) lub Flowchart Mode (wizualny, ręczna logika) |
| Najlepsze zastosowanie | Użytkownicy no-code, zespoły operacyjne i sprzedażowe, szybkie pobieranie danych z przeglądarki | Osoby, które chcą budować regułowe przepływy pracy dla złożonych stron |
| Obsługa paginacji | Kompatybilna paginacja i wzbogacanie podstron na obsługiwanych stronach | Smart Mode wykrywa automatycznie; Flowchart Mode oferuje jawne komponenty pętli |
| Obsługa interakcji (kliknięcia, formularze, przewijanie) | Oparta na sesji przeglądarki, działa w ramach autoryzowanych sesji tam, gdzie to możliwe | Jawne komponenty Flowchart: kliknięcie, hover, lista rozwijana, wpisywanie, czekanie, warunek |
| Harmonogram | Oparty na chmurze, zależnie od planu (sprawdź aktualny plan) | Harmonogram w aplikacji desktopowej od poziomu Premium |
| Eksport | Excel, Google Sheets, Airtable, Notion i inne obsługiwane formaty | Excel, TXT, CSV, HTML, MySQL, PostgreSQL, SQL Server, MongoDB, Google Sheets (Premium+) |
| Dostęp dla deweloperów | Open API, MCP Server, CLI | RESTful API do lokalnego sterowania zadaniami (Business) |
| Model cenowy | Na bazie kredytów/planu — zobacz aktualny cennik | Subskrypcja warstwowa, zobacz oficjalny cennik |
Celowo nie porównuję tutaj szybkości ani dokładności. Nie widziałem niezależnego, kontrolowanego benchmarku zestawiającego oba narzędzia bezpośrednio, a deklaracje producentów dotyczące szybkości (jak „3-10x” w przypadku ScrapeStorm) mocno zależą od czasu ładowania strony i sposobu zbudowania zadania. Nie będę więc udawał, że mam dane, których po prostu nie mam.
Czym jest Thunderbit?
Thunderbit to narzędzie stworzone w mojej firmie — agentowy web scraper zaprojektowany dla osób, które nie mają najmniejszej ochoty uczyć się XPath czy selektorów CSS, ale pilnie potrzebują arkusza danych jeszcze tego samego dnia.

Oto rzeczywisty aktualny proces, bo widziałem starsze recenzje opisujące interfejs, którego już nie ma (do tego tematu „0 Ratings” wrócę później): klikasz One Click Extract w rozszerzeniu przeglądarki, a agent Thunderbit wykrywa stronę, czyta ją i analizuje. Sam rozpoznaje sensowne pola — nazwy produktów, ceny, dane kontaktowe, cokolwiek sugeruje struktura strony — i po prostu startuje. Run Now jest dostępne, jeśli chcesz uruchomić od razu, ale jeśli nic nie klikniesz, i tak wystartuje samo.
Właśnie to zaskakuje ludzi. Nie ma etapu „przejrzyj swoje selektory”, nie ma budowania schematu. Potem możesz dopracować wynik zwykłym językiem — poprosić o zmianę formatu daty albo rozdzielenie kolumny z imieniem i nazwiskiem — a na kompatybilnych stronach Thunderbit obsługuje paginację i wzbogacanie podstron (czyli np. pobranie listy pozycji, a potem automatyczne dociągnięcie dodatkowych szczegółów z każdej podstrony).
Poza rozszerzeniem przeglądarki Thunderbit oferuje też aplikację webową, Open API dla deweloperów chcących uruchamiać ekstrakcję programowo, MCP Server, dzięki któremu agenci AI, tacy jak Claude czy Cursor, mogą wywoływać Thunderbit jako narzędzie, oraz CLI do pracy z terminala. Eksport trafia do Excela, Google Sheets, Airtable, Notion i innych obsługiwanych formatów.
Powiem to wprost: działa to dobrze tylko na stronach kompatybilnych i takich, do których masz uprawniony dostęp. To nie jest uniwersalny klucz otwierający każde zablokowane drzwi w internecie.
Czym jest ScrapeStorm?
ScrapeStorm działa zupełnie inaczej pod względem architektury. To aplikacja do pobrania — na Windows, macOS lub Linux — i istnieje już wystarczająco długo, by rozwinąć naprawdę rozbudowany zestaw funkcji.
Sercem ScrapeStorm są dwa tryby pracy i ich różnica ma ogromne znaczenie przy ocenie, czy narzędzie pasuje do Twojego przypadku.
Smart Mode próbuje automatycznie wykryć treść i strukturę paginacji na stronach typu list i content. Zgodnie z oficjalnym poradnikiem ScrapeStorm dotyczącym wyboru trybu, dobrze sprawdza się to wtedy, gdy strona pasuje do rozpoznawalnych wzorców — np. siatek z produktami czy kanałów z artykułami.
Flowchart Mode to miejsce, w którym ScrapeStorm naprawdę pokazuje moc przy bardziej skomplikowanych stronach. Budujesz wizualny schemat z komponentów opisanych w ich dokumentacji komponentów Flowchart: otwórz URL, kliknij coś, poczekaj na załadowanie, przewiń w dół, wpisz wartość w formularz, najedź kursorem, żeby rozwinąć listę, ustaw gałęzie warunkowe, przechodź pętlą po wynikach stronicowanych albo wariantach SKU, wróć do poprzedniej strony, skopiuj wartość, a nawet obsłuż kroki CAPTCHA.
To daje bardzo dużą precyzję. Jeśli strona wymaga logowania, filtrowania z listy rozwijanej, a potem klikania przez pięć kart, zanim pojawią się właściwe dane, Flowchart Mode pozwala odwzorować dokładnie taką sekwencję.
ScrapeStorm obsługuje też lokalne uruchamianie na Twoim komputerze albo tryby chmurowe/serwerowe, bezpośredni eksport do baz danych takich jak MySQL, PostgreSQL, SQL Server i MongoDB, a także — na wyższych planach — automatyczne harmonogramy i integrację z Google Sheets.
Kluczowa różnica: delegowanie do agenta kontra hybrydowa kontrola wizualna
Dobrze, tu na chwilę zrobię krok w stronę filozofii, bo uważam, że to właśnie jest właściwy model decyzyjny — ważniejszy niż każda tabela funkcji.
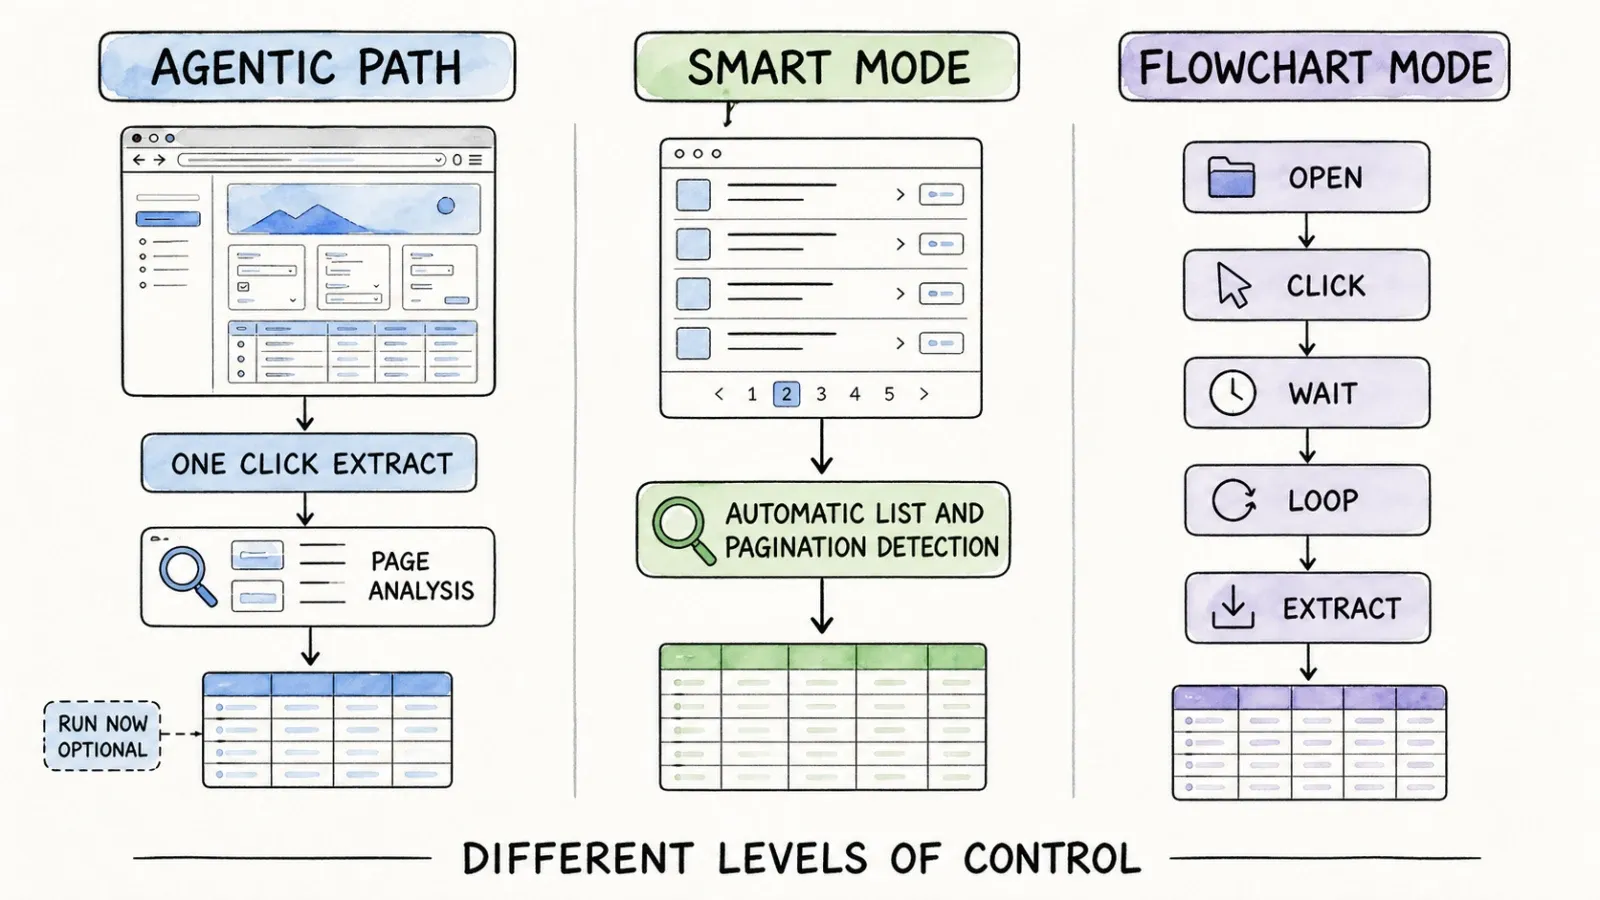
Jednoklikowa ścieżka agentowa Thunderbit
Cała idea Thunderbit opiera się na delegowaniu. Nie mówisz narzędziu: „cena jest w tym konkretnym divie, a tytuł w tamtym spanie”. Zasadniczo mówisz: „rozgryź to” — i agent to robi. Start jest przez to naprawdę szybszy, bo między „mam otwartą stronę” a „mam uporządkowane dane” nie ma etapu konfiguracji.
Koszt tej wygody polega na tym, że ufasz interpretacji agenta. Na większości standardowych stron — listach produktów, katalogach, stronach z recenzjami — działa to bardzo dobrze. Na stronach o nietypowej strukturze albo z niejednoznacznymi danymi może być potrzebna drobna wskazówka w naturalnym języku.
ScrapeStorm Smart Mode
Smart Mode to odpowiedź ScrapeStorm na ten sam problem i nie uważam, że uczciwie byłoby nazywać go „ręcznym” — to wciąż automatyczne rozpoznawanie wzorców, tylko oparte na rozpoznawaniu konkretnych typów stron, a nie na otwartym, agentowym rozumowaniu. Gdy działa, konfiguracja jest naprawdę minimalna. Gdy strona nie pasuje do rozpoznawanych wzorców, przechodzisz raczej do Flowchart Mode.
ScrapeStorm Flowchart Mode
To tryb, który wymaga faktycznego zbudowania przepływu pracy. Układasz sekwencję kroków, testujesz ją, debugujesz, gdy kliknięcie nie zadziała albo czas oczekiwania okaże się za krótki. Jest potężny, ale to zupełnie inny rodzaj pracy — bardziej jak lekkie programowanie za pomocą wizualnych bloków niż „wskaż stronę i pobierz dane”.
Najprościej mówiąc: Thunderbit daje gotowy wynik tabelaryczny na kompatybilnych stronach. Flowchart Mode w ScrapeStorm daje Ci przepływ pracy, który sam zbudowałeś, przetestowałeś i teraz możesz uruchamiać wielokrotnie z dużą pewnością — ale zapłaciłeś za tę pewność czasem konfiguracji.
Porównanie praktycznych scenariuszy
Przejdźmy przez kilka realnych przypadków, bo abstrakcyjne porównania funkcji mają swoje granice.
Prosta lista lub tabela
Jeśli pobierasz prostą tabelę — np. katalog firm z nazwą, adresem i numerem telefonu — jednoplikowy proces Thunderbit jest mniej więcej tak szybki, jak to możliwe. Smart Mode w ScrapeStorm też powinien sobie z tym poradzić, zakładając, że strona pasuje do rozpoznanych wzorców list.
Paginacja i nieskończone przewijanie
To jeden z najczęściej zgłaszanych problemów w opiniach użytkowników — nikt nie chce ręcznie klikać „następna strona” pięćdziesiąt razy. Thunderbit obsługuje kompatybilną paginację i wzbogacanie podstron automatycznie w ramach swojego agentowego procesu, o ile struktura strony na to pozwala. Smart Mode w ScrapeStorm również potrafi automatycznie wykryć paginację na obsługiwanych typach stron, a jeśli to zawiedzie, Flowchart Mode ma jawne komponenty pętli stworzone dokładnie do takich zadań — przechodzenia po stronach albo przewijania treści ładowanej w nieskończoność.
Żadne z tych narzędzi nie gwarantuje sukcesu przy każdym możliwym schemacie paginacji. Niektóre witryny stosują naprawdę trudną logikę (np. przyciski „load more” renderowane przez JavaScript z dziwnym timingiem), a oba narzędzia są zależne od rzeczywistego zachowania strony.
Strony szczegółowe i nawigacja wieloetapowa
Tutaj różnice są wyraźniejsze. Jeśli musisz przejść z listy na indywidualne strony szczegółów i pobrać dodatkowe pola z każdej z nich, wzbogacanie podstron w Thunderbit na kompatybilnych stronach robi to w ramach tego samego procesu agentowego — bez osobnej konfiguracji. ScrapeStorm też jak najbardziej potrafi to zrobić, ale zazwyczaj wymaga Flowchart Mode, aby jawnie odwzorować sekwencję kliknięcia w szczegóły i ekstrakcji.
Logowanie, formularze i zadania wymagające interakcji
To całkiem uzasadniona wątpliwość, którą widzę bardzo często: „czy to działa za loginem?” Thunderbit może działać w autoryzowanej, zalogowanej sesji przeglądarki tam, gdzie jest to wspierane — czyli jeśli jesteś już zalogowany w przeglądarce, rozszerzenie może działać w ramach tej sesji. Nie oznacza to jednak gwarancji dla każdego mechanizmu uwierzytelniania czy każdego systemu antybotowego.
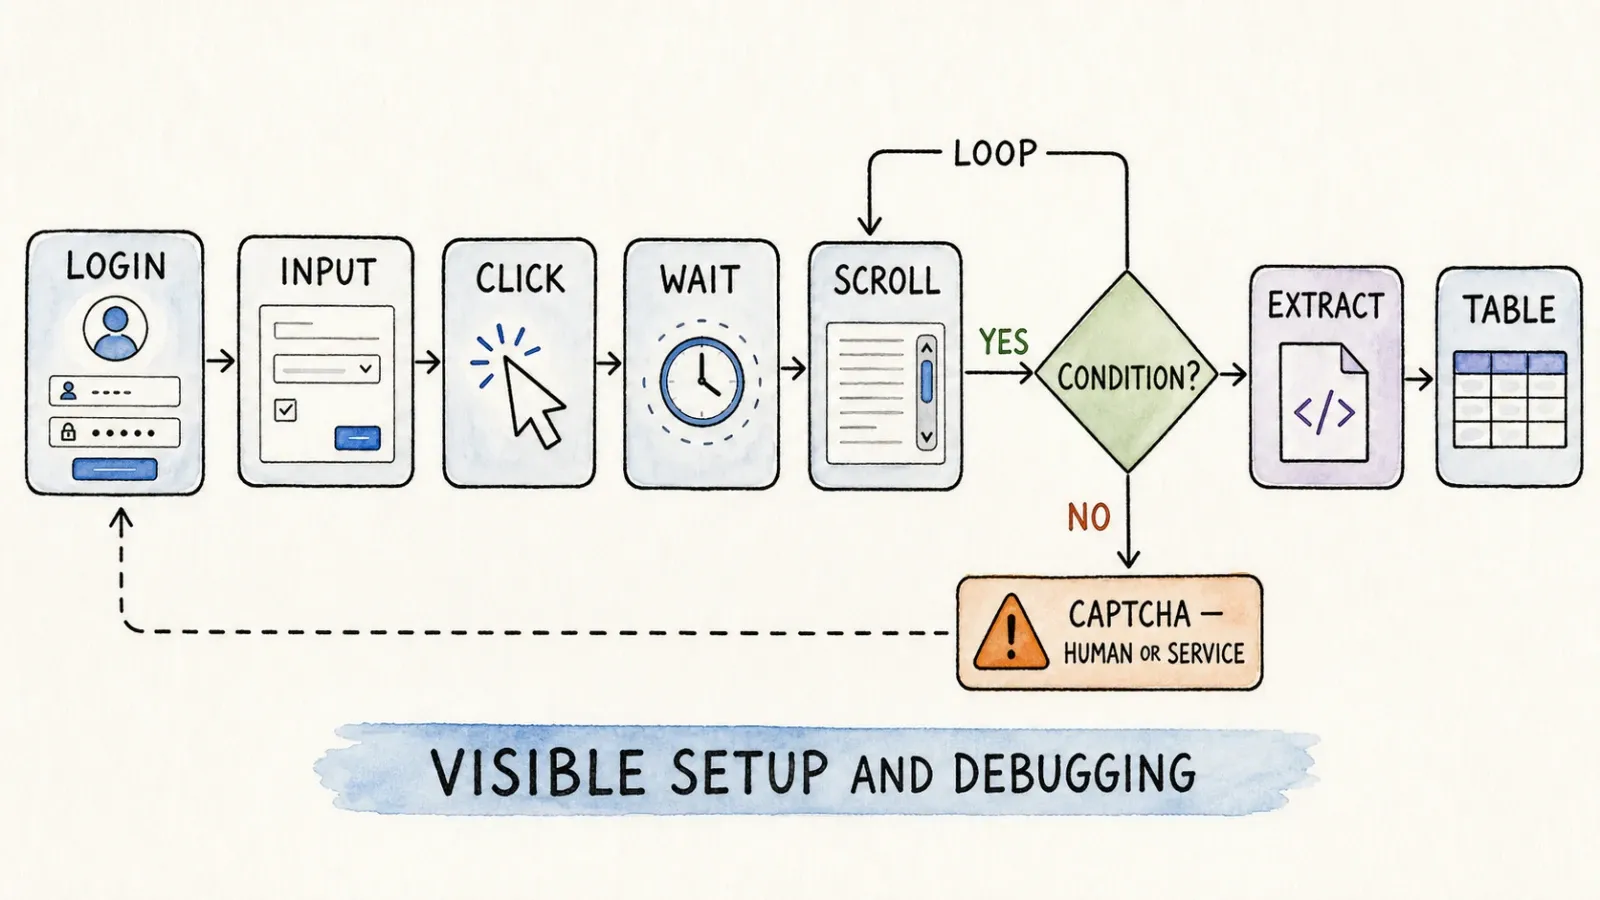
Flowchart Mode w ScrapeStorm daje jawne komponenty do wpisywania danych i klikania, więc jeśli trzeba, możesz krok po kroku odwzorować proces logowania — wpisz nazwę użytkownika, wpisz hasło, kliknij wyślij, poczekaj na przekierowanie. To bardziej „ręczne”, ale jednocześnie bardzo przejrzyste, bo dokładnie widać, co dzieje się na każdym etapie.
Jeśli chodzi o CAPTCHA: w planie Business ScrapeStorm oferuje funkcje obsługi CAPTCHA. Nie powinno się opisywać żadnego z tych narzędzi jako czegoś, co omija każdy system antybotowy — to po prostu nierealistyczne twierdzenie dla jakiegokolwiek scrapera.
Regularne, cykliczne pobieranie danych
Jeśli potrzebujesz tych danych co tydzień albo codziennie, oba narzędzia oferują harmonogramy — Thunderbit w planach opartych na chmurze (sprawdź szczegóły swojego aktualnego planu), a ScrapeStorm od poziomu Premium z opcjami godzinowymi/dziennymi/tygodniowymi oraz automatycznym eksportem.
Automatyzacja i dostęp dla deweloperów
Dla zespołów, które chcą wyjść poza klikanie, oba narzędzia mają warstwę dla deweloperów, ale są zbudowane inaczej.
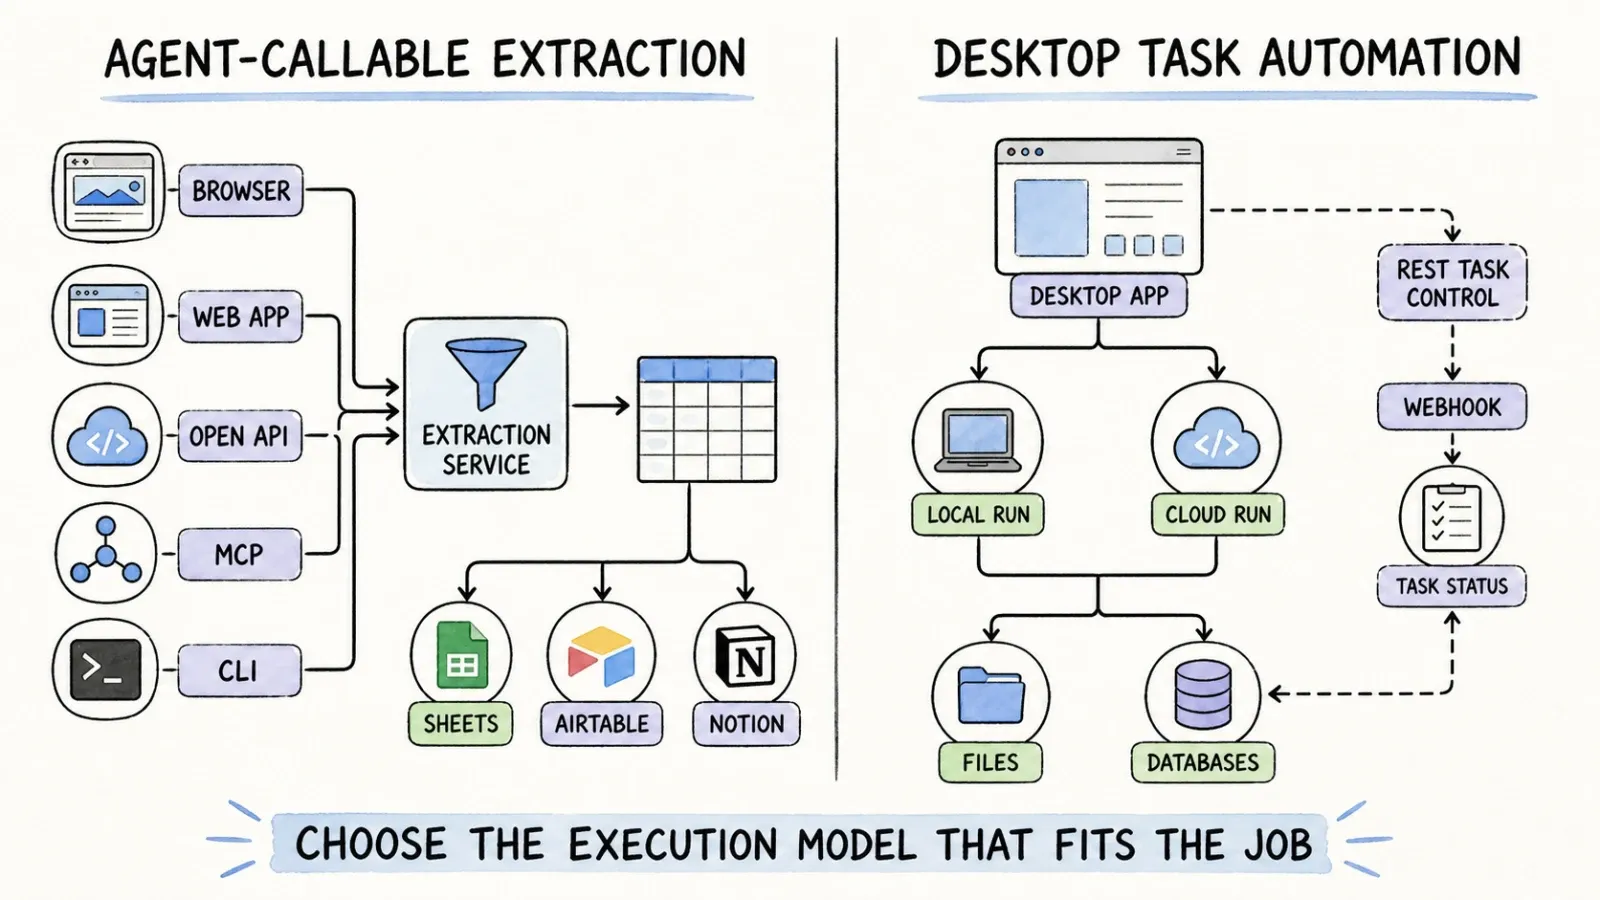
W planie Business ScrapeStorm zawiera RESTful API, które pozwala sterować zadaniami uruchomionymi w lokalnej aplikacji ScrapeStorm — wczytać zadanie, sprawdzić jego status, uruchomić, zatrzymać, wyczyścić dane i tak dalej. Dochodzą też webhooki oraz grupy zadań. Chcę to powiedzieć precyzyjnie: to automatyzacja sterowania zadaniami w lokalnie uruchomionej aplikacji desktopowej, a nie hostowane API do ekstrakcji, które pobiera dane i zwraca je z jakiegoś zewnętrznego serwera. To istotna różnica, jeśli budujesz wokół tego większy system.
Open API Thunderbit działa bardziej jak klasyczne API — możesz programowo uruchomić ekstrakcję i otrzymać z powrotem uporządkowane dane bez konieczności uruchamiania lokalnej aplikacji desktopowej. MCP Server jest naprawdę ciekawy dla osób budujących dziś z agentami AI — udostępnia możliwości ekstrakcji Thunderbit jako narzędzie, które agenci w Claude, Cursor lub podobnych środowiskach mogą wywoływać bezpośrednio. A CLI daje osobom pracującym z terminalem możliwość skryptowania zadań ekstrakcyjnych.
Jeśli budujesz przepływy agentowe albo chcesz traktować ekstrakcję jako jeden z kroków większego zautomatyzowanego procesu, uważam, że kombinacja API/MCP to miejsce, w którym architektura Thunderbit naprawdę wysuwa się na prowadzenie w zastosowaniach deweloperskich.
Eksport i wdrożenie
Opcje eksportu w ScrapeStorm mocno kierują się w stronę pracy na plikach lokalnych i bazach danych: Excel, TXT, CSV, HTML lokalnie, a do tego bezpośrednie połączenia z MySQL, PostgreSQL, SQL Server i MongoDB. Integracja z Google Sheets i automatyczny eksport pojawiają się od poziomu Premium.
Eksporty Thunderbit są budowane wokół narzędzi, w których żyją zespoły biznesowe — Excel, Google Sheets, Airtable, Notion — oraz innych aktualnie obsługiwanych formatów (sprawdź stronę Thunderbit po aktualną listę).
Głębsza różnica operacyjna jest taka: model desktopowy ScrapeStorm oznacza, że zarządzasz plikami zadań i uruchamiasz aplikację na konkretnym komputerze (albo na maksymalnie trzech jednocześnie w planie Business). Model przeglądarkowy i chmurowy Thunderbit oznacza mniejszy narzut związany z zarządzaniem maszynami, ale też mniej tego „wszystko działa tylko na moim komputerze”, co niektóre zespoły pracujące na wrażliwych danych wolą mieć pod pełną kontrolą.
Cennik
Zawsze radzę sprawdzać aktualne strony z cennikiem przed podjęciem decyzji, bo ceny subskrypcji zmieniają się częściej, niż ktokolwiek by chciał. To powiedziawszy, oto, co pokazuje oficjalny cennik ScrapeStorm według stanu na dzień moich badań:
- Starter (Free): 10 zadań, jedno równoczesne uruchomienie lokalne, nieograniczona liczba URL-i/stron na zadanie, ale limit 100 wyeksportowanych wierszy dziennie
- Professional (45 USD/mies., albo 39 USD/mies. przy rozliczeniu rocznym): 100 zadań, dwa równoczesne uruchomienia lokalne, limit eksportu 10 000 wierszy dziennie, rotacja IP
- Premium (89 USD/mies., albo 79 USD/mies. rocznie): nielimitowane zadania, nielimitowane równoczesne uruchomienia lokalne, nielimitowany eksport danych, harmonogram, integracja z Google Sheets, pobieranie obrazów
- Business (179 USD/mies., albo 158 USD/mies. rocznie): wszystko z Premium plus REST API, webhooki, grupy zadań, pobieranie plików, funkcje obsługi CAPTCHA oraz do trzech równoczesnych komputerów
- Customized: wycena na zapytanie
Chcę zwrócić uwagę na ważną rzecz dotyczącą zapisu „nieograniczona liczba URL-i/stron na zadanie” w darmowym planie — nieograniczone crawlowanie stron nie oznacza nieograniczonego użytecznego wyniku, skoro nadal obowiązuje limit 100 eksportowanych wierszy dziennie. Moc obliczeniowa lokalnego komputera, zachowanie strony docelowej, limity współbieżności i koszty proxy (które mogą być sprzedawane osobno) wszystko razem wpływają na to, jak to „nielimitowane” wygląda w praktyce.
Aktualny cennik Thunderbit sprawdzaj bezpośrednio na oficjalnej stronie cenowej — struktura planów i system kredytów potrafią się zmieniać, a wolę odesłać Cię do źródła niż podawać liczby, które mogą być nieaktualne, gdy to czytasz.
Które narzędzie wybrać?
Wybierz Thunderbit, jeśli...
Jesteś użytkownikiem biznesowym — ze sprzedaży, operacji, marketingu albo badań — który potrzebuje danych szybko i nie chce spędzać popołudnia na nauce logiki działania nowego narzędzia. Pracujesz głównie w przeglądarce, chcesz, żeby kompatybilna paginacja i wzbogacanie podstron działały bez dodatkowej konfiguracji, i wolisz dopracować wynik zwykłym językiem niż debugować schemat blokowy.
Wybierz ScrapeStorm, jeśli...
Nie przeszkadza Ci — albo wręcz zależy Ci na — bardzo precyzyjnej kontroli logiki interakcji z przeglądarką. Pracujesz ze stronami, które wymagają złożonej, wieloetapowej nawigacji — logowania, filtrów z list rozwijanych, gałęzi warunkowych — i chcesz wizualnie odwzorować oraz debugować dokładnie taką sekwencję. Zależy Ci też na eksporcie do lokalnych baz danych i nie masz nic przeciwko zarządzaniu aplikacją desktopową na komputerach zespołu.
Użyj obu, jeśli...
Szczerze? Zdarza się to częściej, niż ludzie przyznają. Rozmawiałem z zespołami, które używają Thunderbit do szybkich, jednorazowych pobrań z przeglądarki i ad hoc researchu, a jednocześnie utrzymują w ruchu zaplanowane zadania Flowchart Mode w ScrapeStorm dla kilku złożonych stron chronionych logowaniem, gdzie potrzebna jest właśnie taka precyzyjna kontrola krok po kroku. Nie ma zasady mówiącej, że w całej organizacji musisz używać tylko jednego narzędzia do każdego zadania scrapingu.
Ostateczny werdykt
Gdybym miał to zamknąć w jednym zdaniu: Thunderbit daje najkrótszą drogę od „otwórz stronę” do „uporządkowane dane” dzięki delegowaniu do agenta, podczas gdy ScrapeStorm oferuje hybrydę automatycznego wykrywania i ręcznej, wizualnej kontroli, gdy witryna naprawdę wymaga logiki krok po kroku.
Żadne z nich nie jest obiektywnie „lepsze” w oderwaniu od kontekstu — takie podejście jest po prostu trochę leniwe. To, co naprawdę polecam: wybierz jedną realną stronę docelową, do której masz uprawniony dostęp, taką, która ma znaczenie dla Twojego faktycznego procesu, i przetestuj oba narzędzia na tym samym przykładzie. Zmierz, ile trwa konfiguracja. Sprawdź, czy wynik nadaje się do użycia od razu, czy wymaga czyszczenia. Zastanów się, kto w Twoim zespole będzie to utrzymywał za sześć miesięcy.
To jest prawdziwe porównanie — nie tabela funkcji (nawet dobra, jak ta powyżej), ale Twoje realne dane i rzeczywista cierpliwość zespołu do konfiguracji. Jeśli chcesz zobaczyć, jak podejście agentowe radzi sobie z Twoją konkretną stroną, rozszerzenie Thunderbit do Chrome można wypróbować za darmo — kliknij One Click Extract na stronie, która jest dla Ciebie ważna, i zobacz, co zwróci, zanim zdecydujesz się na coś bardziej złożonego.
FAQ
Czy ScrapeStorm naprawdę jest oparte na AI?
Smart Mode w ScrapeStorm wykorzystuje automatyczne rozpoznawanie wzorców, aby identyfikować struktury list i treści oraz paginację na wielu typach stron, co producent opisuje jako funkcję AI / inteligentnego wykrywania. To realna możliwość, ale ograniczona do rozpoznawalnych wzorców stron, a nie do bardziej otwartego, agentowego rozumowania, którego Thunderbit używa do interpretowania dowolnych struktur.
Jaka jest różnica między Smart Mode a Flowchart Mode?
Smart Mode automatycznie próbuje wykryć dane i paginację na stronach typu list/treść przy minimalnej konfiguracji. Flowchart Mode wymaga zbudowania jawnego, wizualnego przepływu pracy z komponentów takich jak kliknięcie, czekanie, przewijanie, wpisywanie, warunek i pętla — daje to większą kontrolę nad stronami, których Smart Mode nie obsłuży płynnie, ale kosztem dłuższego czasu konfiguracji.
Czy Thunderbit wymaga selektorów albo kodowania?
Nie. Domyślny proces w przeglądarce jest agentowy — kliknij One Click Extract, a narzędzie wykryje, przeczyta i przeanalizuje stronę, proponując pola, a potem uruchomi ekstrakcję automatycznie (Run Now pozwala po prostu zacząć od razu, bez czekania). W standardowym procesie nie są potrzebne XPath, selektory CSS ani ręczne projektowanie schematu.
Czy oba narzędzia obsługują paginację i strony logowania?
Oba oferują odpowiednie możliwości, ale żadne nie gwarantuje sukcesu w każdym przypadku. Thunderbit obsługuje kompatybilną paginację i wzbogacanie podstron na wspieranych stronach oraz może działać w autoryzowanej, zalogowanej sesji przeglądarki, jeśli jest to możliwe. Smart Mode w ScrapeStorm automatycznie wykrywa paginację na wielu typach stron, a Flowchart Mode ma jawne komponenty do modelowania logowania i złożonej nawigacji. Wynik zawsze zależy od konkretnej struktury strony, metody uwierzytelniania i zastosowanych zabezpieczeń antybotowych.
Czy ScrapeStorm oferuje API?
Tak, w planie Business. To RESTful API do sterowania zadaniami uruchomionymi w lokalnie zainstalowanej aplikacji ScrapeStorm — uruchamiania, zatrzymywania, sprawdzania statusu i czyszczenia zadań, a także wsparcie webhooków. To automatyzacja sterowania zadaniami, a nie hostowane API do ekstrakcji działające niezależnie od lokalnej instalacji desktopowej.
Które narzędzie lepiej nadaje się do harmonogramów?
Oba wspierają planowanie. ScrapeStorm oferuje harmonogramy w aplikacji desktopowej od poziomu Premium, z opcjami godzinowymi/dziennymi/tygodniowymi i automatycznym eksportem. Thunderbit oferuje harmonogramy oparte na chmurze w zależności od aktualnego planu — dokładne, bieżące szczegóły sprawdzaj na stronie cen Thunderbit.
Czy któreś z nich potrafi pobrać dane z każdej strony?
Nie — i każde narzędzie, które twierdziłoby coś takiego, powinno wzbudzić Twoją ostrożność. Zarówno Thunderbit, jak i ScrapeStorm zależą od tego, czy strona jest dostępna, strukturalnie kompatybilna i czy masz do niej uprawniony dostęp. Silne zabezpieczenia antybotowe, nietypowe renderowanie JavaScript i restrykcyjne uwierzytelnianie mogą ograniczyć działanie obu narzędzi. Zawsze testuj na rzeczywistej stronie docelowej, zanim zbudujesz wokół niej cały proces.




