
Co kilka tygodni ktoś z naszego zespołu wsparcia przekazuje mi od potencjalnego klienta to samo pytanie: „Czym Thunderbit różni się od ScraperAPI?”. Rozumiem, skąd bierze się to pytanie — oba narzędzia pojawiają się w tych samych wynikach Google po haśle „web scraping tool”, oba mają na stronie głównej słowa „scrape” lub „scraper”, i oba obiecują dostarczyć dane z internetu. Ale po latach budowania produktów automatyzacyjnych i AI (i po wcześniejszym czasie spędzonym na rozplątywaniu chaotycznych pipeline’ów danych w Automation Anywhere) mogę powiedzieć jedno: te dwa narzędzia odpowiadają na zupełnie różne potrzeby.
To tak naprawdę nie jest porównanie w stylu „które jest lepsze” — to raczej zestawienie firmy przeprowadzkowej z osobistym asystentem. Oba pomagają załatwiać sprawy, ale nie zatrudniłbyś jednego do pracy drugiego. Dlatego przejdę przez to, czym naprawdę jest ScraperAPI, czym naprawdę jest Thunderbit, ile każde z nich kosztuje w realnych scenariuszach (i to wreszcie w porównaniu obok siebie, bo zauważyłem, że nikt tego dotąd nie rozpisał), oraz kto powinien wybrać które. Bez unikania odpowiedzi, bez wymówek w stylu „to zależy”, jeśli da się ich uniknąć.
Thunderbit kontra ScraperAPI: szybka odpowiedź w skrócie
Oto wersja w jednym zdaniu, bo wiem, że część z Was czyta to w przerwie na lunch: ScraperAPI to infrastruktura dla deweloperów do scrapowania na dużą skalę — proxy, obsługa CAPTCHA i renderowanie, wszystko dostarczane przez API. Thunderbit to agentowa, bezkodowa warstwa ekstrakcji, która zamienia oglądane przez Ciebie strony w uporządkowane dane, z rozszerzeniem do przeglądarki, aplikacją webową, Open API i MCP Server pod spodem.
A oto tabela referencyjna, którą sam chciałbym mieć, gdy pierwszy raz zacząłem dostawać takie pytania:
| ScraperAPI | Thunderbit | |
|---|---|---|
| Najlepsze dla | Zespołów inżynieryjnych budujących pipeline’y do scrapowania | Użytkowników biznesowych, marketingu, operacji i deweloperów, którzy chcą szybko dostać uporządkowane dane |
| Wymagany start | Klucz API + parametry żądania + własna logika parsowania | Kliknij One Click Extract na stronie (rozszerzenie do przeglądarki) albo użyj Open API/MCP do automatyzacji |
| Format wyjściowy | Surowy HTML/JSON, parsery strukturalne dla wspieranych witryn | Uporządkowane, eksportowalne tabele |
| Wymagane kodowanie | Tak, w większości realnych zastosowań | Nie w przypadku przepływu przeglądarkowego; tak, jeśli używasz API/CLI/MCP |
| Idealny użytkownik | Deweloper lub techniczny zespół operacyjny | Osoba nietechniczna, a także deweloperzy, którzy chcą szybszej warstwy strukturyzacji |
Jeśli już wiesz, do której grupy należysz, przejdź do odpowiadającej Ci sekcji poniżej — jedna opisuje dokładniej ScraperAPI, druga Thunderbit, a dalej znajdziesz też realne porównanie cen i ramy decyzyjne, które powinny rozstrzygnąć pytanie „co będzie dla mnie” w mniej niż dwie minuty.
Czym jest ScraperAPI? Narzędzie stworzone dla deweloperów i infrastruktury scrapującej
ScraperAPI to po prostu usługa, do której wysyłasz adres URL, a ona odsyła treść strony, jednocześnie po cichu ogarniając trudne elementy scrapowania — rotujące proxy, ponawianie nieudanych żądań, omijanie CAPTCHA i systemów wykrywania botów oraz opcjonalne renderowanie stron mocno opartych na JavaScript tak, jak zrobiłaby to zwykła przeglądarka. Nadal to Ty piszesz kod, który wywołuje API i parsuje wynik.
To ważna różnica, o której — moim zdaniem — mówi się za mało. ScraperAPI nie jest już wyłącznie „surowym HTML-em” — jego obecny zestaw funkcji obejmuje automatyczne parsowanie do JSON i endpointy z danymi strukturalnymi dla wspieranych źródeł, a także produkt DataPipeline i pełny dostęp do crawlera przy większych zadaniach. Czyli nie utknęło w 2018 roku. Ale podstawowe założenie produktu pozostaje takie, że masz wokół niego zbudowany (albo dopiero budujesz) proces inżynieryjny: coś, co wysyła żądania, sprawdza odpowiedzi, obsługuje ponawianie prób na poziomie aplikacji i zapisuje wynik w odpowiednim miejscu.
Tam, gdzie ScraperAPI naprawdę błyszczy, jest praca na poziomie infrastruktury: setki tysięcy albo miliony żądań miesięcznie, kierowane do witryn aktywnie walczących z botami. To trudny problem, a zlecenie zarządzania proxy firmie, której całym zajęciem jest zarządzanie proxy, to dla wielu zespołów inżynieryjnych bardzo rozsądny ruch. Powiem to jasno, bo niektóre artykuły porównawcze lubią przesadzać w obie strony: ScraperAPI nie gwarantuje obejścia każdego systemu anty-bot na świecie, a wskaźniki typu uptime podawane w marketingu są deklaracjami dostawcy, a nie niezależnie zweryfikowanymi benchmarkami. Traktuj je jako punkt wyjścia, nie jako świętą prawdę.
Kto w ogóle powinien rozważyć ScraperAPI?
Najpewniej pasujesz, jeśli:
- Potrafisz pisać kod wysyłający żądania API i parsujący odpowiedzi
- Musisz scrapować na realną skalę — od dziesiątek tysięcy do milionów stron miesięcznie
- Potrzebujesz rotacji proxy, geotargetowania i obsługi anty-bot wbudowanej bezpośrednio w pipeline żądań
- Masz już (albo chcesz zbudować) pipeline danych, w którym ScraperAPI będzie warstwą „dostępu”
Jeśli któreś z powyższych sprawiło, że kiwnąłeś głową — ScraperAPI powinien zostać na Twojej krótkiej liście. Jeśli za to zrobiło Ci się od tego ciężko w oczach, zostań — kolejna sekcja będzie prawdopodobnie bardziej w Twoim stylu.
Czym jest Thunderbit? Agentowa, bezkodowa warstwa ekstrakcji
Thunderbit zaczyna z zupełnie innego miejsca: zamiast zakładać, że sam napiszesz logikę ekstrakcji, sam ją za Ciebie wyprowadza. Klikasz One Click Extract, a AI Thunderbit podpowiada właściwe pola i strategię ekstrakcji, po czym zamienia stronę w uporządkowane dane — nazwy produktów, ceny, dane kontaktowe, oferty pracy albo cokolwiek innego ta strona faktycznie zawiera.

Ta prostota ma ogromne znaczenie dla osób nietechnicznych, dla których zbudowano Thunderbit: przejście od strony internetowej do gotowego arkusza zajmuje jedno kliknięcie, bez selektorów, projektowania schematu czy pisania kodu do scrapowania. Nikt nie chce pracy domowej, zanim dostanie swój arkusz.
Thunderbit nie ogranicza się też do przeglądarki. Jest aplikacja webowa do uruchomień w chmurze, Open API dla deweloperów, którzy chcą wywoływać ekstrakcję programowo, MCP Server do podpinania Thunderbit do agentów AI takich jak Claude czy Cursor, oraz CLI dla workflowów terminalowych. Czyli choć flagowe doświadczenie jest bezkodowe, nie jest to wyłącznie narzędzie no-code — trafniej byłoby nazwać je warstwą strukturyzacji danych z wieloma wejściami do tej samej funkcji pod spodem.
I żeby od razu uprzedzić coś, do czego jeszcze wrócę: Thunderbit nie jest produktem do rotacji proxy ani do obchodzenia zabezpieczeń anty-bot. Jest zbudowany do wyciągania uporządkowanych danych ze stron, do których już masz dostęp, a nie do przebijania się przez ściany CAPTCHA na dużą skalę. To zupełnie inna robota.
Kto w ogóle powinien rozważyć Thunderbit?
Najpewniej pasujesz, jeśli:
- Jesteś w sprzedaży, marketingu, operacjach albo badaniach i potrzebujesz dziś danych ze strony, a nie po dwutygodniowym sprincie inżynieryjnym
- Chcesz, żeby dane od razu trafiły do Excela, Google Sheets, Airtable albo Notion, bez pisania parsera
- Wolisz kliknąć przycisk niż pisać scraper, i to nie jest żadna wada charakteru, tylko zwykła efektywność
- Jesteś deweloperem, który chce szybszej warstwy z danymi strukturalnymi do wewnętrznych narzędzi, nawet jeśli umiesz programować
Jak to działa: architektura i workflow obok siebie
Najprościej ująłbym tę różnicę tak: ScraperAPI daje Ci surowy materiał i zakłada, że sam zbudujesz z niego meble. Thunderbit próbuje wręczyć Ci już złożone meble.
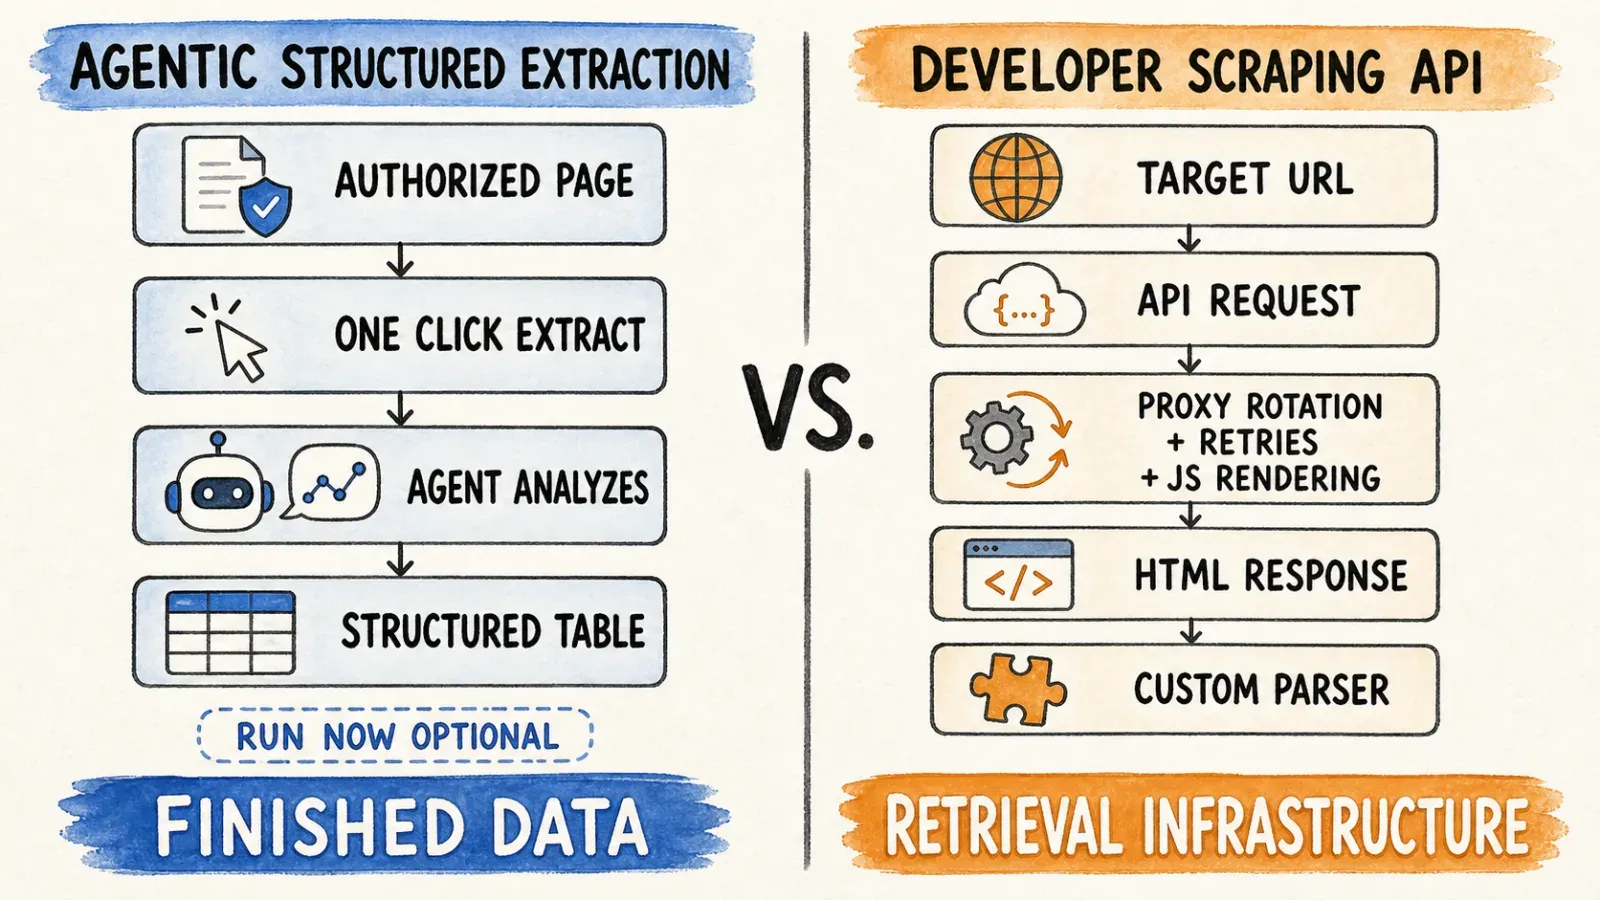
Pod maską architektura ScraperAPI jest najpierw oparta na proxy i renderowaniu. Twoje żądanie przechodzi przez jego sieć, jest kierowane przez adresy IP klasy residential albo mobile, w razie potrzeby renderowane przez headless browser, jeśli wymaga tego JavaScript, a potem wraca do Ciebie jako HTML, JSON albo sparsowana struktura dla wspieranych domen. Cała reszta — projekt schematu, storage, deduplikacja, harmonogramy — spoczywa na Tobie, chyba że używasz konkretnie produktów DataPipeline lub crawlera stworzonych właśnie do tego.
Architektura Thunderbit jest najpierw analityczna. Agent najpierw czyta strukturę i treść strony, zanim zdecyduje, co ma wydobyć, co oznacza, że etap „schematu”, który deweloper zwykle kodowałby ręcznie, odbywa się automatycznie. Wynik nie jest surowcem — to tabela, którą można bez wstydu wysłać menedżerowi sprzedaży.
Tabela porównawcza: podstawowe mechanizmy
| ScraperAPI | Thunderbit | |
|---|---|---|
| Model działania | Rotacja proxy + surowy HTML/renderowanie JS przez API | Agentowa analiza strony → strukturalna ekstrakcja przez rozszerzenie, aplikację webową, API, MCP Server |
| Start | Wyślij żądanie do endpointu z parametrami | Kliknij One Click Extract; AI proponuje pola i strategię ekstrakcji, a potem uruchamia proces |
| Wynik | Surowy HTML/JSON, parsery strukturalne dla wspieranych stron | Uporządkowane, eksportowalne dane |
| Najlepsze zastosowanie | Pipeline’y scrapujące na poziomie infrastruktury | Szybka, uporządkowana, bezkodowa ekstrakcja z dostępnej strony |
Żaden z tych modeli nie jest „lepszy” sam w sobie — każdy rozwiązuje inne wąskie gardło. W przypadku ScraperAPI wąskim gardłem jest dostęp (przejście przez blokady). W przypadku Thunderbit wąskim gardłem jest zrozumienie (zamiana chaotycznej strony w użyteczne wiersze danych).
Thunderbit kontra ScraperAPI: koszt za 1 000 stron w praktyce
Szczerze mówiąc, to właśnie ta część sprawiła, że chciałem napisać cały ten artykuł. Każde dogłębne omówienie cen ScraperAPI szczegółowo wyjaśnia jego system mnożników kredytów, a każda strona cenowa Thunderbit opisuje własne plany — ale nikt nie stawia ich obok siebie i nie mówi: „okej, ale ile to właściwie kosztuje w tym, co próbuję zrobić?”.
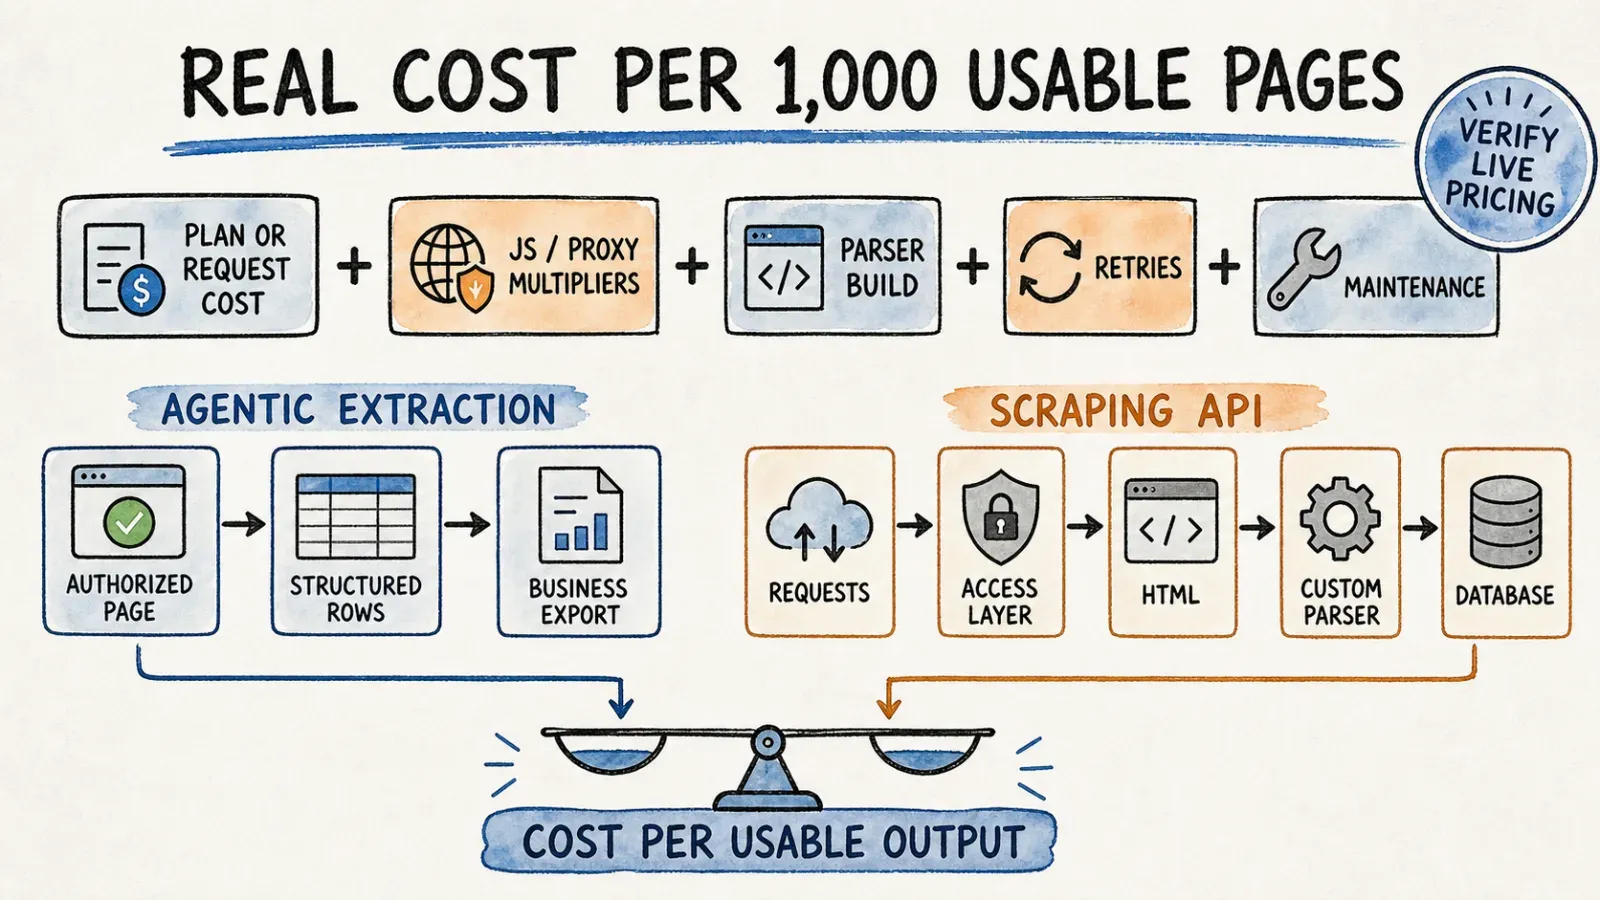
Zróbmy więc obliczenia, które umożliwia oficjalna dokumentacja ScraperAPI. Jego system kredytów nalicza różne stawki bazowe w zależności od celu: zwykła strona kosztuje 1 kredyt, Amazon 5 kredytów, wyniki Google lub Bing 25 kredytów, a LinkedIn 30 kredytów. Dodatkowo obejście systemów ochrony botów, takich jak Cloudflare czy DataDome, może dorzucić kolejne 10 kredytów, a renderowanie JavaScriptu lub funkcje premium proxy mogą zwiększyć koszt jeszcze bardziej — dokładna wartość zależy od źródła, więc jedynym wiarygodnym punktem odniesienia przed wyborem planu jest własny estimator kosztów w panelu ScraperAPI.
Przyjmując plan Hobby (49 USD za 100 000 kredytów, czyli około 0,00049 USD za kredyt) jako bazę dla 1 000 stron:
| Scenariusz | Koszt ScraperAPI za 1 000 stron (stawka planu Hobby) | Koszt ScraperAPI za 1 000 stron (stawka planu Business) |
|---|---|---|
| Proste statyczne strony (1 kredyt/strona) | ok. 0,49 USD | ok. 0,10 USD |
| Strony e-commerce w stylu Amazon (5 kredytów/strona) | ok. 2,45 USD | ok. 0,50 USD |
| Scrapowanie wyników Google/Bing SERP (25 kredytów/strona) | ok. 12,25 USD | ok. 2,49 USD |
| Strony LinkedIn (30 kredytów/strona) | ok. 14,70 USD | ok. 2,99 USD |
Ten zakres szybko się powiększa, gdy doliczymy renderowanie JS albo dopłaty za omijanie zabezpieczeń, a jednocześnie wyraźnie się zwęża na planach o większym wolumenie, ponieważ stawka za kredyt spada w miarę przechodzenia z Hobby do Business, Scaling lub Professional. To właśnie ten fragment większość artykułów porównawczych pomija — rzeczywisty koszt pojedynczej strony w ScraperAPI mocno zależy zarówno od typu witryny, jak i od poziomu planu.
Model cenowy Thunderbit działa strukturalnie inaczej: zamiast mnożników zależnych od domeny, gdzie scrapowanie LinkedIn kosztuje 30 razy więcej niż zwykłego bloga, plany Thunderbit opierają się na miesięcznych limitach kredytów związanych z liczbą wierszy lub stron, które wyciągasz, i skalują się wraz z planem. Nie będę tu wymyślał konkretnej liczby za kredyt, bo cenniki się zmieniają, a wolę odesłać Cię do aktualnej strony cenowej Thunderbit, niż podawać wartość, która za trzy miesiące będzie już nieaktualna. Mogę za to powiedzieć jedno: przy jednorazowym zadaniu — na przykład wyciągnięciu 500 leadów z katalogu albo zeskrobaniu kilkuset ofert produktów dla audytu klienta — nie będziesz siedzieć i liczyć mnożników kredytów przed uruchomieniem. Po prostu uruchamiasz ekstrakcję, a Twój plan określa, ile takich uruchomień dostajesz w miesiącu.
Wniosek: jeśli robisz scrapowanie na poziomie infrastruktury, na wielu różnych typach domen, i potrafisz wcześniej przewidzieć mnożniki kredytów, model kosztowy ScraperAPI nagradza planowanie i wolumen. Jeśli wykonujesz uporządkowaną, doraźną lub biznesową ekstrakcję, gdzie wartość leży w gotowej tabeli, a nie w liczbie żądań, model Thunderbit jest zbudowany dokładnie pod taki przypadek.
Które narzędzie wybrać? Ramy decyzyjne oparte na personach
Zauważyłem, że artykuły zajmujące najwyższe pozycje dla tego porównania nigdy tak naprawdę nie odpowiadają na pytanie, którego ludzie szukają, czyli w praktyce: „czy jestem deweloperem, który potrzebuje infrastruktury, czy osobą biznesową, która po prostu potrzebuje danych?”. Odpowiem więc wprost.
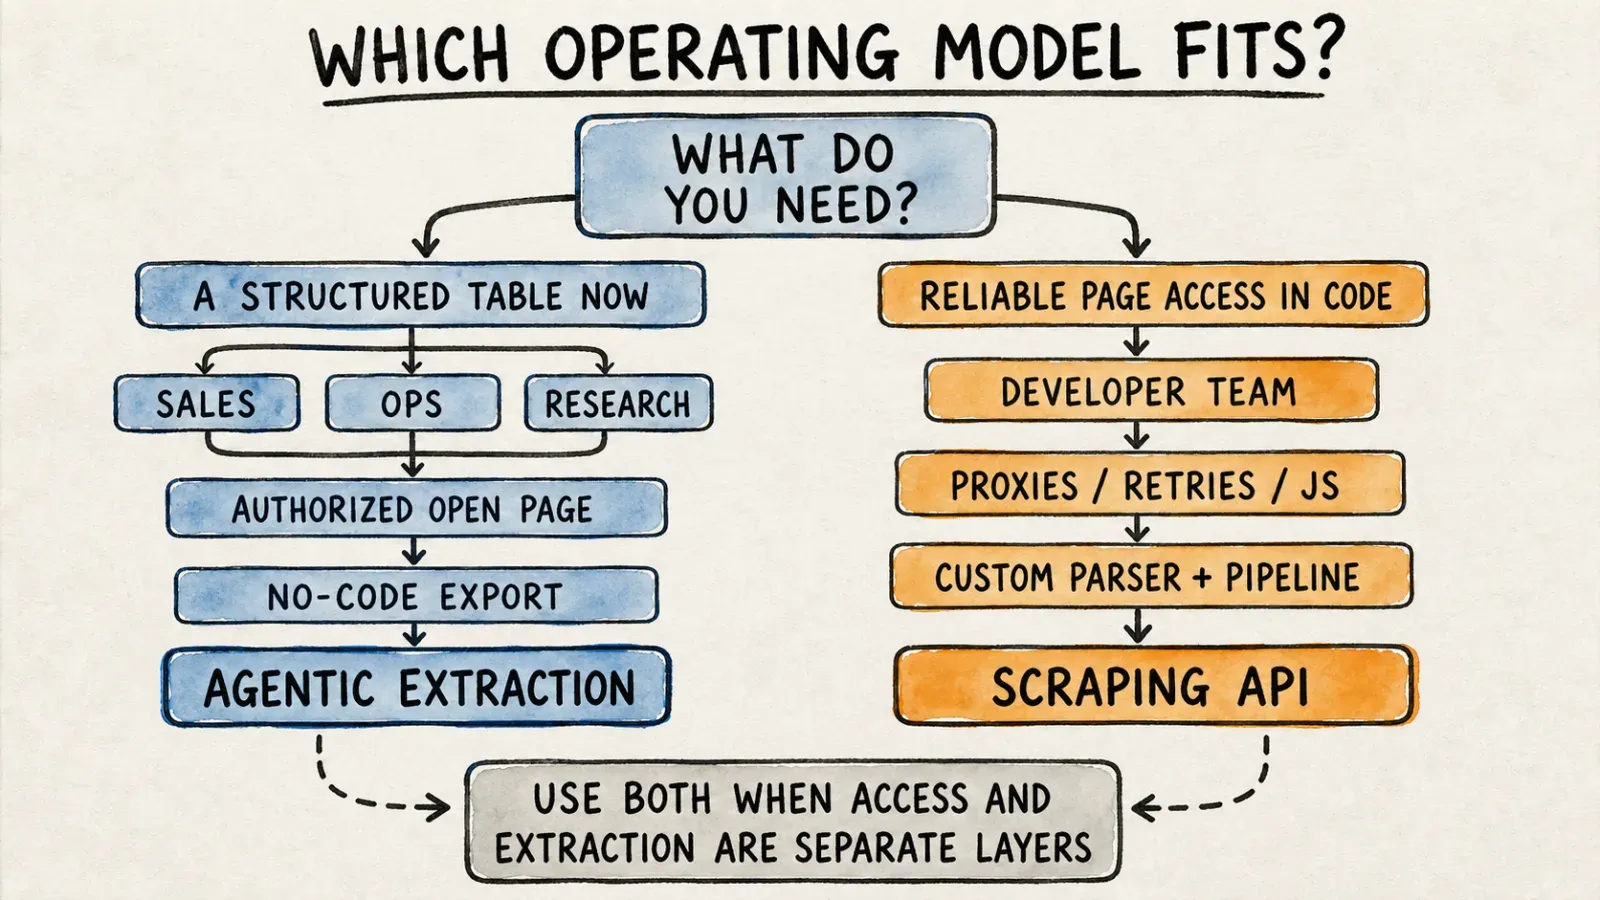
Wybierz ScraperAPI, jeśli...
- Jesteś deweloperem lub zespołem inżynieryjnym budującym infrastrukturę scrapującą na dużą skalę
- Potrzebujesz rotacji proxy i obsługi CAPTCHA wbudowanej bezpośrednio w wywołania API
- Swobodnie piszesz logikę żądań i parsujesz surowy HTML lub odpowiedzi JSON
- Twój przypadek użycia obejmuje miliony żądań miesięcznie w wielu różnych domenach
Wybierz Thunderbit, jeśli...
- Jesteś użytkownikiem biznesowym, marketerem albo operatorem, który potrzebuje uporządkowanych danych ze strony, którą już ogląda
- Wolisz kliknąć One Click Extract i pozwolić agentowi samodzielnie dobrać pola niż pisać choćby jedną linię kodu do scrapowania
- Chcesz, żeby wynik od razu trafił do Excela, Google Sheets, Airtable albo Notion
- Jesteś deweloperem, który chce szybszej warstwy danych strukturalnych do narzędzi wewnętrznych bez budowania logiki ekstrakcji od zera
Pierwszy przyznam, że to nie jest wybór binarny dla wszystkich. Rozmawiałem z zespołami, które używają obu narzędzi — inżynieria obsługuje pipeline ScraperAPI dla infrastruktury o dużym wolumenie, a sprzedaż i marketing korzystają z Thunderbit przy prośbach typu „potrzebuję tej listy leadów do czwartku”, które inaczej utknęłyby w backlogu inżynieryjnym na dwa tygodnie. To połączenie naprawdę ma sens, gdy przestajesz zmuszać jedno narzędzie do wykonywania pracy drugiego.
Czy Thunderbit zastępuje ScraperAPI? Wyjaśnienie nieporozumienia
To właśnie tutaj widzę najwięcej pomyłek i chcę powiedzieć to wprost, zamiast krążyć wokół tematu ze względów SEO. Ludzie wpisują „AI scraper tool” i wrzucają każdy wynik — w tym Thunderbit — do tego samego mentalnego worka co „infrastruktura scrapująca”. To nie jest ten sam worek.
Thunderbit to warstwa strukturyzacji danych. Została zbudowana po to, by zamienić stronę, do której już masz dostęp, w użyteczne, eksportowalne dane, używając AI do wykrycia pól zamiast zmuszania Cię do ręcznego definiowania schematu. Nie jest to produkt infrastrukturalny do rotacji proxy ani obchodzenia zabezpieczeń anty-bot, tak jak ScraperAPI. Jeśli musisz przebijać się przez wyzwania Cloudflare w dziesięciu tysiącach różnych domen dziennie, to jest terytorium ScraperAPI, nie Thunderbit.
Ale odwróćmy sytuację: ScraperAPI nie oferuje bezkodowego wykrywania pól przez AI. Chętnie zwróci Ci HTML strony chronionej silnym systemem anty-bot, ale nadal to Ty decydujesz, co w tym HTML oznacza „cena” albo „stanowisko pracy”, i piszesz kod do wyciągnięcia tych danych. Żadne z tych narzędzi nie próbuje być drugim i wolałbym powiedzieć to jasno, niż pozwolić Ci odkryć to na własnej skórze trzy tygodnie po starcie projektu.
W przypadku crawlowania na dużą skalę, z wysokim ryzykiem blokad, pula proxy i obsługa anty-bot w ScraperAPI pozostają bardziej naturalnym wyborem. Do szybkiej, uporządkowanej ekstrakcji ze stron, do których Ty lub Twój zespół już macie dostęp, agentowe podejście Thunderbit zostało stworzone właśnie do tego. I dla uczciwości wobec obu produktów: żadnego z tych twierdzeń nie należy wyolbrzymiać — Thunderbit nie obiecuje obejścia każdego systemu anty-bot, a deklaracje uptime i skuteczności ScraperAPI są podawane przez producenta, a nie niezależnie weryfikowane.
Tabela porównawcza funkcji: Thunderbit kontra ScraperAPI
Poza różnicami w architekturze i cenach, tak te dwa narzędzia wypadają w praktycznych aspektach, które zespoły naprawdę biorą pod uwagę na co dzień.
| Funkcja | ScraperAPI | Thunderbit |
|---|---|---|
| Wymagane kodowanie | Tak, w większości realnych zastosowań | Nie, w przepływie przez rozszerzenie do przeglądarki |
| Format wyjściowy | Surowy HTML/JSON, parsery strukturalne dla wspieranych stron | Uporządkowane tabele gotowe do eksportu |
| Opcje eksportu | Zarządzane przez dewelopera (własny storage/dostarczanie) | Eksport do Excel, Google Sheets, Airtable, Notion |
| Harmonogramowanie | Dostępne przez DataPipeline dla wspieranych workflowów | Dostępne w wybranych planach i warstwach produktu |
| Obsługa proxy/anty-bot | Wbudowana w każde żądanie, kluczowa funkcja produktu | Nie jest to główna funkcja; ekstrakcja dotyczy dostępnych/autoryzowanych stron |
| Warstwy automatyzacji | REST API, DataPipeline, dostęp do crawlera | Rozszerzenie do przeglądarki, aplikacja webowa, Open API, MCP Server, CLI |
| Najlepsze dopasowanie zespołu | Inżynieria / techniczne operacje | Sprzedaż, marketing, operacje, badania oraz workflowy deweloperskie |
Ostatni wiersz właściwie streszcza całą historię w jednym zdaniu. Jeśli w Slacku Twojego zespołu dominują inżynierowie, ScraperAPI prawdopodobnie już ma dla Ciebie sens. Jeśli za to w Slacku częściej pojawia się „czy ktoś może wrzucić tę listę do arkusza?”, to dokładnie po to istnieje Thunderbit.
Dostęp do danych, zgodność i odpowiedzialne użycie
Tę sekcję celowo zostawię krótką, bo ani ja, ani żadna z firm nie powinniśmy udzielać porad prawnych. Oba narzędzia wymagają pracy na danych publicznych lub w inny sposób autoryzowanych, przestrzegania kontroli dostępu na witrynach źródłowych, stosowania się do obowiązujących przepisów o prywatności oraz respektowania regulaminu serwisu docelowego. Ani sieć proxy ScraperAPI, ani ekstrakcja AI w Thunderbit nie sprawiają automatycznie, że dane scrapowanie staje się legalne lub zgodne z zasadami — odpowiedzialność spoczywa na osobie uruchamiającej ekstrakcję, a nie na narzędziu, które ją wykonuje. Jeśli scrapujesz cokolwiek związanego z danymi osobowymi, sesjami zalogowanych użytkowników albo stroną z wyraźnym zakazem scrapowania w regulaminie, to jest temat dla działu prawnego, a nie dla checkboxa w funkcjach.
FAQ: Thunderbit kontra ScraperAPI
Czy Thunderbit ma API tak jak ScraperAPI?
Tak. Open API Thunderbit obsługuje Distill i strukturalne Extract dla workflowów programistycznych. To inne doświadczenie niż bezkodowe rozszerzenie do przeglądarki, stworzone dla zespołów, które chcą wywoływać ekstrakcję z własnych aplikacji lub backendowych pipeline’ów.
Czy Thunderbit radzi sobie z CAPTCHA i blokadami IP tak jak ScraperAPI?
Nie. Thunderbit nie oferuje infrastruktury rotacji proxy ani omijania CAPTCHA, wokół której zbudowany jest ScraperAPI. Jest zaprojektowany do strukturalnej ekstrakcji z dostępnych, autoryzowanych stron — nie do omijania systemów anty-bot na dużą skalę.
Które narzędzie jest tańsze przy 10 000 albo 100 000 stron?
To naprawdę zależy od scenariusza. Zadania na prostych stronach statycznych przy dużym wolumenie zwykle bardziej sprzyjają cenom infrastrukturalnym ScraperAPI, gdy jesteś już na wyższym planie. Strukturalne, doraźne zadania ekstrakcji — gdzie wartość leży w gotowej tabeli, a nie w liczbie surowych żądań — zwykle bardziej sprzyjają Thunderbit. Zobacz porównanie scenariuszy wyżej, zanim założysz, że któreś z narzędzi jest automatycznie tańsze.
Czy Thunderbit jest dobrą alternatywą dla ScraperAPI?
Tylko w przypadku uporządkowanej, bezkodowej ekstrakcji. To nie jest zamiennik „drop-in” dla rotacji proxy ani infrastruktury anty-bot na dużą skalę i wolę powiedzieć to z góry, niż żebyś odkrył to w trakcie projektu.
Czy mogę używać Thunderbit i ScraperAPI razem?
Wiele zespołów dokładnie tak robi — inżynieria korzysta z ScraperAPI do dostępu na poziomie infrastruktury i dużego wolumenu, a zespoły biznesowe używają Thunderbit do uporządkowanych, jednorazowych lub cyklicznych zadań ekstrakcji, które nie wymagają pełnego sprintu inżynieryjnego. Nie ma zasady, że musisz wybrać tylko jedno.
Wybór między tymi dwoma naprawdę sprowadza się do jednego uczciwego pytania: budujesz infrastrukturę, czy po prostu potrzebujesz tabeli z danymi do końca dnia? ScraperAPI to infrastruktura do scrapowania klasy developerskiej — proxy, obsługa CAPTCHA i renderowanie, zbudowane dla zespołów, które umieją pisać logikę żądań na dużą skalę. Thunderbit to agentowa, bezkodowa warstwa ekstrakcji, stworzona dla użytkowników biznesowych, marketerów i badaczy, którzy potrzebują szybko dostać uporządkowane dane ze strony, a do tego API i warstwę MCP dla deweloperów, którzy chcą tej samej szybkości programowo. Wybierz narzędzie, które pasuje do realnego zadania przed Tobą, a nie to z bardziej efektowną stroną główną — a jeśli dziś wolisz kliknąć przycisk niż pisać scraper, możesz wypróbować rozszerzenie Thunderbit do Chrome i sprawdzić, jak daleko naprawdę zaprowadzi Cię jedno kliknięcie.




