
Ktoś na naszym Discordzie zapytał mnie ostatnio wprost: „Czym Thunderbit różni się od Nimble?”. Zacząłem szukać rzetelnej odpowiedzi i… niczego sensownego nie znalazłem. Każda wysoko notowana strona była albo cienkim, automatycznie wygenerowanym widgetem, albo listą konkurencji, w której Thunderbit wrzucano na margines jako „lekkie/no-code”, albo tekstem „Thunderbit vs coś innego”, który rankował głównie dzięki zbieżności marki. Nikt tak naprawdę nie usiadł i nie porównał obu produktów funkcja po funkcji.
Postanowiłem więc zrobić to sam — częściowo dlatego, że jestem CEO jednej z tych firm, a częściowo dlatego, że naprawdę byłem ciekaw, jak nasz produkt wypada na tle platformy zbudowanej pod zupełnie innego odbiorcę. Oto, co ustaliłem — i mały spoiler: te dwa narzędzia tak naprawdę nie walczą o tego samego klienta, co czyni to porównanie ciekawszym, a nie mniej ważnym.
Krótka odpowiedź
Jeśli chcesz najkrótszą wersję, zanim wejdę w szczegóły:
- Thunderbit jest zaprojektowany do natychmiastowej pracy „z strony do tabeli”. Otwierasz stronę, klikasz raz i dostajesz uporządkowany zestaw danych — a gdy trzeba, masz też Open API, MCP Server i CLI, żeby podpiąć to pod większy system.
- Nimble to platforma danych webowych dla programistów i firm, obejmująca produkty Search, Extract, Crawl, Map i Agent, a także zarządzane Data Services dla zespołów pracujących na dużą skalę.
- Właściwy wybór zależy od tego, kto faktycznie prowadzi proces — handlowiec, który dziś po południu chce zbudować listę prospectów, czy inżynier danych stawiający środowisko produkcyjne dla systemu RAG.
Na pierwszy rzut oka
Lubię tabele, bo wymuszają uczciwość — w tabeli nie da się lawirować tak łatwo jak w długim opisie. Oto, jak oba produkty wypadają w obszarach, które naprawdę mają znaczenie przy wyborze.
| Obszar | Thunderbit | Nimble |
|---|---|---|
| Główny użytkownik | Nietechniczni użytkownicy biznesowi (sprzedaż, ops, marketing) | Inżynierowie AI/danych, zespoły enterprise |
| Główne wejście | Rozszerzenie przeglądarki, aplikacja webowa | REST API, SDK |
| Poziom wdrożenia | Jedno kliknięcie, bez schematu i selektorów | Klucz API, wybór drivera/warstwy, konfiguracja schematu |
| Zakres ekstrakcji | Pojedyncza strona lub zestaw stron, wzbogacanie podstronami | Produkty Search, Extract, Crawl, Map, Agent |
| Podejście do anty-bota | Zarządzane renderowanie na obsługiwanych/autoryzowanych stronach | Wielopoziomowe „drivery” (VX6/VX8/VX10) z opcjami stealth |
| Wynik | Tabela, Excel, Google Sheets, Airtable, Notion | HTML, Markdown, JSON, zrzuty ekranu, parsowanie strukturalne |
| Harmonogram | Zaplanowane uruchomienia zależne od planu | Zadania synchroniczne/asynchroniczne, webhooki |
| Dostęp dla developerów | Open API, MCP Server, CLI | SDK, integracja MCP w zarządzanych Data Services |
| Obserwowalność | Podstawowa historia uruchomień w aplikacji | Status zadań, callbacki, integracja z chmurą |
| Model cenowy | Na kredyty, samodzielna obsługa | PAYG według zużycia plus roczne zarządzane plany |
| Najlepsze zastosowanie | Szybkie, jednorazowe lub cykliczne potrzeby na dane strukturalne | Infrastruktura danych webowych w skali produkcyjnej |
Czym jest Thunderbit?
Thunderbit to agentowy web scraper, który działa przede wszystkim jako rozszerzenie do przeglądarki. Workflow jest celowo prosty w najlepszym znaczeniu tego słowa: otwierasz stronę, do której masz dostęp, klikasz One Click Extract, a agent odczytuje stronę, sam rozpoznaje, co warto pobrać, i przygotowuje pola. Pojawia się przycisk Run Now — możesz kliknąć od razu, jeśli się spieszysz, albo po prostu chwilę poczekać, bo ekstrakcja uruchomi się automatycznie, jeśli nic nie zrobisz. I tyle. Bez selektorów, bez schematu, bez Pythona.
To jednak nie jest tylko narzędzie typu „kliknij i gotowe”. Jest Web App do uruchamiania i zarządzania ekstrakcjami z poziomu przeglądarki bez rozszerzenia, Open API dla zespołów, które chcą wywoływać ekstrakcję z własnych aplikacji, MCP Server, aby podłączyć Thunderbit do Claude, Cursor, Windsurf i innych agentów AI zgodnych z MCP, oraz CLI do pracy w terminalu i w przepływach z agentami kodującymi. Gdy masz już dane strukturalne, możesz wyeksportować je do Excel, Google Sheets, Airtable lub Notion, a pola dopracować zwykłymi instrukcjami po angielsku zamiast regexów.

Chcę tu być ostrożny, bo widziałem mnóstwo marketingowego bełkotu wokół „AI scraperów”, który obiecuje zbyt wiele. Ekstrakcja jednym kliknięciem działa dobrze na obsługiwanych, autoryzowanych stronach — nie jest uniwersalnym sposobem na ominięcie każdej logiki logowania czy każdego systemu anty-bot w internecie. To po prostu bardzo szybki sposób, by zamienić stronę, którą już możesz zobaczyć, w arkusz kalkulacyjny, a to pokrywa zaskakująco dużą część codziennych potrzeb biznesowych.
Czym jest Nimble?
Nimble to zupełnie inne zwierzę — platforma danych webowych stworzona dla inżynierów, a nie dla osoby w Twojej firmie, która nadal nazywa arkusz kalkulacyjny „bazą danych”. Zgodnie z dokumentacją Nimble, rodzina produktów obejmuje Search API, Extract API, Crawl, Map, produkt Web Search Agent i sieć proxy, wszystko połączone jako SDK, które developerzy wpinają do własnych aplikacji.
Samo Extract API daje HTML, Markdown, zrzuty ekranu, nagłówki albo parsowanie strukturalne, renderowanie JavaScript, stealth drivery dla chronionych stron, schematy parsowania oparte o selektory CSS, a nawet sterowane skryptem akcje w przeglądarce, takie jak klikanie, przewijanie i wpisywanie tekstu. Możesz kierować zapytania według kraju, stanu albo miasta, przekazywać własne nagłówki i ciasteczka, przechwytywać ruch sieciowy oraz uruchamiać zadania synchronicznie lub asynchronicznie z callbackami webhook. Crawl i Map rozszerzają to na całe domeny, a Web Search Agents oferują szablonowe ekstraktory dla popularnych stron, wymagające mniej ręcznej konfiguracji.
Poza samymi API Nimble sprzedaje też Managed Data Services — roczne umowy, które obejmują niestandardowe pipeline’y ETL oparte na agentach, okna retencji danych i integrację MCP dla zespołów, które chcą, by Nimble praktycznie prowadziło ich operacje danych webowych za nich. To infrastruktura enterprise, a nie narzędzie do przeglądarki — i tak właśnie jest wyceniana oraz sprzedawana.
Kluczowa różnica: ekstrakcja dla użytkownika biznesowego vs infrastruktura danych webowych
Natychmiastowe zadanie w przeglądarce
Najprościej mówiąc: Thunderbit powstał na moment, gdy masz teraz otwartą stronę i potrzebujesz wyciągnąć z niej dane do tabeli, jeszcze dziś, bez zakładania ticketu do IT. To cała idea rozszerzenia — nie projektujesz pipeline’u, tylko próbujesz wrzucić 200 wierszy z ofertami produktowymi do arkusza, zanim zacznie się spotkanie.
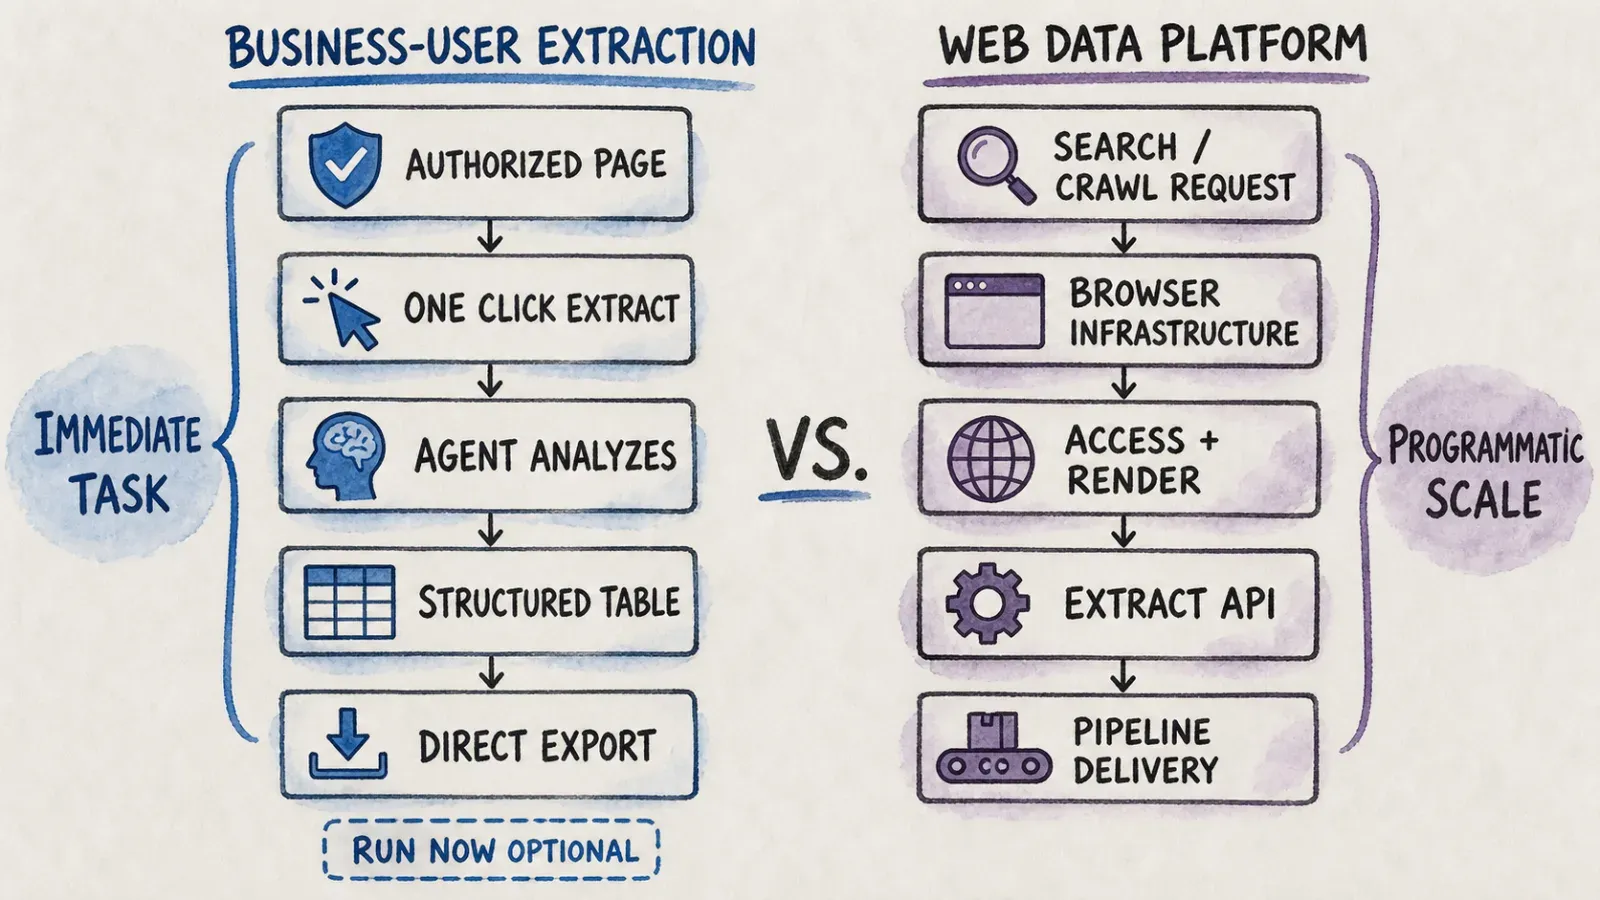
Programowy workflow search/crawl/extract
Nimble zakłada, że nie patrzysz na jedną stronę — budujesz coś, co działa ciągle, w skali, na tysiącach albo milionach URL-i, karmiąc system, a nie arkusz. Wybór poziomu drivera, napisanie schematu parsowania i podpięcie callbacków webhook to zupełnie inny model myślenia niż kliknięcie przycisku w przeglądarce. To praca nad infrastrukturą — i właśnie po to to narzędzie istnieje.
Operacje enterprise i governance
Poziom Managed Data Services w Nimble istnieje dlatego, że niektóre firmy nie chcą same brać na siebie całej pracy infrastrukturalnej — chcą SLA, polityki retencji i dostawcy odpowiedzialnego za dostępność. Thunderbit tak naprawdę nie konkuruje w tym obszarze; jego plany są zbudowane wokół kredytów self-service i zespołów biznesowych, a nie rocznych kontraktów enterprise z gwarancją dedykowanej współbieżności.
Scenariusze z praktyki
Porównania szybko robią się abstrakcyjne, więc osadzę to w sytuacjach, które naprawdę się zdarzają.
Budowa tabeli leadów lub produktów z otwartej strony
Załóżmy, że pracujesz w sales ops i szef prosi Cię o listę wszystkich wystawców z targów, zebranych ze strony wydarzenia, z nazwą firmy, numerem stoiska i adresem URL strony. Otwierasz stronę, klikasz One Click Extract, pozwalasz agentowi samemu rozpoznać kolumny, eksportujesz do Google Sheets i po kilku minutach masz gotowe. To dokładnie teren Thunderbit — zobacz nasze podejście do AI lead generation, jeśli to regularna część Twojej pracy.
Zasilanie pipeline’u RAG albo monitoringu
Teraz wyobraź sobie, że budujesz system retrieval-augmented generation, który codziennie potrzebuje świeżej treści z tysięcy URL-i, z parsowaniem strukturalnym i powiadomieniami webhook po zakończeniu zadań. To właśnie teren API Extract i Crawl w Nimble — zadania asynchroniczne, cloud storage i schemat, który usługa downstream może pobrać bez oglądania surowego wyniku przez człowieka.
Crawlowanie lub wyszukiwanie na dużą skalę
Jeśli zadanie brzmi „znajdź każdą stronę w tej domenie” albo „przeszukaj web i podsumuj, co tam jest”, to jesteś już po etapie ekstrakcji i wchodzisz w discovery — i tutaj działają produkty Search, Map i Answer w Nimble, które łączą pobieranie z podsumowaniami generowanymi przez AI, a nie tylko wyciągają strukturalne pola z jednej znanej strony.
Integracja z agentami AI
Oba produkty komunikują się dziś z agentami AI, ale z zupełnie innej strony. MCP Server w Thunderbit pozwala sesji w Claude lub Cursor bezpośrednio wywoływać narzędzia ekstrakcji Thunderbit, podczas gdy w Nimble integracja MCP jest częścią oferty Managed Data Services. Żadna z tych firm nie ma monopolu na „agent-ready” — różnica polega na tym, że dostęp agenta w Thunderbit siedzi na wierzchu tego samego produktu one-click, z którego korzysta handlowiec, a w Nimble na szerszej warstwie infrastruktury.
Jakość danych, blokady i utrzymanie
Tu chcę mówić wprost, bo dostawcy po obu stronach — łącznie ze mną — mają motywację, by przesadzać z obietnicami niezawodności. Zarządzane renderowanie Thunderbit radzi sobie automatycznie z wieloma stronami mocno opartymi o JavaScript, ale dotyczy to obsługiwanych, autoryzowanych stron — nie jest gwarancją obejścia każdego systemu anty-bot. Model driverów Nimble wprost pokazuje ten kompromis: oferuje trzy poziomy — VX6 dla standardowych statycznych żądań HTTP, VX8 dla renderowania JavaScript i VX10 dla stealth renderingu na chronionych stronach — a cena rośnie wraz z trudnością dostępu do celu.
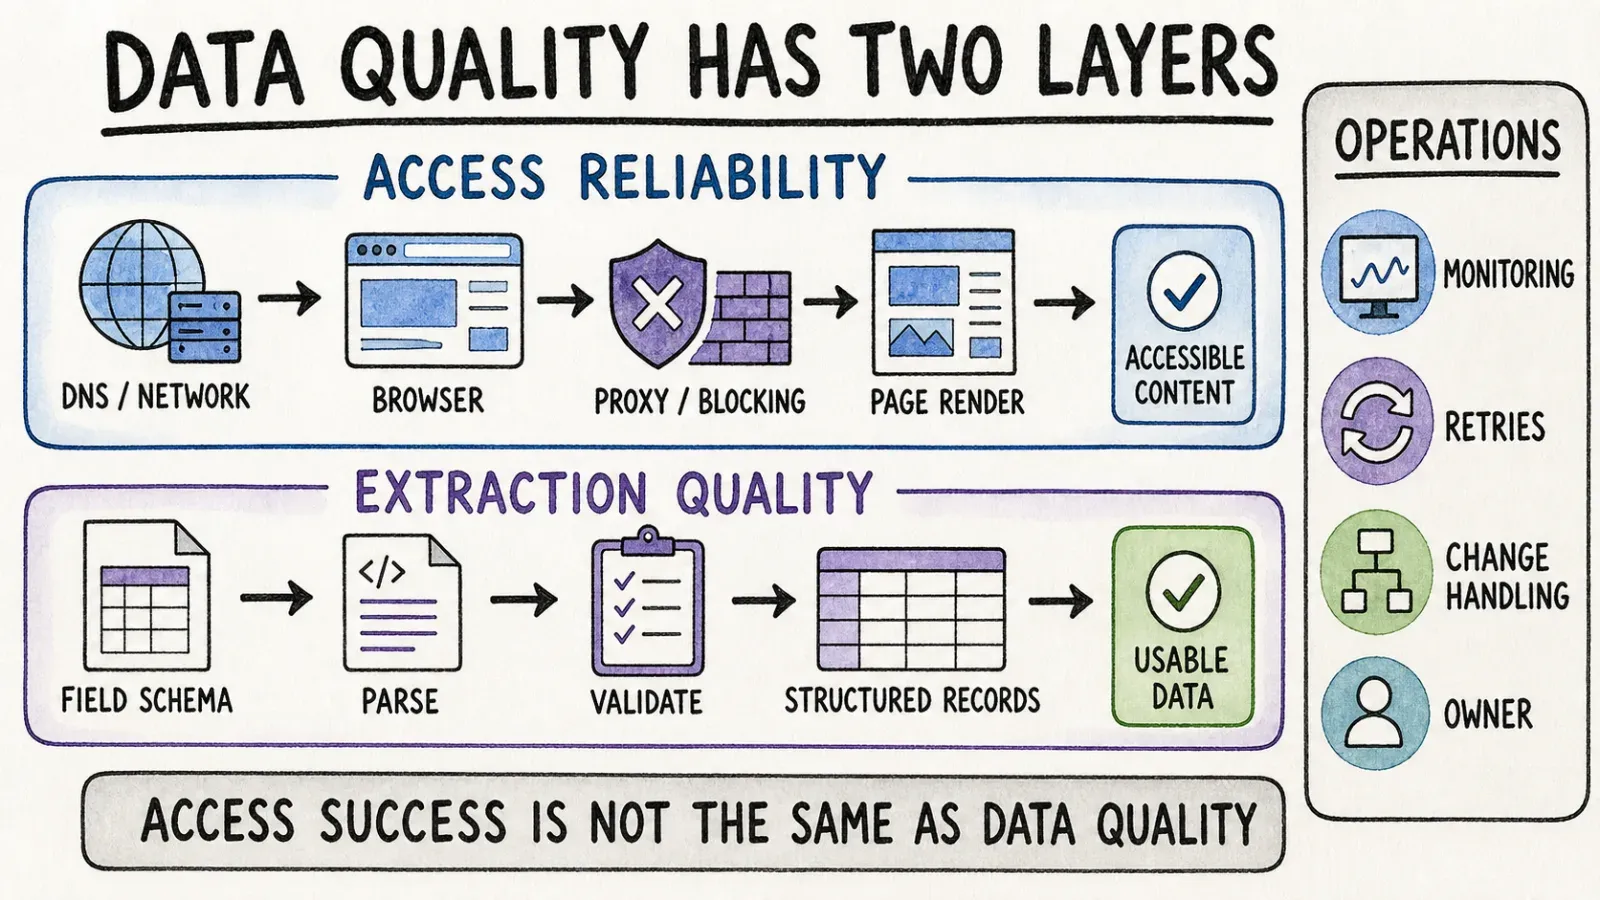
Tak naprawdę doceniam, że Nimble otwarcie pokazuje złożoność warstw w cenie, bo to uczciwe wobec prawdy, z którą mierzy się każdy dostawca scrapingu: im mocniej strona się broni, tym więcej infrastruktury potrzeba, żeby się przez nią przebić — i ktoś za tę infrastrukturę i tak zapłaci.
Żadna z tych firm nie może obiecać zerowego blokowania i zerowego utrzymania na każdej stronie w internecie, a każdy tool, który twierdzi inaczej, budziłby u mnie duży sceptycyzm.
Różnica polega na tym, kto bierze na siebie utrzymanie. W Thunderbit mój zespół odpowiada za logikę ekstrakcji i agenta interpretującego strony — nie piszesz ani nie utrzymujesz selektorów. W Nimble, jeśli korzystasz ze schematów parsowania opartych na selektorach CSS w Extract API, to Ty musisz dbać o synchronizację selektorów, gdy docelowa strona przebuduje układ — chyba że zamiast tego oprzesz się na szablonowych Web Search Agents.
Cena i całkowity koszt
Porównania cen dokładnie tej pary praktycznie nie istnieją w sieci, co mnie zaskoczyło, biorąc pod uwagę, ile materiałów porównuje każde z tych narzędzi z czymś innym. Poniżej zebrałem to, co znalazłem na oficjalnych stronach, z zastrzeżeniem, że cenniki się zmieniają i przed planowaniem budżetu zawsze warto sprawdzić aktualną wersję.
| Element | Thunderbit | Nimble |
|---|---|---|
| Punkt wejścia | Plany self-serve, model kredytowy | Darmowy trial: 5,000 stron bez karty |
| Podstawowa ekstrakcja | Kredyty zależne od planu (zobacz Thunderbit Pricing) | Extract/Crawl/Map na VX6: $0.90 za 1,000 URL-i |
| Renderowanie JS | Wliczone w ekstrakcję agentową | VX8: $1.30 za 1,000 URL-i |
| Stealth/chronione strony | Zarządzane automatycznie tam, gdzie wspierane | VX10: $1.45 za 1,000 URL-i |
| Search/Answer | Nie jest kluczową powierzchnią produktu | Cennik Nimble i dokumentacja SDK są tu niespójne — jedna podaje $5 za 1,000 wejść, druga $1 za 1,000, więc przed budżetem sprawdź bezpośrednio |
| Ekstrakcja oparta na agentach | Wliczona w plan | Od $3 za 1,000 zeskanowanych stron, plus 10% za zarządzane Web Search Agents |
| Proxy residential | Nie dotyczy | $5.30 za GB |
| Poziom enterprise/managed | To nie jest obecne pozycjonowanie | Managed Data Services od $2,500/mies. za 350,000 kredytów stron do $15,000/mies. za 3 mln stron, albo pakiet Enterprise na zamówienie |
Kilka szczerych obserwacji. Po pierwsze, na stronie cenowej Nimble i w dokumentacji SDK są sprzeczne informacje o cenie Search API — jedno źródło mówi o $5 za 1,000 wejść, drugie o $1 za 1,000. To dokładnie ten rodzaj rozbieżności, który chciałbym wyjaśnić przed podpisaniem umowy, więc zwracam na to uwagę zamiast wybierać liczbę, która wygląda lepiej. Po drugie, model kredytowy Thunderbit pojawia się czasem w recenzjach G2 jako niewielki punkt tarcia — niektórzy użytkownicy zauważają, że cena „mogłaby być bardziej przystępna” przy intensywnym użyciu — uczciwa uwaga, o której zespół pamięta wraz z rozwojem produktu. Po trzecie, porównywanie tych dwóch narzędzi wyłącznie po cenie jest trochę jak porównywanie taksówki do leasingu samochodu — całkowity koszt Nimble obejmuje też czas inżynierów na zbudowanie i utrzymanie integracji, a tego nie widać na stronie z cennikiem, choć jest jak najbardziej realne.
Kto powinien wybrać Thunderbit?
Thunderbit będzie dobrym wyborem, jeśli jesteś osobą nietechniczną — sprzedaż, marketing, rekrutacja, ecommerce ops — i potrzebujesz dziś danych strukturalnych ze strony internetowej, bez czekania na dział inżynieryjny. To także sensowny wybór dla małych zespołów, które chcą jednego narzędzia obejmującego zarówno szybkie kliknięcie i ekstrakcję, jak i możliwość podpięcia API albo agenta AI zgodnego z MCP bez zatrudniania dedykowanego inżyniera danych. Jeśli w Twoim zespole kiedykolwiek padło: „po prostu potrzebujemy tej listy w arkuszu”, to jest właśnie ten przypadek użycia. Szersze omówienie tego, gdzie mieści się no-code extraction, znajdziesz w naszym tekście o web scraping bez kodowania.
Kto powinien wybrać Nimble?
Nimble ma sens wtedy, gdy jesteś zespołem inżynierskim albo data teamem budującym coś, co musi działać ciągle i w prawdziwej skali — zadania search, crawl lub extraction liczone w dziesiątkach tysięcy albo milionach stron, zasilające pipeline RAG, system monitoringu albo wewnętrzny hurtownię danych. Jeśli potrzebujesz kontroli na poziomie drivera nad renderowaniem JavaScript i zachowaniem stealth, zapytań geotargetowanych, przechwytywania ruchu sieciowego albo enterprise SLA z dedykowanym storage i współbieżnością, to jest infrastruktura, którą Thunderbit w ogóle nie stara się być.
Czy mogą się uzupełniać?
Przyznam, że podczas researchu też o tym myślałem — czy zespół mógłby rozsądnie używać obu? Teoretycznie tak, jako dwóch warstw architektury: Nimble do dużej skali discovery i retrieval, Thunderbit do ostatniego etapu, czyli zamieniania konkretnej strony w czystą tabelę dla osoby nietechnicznej. Chcę jednak uważać, żeby nie sugerować istnienia oficjalnego partnerstwa czy integracji między tymi firmami, bo o żadnym takim nie wiem. Po prostu produkty zajmują różne warstwy hipotetycznego stacku — tak jak sieć proxy i narzędzie arkuszowe zajmują różne poziomy bez potrzeby bezpośredniej komunikacji.
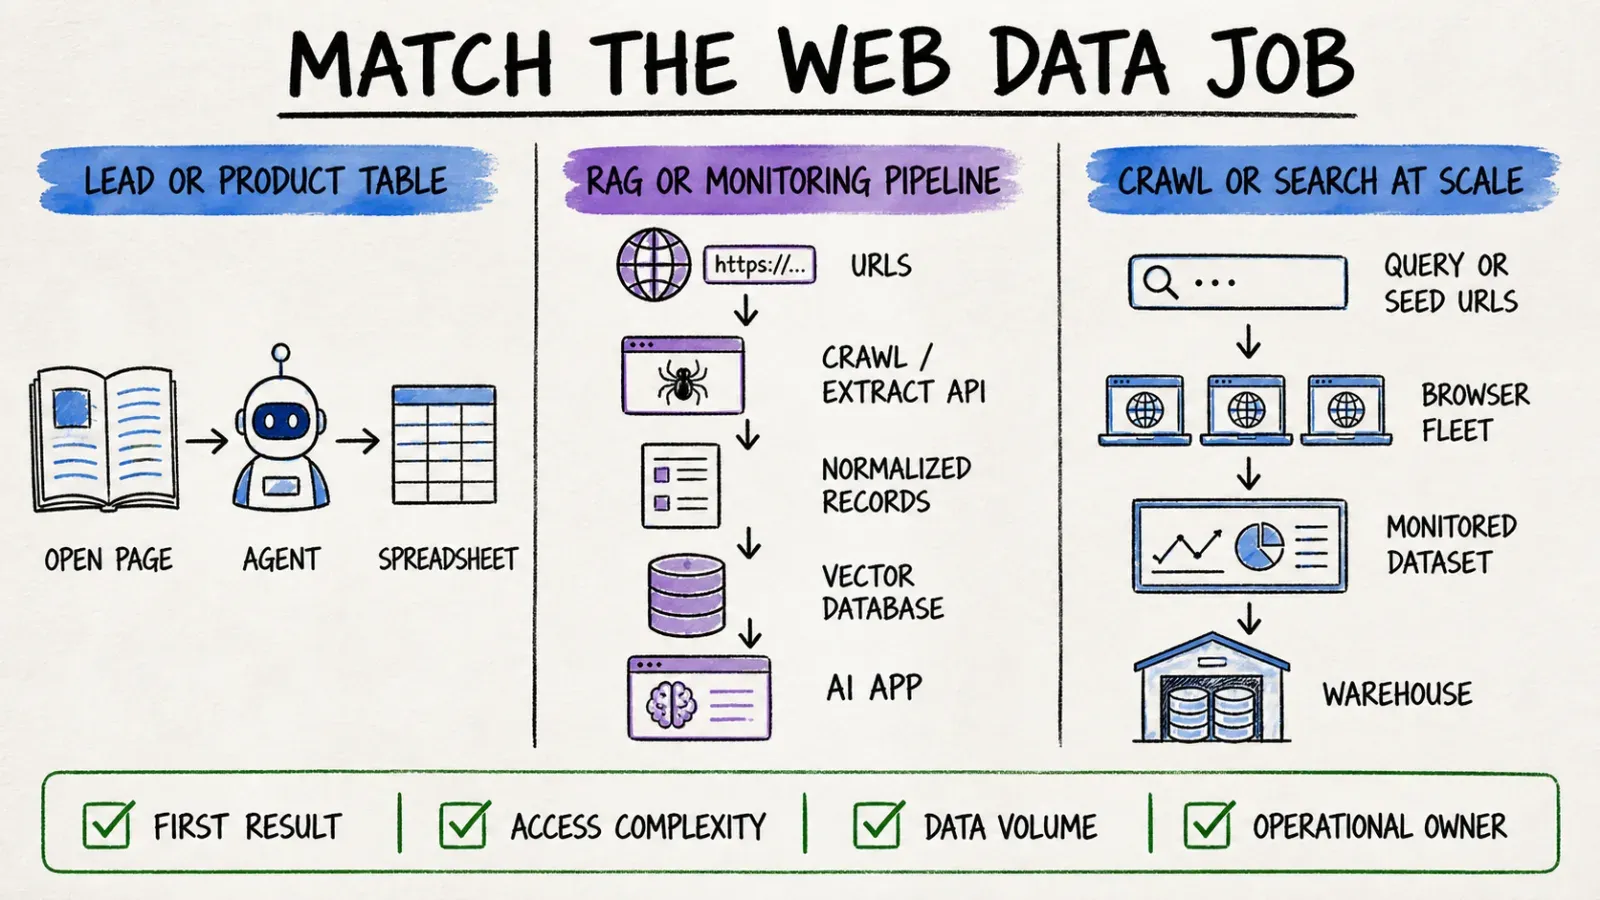
Werdykt
Gdybym miał to zamknąć w jednej radzie: wybieraj według tego, kto obsługuje workflow, a nie według tego, która firma ma bardziej efektowny marketing AI. Pięcioosobowy zespół sprzedażowy, który chce zbudować listę prospectów, nie potrzebuje poziomów driverów i callbacków webhook — potrzebuje kliknąć przycisk i dostać arkusz, a właśnie dlatego od lat buduję Thunderbit w taki sposób, w jaki go budujemy. Zespół data engineering, który tworzy produkcyjną infrastrukturę RAG dla miliona stron, nie chce rozszerzenia do przeglądarki — chce API z warstwową kontrolą dostępu i wsparciem enterprise, a to jest cały sens istnienia Nimble.
Drugim rozstrzygającym czynnikiem jest wolumen. Przy skali do kilku tysięcy stron miesięcznie ekstrakcja jednym kliknięciem oszczędza więcej czasu, niż kosztuje. Powyżej tego progu ekonomia zaczyna premiować infrastrukturę, którą można automatyzować i monitorować programowo — i tu narzędzia takie jak nasz Open API albo platforma w stylu Extract API od Nimble zaczynają naprawdę zarabiać na siebie. A jeśli chodzi o utrzymanie: jeśli nikt w Twoim zespole nie chce odpowiadać za logikę selektorów albo konfigurację driverów, to jest mocny sygnał, że potrzebujesz produktu, który to abstrakcjonuje, a nie takiego, który oddaje Ci pełną kontrolę.
FAQ
Czy Nimble to rozszerzenie do przeglądarki? Nie. Nimble działa przez API i SDK — produkty Search, Extract, Crawl, Map i Agent są dostępne przez integracje developerskie, a nie przez narzędzie typu point-and-click w przeglądarce. Thunderbit natomiast oferuje rozszerzenie przeglądarki jako główny punkt wejścia.
Czy Thunderbit ma dostęp do API i MCP? Tak. Thunderbit oferuje Open API do programowej ekstrakcji, MCP Server dla agentów AI takich jak Claude, Cursor i Windsurf oraz CLI do pracy w terminalu i z agentami kodującymi, obok bezkodowego rozszerzenia do przeglądarki.
Które narzędzie lepiej radzi sobie z dużymi crawlami? Nimble zostało stworzone właśnie do dużych crawlów i wyszukiwania przez Crawl, Map i Search API, z poziomami driverów i obsługą zadań asynchronicznych zaprojektowaną pod wolumen. Thunderbit jest zoptymalizowany pod ekstrakcję na poziomie strony i wielu stron z wzbogacaniem podstronami, a nie pod crawl całych domen.
Które jest łatwiejsze dla użytkowników biznesowych? Thunderbit, i to zdecydowanie. Workflow z jednym kliknięciem nie wymaga selektorów, schematów ani kodu — otwierasz stronę, klikasz i dostajesz uporządkowany wynik. Nimble zakłada, że request konfiguruje developer, co dla użytkownika nietechnicznego jest wyraźnie wyższym progiem wejścia.
Czym różnią się obecne modele cenowe? Thunderbit korzysta z planów self-serve opartych na kredytach (zobacz Thunderbit Pricing). Nimble stosuje model pay-as-you-go zależny od zużycia i złożoności drivera, a także roczne umowy Managed Data Services zaczynające się mniej więcej od $2,500 miesięcznie dla potrzeb enterprise. Zawsze sprawdzaj aktualne cenniki obu firm, bo dokumentacja Nimble pokazuje niespójności między stroną cenową a dokumentacją SDK.




