
Kilka tygodni temu ktoś na Slacku naszego zespołu wrzucił link z pytaniem: „chwila, to jest ten sam Ferret?” Nie był. Okazało się, że istnieje model wizyjny Apple o nazwie Ferret, narzędzie danych NOAA o nazwie Ferret, a do tego MontFerret — open-source’owy framework do automatyzacji przeglądarki, którego programiści używają do pisania skryptów do scrapowania w czymś, co nazywa się FQL. Nic z tego nie jest ze sobą powiązane, a jeśli właśnie szukasz porównania „Thunderbit vs MontFerret”, to pewnie też trafiłeś(-aś) na ten sam mur nieporozumień.
Wyjaśnijmy więc od razu: prowadzę Thunderbit i mówię tutaj konkretnie o naszym produkcie kontra MontFerret — czyli o projekcie do deklaratywnego web scrapingu z montferret.dev. Nie o rozwiązaniu Apple. Nie o narzędziu NOAA. I szczerze mówiąc, gdy przebijesz się przez ten chaos nazw, zestawienie robi się naprawdę ciekawe, bo Thunderbit i MontFerret tak naprawdę nie walczą o tego samego klienta. Rozwiązują różne problemy dla różnych osób — i właśnie o to tu chodzi.
Krótka odpowiedź
Jeśli chcesz wersję skróconą, zanim wejdziemy w szczegóły: Thunderbit to zarządzany, agentowy web scraper stworzony po to, by szybko zamieniać dowolną stronę w uporządkowane dane — przez rozszerzenie do przeglądarki, Web App, Open API, MCP Server i CLI. MontFerret to open-source’owy framework do automatyzacji przeglądarki, w którym piszesz zapytania w FQL (Ferret Query Language), aby pobierać dane i wchodzić w interakcję ze stronami.
Jeszcze jedna uwaga porządkująca, bo widziałem już, jak ludzie tracą na tym 20 minut: chodzi wyłącznie o projekt MontFerret. Nie o model wizyjny Ferret od Apple, nie o narzędzie NOAA do wizualizacji danych Ferret i nie o żaden inny „Ferret”, na jaki możesz trafić w Google. Tylko montferret.dev.
W skrócie
| Thunderbit | MontFerret | |
|---|---|---|
| Główny użytkownik | Biznesowi użytkownicy nietechniczni (sprzedaż, operacje, GTM), a także programiści | Programiści/inżynierowie |
| Konfiguracja | Zainstaluj rozszerzenie albo otwórz Web App | Zainstaluj runtime Go/Ferret, skonfiguruj port debugowania Chrome |
| Interfejs | Klikasz One Click Extract, resztą zajmuje się agent | Piszesz zapytania FQL do DOM/CDP |
| Język zapytań | Brak — doprecyzowanie pól naturalnym językiem | FQL (inspirowany ArangoDB AQL) |
| Automatyzacja przeglądarki | Zarządzana na zgodnych, autoryzowanych stronach | Samodzielnie zarządzana przez Chrome DevTools Protocol |
| Logika ekstrakcji | Agentowa analiza strony | Jawnie zdefiniowane selektory, pętle i filtry, które piszesz samodzielnie |
| Wdrożenie | Rozszerzenie do przeglądarki / Web App / chmura | Własny hosting, pełna kontrola nad infrastrukturą |
| Planowanie uruchomień | Dostępne w kwalifikujących się planach | Budujesz i utrzymujesz samodzielnie |
| Utrzymanie | Po stronie produktu | Po stronie Twojego zespołu |
| Licencja | Płatne SaaS (w oparciu o kredyty/plan) | Open-source, darmowy w użyciu |
| Całkowity koszt | Abonament | „Darmowe” oprogramowanie, ale dochodzi infrastruktura i czas inżynierów |
Czym jest Thunderbit?
Wielu osobom, które nigdy w życiu nie scrapowały strony, tłumaczyłem Thunderbit w podobny sposób: otwierasz stronę, do której masz dostęp, klikasz jeden przycisk, a Thunderbit sam rozpoznaje, jakie dane na tej stronie są istotne.
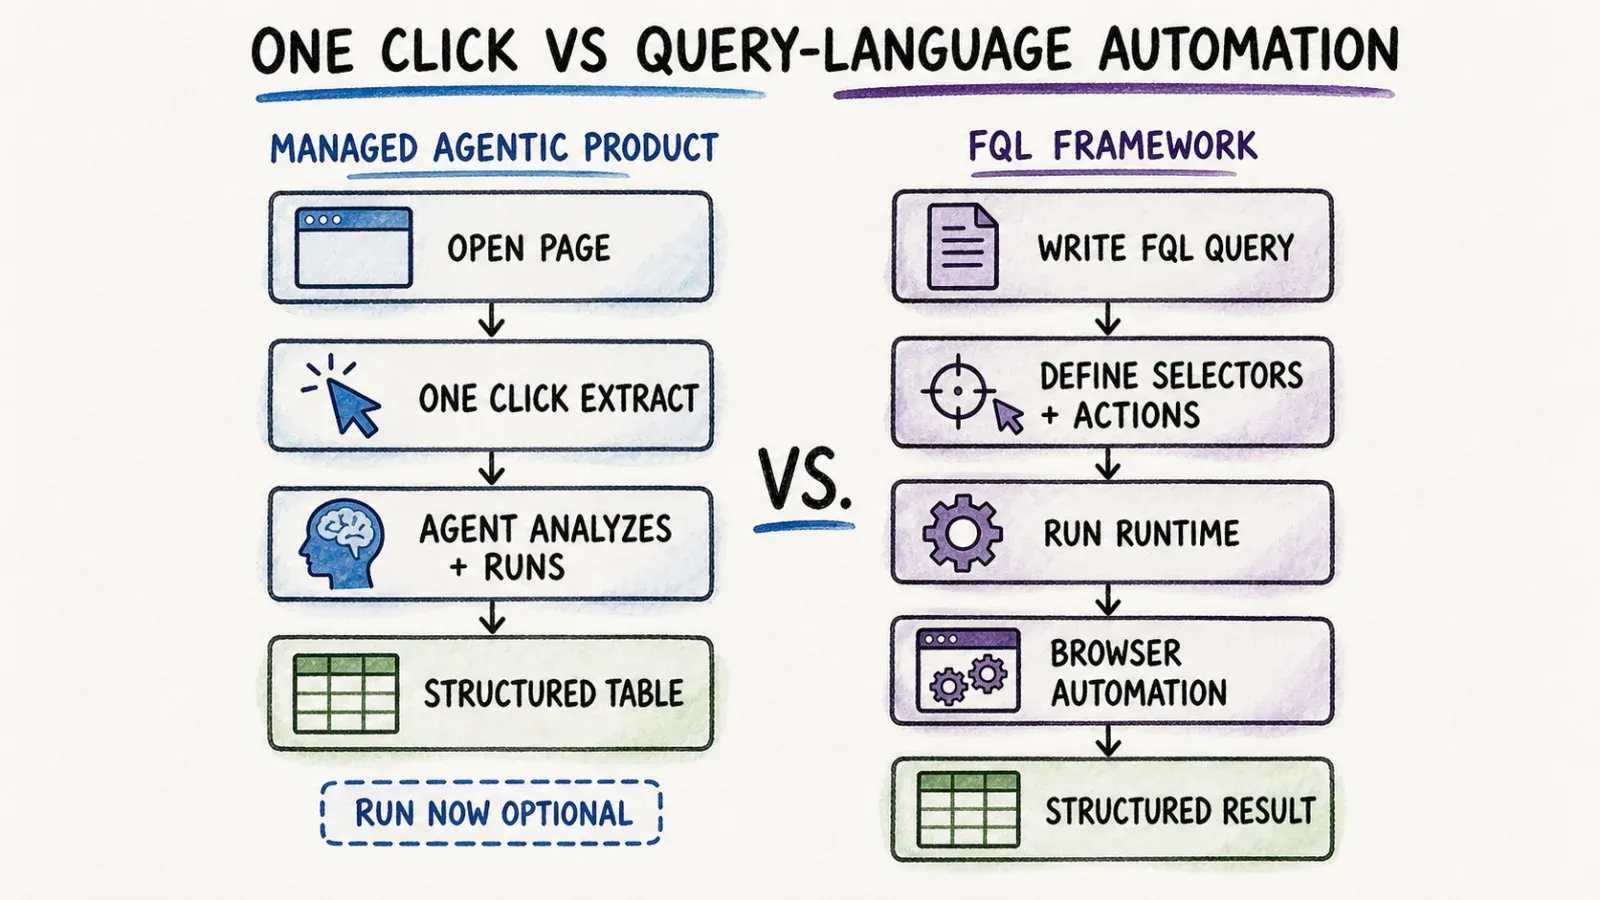
Rzeczywisty przebieg wygląda tak: klikasz One Click Extract. Nasz agent wykrywa stronę, odczytuje ją, analizuje strukturę i przygotowuje pola, które uznaje za przydatne — na przykład nazwy produktów, ceny, dane kontaktowe albo cokolwiek innego, co ta strona faktycznie oferuje. Potem pokazuje przycisk Run Now. Możesz go kliknąć, żeby uruchomić proces od razu, albo… nic nie robić, a uruchomi się automatycznie. To wszystko. Jeden świadomy klik, bez budowania schematu, bez pisania selektorów, bez kodu.

To jest przepływ pracy Thunderbit Chrome Extension, z którym większość osób styka się jako pierwszym. Ale to nie jedyna opcja. Jeśli chcesz dopracować ekstrakcję — na przykład dopisać konkretne pole, którego agent nie wyłapał, albo zmienić format danych — możesz to zrobić prostą instrukcją. Thunderbit automatycznie obsługuje także zgodną paginację i wzbogacanie danych z podstron na wspieranych stronach oraz pozwala eksportować wyniki do Excela, Google Sheets, Airtable albo Notion.
Dla programistów pod maską jest jeszcze więcej: Thunderbit Web App do ekstrakcji w chmurze, Open API do dostępu programatycznego, MCP Server do podłączenia się do agentów AI, takich jak Claude czy Cursor, oraz CLI do pracy w terminalu lub z agentami kodującymi. Czyli rozszerzenie jest wejściem bez kodu, ale Thunderbit nie jest tylko „przeglądarkową zabawką” — to pełna platforma do ekstrakcji z wieloma drogami wejścia.
Jedna uczciwa uwaga: „jeden klik” dotyczy zgodnych stron, do których masz uprawniony dostęp. To nie jest gwarancja obejścia każdego antybota, każdego logowania czy każdego nietypowego przypadku, jaki strona może rzucić na stół.
Czym jest MontFerret?
MontFerret to zupełnie inna historia i naprawdę szanuję to, co zbudowali. To open-source’owy system do deklaratywnego scrapowania stron, w którym zamiast klikać przyciski, piszesz zapytania w FQL — Ferret Query Language — który projekt opisuje jako inspirowany AQL od ArangoDB.
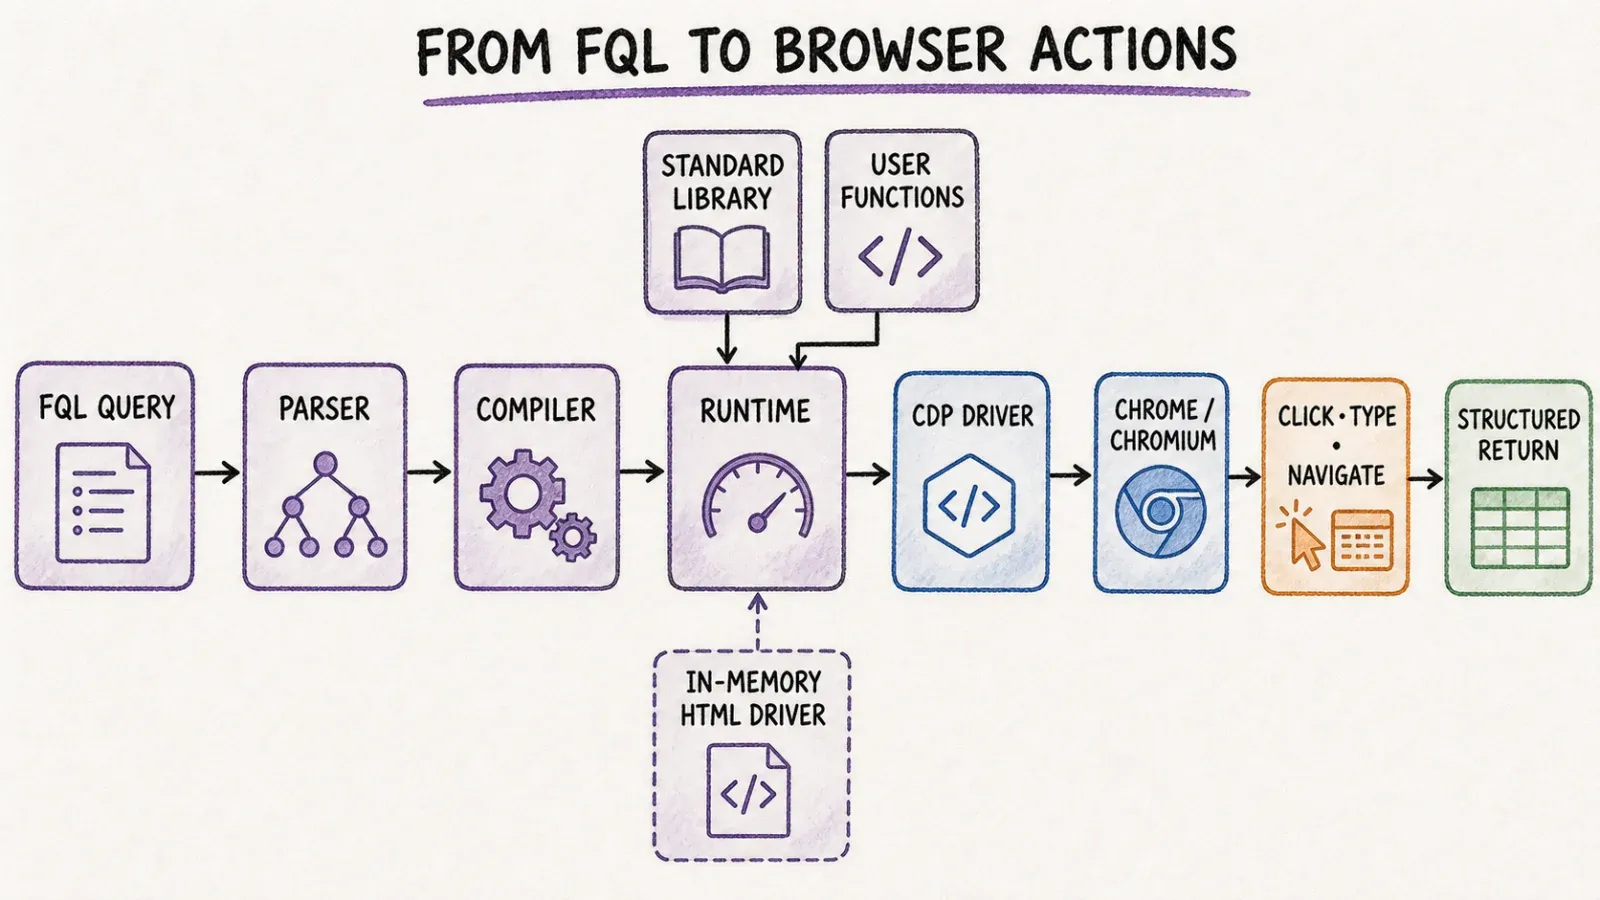
Zgodnie z ich oficjalną dokumentacją system składa się z kilku kluczowych elementów: parsera FQL, kompilatora, runtime’u, biblioteki standardowej, rejestru funkcji użytkownika, wbudowanych driverów HTML działających w pamięci, drivera Chrome DevTools Protocol (CDP) oraz interfejsu wiersza poleceń. Jeśli brzmi to jak sporo ruchomych części, to tak właśnie jest — ale o to tu chodzi. MontFerret jest zbudowany dla programistów, którzy chcą bardzo precyzyjnej, kodowej kontroli nad tym, jak strona jest scrapowana.
W przypadku treści renderowanych przez JavaScript albo faktycznej interakcji z przeglądarką potrzebujesz uruchomionego Chrome lub Chromium z otwartym portem debugowania, żeby MontFerret mógł komunikować się z nim przez CDP. Gdy to skonfigurujesz, Twoje zapytanie FQL może opisywać pętle, filtry, selektory w stylu CSS, nawigację między stronami, kliknięcia, wpisywanie tekstu i zwracanie ustrukturyzowanych wyników — czyli w praktyce język zapytań opakowujący logikę automatyzacji przeglądarki.
Kompromis jest realny: MontFerret odciąża Cię od dużej części niskopoziomowej logiki przeglądarki i sieci, ale nadal musisz nauczyć się FQL, pisać i testować zapytania oraz samodzielnie utrzymywać runtime. Nie ma tu momentu „kliknij i samo rozpozna pola”. Za każdym razem mówisz dokładnie, co ma zrobić.
Główna różnica: zarządzany produkt agentowy vs framework z językiem zapytań
Czas do pierwszego ustrukturyzowanego wyniku
Tutaj różnica widać najlepiej. W Thunderbit czas do pierwszego wyniku liczony jest w sekundach: kliknij One Click Extract, pozwól agentowi przeanalizować stronę, a zadanie uruchomi się samo; Run Now jest opcjonalny. W MontFerret najpierw piszesz zapytanie. Nawet prosty skrypt FQL wymaga zrozumienia selektorów, składni zapytań i tego, jak driver CDP zachowuje się na docelowej stronie. To nie jest zarzut wobec MontFerret — to po prostu zupełnie inny punkt startu. Jedno podejście mówi: „niech agent to ogarnie”, drugie: „powiedz mu dokładnie, co ma zrobić”.
Automatyzacja przeglądarki i kontrola
Ale jeśli odwrócić perspektywę, MontFerret wygrywa precyzją. Jeśli potrzebujesz scrapera, który robi coś bardzo konkretnego — wieloetapowe wypełnianie formularzy, logikę warunkową zależną od stanu strony, własne reguły ponawiania — FQL daje Ci taki poziom kontroli, bo logikę piszesz samodzielnie. Podejście agentowe Thunderbit świetnie sprawdza się przy zadaniu „wyciągnij to, co na tej stronie jest użyteczne”, ale nie jest to uniwersalny język skryptowy do przeglądarki. Jeśli Twój przypadek użycia wymaga niestandardowej logiki rozgałęzień w wielostronicowym procesie, to jest właśnie obszar MontFerret.
Wdrożenie i odpowiedzialność za utrzymanie
To jest ten fragment, który ludzie często bagatelizują. W Thunderbit, kiedy strona zmienia układ, ekstrakcja agentowa potrafi się dostosować, bo za każdym razem analizuje stronę od nowa, zamiast opierać się na sztywno wpisanych selektorach — choć znowu, nie oznacza to, że zadziała na każdej przebudowie. W MontFerret, jeśli zmieni się struktura DOM strony, selektory w zapytaniu FQL mogą przestać działać i ktoś z Twojego zespołu musi to zauważyć, zdebugować i naprawić. To stała odpowiedzialność inżynierska, która przy ręcznie pisanym scraperze nigdy całkiem nie znika — niezależnie od tego, czy to open-source, czy nie.
Praktyczne scenariusze
Jednorazowa ekstrakcja dla biznesu
Załóżmy, że osoba z działu sales ops potrzebuje do końca dnia listy firm z katalogu, a żaden inżynier nie jest dostępny. Thunderbit jest dokładnie do tego: otwórz stronę, kliknij One Click Extract, wyeksportuj do Google Sheets i wróć do pracy. Nikt nie pisze FQL do jednorazowego zadania.
Powtarzalna automatyzacja przeglądarki tworzona przez programistów
Teraz załóżmy, że zespół inżynierów buduje pipeline monitorujący, który każdej nocy sprawdza stronę cennika konkurencji, parsuje konkretne zagnieżdżone dane i przekazuje je do wewnętrznego systemu z własną logiką transformacji. W takim przypadku deklaratywne podejście MontFerret może błyszczeć — piszesz FQL raz, dokładnie wiesz, co robi, i sam odpowiadasz za cały pipeline.
Dynamiczny, wieloetapowy workflow na stronie
W przypadku stron wymagających logowania, przechodzenia przez wiele podstron i działań warunkowych zależnych od tego, co widać na ekranie, driver CDP MontFerret i jawna logika zapytań dają Ci kontrolę potrzebną do precyzyjnego zautomatyzowania procesu. Thunderbit obsługuje zgodną paginację i wzbogacanie danych z podstron na wspieranych, autoryzowanych stronach, ale nie jest projektowany jako uniwersalne narzędzie skryptowe do dowolnych wieloetapowych workflow w przeglądarce.
Integracja z API lub agentem AI
Jeśli budujesz agenta AI, który w ramach większego procesu potrzebuje pobierać ustrukturyzowane dane z internetu, MCP Server w Thunderbit podłącza się bezpośrednio do narzędzi takich jak Claude Code czy Cursor. MontFerret też można wpiąć w customowy stack, ale warstwę integracyjną budujesz samodzielnie, zamiast korzystać z gotowego konektora.
Niezawodność, elastyczność i utrzymanie
Powiem wprost, bo to właśnie w tej sekcji wiele porównań idzie na skróty. Agentowe rozumienie strony w Thunderbit jest naprawdę użyteczne, ponieważ zmniejsza koszt utrzymania selektorów wpisanych na sztywno — agent odczytuje strukturę strony od nowa, zamiast polegać na kruchej ścieżce CSS, która pęka przy każdej zmianie markup’u. Ale „agentowe” nie znaczy „magiczne”. Działa na zgodnych, autoryzowanych stronach i są witryny oraz sytuacje, w których może nie wyciągnąć dokładnie tego, czego oczekujesz.
Jawna logika zapytań i automatyzacji w MontFerret jest w jednym sensie bardziej przewidywalna — wiesz dokładnie, co robi zapytanie, bo to Ty je napisałeś(-aś) — ale ta przewidywalność ma cenę w postaci kruchości, gdy zmienia się strona źródłowa. Jeśli witryna zamieni div na section, selektor może po cichu przestać działać i nie dowiesz się o tym, dopóki dane nie wrócą puste albo błędne.
Żadne z tych narzędzi nie obiecuje uniwersalnego przełamania zabezpieczeń antybotowych i podchodziłbym sceptycznie do każdego, które to deklaruje. Oba wymagają działania w granicach tego, do czego masz uprawniony dostęp.
Cena, licencja i całkowity koszt
To właśnie tu określenie „darmowe” przy open-source bywa mylące i warto powiedzieć to wprost.
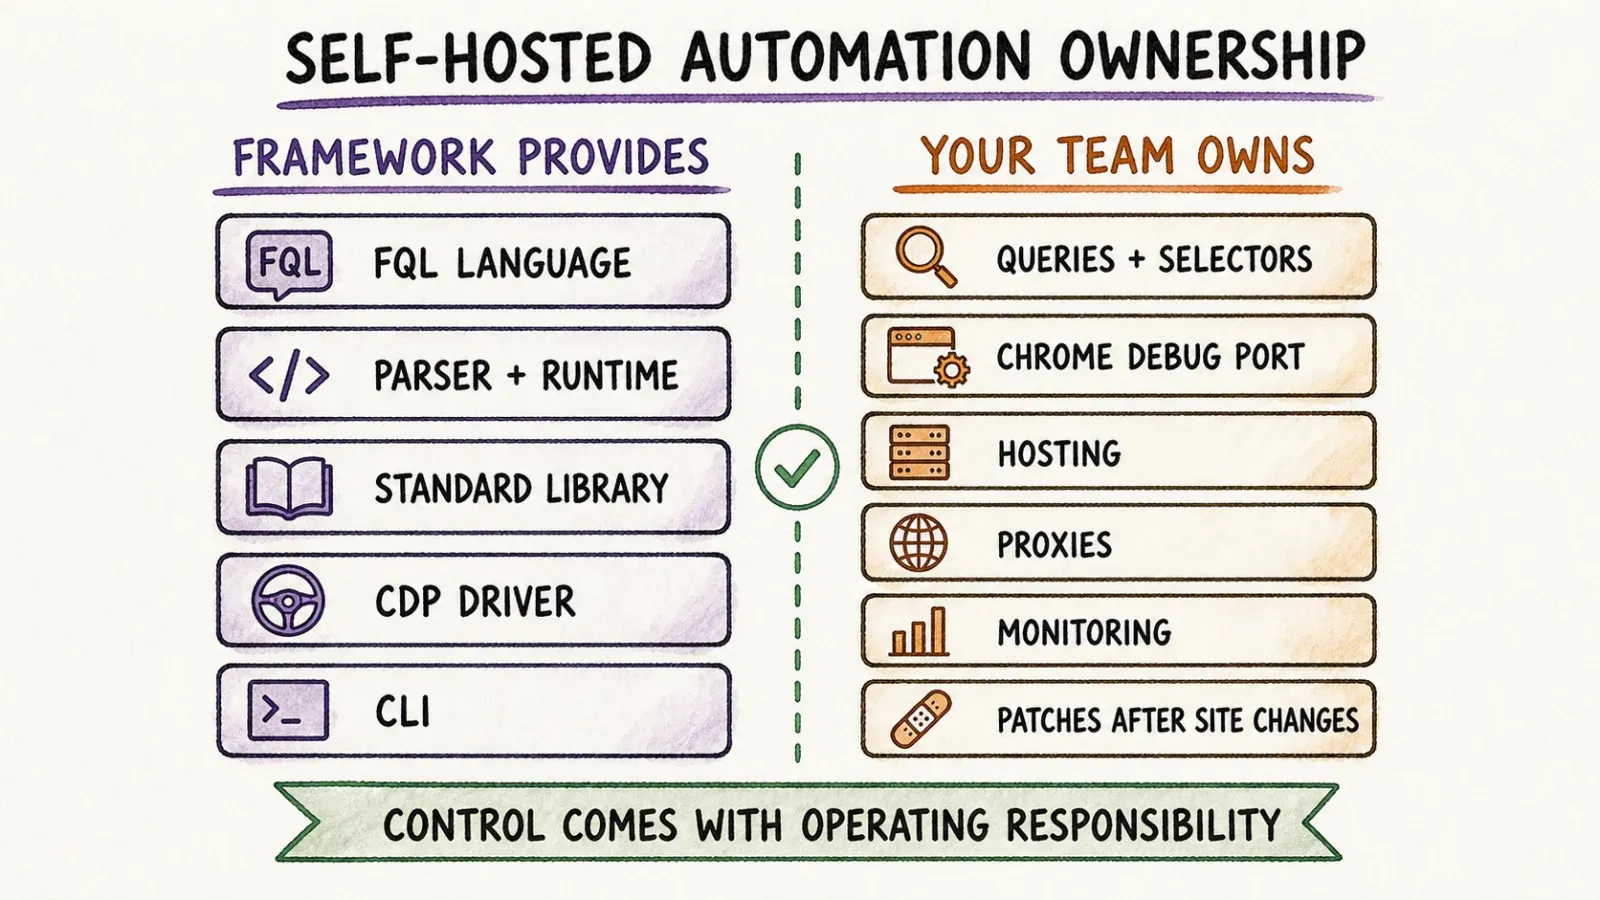
MontFerret jest open-source — przed wdrożeniem sprawdź aktualną licencję w repozytorium, bo takie rzeczy technicznie mogą się zmieniać — ale ogólnie rzecz biorąc nie ma opłaty abonamentowej za korzystanie z podstawowego frameworka. Tyle że „darmowe” dotyczy wyłącznie licencji na oprogramowanie. Nadal musisz zapewnić i utrzymywać własną moc obliczeniową, uruchamiać i pilnować instancji Chrome/Chromium, zarządzać proxy, jeśli scrapujesz na poważniejszą skalę, monitorować awarie i płacić inżynierom za pisanie oraz utrzymywanie skryptów FQL.
Thunderbit działa w modelu płatnym — aktualne kwoty sprawdź na stronie Thunderbit Pricing, bo te dane zmieniają się w czasie — ale ten koszt obejmuje zarządzane uruchamianie w przeglądarce/chmurze, logikę ekstrakcji agentowej, eksport oraz dostęp przez API/MCP/CLI. Nie ma osobnego rachunku za infrastrukturę, o który trzeba się martwić.
| Czynnik kosztowy | Thunderbit | MontFerret |
|---|---|---|
| Koszt licencji | Płatne SaaS (w oparciu o kredyty/plan) | Darmowy, open-source |
| Koszt infrastruktury | Wliczony w plan | Sam zapewniasz i hostujesz serwery, Chrome, proxy |
| Czas inżynierski | Minimalny — bez kodowania | Stały — pisanie, testowanie i debugowanie FQL |
| Ciężar utrzymania | Po stronie produktu | Po stronie Twojego zespołu |
Prawdziwe pytanie nie brzmi: „co jest tańsze?”, tylko: „gdzie chcesz, żeby ten koszt się pojawił”. W Thunderbit zobaczysz go na miesięcznej fakturze. W MontFerret zobaczysz go w kalendarzu zespołu inżynierskiego.
Kto powinien wybrać Thunderbit?
Jeśli jesteś osobą nietechniczną i potrzebujesz danych od razu, a nie masz pod ręką zasobów inżynierskich, Thunderbit jest oczywistym wyborem. To samo dotyczy każdej osoby robiącej jednorazowe albo cykliczne pobieranie danych biznesowych, gdzie „zero konfiguracji” jest ważniejsze niż drobiazgowa kontrola. A jeśli już budujesz workflow z agentami AI i chcesz, żeby scrapowanie wpinało się przez MCP albo CLI bez pisania własnej warstwy integracyjnej, to Thunderbit również jest dokładnie w tym obszarze.
Kto powinien wybrać MontFerret?
Jeśli jesteś programistą budującym powtarzalny pipeline scrapingowy, który ma działać w CI/CD, albo potrzebujesz własnej infrastruktury ze względów związanych z rezydencją danych czy zgodnością, deklaratywne podejście MontFerret i pełna kontrola nad infrastrukturą mają sens. To także lepszy wybór, jeśli Twój zespół ma zaplecze inżynierskie do długoterminowego utrzymywania skryptów FQL i naprawdę chce mieć taki poziom kontroli nad logiką automatyzacji przeglądarki.
Czy zespoły mogą używać obu narzędzi?
Tak — i szczerze mówiąc, nie uważam tego za wymijającą odpowiedź. Widziałem konfiguracje, w których zespół techniczny uruchamia wyspecjalizowane, powtarzalne zadania FQL dla kluczowych pipeline’ów danych, gdzie potrzebna jest dokładna logika kontrolowana wersjami, a jednocześnie użytkownicy biznesowi w tym samym zespole korzystają z Thunderbit do doraźnych badań, szybkich eksportów albo eksploracyjnego pobierania danych, które nie uzasadnia pisania własnego skryptu. To nie są tak naprawdę narzędzia konkurencyjne — działają na różnych warstwach tego samego szerszego procesu danych. Nie będę udawał, że istnieje między nimi oficjalna integracja, bo jej nie ma, ale architektonicznie taki podział jest całkowicie sensowny.
Werdykt
Jeśli miałbym zamknąć to w jednym zdaniu: wybierz narzędzie na podstawie tego, kto ma wykonywać pracę i ile ma na to czasu. Jeśli masz osobę nietechniczną, która potrzebuje tabeli z danymi w ciągu najbliższych dziesięciu minut, Thunderbit wygrywa za każdym razem — tu nie ma porównania. Jeśli masz inżyniera, który chce deklaratywny, samodzielnie hostowany, wersjonowalny pipeline do scrapowania i nie przeszkadza mu długoterminowe utrzymanie, MontFerret jest naprawdę solidną opcją open-source.
To nie jest sytuacja typu „jedno narzędzie pokonuje drugie” i robiłbym Ci niedźwiedzią przysługę, gdybym twierdził inaczej. To jest sytuacja „jaki problem naprawdę rozwiązujesz”.
FAQ
O jakim projekcie Ferret mowa? Chodzi o MontFerret — open-source’owy, deklaratywny framework do web scrapingu dostępny na montferret.dev. Nie ma on związku z modelem wizyjnym Ferret od Apple, narzędziem do wizualizacji danych Ferret od NOAA ani żadnym innym projektem używającym nazwy „Ferret”.
Czy MontFerret jest open source? Tak, MontFerret to projekt open source. Za podstawowy framework nie ma opłaty licencyjnej, ale przed użyciem komercyjnym warto sprawdzić aktualne warunki licencji w repozytorium, ponieważ mimo darmowego oprogramowania nadal ponosisz koszty infrastruktury i pracy inżynierskiej.
Czy Thunderbit obsługuje integracje z API i MCP? Tak. Thunderbit oferuje Open API do dostępu programatycznego oraz MCP Server, który łączy narzędzia ekstrakcyjne Thunderbit z hostami agentów AI, takimi jak Claude Code i Cursor, a także CLI do workflow opartych na terminalu.
Które narzędzie jest łatwiejsze dla osób nietechnicznych? Thunderbit, bez dwóch zdań. Rozszerzenie do przeglądarki zostało stworzone po to, aby osoby nietechniczne mogły wyciągać ustrukturyzowane dane jednym kliknięciem One Click Extract — bez języka zapytań, bez selektorów, bez kodu. MontFerret wymaga nauki FQL i konfiguracji runtime’u, co zakłada przynajmniej podstawowe umiejętności programistyczne.
Które narzędzie daje bardziej precyzyjną kontrolę nad automatyzacją przeglądarki? MontFerret. Ponieważ piszesz zapytania FQL bezpośrednio do DOM przez Chrome DevTools Protocol, masz bardzo precyzyjną, kodową kontrolę nad nawigacją, interakcjami i logiką warunkową. Podejście agentowe Thunderbit optymalizuje szybkie wydobywanie ustrukturyzowanych danych na zgodnych stronach, zamiast oferować szczegółową, skryptową automatyzację.




