
Od kilku tygodni co jakiś czas wracam do strony Kadoa, głównie dlatego, że ich rebranding z czerwca 2026 totalnie mnie zaskoczył. Jeszcze jednego dnia byli „AI web scraperem”, a następnego zaczęli przedstawiać się jako „Web Scraping OS”. To duży skok — i sporo mówi o tym, dokąd zmierza cała ta kategoria.
I właśnie to pytanie ciągle wracało do mnie od czytelników i od mojego zespołu: czy Kadoa nadal da się porównać z Thunderbit, czy może już całkiem wyszli z ligi „szybkich narzędzi do scrapowania”? Krótka odpowiedź: trochę jedno, trochę drugie. Dłuższa — poniżej.
Krótka odpowiedź
Jeśli chcesz wersję tl;dr, zanim wejdę w szczegóły:
- Thunderbit jest stworzone na moment, gdy patrzysz na stronę i myślisz: „Potrzebuję tych danych teraz, do arkusza”. Jeden klik, bez schematu, bez czekania na dział danych.
- Kadoa jest stworzone dla organizacji, które potrzebują zarządzanych, monitorowanych i stale utrzymywanych zbiorów danych działających produkcyjnie — pomyśl o zespołach finansowych pobierających alternatywne dane z dziesiątek źródeł każdego dnia, z pełnym audytem.
- Żadne z nich nie jest „AI scraperem” kontra „manualnym scraperem”. Oba są naprawdę agentowe — różnica polega na tym, do czego dokładnie optymalizują agenta.
Ten ostatni punkt jest ważniejszy, niż wielu osobom się wydaje. Widziałem już mnóstwo artykułów porównawczych, które traktują to jak konkurs checklist funkcji, a tak naprawdę to dwa produkty, które rozjechały się w różne segmenty odbiorców.
W skrócie
| Obszar | Thunderbit | Kadoa |
|---|---|---|
| Główny użytkownik | Użytkownicy biznesowi, marketerzy, solo operatorzy, deweloperzy | Zespoły danych w enterprise/finansach, centralne organizacje danych |
| Horyzont czasu | Natychmiast — wyciągnij dane z widocznej strony | Cykl produkcyjny — budowa, zatwierdzanie i utrzymanie pipeline’u |
| Proces konfiguracji | Klik One Click Extract → automatyczny start | Prompt → propozycja schematu → budowa/test pipeline’u → akceptacja → zaplanowany workflow na żywo |
| Model działania | Agentowa analiza strony w każdej sesji | Deterministyczne generowanie pipeline’u z agentowym wsparciem utrzymania |
| Utrzymanie | Użytkownik uruchamia ponownie na zgodnych stronach | Automatyczny monitoring pipeline’u i samonaprawa (według opisu dostawcy) |
| Widoczność działania | Podgląd tabeli, dopracowanie | Skuteczność, MTTR, pochodzenie danych, dashboardy SLA (według opisu dostawcy) |
| Dostęp | Rozszerzenie do przeglądarki, aplikacja webowa, Open API, MCP Server, CLI | Platforma Web Scraping OS, wdrożenie enterprise |
| Cennik | Publiczne plany self-service, zobacz stronę cen | Kontakt z działem sprzedaży; brak publicznego cennika self-service w momencie pisania |
| Najlepsze zastosowanie | Zadania ad hoc, działowe lub umiarkowanie cykliczne | Zarządzane, wieloźródłowe, stale odświeżane zbiory danych dla enterprise |
Szczerze mówiąc — stworzenie tej tabeli zajęło mi więcej czasu, niż się spodziewałem, bo większość materiałów „Thunderbit vs Kadoa” w internecie po prostu stawia obu narzędziom znaczek przy „AI-powered” i na tym kończy temat. To niczego nie wyjaśnia.
Czym jest Thunderbit?
Oto rzeczywisty proces — dokładnie taki, jak działa dziś (nie stary interfejs, który wciąż opisują niektóre recenzje):

Otwierasz stronę, do której masz uprawniony dostęp. Klikałeś One Click Extract. To wszystko — agent Thunderbit wykrywa strukturę strony, czyta treść, rozpoznaje, które pola są istotne, i zaczyna przygotowywać ekstrakcję. Zobaczysz przycisk Run Now, ale szczerze — nie musisz go nawet klikać; jeśli nic nie zrobisz, proces i tak ruszy automatycznie. Jeden świadomy klik, zero ustawiania schematu, zero selektorów.
Lubię opisywać to tak: „to narzędzie nie przeszkadza”. Nadal możesz dopracować wynik naturalnym językiem, jeśli automatycznie wykryte pola nie są idealne, a na zgodnych stronach narzędzie samo przejdzie przez kolejne podstrony lub wzbogaci dane. Poza rozszerzeniem do przeglądarki dostępne są też Web App, Open API dla deweloperów, MCP Server dla agentów AI takich jak Claude czy Cursor oraz CLI do pracy w terminalu. Eksport trafia do Excel, Google Sheets, Airtable lub Notion.
To nie jest narzędzie projektowane jako element ciężkiego stacku data engineering. To rozwiązanie dla osoby, która potrzebuje danych już teraz i nie chce zakładać ticketu, żeby je dostać.
Czym jest Kadoa w 2026 roku?
I tu robi się ciekawie. Ogłoszenie Kadoa z czerwca 2026 wprowadziło to, co nazywają Web Scraping OS, napędzane czymś, co określają jako „Kadoa Assistant”. Opisywany przez nich workflow wygląda tak:
- Wpisujesz zapytanie po ludzku — „Potrzebuję danych cenowych z tych 12 stron konkurencji, odświeżanych codziennie”
- Kadoa analizuje źródła i wybiera najbardziej niezawodną metodę ekstrakcji (endpoint API, osadzony JSON, plik do pobrania — cokolwiek jest najstabilniejsze)
- Proponuje schemat danych
- Buduje deterministyczny pipeline — czyli faktyczny wygenerowany kod ekstrakcji, a nie model językowy zgadujący przy każdym uruchomieniu — i go testuje
- Oglądasz podgląd i zatwierdzasz
- Wszystko trafia do produkcji z harmonogramem, walidacją i powiadomieniami wbudowanymi w proces
Ujęcie „Web Scraping OS” oznacza automatyczne utrzymanie pipeline’ów, odblokowanie infrastruktury, dashboardy obserwowalności (skuteczność, mean time to repair, śledzenie SLA), pochodzenie danych oraz procesy governance/compliance. To jest język infrastruktury enterprise, a obecne pozycjonowanie mocno celuje w zastosowania finansowe i alternative data — czyli np. fundusze hedgingowe i asset managerów, którzy potrzebują audytowalnych, stale odświeżanych zbiorów danych z dziesiątek źródeł.
To naprawdę inna ambicja produktowa niż „pomóż mi zeskrobać stronę”. Trzeba Kadoa oddać jedno: przejście od narzędzia do scrapowania do platformy infrastruktury danych to realny ruch strategiczny, a nie zwykły rebranding dla marketingu.
Kluczowa różnica: natychmiastowa ekstrakcja kontra cykl życia zbioru danych produkcyjnych
Jednoklikowe, interaktywne zadanie Thunderbit
Thunderbit optymalizuje najkrótszą możliwą drogę między „widzę dane na stronie” a „mam je w arkuszu”. Nie ma kroku przeglądu schematu, bo agent wykrywa pola w czasie rzeczywistym na stronie, którą właśnie oglądasz. Jeśli jesteś solo founderem albo handlowcem, dokładnie tego potrzebujesz — o 16:00 we wtorek nie masz energii na „zatwierdzanie podglądu pipeline’u”, kiedy potrzebujesz po prostu 200 leadów.
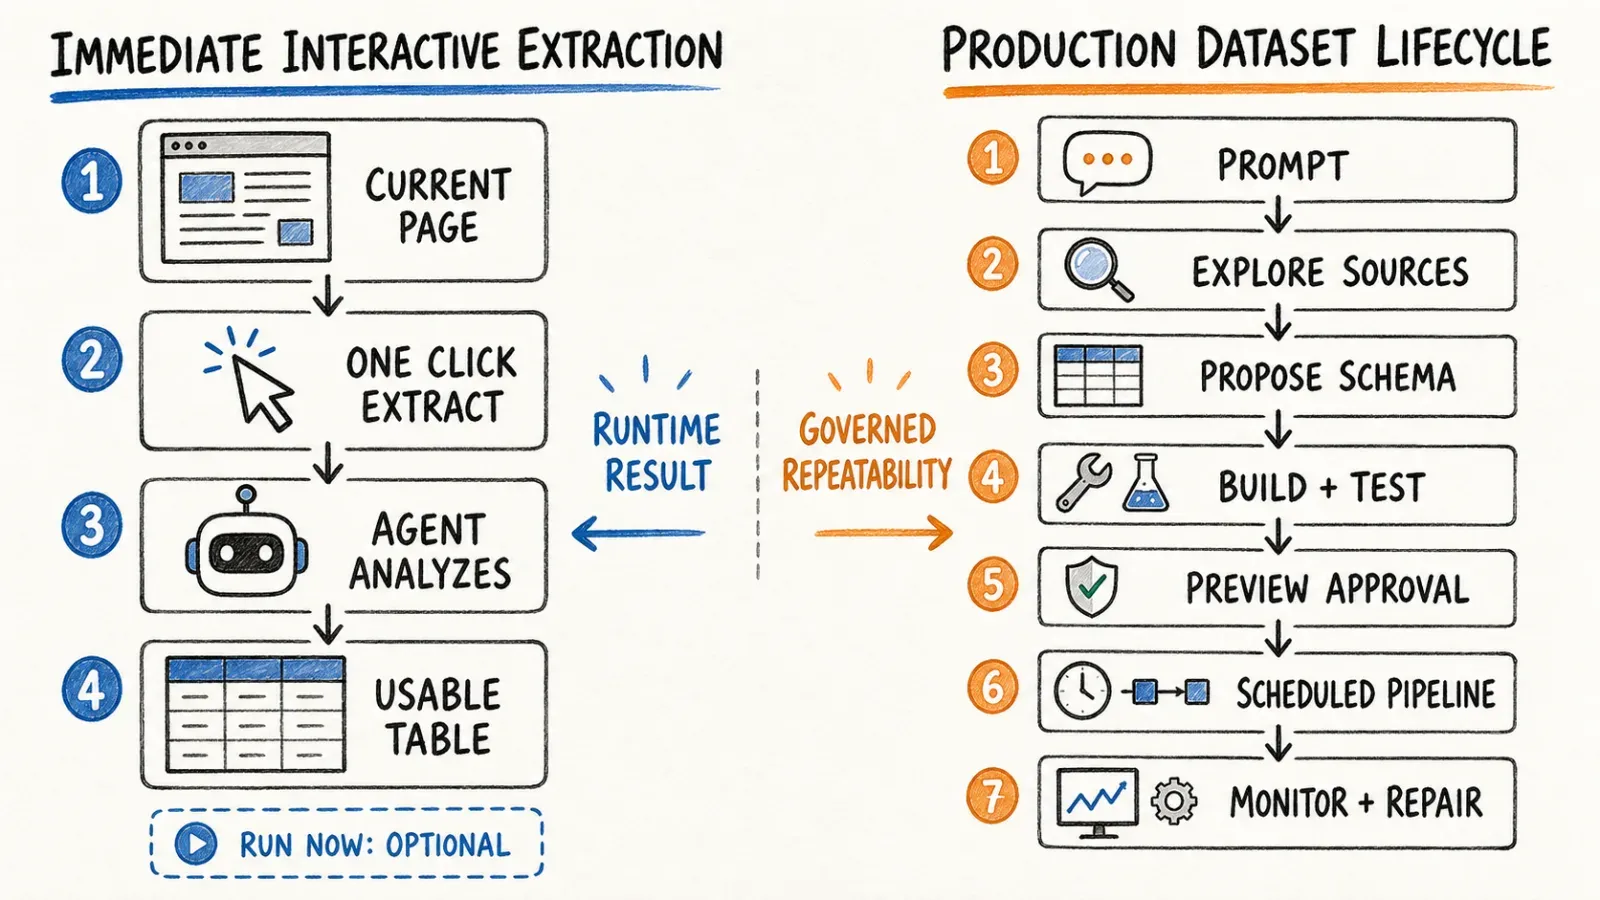
Zatwierdzony deterministyczny pipeline Kadoa
Workflow Kadoa celowo wstawia etap przeglądu i akceptacji, zanim cokolwiek trafi do produkcji. To nie jest wada, tylko założenie — jeśli budujesz zbiór danych zasilający model tradingowy albo raport zgodności, chcesz, żeby człowiek zatwierdził schemat, zanim proces będzie działał bez nadzoru przez następne sześć miesięcy.
Interpretacja w runtime kontra generowany przez agenta utrzymywany kod
Jest tu ważny niuans architektoniczny: Kadoa wyraźnie rozróżnia generowanie deterministycznego kodu ekstrakcji przez agenta (który potem działa bez wywoływania LLM przy każdym uruchomieniu) od bezpośredniej ekstrakcji LLM przy każdym odświeżeniu strony. Ich oficjalne wyjaśnienie AI w web scrapingu opisuje to szerzej. Nie będę zgadywać ponad to, co opublikowali, ale wniosek jest taki: Kadoa próbuje połączyć niezawodność deterministycznego kodu z szybkością konfiguracji typową dla generowania pipeline’u wspieranego AI. Thunderbit z kolei utrzymuje agentową analizę w pętli dla każdej interaktywnej sesji, zamiast od razu kompilować długowieczny artefakt pipeline’u.
Scenariusze z praktyki
Pokażę, jak faktycznie użyłbym każdego z tych narzędzi, bo abstrakcyjne porównania funkcji nigdy nie pokazują całego obrazu.
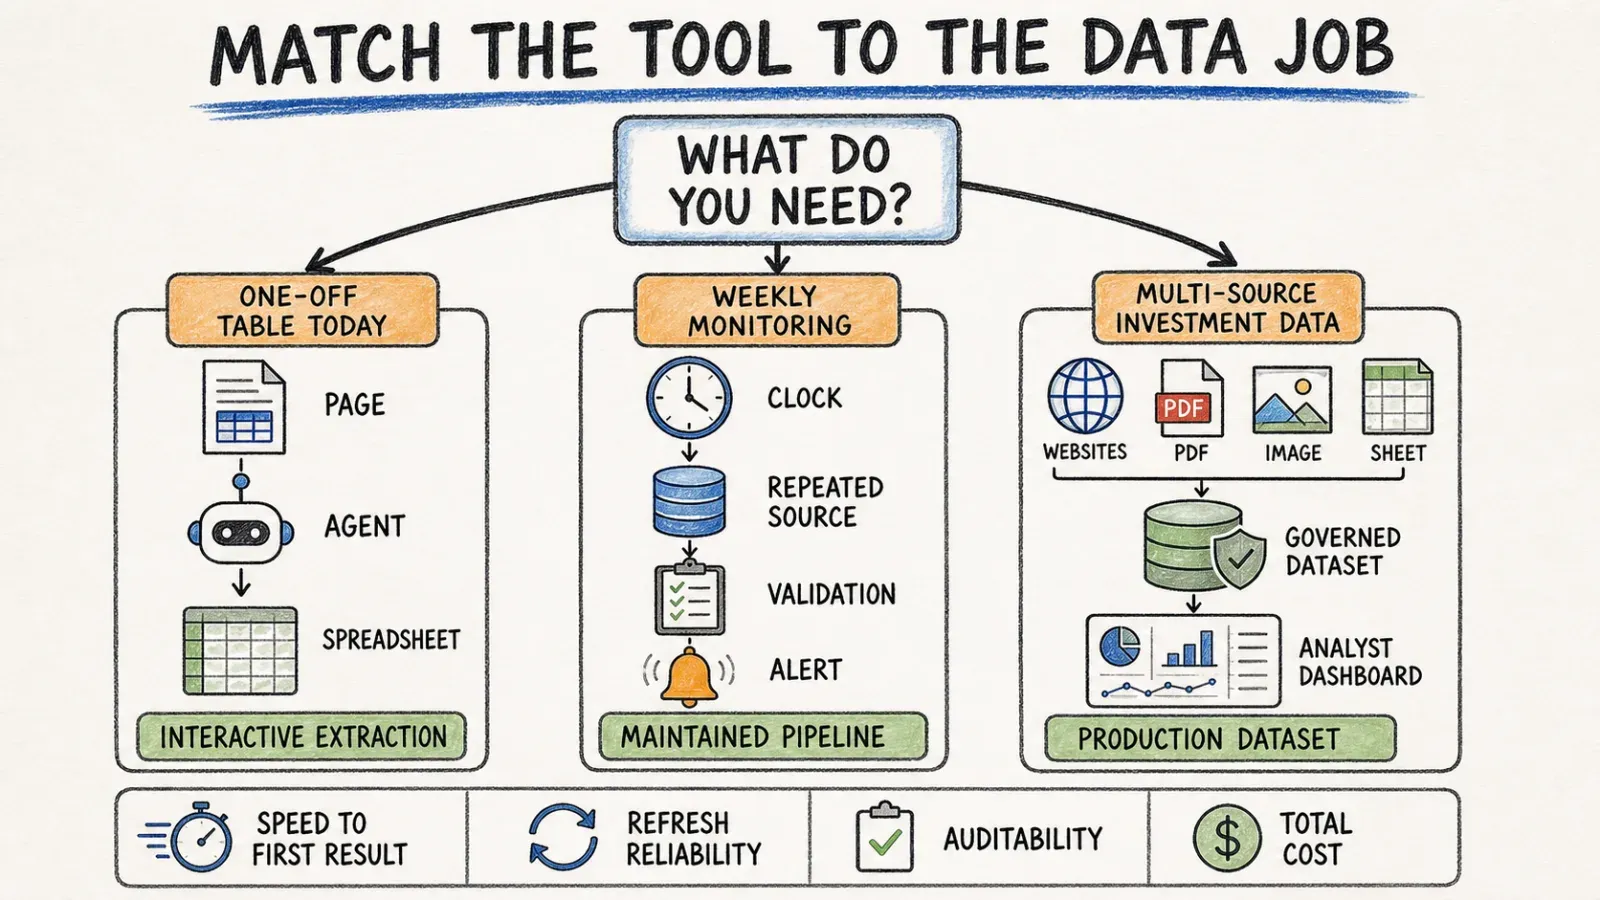
Jednorazowa tabela leadów / produktów / researchu
Załóżmy, że potrzebuję listy 150 firm z katalogu, wraz z nazwami, stronami WWW i adresami e-mail do kontaktu. Otworzyłbym stronę, kliknął One Click Extract w Thunderbit i miałbym arkusz w mniej niż minutę. Nie ma świata, w którym uruchamiałbym pipeline Kadoa, czekał na akceptację schematu i planowany run dla jednorazowej listy tego typu. Totalna przesada.
Cotygodniowy zbiór danych do monitorowania konkurencji
Teraz załóżmy, że chcę dane cenowe z 15 stron konkurencji, odświeżane w każdy poniedziałek rano i trafiające do dashboardu, któremu ufa cały zespół. To dużo bliżej mocnych stron Kadoa — etap akceptacji, monitoring, a także scenariusz „co się stanie, gdy konkurent przebuduje stronę” zaczynają mieć duże znaczenie. Thunderbit też technicznie potrafi wykonywać zaplanowaną ekstrakcję na obsługiwanych planach i powierzchniach, ale cały przekaz Kadoa jest zbudowany właśnie wokół takiego powtarzalnego, wieloźródłowego use case’u.
Wieloźródłowy workflow investment / alternative data
To jest terytorium Kadoa, patrząc na ich obecne pozycjonowanie — pobieranie danych z dziesiątek źródeł finansowych lub alternative data z pełnym śledzeniem pochodzenia i audytem. W takim przypadku nie sięgałbym po Thunderbit; to po prostu nie jest centrum projektowe tego produktu.
Integracja z agentem AI i dostarczanie danych
Jeśli buduję pipeline RAG albo agenta monitorującego, który ma programowo wywoływać narzędzie ekstrakcyjne, wtedy wchodzi Thunderbit z MCP Server i Open API — Claude, Cursor albo inny zgodny host AI może wywołać Thunderbit bezpośrednio. Na moment pisania nie widzę publicznie dostępnego self-serve API ani oferty MCP od Kadoa, więc jeśli to twardy wymóg Twojego stacku, sprawdź to bezpośrednio u Kadoa, zamiast zakładać pełną parytetowość.
Dokładność, utrzymanie i obserwowalność
Kadoa opisuje grounding źródeł, scoring pewności oraz testy wiarygodności i kompletności jako część walidacji pipeline’u. Publikowali też wczesne wyniki — np. szybszą konfigurację i mniejszy narzut utrzymania — od klientów early-access. Chcę powiedzieć to wprost: to są liczby podawane przez samego dostawcę, nie niezależne benchmarki, i nie widziałem kontrolowanego testu head-to-head między Thunderbit a Kadoa pod kątem dokładności czy kosztu utrzymania. Traktuj więc każdy konkretny procent z ich marketingu jako deklarację do zweryfikowania, a nie przesądzony fakt.
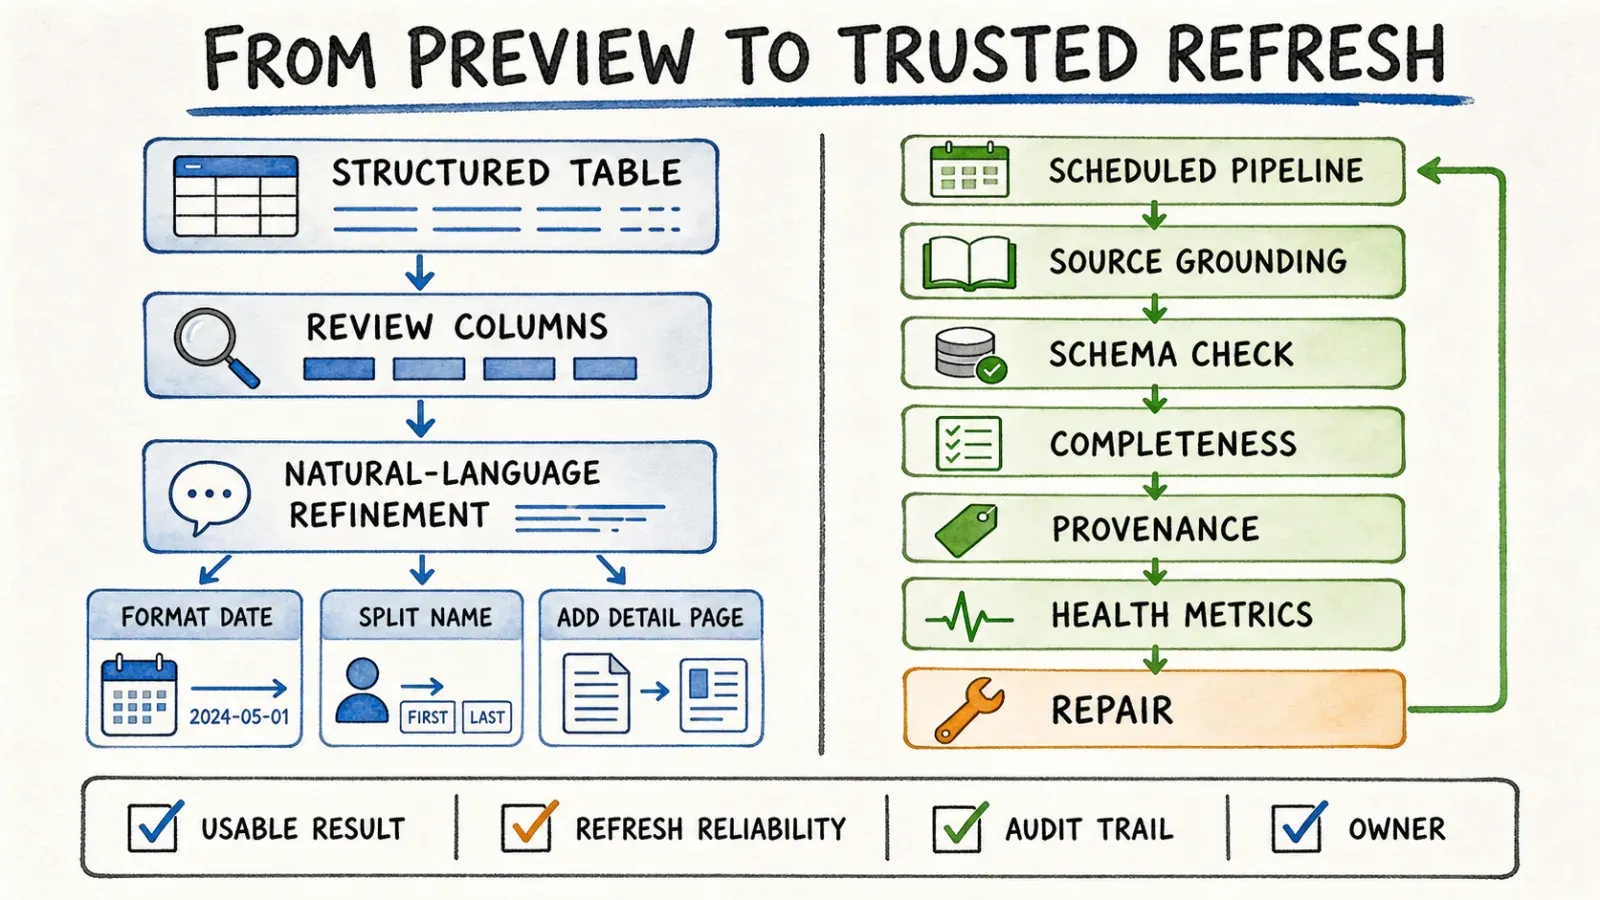
Po stronie Thunderbit historia dokładności jest prostsza, bo prostszy jest też workflow: dostajesz natychmiastowy podgląd tabeli, możesz ocenić go „na oko” i doprecyzować instrukcje pól od razu, a nie ma tu półrocznego pipeline’u, który cicho rozjeżdża się po redesignie strony — bo po prostu nie ma półrocznego pipeline’u. Dane są zawsze świeżo pobierane.
Jedno uczciwe zastrzeżenie, które dotyczy obu narzędzi: żadne nie gwarantuje sukcesu na każdej stronie. Loginy, agresywne zabezpieczenia anty-botowe i duże zmiany layoutu to realne punkty awarii. Agentowe ponowne analizowanie przez Thunderbit pomaga na zgodnych, uprawnionych stronach, ale „agentowe” nie jest magicznym słowem, które usuwa CAPTCHA.
API, MCP i wdrożenie
Powierzchnie dla deweloperów w Thunderbit są dobrze udokumentowane: Open API do dostępu programistycznego, MCP Server do integracji z agentami AI oraz CLI do pracy w terminalu i z coding agentami — plus uruchamianie w przeglądarce i w chmurze dla pracy interaktywnej.
Obecny model wdrożenia Kadoa skupia się na platformie enterprise Web Scraping OS, z zarządzaną infrastrukturą pipeline’ów oraz funkcjami governance/security skierowanymi do większych organizacji. Nie znalazłem w chwili pisania publicznej dokumentacji self-serve API ani integracji MCP dla Kadoa — jeśli to kluczowe dla Twojej oceny, potwierdź to bezpośrednio z ich zespołem, zamiast zakładać parytet z narzędziami deweloperskimi Thunderbit.
Cennik i sposób zakupu
Tu muszę być szczery co do ograniczenia: obecne publiczne strony Kadoa, po launchu z czerwca 2026, nie pokazują self-serve tabeli cen. Ich komunikacja kieruje potencjalnych klientów do kontaktu ze sprzedażą albo do zamówienia testu. Jeśli więc porównujesz pozycje typu „$X/miesiąc” między tymi produktami, po stronie Kadoa natrafisz na mur — nie dlatego, że nie chciałem tego sprawdzić, tylko dlatego, że tego po prostu nie opublikowano.
Thunderbit ma natomiast publiczną, aktualną stronę cen z planami self-service, które możesz sprawdzić od razu.
To, co naprawdę ma znaczenie przy porównaniu sposobu zakupu, to nie sama cena, tylko tarcie procurementowe. Thunderbit pozwala zarejestrować się i zacząć ekstrakcję w kilka minut. Model enterprise Kadoa zakłada rozmowę sprzedażową, onboarding i prawdopodobnie okres proof-of-concept, zanim wejdziesz do produkcji. Jeśli Twoja organizacja i tak ma proces zakupowy przygotowany pod enterprise SaaS, nie będzie to problem. Jeśli jesteś dwuosobowym zespołem, to realny koszt tarcia, który warto uwzględnić.
Które narzędzie wybrać?
Wybierz Thunderbit, jeśli...
- Jesteś solo marketerem, founderem albo handlowcem i potrzebujesz danych z kilku stron już dziś, bez czekania na kogokolwiek
- Twój zespół potrzebuje cyklicznych eksportów do Sheets lub Airtable, ale nie ma działu data engineering i nie chce go budować
- Jesteś deweloperem, który tworzy agenta AI, pipeline RAG albo skrypt monitorujący i chcesz dostępu programistycznego przez API, MCP lub CLI
- Wolisz dostać używalną tabelę jednym kliknięciem niż formalny workflow akceptacji pipeline’u
Wybierz Kadoa, jeśli...
- Jesteś zespołem danych w enterprise lub finansach i potrzebujesz zarządzanych, wieloźródłowych, stale odświeżanych zbiorów danych z audytem
- Compliance, pochodzenie danych i dashboardy obserwowalności to dla Ciebie warunki konieczne
- Masz już proces zakupowy, albo go budujesz, pod produkt enterprise z kontaktem ze sprzedażą i ceną ustalaną indywidualnie
- Utrzymanie pipeline’u i infrastruktura samonaprawiająca są dla Ciebie ważniejsze niż szybkość jednego kliknięcia
Użyj obu, jeśli...
- Twoi analitycy chcą szybko sprawdzić i zweryfikować pomysł na dane z Thunderbit, zanim centralny zespół danych uzna, że warto zamienić go w utrzymywany pipeline enterprise w Kadoa. Widziałem już taki model w mniejszych firmach, które rosną — najpierw działanie „na szybko”, formalizacja później.
Ostateczny werdykt
Wciąż wracam do tego samego ujęcia: Thunderbit to interaktywny agentowy scraper zbudowany pod szybkość i dostępność. Kadoa, szczególnie po rebrandingu, to enterprise Web Scraping OS zbudowany pod governance i skalę. Porównywanie ich po checkliście funkcji mija się z celem — rozwiązują zupełnie różne problemy.
Jeśli naprawdę wahasz się między nimi, moją szczerą radą jest zrobienie małego proof of concept zamiast ufać dowolnemu artykułowi porównawczemu (w tym temu). Zmierz: jak szybko masz pierwszy używalny wynik, jak dobrze ekstrakcja znosi zmianę strony, jak audytowalny jest wynik w Twoim przypadku oraz jaki jest realny całkowity koszt posiadania po uwzględnieniu czasu konfiguracji i utrzymania.
Dla większości osób trafiających na tę stronę — ktoś patrzy na stronę i zastanawia się, jak wyciągnąć z niej dane bez pisania kodu i bez czekania na IT — rozszerzenie Thunderbit do przeglądarki będzie prawdopodobnie szybszą drogą do odpowiedzi. Możesz zacząć za darmo i w pięć minut będziesz wiedzieć, czy rozwiązuje Twój problem.
FAQ
Czy Thunderbit i Kadoa są oba agentowe? Tak. Oba wykorzystują agentów AI do rozumienia struktury strony i ekstrakcji danych bez ręcznego pisania selektorów. Thunderbit stosuje agentową analizę w każdej interaktywnej sesji na oglądanej stronie; Kadoa używa agentów do generowania i utrzymywania deterministycznych pipeline’ów ekstrakcyjnych dla danych produkcyjnych.
Jak działa Kadoa Assistant? Według oficjalnego ogłoszenia Kadoa opisujesz potrzebne dane naturalnym językiem, Kadoa analizuje źródła i proponuje schemat, buduje i testuje deterministyczny pipeline, a po Twojej akceptacji wdraża go jako zaplanowany, monitorowany workflow.
Czy Thunderbit wymaga selektorów albo konfiguracji schematu? Nie. Klikasz One Click Extract na stronie, a agent automatycznie wykrywa pola; Run Now jest opcjonalny, bo ekstrakcja startuje sama, jeśli nic nie klikniesz.
Czy Kadoa uruchamia ekstrakcję LLM na każdej stronie? Niekoniecznie. Kadoa rozróżnia kod deterministyczny generowany przez agenta (który działa bez wywołania LLM przy każdym uruchomieniu) oraz bezpośrednią ekstrakcję LLM. Ich opis architektury omawia to rozróżnienie szerzej.
Które narzędzie jest lepsze do cyklicznych zbiorów danych? To zależy od skali i potrzeb governance. Thunderbit wspiera zaplanowaną ekstrakcję w obsługiwanych planach dla umiarkowanie cyklicznych zadań. Kadoa jest zaprojektowane specjalnie pod duże, wieloźródłowe, stale utrzymywane zbiory danych z obserwowalnością i kontrolą compliance — jego obecne pozycjonowanie celuje głównie w finansy i enterprise data teams.
Czy cennik Kadoa jest publiczny? W chwili pisania — nie. Obecne strony launchowe Kadoa kierują zainteresowanych do kontaktu ze sprzedażą albo do zamówienia testu, zamiast pokazywać publiczne plany self-service. Thunderbit ma publiczną stronę cen, którą możesz sprawdzić bezpośrednio.
Czy któreś z tych narzędzi obsłuży każdą stronę? Nie. Oba działają najlepiej na zgodnych, autoryzowanych stronach. Loginy, agresywne systemy anty-botowe i duże przebudowy witryn nadal są realnymi punktami awarii dla każdego narzędzia do scrapowania, agentowego czy nie — traktuj więc obietnice typu „obsługuje wszystko” z dużą dozą sceptycyzmu.




