
Data Miner od ponad dekady siedzi w folderach rozszerzeń Chrome wielu użytkowników, cicho wspierając całą armię osób, które zbudowały własną bibliotekę „receptury do web scrapingu”. Widziałem, jak ten temat wracał na forach za każdym razem, gdy ktoś pytał, jak pobrać tabelę ze strony bez pisania kodu. To naprawdę solidne narzędzie. Ale jest też dobrym przykładem tego, że „no-code” nadal może znaczyć: „bez kodu, ale to ty budujesz całą logikę”.
To właśnie jest prawdziwe pytanie, które ludzie wpisują w Google, szukając hasła „Thunderbit kontra Data Miner”: czy chcę sam tworzyć reguły wielokrotnego użytku, czy wolę agentowy web scraper, który sam ogarnie stronę za mnie? Odpowiedzmy na to porządnie, obok siebie, zamiast robić to, co robi większość artykułów — opisywać Data Miner, a potem nagle przechodzić do prezentacji Thunderbit, nigdy nie zestawiając obu narzędzi w jednej tabeli.
Thunderbit kontra Data Miner w skrócie
Powiem wprost: prowadzę Thunderbit, więc potraktuj to zestawienie z odpowiednim dystansem. Starałem się jednak przedstawić uczciwie to, co każde narzędzie faktycznie robi, a nie to, w co chciałaby cię przekonać dowolna strona marketingowa.
| Kategoria | Data Miner | Thunderbit |
|---|---|---|
| Metoda ekstrakcji | Ręczne „receptury” oparte na selektorach CSS/HTML | AI agentowa — kliknij One Click Extract, a narzędzie rozpozna i odczyta stronę, po czym uruchomi się automatycznie |
| Konfiguracja przy pierwszym użyciu | Zbuduj prywatną recepturę albo znajdź/podglądnij publiczną | Bez selektorów i schematu — jeden celowy klik na obsługiwanych stronach |
| Stronicowanie | Dodaj selektor „Next” do List Recipe | Obsługiwane stronicowanie na kompatybilnych stronach |
| Wzbogacanie stron szczegółów | Proces z dwiema recepturami: List Recipe → zapisz URL-e → Detail Recipe → Crawl | Kompatybilne wzbogacanie podstron, scalane do jednej tabeli |
| Strony za logowaniem | Działa na widocznej treści w autoryzowanej sesji przeglądarki | Działa na widocznej treści w autoryzowanej sesji przeglądarki |
| Eksport | CSV, Excel, schowek, Google Sheets (płatne plany) | Eksport do obsługiwanych miejsc docelowych (Sheets, Airtable, Notion) oraz pobieranie plików |
| Automatyzacja | Automatyzacja przeglądarki, automatyzacja kolejnych stron, niestandardowy JS, zautomatyzowane crawle | Uruchomienia w przeglądarce/chmurze, harmonogramy tam, gdzie są dostępne, Open API, MCP Server, CLI |
| Wielokrotne użycie | Receptury można udostępniać i ponownie wykorzystywać — ogromna biblioteka społeczności | AI za każdym razem na nowo interpretuje stronę; brak biblioteki receptur do utrzymywania |
| Model cenowy | Miesięczne kredyty stron, zależne od wolumenu | Oparty na planie, zobacz aktualny cennik |
| Najlepsze zastosowanie | Stabilne, powtarzalne źródła, dla których istnieje już działająca receptura | Nowe lub zmienne strony, osoby nietechniczne, szybkie jednorazowe zadania |
Nikt inny nie zestawił tych dwóch narzędzi w ten sposób. Sprawdziłem. To dość dziwna luka, biorąc pod uwagę, jak często to hasło jest wyszukiwane.
Czym jest Thunderbit?
Thunderbit to, jak to nazywam, agentowy web scraper — a część „agentowy” ma znaczenie, bo narzędzie nie tylko automatyzuje kliknięcia. Ono interpretuje stronę tak, jak zrobiłby to człowiek, a potem decyduje, które dane mają sens. Instalujesz rozszerzenie Chrome, otwierasz stronę, do której masz uprawniony dostęp, i klikasz One Click Extract. To naprawdę wszystko, czego wymaga start. Agent odczytuje stronę, rozpoznaje przydatne pola i zaczyna działać — możesz kliknąć Run Now, jeśli chcesz uruchomić go od razu, ale jeśli po prostu poczekasz, wystartuje sam.

Zbudowałem to specjalnie dlatego, że miałem dość patrzenia, jak nietechniczni członkowie zespołu w poprzednich firmach blokowali się w chwili, gdy narzędzie do scrapingu prosiło ich o zdefiniowanie „selektora”. Większość ludzi nie wie, czym jest selektor CSS, i szczerze mówiąc — nie powinna musieć wiedzieć.
Poza rozszerzeniem dostępna jest też aplikacja webowa, Open API dla programistów chcących korzystać z dostępu programowego, MCP Server do workflow z agentami AI (pomyśl o Claude, Cursor i całym tym ekosystemie) oraz CLI do automatyzacji z terminala. Na kompatybilnych stronach obsługuje stronicowanie i może wzbogacać wiersze listy o dane pobrane ze stron szczegółów, a potem scalić wszystko w jedną tabelę.
Czym jest Data Miner?
Data Miner jest starszy, bardziej ugruntowany i opiera się na zupełnie innej filozofii: receptury do web scrapingu. Receptura to zapisany zestaw instrukcji — w praktyce selektory mapowane na wiersze i kolumny — powiązany z konkretną strukturą HTML danej strony. W dokumentacji pomocy Data Minera help documentation wyjaśniono, że receptury występują w trzech wariantach: publiczne (udostępniane przez innych użytkowników), generyczne (zaprojektowane tak, by działały szerzej na wielu stronach) oraz prywatne (tworzone samodzielnie).
Na stronie podano, że dostępnych jest ponad 50 000 publicznych receptur obejmujących ponad 15 000 popularnych witryn — choć ciekawostką jest, że w innej części ich własnej strony pojawia się liczba „60 000”. Nazwę to po prostu „dziesiątkami tysięcy” i zostawię ci ocenę, jak precyzyjnie to liczą.
Data Miner obsługuje Page Scrape, Next Page Automation, URL Crawl (do scrapingu list adresów URL), automatyczne wypełnianie formularzy oraz niestandardowy JavaScript dla bardziej zaawansowanych użytkowników. Działa w przeglądarce, więc ma dostęp do treści widocznych po zalogowaniu — dokładnie tak, jak widzisz je ręcznie — a klienci Enterprise otrzymują także opcję uruchamiania po stronie serwera.
Prawdziwa różnica: interpretacja strony w czasie działania kontra zapisane receptury
Tu właśnie większość artykułów porównawczych robi się leniwa. Piszą: „Data Miner opiera się na receptury do web scrapingu, Thunderbit na AI” i na tym kończą — bez przykładu, bez przejścia krok po kroku, bez niczego, co naprawdę można sobie wyobrazić.
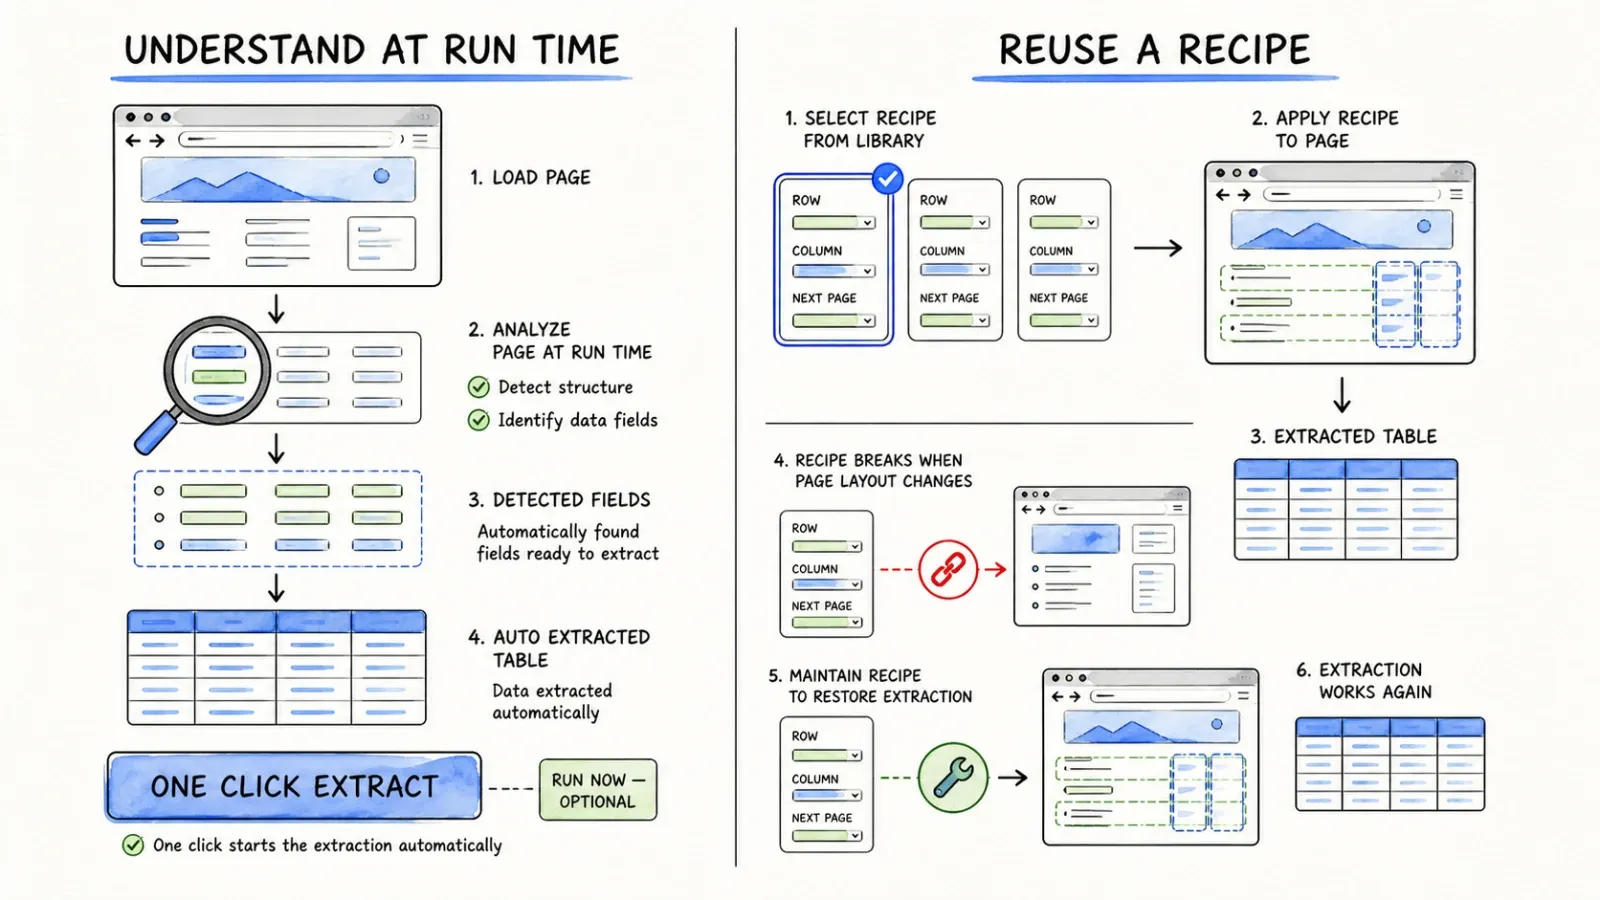
Thunderbit przekazuje interpretację agentowi. Za każdym razem, gdy trafiasz na nową stronę, AI analizuje ją od nowa. Nie odwołuje się do zapisanej instrukcji dla tej konkretnej witryny — czyta DOM, rozumie strukturę i ocenia, które dane mogą być istotne. Oznacza to zero czasu na konfigurację na stronie, której nigdy wcześniej nie widziałeś, ale też to, że AI wykonuje realną pracę przy każdym uruchomieniu, zamiast odtwarzać wyuczony skrypt.
Data Miner ponownie wykorzystuje instrukcje selektorów. Gdy receptura już istnieje — niezależnie od tego, czy stworzyłeś ją ty, czy ktoś inny — ponowne uruchomienie jest szybkie, bo logika jest już gotowa. Cena tego rozwiązania, co sami autorzy Data Minera przyznają, polega na tym, że jeśli HTML strony się zmieni, receptura może przestać działać. Zamiast scrapingu masz wtedy debugowanie selektorów.
Kiedy którekolwiek podejście staje się „jednym kliknięciem”: Data Miner może być naprawdę jedną akcją — jeśli dla twojego dokładnego celu istnieje już działająca publiczna receptura. To jednak duże „jeśli”. Z kolei obietnica „one click” w Thunderbit dotyczy stron, które agent potrafi skutecznie zinterpretować; to również nie jest gwarancja dla każdej witryny w internecie, zwłaszcza przy silnych zabezpieczeniach antybotowych lub nietypowych układach.
Żadne z tych narzędzi nie ma monopolu na „łatwość”. Po prostu definiują ją inaczej — jedno przez skróty tworzone przez społeczność, drugie przez interpretację w czasie działania.
Porównanie praktycznego workflow
Scraping prostej tabeli: W Data Minerze sprawdziłbyś, czy istnieje publiczna receptura dla danej strony, podejrzał ją i uruchomił scraping, jeśli pasuje. Jeśli nie, ręcznie budujesz wiersze i kolumny przy pomocy Easy Finder. W Thunderbit po prostu klikasz One Click Extract i pozwalasz, by narzędzie samo rozpoznało strukturę tabeli.
Stronicowanie list produktów lub katalogów: Data Miner wymaga dodania selektora nawigacji do List Recipe, aby wiedział, jak wygląda „Next”. Thunderbit obsługuje kompatybilne stronicowanie na wspieranych stronach bez tego ręcznego kroku.
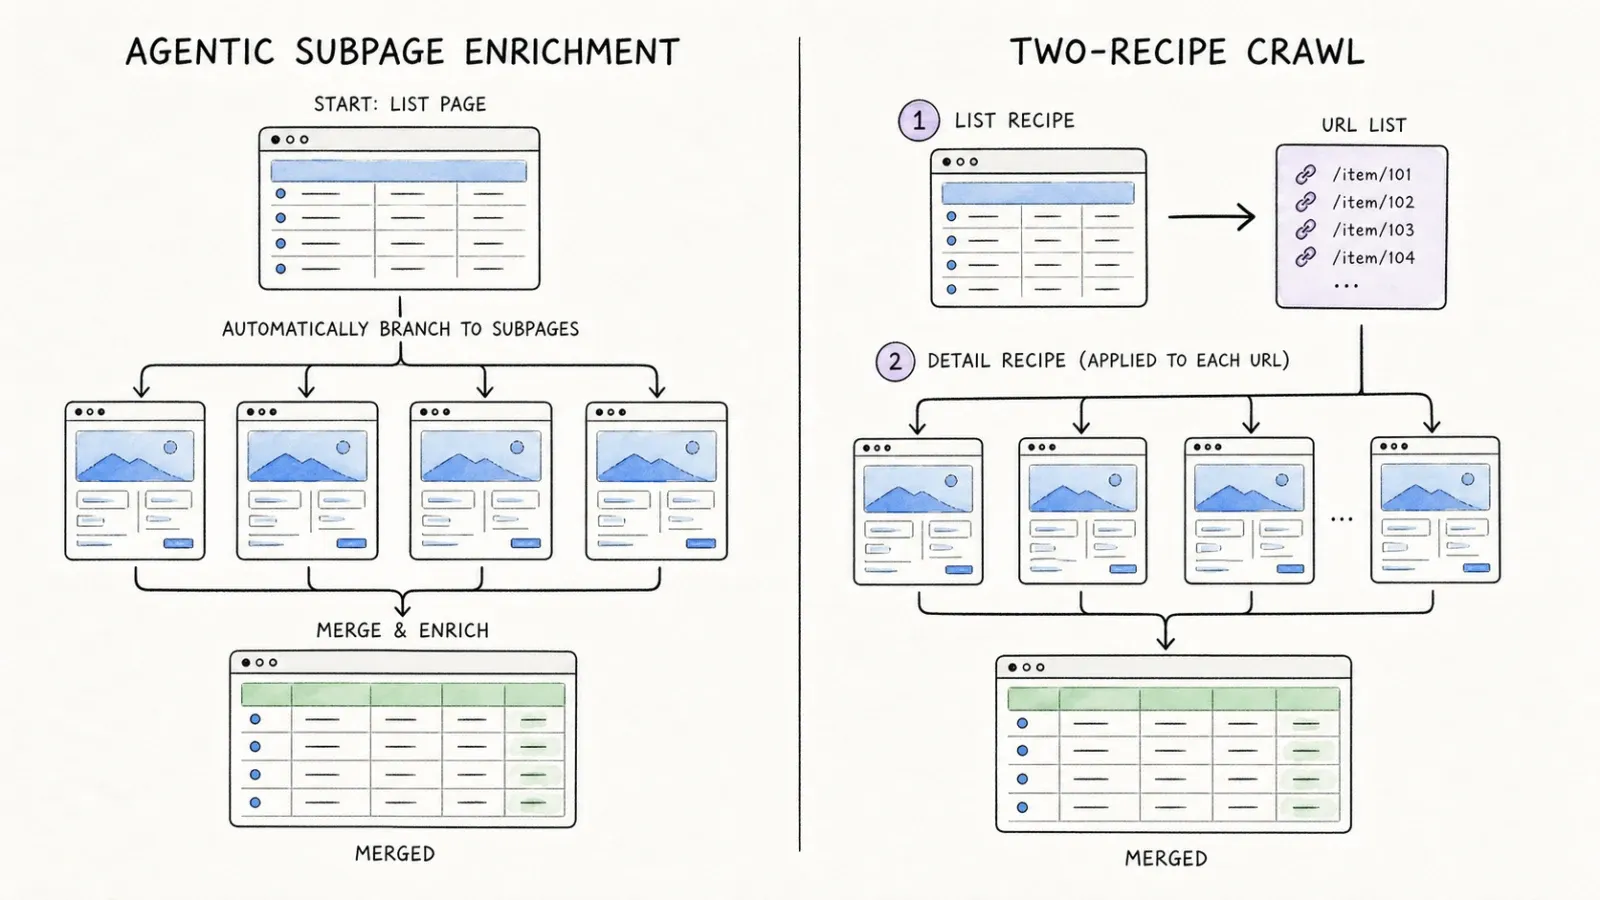
Wzbogacanie wierszy listy danymi ze stron szczegółów: To tutaj workflow najbardziej się rozchodzą. Dokumentacja Crawl w Data Minerze opisuje naprawdę wieloetapowy proces: budujesz List Recipe, aby zebrać URL-e stron szczegółów, zapisujesz tę listę URL-i, tworzysz osobną Detail Recipe, konfigurujesz zadanie Crawl łączące oba elementy, weryfikujesz adresy, uruchamiasz proces, a potem eksportujesz dane. Działa to, ale wymaga kilku odrębnych kroków i dwóch osobnych receptur. Kompatybilne wzbogacanie podstron w Thunderbit wciąga dane ze stron szczegółów do tej samej tabeli bez tego tańca z parą receptur — choć uczciwie dodam, że działa to niezawodnie tylko na stronach, które agent potrafi dobrze odczytać.
Praca za autoryzowanym logowaniem: Oba narzędzia działają na treściach widocznych w sesji przeglądarki, więc jeśli jesteś zalogowany na konto z odpowiednimi uprawnieniami, oba widzą to, co widzisz ty. Żadne z nich nie omija magią autoryzacji — po prostu pracują na tym, co jest wyrenderowane na ekranie.
Automatyzacja, rozszerzenia i dostęp dla programistów
Automatyzacja w Data Minerze odbywa się w przeglądarce: automatyzacja kolejnych stron, automatyczne crawle URL-i i niestandardowy JavaScript dla osób, które czują się dobrze, pisząc własne skrypty. Integracja z Google Sheets jest dostępna w płatnych planach. Klienci Enterprise mogą przenieść wykonywanie zadań na serwery Data Minera zamiast uruchamiać wszystko lokalnie.
Thunderbit oferuje szerszy zakres w innym kierunku. Oprócz uruchomień w przeglądarce i w chmurze, z harmonogramami tam, gdzie są dostępne, jest też Open API do integracji backendowych oraz MCP Server — i ma to większe znaczenie, niż mogłoby się wydawać. MCP pozwala agentom AI (Claude Code, Cursor i podobnym narzędziom) wywoływać Thunderbit bezpośrednio jako część własnych workflow. Jeśli budujesz rozwiązanie, w którym agent AI ma pobrać ustrukturyzowane dane z internetu jako jeden z kroków większego procesu, to jest to istotnie inna możliwość niż „napisałem trochę własnego JavaScriptu w rozszerzeniu przeglądarki”.
Żeby było jasne: niestandardowy JS w Data Minerze jest naprawdę użyteczny dla zaawansowanych użytkowników, którzy chcą pełnej kontroli. To po prostu nie ta sama kategoria narzędzia co publiczne API albo MCP Server, z którego może korzystać agent.
Eksport, prywatność i zarządzanie danymi
Data Miner eksportuje do CSV, Excela, schowka albo Google Sheets w płatnych planach. W ich FAQ cenowym podano, że zeskrobane dane nie są sprzedawane ani udostępniane, a dokumentacja crawl z przeglądarki zaznacza, że podczas standardowych zautomatyzowanych crawlów dane nie są przechowywane na serwerach Data Minera — po zakończeniu zadania masz samodzielnie zapisać wynik. Zadania Enterprise uruchamiane po stronie serwera to już zupełnie inny model wykonania.
Thunderbit eksportuje do obsługiwanych miejsc docelowych, takich jak Google Sheets, Airtable i Notion, a także oferuje standardowe pobieranie plików oraz tryby uruchamiania w przeglądarce i w chmurze, zależnie od workflow.
Nie będę udawał, że jedna architektura jest zawsze „bardziej prywatna” od drugiej — to naprawdę zależy od tego, co scrapujesz, jak wrażliwe są dane i jaki tryb wykonania wybierzesz. Jeśli prywatność danych ma znaczenie w twoim przypadku, warto porozmawiać o tym z dostawcą przed podjęciem decyzji, zamiast zakładać coś na podstawie artykułu porównawczego.
Ceny: limity stron i koszty receptur
Oto aktualny cennik Data Minera w chwili pisania tego tekstu:
| Plan | Cena | Stron/miesiąc |
|---|---|---|
| Free | $0 | 500 (niektóre domeny ograniczone) |
| Solo | $19.99/mies. | 500 |
| Small Business | $49/mies. | 1,000 |
| Business | $99/mies. | 4,000 |
| Business Plus | $200/mies. | 9,000 |
| Enterprise | Indywidualna | Indywidualna |
Kredyty resetują się co miesiąc i nie przechodzą na kolejny okres — a w ich FAQ jest też wzmianka, że przekroczenie darmowego limitu 500 stron może zablokować konto Free do czasu aktualizacji planu. Dobrze to wiedzieć, zanim przejdziesz przez połowę projektu.
Co prawie nikt nie wspomina przy recenzowaniu Data Minera: sprzedają oni także tworzenie niestandardowych receptur jako płatną usługę. Jedna niestandardowa receptura kosztuje jednorazowo 150 USD; wielopoziomowa receptura (czyli taka, jakiej potrzebujesz do crawlowania list do stron szczegółów) to 300 USD jednorazowo; wszystko bardziej zaawansowane wyceniane jest indywidualnie. Jeśli twoja docelowa strona nie ma działającej publicznej receptury i nie chcesz budować jej samodzielnie, to jest to realny koszt ponad abonament.
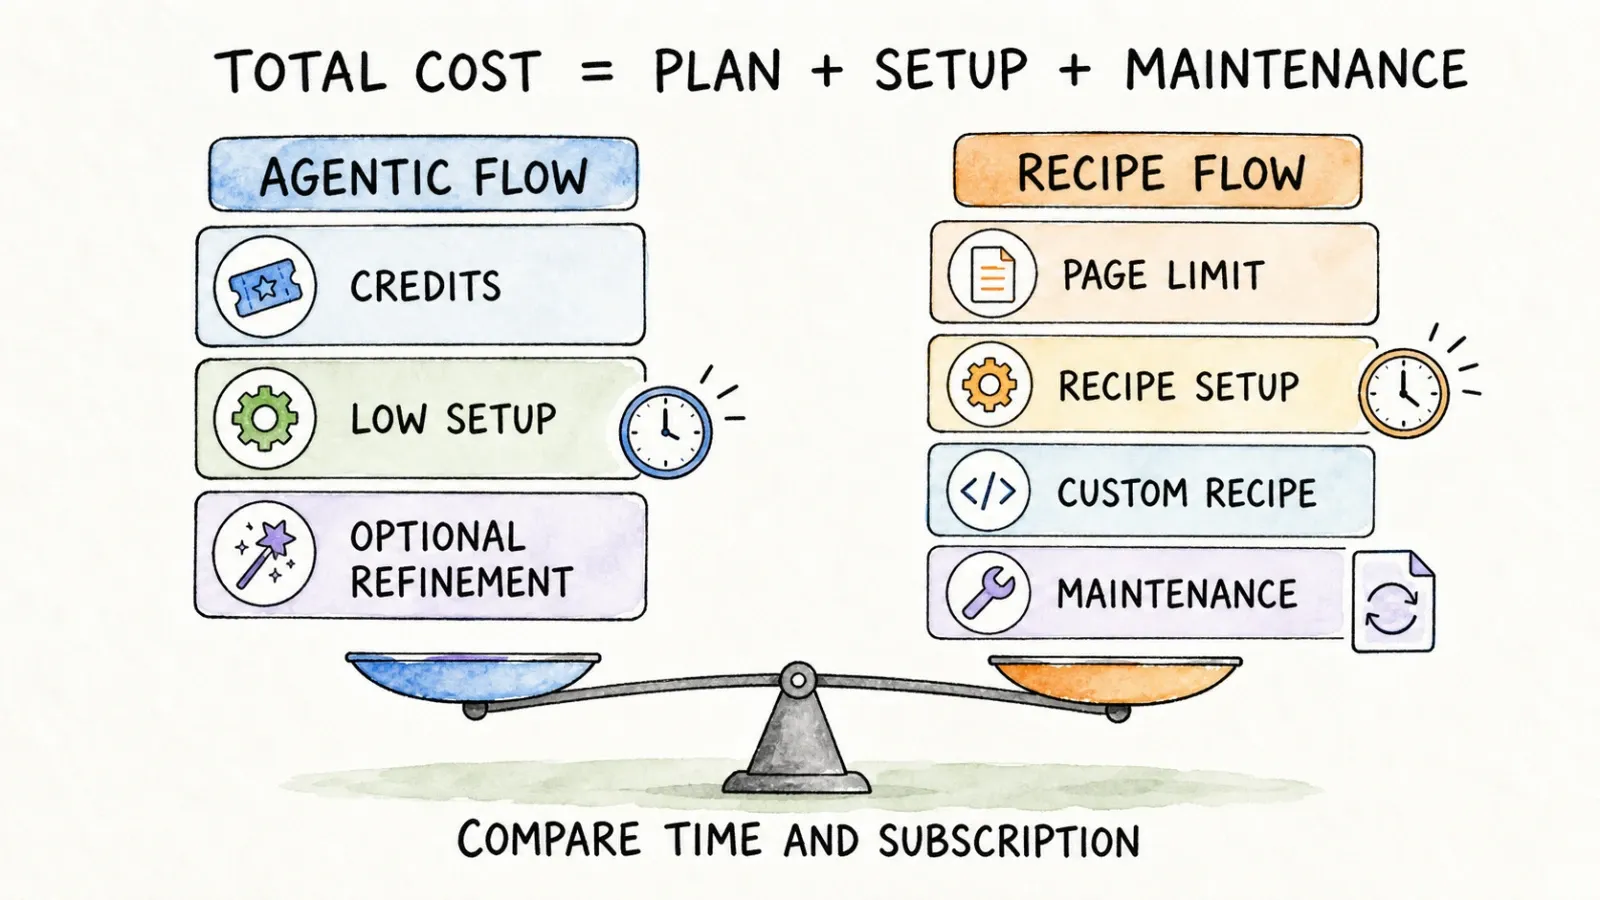
Jeśli chodzi o aktualne ceny Thunderbit, sprawdź bieżącą stronę z cennikiem, zamiast ufać jakimkolwiek liczbom, które mógłbym tu przytoczyć — plany się zmieniają i wolę odesłać cię do źródła niż ryzykować, że dane się zdezaktualizują.
Najważniejszy koszt to, szczerze mówiąc, nie sam cennik żadnego z planów, tylko łączny czas pracy. Budowanie i utrzymywanie receptur zajmuje godziny, za które nikt ci nie płaci — chyba że liczysz własne wynagrodzenie. Agentowa reinterpretacja pozwala uniknąć tego obciążenia związanego z utrzymaniem, ale oznacza, że AI wykonuje świeżą pracę przy każdym uruchomieniu, czyli ponosisz inny rodzaj kosztu (moc obliczeniową, a nie swój cały poranek).
Które narzędzie wybrać?
Wybierz Thunderbit, jeśli... nie jesteś techniczny, trafiasz na stronę, której nigdy wcześniej nie scrapowałeś, albo chcesz całkowicie pominąć etap budowania / szukania receptury. Dla osób z sales ops, które wyciągają listy leadów z katalogów, dla badaczy rynku sprawdzających co tydzień ceny konkurencji, dla każdego, kto chce po prostu mieć dane od razu, bez etapu konfiguracji.
Wybierz Data Miner, jeśli... masz powtarzalny, stabilny cel, dla którego istnieje już działająca publiczna receptura, albo należysz do osób, które naprawdę lubią szczegółową kontrolę selektorów i nie mają nic przeciwko przebudowie receptury po redesignie strony. Zaawansowani użytkownicy, którzy czują się dobrze z niestandardowym JavaScript, też poczują się tu jak w domu.
Używaj obu, jeśli... masz miks przypadków — część starszych zadań na stronach, dla których masz już działające receptury Data Minera (nie ma sensu ich odtwarzać), oraz nowe, zmienne źródła, dla których nie chcesz spędzać popołudnia na definiowaniu selektorów. Rozmawiałem z zespołami, które robią dokładnie tak: utrzymują stare receptury i testują Thunderbit dla wszystkiego nowego. To nie jest decyzja typu „albo–albo”, mimo że wiele artykułów „vs” tak to przedstawia.
Ostateczny werdykt
W gruncie rzeczy chodzi tu o interpretację agentową kontra receptury wielokrotnego użytku — i żadne z tych podejść nie jest obiektywnie lepsze w każdej sytuacji. Data Miner nagradza cierpliwość i inwestycję w konkretną stronę naprawdę szybkim uruchamianiem kolejnych zadań. Thunderbit nagradza szybkość dojścia do pierwszego wyniku kosztem tego, że nigdy nie „zapamiętuje” strony tak, jak robi to receptura.
Moja szczera rada: wybierz jeden realny, autoryzowany cel, z którego faktycznie potrzebujesz danych, i przetestuj oba narzędzia. Zmierz, ile trwa konfiguracja, policz, ile użytecznych wierszy wychodzi czysto, sprawdź, co się stanie, gdy strona coś zmieni (receptury się psują, agenci zwykle się dostosowują) i zsumuj prawdziwy koszt, łącznie z ewentualnymi opłatami za tworzenie własnych receptur.
Jeśli chcesz zobaczyć wersję „jednego kliknięcia” w akcji, rozszerzenie Thunderbit Chrome możesz przetestować za darmo — bez budowania receptur.
FAQ
Czy Data Miner naprawdę działa jednym kliknięciem? Tak, jeśli dla twojej strony docelowej istnieje już działająca publiczna receptura. Jeśli nie, budujesz ją od zera w Recipe Creator, co wymaga realnego czasu na konfigurację.
Czy Data Miner wymaga kodowania? Nie w przypadku podstawowych receptur — Easy Finder pozwala klikać, aby wybierać wiersze i kolumny. Niestandardowy JavaScript i zaawansowana praca z selektorami są opcjonalne dla użytkowników, którzy chcą większej kontroli.
Czy Data Miner potrafi scrapować wiele stron i strony szczegółów? Tak, przez Next Page Automation do stronicowania oraz dwuetapowy workflow Crawl (List Recipe + Detail Recipe) do pobierania danych z powiązanych stron szczegółów.
Czy Thunderbit używa selektorów CSS? Nie. Agent interpretuje strukturę strony w czasie działania, więc na obsługiwanych stronach nie trzeba ręcznie definiować selektorów.
Które narzędzie działa lepiej po zalogowaniu? Oba działają na treści widocznej w autoryzowanej sesji przeglądarki, więc wynik bardziej zależy od tego, co jest wyrenderowane na ekranie, niż od samego narzędzia.
Jak Data Miner liczy strony? Każdy plan przydziela miesięczny limit kredytów stron — 500 w planach Free i Solo, aż do 9 000 w Business Plus. Kredyty resetują się co miesiąc i nie przechodzą na kolejny okres.
Czy któryś z produktów oferuje API? Thunderbit ma Open API, MCP Server i CLI dla workflow programistów i agentów. Automatyzacja Data Minera jest przede wszystkim oparta na przeglądarce, z opcjami serwerowymi dostępnymi dla klientów Enterprise.
Czy którykolwiek scraper działa na każdej stronie? Nie. Oba narzędzia zależą od kompatybilności strony, autoryzacji i struktury witryny — zabezpieczenia antybotowe, nietypowe układy albo ciężki rendering JavaScript mogą ograniczać możliwości każdego z nich.




