
Kilka tygodni temu ktoś z naszego zespołu podesłał mi wątek na GitHubie, w którym programista o 23:00 w piątek debugował już trzecią logikę ponawiania w PlaywrightCrawler. Tuż pod tym inny użytkownik odpisał: „po prostu użyj do tego Thunderbit”, a autor posta odbił: „to nie o to chodzi, potrzebuję tego w moim pipeline”. Obaj mieli rację. W zasadzie cały spór Thunderbit kontra Crawlee mieści się w jednym wątku na GitHubie.
Przez tyle lat żonglowałem między SaaS a narzędziami automatyzującymi pracę (pozdrowienia dla czasów Automation Anywhere), że wiem jedno: pytanie „który scraper jest lepszy” prawie zawsze jest źle postawione. Właściwe pytanie brzmi: kto właściwie robi scraping i czego potrzebuje dalej? Zobaczmy to bliżej.
Prawdziwe pytanie nie brzmi „które narzędzie jest lepsze” — tylko „kto będzie robił scraping?”
Jest coś, co za każdym razem myli ludzi, gdy wpisują w Google „Crawlee vs [cokolwiek]”: oczekują porównania funkcja za funkcję, jakby zestawiali dwa ekspresy do kawy. Ale Crawlee i Thunderbit nie walczą o to samo zastosowanie. Zostały stworzone dla dwóch zupełnie różnych osób stojących przed dwoma zupełnie różnymi problemami.
Crawlee to open-source’owa biblioteka do crawlowania stworzona przez zespół Apify. Zakłada, że jesteś programistą swobodnie poruszającym się w JavaScript, TypeScript albo Pythonie. Instalujesz ją, piszesz handlery żądań, definiujesz selektory i wdrażasz kod. Thunderbit zakłada coś zupełnie innego: że pracujesz w sprzedaży, marketingu albo operacjach i potrzebujesz od razu danych ze strony internetowej — bez najmniejszej ochoty otwierać terminala.
| Czynnik | Crawlee | Thunderbit |
|---|---|---|
| Dla kogo | Programiści tworzący własne crawlery | Użytkownicy nietechniczni, zespoły ops/sales/marketing |
| Wymagane przygotowanie | Instalacja Node.js lub Pythona, napisanie kodu scrapera | Instalacja rozszerzenia do przeglądarki, kliknięcie One Click Extract |
| Wymaga kodowania | Tak (JS/TS lub Python) | Nie |
| Najlepsze zastosowanie | Pipeline’y produkcyjne, logika szyta na miarę | Jednorazowe lub cykliczne pobieranie ustrukturyzowanych danych ze strony |
Mówię o tym na początku, bo większość artykułów porównawczych całkowicie pomija ten pierwszy rozjazd, a to właśnie on decyduje, które narzędzie w ogóle warto brać pod uwagę. Jeśli jesteś programistą i potrzebujesz precyzyjnej kontroli nad retry, proxy i pulami przeglądarek, żadna wygoda „jednym kliknięciem” Cię nie przekona. A jeśli nie jesteś developerem, elastyczność Crawlee i tak nie ma większego znaczenia — po prostu z niego nie skorzystasz.
Czym jest Thunderbit?
Thunderbit to, jak to nazywam, agentowy web scraper — czyli taki, w którym warstwa AI wykonuje pracę interpretacyjną: rozpoznaje, co jest na stronie i co należy wyciągnąć, zamiast wymagać od Ciebie ręcznego pisania selektorów. Główny proces w Thunderbit Chrome Extension wygląda tak: otwierasz stronę, z której chcesz pobrać dane, klikasz One Click Extract, a agent czyta i analizuje stronę, rozpoznaje przydatne pola i przygotowuje wszystko do uruchomienia. Run Now pojawia się jako opcja, jeśli chcesz wystartować od razu, ale nie jest obowiązkowe — jeśli nic nie zrobisz, ekstrakcja uruchomi się automatycznie.

To naprawdę cała konfiguracja. Bez budowania schematu i bez mapowania pól: agent analizuje stronę i od razu uruchamia pobieranie.
Poza rozszerzeniem do przeglądarki Thunderbit ma też Web App, Open API do dostępu programistycznego, MCP Server do użycia przez agentów AI oraz CLI do pracy z terminala. Ten ostatni element ma większe znaczenie, niż się wielu osobom wydaje — wrócę do niego później, bo dzięki niemu to nie jest artykuł typu „no-code zawsze wygrywa”.
Na kompatybilnych stronach Thunderbit potrafi też obsługiwać paginację i wzbogacać dane z podstron, a po zebraniu informacji możesz je wyeksportować do arkuszy kalkulacyjnych lub innych wspieranych miejsc docelowych. Zawsze jednak dodaję tu ten sam zastrzyk ostrożności, co przy każdym haśle „AI czyta stronę”: działa to dobrze na kompatybilnych, autoryzowanych stronach, ale nie oznacza, że każdy framework JavaScript czy każda antybotowa blokada w internecie ugnie się pod Twoją wolą.
Czym jest Crawlee?
Crawlee to open-source’owa biblioteka — nie hostowany produkt — do budowania crawlerów i scraperów w JavaScript/TypeScript lub Pythonie. Jest rozwijana przez Apify i chcę to wyraźnie zaznaczyć, bo wiele osób wrzuca te dwa pojęcia do jednego worka: Crawlee to biblioteka, a Apify to osobna, choć powiązana platforma chmurowa, która może hostować i uruchamiać projekty oparte na Crawlee. To produkty z jednej rodziny, ale nie to samo.
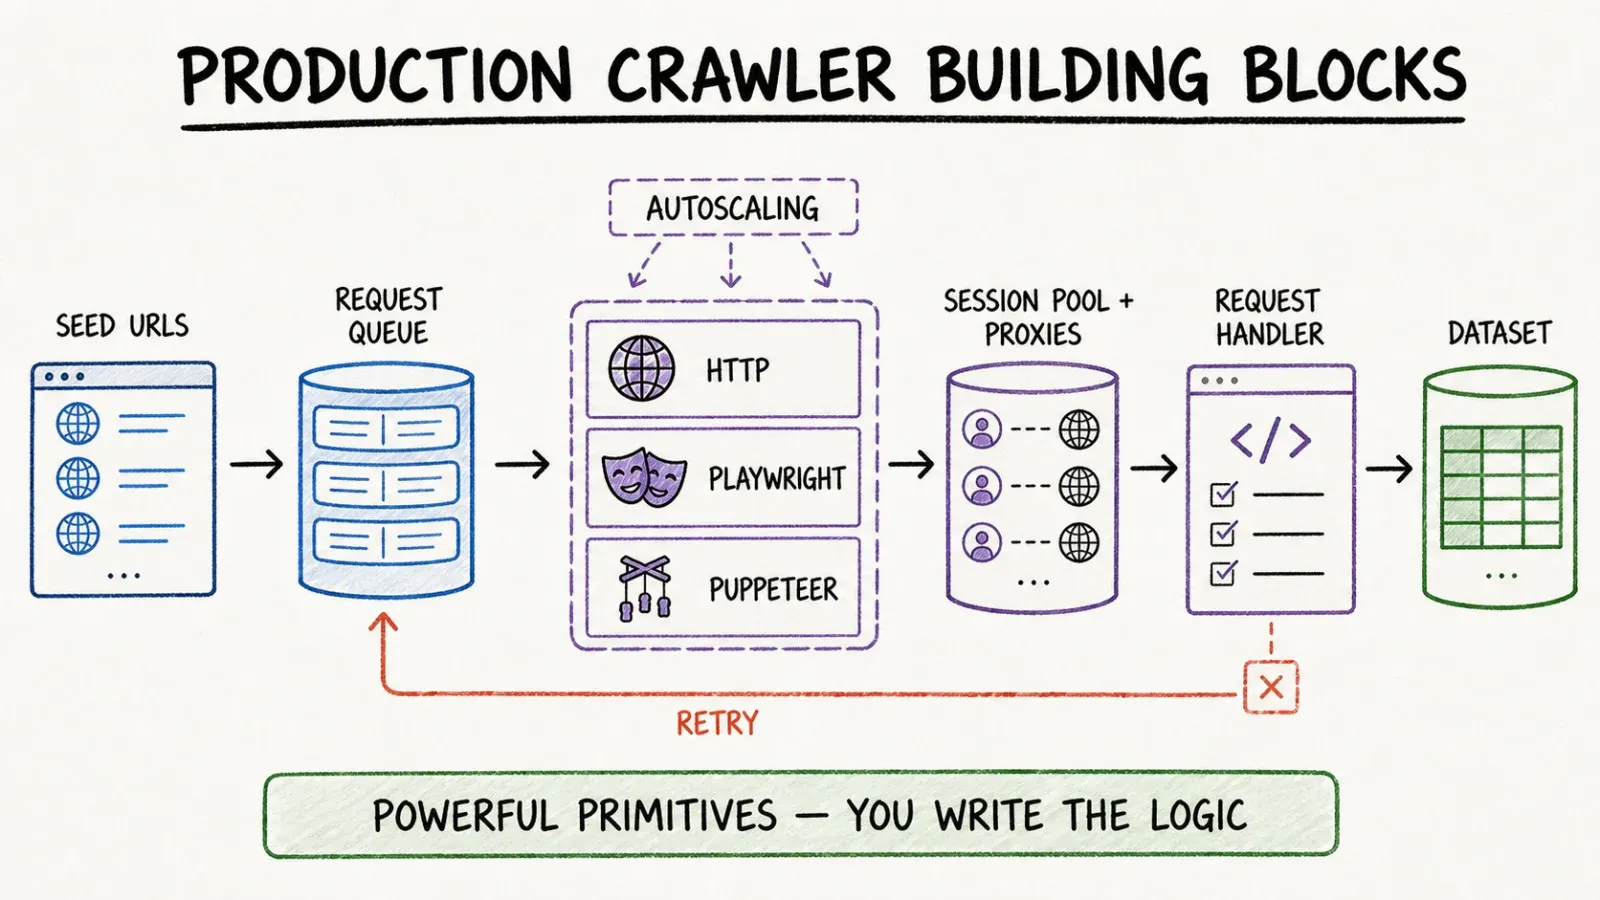
Crawlee daje Ci zestaw narzędzi. Oferuje crawler HTTP do lekkiego scrapingu bez dużego udziału JavaScriptu, a także crawlery przeglądarkowe oparte na Playwright i Puppeteer dla stron wymagających pełnego renderowania. Obsługuje kolejki żądań, więc nie musisz ręcznie pilnować, które adresy już odwiedziłeś. Zarządza też magazynowaniem pobranych danych. Ma wbudowane autoskalowanie i pule sesji, więc jeśli uruchamiasz crawl na tysiącach stron, nie musisz od zera pisać logiki współbieżności.
Ale nic z tego nie dzieje się po kliknięciu przycisku. Piszesz kod — definiujesz handlery żądań, konfigurujesz instancję crawlera, określasz, co ma się wydarzyć po wejściu na stronę. Crawlee daje rusztowanie; dom nadal budujesz sam.
Kluczowa różnica: zarządzany produkt do ekstrakcji vs biblioteka kodu
Czas do pierwszej tabeli z danymi
Tu różnica jest najbardziej widoczna. Z Thunderbit od otwarcia strony do uzyskania użytecznej tabeli danych mija zwykle od kilku sekund do paru minut na kompatybilnej stronie — klik, agent wykrywa pola i uruchamia proces, gotowe.
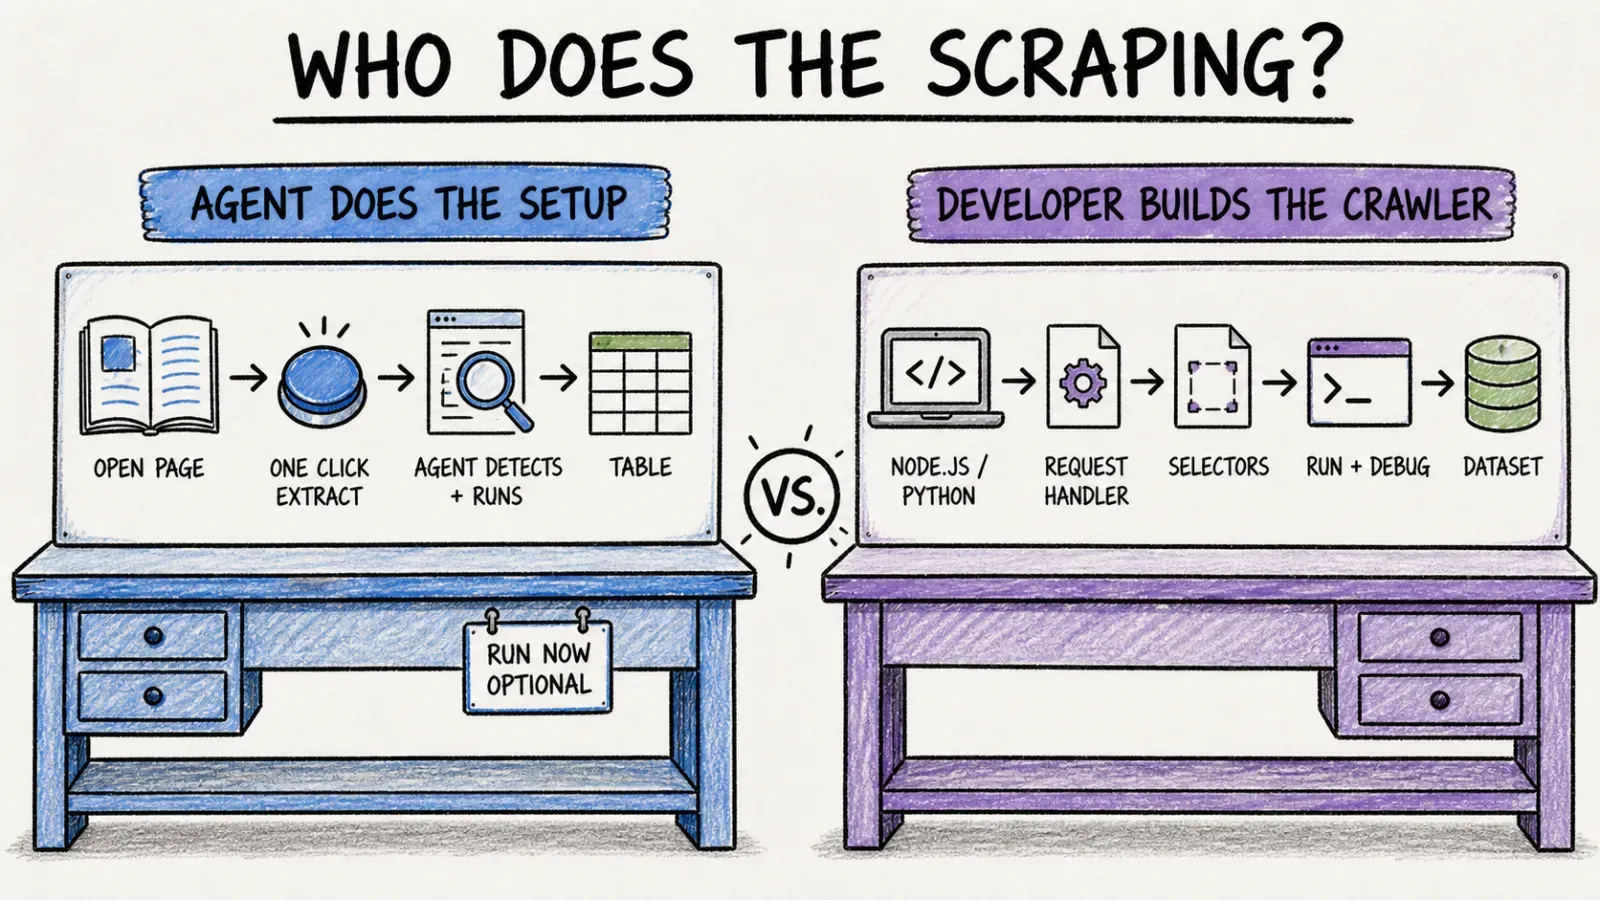
W przypadku Crawlee nawet prosty pierwszy crawler zabierze realny czas na konfigurację. Potrzebujesz zainstalowanego Node.js albo Pythona, dodanego pakietu Crawlee, napisanego request handlera, zidentyfikowanych selektorów (ręcznie, przez inspekcję strony), a potem uruchamiasz wszystko i poprawiasz błędy. Dla osoby zaczynającej od zera szacowałbym 30–60 minut tylko po to, żeby uzyskać jedno działające pobieranie — i to zakładając, że już znasz trochę JavaScript albo Pythona.
Kontrola nad logiką przeglądarki / crawlera
Tutaj Crawlee wygrywa bez dyskusji. Masz kontrolę nad wszystkim: nad silnikiem przeglądarki, sposobem zarządzania sesjami, rotacją proxy, zachowaniem po błędnym żądaniu, głębokością odkrywania linków i limitem współbieżności. Jeśli Twój crawl wymaga niestandardowej logiki — na przykład wieloetapowego logowania albo przechodzenia przez stronę z dziwną paginacją, która łamie standardowe schematy — Crawlee daje Ci wszystkie prymitywy potrzebne do zbudowania dokładnie tego, czego chcesz.
Podejście agentowe Thunderbit oddaje tę szczegółowość w zamian za szybkość i dostępność. Nie piszesz logiki — AI wywnioskuje ją na podstawie tego, co widzi na stronie. To świetne rozwiązanie, gdy działa, i mniej przydatne wtedy, gdy potrzebujesz wymusić bardzo konkretny, nieoczywisty wzorzec ekstrakcji.
Wdrożenie i utrzymanie
W przypadku Crawlee odpowiadasz za wdrożenie. To oznacza, że sam zajmujesz się hostingiem (na własnych serwerach, na platformie Apify albo gdziekolwiek indziej), obsługą zmian w strukturze strony, które psują selektory, oraz aktualizowaniem zależności. To prawdziwa, ciągła praca — ale też realna, stała kontrola.
Thunderbit działa na zarządzanej infrastrukturze — rozszerzenie do przeglądarki wykonuje się lokalnie w Twojej sesji albo w chmurze przy zadaniach zaplanowanych, a logika ekstrakcji jest aktualizowana po stronie Thunderbit, nie po Twojej.
Praktyczne scenariusze
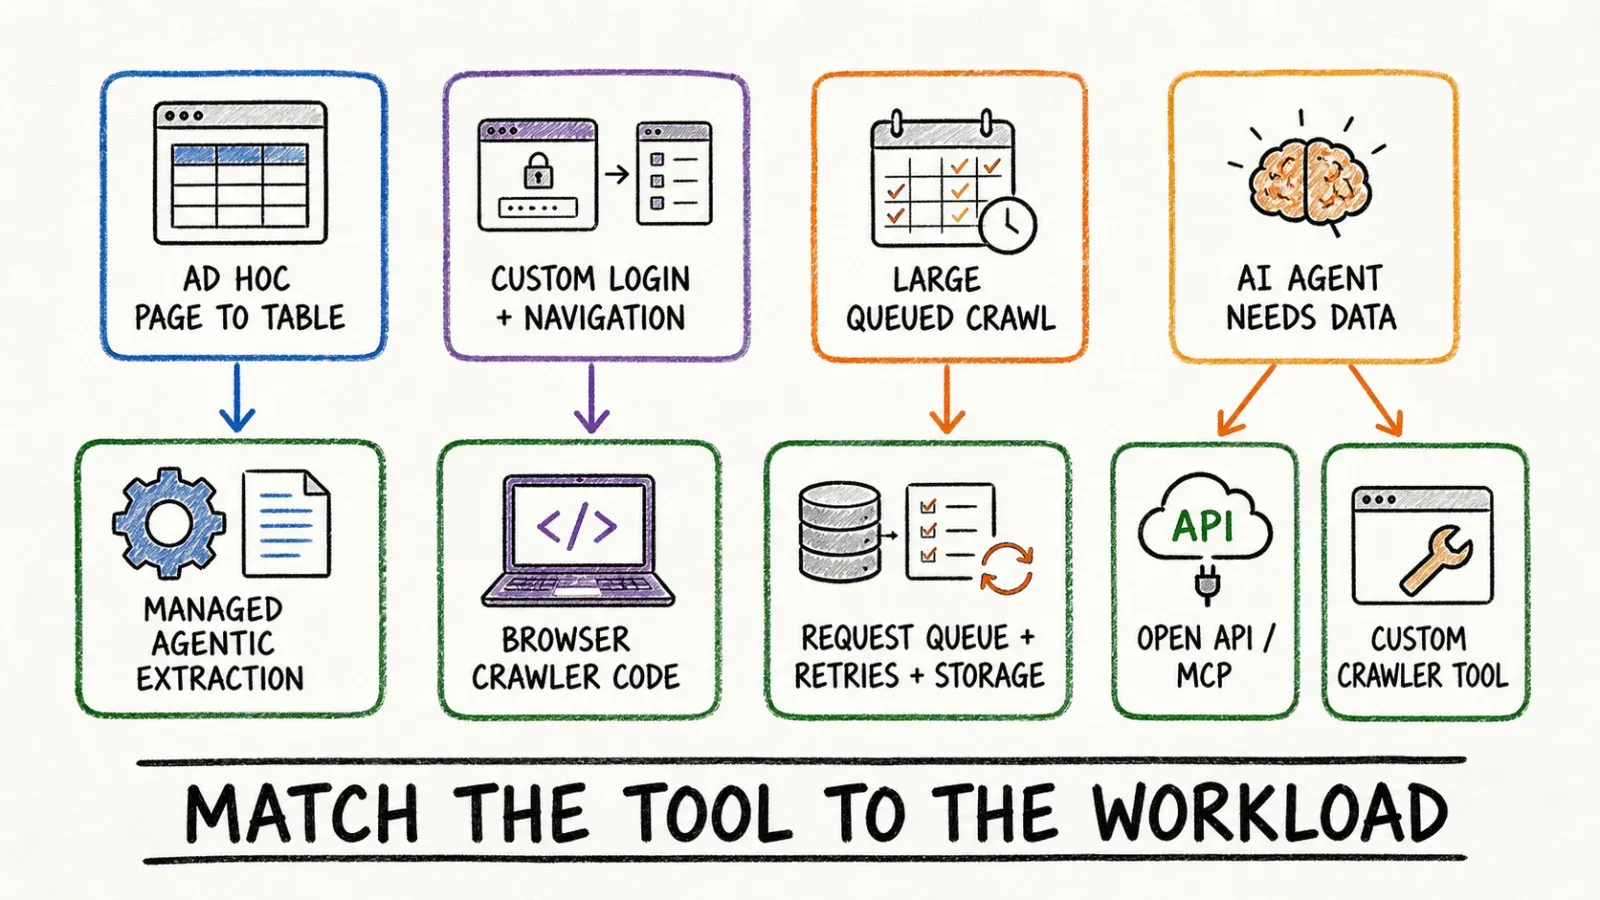
Jednorazowa ekstrakcja jednej strony
Załóżmy, że przed spotkaniem o 14:00 musisz wrzucić listę produktów konkurencji do arkusza. Thunderbit został stworzony dokładnie do takich zadań — otwierasz stronę, klikasz One Click Extract, eksportujesz dane. W Crawlee do jednorazowego zadania byłoby to przerostem formy nad treścią; więcej czasu zajęłoby Ci pisanie skryptu niż zyskałbyś na automatyzacji.
Własny crawl w Playwright/Puppeteer
Teraz wyobraź sobie, że budujesz pipeline monitorujący, który ma logować się do chronionego dashboardu, przechodzić trzy poziomy głęboko i wyciągać dane ze strony renderowanej przez framework JavaScript o nietypowym czasie pojawiania się elementów DOM. To naturalne środowisko Crawlee. PlaywrightCrawler daje Ci narzędzia automatyzacji przeglądarki potrzebne właśnie do takiej niestandardowej nawigacji.
Duży crawl z kolejką, retry i zapisem danych
Jeśli przetwarzasz dziesiątki tysięcy adresów i potrzebujesz automatycznych retry, trwałej kolejki żądań i ustrukturyzowanego zapisu wyników, wbudowana kolejka żądań i abstrakcje datasetów w Crawlee są zaprojektowane dokładnie pod taką skalę. To nie jest typowy przypadek użycia Thunderbit w przeglądarce — to narzędzie do pracy na jednej stronie naraz (albo kompatybilnych podstronach), a nie system zarządzania kolejkami.
Wywoływanie ekstrakcji z agenta AI
To scenariusz, który w takich porównaniach ludzie najczęściej rozumieją nie do końca. Programiści budujący workflowy agentów AI często zakładają, że „agent AI potrzebuje danych” automatycznie oznacza „napisz własny kod w Crawlee i owiń go jako narzędzie”. To jeden z poprawnych kierunków. Ale Thunderbit ma MCP Server właśnie po to, by host AI — Claude, Cursor i podobne kompatybilne klienty — mógł wywołać funkcję ekstrakcji Thunderbit jako narzędzie, bez pisania własnego crawlera. To zupełnie inne wejście niż jednorazowy workflow w przeglądarce i wymaga konfiguracji, a nie tylko „kliknij i gotowe”. Ale też nie jest to ten sam nakład pracy, co budowanie narzędzia na bazie Crawlee od zera.
Dynamiczne strony, skala i niezawodność
Chcę tu być ostrożny, bo to miejsce, w którym marketingowe opisy — także moje, historycznie — lubią obiecywać za dużo. Crawlery przeglądarkowe w Crawlee mogą uruchamiać JavaScript, czekać na dynamiczną treść i wchodzić w interakcję ze stroną tak, jak robiłby to prawdziwy użytkownik — i to jest naprawdę przydatne przy stronach ciężkich od renderowania. Rozszerzenie Thunderbit działa również w prawdziwym kontekście przeglądarki i potrafi pracować ze stronami renderowanymi przez JS, które masz otwarte.
Ale żadne z tych narzędzi nie gwarantuje sukcesu wszędzie. Crawlee daje programistom narzędzia do samodzielnej konfiguracji rotacji proxy i pul sesji — to ręczna, konfigurowalna kontrola, a nie automatyczne obejście blokad. Thunderbit stosuje zarządzane renderowanie i obsługę antybotową na wspieranych, autoryzowanych stronach, co również nie jest uniwersalnym „działa na wszystkim”. Jeśli gdziekolwiek czytasz porównanie, które obiecuje 100% skuteczności wobec każdego systemu antybotowego w internecie, to takie porównanie po prostu Cię okłamuje.
Cena, licencja i całkowity koszt
Samo Crawlee jest darmowe i open-source — wersja Python, na przykład, działa na licencji Apache 2.0. Ale „darmowe” nie znaczy „bez kosztów”. Płacisz czasem programistów za napisanie i utrzymanie crawlerów, kosztami hostingu (na własnych serwerach albo na platformie Apify, która jest osobnym płatnym produktem od samej biblioteki) oraz opłatami za proxy, jeśli docelowe strony wymagają rotacji IP, by uniknąć blokad.
Thunderbit działa w modelu subskrypcyjnym / planowym, z rozliczaniem opartym na kredytach — najlepiej odesłać do strony Thunderbit Pricing, bo stawki się zmieniają i nie chcę podawać liczby, która mogłaby się zdezaktualizować zanim to przeczytasz.
Uczciwe porównanie utrzymania: crawlery w Crawlee psują się, gdy strona docelowa zmienia strukturę HTML, bo selektory zostały napisane pod konkretny układ DOM. Ktoś musi zauważyć awarię i poprawić kod. Agentowa ekstrakcja Thunderbit ponownie analizuje stronę przy każdym uruchomieniu, co zmniejsza — ale nie eliminuje — tego typu awarie; duża przebudowa layoutu nadal może namieszać, ale nie utrzymujesz sztywnych selektorów w ten sam sposób.
Kto powinien wybrać Thunderbit?
Jeśli nie jesteś programistą i potrzebujesz danych ze stron — do list leadów, cen konkurencji, researchu rynkowego czy czegokolwiek podobnego — Thunderbit został stworzony dokładnie dla Ciebie. To samo dotyczy sytuacji, gdy jesteś developerem i chcesz oddać samoobsługowe narzędzie do ekstrakcji nietechnicznemu zespołowi, albo gdy potrzebujesz dostępu programistycznego przez Open API bez budowania pełnego crawlera od zera.
Kto powinien wybrać Crawlee?
Jeśli budujesz produkcyjny pipeline danych, który wymaga własnej logiki nawigacji, precyzyjnej kontroli nad retry i proxy oraz chcesz mieć pełną własność kodu źródłowego, Crawlee będzie właściwym fundamentem. To także lepszy wybór, jeśli crawl ma działać na naprawdę dużą skalę — dziesiątki tysięcy stron z zarządzaniem kolejką żądań — bo taki problem nie jest tym, do czego zaprojektowano workflow oparty na rozszerzeniu przeglądarki.
Czy zespoły mogą używać obu narzędzi?
W praktyce tak — i nie uważam, że to unik. Widziałem ten model w wielu firmach, z którymi współpracowałem: dział inżynierii utrzymuje pipeline oparty na Crawlee do powtarzalnych, masowych zadań crawlujących, które zasilają hurtownię danych, a zespoły sales, marketingu czy ops korzystają z rozszerzenia Thunderbit albo Web App do ad hoc’owych zadań typu „potrzebuję danych z tej jednej strony już teraz”, które w innym wypadku trafiłyby jako ticket do backlogu engineeringu. Nie ma żadnej oficjalnej integracji łączącej te dwa światy — nie będę jej wymyślał — ale architektonicznie rozwiązują sąsiednie problemy na tyle dobrze, że wiele zespołów kończy z oboma narzędziami.
Werdykt
Jeśli jesteś programistą i tworzysz coś, co ma żyć w codebase, skalować się do tysięcy stron albo obsługiwać naprawdę niestandardową logikę nawigacji, Crawlee daje Ci kontrolę potrzebną do takiej pracy — kosztem Twojego czasu i stałego utrzymania. Jeśli jesteś kimś innym i potrzebujesz danych ze strony bez pisania kodu, albo jesteś developerem, który chce wystawić ekstrakcję jako narzędzie dla agenta AI bez budowania crawlera od zera, Thunderbit będzie szybszą drogą. Żadne z tych narzędzi nie jest „lepsze” w oderwaniu od kontekstu. Rozwiązują różne problemy dla różnych ludzi, a jedyny błąd, którego naprawdę warto unikać, to wybranie niewłaściwego narzędzia do własnego przypadku.
FAQ
Czy Crawlee to to samo co Apify? Nie. Crawlee to open-source’owa biblioteka do crawlowania utrzymywana przez zespół Apify. Apify to osobna platforma chmurowa, która może hostować i uruchamiać projekty oparte na Crawlee, a także oferuje inne usługi, takie jak proxy i planowanie zadań. To powiązane, ale odrębne produkty z różnymi modelami cenowymi.
Czy Crawlee jest darmowe? Sama biblioteka jest darmowa i open-source (wersja Python korzysta z licencji Apache 2.0). Realne koszty wynikają z czasu pracy programistów, infrastruktury hostingowej i ewentualnych usług proxy, których potrzebujesz — nie z opłaty licencyjnej.
Czy Thunderbit oferuje dostęp przez API i MCP dla programistów? Tak. Poza rozszerzeniem do przeglądarki Thunderbit oferuje Open API do dostępu programistycznego oraz MCP Server, który pozwala zgodnym hostom AI wywoływać narzędzia ekstrakcji Thunderbit bezpośrednio.
Co jest łatwiejsze dla osoby bez doświadczenia w kodowaniu? Thunderbit, bez wahania. Flow One Click Extract w rozszerzeniu do przeglądarki nie wymaga kodu, pisania selektorów ani przygotowywania schematu. Crawlee od początku zakłada znajomość JavaScript/TypeScript albo Pythona.
Które narzędzie daje większą kontrolę nad zachowaniem crawlera, np. retry i proxy? Crawlee, i to zdecydowanie. Ujawnia pule sesji, rotację proxy, zarządzanie kolejką żądań i logikę ponawiania jako konfigurowalne elementy dla programistów. Thunderbit zarządza tym po swojej stronie, oddając tę ręczną kontrolę w zamian za prostotę i szybkość.




