
Przerobiłem już wystarczająco dużo wątków na Slacku w zespołach inżynieryjnych, żeby dobrze wiedzieć, jak zwykle zaczyna się takie pytanie: ktoś wrzuca link do listy „najlepszych web scraperów”, a trzech inżynierów od razu odpisuje: „żaden z nich nie wspomina o Colly”. To nie jest przypadek. Przejrzałem cztery artykuły, które dziś rankują na frazę „Thunderbit vs Colly”, i każdy z nich porównuje Thunderbit z innymi narzędziami no-code — Crawl4AI, Browse AI, rtrvr.ai, Chat4Data. Colly nie pojawia się ani razu.
To trochę zaskakujące, bo Colly ma bardzo konkretną, lojalną społeczność na r/golang i w firmach pracujących w Go, które potrzebują szybkich crawlerów budowanych i utrzymywanych we własnym kodzie. Właśnie dlatego ten artykuł naprawdę odpowiada na pytanie, zamiast być tylko odmalowaną „porównywarką narzędzi AI” z dopisanym na siłę Colly.
Krótka odpowiedź
Jeśli chcesz wersji w pigułce, to wygląda to tak: Thunderbit to zarządzany, agentowy web scraper, który uruchamiasz jednym kliknięciem — bez selektorów, bez kodu, z wykonywaniem w przeglądarce lub w chmurze, a do tego z Web App, Open API, MCP Server i CLI dla programistów, którzy chcą dostępu programowego. Colly to otwartoźródłowy framework w Go — to Ty piszesz crawler, to Ty odpowiadasz za logikę i to Ty stroisz współbieżność.
To w praktyce nie są klasyczni konkurenci. Jedno jest produktem. Drugie jest biblioteką. Bezpośrednie porównanie ma sens tylko wtedy, gdy stoisz na rozdrożu i zastanawiasz się, która droga lepiej pasuje do Twojej sytuacji — a właśnie w tym chcę Ci pomóc.
Na pierwszy rzut oka
| Wymiar | Thunderbit | Colly |
|---|---|---|
| Główny użytkownik | Użytkownicy biznesowi, zespoły operacyjne, programiści ceniący szybkość | Programiści Go |
| Konfiguracja | Klikasz One Click Extract na stronie | go get github.com/gocolly/colly + piszesz kod w Go |
| Czas do pierwszego wyniku | Sekundy do minut, agent uruchamia się automatycznie | Zależy od tego, jak szybko napiszesz callbacki |
| Język | Nie jest wymagany do korzystania w przeglądarce | Go |
| Model crawlingu | Agentowa analiza strony, obsługa paginacji/podstron | Ręczne callbacki Collector + OnHTML/OnResponse |
| Renderowanie | Zarządzane wykonanie w przeglądarce/chmurze | Głównie HTTP/HTML; strony mocno oparte na JS wymagają dodatkowych narzędzi |
| Reguły ekstrakcji | Agent proponuje pola, użytkownik może je doprecyzować | Programista ręcznie pisze selektory CSS |
| Współbieżność | Zarządzana przez platformę | Pełna ręczna kontrola przez goroutines |
| Przechowywanie/eksport | Eksport do arkuszy, spreadsheetów i innych obsługiwanych miejsc | Tworzone przez programistę (pliki, bazy danych, Redis itd.) |
| Wdrożenie | Rozszerzenie przeglądarki, Web App, API, MCP, CLI | Samodzielnie hostowany binarny plik/skrypt Go |
| Utrzymanie | Zarządzana logika ekstrakcji; nadal zależna od zgodności strony | Programista poprawia selektory, gdy strona się zmieni |
| Licencja/koszt | Plany oparte na kredytach (sprawdź aktualne poziomy na pricing) | Apache-2.0, darmowe — ale infrastruktura i czas devów już nie |
Czym jest Thunderbit?
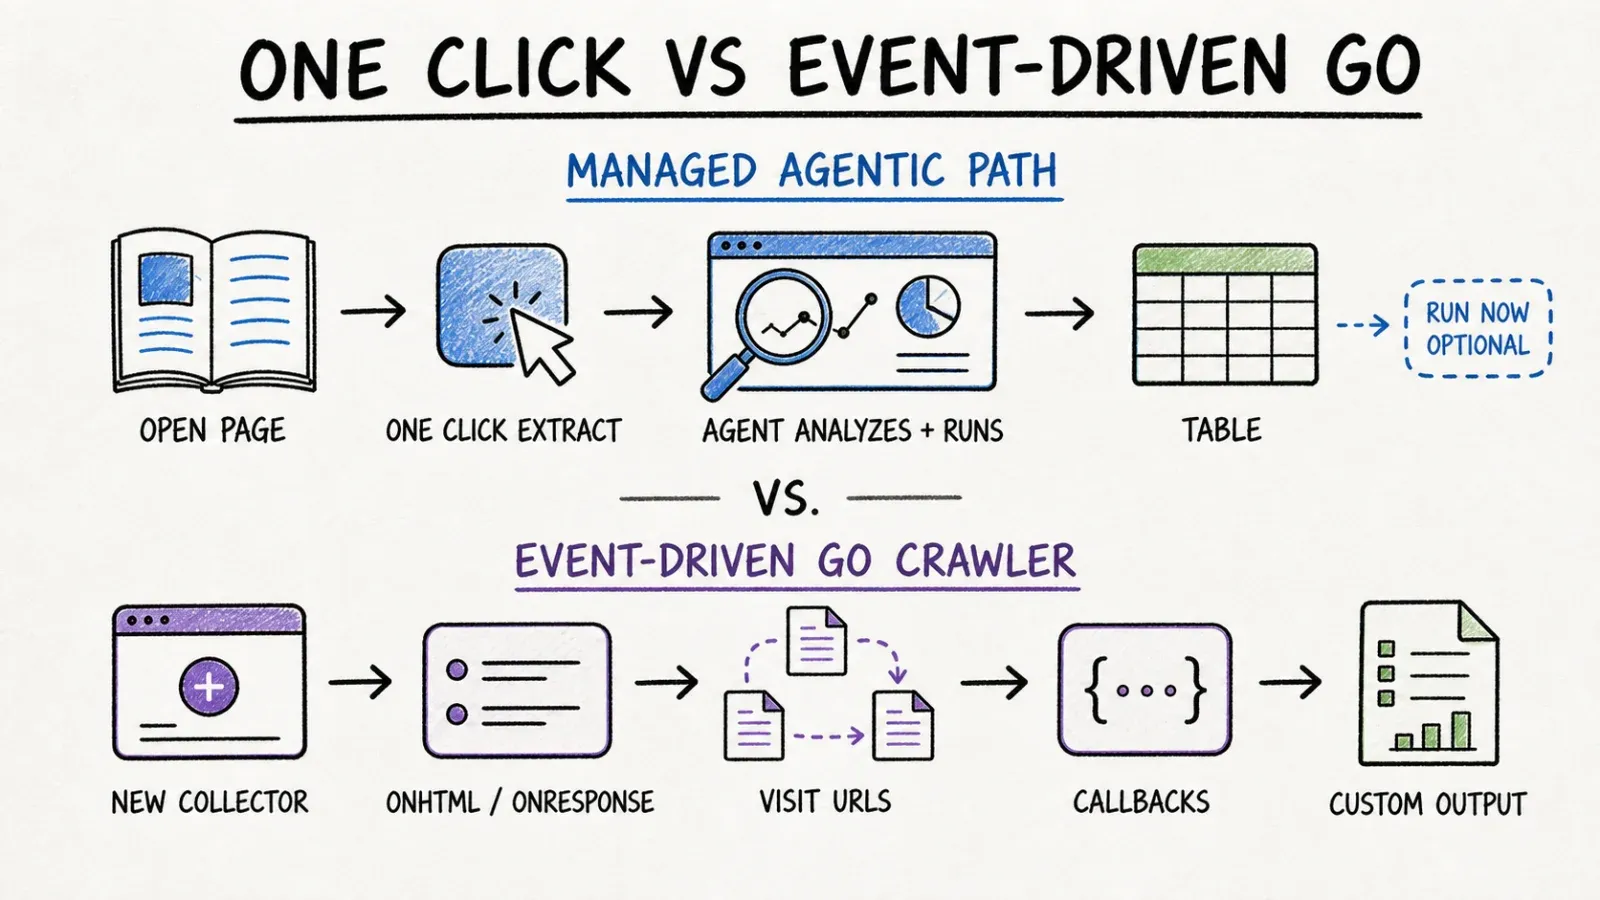
Domyślny workflow Thunderbit naprawdę opiera się na jednym kliknięciu. Otwierasz stronę, do której masz uprawniony dostęp, klikasz One Click Extract, a agent czyta stronę, rozpoznaje, co warto pobrać, i proponuje pola. Jest przycisk Run Now, ale szczerze mówiąc służy głównie dla spokoju ducha — jeśli niczego nie ruszysz, ekstrakcja i tak startuje sama. Bez pisania selektorów, bez konfiguracji schematu — na stronach, które agent obsługuje.
Stamtąd możesz dopracować pola, jeśli agent nie trafił idealnie, a na zgodnych stronach przejdzie też przez paginację albo zajrzy do podstron w celu wzbogacenia danych — na przykład pobierze dodatkowe szczegóły z każdej strony produktu z listy. Gdy masz już dane, eksportujesz je do standardowych miejsc: Excel, Google Sheets i kilku innych obsługiwanych destination.

Ale rozszerzenie przeglądarki to dopiero wejście główne. Jeśli jesteś programistą, masz Open API do uruchamiania ekstrakcji z własnego kodu, MCP Server, który pozwala podpiąć ekstrakcję jako wywoływane narzędzie do Claude, Cursor czy Windsurf, oraz CLI do pracy w terminalu i w agentowych workflow programistycznych. Wspominam o tym, bo wiele porównań „no-code vs code” traktuje Thunderbit jak wyłącznie zabawkę dla biznesu — a to po prostu już nie jest prawda.
Czym jest Colly?
Colly to biblioteka w Go — kropka. Nie ma dashboardu, nie ma hostowanej usługi, nie ma warstwy AI, która decyduje, co scrapować. Piszesz w Go, tworzysz Collector i podpinasz callbacki takie jak OnHTML i OnResponse, żeby dokładnie określić, co ma się stać po wejściu na stronę.
Mniej więcej tak to wygląda:
c := colly.NewCollector()

c.OnHTML("a[href]", func(e *colly.HTMLElement) {
    link := e.Attr("href")
    c.Visit(e.Request.AbsoluteURL(link))
})

c.OnResponse(func(r *colly.Response) {
    fmt.Println("Visited", r.Request.URL)
})

c.Visit("https://example.com")
To cały model mentalny: definiujesz, czego szukać, definiujesz, co zrobić po znalezieniu, a kolektor robi crawl. Pod spodem dostajesz synchronous, asynchronous, and parallel crawling, limitowanie ruchu per domena, automatyczną obsługę cookies i sesji, cache requestów, respektowanie robots.txt, rotację proxy oraz wymienne backendy storage, w tym Redis dla wdrożeń rozproszonych.
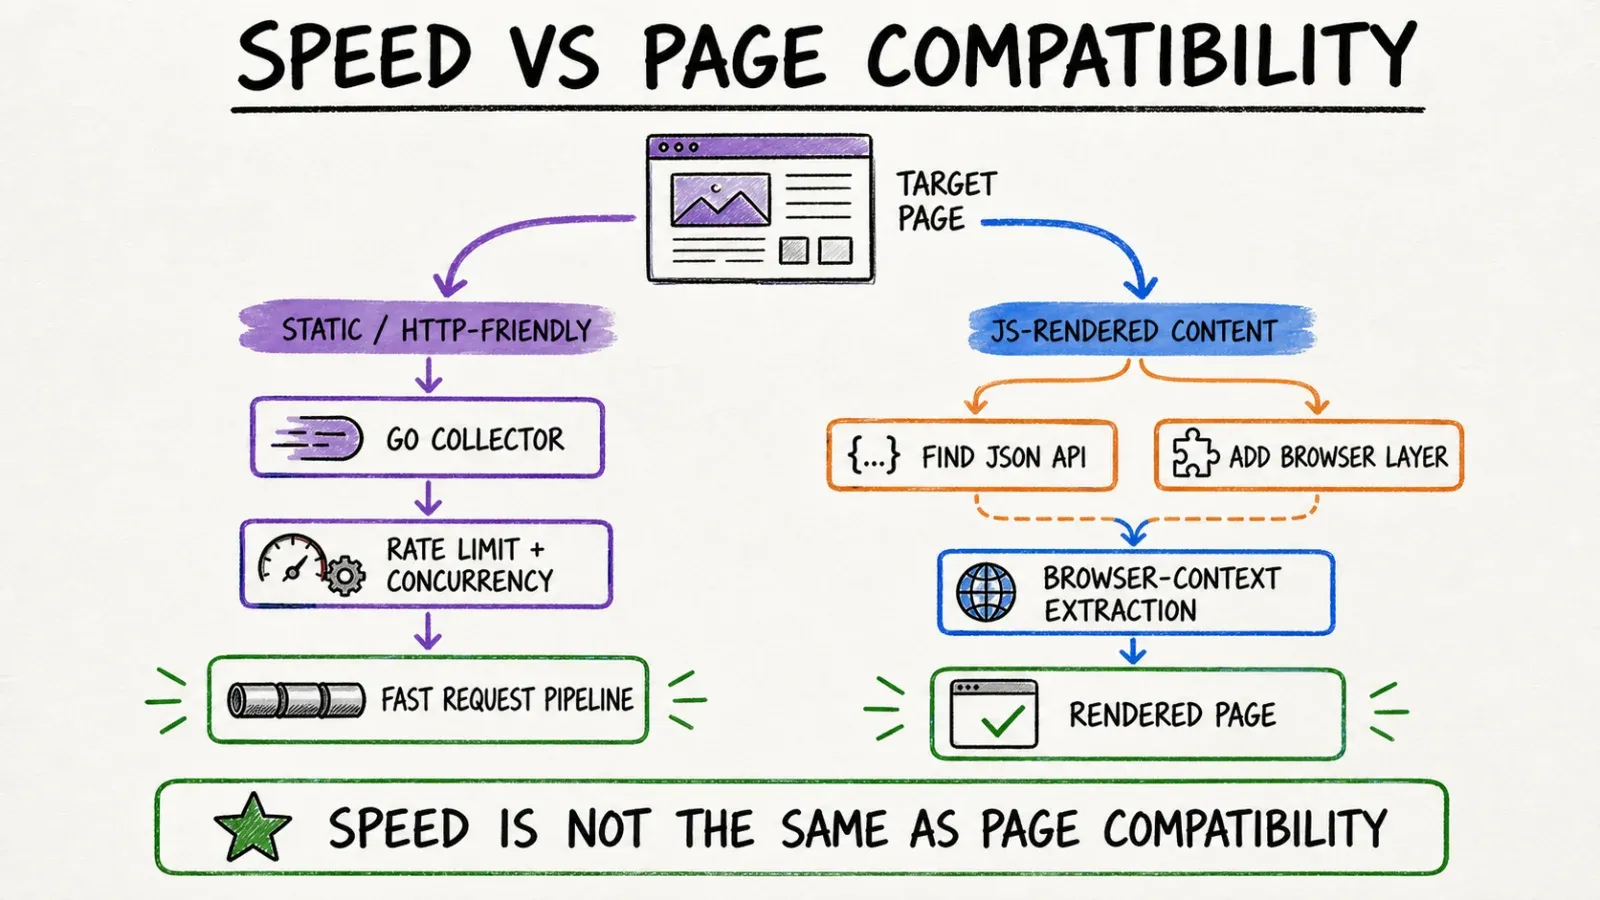
Jedna ważna rzecz, o której warto powiedzieć wprost: Colly to przede wszystkim framework HTTP/HTML. Nie uruchamia pełnej przeglądarki tak jak Playwright. Jeśli Twoja strona mocno opiera się na renderowaniu JavaScript, to albo szukasz ukrytego JSON API, z którego korzysta, albo łączysz Colly z osobnym narzędziem do automatyzacji przeglądarki. To nie jest wada Colly — po prostu inna filozofia projektowania niż w pełni agentowy, „browser-aware” produkt.
Kluczowa różnica: zarządzana ekstrakcja agentowa vs framework w Go
Czas do pierwszej tabeli
To tutaj różnica jest najbardziej odczuwalna. W Thunderbit „czas do pierwszego wyniku” liczy się w czasie potrzebnym na kliknięcie przycisku i poczekanie, aż agent skończy czytać stronę — od kilku sekund do paru minut, zależnie od złożoności strony. W Colly „czas do pierwszego wyniku” obejmuje napisanie collectora, znalezienie właściwych selektorów (co zwykle oznacza trochę prób i błędów w narzędziach deweloperskich), samodzielne ogarnięcie logiki paginacji i dopiero uruchomienie całości. Przy jednorazowym zadaniu to realny koszt czasu, nawet dla dobrego programisty Go.
Wydajność i kontrola
Colly wygrywa pod względem surowej kontroli, bez dwóch zdań. Ponieważ to Ty piszesz logikę, sam decydujesz, ile goroutines działa równolegle, jak agresywne ma być limitowanie, co ma być cache’owane i jak ponawiać błędy. W dokumentacji projektu pojawia się informacja o ponad 1,000 requests per second na jednym rdzeniu dla odpowiednich statycznych celów — to deklaracja benchmarkowa Colly, a nie kontrolowane porównanie z Thunderbit, i nie będę udawał, że jest inaczej. Mówi to jednak coś ważnego: przy targetach przyjaznych HTTP, ręcznie dopieszczona współbieżność w Go będzie bardzo trudna do pobicia.
Thunderbit wymienia tę granularną kontrolę na zarządzane wykonanie. Nie stroisz pul goroutines — polegasz na przeglądarce i ścieżkach wykonania w chmurze oferowanych przez platformę, a także na harmonogramie ekstrakcji, jeśli Twój plan to obsługuje. To dobry kompromis, jeśli nie chcesz podejmować decyzji infrastrukturalnych, i zły, jeśli Twoja praca polega właśnie na wyciskaniu maksimum przepustowości z crawlera.
Wdrożenie i odpowiedzialność za utrzymanie
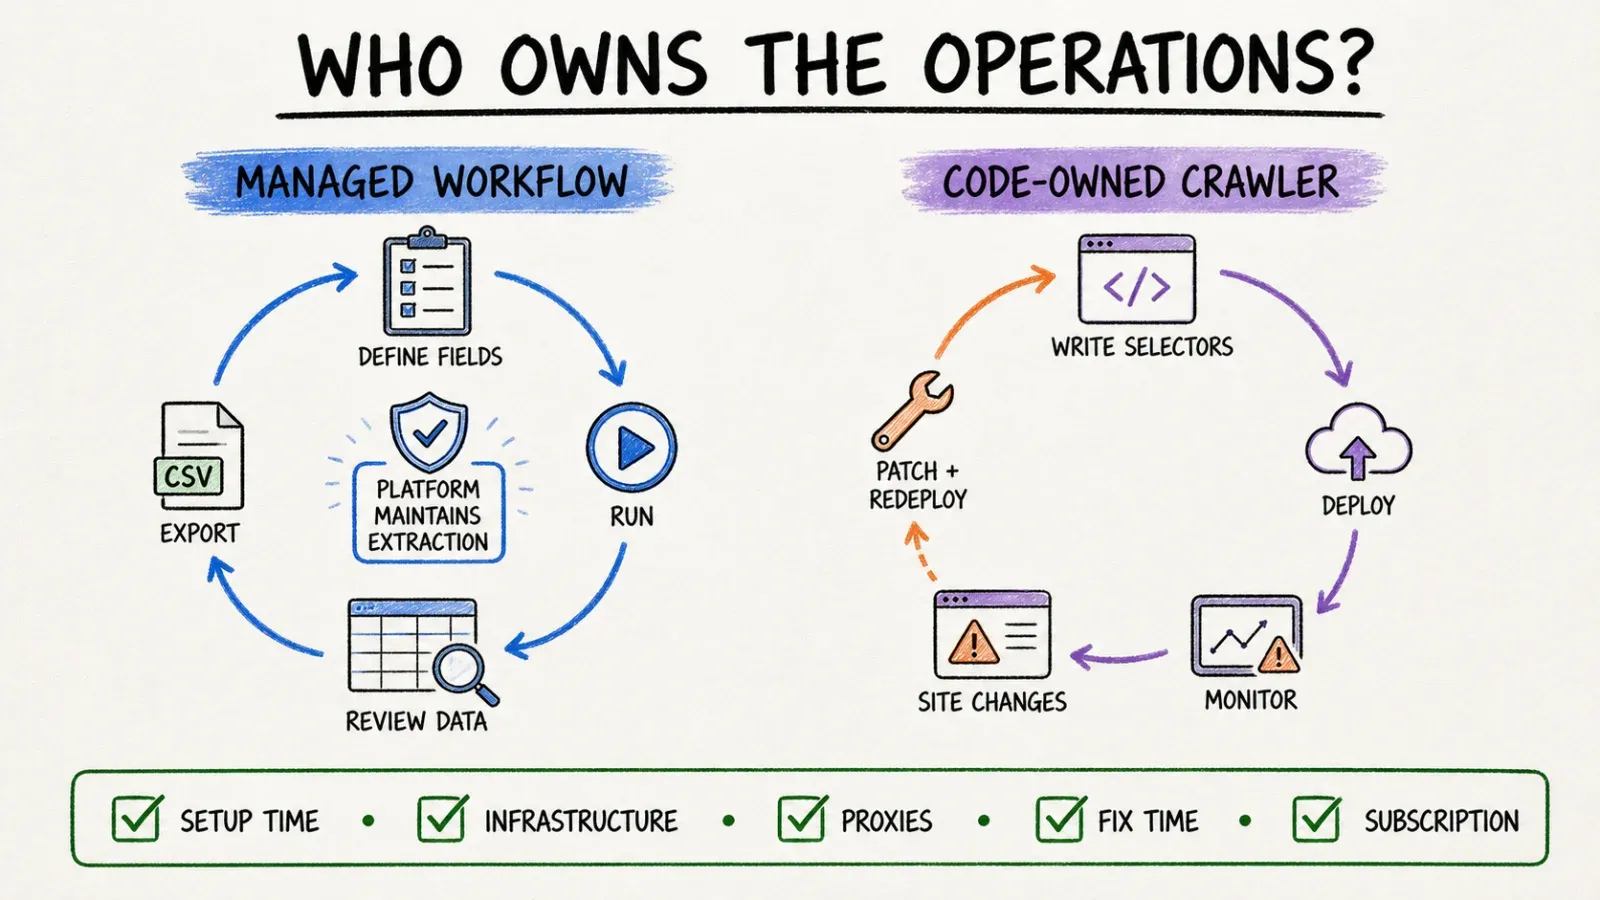
To jest część, o której mówi się za mało. Colly jest „darmowe” w tym sensie, że licencja Apache-2.0 nic nie kosztuje. Ale ktoś nadal musi to napisać, hostować, monitorować i — co najważniejsze — naprawiać, kiedy docelowa strona zmieni HTML. Selektory psują się po cichu. Nikt nie dostaje alertu: „hej, ta strona przeprojektowała kartę produktu”. Programista musi zauważyć, że pipeline przestał działać albo zwraca śmieci, a potem go poprawić.
W Thunderbit logika ekstrakcji jest zarządzana przez platformę, a jej agentowa analiza strony została zaprojektowana tak, by dostosowywać się do różnic w układzie na obsługiwanych, uprawnionych stronach. Chcę tu jednak uważać — to nie jest żadna gwarancja absolutna. Strony z mocną ochroną antybotową, treści za logowaniem poza zakresem autoryzacji czy witryny, z którymi agent po prostu nie radzi sobie dobrze, to realne ograniczenia. Uczciwe podsumowanie brzmi: w Colly poprawka zawsze spoczywa na Tobie. W Thunderbit ciężar jest mniejszy, ale „mniejszy” nie znaczy „zerowy” — powodzenie nadal zależy od tego, czy dana strona jest dobrze obsługiwana przez Thunderbit.
Scenariusze z praktyki
Jednorazowa ekstrakcja katalogu / produktów
Załóżmy, że do końca dnia potrzebujesz tabeli 200 produktów z katalogu konkurenta, a nie jesteś programistą (albo jesteś, ale masz ważniejsze rzeczy do roboty). To naturalny teren Thunderbit — klikasz, agent proponuje pola, dopracowujesz, jeśli trzeba, eksportujesz do Sheets. Napisanie skryptu w Colly do jednorazowej ekstrakcji jest technicznie możliwe, ale przypomina używanie piły łańcuchowej do przycinania bonsai.
Wysokoprzepustowy, własny crawler w Go
Teraz odwróćmy sytuację: budujesz pipeline monitorujący, który uderza w tysiące URL-i dziennie, masz już stack w Go i potrzebujesz dokładnej kontroli nad retry logic, rozproszonym storage przez Redis oraz limitami per domena, ustawionymi tak, by nie dać się zablokować. To jest dokładnie domena Colly. Nie płacisz subskrypcji, jesteś właścicielem każdej linijki logiki i możesz optymalizować pod własny wzorzec ruchu w sposób, którego zarządzany produkt zwykle nie wystawia na wierzch.
Cel mocno zależny od JavaScript
Jeśli Twoja strona renderuje wszystko po stronie klienta i mocno opiera się na JS, samo Colly prawdopodobnie nie wystarczy — będziesz szukać ukrytego JSON API albo dołożysz warstwę automatyzacji przeglądarki. Thunderbit, dzięki zarządzanym ścieżkom wykonania w przeglądarce i chmurze, jest projektowany z myślą o takich stronach, ale — znowu — warto przetestować zgodność na konkretnym celu, zanim założysz, że po prostu zadziała.
Integracja z API lub agentem AI
Budujesz narzędzie wewnętrzne, w którym agent AI (na przykład działający w Claude albo Cursor) musi pobrać ustrukturyzowane dane jako część większego workflow? Właśnie tutaj MCP Server Thunderbit staje się naprawdę użyteczny — udostępnia ekstrakcję jako wywoływalne narzędzie w workflow agentów, czego Colly po prostu natywnie nie oferuje, bo jest samodzielną biblioteką, a nie czymś, co agent AI może od razu wywołać jak tool.
Niezawodność, skala i utrzymanie
Chcę rozdzielić dwie rzeczy, które często się ze sobą myli: surową przepustowość i całkowity współczynnik sukcesu na prawdziwych stronach. Colly potrafi działać szybko na statycznych, przyjaznych HTTP stronach — dokładnie do tego został stworzony. Ale „szybko” nie oznacza automatycznie „będzie działać za trzy miesiące”, kiedy strona docelowa dostanie redesign. Każdy napisany przez Ciebie selektor staje się wtedy potencjalnie nieaktualny, a nikt Cię nie ostrzeże, dopóki pipeline nie zacznie po cichu zwracać nulli.
Podejście agentowe Thunderbit oznacza, że nie utrzymujesz selektorów samodzielnie — ale nie zgodziłbym się z żadnym przekazem (w tym, szczerze mówiąc, z niektórymi materiałami marketingowymi Thunderbit), który sugerowałby uniwersalną niezawodność na każdej stronie, zwłaszcza tych z agresywną ochroną antybotową albo treściami za autoryzacją, do których nie masz prawa dostępu. Jeśli oceniasz któreś z tych narzędzi, prawdziwe pytanie brzmi: „kto to naprawia, gdy przestaje działać, i ile to trwa” — a nie tylko „jak szybko działa pierwszego dnia”.
Cena, licencja i całkowity koszt
Colly jest open-source na licencji Apache 2.0 — sama biblioteka jest darmowa. Ale całkowity koszt posiadania obejmuje godziny deweloperów na napisanie i debugowanie crawlera, koszty obliczeń do jego uruchamiania, wydatki na proxy, jeśli potrzebujesz rotacji IP, oraz ciągły czas poświęcany na naprawy, gdy docelowa strona zmieni się i popsuje selektory. Dla zespołu biegle pracującego w Go może to być naprawdę tanie w skali. Dla zespołu bez takich kompetencji „darmowe” szybko zamienia się w „drogo w ukryty sposób”.
Thunderbit działa w modelu opartym na kredytach — sprawdź aktualną stronę cen, bo poziomy planów i limity kredytów zmieniają się dość często, a wolę odesłać Cię do źródła niż podać liczbę, która będzie nieaktualna, zanim skończysz czytać. Kompromis polega na tym, że płacisz za mniejszy nakład ręcznego utrzymania na obsługiwanych stronach, a nie za brak utrzymania wszędzie.
Jeśli chcesz uczciwego modelu myślenia, zrób prostą tabelę dla własnej sytuacji: czas konfiguracji, koszt infrastruktury/proxy, czas potrzebny na poprawki i koszt subskrypcji. Którakolwiek strona wygra w tej tabeli przy realnych umiejętnościach i obciążeniu Twojego zespołu — to jest odpowiedź, a nie ogólne „open source jest tańsze”.
Kto powinien wybrać Thunderbit?
Jeśli jesteś użytkownikiem biznesowym, osobą z operacji albo członkiem zespołu growth i potrzebujesz danych strukturalnych już teraz, bez dotykania kodu, rozszerzenie Thunderbit będzie oczywistym wyborem. Jeśli jesteś programistą, który chce traktować ekstrakcję jako komponent budulcowy — przez API, CLI albo wewnątrz workflow agenta AI przez MCP — Thunderbit też pasuje, tylko wchodzi się do niego innymi drzwiami niż przez kliknięcie i uruchomienie.
Kto powinien wybrać Colly?
Jeśli jesteś programistą Go (albo Twój zespół jest przede wszystkim Go-first) i potrzebujesz własnego crawlera o dużej przepustowości, gdzie kontrolujesz każdy request, każdy retry i każdą rotację proxy — Colly został stworzony dokładnie do takiego zadania. To także dobry wybór, jeśli chcesz mieć pełną własność kodu bez zależności od subskrypcji i masz zasoby inżynierskie, żeby to utrzymywać.
Czy zespoły mogą używać obu narzędzi?
Szczerze? Tak, i nie uważam tego za wymijającą odpowiedź. Bardzo często zespół inżynieryjny utrzymuje odporny, skalowalny crawler Colly dla kluczowego pipeline’u danych, podczas gdy inne zespoły — sprzedaż, operacje, marketing — korzystają z Thunderbit do ad hoc ekstrakcji, która nie uzasadnia pisania i utrzymywania skryptu. Nie będę tu wymyślał jakiejś fikcyjnej „oficjalnej integracji” między tymi narzędziami — o ile wiem, nie ma takiej — ale architektonicznie nic nie stoi na przeszkodzie, by oba działały w tej samej organizacji i rozwiązywały różne problemy.
Werdykt
Wybierz narzędzie zgodnie z tym, kto wykonuje pracę i co jest celem optymalizacji. Jeśli masz umiejętności w Go, potrzebujesz własnej logiki i chcesz w zamian za pełną kontrolę oraz brak kosztu subskrypcji samodzielnie odpowiadać za utrzymanie — Colly jest właściwym wyborem. Jeśli chcesz szybko dostać dane, nie chcesz pisać ani utrzymywać kodu i jesteś gotów oddać część kontroli niskopoziomowej w zamian za zarządzane doświadczenie — także z możliwością podpięcia ekstrakcji do API albo agenta AI — lepiej sprawdzi się Thunderbit. Żadne z nich nie jest „lepsze” w oderwaniu od kontekstu; oba są stworzone dla różnych ludzi rozwiązujących różne problemy.
FAQ
Czy Colly jest darmowe? Tak — Colly jest open-source na licencji Apache 2.0, więc sama biblioteka nic nie kosztuje. Rzeczywiste koszty wynikają z czasu programistów, hostingu, proxy, jeśli są potrzebne, oraz bieżącego utrzymania, gdy strony docelowe się zmieniają.
Czy Colly renderuje JavaScript? Nie natywnie. Colly to przede wszystkim framework HTTP/HTML, więc strony mocno oparte na JavaScript zwykle wymagają znalezienia ukrytego JSON API, z którego korzystają, albo połączenia Colly z osobnym narzędziem do automatyzacji przeglądarki.
Czy Thunderbit obsługuje API i MCP dla programistów? Tak. Thunderbit oferuje Open API do programowej ekstrakcji oraz MCP Server, który udostępnia ekstrakcję jako wywoływalne narzędzie w zgodnych workflow agentów AI, takich jak Claude, Cursor czy Windsurf.
Które narzędzie pozwala szybciej zacząć? Thunderbit, z założenia — przepływ One Click Extract w rozszerzeniu przeglądarki daje wynik w sekundach lub minutach, bez kodu. Colly wymaga napisania i przetestowania kodu w Go, zanim zobaczysz pierwszy rezultat.
Które daje większą kontrolę niskopoziomową nad samym crawlamiem? Colly, bez dyskusji. To Ty kontrolujesz współbieżność przez goroutines, limitowanie żądań, cache, rotację proxy i backendy storage bezpośrednio w kodzie — poziom strojenia, którego zarządzany produkt taki jak Thunderbit z definicji nie wystawia.




