
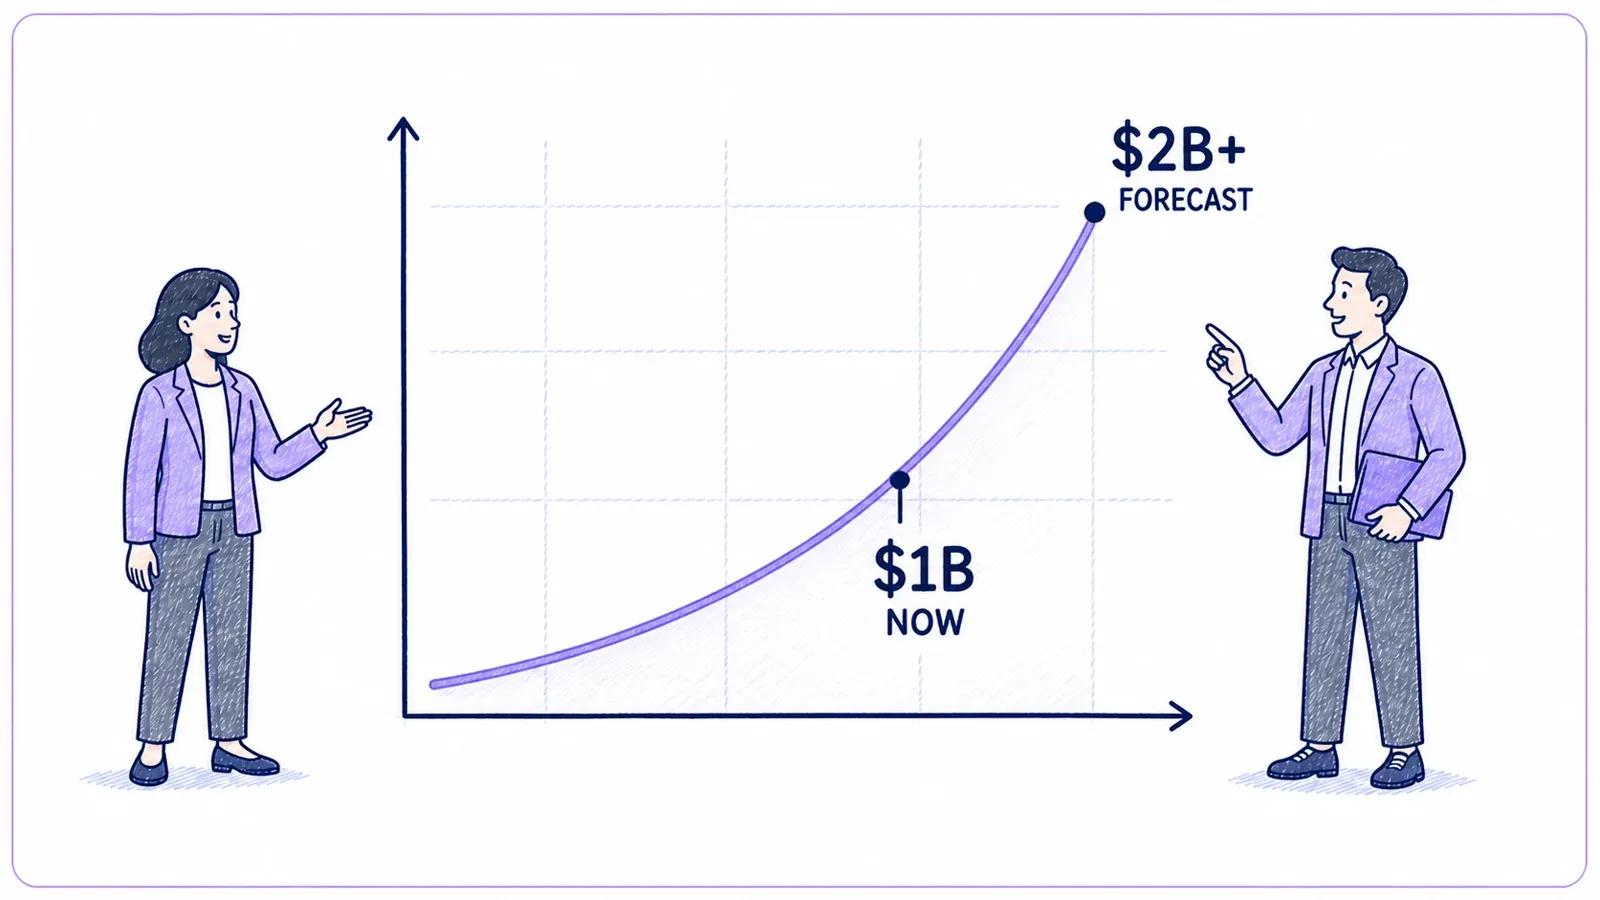
Bądźmy szczerzy: jeśli w 2026 roku nadal ręcznie kopiujesz dane ze stron internetowych, to trochę tak, jakbyś próbował przebiec maraton w klapkach. Rynek oprogramowania do web scrapingu osiągnął 1,01 mld USD w 2024 roku i według prognoz wzrośnie do 2,49 mld USD do 2032 roku, wynika z raportu Apify o stanie web scrapingu. Ponad połowa firm w USA już zbiera zewnętrzne dane z sieci — monitoruje konkurencję, śledzi ceny i buduje listy leadów — bo wiedzą, że wygrywa ten, kto ma najświeższe dane.
Pozyskuj dane ze stron internetowych z pomocą AI w jeden klik Agentowy web scraper Thunderbit sam odczytuje dane z dowolnej strony i wyciąga je jednym kliknięciem — bez konfiguracji. Get Started Free
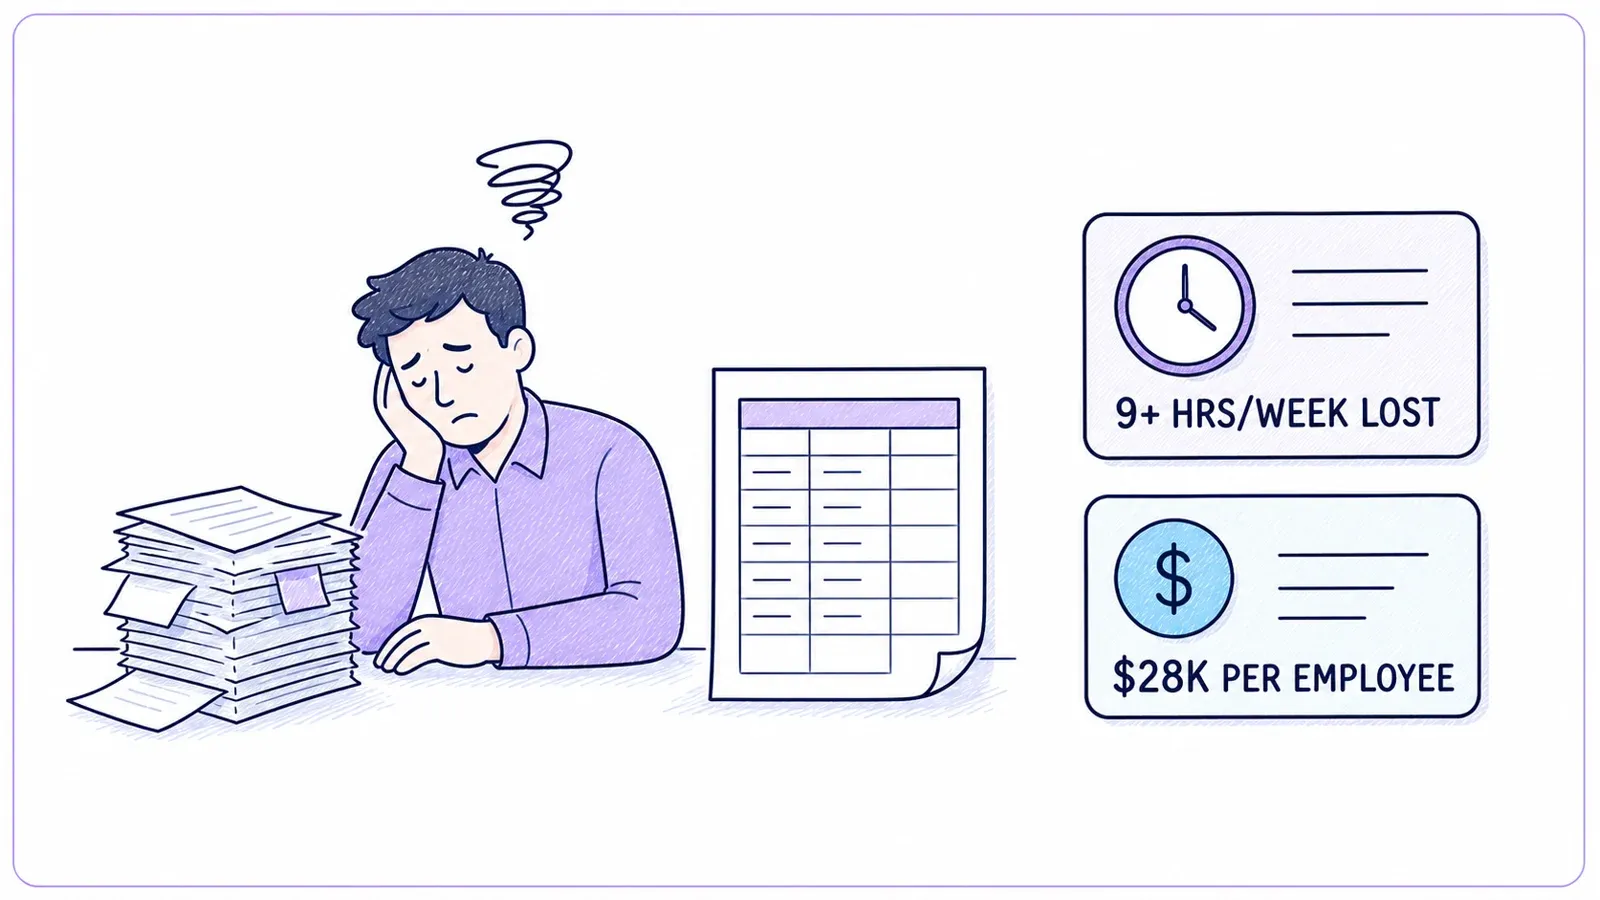
Jest jednak haczyk: większość osób biznesowych nie programuje. Widziałem zespoły sprzedaży, marketerów i operacje, które spędzają ponad 9 godzin tygodniowo na powtarzalnym wpisywaniu danych, co według badania Parseur/QuestionPro z 2025 roku, obejmującego 500 specjalistów z USA, kosztuje firmy około 28 500 USD rocznie na pracownika. Prawie 60% pracowników mówi też, że takie zadania wypalają ich zawodowo. Dobra wiadomość? Efektywne pozyskiwanie danych ze stron internetowych jest dziś dostępne dla każdego — nawet jeśli nigdy nie napisałeś ani jednej linijki kodu. Pokażę Ci dokładnie, jak to zrobić, z jakich narzędzi skorzystać i jak przejść od „potrzebuję tych danych” do gotowego arkusza — w przypadku dobrze uporządkowanych stron w kilku kliknięciach; przy bardziej chaotycznych w kilku kliknięciach plus po małej korekcie promptów.
Co to znaczy pozyskiwać dane ze stron internetowych?
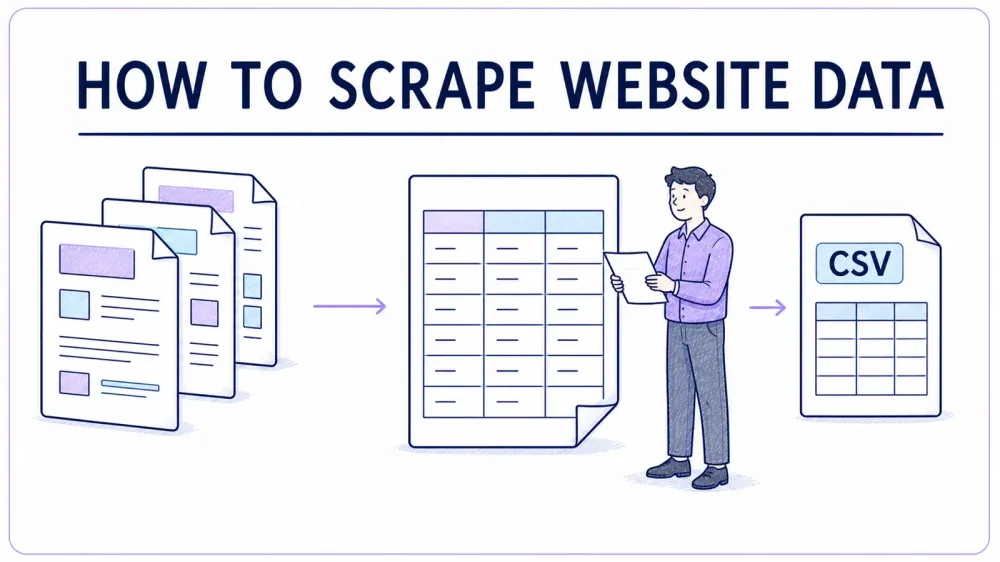
W najprostszym ujęciu pozyskiwanie danych ze stron internetowych oznacza używanie oprogramowania do automatycznego wyciągania informacji z podstron i porządkowania ich w strukturę — na przykład w tabelę, arkusz kalkulacyjny albo bazę danych. Wyobraź sobie cyfrowego asystenta, który odwiedza setki stron, zbiera potrzebne Ci informacje (np. nazwy, ceny, e-maile) i zapisuje je do Excela, podczas gdy Ty w tym czasie pijesz kawę.
Ręczne zbieranie danych — czyli kopiowanie i wklejanie z witryn — sprawdza się przy kilku wierszach. Ale gdy trzeba zebrać informacje z dziesiątek albo tysięcy stron, kończy się to obolałymi nadgarstkami i masą literówek. Automatyczne narzędzia do web scrapingu wykonują ciężką pracę za Ciebie, pobierając dokładnie te pola danych, których potrzebujesz, na dużą skalę i z dużo mniejszą liczbą błędów (ParseHub).
Podstawowe kroki web scrapingu:
- Określ, jakich danych potrzebujesz (np. ceny produktów, dane kontaktowe, opinie).
- Wyciągnij dane za pomocą narzędzia lub skryptu.
- Wyeksportuj wyniki do formatu, który możesz analizować (CSV, Excel, Google Sheets itp.).
Nowoczesne web scrapery radzą sobie nawet z listami obejmującymi wiele stron, klikaniem przycisku „następna” i przechodzeniem do podstron — dzięki czemu dostajesz pełny zestaw danych, a nie tylko to, co widać na jednym ekranie.
Dlaczego pozyskiwanie danych ze stron internetowych jest ważne dla biznesu?
Spójrzmy, dlaczego ta umiejętność jest dziś niezbędna w działach sprzedaży, marketingu i operacji:
- Generowanie leadów: Twórz precyzyjne listy potencjalnych klientów, scrapując katalogi firm, LinkedIn albo strony z uczestnikami wydarzeń. Koniec z kupowaniem przestarzałych baz i wielogodzinnym szukaniem w Google.
- Monitorowanie cen: Śledź ceny konkurencji i stany magazynowe na marketplace’ach. Detaliści tacy jak John Lewis zwiększyli sprzedaż o 4%, wykorzystując dane cenowe z web scrapingu.
- Badania rynku: Zbieraj opinie, oceny i wzmianki w mediach społecznościowych, by w czasie rzeczywistym wyłapywać trendy i nastroje klientów.
- Efektywność operacyjna: Utrzymuj aktualne katalogi produktów, dane dostawców czy oferty nieruchomości — automatycznie.
Oto krótka tabela podsumowująca korzyści:
| Kluczowa korzyść | Co to oznacza | Efekt w praktyce |
|---|---|---|
| Oszczędność czasu | Automatyzacja godzin ręcznej pracy z danymi | +9 godzin tygodniowo oszczędzone na pracownika (PRNewswire) |
| Dokładność | Mniej błędów, bardziej spójne dane | Dokładność nawet do 99,5% (Scrapingdog) |
| Przewaga konkurencyjna | Szybsze i świeższe informacje niż u rywali | Dynamiczne ceny, lepsze targetowanie |
| Automatyzacja procesów | Dane aktualizują się same — bez ręcznego sprawdzania | Zaplanowane raporty dzienne/tygodniowe |
Nic dziwnego, że 63% firm korzystających z danych zewnętrznych twierdzi, że poprawiło to jakość decyzji, a ponad połowa zauważyła wzrost przychodów.
Krok po kroku: jak pozyskiwać dane ze stron internetowych bez kodowania
Często słyszę pytanie: „Jak właściwie zacząć scrapować dane, jeśli nie jestem techniczny?” Oto prosty plan dla początkujących:
1. Określ cel i potrzebne pola danych
Zdecyduj, czego potrzebujesz. Chcesz listę wszystkich restauracji w Twoim mieście z Yelp wraz z nazwą, adresem i numerem telefonu? A może ceny produktów konkurencji z Amazon? Zapisz wszystkie pola, które są Ci potrzebne.
2. Wybierz odpowiednie narzędzie
Jeśli nie programujesz, odpuść skrypty w Pythonie. Postaw na narzędzia no-code, takie jak Thunderbit — rozszerzenie do Chrome oparte na AI — albo inne wizualne scrapery, np. Octoparse czy ParseHub.
Wypróbuj agentowy web scraper Thunderbit za darmo Darmowy plan obejmuje 6 stron miesięcznie, bez karty kredytowej — szybki sposób, by przetestować ekstrakcję na docelowej witrynie. Get Started Free
3. Skonfiguruj środowisko
Zainstaluj wybrane narzędzie (w przypadku Thunderbit pobierz rozszerzenie Chrome). Załóż konto, zaloguj się i możesz działać.
4. Zidentyfikuj dane na stronie
Wejdź na docelową stronę. W Thunderbit wystarczy kliknąć „One Click Extract” — AI przeskanuje stronę, dobierze odpowiednie kolumny (np. Nazwa, Cena, E-mail) i wyciągnie dane.
5. Wykonaj testowe pobranie
Zawsze zaczynaj od małej skali. Zeskrapuj jedną stronę albo kilka wpisów, żeby sprawdzić, czy dane wyglądają poprawnie. W razie potrzeby dostosuj kolumny lub prompty.
6. Zeskrapuj pełny zbiór danych
Gdy wszystko wygląda dobrze, uruchom pełne pobieranie. Przy większych zadaniach użyj trybu chmurowego (za chwilę wyjaśnię, o co chodzi). Narzędzie obsłuży paginację i podstrony, jeśli zostało to skonfigurowane.
7. Wyeksportuj i wykorzystaj dane
Eksportuj do Excela, Google Sheets, Airtable albo Notion. Sprawdź losowo kilka wierszy, żeby upewnić się, że wszystko jest w porządku.
Wskazówka: Unikaj typowych błędów, takich jak pomijanie paginacji, pobieranie zbyt wielu danych naraz czy ignorowanie regulaminu serwisu. Zacznij od konkretnego zakresu, dopracowuj proces krok po kroku i wkrótce będziesz działać jak profesjonalista.
Jak wybrać właściwe narzędzie: Thunderbit kontra tradycyjne rozwiązania do scrapingu
Porównajmy dostępne opcje:
| Rozwiązanie | Łatwość użycia | Czas konfiguracji | Utrzymanie | Skalowalność | Koszt | Najlepsze dla |
|---|---|---|---|---|---|---|
| Thunderbit (AI no-code) | Bardzo wysoka | Minuty | Niski | Wysoka (chmura) | Darmowy plan, od 15 USD/mies. | Sprzedaż, operacje, osoby nietechniczne |
| Tradycyjne rozszerzenia | Średnia | 30+ min | Średni | Ograniczona | Darmowe/niskie | Proste zadania, cierpliwi użytkownicy |
| Własny kod (Python) | Niska | Godziny+ | Wysoki | Bardzo wysoka | Czas deweloperski | Programiści, zespoły danych |
| Usługi outsourcingowe | Wysoka | Dni | Niski | Wysoka | $$$ | Duże, jednorazowe projekty |
Thunderbit wyróżnia się dla użytkowników nietechnicznych: brak kodu, One Click Extract i proces tak prosty, jak zamówienie jedzenia z dostawą. Tradycyjne narzędzia wymagają więcej dłubania, a własny kod najlepiej zostawić inżynierom.
Wyciągnij dowolną stronę jednym kliknięciem Agentowy web scraper Thunderbit odczytuje stronę, rozpoznaje jej strukturę i zwraca czystą tabelę — bez selektorów. Get Started Free
Thunderbit w praktyce: pozyskiwanie danych ze stron internetowych w kilku kliknięciach
Tak wyglądałoby moje użycie Thunderbit do zebrania np. katalogu agentów nieruchomości:
- Zainstaluj rozszerzenie Chrome i zaloguj się.
- Wejdź na stronę docelową (np. katalog agentów nieruchomości).
- Kliknij ikonę Thunderbit, aby otworzyć panel boczny.
- Naciśnij „One Click Extract”. AI Thunderbit przeskanuje stronę i zaproponuje kolumny, takie jak Nazwa, Biuro, Telefon, E-mail.
- Sprawdź i dopasuj pola — zmień nazwy kolumn, dodaj własny prompt, jeśli chcesz kategoryzować lub formatować dane.
- Kliknij „Scrape”. Thunderbit wyciągnie dane do tabeli, obsługując paginację, a nawet nieskończone przewijanie.
- Wyeksportuj do Excela, Google Sheets lub Notion — bez dodatkowych opłat i ukrytych kosztów.
Jeśli imię i nazwisko każdego agenta prowadzi do profilu, użyj funkcji Subpage Scraping: Thunderbit odwiedzi każdą podstronę, pobierze dodatkowe informacje (np. adres lub liczbę lat doświadczenia) i dopisze je do tabeli. Koniec z otwieraniem kart po jednej.
Scrapowanie w przeglądarce czy w chmurze: który tryb wybrać?
Thunderbit daje Ci dwa tryby:
- Browser Scraping: działa lokalnie w Twojej przeglądarce Chrome. Idealny do danych za logowaniem albo stron spersonalizowanych (np. Twojego konta LinkedIn czy wewnętrznych dashboardów). Korzysta z Twojej sesji i ciasteczek, więc jeśli Ty widzisz stronę, Thunderbit też może ją zeskrapować.
- Cloud Scraping: działa na serwerach Thunderbit. Bardzo szybki przy danych publicznych — może pobierać nawet do 50 stron jednocześnie, nie obciąża komputera i działa dalej, nawet jeśli zamkniesz laptopa. Świetny do dużych zadań, np. zeskrapowania wszystkich produktów ze sklepu ecommerce.
Kiedy używać którego trybu:
- Tryb przeglądarkowy: strony wymagające logowania, spersonalizowane feedy, małe zadania.
- Tryb chmurowy: duże zbiory publicznych danych, zaplanowane pobrania lub sytuacje, gdy chcesz ustawić wszystko raz i zapomnieć.
Thunderbit obsługuje też paginację i podstrony w obu trybach, więc za każdym razem dostajesz pełny zestaw danych.
Efektywność na dwa kliknięcia: jak AI pomaga dopracować pola i format danych
Jedną z moich ulubionych funkcji Thunderbit jest „AI Improve Fields”. Oto, dlaczego robi robotę:
- Automatyczne formatowanie: standaryzuj numery telefonów, ceny lub daty już podczas scrapowania — bez bałaganu w arkuszach.
- Kategoryzacja: dodaj kolumnę typu „Kategoria” i pozwól AI oznaczać każdy wiersz (np. Elektronika, Odzież, Meble) na podstawie opisu.
- Tłumaczenie: zeskrapuj strony w innych językach i pozwól Thunderbit przetłumaczyć pola na angielski (albo na ponad 34 inne języki).
- Własne prompty: chcesz wyciągać sentyment z opinii albo oznaczać firmy według wielkości? Po prostu dodaj prompt AI do pola.
Dzięki temu dostajesz dane gotowe do analizy prosto z narzędzia, bez godzin ręcznego czyszczenia.
Zautomatyzuj pracę: planowanie regularnego pobierania danych ze stron
Po co ograniczać się do jednorazowego scrapowania? Funkcja Schedule w Thunderbit pozwala ustawić cykliczne pobieranie — codzienne, tygodniowe albo według dowolnego harmonogramu.
- Opisz harmonogram prostym językiem („co poniedziałek o 9:00”).
- Wybierz projekt i miejsce eksportu (Excel, Google Sheets, Airtable, Notion).
- Thunderbit uruchamia pobieranie automatycznie i aktualizuje dane — bez ręcznej pracy.
Przykłady zastosowań:
- Sprzedaż: codzienne aktualizacje list leadów.
- Ecommerce: automatyczne monitorowanie cen.
- Operacje: alerty o stanach magazynowych.
- Badania rynku: agregacja newsów lub opinii.
Dzięki zaplanowanemu scrapowaniu dane pozostają świeże, a Twój zespół ma zawsze najnowsze informacje pod ręką.
Porównanie popularnych narzędzi do pozyskiwania danych ze stron: szybka ściąga
Oto porównanie najpopularniejszych opcji:
| Typ narzędzia | Łatwość użycia | Czas konfiguracji | Skalowalność | Utrzymanie | Koszt | Najlepsze dla |
|---|---|---|---|---|---|---|
| Thunderbit (AI no-code) | ⭐⭐⭐⭐⭐ | Minuty | Wysoka | Niskie | Darmowy / od 15 USD/mies. | Sprzedaż, operacje, osoby nietechniczne |
| Tradycyjne rozszerzenia | ⭐⭐⭐ | 30+ min | Średnia | Średnie | Darmowe/niskie | Proste zadania, cierpliwi użytkownicy |
| Własny kod (Python) | ⭐ | Godziny+ | Bardzo wysoka | Wysokie | Czas deweloperski | Programiści, zespoły danych |
| Usługi outsourcingowe | ⭐⭐⭐⭐ | Dni | Wysoka | Niskie | $$$ | Duże, jednorazowe projekty |
Dla większości użytkowników biznesowych Thunderbit jest oczywistym zwycięzcą pod względem szybkości, prostoty i kosztów.
Najważniejsze wnioski: jak efektywnie pozyskiwać dane ze stron internetowych
- Web scraping jest dziś dostępny dla każdego. Nie trzeba programować — wystarczy odpowiednie narzędzie i kilka prostych kroków.
- Zdefiniuj cel i pola danych, zanim zaczniesz. Wiedz, jakich danych potrzebujesz i gdzie ich szukać.
- Korzystaj z narzędzi opartych na AI, takich jak Thunderbit, aby uzyskać najłatwiejsze i najszybsze rezultaty — szczególnie jeśli nie jesteś techniczny.
- Automatyzuj powtarzalne zadania za pomocą harmonogramu, żeby dane aktualizowały się same.
- Dopracowuj i formatuj dane w trakcie scrapowania dzięki promptom AI — od razu otrzymasz wyniki gotowe do analizy.
Gotowy, żeby spróbować? Pobierz rozszerzenie Chrome Thunderbit i wykonaj pierwszy scraping za darmo. Możesz też zajrzeć na Thunderbit Blog, aby znaleźć więcej poradników i przykładów z praktyki.
Zobacz, jak Thunderbit wypada na tle innych Sprawdź, jak jednorazowe, oparte na AI wyciąganie danych przez Thunderbit wypada na tle innych narzędzi z tego poradnika. Get Started Free
FAQ
1. Czy web scraping jest legalny i bezpieczny w biznesie?
Tak, o ile pozyskujesz publicznie dostępne dane i przestrzegasz regulaminu strony. Unikaj scrapowania danych osobowych lub wrażliwych bez zgody i zawsze sprawdzaj zasady danej witryny.
2. Jakie dane mogę zeskrapować w Thunderbit?
Możesz wyciągać tekst, liczby, daty, adresy URL, e-maile, numery telefonów, obrazy i wiele więcej. AI Thunderbit potrafi też kategoryzować, oznaczać i tłumaczyć pola w trakcie scrapowania.
3. Czy mogę pobierać dane ze stron wymagających logowania?
Jak najbardziej — użyj trybu Browser Mode w Thunderbit, aby pozyskiwać dane z każdej strony, do której masz dostęp w przeglądarce, również tych za logowaniem.
4. Jak Thunderbit radzi sobie ze stronami mającymi wiele podstron?
Thunderbit obsługuje automatyczną paginację i scrapowanie podstron. Może klikać przycisk „następna” i odwiedzać powiązane strony szczegółów, łącząc wszystkie dane w jedną tabelę.
5. Czy mogę zaplanować automatyczne uruchamianie scrapingu?
Tak! Funkcja Schedule w Thunderbit pozwala ustawić cykliczne pobieranie danych (codzienne, tygodniowe itd.) i eksportować wyniki bezpośrednio do Excela, Google Sheets, Airtable lub Notion.
Wypróbuj agentowy web scraper Thunderbit za darmo Get Started Free
Pozyskiwanie danych ze stron internetowych nie musi być uciążliwe. Z odpowiednimi narzędziami i jasnym planem możesz zamienić sieć w swoją osobistą bazę danych — bez kodu, bez stresu, po prostu z wynikami. Udanych scrapów!



