
Tempo cyfrowych wiadomości dziś jest wręcz zawrotne. Co minutę publikowane, aktualizowane albo po cichu edytowane są tysiące nagłówków — w serwisach mainstreamowych, niszowych blogach i kanałach społecznościowych.
Dla zobrazowania skali: LexisNexis Newsdesk przetwarza ponad 4 miliony artykułów prasowych każdego dnia, a GDELT Project monitoruje wiadomości w ponad 100 językach i odświeża swój globalny feed co 15 minut.
Dla osób pracujących w mediach, badaniach czy business intelligence ręczne śledzenie tego strumienia przypomina próbę opróżniania tonącej łodzi kubkiem kawy.
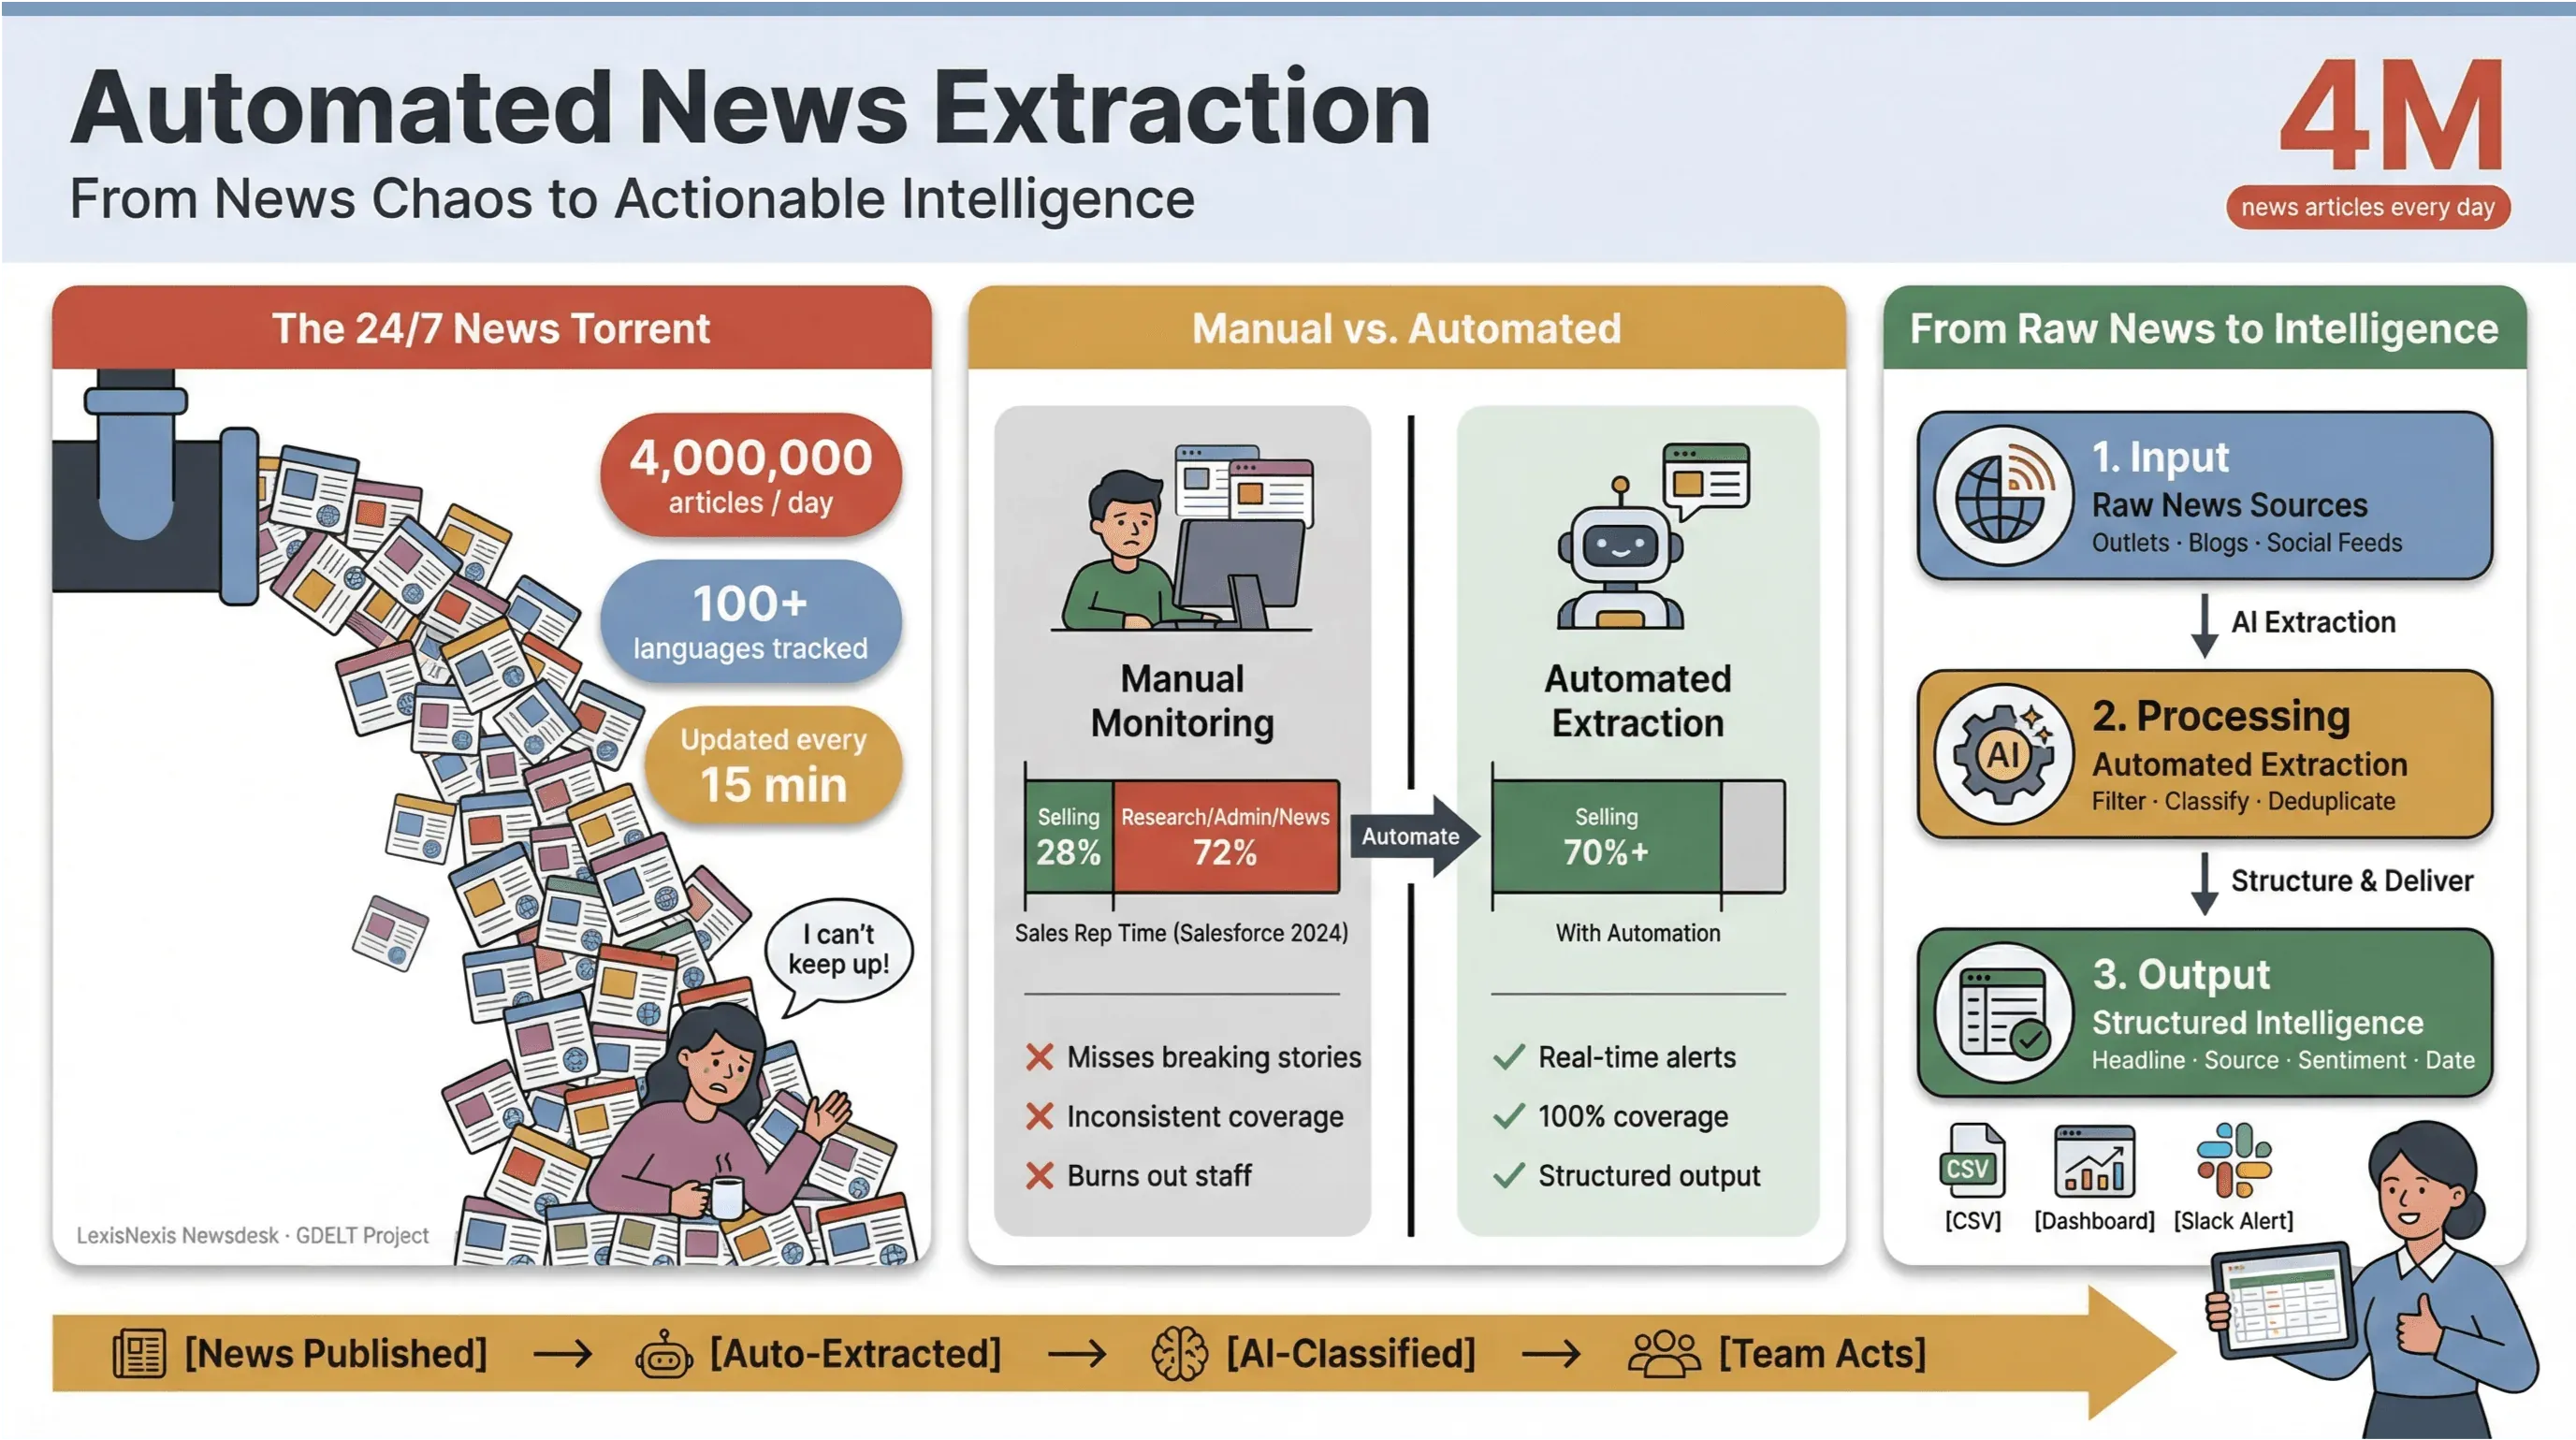
Widziałem na własne oczy, jak ręczne monitorowanie wiadomości pochłania czas i zasoby. Zespoły sprzedażowe spędzają na faktycznej sprzedaży mniej niż jedną trzecią tygodnia — zaledwie 28% według Salesforce — a reszta znika na research, administrację i, tak, niekończące się przeskakiwanie między kartami z wiadomościami.
Właśnie dlatego automatyczna ekstrakcja wiadomości stała się tajną bronią nowoczesnych zespołów: to jedyny sposób, by zamienić chaos całodobowego cyklu informacyjnego w uporządkowaną, użyteczną wiedzę — bez przeciążania ludzi i bez pomijania najważniejszych tematów.
Sprawdźmy, czym naprawdę jest automatyczna ekstrakcja wiadomości, dlaczego ma kluczowe znaczenie dla każdego, kto potrzebuje danych newsowych w czasie rzeczywistym, i jak zbudować solidny, zgodny z przepisami workflow z użyciem najlepszych narzędzi (w tym tego, jak Thunderbit sprawia, że cały proces jest zaskakująco prosty — nawet dla osób nietechnicznych, takich jak moja mama).
Wypróbuj Thunderbit do automatycznej ekstrakcji wiadomości Nagłówek, znacznik czasu, autor i podsumowanie z dowolnej strony newsowej — kliknij raz i ustaw cykliczne uruchamianie. Get Started Free
Automatyczna ekstrakcja wiadomości: dlaczego jest niezbędna w nowoczesnych newsroomach
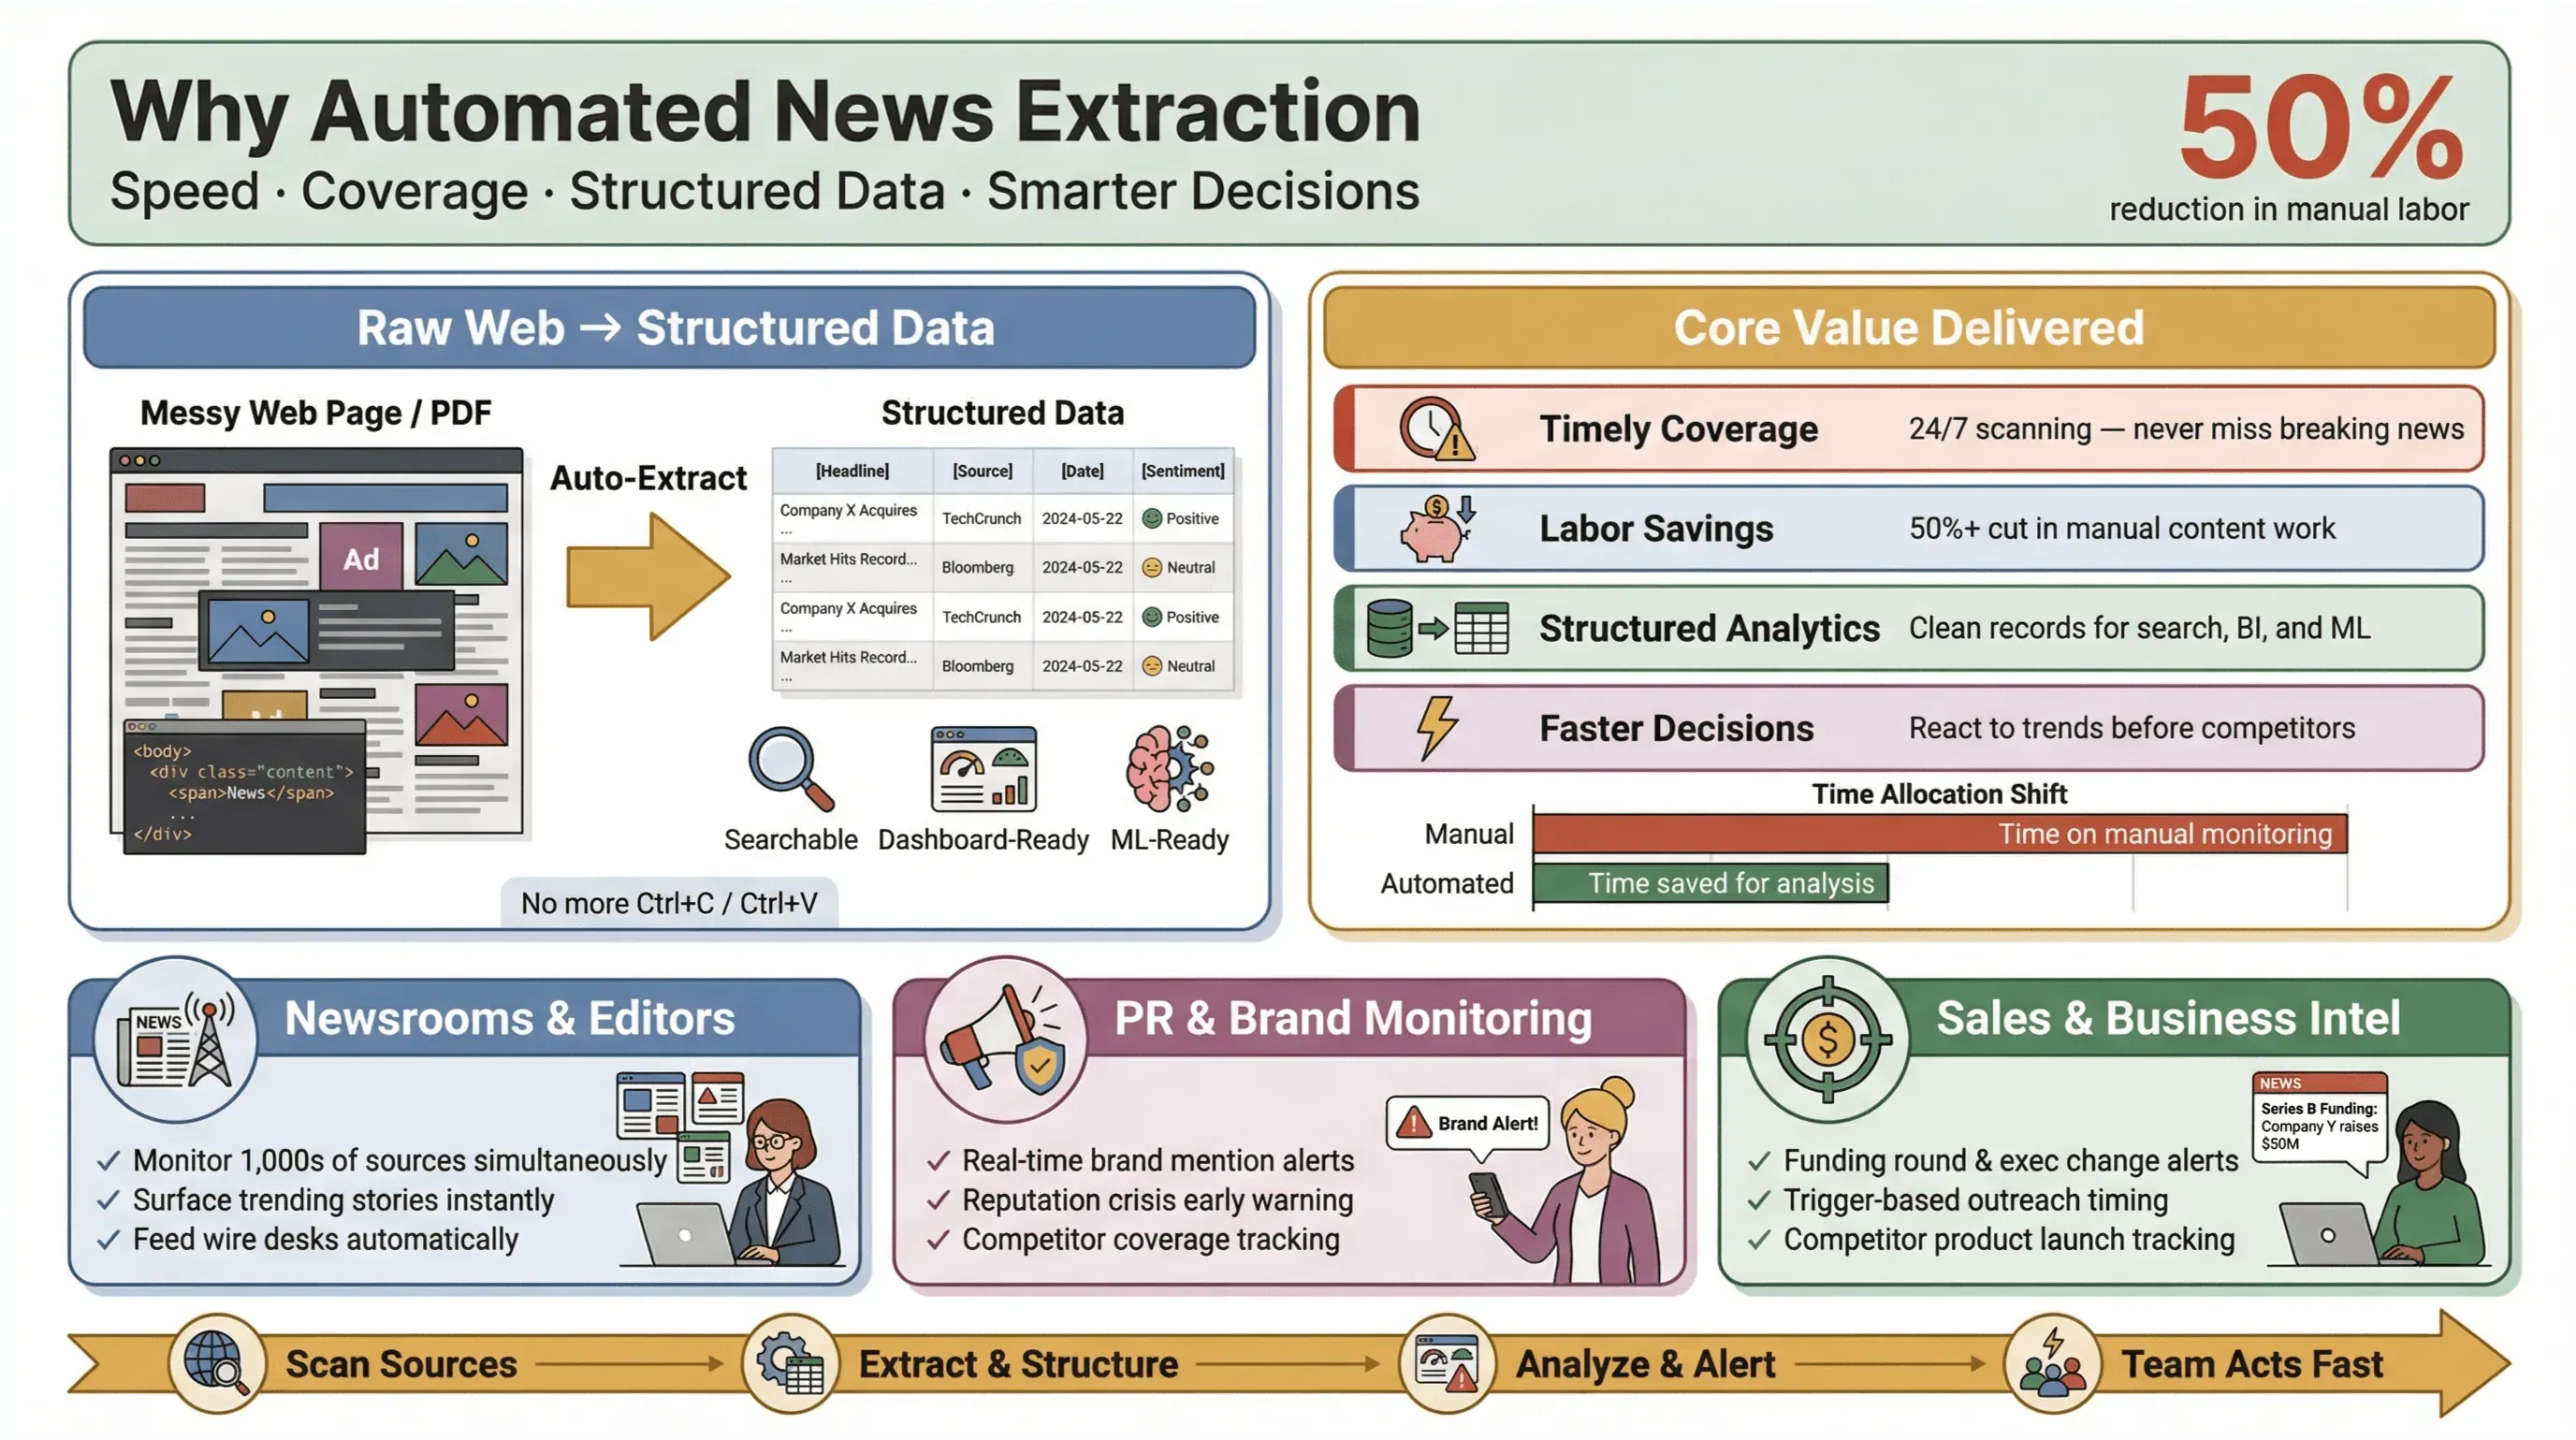
Automatyczna ekstrakcja wiadomości to dokładnie to, na co wskazuje nazwa: wykorzystanie oprogramowania do automatycznego zbierania treści newsowych i przekształcania ich w uporządkowane, przeszukiwalne dane — czyli wiersze i kolumny zamiast chaotycznych stron internetowych czy plików PDF. W praktyce oznacza to możliwość monitorowania setek (albo tysięcy) źródeł, wyciągania kluczowych pól, takich jak nagłówek, znacznik czasu, autor i treść artykułu, a następnie przesyłania tych danych do dashboardów, alertów lub dalszej analityki — bez sięgania po Ctrl+C/Ctrl+V.
Dlaczego to takie ważne? Bo we współczesnym krajobrazie medialnym liczy się szybkość. Niezależnie od tego, czy jesteś redaktorem newsroomu, specjalistą PR śledzącym wzmianki o marce, czy analitykiem biznesowym obserwującym ruchy konkurencji, bycie pierwszym może decydować o tym, czy wykorzystasz szansę, czy tylko będziesz nadrabiać zaległości. Narzędzia do automatycznej ekstrakcji pozwalają nawet małym zespołom działać ponad swoją wagę — zbierać dane newsowe w czasie rzeczywistym z całej sieci, ograniczać ręczną pracę i wyłapywać najważniejsze historie.
Efekty są wymierne: badania pokazują, że automatyzacja może zmniejszyć nakład pracy ręcznej przy aktualizowaniu treści o co najmniej 50%, uwalniając czas na faktyczną analizę i podejmowanie decyzji.
Główna wartość automatycznej ekstrakcji wiadomości w branży medialnej
Przejdźmy do konkretów. Co właściwie daje automatyczna ekstrakcja wiadomości newsroomom i zespołom biznesowym?
- Terminowe, szerokie pokrycie tematu: Koniec z przegapianiem przełomowych newsów tylko dlatego, że ktoś nie sprawdził feedu. Narzędzia automatyczne monitorują źródła 24/7, więc nic Ci nie umknie.
- Oszczędność pracy i kosztów: Małe i średnie zespoły mogą śledzić tyle samo źródeł co duże organizacje — bez zatrudniania armii stażystów.
- Ustrukturyzowane dane do analityki: Zamiast przekopywać się przez niestrukturyzowane artykuły, dostajesz czyste rekordy gotowe do wyszukiwania, dashboardów i uczenia maszynowego.
- Szybsze i trafniejsze decyzje: Dane newsowe w czasie rzeczywistym pozwalają reagować na zmiany rynkowe, kryzysy PR czy nowe trendy, zanim zrobi to konkurencja.
Weźmy PR i komunikację: platformy takie jak Cision i Meltwater pozycjonują monitoring mediów w czasie rzeczywistym jako coś niezbędnego do ochrony reputacji i szybkiego reagowania na szkodliwe publikacje. W sprzedaży alerty newsowe w czasie rzeczywistym stają się „kartami kontekstowymi” do prospectingu — na przykład rundy finansowania, zmiany kadrowe w zarządzie czy premiery produktów, które uruchamiają kontakt dokładnie w odpowiednim momencie.
Jak wybrać odpowiednie narzędzia do scrapingu wiadomości w różnych scenariuszach
Nie wszystkie narzędzia do scrapingu wiadomości są sobie równe. Właściwy wybór zależy od Twoich celów, komfortu technicznego i rodzaju newsów, które chcesz śledzić. Oto ramy, które pomogą Ci wybrać najlepsze rozwiązanie:
- Ocena łatwości użycia i dostępności
- Bezpieczeństwo i prywatność danych
- Dopasowanie narzędzi do typów wiadomości i potrzeb branżowych
Ocena łatwości użycia i dostępności
Dla większości użytkowników biznesowych i dziennikarzy prostota obsługi jest nie do negocjacji. Potrzebujesz narzędzia, które działa od razu, bez kodowania i skomplikowanej konfiguracji. Platformy no-code i low-code, takie jak Thunderbit, Octoparse i ParseHub, pozwalają budować scrapery wizualnie — po prostu wskazujesz, klikasz i pobierasz dane.
Thunderbit szczególnie wyróżnia się przepływem opartym na jednym kliknięciu: kliknij One Click Extract, a AI odczyta stronę, rozpozna pola i pobierze dane. Nawet osoby nietechniczne mogą uruchomić pipeline danych newsowych w kilka minut, a nie godzin.
Bezpieczeństwo i prywatność danych
Duże dane oznaczają dużą odpowiedzialność. Narzędzia do scrapingu wiadomości często mają dostęp do wrażliwych treści, dlatego bezpieczeństwo i zgodność powinny być priorytetem. Zwróć uwagę na:
- Szyfrowanie danych (w tranzycie i spoczynku)
- Jasne polityki prywatności (Thunderbit deklaruje np., że nie sprzedaje danych użytkowników i ma dostęp wyłącznie do treści, które sam zdecydujesz się pobrać)
- Precyzyjne uprawnienia (szczególnie w przypadku rozszerzeń przeglądarki — zawsze sprawdzaj, do jakich danych narzędzie ma dostęp)
- Zgodność z lokalnym prawem (RODO/GDPR, CCPA oraz — dla użytkowników z UE — DSM Copyright Directive)
Dla większego spokoju wybieraj renomowanych dostawców, weryfikuj uprawnienia rozszerzeń i ograniczaj dostęp tylko do tego, co jest naprawdę potrzebne.
Dopasowanie narzędzi do typów wiadomości i potrzeb branżowych
Niektóre narzędzia najlepiej sprawdzają się w konkretnych obszarach newsowych:
- Finanse: API takie jak News API i AYLIEN oferują klastrowanie, analizę sentymentu i wykrywanie wydarzeń w wiadomościach finansowych.
- Tech i startupy: Niestandardowy scraping z Thunderbit lub Octoparse pozwala targetować niszowe blogi, komunikaty prasowe czy listy wydarzeń.
- Polityka i regulacje: Licencjonowane bazy, takie jak Factiva i LexisNexis, zapewniają dostęp do źródeł premium i archiwów.
Jeśli musisz monitorować mieszankę źródeł głównego nurtu, niszowych i międzynarodowych — w tym takich bez API — elastyczne scrapery oparte na AI, takie jak Thunderbit, będą najlepszym wyborem.
Unikalne przewagi Thunderbit w ekstrakcji danych newsowych w czasie rzeczywistym
Pobieraj dane newsowe w czasie rzeczywistym z Thunderbit AI odczytuje stronę i sam dobiera pola — bez ręcznego poprawiania selektorów po zmianie wyglądu strony przez wydawcę. Get Started Free
Teraz porozmawiajmy o tym, co sprawia, że Thunderbit jest świetnym wyborem do automatycznej ekstrakcji wiadomości — szczególnie jeśli chcesz mieć dane newsowe w czasie rzeczywistym bez problemów technicznych.
Thunderbit to rozszerzenie Chrome oparte na AI, stworzone dla użytkowników biznesowych, dziennikarzy i analityków, którzy potrzebują aktualnych, ustrukturyzowanych treści newsowych z dowolnej strony internetowej. Oto dlaczego stało się moim podstawowym narzędziem:
- One Click Extract: Thunderbit czyta stronę z wiadomościami i sam rozpoznaje najlepsze kolumny do pobrania — nagłówek, znacznik czasu, autora, podsumowanie i inne. Nie trzeba męczyć się z selektorami ani szablonami.
- Scraping podstron: Potrzebujesz pełnego artykułu, a nie tylko nagłówka? Thunderbit może odwiedzić każdy link do newsa, wyciągnąć pełną treść, encje i tagi, a następnie połączyć wszystko w jedną, uporządkowaną tabelę.
- Eksport zbiorczy i natychmiastowe aktualizacje: Eksportuj dane newsowe bezpośrednio do Excel, Google Sheets, Airtable lub Notion jednym kliknięciem. Koniec z kopiowaniem i wklejaniem oraz walką z CSV.
- Zaplanowany scraping: Ustaw cykliczne zadania (co godzinę, codziennie lub w niestandardowych odstępach), aby feed wiadomości był zawsze świeży — idealne do bieżących newsów, monitoringu rynku i badań ciągłych.
- Elastyczność: AI w Thunderbit dostosowuje się do zmian układu strony i mniej typowych serwisów newsowych, więc spędzasz mniej czasu na naprawianiu uszkodzonych scraperów, a więcej na analizie danych.
Z ponad 100 000 użytkowników w Chrome Web Store Thunderbit jest używany przez zespoły PR, researcherów sprzedaży i analityków, którzy potrzebują danych newsowych bez pilnowania scrapera.
AI wykrywające pola i scraping podstron
Jedną z najmocniejszych funkcji Thunderbit jest AI do wykrywania pól. Wystarczy kliknąć „One Click Extract”, a narzędzie przeskanuje stronę newsową — rozpoznając kluczowe pola, takie jak tytuł, data, autor i podsumowanie. Możesz doprecyzować lub dodać własne pola (na przykład: „oznacz ten artykuł jako ‘earnings’, jeśli wspomina o wynikach kwartalnych”), a AI Thunderbit zajmie się resztą.
Scraping podstron zmienia zasady gry w przypadku newsów: zeskrob stronę główną lub listing działu, aby pobrać nagłówki, a następnie pozwól Thunderbit odwiedzić każdy adres URL artykułu, by wyciągnąć pełną treść, encje, a nawet obrazy. Dzięki temu otrzymujesz kompletne, wzbogacone rekordy newsowe — gotowe do wyszukiwania, dashboardów lub dalszej analizy AI.
Eksport zbiorczy i natychmiastowe aktualizacje
Thunderbit sprawia, że eksport danych newsowych jest bezproblemowy. Jednym kliknięciem możesz wysłać uporządkowany feed wiadomości do Google Sheets, Airtable, Notion albo pobrać go jako CSV/Excel. Dla zespołów żyjących w arkuszach kalkulacyjnych lub narzędziach BI to ogromna oszczędność czasu.
A ponieważ Thunderbit obsługuje zaplanowany scraping, możesz ustawić uruchamianie co godzinę, codziennie lub według własnego harmonogramu — dzięki czemu dane newsowe są zawsze aktualne. Koniec z czekaniem, aż Google Alerts zaindeksuje temat po kilku dniach.
Jak pokonać wyzwania operacyjne w rozwiązaniach do danych newsowych w czasie rzeczywistym
Nawet najlepsze narzędzia do ekstrakcji newsów w czasie rzeczywistym wiążą się z pewnymi wyzwaniami. Oto jak poradzić sobie z najczęstszymi z nich:
Zarządzanie opóźnieniem i świeżością danych
- Planuj scraping zgodnie z dynamiką newsów: W przypadku gorących tematów ustaw uruchamianie co 15–30 minut (zgodnie z cyklem aktualizacji GDELT Project). Dla wolniejszych tematów wystarczy tryb dzienny lub godzinowy.
- Monitoruj opóźnienie między publikacją a pobraniem: Śledź różnicę między momentem publikacji artykułu a chwilą, gdy system go pobiera. Jeśli opóźnienie rośnie, sprawdź, czy nie ma blokad albo spowolnień.
- Ponownie pobieraj „ciche edycje”: Artykuły newsowe często są aktualizowane po publikacji. Zaplanuj drugi scraping po 24 godzinach, aby wychwycić poprawki lub ukryte zmiany (GDELT robi to celowo).
Obsługa limitów API i zmienności źródeł
- Szanuj limity API: Jeśli korzystasz z API newsowych, pilnuj rate limitów — rozkładaj zapytania w czasie i cache’uj wyniki, gdy to możliwe (dokumentacja News API).
- Usuwaj duplikaty i stosuj canonicalizację: Artykuły często pojawiają się pod wieloma adresami URL albo są aktualizowane. Zapisuj canonical URL i używaj hashy (np. tytuł + data), aby uniknąć duplikatów (przewodnik Google o canonicalizacji).
- Radź sobie z dynamiczną treścią: W serwisach z infinite scroll lub lazy loading wybieraj narzędzia obsługujące dynamiczne renderowanie i monitoruj zmiany układu strony (przewodnik Octoparse).
Inteligentna analiza danych newsowych: rola AI i machine learning
Samo pobieranie wiadomości to dopiero pierwszy krok. Prawdziwa wartość pojawia się wtedy, gdy analizujesz dane i podejmujesz na ich podstawie działania — i właśnie tutaj AI oraz uczenie maszynowe pokazują swoją siłę.
- Ekstrakcja encji: Wykorzystaj NLP, aby wyciągać z artykułów osoby, organizacje i miejsca (przewodnik Google Cloud).
- Klasyfikacja tematów: Automatycznie oznaczaj artykuły według tematu, sentymentu lub pilności — dzięki czemu dashboardy i alerty stają się znacznie mądrzejsze (dokumentacja taksonomii AYLIEN).
- Klastrowanie wydarzeń: Grupuj duplikaty lub powiązane historie z różnych mediów, aby zobaczyć pełny obraz, a nie tylko lawinę podobnych nagłówków.
- Personalizacja i targetowanie: Wykorzystuj dane newsowe w czasie rzeczywistym do segmentacji odbiorców, lepszego targetowania reklam lub rekomendacji treści — zwiększając zaangażowanie i ROI.
Na przykład zespoły PR używają analityki newsów w czasie rzeczywistym, by wychwycić rodzące się kryzysy, zanim staną się viralem, a zespoły sprzedażowe wzbogacają listy prospectów o „zdarzenia wyzwalające”, takie jak rundy finansowania czy zatrudnienie kadry zarządzającej.
Lista najlepszych praktyk dla automatycznej ekstrakcji wiadomości
Oto krótka lista kontrolna, która pomoże utrzymać pipeline ekstrakcji wiadomości w dobrej kondycji:
| Najlepsza praktyka | Dlaczego to ważne | Jak wdrożyć |
|---|---|---|
| Planuj częste scrape’y | Ogranicza opóźnienie danych i pozwala łapać breaking news | Dopasuj częstotliwość do dynamiki newsów (np. co 15 min dla szybkich tematów) |
| Korzystaj z ekstrakcji opartej na AI | Dostosowuje się do zmian układu strony i skraca czas konfiguracji | Narzędzia takie jak Thunderbit, Diffbot, Zyte API |
| Usuwaj duplikaty i stosuj canonicalizację | Unikasz powielonych alertów i utrzymujesz czyste dane | Zbieraj canonical URL, używaj hashy do deduplikacji |
| Monitoruj jakość ekstrakcji | Wykrywasz brakujące pola, drift lub błędy | Śledź odsetek kompletnych rekordów, opóźnienie i wskaźniki błędów |
| Przestrzegaj zasad prawnych i compliance | Ograniczasz ryzyko prawne i budujesz zaufanie | Preferuj oficjalne API/feed’y, sprawdzaj warunki korzystania, minimalizuj dane osobowe |
| Eksportuj do ustrukturyzowanych formatów | Ułatwiasz dalszą analizę | CSV, Excel, Sheets, Notion, Airtable |
| Planuj ponowne pobrania pod kątem edycji | Wychwytujesz zmiany po publikacji | Wracaj do artykułów po 24h/1 tyg. (model GDELT) |
| Zabezpiecz pipeline | Chronisz wrażliwe dane | Szyfrowanie, kontrola dostępu, renomowane narzędzia |
Jak zbudować solidny workflow automatycznej ekstrakcji wiadomości
Gotowy, by zbudować własne „black box” dla danych newsowych? Oto workflow krok po kroku:
- Zidentyfikuj źródła: Sporządź listę serwisów newsowych, blogów lub API, które chcesz monitorować.
- Skonfiguruj ekstrakcję: Użyj Thunderbit lub wybranego narzędzia, aby zdefiniować pola (One Click Extract bardzo to upraszcza).
- Ustal harmonogram scrape’ów: Dobierz częstotliwość do dynamiki newsów — co godzinę dla breaking news, codziennie dla spokojniejszych tematów.
- Wzbogacanie podstron: Dla każdego nagłówka pobierz pełny artykuł, treść, encje i tagi.
- Deduplikacja i normalizacja: Zapisuj canonical URL, haszuj rekordy i standaryzuj pola.
- Eksport i integracja: Przesyłaj uporządkowane dane do Excel, Google Sheets, Airtable lub Notion do analizy.
- Monitoruj i dostosowuj: Śledź jakość ekstrakcji, obserwuj zmiany układu strony i wprowadzaj poprawki.
- Dbaj o zgodność: Sprawdzaj warunki korzystania, respektuj robots.txt i minimalizuj dane osobowe.
Wizualnie można to ująć tak:
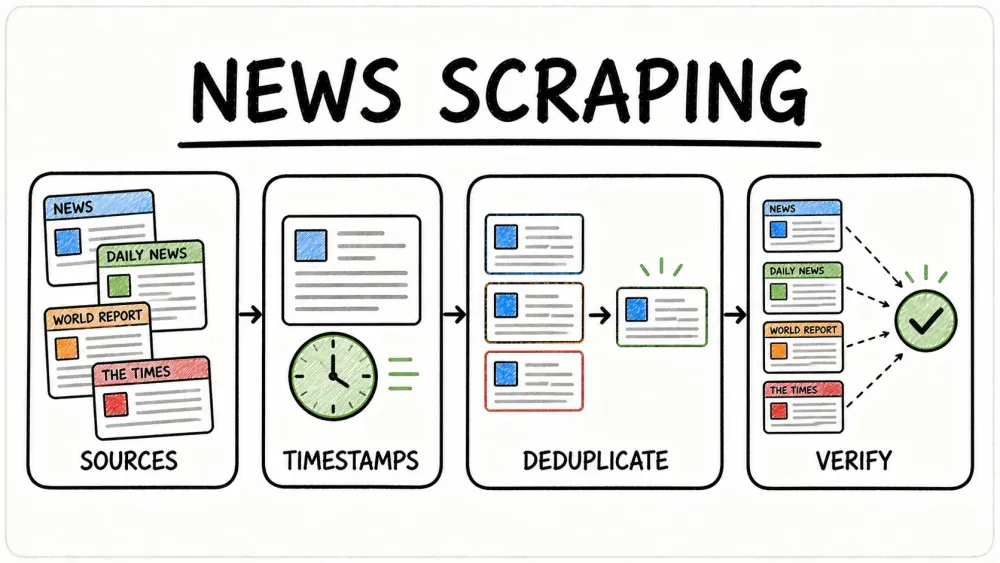
Źródła → Ekstrakcja (pola AI) → Wzbogacanie podstron → Deduplikacja → Eksport → Analiza/alerty → Monitoring
Podsumowanie i najważniejsze wnioski
Zamień dowolną stronę z wiadomościami w tabelę Możesz zacząć za darmo, bez karty. Extractory Email, Phone Number i Image są dostępne w każdym planie. Get Started Free
Automatyczna ekstrakcja wiadomości to już nie „fajny dodatek” — to konieczność dla każdego, kto chce wyprzedzać innych w świecie, w którym newsy pojawiają się i zmieniają z minuty na minutę. Stosując najlepsze praktyki i odpowiednie narzędzia, możesz przekształcić potok cyfrowych wiadomości w stały strumień uporządkowanej, użytecznej wiedzy.
Najważniejsze wnioski:
- Skala i tempo newsów online wymagają automatyzacji — ręczne monitorowanie zwyczajnie nie nadąża.
- Narzędzia do automatycznej ekstrakcji wiadomości oszczędzają czas, obniżają koszty i pozwalają małym zespołom dorównać znacznie większym organizacjom.
- Wybór odpowiedniego narzędzia to balans między prostotą obsługi, bezpieczeństwem i elastycznością — Thunderbit wyróżnia się prostotą opartą na AI i opcjami natychmiastowego eksportu.
- Zbuduj workflow wokół świeżości danych, deduplikacji, zgodności i monitorowania jakości, aby zapewnić wiarygodne, praktyczne dane newsowe.
- AI i uczenie maszynowe odblokowują jeszcze większą wartość — umożliwiając lepsze targetowanie, personalizację i podejmowanie decyzji.
Jeśli nadal kopiujesz nagłówki ręcznie albo czekasz, aż Google Alerts pokaże temat z jednodniowym opóźnieniem, warto przetestować automatyczny workflow. Zainstaluj darmowe rozszerzenie Chrome, wskaż mu trzy lub cztery źródła, które sprawdzasz codziennie rano, i zobacz, czy uporządkowany eksport rzeczywiście oszczędza Ci tyle czasu, ile zakładasz. Po więcej wskazówek, workflowów i szczegółowych analiz zajrzyj na Thunderbit Blog.
Scrapuj serwisy newsowe z Thunderbit Ustaw harmonogram i pozwól narzędziu monitorować źródła, które są dla Ciebie ważne. Eksport trafia bezpośrednio do Sheets, Excel, Airtable lub Notion. Get Started Free
FAQ
1. Czym jest automatyczna ekstrakcja wiadomości i jak działa?
Automatyczna ekstrakcja wiadomości to proces wykorzystania oprogramowania do zbierania artykułów newsowych i przekształcania ich w ustrukturyzowane dane (np. tabele lub JSON) do analizy, wyszukiwania albo alertów. Narzędzia takie jak Thunderbit używają AI do rozpoznawania kluczowych pól (nagłówek, znacznik czasu, autor, treść) i automatycznie pobierają je ze stron internetowych lub API.
2. Dlaczego dane newsowe w czasie rzeczywistym są tak ważne dla firm?
Dane newsowe w czasie rzeczywistym pozwalają firmom szybko reagować na wydarzenia rynkowe, kryzysy PR czy ruchy konkurencji. Niezależnie od tego, czy pracujesz w sprzedaży, PR czy badaniach, aktualne wiadomości pomagają podejmować mądrzejsze i szybsze decyzje oraz utrzymać przewagę nad konkurencją.
3. Jak Thunderbit ułatwia scrapowanie wiadomości osobom nietechnicznym?
Thunderbit oferuje prosty przepływ oparty na jednym kliknięciu: kliknij One Click Extract, a AI samo rozpozna, co pobrać. Dzięki funkcjom takim jak scraping podstron i natychmiastowy eksport do Excel lub Google Sheets nawet osoby nietechniczne mogą zbudować solidny pipeline danych newsowych w kilka minut.
4. Jakie są kwestie prawne i compliance przy scrapowaniu wiadomości?
Zawsze sprawdzaj regulamin docelowych stron, jeśli to możliwe korzystaj z oficjalnych API lub feedów i respektuj dyrektywy robots.txt. Unikaj scrapowania treści wymagających logowania lub objętych paywallem bez zgody i ograniczaj zbieranie danych osobowych, aby pozostać w zgodzie z przepisami o prywatności.
5. Jak sprawić, by workflow ekstrakcji wiadomości był niezawodny w dłuższym okresie?
Planuj regularne scrape’y, monitoruj jakość ekstrakcji i korzystaj z narzędzi, które dostosowują się do zmian układu strony (jak ekstrakcja oparta na AI w Thunderbit). Usuwaj duplikaty, śledź opóźnienie między publikacją a ekstrakcją i ustaw alerty na błędy lub brakujące pola, aby pipeline pozostał sprawny i aktualny.
Wypróbuj Thunderbit AI Web Scraper Get Started Free
Dowiedz się więcej
- 10 automatycznych narzędzi do web scrapingu, które zaoszczędziły mojemu zespołowi godziny (2026)
- 5 najlepszych programów do scrapowania danych z internetu w 2026
- 15 najlepszych narzędzi do ekstrakcji danych w 2026: ostateczna lista dla każdego zespołu
- Najlepsze scrapery artykułów w 2026: praktyczne porównanie
- Jak opanować automatyczne scrapowanie danych z Thunderbit




