
MarkItDown bardzo często wrzuca się do tego samego worka co web scrapery — i to jest błędne skojarzenie. Nie ma żadnego crawlera, silnika JavaScript ani mechanizmu, który pobiera adres URL i usuwa z niego zbędny kod strony. Jego zadanie jest inne: bierze pliki, które już masz — PDF, dokument Word, arkusz kalkulacyjny, prezentację — i zamienia je w Markdown czytelny dla modelu językowego.
Przez kilka tygodni testowałem Microsoft MarkItDown na prawdziwych dokumentach na jednym Macu, porównując każdą tabelę z manifestem przygotowanym przed startem i mierząc czas każdej konwersji. W skrócie: na czystych danych działa szybko i wiernie, w pakiecie ukrywa jednak 73 MB środowiska ML, którego nikt nie zamawiał, a tabele potrafią się rozsypać w sposób, który przejdzie test typu „czy tekst się zachował?”, ale obleje sprawdzian „czy dane trafiły do właściwej kolumny?”. Poniżej pełny obraz wraz z liczbami.
Czym MarkItDown naprawdę jest
MarkItDown to narzędzie Pythona od Microsoftu, które konwertuje pliki i dokumenty Office do Markdown zoptymalizowanego pod LLM. Wskażesz mu PDF, .docx, .xlsx, .pptx, obraz, plik HTML albo kilka innych formatów, a ono zwróci Markdown. Można z niego korzystać na trzy sposoby: przez CLI (markitdown file.pdf -o out.md albo przez stdin), przez API Pythona (MarkItDown().convert(...)) oraz opcjonalnie przez serwer MCP do workflowów agentowych.
Najważniejsze jest to, czego ten program nie robi — bo README tego nie obiecuje, a ja potwierdziłem to w testach: nie crawluje, nie renderuje JS, nie podąża za linkami, nie przechodzi przez paginację i nie wycina głównej treści w stylu narzędzi readability. To konwerter całego dokumentu. Ty dostarczasz bajty, on je normalizuje. To właśnie ta jedna różnica decyduje, czy to narzędzie pasuje do Twojego stosu, czy nie — dlatego będę do niej wracał.
Samo repozytorium robi wrażenie wg git-hubowych metryk popularności — 165 282 gwiazdki i 11 790 forków w połowie lipca 2026, licencja MIT, a najnowsze wydanie (v0.1.6) pojawiło się 2026-05-26. To jednak przede wszystkim repo Microsoftu korzystające na ogólnym entuzjazmie wobec narzędzi LLM, a nie sygnał dojrzałości samego silnika konwersji. Jest też 833 otwarte zgłoszenia, a część z nich ma znaczenie jeszcze przed instalacją (więcej o tym niżej).
HTML do Markdown: szybko, kompletnie, z boilerplate’em w pakiecie
Ponieważ reszta mojej serii recenzenckiej scraperów używa tych samych czterech testowych stron, podałem MarkItDown identyczne lokalne pliki HTML — nie po to, by oceniać go jak scraper, ale żeby sprawdzić jakość konwersji HTML → Markdown. Na dobrze oznaczonych stronach wypada naprawdę dobrze.
Wszystkie cztery strony przeszły konwersję na podstawowej instalacji bez dodatkowych komponentów, a każdy test obecności treści głównej został zaliczony. Artykuł Wikipedii „Web scraping” (226 KB) wyszedł z wiernie odtworzoną strukturą nagłówków — jeden h1, siedem h2, dwanaście h3, zgodnie z faktycznym układem sekcji — a 418 linków zostało zachowanych jako poprawne [tekst](url). Tabela statystyk hokejowych 25×9 ze strony Scrape This Site forms page została zamieniona w czystą tabelę GFM z 27 wierszami (nagłówek + separator + 26 wierszy danych), łącznie z pustymi komórkami. Prędkość też nie była problemem: mediana od 48 ms dla małej strony z cytatami do 352 ms dla 226 KB Wikipedii.
Jest tu jednak haczyk, i to raczej decyzja projektowa niż błąd. MarkItDown nie usuwa boilerplate’u. Konwertuje całe <body>, więc elementy interfejsu strony trafiają do wyniku — a ilość „szumu” rośnie wraz z tym, ile tego szumu ma sama strona.
| Strona | Liczba znaków w wyjściu | Nagłówki (h1/h2/h3) | Linki | Linie interfejsu strony |
|---|---|---|---|---|
| Books to Scrape | 10,478 | 1 / 0 / 0 | 94 | 0.6% (1/159) |
| Quotes to Scrape | 2,973 | 1 / 1 / 0 | 55 | 1.2% (1/86) |
| ScrapeThisSite forms | 3,385 | 1 / 0 / 0 | 31 | 6.7% (5/75) |
| Wikipedia Web scraping | 60,159 | 1 / 7 / 12 | 418 | 12.4% (42/338) |
Na prawie pozbawionej boilerplate’u stronie Books tylko 0,6% linii wyjściowych to elementy interfejsu. Na Wikipedii to już 12,4% — 42 z 338 niepustych linii to „przejdź do treści”, „pokaż/sprawdź spis treści”, „22 języki”, „pobrano z”, stopki cookie i licencyjne. Te wiki-panele administracyjne („Ten artykuł wymaga dodatkowych przypisów”) są nawet wiernie zamieniane w dwukolumnowe tabele pipe, co daje dziewięć wierszy tabeli na stronie, która nie zawiera żadnej prawdziwej tabeli danych.
To nie jest coś, co MarkItDown robi źle. To konwerter całego dokumentu, a nie ekstraktor czytelnej treści: wierna konwersja HTML do Markdown to zupełnie inne zadanie niż czyste wyciąganie artykułu. Narzędzia w stylu Trafilatura czy Firecrawl zwracają tylko główną treść; MarkItDown oddaje całą stronę. Wewnątrz _html_converter.py usuwa <script> i <style>, a potem przekazuje całe body do biblioteki markdownify — bez żadnej heurystyki wykrywającej treść główną. Jeśli chcesz tylko artykuł, to jest zła warstwa narzędzia.
Naturalne środowisko: PDF, DOCX, XLSX, PPTX
Dokumenty to prawdziwy teren działania MarkItDown. Sprawdziłem go na realnych plikach publicznych — artykule z arXiv z warstwą tekstową, białej księdze Bitcoina, skanowanym PDF-ie bez warstwy tekstowej, który sam wyrenderowałem tak, by nie miał żadnego tekstu, oraz plikach DOCX/XLSX/PPTX z własnego zestawu testowego MarkItDown (z UUID-ami zaszytymi w treści, żebym mógł wykryć ciche gubienie danych).
| Dokument | Wejście | Liczba znaków w wyjściu | Proby | Mediana czasu | Uwagi |
|---|---|---|---|---|---|
| arXiv 1706.03762 (PDF z warstwą tekstową) | 2.2 MB | 40,174 | 7/7 | 3.7 s (warm) | tytuł, „Transformer”, „BLEU”, „References” obecne |
| Whitepaper Bitcoina (PDF, 9 str.) | 184 KB | 22,485 | 6/6 | 1.4 s | „Satoshi Nakamoto”, „proof-of-work”, „Conclusion” obecne |
| Skanowany PDF (bez warstwy tekstowej) | 89 KB | 0 | 0/4 | 15 ms | pusty wynik, bez błędu, bez OCR |
| DOCX (test.docx) | 136 KB | 4,651 | — | 70 ms | nagłówki + tabela GFM; osadzone UUID-y zachowane |
| DOCX z równaniami | 15 KB | 240 | — | 101 ms | Office Math zachowane jako LaTeX |
| XLSX (test.xlsx) | 12 KB | 808 | — | 57 ms | każdy arkusz → ## SheetName + tabela GFM |
| PPTX (test.pptx) | 278 KB | 2,047 | — | 52 ms | znaczniki numerów slajdów, tabele, wykres → tabela |
Odzysk tekstu z PDF-ów z warstwą tekstową był bardzo dobry — 7 z 7 wcześniej zdefiniowanych prób na artykule arXiv „Attention Is All You Need” oraz 6 z 6 na whitepaperze Bitcoina — a żaden z plików Office nie zgubił ani jednego sentinela UUID, więc w testowych fixture’ach maintainerów nie ma cichej utraty danych. Mały, ale ważny plus: ścieżka DOCX (przez mammoth) zachowuje równania Office Math jako LaTeX, zamieniając equations.docx na prawdziwy matematyczny zapis $$...$$. Jeśli karmisz LLM dokumentami Word pełnymi wzorów, to realna, choć niszowa zaleta, której nie znalazłem dobrze opisanej nigdzie indziej.
Dwa wnioski z tego obszaru zasługują na osobne omówienie, bo to one najpewniej Cię zaboleją.
Skanowany PDF, który znika
Jeśli podasz MarkItDown PDF wyłącznie obrazkowy, bez warstwy tekstowej, zwróci pusty ciąg. Zero znaków, bez wyjątku, bez ostrzeżenia — konwersja trwa około 15 ms, bo nie ma czego wyciągać. Ścieżka PDF w MarkItDown robi tylko ekstrakcję tekstu (pod spodem pdfminer i pdfplumber), a OCR nie jest częścią ani instalacji bazowej, ani żadnego dodatkowego pakietu pip.
To ma znaczenie przy pracy wsadowej. Deweloper, który podaje folder PDF-ów, w których część to skany, dostaje dla tych plików po cichu puste wyniki bez żadnego sygnału, że coś pominięto. Sprawdziłem, czy fixture nie był uszkodzony, uruchamiając extract_text z pdfminera bezpośrednio na pliku — wynik był pusty, bez wyciętych znaków, bez warstwy tekstowej, potwierdzone. Puste wyjście to więc prawdziwe zachowanie MarkItDown na prawdziwym skanie. To odtwarza od dawna otwarty brak fallbacku OCR (#1268), który jest od jakiegoś czasu śledzony upstream. Oficjalna ścieżka to opcjonalny backend Azure Document Intelligence albo plugin; żaden z nich nie wchodzi do domyślnej instalacji.
PDF-y wychodzą jako płaski tekst, nie jako struktura
Na obu PDF-ach z warstwą tekstową MarkItDown wygenerował zero znaczników nagłówków Markdown. PDF nie niesie semantycznych tagów nagłówków, a MarkItDown nie zgaduje ich na podstawie wielkości czcionki, więc każda linia trafia do poziomu zwykłej treści. Tekst jest odzyskany dobrze; struktura pozostaje płaska.
To nie tylko mój wynik. Publiczne benchmarki osób trzecich oceniają hierarchię nagłówków PDF w MarkItDown na około 0,0, a wierność tabel na około 0,27 — znacznie poniżej 0,88 osiąganych przez Docling z TableFormer (zob. porównanie MarkItDown vs Docling vs Marker oraz benchmark READoc). Moje testy to potwierdzają, a to wzmacnia wiarygodność wyniku — moje liczby zgadzają się z danymi z zewnętrznego źródła. Ten sam zestaw benchmarków pokazuje też, że MarkItDown działa około 100× szybciej niż Docling, co pokrywa się z moimi czasami liczonymi w sekundach, a nie minutach, na dokumentach, które narzędzia oparte o modele układu przetwarzają przez długie minuty. Wniosek: MarkItDown daje Ci czysty, szybki tekst z PDF-a, ale nie daje jego struktury. Jeśli muszą przetrwać nagłówki i tabele, właściwą warstwą jest narzędzie typu Docling albo Marker.
Tabele: treść zawsze zostaje, struktura nie zawsze
Tabele są miejscem, gdzie „czy tekst przetrwał?” i „czy dane nadal nadają się do użycia?” rozchodzą się na różne ścieżki, więc zbudowałem macierz 13 przypadków — jedna tabela <table> na przypadek, każdy oceniany względem manifestu przygotowanego przed uruchomieniem — aby dokładnie sprawdzić, które kształty trzymają się kupy, a które się łamią.
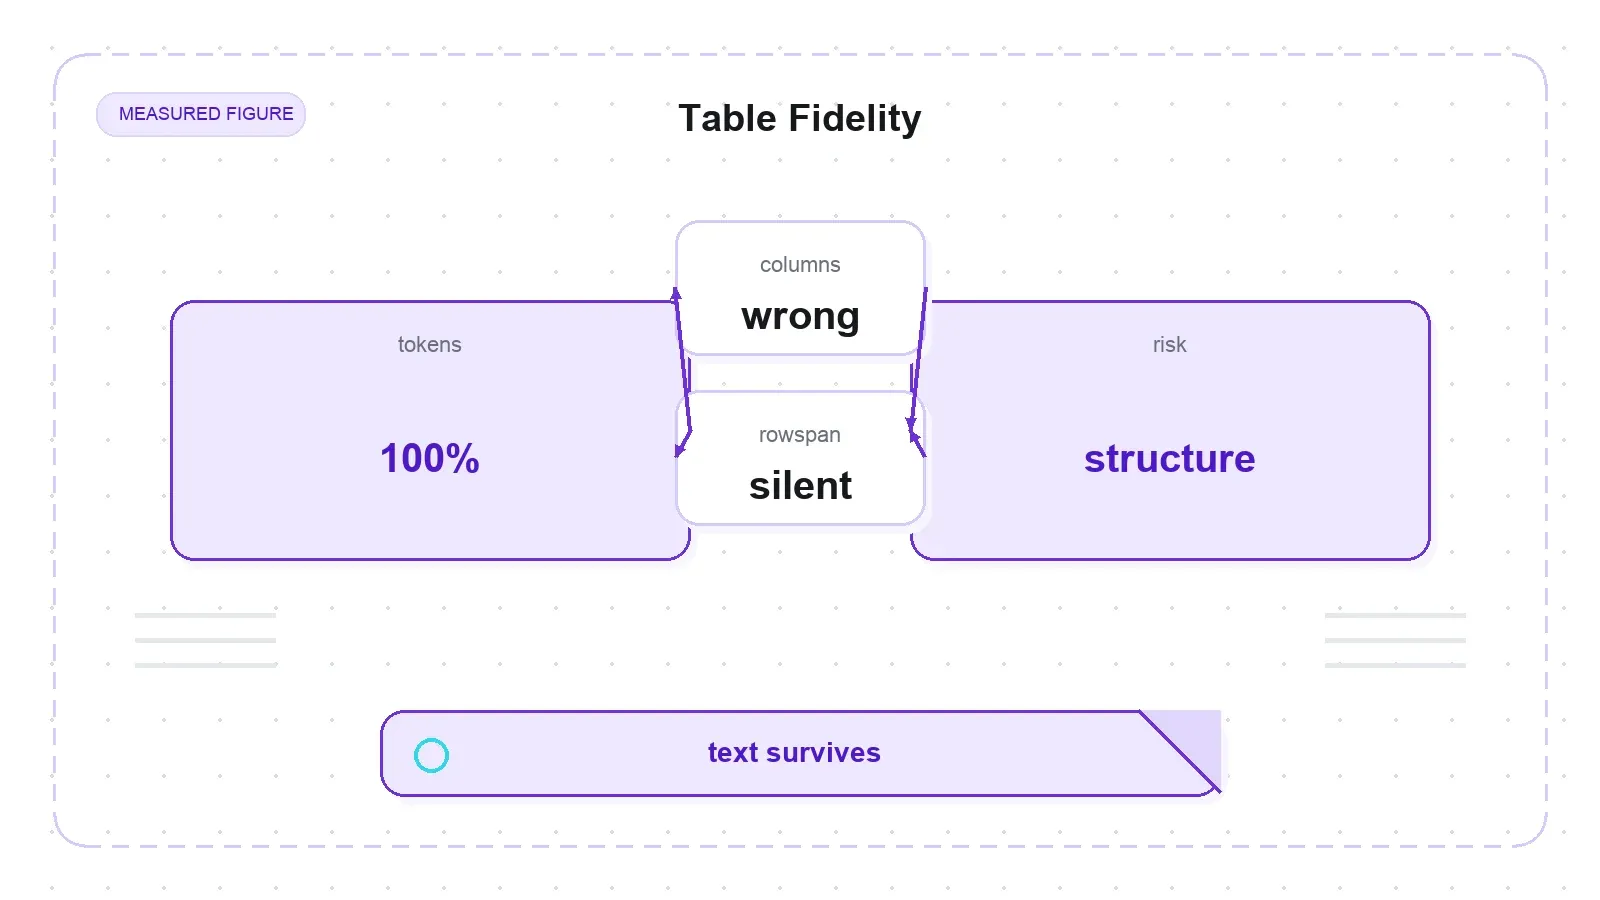
Najkrótsza wersja: MarkItDown nigdy nie zgubił zawartości tabel. We wszystkich 13 przypadkach zachował 100% wcześniej zadeklarowanych tokenów. Wierność strukturalna rozpadła się jednak na trzy sposoby. Siedem z trzynastu przypadków dało poprawną siatkę GFM (zwykła, z colspan w nagłówku, szeroka na 24 kolumny, bez nagłówka, z pustymi komórkami, blok w komórce oraz arabska od prawej do lewej). Cztery wyszły nierówno, bo Markdown nie ma pojęcia o komórkach rozciągniętych — więc rowspan, colspan i źle sformatowane źródła generują krótkie wiersze. A dwa były po prostu zepsute.
Dwa przypadki warto nazwać wprost. Zagnieżdżona tabela (<table> wewnątrz <td>) zostaje spłaszczona inline, a jej własne separatory i linie pipe lądują w komórce nadrzędnej, tworząc śmieciowy wiersz udający 14 kolumn. Z kolei literalny | wewnątrz komórki nie jest escape’owany — tekst a | b zamienia się w dwie kolumny, x || y w trzy — więc tabela dwukolumnowa zaczyna zwracać wiersze z dwiema, trzema i czterema kolumnami, a każdy parser Markdown odczyta przez to złe granice. Co ciekawe, gwiazdki i backticki w komórkach są escape’owane; pipe’y już nie. Przyczyną jest to, że ścieżka HTML w MarkItDown korzysta z domyślnej obsługi tabel w markdownify, a jego własna klasa rozszerzająca nadpisuje linki, obrazy i nagłówki, ale nie komórki tabel. Ten sam błąd z escape’owaniem pipe’ów jest też otwartym problemem dla konwertera CSV (#2019), choć ta poprawka nie dotyczy ścieżki HTML, którą testowałem.
Najbardziej podstępny przypadek — i ten, który najchętniej pokazałbym inżynierowi danych — to rowspan. Przypadek t03 nie tylko wychodzi nierówno; on po cichu rozjeżdża dane. Etykieta z rowspan=2 („Fruit”) pojawia się tylko raz, a wiersz pod nią staje się krótkim, dwukolumnowym wierszem (| Banana | 8 |), więc „Banana” trafia pod kolumnę Group zamiast Item. Każdy token jest obecny. Naiwny konsument czytający „drugą kolumnę” dostaje złą wartość. To właśnie taki błąd przechodzi test zachowania tekstu, a po cichu psuje zbiór danych.
Samo ograniczenie spanów to znane, śledzone założenie projektowe (#1211, #1248) — płaska siatka GFM po prostu nie potrafi wyrazić rozciągniętych ani zagnieżdżonych komórek, więc konwerter wymienia strukturę na kompletność treści. Są też dobre zachowania: tabele bez nagłówka dostają wygenerowany pusty wiersz nagłówka (dzięki czemu żadne dane nie awansują po cichu do nagłówka), puste komórki są zachowane, a <caption> pojawia się jako linia tekstu nad tabelą.
Instalacja i start: podatek, o którym „lekkie narzędzie” nie uprzedza
Nic mnie tu nie zaskoczyło bardziej, i właśnie tutaj narracja o „lekkim narzędziu Pythona” najciszej przecenia możliwości.
Po pierwsze, nie uruchamiaj pip install 'markitdown[all]'. Na Pythonie 3.14 ten wariant po cichu cofa się do markitdown 0.0.2 — wydania sprzed dwóch lat — i odtworzyłem to na żywo w czystym virtualenvie. Próba z przypięciem wersji pokazuje dlaczego: pip install 'markitdown[all]==0.1.6' kończy się błędem, bo dodatkowy pakiet [all] przypina youtube-transcript-api~=1.0.0, a na obecnym PyPI wszystkie buildy z tego zakresu wymagają Pythona <3.14, podczas gdy jedyne buildy zgodne z 3.14 wypadają poza to przypięcie. Resolver cofa się więc aż do ostatniej wersji, której zależności potrafi zaspokoić. To zgadza się z otwartym upstreamowym issue (#2179). Naprawa jest prosta — przypnij wersję i instaluj dodatki osobno: pip install 'markitdown==0.1.6', a potem pip install 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. Każdy z tych wariantów rozwiązuje się poprawnie; tylko wspólny bundle [all] ma toksyczne przypięcie. (To pułapka zależna od wersji Pythona — na Pythonie 3.13 lub starszym blokada może nie zadziałać, więc [all] może rozwiązać się inaczej.)
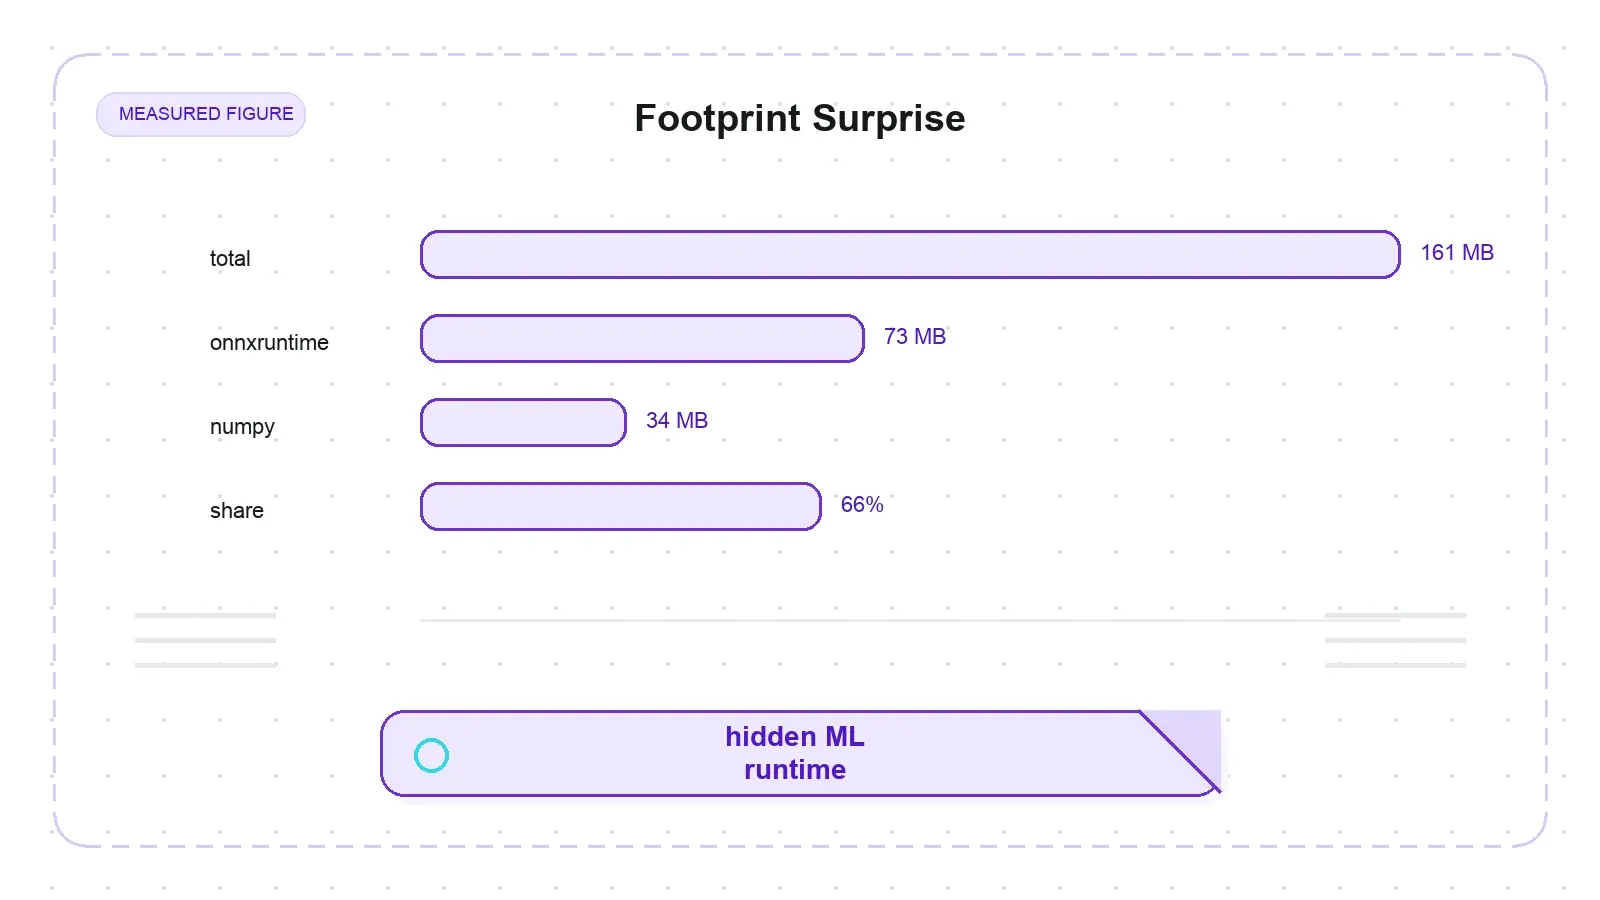
Po drugie, rozmiar instalacji. Core ma 161 MB (13 MB pustego virtualenv + 148 MB dodatków). Z tego onnxruntime (73 MB) i numpy (34 MB) razem zajmują 107 MB — 66% całego śladu bazowego — i oba są wciągane przez jedną twardą zależność: magika, klasyfikator typów plików Google oparty na ML. Czyli konwerter tekstu dostaje w podstawowej instalacji 73 MB runtime’u ONNX, zanim dodasz choć jeden format dokumentu. Po dołożeniu dodatków dokumentowych virtualenv rośnie do 310 MB. To nadal znacznie lżejsze niż stack z headless browserem, ale jeśli spodziewałeś się mikro-narzędzia typu pip install i koniec, pamiętaj, że razem z nim przyjeżdża runtime ONNX.
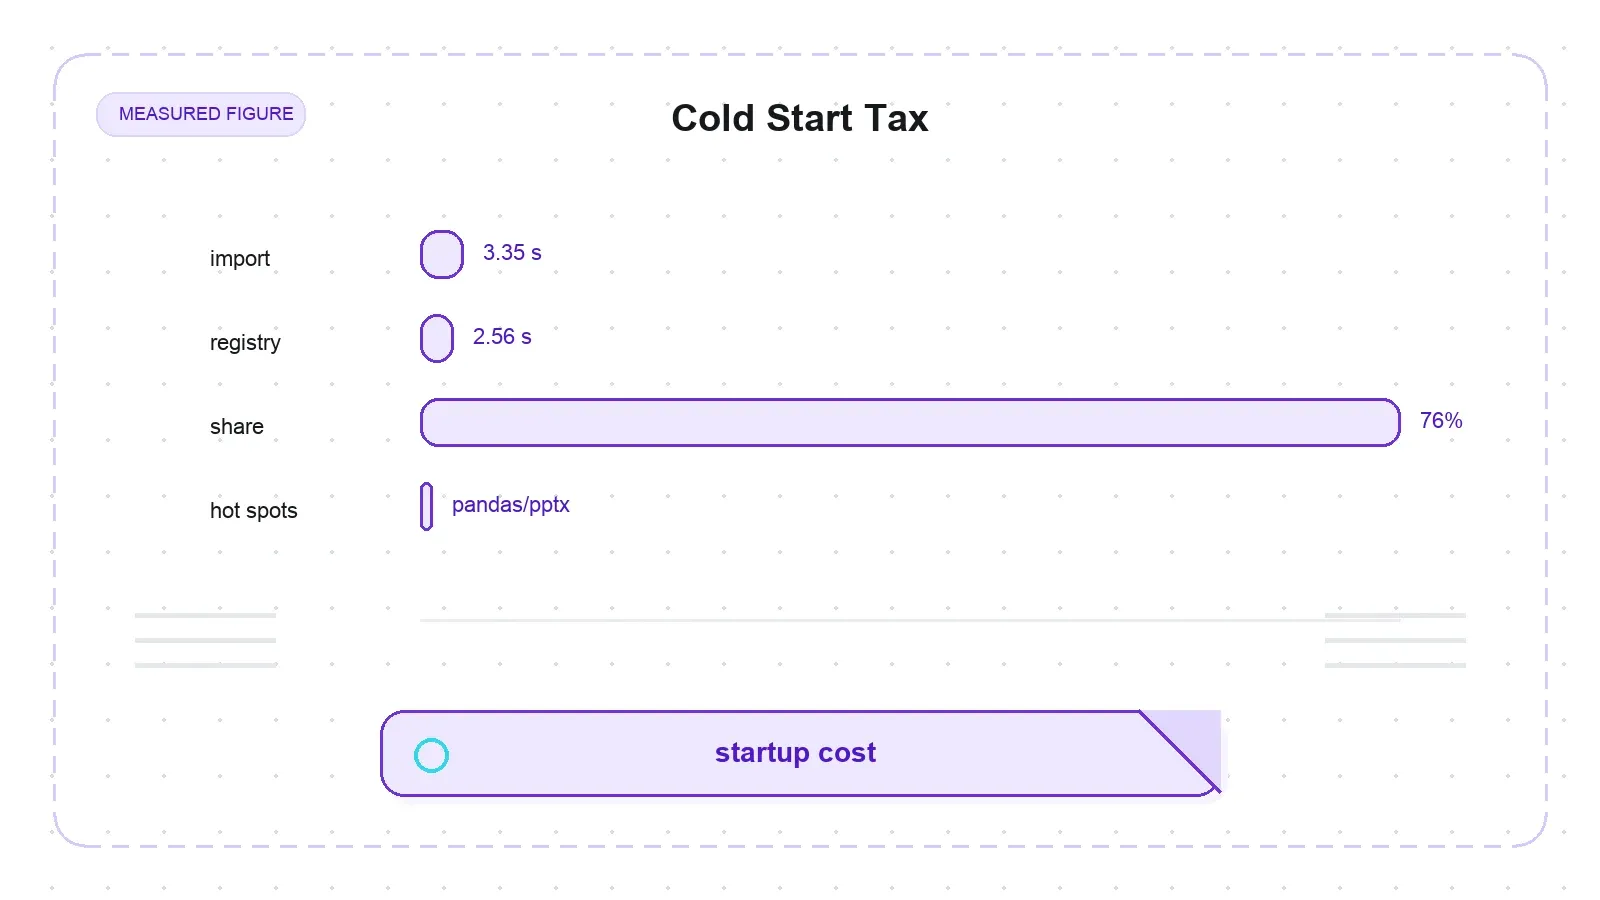
Po trzecie — i to jest jedyny wynik w całym zestawie, który przechodzi wszystkie testy nowości, jakie zrobiłem — nawet po czystej instalacji import markitdown kosztuje na tej maszynie około 3,35 sekundy. Koszt pojawia się niemal w całości przy imporcie: markitdown._markitdown z wyprzedzeniem ładuje cały rejestr konwerterów (łącznie 2,56 s, czyli 76% całości), co wciąga pandas (1,21 s, przez konwerter XLSX), python-pptx (427 ms), magika (354 ms) i requests (270 ms) — niezależnie od tego, czy kiedykolwiek konwertujesz którykolwiek z tych formatów. W długodziałającym serwisie ten koszt się amortyzuje i nie ma większego znaczenia. W przypadku jednorazowego wywołania CLI albo cold startu serverless to realny podatek nakładany na każdy proces, którego etykieta „lekkie narzędzie” wcale nie sugeruje. (Uczciwe zastrzeżenie: to pojedynczy profilowany przebieg, potraktowany jako jedna obserwacja, a nie pełny rozkład z wielu uruchomień.)
Skala: nie wywala się, ale do PDF-ów rezerwuj CPU, a do arkuszy pamięć
Przepchnąłem przez niego cztery duże przypadki, każdy w osobnym procesie, żeby szczytowe zużycie pamięci nie było zniekształcone poprzednim uruchomieniem. Nic się nie wysypało. Profil kosztów jest jednak wyraźnie nierówny.
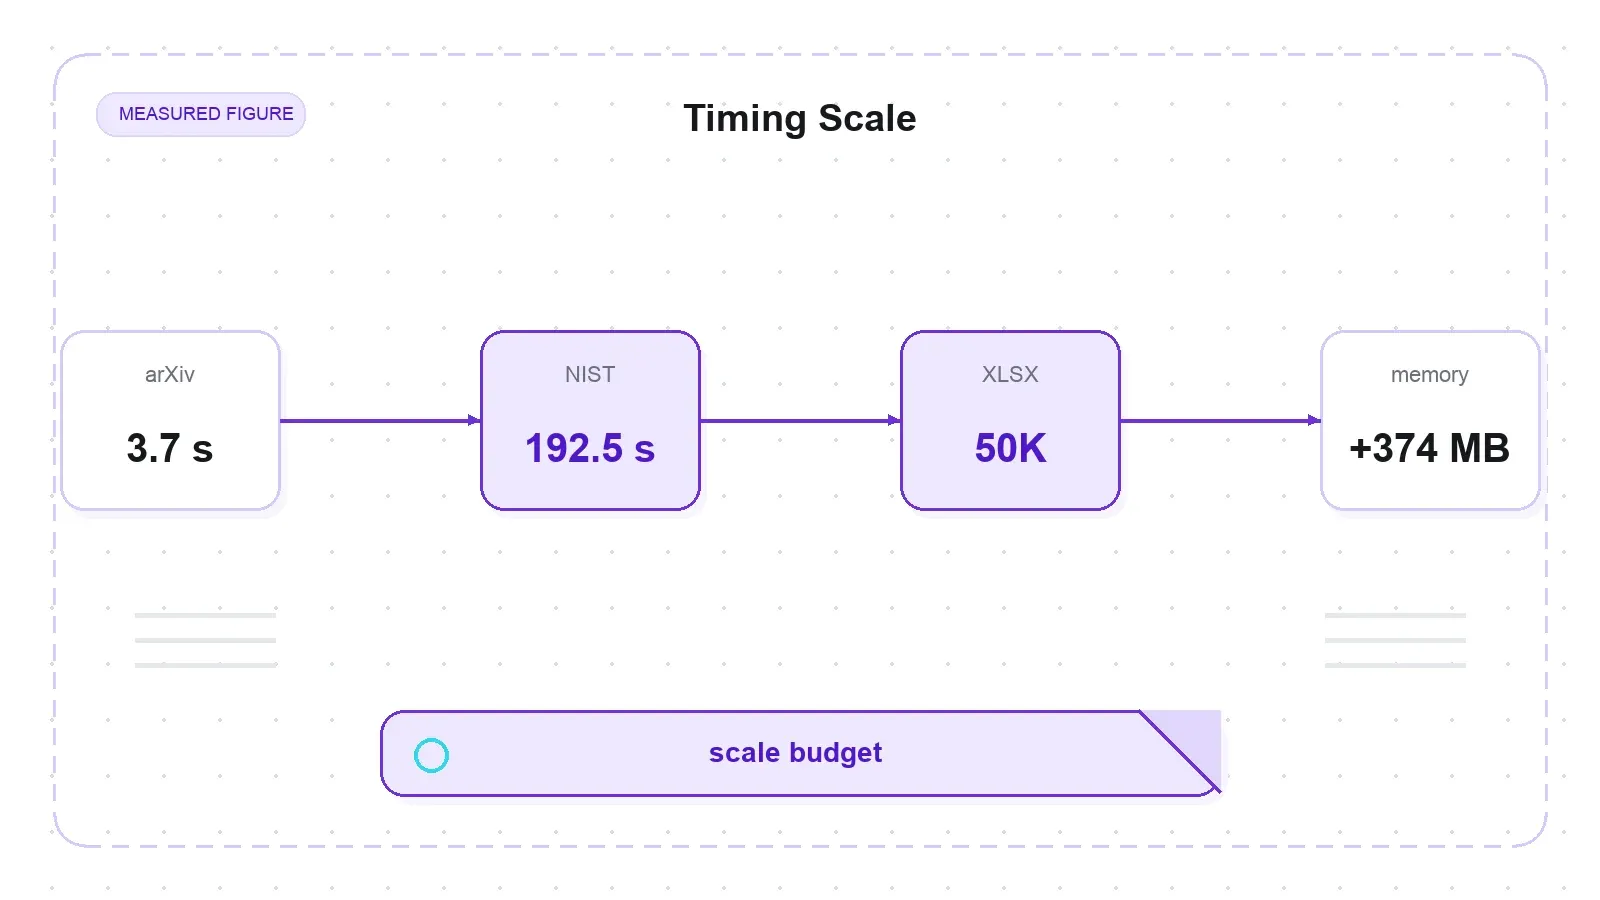
| Przypadek | Wejście | Liczba znaków w wyjściu | Mediana czasu | Szczytowy wzrost RSS |
|---|---|---|---|---|
| NIST SP 800-53r5 (PDF, 492 strony) | 6.07 MB | 1,625,365 | 192.5 s | +40 MB |
| XLSX 50 000 wierszy × 8 kolumn | 2.1 MB | 3,722,955 | 62.1 s | +374 MB |
| arXiv 1706.03762 (~15 stron, PDF) | 2.2 MB | 40,174 | 12.6 s | +25 MB |
| XLSX 200 wierszy × 64 kolumny | 46 KB | 120,129 | 2.9 s | +22 MB |
492-stronicowy PDF NIST zajął medianowo 192,5 sekundy — około 3,2 minuty, czyli 0,39 s na stronę — ponieważ pdfplumber wykonuje wykrywanie formularzy na poziomie pozycjonowania słów dla każdej strony. Szczytowe RSS pozostało na poziomie +40 MB, więc to ograniczenie CPU, nie pamięci. Nawet 15-stronicowy PDF z arXiv potrzebował 12,6 sekundy w osobnym, izolowanym procesie — około 3,4× więcej niż 3,7 sekundy, które ten sam plik osiągnął w trybie warm w moim zestawie dokumentów. Ta różnica pokazuje koszt zimnego procesu i potwierdza, że głównym napędem jest praca per strona, a nie sam rozmiar pliku. Jeśli chcesz jedną przenoszalną wartość dla tego PDF-a, używaj izolowanego 12,6 s.
Ścieżka arkuszy kalkulacyjnych odwraca wąskie gardło. XLSX o wielkości 2,1 MB i 50 000 wierszy urósł do +374 MB szczytowego RSS (i 3,7 mln znaków wyjściowych), ponieważ konwerter wczytuje cały arkusz i buduje jeden duży ciąg Markdown w pamięci. Praktyczna rada jest więc bez ogródek: duże PDF-y = licz w minutach CPU; duże arkusze = licz w setkach MB RAM. To liczby z jednego komputera, na macOS arm64 i Pythonie 3.14, więc stałe per strona i per wiersz są zależne od platformy — ale kształt zależności (PDF jest wolny i CPU-bound, XLSX jest pamięciożerny, nic się nie wywala) już się przenosi.
Gdzie pasuje Thunderbit — a gdzie nie
Wypróbuj Thunderbit do ekstrakcji danych z sieci
To jedno porównanie łatwo byłoby przecenić, więc zaznaczę granicę bardzo precyzyjnie. MarkItDown i Thunderbit rozwiązują sąsiednie problemy, ale nie ten sam.
MarkItDown konwertuje pliki, które już masz. Thunderbit najpierw pobiera stronę. Endpoint Thunderbit /distill zamienia żywą stronę WWW w czysty Markdown gotowy dla LLM — radząc sobie z renderowaniem JS, anty-botami i dynamiczną treścią, z czym MarkItDown nie ma żadnych narzędzi — a endpoint /extract zwraca ustrukturyzowany JSON dopasowany do schematu, a nie sam surowy Markdown. Dla programistów jest to dostępne jako API (POST /distill / POST /extract), serwer MCP i CLI (npx @thunderbit/thunderbit-cli) oparte na jednym silniku AI, tym samym, który stoi za rozszerzeniem z ponad 100 000 użytkowników.
Nakładają się więc tylko w jednym punkcie — oba potrafią zwrócić „Markdown gotowy dla LLM” — ale domena wejściowa jest inna: Thunderbit distill bierze URL z otwartej sieci, a MarkItDown bierze plik lokalny. To nie są zamienniki 1:1 i nie będę udawał, że są. Realny stos wykorzystuje oba: Thunderbit (albo usługę w stylu Firecrawl) do pobierania i crawlowania sieci, a MarkItDown do normalizacji mieszanki lokalnych dokumentów, które też masz — PDF-ów, prezentacji i arkuszy. Jeden obsługuje sieć, drugi szufladę z plikami.
Zalety i wady
Mocne strony
- Pełny odzysk treści z czystego HTML (4/4 strony), z wiernie zachowaną strukturą nagłówków i linkami
- Wysoki odzysk tekstu z PDF/DOCX (arXiv 7/7 prób, Bitcoin 6/6) i brak cichej utraty danych na własnych fixture’ach Office
- Równania Office Math zachowane jako LaTeX — bardzo przydatna nisza
- Na żadnym dużym przypadku nie doszło do awarii, nawet przy PDF-ie 492-stronicowym i XLSX z 50 tys. wierszy
- Bardzo proste w użyciu: CLI,
convert(), stdin, opcjonalny serwer MCP - Licencja MIT, aktywnie utrzymywany przez Microsoft, responsywny tracker zgłoszeń
Słabe strony
- Zachowuje boilerplate — na Wikipedii nawet do 12,4% linii to elementy interfejsu; nie jest ekstraktorem artykułów
- Tabele psują się przy spaniach, zagnieżdżeniu i pipe’ach wewnątrz komórek (2/13 zepsute, 4/13 nierówne), a rowspan może po cichu przesunąć dane do złej kolumny
- PDF-y skanowane/obrazkowe zwracają pusty wynik, bez OCR i bez błędu
- Wyjście z PDF-a nie ma żadnej struktury nagłówków (zgodne z publicznymi benchmarkami)
- 161 MB instalacji bazowej z runtime’em ONNX 73 MB; około 3,35 s zimnego importu
- Dodatkowy pakiet
[all]po cichu cofa się do starego 0.0.2 na Pythonie 3.14
Kto powinien go używać, a kto nie
Sięgaj po MarkItDown, jeśli chcesz ujednolicić zestaw lokalnych dokumentów — Word, Excel, PowerPoint, PDF-y z warstwą tekstową — do Markdown dla pipeline’u LLM i zależy Ci bardziej na pełnej treści niż na zachowaniu struktury. Jako końcowy konwerter w zadaniu wsadowym, który karmi model czystym tekstem, jest szybki, wierny i darmowy.
Pomiń go albo połącz z czymś innym, jeśli Twoje zadanie należy do którejś z tych kategorii: potrzebujesz tylko głównego artykułu ze strony WWW (użyj narzędzia readability albo w stylu Firecrawl); chcesz, żeby nagłówki i tabele w PDF-ie przetrwały w nienaruszonej formie (to domena Docling albo Marker); albo Twoje źródła obejmują skanowane dokumenty wymagające OCR (potrzebny będzie backend Azure albo zupełnie inne narzędzie). A jeśli myślałeś, że kupujesz scraper — coś, co pobiera strony i crawluje — to w ogóle nie to.
Wstępny scoring, który wykonałem na rubricy przypominającej scraper, daje MarkItDown wynik 60/100, ale to niski rezultat wynikający z oceniania konwertera testem dla crawlera. Na swoim własnym terenie ma wysoką jakość odzysku tekstu; słabe punkty są strukturalne (tabele, nagłówki PDF) i pakietowe (rozmiar, import, pułapka [all]), a nie związane z jakością tekstu. Oceniaj go za to, czym jest — konwerter plików do Markdown — a dostaniesz solidne, dobrze utrzymane narzędzie z kilkoma ostrymi krawędziami, o których warto wiedzieć, zanim włączysz je do produkcji.
Najczęściej zadawane pytania
Czy MarkItDown jest web scraperem?
Nie. Nie ma crawlera, renderowania JavaScript, podążania za linkami ani paginacji. Konwertuje pliki i dokumenty, które już masz — PDF, DOCX, XLSX, PPTX, obrazy, HTML — do Markdown. Jeśli chcesz pobierać i crawlować strony WWW na żywo, potrzebujesz narzędzia do scrapingu, takiego jak Thunderbit albo Firecrawl; MarkItDown to etap późniejszy, który zamienia pobrane lub lokalne pliki w czysty Markdown.
Dlaczego pip install markitdown[all] instaluje starą wersję?
Na Pythonie 3.14 wariant [all] przypina youtube-transcript-api~=1.0.0, a każdy build w tym zakresie wymaga Pythona poniżej 3.14. Resolver nie może spełnić tego przypięcia, więc po cichu cofa się do markitdown 0.0.2, wydania sprzed dwóch lat. Rozwiązanie to przypięcie wersji i instalowanie dodatków osobno: pip install 'markitdown==0.1.6', a potem dodanie 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. Problem jest śledzony w issue #2179.
Czy MarkItDown robi OCR na skanowanych PDF-ach?
Nie w domyślnej instalacji. Ścieżka PDF robi tylko ekstrakcję tekstu, więc PDF wyłącznie obrazkowy, bez warstwy tekstowej, zwraca pusty ciąg — bez błędu i bez ostrzeżenia. OCR wymaga opcjonalnego backendu Azure Document Intelligence albo pluginu, z których żaden nie jest instalowany domyślnie. To od dawna śledzona luka (issue #1268).
Jak dobrze MarkItDown radzi sobie z tabelami?
Pod względem treści bardzo dobrze — w moim teście 13 przypadków zachował 100% treści tabel w każdym wariancie. Pod względem struktury zależy od kształtu: proste, szerokie, beznagłówkowe i z pustymi komórkami tabele wychodzą jako czyste siatki GFM, ale rowspan i colspan robią się nierówne (a rowspan może po cichu przesunąć dane do złej kolumny), zagnieżdżone tabele spłaszczają się do śmieciowych wierszy, a literalne znaki pipe wewnątrz komórek nie są escape’owane. Płaski format tabel Markdown po prostu nie umie odwzorować spanów ani zagnieżdżeń.
Czy MarkItDown jest wystarczająco szybki dla dużych dokumentów?
Nie wywala się na dużych plikach, ale trzeba planować zasoby zależnie od typu. PDF o 492 stronach zajął około 3,2 minuty (mniej więcej 0,39 s na stronę), bo robi wykrywanie formularzy dla każdej strony, i jest ograniczony CPU. Arkusz 50 000 wierszy zakończył się w około minutę, ale zużył +374 MB RAM, bo buduje w pamięci jeden duży ciąg Markdown. Dla dużych PDF-ów planuj minuty CPU; dla dużych arkuszy planuj setki MB RAM.
Wypróbuj Thunderbit do ekstrakcji danych z sieci Get Started Free




