
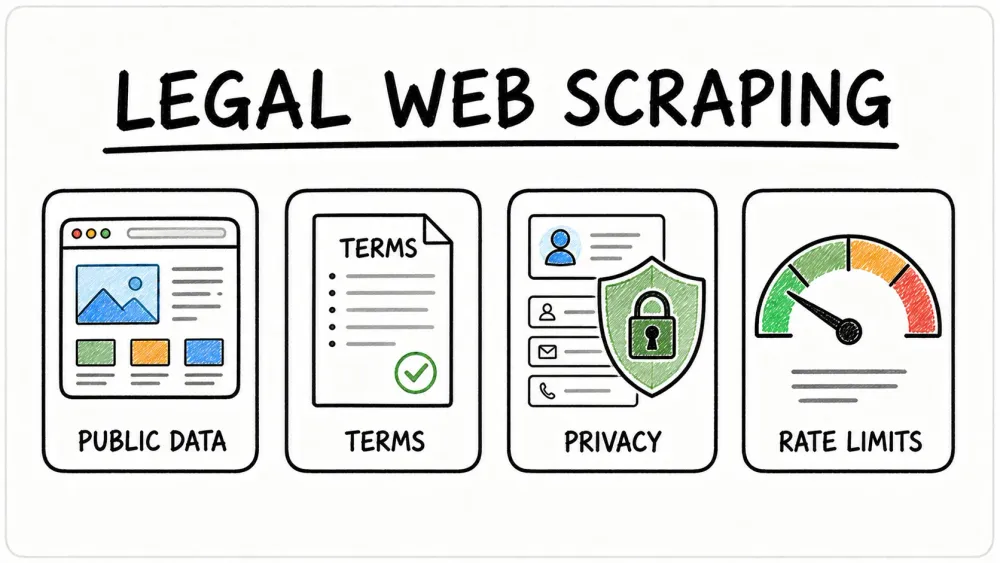
„czy pobieranie danych ze stron internetowych jest legalne” — to pytanie za milion dolarów, które niemal co tydzień słyszę od zespołów sprzedaży, operacji i marketingu. Skoro web scraping napędza dziś wszystko — od pozyskiwania leadów po analizę konkurencji — nic dziwnego, że wszyscy chcą dostać jasną odpowiedź. Tyle że rzeczywistość? Krajobraz prawny jest mniej przejrzysty niż filiżanka wczorajszej kawy. Wystarczy spojrzeć na nagłówki: jeden sąd uznaje pobieranie publicznych danych za dopuszczalne, a inny ostrzega przed „bezprawnym pozyskiwaniem danych”. Nic dziwnego, że tak wiele zespołów obawia się przekroczenia granicy.
Jest jednak pewien fakt: już ponad dwie trzecie organizacji korzysta z web scrapingu do zasilania analiz i projektów AI, a aż 78% firm e-commerce wykorzystuje go do analizy cen. Ale przy głośnych sprawach sądowych, takich jak LinkedIn kontra hiQ Labs, stawka nigdy nie była wyższa. Jak więc korzystać z wartości danych z sieci — i jednocześnie nie wpakować się w kłopoty prawne? Rozłóżmy na czynniki pierwsze ramy prawne, checklisty zgodności i dobre praktyki, które powinien znać każdy użytkownik biznesowy. A tak, pokażę też, jak Thunderbit sprawia, że zgodne z przepisami scrapowanie staje się dużo prostsze.
Zrozumieć krajobraz prawny: czy pobieranie danych ze stron internetowych jest legalne?
Wypróbuj zgodny z przepisami Web Scraper od Thunderbit Agentowy Web Scraper Thunderbit sam odczytuje publiczne strony i wyciąga dane jednym kliknięciem, z myślą o zespołach dbających o zgodność. Get Started Free
Przejdźmy od razu do sedna: legalność web scrapingu zależy od tego, co pobierasz, w jaki sposób to robisz i w jakim kraju działasz. Nie ma jednego uniwersalnego prawa, które mówiłoby „scraping jest legalny” albo „scraping jest nielegalny”. Zamiast tego masz do czynienia z mozaiką przepisów — od ustaw antyhakerskich, przez regulacje prywatności, po prawo autorskie, a nawet regulaminy serwisów (Thunderbit Blog).
Oto najważniejsze czynniki, które decydują o tym, czy Twój projekt mieści się w granicach prawa:
- Dane publiczne vs. prywatne: Pobieranie danych dostępnych dla wszystkich (bez logowania i bez paywalla) jest zazwyczaj bezpieczniejsze. Jeśli próbujesz dostać się do treści za logowaniem, wchodzisz na znacznie bardziej ryzykowny grunt.
- Rodzaj danych: Dane osobowe (np. imiona, e-maile, profile społecznościowe) oraz treści chronione prawem autorskim (artykuły, obrazy) są dużo bardziej ryzykowne niż pobieranie informacji faktograficznych (ceny, specyfikacje produktów, wpisy firm).
- Cel wykorzystania: Korzystanie z danych wewnętrznie — do analiz lub badań — jest zwykle mniej ryzykowne niż ich publikowanie lub odsprzedawanie.
- Zgodność z zasadami serwisu: Naruszenie regulaminu strony lub zignorowanie pliku robots.txt może skończyć się problemami — nawet jeśli dane są publiczne.
- Podejście techniczne: Pobieranie w tempie zbliżonym do ludzkiego oraz niewyłączanie zabezpieczeń, takich jak CAPTCHA czy blokady IP, wzmacnia Twoją pozycję.
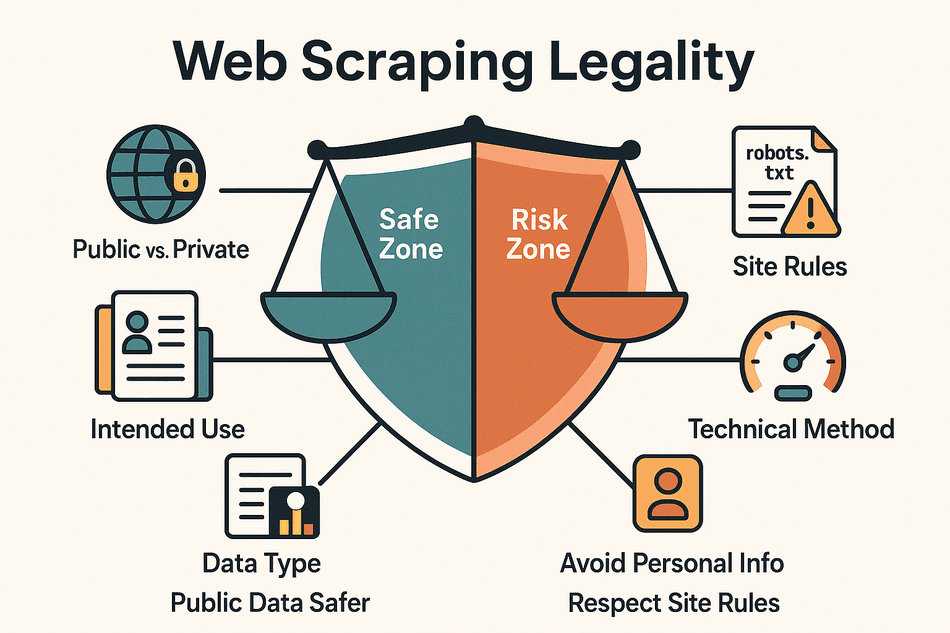
 Wniosek? Pobieranie publicznych, nieosobowych danych do użytku wewnętrznego jest szeroko akceptowane w wielu regionach, ale istnieją ważne wyjątki — szczególnie w obszarze prywatności, praw autorskich i agresywnego scrapingu (Thunderbit Blog).
Ramy prawne pobierania danych: przegląd najważniejszych regulacji na świecie
 Zróbmy szybki przegląd głównych ram prawnych dotyczących web scrapingu na świecie:
Stany Zjednoczone: CFAA, prawa autorskie i umowy
- Computer Fraud and Abuse Act (CFAA): Ta ustawa antyhakerska zakazuje dostępu do systemów komputerowych „bez upoważnienia”. Jednak sądy doprecyzowały, że pobieranie danych z publicznych stron nie narusza CFAA, ponieważ nie wymaga „upoważnienia” (California Lawyers Association).
- Przełomowa sprawa: W sprawie hiQ Labs v. LinkedIn dziewiąty okręg orzekł, że pobieranie publicznych profili LinkedIn nie stanowiło naruszenia CFAA. LinkedIn mógł jednak nadal wystąpić z roszczeniem o naruszenie umowy (czyli regulaminu) albo praw autorskich.
- Inne ryzyka: Jeśli scrapujesz zbyt agresywnie — jak bot w sprawie eBay v. Bidder’s Edge, który wysyłał 100 000 zapytań dziennie — możesz narazić się na zarzut „trespass to chattels”, czyli zakłócania działania cudzych serwerów (Wikipedia).
Unia Europejska: RODO i prawa do baz danych
- RODO: Ogólne rozporządzenie o ochronie danych obowiązuje także w przypadku publicznie dostępnych danych osobowych. Jeśli pobierasz informacje, które pozwalają zidentyfikować osobę, potrzebujesz podstawy prawnej (np. zgody albo prawnie uzasadnionego interesu) i musisz przestrzegać surowych zasad ochrony prywatności.
- Dyrektywa o bazach danych: UE chroni również całe bazy danych. Pobranie „istotnej części” uporządkowanej bazy (np. wszystkich ofert z serwisu nieruchomości) może naruszyć prawa do bazy danych — nawet jeśli pojedyncze fakty nie są objęte prawem autorskim (Thunderbit Blog).
Wielka Brytania: UK GDPR i Data Protection Act
- UK GDPR: Po Brexicie brytyjskie przepisy są zbliżone do unijnych. Pobieranie publicznych, nieosobowych danych jest zazwyczaj w porządku, ale scraping danych osobowych jest ściśle regulowany.
- Computer Misuse Act: Podobnie jak CFAA, ta ustawa może uznać nieuprawniony dostęp za przestępstwo.
Chiny: PIPL i ustawa o bezpieczeństwie danych
- Personal Information Protection Law (PIPL): Wymaga zgody na zbieranie danych osobowych. Pobieranie z chińskich stron informacji o osobach bez pozwolenia to poważne naruszenie.
- Data Security Law: Wykorzystywana do zwalczania scrapingu, który szkodzi właścicielom danych lub prowadzi do nieuczciwej konkurencji.
Inne regiony
- Kanada, Australia, APAC: Większość z nich ma przepisy antyhakerskie i regulacje prywatności podobne do tych z UE i Wielkiej Brytanii. Zawsze sprawdzaj lokalne prawo przed rozpoczęciem scrapingu.
Najważniejszy wniosek: Najbezpieczniejszą opcją jest pobieranie publicznych, nieosobowych danych do użytku wewnętrznego i zawsze sprawdzanie przepisów obowiązujących w Twoim regionie (Thunderbit Blog).
Checklista zgodności: jak upewnić się, że pobieranie danych jest legalne?
Zanim zaczniesz scrapować, przejdź przez tę checklistę zgodności:
- Przeczytaj regulamin strony: Jeśli regulamin mówi „brak scrapingu”, lepiej się wycofać albo najpierw poprosić o zgodę (Thunderbit Blog).
- Trzymaj się danych publicznych: Nie pobieraj niczego zza logowania ani paywalla bez wyraźnej autoryzacji.
- Sprawdź robots.txt: Wejdź na
site.com/robots.txt, aby zobaczyć, czy botom nie zabroniono dostępu do konkretnych sekcji. Choć nie jest to dokument prawnie wiążący, warto go respektować. - Unikaj danych osobowych: Nie pobieraj imion, e-maili ani innych danych osobowych, jeśli nie masz podstawy prawnej i planu ochrony prywatności.
- Nie kopiuj treści kreatywnych: Trzymaj się faktów i danych liczbowych. Republikowanie artykułów, obrazów czy dużych fragmentów treści może wywołać roszczenia z tytułu praw autorskich.
- Korzystaj z oficjalnych API, jeśli są dostępne: Jeśli strona udostępnia API, użyj go — to bezpieczniejsze i zwykle stabilniejsze.
- Scrapuj delikatnie: Nie obciążaj serwerów. Pobieraj dane w tempie zbliżonym do ludzkiego i nie omijaj zabezpieczeń technicznych.
- Dokumentuj proces: Zapisuj, co pobrałeś, kiedy i dlaczego. To pomaga, jeśli później pojawią się pytania.
- Bądź gotowy przestać: Jeśli otrzymasz wezwanie do zaprzestania działań, natychmiast zatrzymaj scraping i oceń sytuację ponownie.
Zgodne z przepisami praktyki scrapingu w Thunderbit: bezpieczniejsze i bardziej niezawodne pobieranie danych
Gdy tworzyliśmy Thunderbit, zgodność z przepisami była priorytetem. Oto jak Thunderbit pomaga działać po właściwej stronie prawa:
- Scraping w przeglądarce: Thunderbit pobiera wyłącznie to, co widzisz w przeglądarce — bez ukrytych wywołań API i bez obchodzenia logowania. Jeśli czegoś nie widać, Thunderbit tego nie pobierze (Thunderbit Blog).
- Wbudowane ostrzeżenia: Jeśli spróbujesz scrapować stronę z ostrą polityką antyscrapingową, Thunderbit wyświetli ostrzeżenie. To jak mieć eksperta ds. zgodności tuż za plecami.
- Ekstrakcja jednym kliknięciem: AI Thunderbit analizuje stronę i proponuje tylko istotne pola — dzięki czemu łatwiej uniknąć przypadkowego pobrania wrażliwych lub zbędnych danych (Thunderbit Blog).
- Tempo jak u człowieka: Niezależnie od tego, czy scrapujesz lokalnie, czy w chmurze, Thunderbit działa w tempie, które nie przeciąża serwerów.
- Brak przechowywania danych na naszych serwerach: Zebrane dane trafiają bezpośrednio do Ciebie — Thunderbit nie zachowuje ich kopii, co świetnie wspiera zgodność z wymogami prywatności.
- Eksporty przyjazne zgodności: Eksportuj dane bezpośrednio do Google Sheets, Excel, Airtable lub Notion — idealnie do użytku wewnętrznego.
- Obsługa podstron i paginacji: Thunderbit porusza się po serwisie jak prawdziwy użytkownik, klikając kolejne strony i podstrony bez brutalnego odpytywania endpointów.
- Zadania cykliczne z umiarem: Ustaw harmonogram scrapingu w rozsądnych odstępach, żeby nie bombardować strony co minutę.
- Obsługa wielu języków: Interfejs Thunderbit jest dostępny w 55 językach w Chrome Web Store, więc komunikaty o zgodności i podpowiedzi pól są czytelne także dla zespołów nieanglojęzycznych (Chrome Web Store listing).
Krótko mówiąc, Thunderbit „wbudowuje zgodność w produkt”, dzięki czemu prowadzi użytkowników do odpowiedzialnego scrapingu — nawet jeśli nie są ekspertami prawnymi (Thunderbit Blog).
Wypróbuj Thunderbit do zgodnego z przepisami web scrapingu Zainstaluj darmowe rozszerzenie Chrome Thunderbit i wyciągaj dane z dowolnej publicznej strony jednym kliknięciem. Get Started Free
Pobieranie danych a ponowne wykorzystanie danych: gdzie przebiegają granice prawne?
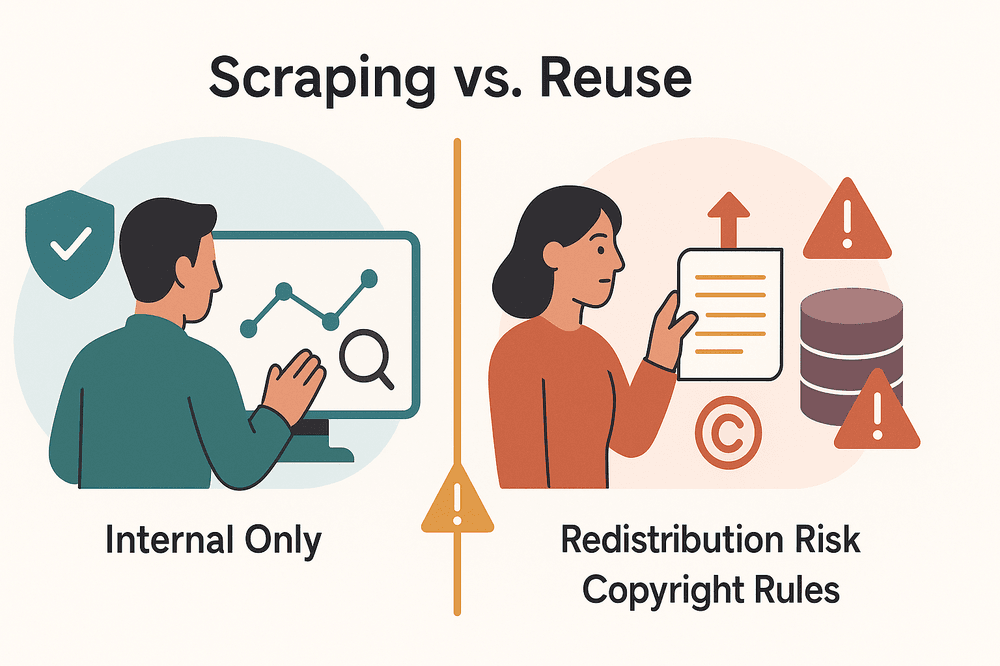 Czym innym jest pobieranie danych do własnego użytku wewnętrznego, a czym innym ich ponowna publikacja, odsprzedaż lub inne wykorzystanie. Oto gdzie granica robi się ostra:
- Użytek wewnętrzny: Pobieranie publicznych danych do wewnętrznej analizy (np. leadów sprzedażowych czy monitorowania cen) jest zazwyczaj bezpieczne — o ile nie pobierasz danych osobowych i nie naruszasz przepisów o prywatności.
- Dystrybucja lub odsprzedaż: Ponowna publikacja pobranych danych (na Twojej stronie, w produkcie lub ich sprzedaż) może uruchomić roszczenia z tytułu praw autorskich, praw do baz danych lub naruszenia umowy.
- Prawo autorskie i prawa do baz danych: W USA fakty nie podlegają ochronie prawnoautorskiej, ale już wybór lub układ danych może być chroniony. W UE i Wielkiej Brytanii pobranie „istotnej części” bazy danych może naruszyć sui generis prawa do baz danych.
- Dozwolony użytek: Prawo USA dopuszcza w niektórych przypadkach „fair use” (np. komentarz lub analiza), ale zwykłe kopiowanie i wklejanie dużych fragmentów treści prawie nigdy się w tym nie mieści.
- Podawanie źródła: Jeśli publicznie wykorzystujesz pobrane dane, zawsze podawaj źródło — ale pamiętaj, że sama atrybucja nie legalizuje działania, jeśli naruszasz inne prawa.
- Nie sprzedawaj surowych danych: Sprzedaż nieprzetworzonych, pobranych zbiorów danych jest szczególnie ryzykowna. Wykorzystuj dane do tworzenia wniosków, a nie jako samodzielny produkt.
Wskazówka: Używaj pobranych danych do wewnętrznej analityki i podejmowania decyzji. Jeśli musisz udostępnić je na zewnątrz, zagreguj je lub przekształć i zawsze sprawdź, czy potrzebujesz zgody (Thunderbit Blog).
Studium przypadków z branży: jak ograniczać ryzyko prawne
Przyjrzyjmy się kilku realnym sprawom — bo nic tak nie uczy zgodności jak zobaczenie, co poszło nie tak u innych:
LinkedIn kontra hiQ Labs
- Co się stało: hiQ Labs pobierało publiczne profile LinkedIn, by tworzyć analizy dotyczące rotacji pracowników. LinkedIn próbował to zablokować, ale sąd orzekł, że pobieranie publicznych danych nie narusza CFAA.
- Wniosek: Scraping publicznych danych jest w USA prawnie obronny, ale nadal trzeba uważać na regulamin i roszczenia dotyczące prywatności (California Lawyers Association).
eBay kontra Bidder’s Edge
- Co się stało: Bidder’s Edge agresywnie scrapowało oferty aukcyjne eBay (100 000 zapytań dziennie), naruszając regulamin i robots.txt. Sąd wydał nakaz w sprawie „trespass to chattels”.
- Wniosek: Nawet publiczne dane można pobierać nielegalnie, jeśli robi się to agresywnie lub z naruszeniem jasnych zasad serwisu (Wikipedia).
Facebook (Meta) kontra Power Ventures
- Co się stało: Power Ventures pobierało dane z Facebooka za zgodą użytkowników, ale po tym jak Facebook cofnął dostęp i zablokował ich adresy IP, firma i tak kontynuowała scraping. Sąd uznał to za „nieuprawniony dostęp”.
- Wniosek: Jeśli właściciel serwisu każe Ci przestać, musisz to zrobić — inaczej ryzykujesz naruszenie ustaw antyhakerskich.
Historie sukcesu w zgodności
Wiele serwisów do porównywania cen w UE działa legalnie, pobierając wyłącznie dane faktograficzne, respektując rezygnacje użytkowników i nie kopiując całych baz danych. Brak pozwów przeciwko tym firmom pokazuje, że trzymanie się publicznych, nieosobowych danych i zasad serwisu po prostu działa.
Jak pomaga Thunderbit
Wbudowane ostrzeżenia, limity szybkości i podejście oparte na przeglądarce pomogłyby uniknąć wielu z tych błędów prawnych — ostrzegając użytkowników przed ryzykownymi stronami i domyślnie wymuszając uprzejmy, ostrożny scraping.
Samodzielna checklista zgodności dla biznesowego scrapingu
Oto praktyczna lista kontrolna do Twojego kolejnego projektu:
- Czy dane są publiczne? (Bez logowania)
- Co mówi regulamin strony? (Jakieś klauzule antyscrapingowe?)
- Czy sprawdziłeś robots.txt? (Czy docelowa sekcja jest zablokowana?)
- Czy pobierasz dane osobowe? (Jeśli tak, czy masz plan ochrony prywatności?)
- Czy pobierasz dużą część serwisu? (Unikaj kopiowania całych baz danych)
- Jaki jest cel? (Użytek wewnętrzny = bezpieczniej; publiczne ponowne wykorzystanie = większe ryzyko)
- Czy scrapujesz delikatnie? (Tempo jak u człowieka, bez obchodzenia zabezpieczeń)
- Czy sprawdziłeś, czy jest API? (Jeśli tak, korzystaj z niego)
- Czy jesteś gotowy przestać, jeśli zostaniesz o to poproszony? (Miej plan na cease-and-desist)
- Jak będziesz przechowywać i zabezpieczać dane? (Ogranicz dostęp, chroń prywatność)
- Czy dokumentujesz proces? (Zachowuj zapisy na potrzeby zgodności)
Jeśli na któreś z pytań odpowiadasz „nie” albo masz wątpliwości, zatrzymaj się i wyjaśnij sytuację, zanim pójdziesz dalej (Thunderbit Blog).
Przykładowy workflow zgodnego scrapingu dla użytkowników Thunderbit
 Przejdźmy przez typowy, bezpieczny pod kątem zgodności workflow w Thunderbit:
- Kontrola przed scrapingiem: Otwórz robots.txt i regulamin strony. Brak zakazów scrapingu? Można działać.
- Otwórz Thunderbit: Wejdź na stronę docelową i uruchom rozszerzenie Thunderbit do Chrome.
- Ekstrakcja jednym kliknięciem: Pozwól AI Thunderbit zaproponować odpowiednie, nieosobowe pola. Sprawdź dwa razy, czy nie ma tam danych osobowych, chyba że masz do nich podstawę prawną.
- Dostosuj pola: W razie potrzeby zmień kolumny i typy danych — zbieraj tylko to, czego naprawdę potrzebujesz.
- Scrape: Kliknij „Scrape”. Thunderbit pobiera dane w tempie zbliżonym do ludzkiego, respektując strukturę strony.
- Scraping podstron: Jeśli trzeba, użyj funkcji podstron, aby wzbogacić dane — znów, tylko o informacje publiczne.
- Eksport: Wyślij dane bezpośrednio do Google Sheets, Excel, Airtable lub Notion do analizy wewnętrznej.
- Harmonogram (opcjonalnie): Ustaw cykliczne pobieranie w rozsądnych odstępach — nigdy zbyt często.
- Dokumentacja: Zapisz, co pobrałeś, kiedy i po co.
Interfejs Thunderbit podpowie Ci na każdym etapie, jeśli pojawią się kwestie zgodności — więc nie działasz po omacku.
Dowiedz się więcej o funkcjach zgodności w Thunderbit Darmowy plan obejmuje 6 stron miesięcznie, bez potrzeby podawania karty — to niskoryzykowny sposób na testowanie ekstrakcji z publicznych stron. Get Started Free
Podsumowanie i najważniejsze rekomendacje: jak bezpiecznie i zgodnie wykorzystywać wartość danych
Web scraping to potężne narzędzie wspierające rozwój biznesu — ale nie jest to wolna amerykanka. Krajobraz prawny jest złożony, lecz podstawowe zasady są jasne:
- Pobieraj publiczne, nieosobowe dane do użytku wewnętrznego, kiedy tylko to możliwe.
- Zawsze sprawdzaj regulamin serwisu, robots.txt i odpowiednie przepisy, zanim zaczniesz.
- Unikaj pobierania danych osobowych i treści kreatywnych, jeśli nie masz podstawy prawnej i planu ochrony prywatności.
- Korzystaj z narzędzi przyjaznych zgodności, takich jak Thunderbit, aby prowadziły Cię przez proces i ograniczały ryzyko.
- Dokumentuj działania i bądź gotowy przestać, jeśli zostaniesz o to poproszony.
Jeśli zgodność stanie się nawykiem, możesz wykorzystać potencjał danych z sieci — bez prawnych problemów. A jeśli chcesz zobaczyć, jak łatwy może być zgodny scraping, wypróbuj Thunderbit. Twój dział prawny — i Twoja przyszła wersja — będą Ci wdzięczne.
Po więcej materiałów o web scrapingu, zgodności i automatyzacji zajrzyj na Thunderbit Blog.
Wypróbuj agentowy Web Scraper do zgodnego pobierania danych Get Started Free
FAQ
1. Czy pobieranie danych z każdej strony internetowej jest legalne?
Nie zawsze. Pobieranie publicznych, nieosobowych danych do użytku wewnętrznego jest w wielu regionach zazwyczaj legalne, ale scrapowanie danych osobowych, treści chronionych prawem autorskim lub danych za logowaniem może być ryzykowne albo wręcz nielegalne. Zawsze sprawdź regulamin strony i lokalne przepisy przed rozpoczęciem (Thunderbit Blog).
2. Jaka jest różnica między pobieraniem a ponownym wykorzystaniem danych?
Pobieranie to sam proces zbierania danych; ponowne wykorzystanie oznacza publikowanie, sprzedaż lub inne ich rozpowszechnianie. Użytek wewnętrzny jest znacznie bezpieczniejszy. Republikowanie lub sprzedawanie pobranych danych może uruchomić roszczenia z tytułu praw autorskich, praw do baz danych lub naruszenia umowy (Thunderbit Blog).
3. Jak Thunderbit pomaga zachować zgodność?
Thunderbit pobiera tylko to, co widać w przeglądarce, ostrzega przed ryzykownymi stronami, sugeruje odpowiednie (nieosobowe) pola i spowalnia zapytania, aby nie przeciążać serwerów. Nie przechowuje też Twoich danych, a opcje eksportu są nastawione na użytek wewnętrzny (Thunderbit Blog).
4. Co zrobić, jeśli dostanę wezwanie do zaprzestania działań?
Natychmiast zatrzymaj scraping i ponownie oceń projekt. Kontynuowanie po bezpośrednim żądaniu zaprzestania może zamienić szarą strefę prawną w oczywiste naruszenie przepisów antyhakerskich lub warunków umowy (Thunderbit Blog).
5. Czy mogę pobierać dane osobowe, jeśli są publiczne?
Nie bez podstawy prawnej. Przepisy dotyczące prywatności, takie jak GDPR i CCPA, obejmują również publicznie dostępne dane osobowe. Będziesz potrzebować zgody albo silnego prawnie uzasadnionego interesu oraz musisz odpowiedzialnie przetwarzać dane (Thunderbit Blog).
Ten przewodnik ma charakter wyłącznie informacyjny i nie stanowi porady prawnej. W przypadku złożonych lub wysokiego ryzyka projektów skonsultuj się z wykwalifikowanym prawnikiem znającym przepisy o danych i prywatności w Twojej jurysdykcji.
Czytaj więcej




