
Podsumowanie zarządcze
Operatorzy DTC mówią o marce, społeczności, kreacji, retencji i doświadczeniu klienta. Pod tym wszystkim kryje się jednak spokojniejsza rzeczywistość: większość nowoczesnych stron DTC opiera się dziś na zaskakująco podobnym stosie technologicznym. W tym badaniu zaczęliśmy od 1 597 kandydatów na marki DTC, rozpoznaliśmy 1 431 domen i przeprowadziliśmy analizę strony głównej dla 1 238 witryn marek na dzień 11 maja 2026 r. Celem nie było rankingowanie marek. Chodziło o odpowiedź na bardziej praktyczne pytanie operatora: kiedy analizujesz publiczne strony marek widocznych w ekosystemach narzędzi ecommerce, jakie wzorce infrastrukturalne faktycznie się pojawiają?
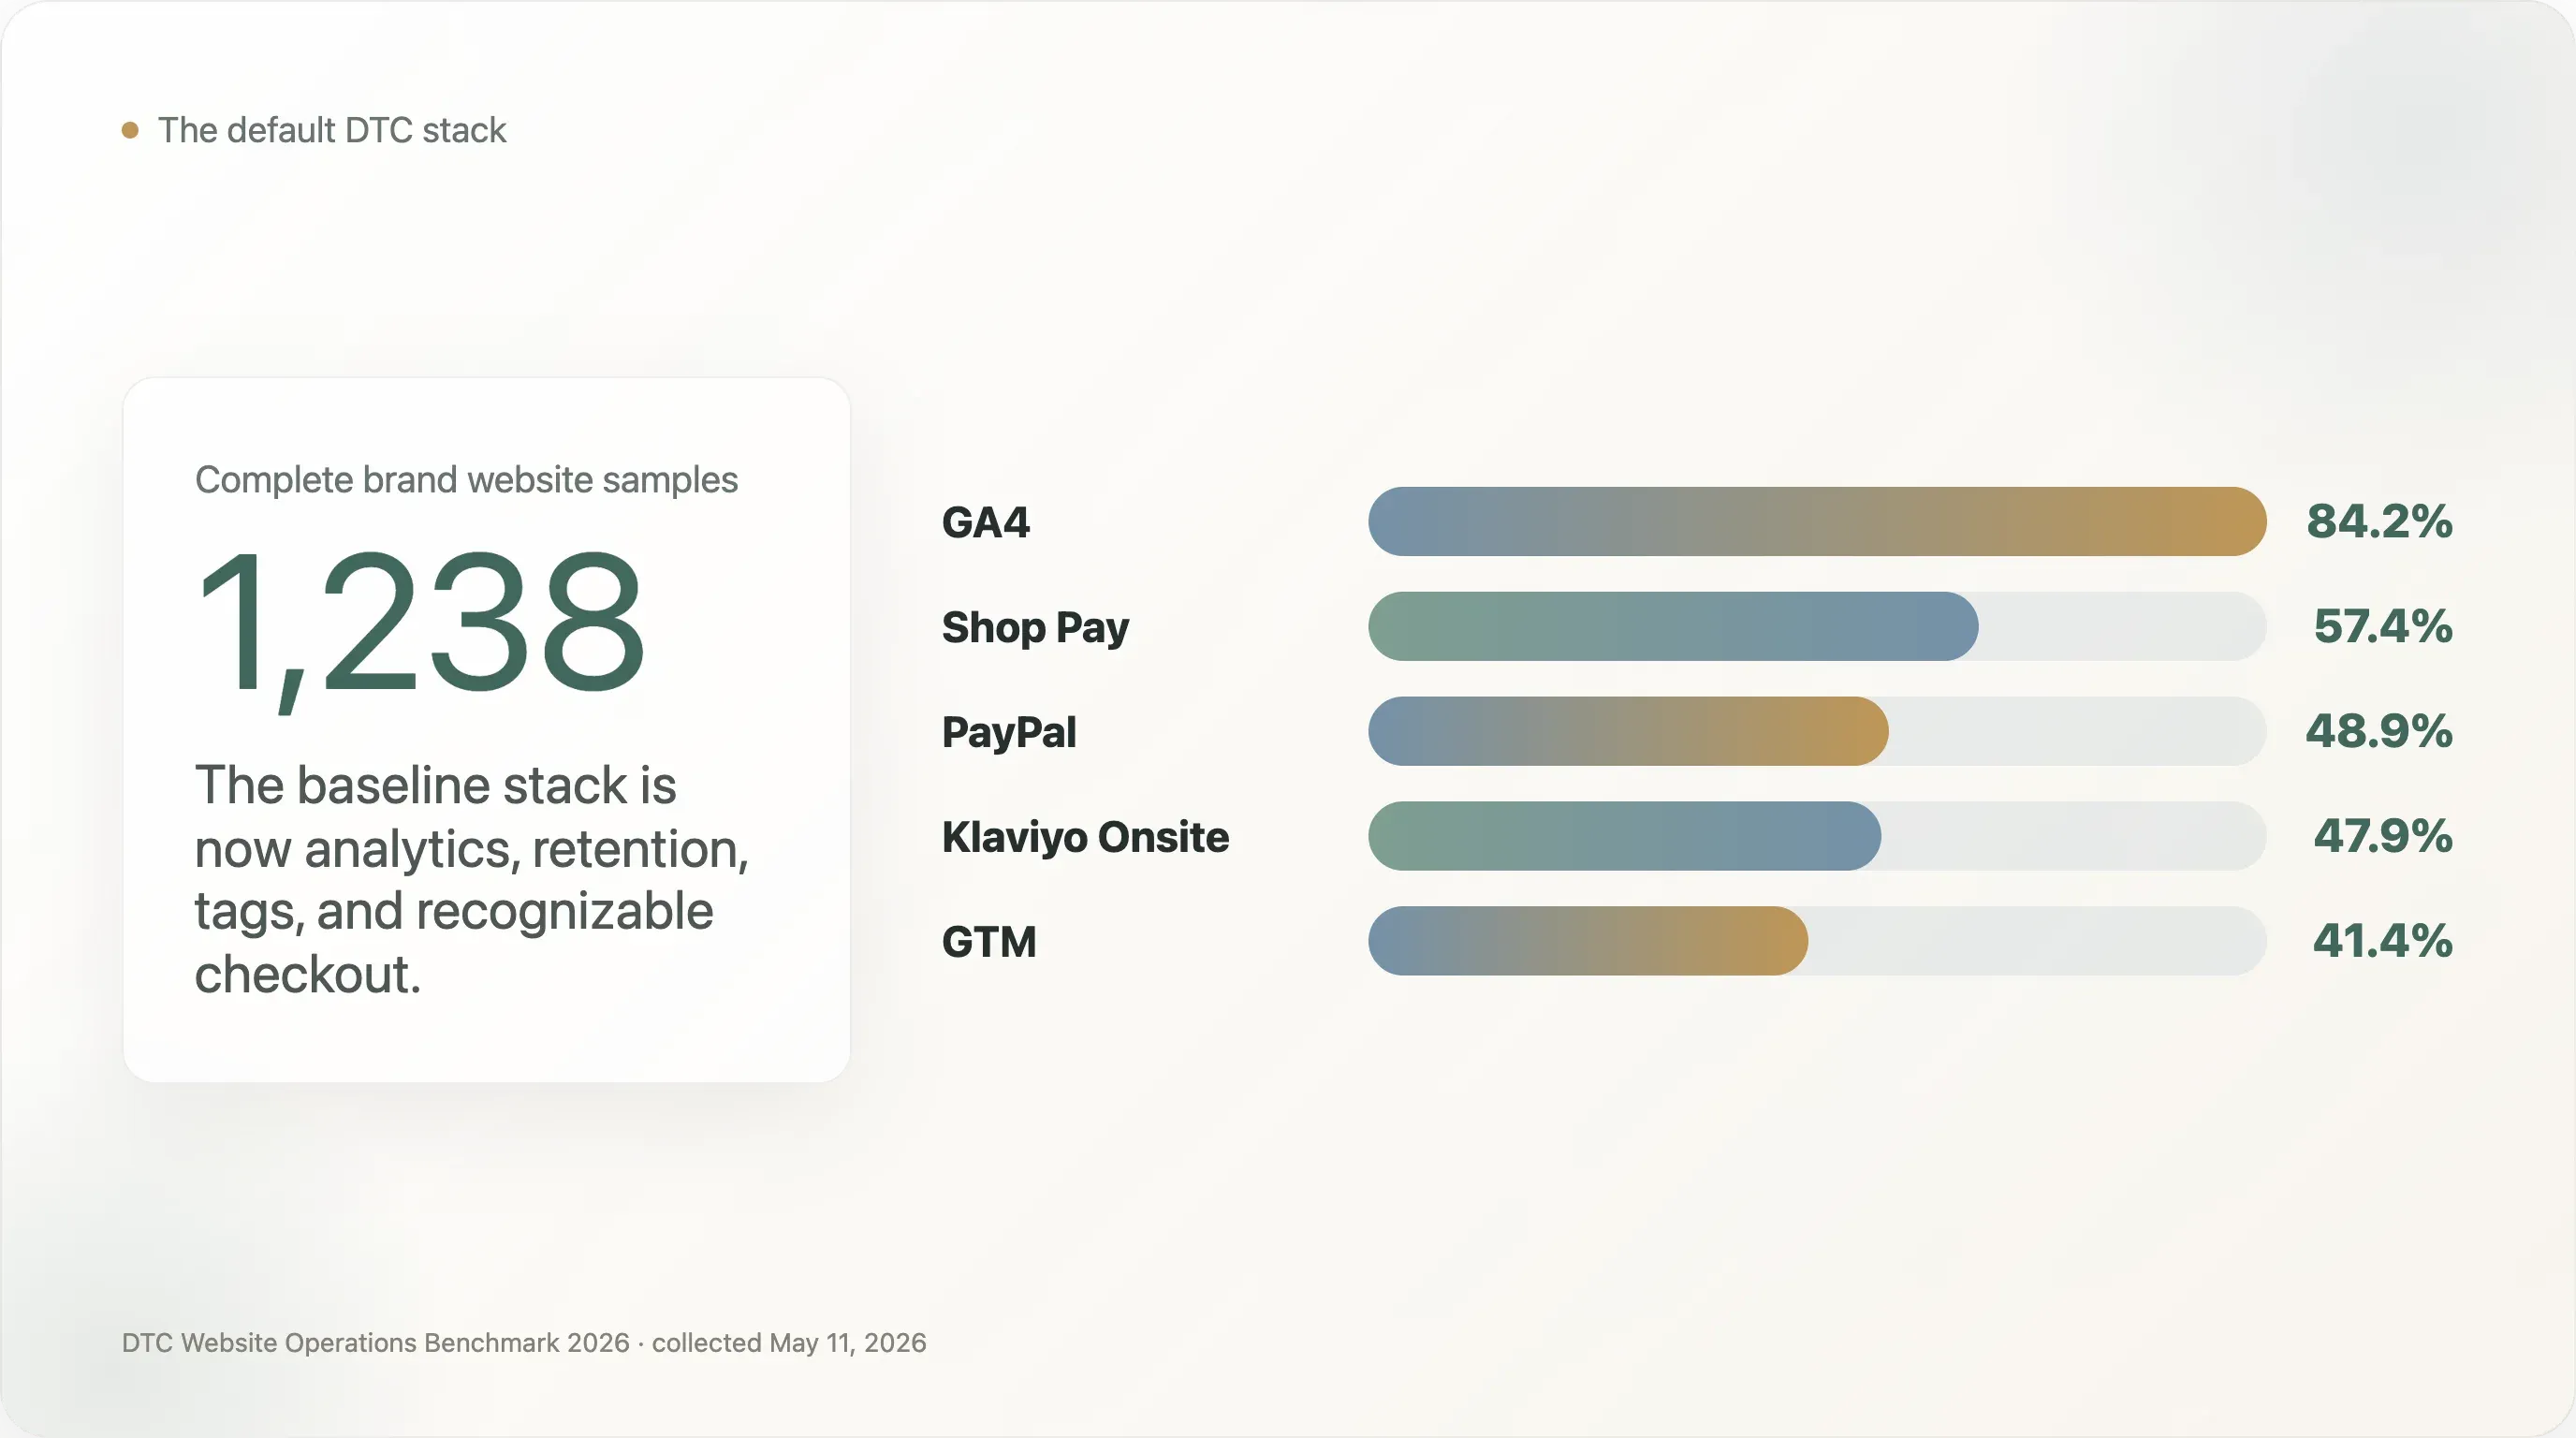
Najbardziej jednoznaczny wniosek jest taki, że dolna warstwa stosu DTC się ustandaryzowała. Google Analytics 4 występuje na 84,2% kompletnych próbek. Klaviyo Onsite występuje na 47,9%. Google Tag Manager występuje na 41,4%. W obszarze płatności Shop Pay występuje na 57,4%, a PayPal na 48,9%. Wśród 1 083 marek, w których wykryto co najmniej jedno narzędzie, GA4 + Shop Pay współwystępują w 65,6%, GA4 + PayPal w 56,0%, PayPal + Shop Pay w 55,6%, a GA4 + Klaviyo w 54,6%. Dla operatorów wniosek jest prosty: domyślny stos DTC nie jest już strategiczną tajemnicą. To dziś po prostu podstawowy wymóg.
Ta podobieństwo nie jest najciekawszą częścią. Najciekawsze jest to, gdzie ono się kończy. Strony DTC wyglądają dojrzale w zakresie podstawowej analityki, checkoutu i infrastruktury e-mail, ale znacznie mniej dojrzale w obszarze gotowości do wyszukiwania AI, uporządkowanych danych produktowych, SEO międzynarodowego, zarządzania wydajnością oraz powiązania między ruchem na stronie a własnymi kanałami społecznościowymi. To właśnie te luki tworzą użyteczne benchmarki dla zespołów ecommerce i wartościowe tematy dla autorów SEO, newsletterów oraz mediów branżowych.
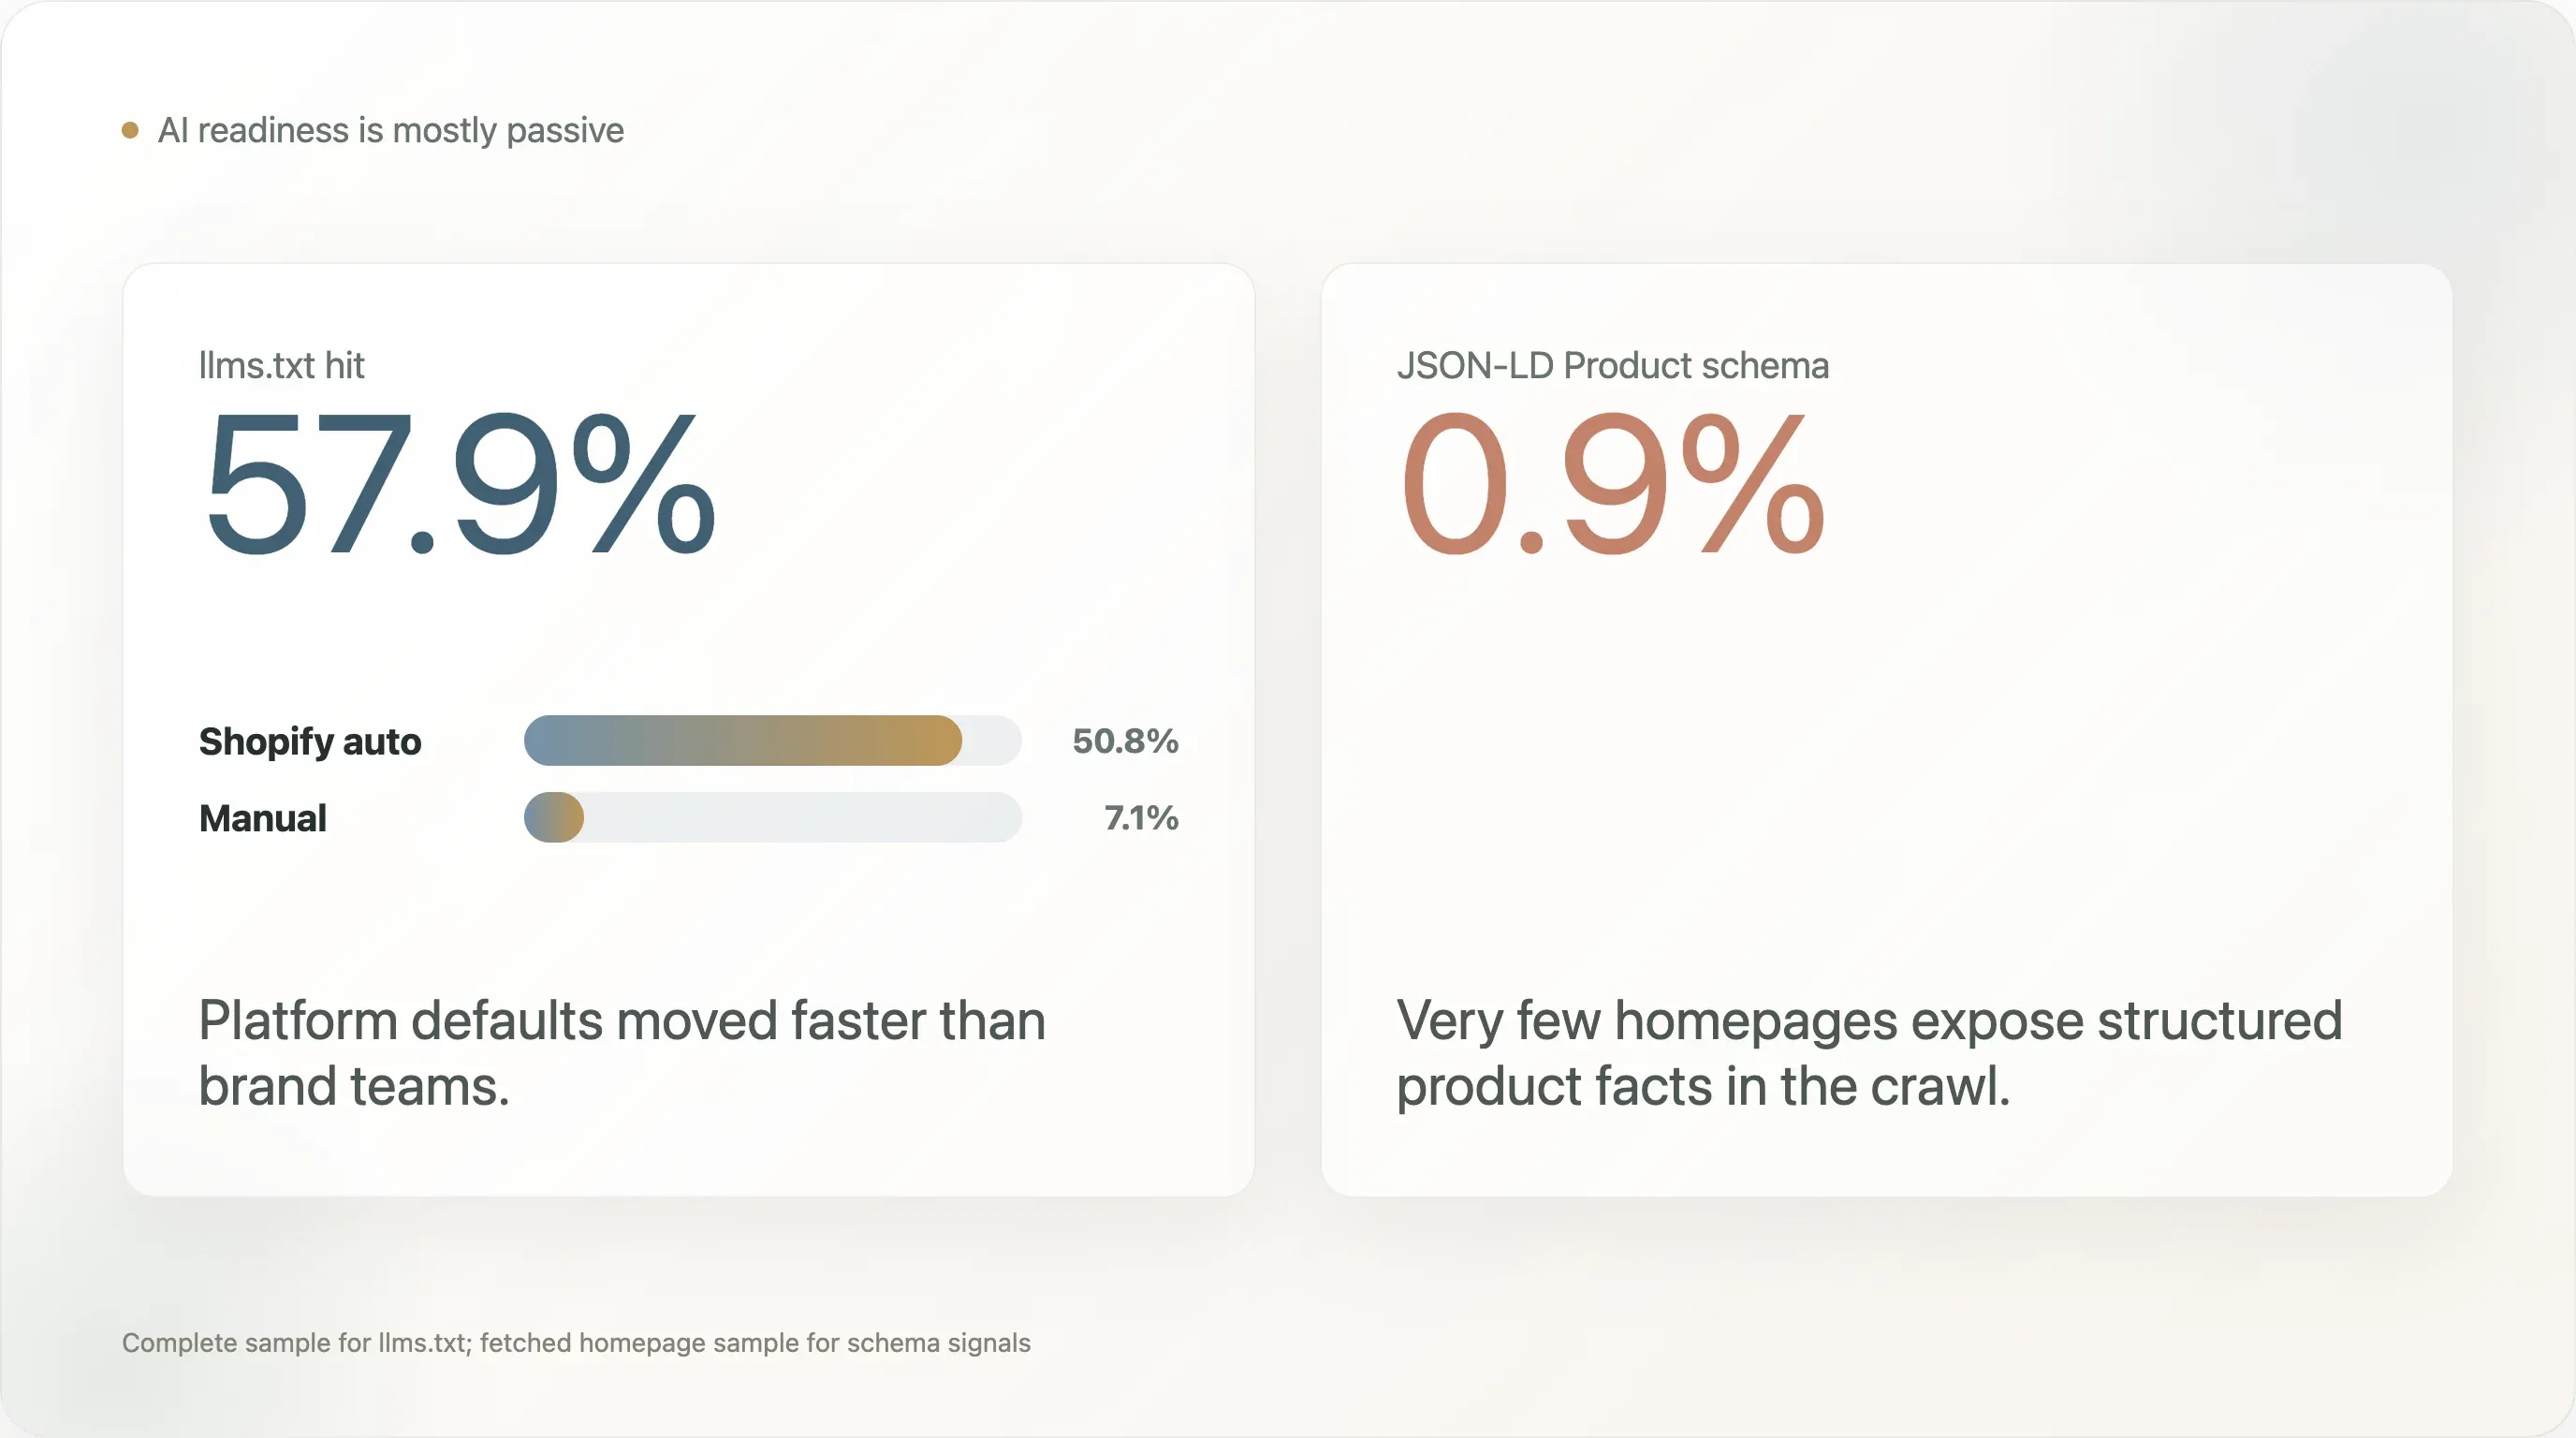
Najbardziej nieintuicyjny wniosek dotyczący wyszukiwania AI to rozjazd między gotowością bierną a aktywną. llms.txt pojawia się na 57,9% kompletnych próbek, co brzmi jak szeroka adopcja gotowości na AI. Ale 50,8 punktu procentowego z tego pochodzi z automatycznie generowanych plików Shopify, podczas gdy tylko 7,1% marek ma ręczny sygnał llms.txt. Jednocześnie schemat JSON-LD Product pojawia się tylko na 0,9% z 1 240 pobranych próbek strony głównej. Oznacza to, że wiele marek ma nową, czytelną dla AI bramę tylko dlatego, że platforma ją udostępniła, ale bardzo niewiele publikuje uporządkowane fakty o produktach w sposób, który wyszukiwarki i systemy AI mogą wiarygodnie interpretować.
Drugim zaskakującym wnioskiem jest to, że głębokość stosu narzędziowego nie stanowi głównej różnicy między bardziej widocznymi markami a długim ogonem. Grupa liderów w tej próbie, zdefiniowana jako marki obecne w co najmniej trzech kolekcjach źródłowych, ma średnio 4,5 wykrytego narzędzia analitycznego i marketingowego. Grupa z jednego źródła ma średnio 4,1. To niewielka różnica. Większe różnice dotyczą konkretnych sygnałów dojrzałości: zaawansowanej atrybucji, adopcji headless frontend, analityki zachowań, zgodności prywatnościowej i świadomej architektury platformowej.
Trzeci wniosek brzmi: strony DTC niosą realny dług wydajnościowy. W 1 240 próbkach strony głównej, dla których dostępne były dane o wydajności, mediana strony głównej to 52 tagi skryptów i 8 domen zewnętrznych. Wartości p75 to 69 skryptów i 12 domen zewnętrznych. Pole rozmiaru bajtowego strony głównej jest ograniczone przez zasady zbierania danych i nie powinno być traktowane jako wniosek, ale liczba skryptów i liczba domen zewnętrznych nadal dobrze wskazują gęstość zależności. Wiele zespołów DTC zamieniło szybkość i prostotę na widoczność marketingową, atrybucję, personalizację, zgodę, czat, wsparcie, piksele i narzędzia testowe.
Czwarty wniosek jest taki, że pozycjonowanie DTC jako „zielone” jest znacznie mniej widoczne w copy strony głównej, niż sugeruje rozmowa branżowa. W czytelnym tekście strony głównej z 1 240 próbek free shipping pojawia się na 26,2%, best seller na 24,4%, a język PR lub „as seen on” na 22,6%. Dla porównania sustainable pojawia się na 4,6%, eco-friendly na 1,3%, a cruelty free na 1,0%. Nie dowodzi to, że marki nie są zrównoważone. Pokazuje natomiast, że wiele marek nie czyni z zrównoważenia głównego publicznego haka konwersyjnego na stronie głównej.
Piąty wniosek jest powiązany ze społecznościami, ale ważny dla operatorów ecommerce: ponad połowa kompletnych próbek strony głównej nie miała widocznych linków do śledzonych platform społecznościowych w statycznym kodzie strony głównej. To wymaga zastrzeżenia, bo stopki renderowane po stronie klienta i dynamiczne menu mogły zostać pominięte. Mimo to jest to użyteczny sygnał operacyjny. Jeśli marka inwestuje w Instagram, TikTok, YouTube, Pinterest lub X, jej oficjalna strona nie powinna utrudniać znalezienia tych kanałów.
Ten raport jest napisany dla trzech grup odbiorców. Zespoły DTC i ecommerce mogą używać go jako benchmarku operacyjnego. Specjaliści SEO i twórcy treści ecommerce mogą korzystać z liczb jako oryginalnych danych gotowych do cytowania, wraz z zachowaniem wszystkich zastrzeżeń. Autorzy branżowi mogą potraktować go jako migawkę tego, gdzie stos DTC się standaryzuje i skąd może nadejść kolejna fala przewagi konkurencyjnej.
Wypróbuj Thunderbit do benchmarkingu ecommerce
Pięć najbardziej „udostępnialnych” wniosków
-
DTC ma już domyślny stos. W tej próbie GA4, Klaviyo, Shop Pay i PayPal tworzą praktyczną bazę. Kolejną przewagą nie jest „instalowanie narzędzi”, tylko lepsze zarządzanie danymi i prowadzenie lepszych eksperymentów.
-
Gotowość na AI jest głównie bierna. llms.txt pojawia się na 57,9% kompletnych próbek, ale większość tego to efekt platformy. Ręczny llms.txt pojawia się tylko na 7,1%, a schemat Product tylko na 0,9%.
-
Długi ogon w dużej mierze dogonił liderów pod względem liczby narzędzi. Marki z grupy liderów mają średnio 4,5 wykrytego narzędzia analitycznego i marketingowego, a marki z długiego ogona 4,1. Różnica nie dotyczy tego, „ile narzędzi”, tylko „które narzędzia dojrzałości i jak dobrze są używane”.
-
Wiele stron głównych DTC jest ciężkich przez zależności. Mediana strony głównej w próbie wydajnościowej ma 52 tagi skryptów i 8 domen zewnętrznych. Widoczność marketingowa ma koszt szybkości.
-
Copy na stronie głównej jest bardziej transakcyjne niż wartościowe. „Free shipping” i „best seller” pojawiają się znacznie częściej niż język zrównoważenia. To cenna wskazówka dla zespołów contentowych, bo przeczy sposobowi, w jaki DTC często opowiada o samym sobie.
1. Właściwie odczytaj próbkę
Tego raportu nie należy czytać jako spisu wszystkich marek DTC na rynku. Początkowa pula marek pochodziła z publicznych źródeł ecommerce i DTC, gdzie marki były prawdopodobnie widoczne: bibliotek case study narzędzi, materiałów ekosystemu Shopify, publicznych indeksów DTC i powiązanych list ecommerce. To tworzy próbę marek możliwych do odnalezienia przez ekosystem narzędzi ecommerce, a nie losowe badanie rynku.
Ma to największe znaczenie przy interpretacji platform. Shopify jest nadreprezentowany, ponieważ wiele list źródłowych jest powiązanych z narzędziami ekosystemu Shopify lub case study ecommerce. W pełnej próbie Shopify pojawia się na 789 z 1 238 witryn, czyli na 63,7%. Ta liczba opisuje tę próbę, a nie cały rynek witryn DTC. Nie należy jej cytować jako udziału rynkowego w branży.
To samo zastrzeżenie dotyczy każdego wniosku specyficznego dla platformy. Jeśli liczba dotyczy narzędzia lub platformy, która ma silny ekosystem case study, może być zawyżona przez sposób zbudowania puli marek. Dlatego raport koncentruje się mniej na stwierdzeniu „Shopify dominuje”, a bardziej na sygnałach operacyjnych, które nadal są użyteczne w ramach tej próby: współwystępowaniu narzędzi, lukach gotowości do AI, wzorcach checkoutu, brakach w schemacie, widoczności społecznościowej, wzorcach kategorii i długu wydajnościowym.
Raport mierzy też publiczne sygnały ze stron, a nie wewnętrzną jakość operacyjną. Marka może używać narzędzia ładowanego dopiero po zgodzie użytkownika, wstrzykiwanego przez tag manager, ukrytego za renderowaniem po stronie klienta albo niewidocznego w pierwszych 256 KB pobranego HTML. Metody płatności takie jak Apple Pay i Google Pay są szczególnie podatne na zaniżenie, ponieważ często ładują się dynamicznie. Wskaźniki instalacji narzędzi należy więc traktować jako dolne granice.
To ograniczenie nie czyni danych bezużytecznymi. Czyni je konkretnymi. Patrzymy na to, co publiczny crawl może zobaczyć na stronach marek, czyli na ten sam poziom widoczności, jaki mają wyszukiwarki, crawlery AI, narzędzia SEO, systemy analizy konkurencji i wielu dziennikarzy robiących szybki research. Dla zespołów ecommerce i SEO ten publiczny poziom widoczności sam w sobie jest wart poprawy.
2. Domyślny stos DTC już tu jest
Wśród 1 238 kompletnych próbek średnia strona ma 3,39 wykrytego narzędzia analitycznego i marketingowego, przy medianie 3. Ta liczba obejmuje wykryty obszar analityki i marketingu, a nie każdą warstwę operacyjną witryny. Po uwzględnieniu sygnałów checkoutu i płatności praktyczna baza operacyjna DTC staje się większa: analityka, retencja, koordynacja tagów, checkout jednym kliknięciem i przynajmniej jeden znany portfel lub metoda płatności.
Najczęściej wykrywane narzędzia pokazują kształt współczesnej bazy DTC:
| Narzędzie | Pokrycie w pełnej próbie |
|---|---|
| Google Analytics 4 | 84,2% |
| Klaviyo Onsite | 47,9% |
| Google Tag Manager | 41,4% |
| Microsoft Clarity | 20,6% |
| Gorgias | 19,1% |
| Triple Whale | 15,3% |
| Bing UET | 11,7% |
| Cookiebot / OneTrust | 9,6% |
| Rebuy | 9,0% |
| Attentive | 8,9% |
Historia dla operatora jest prosta. GA4 to dziś podstawowa instrumentacja. Klaviyo to warstwa retencji DTC. GTM to warstwa koordynacji pikseli i tagów. Microsoft Clarity, Gorgias, Triple Whale, Cookiebot, Rebuy i Attentive nie są uniwersalne, ale wskazują różne formy dojrzałości operacyjnej: analitykę zachowań, obsługę klienta, atrybucję, zgodę, upsell i SMS.
Najbardziej użyteczny benchmark to nie pojedynczy wskaźnik instalacji, ale wzorzec współwystępowania. Wśród 1 083 marek z co najmniej jednym wykrytym narzędziem najczęstsze pary to:
| Para | Współwystępowanie |
|---|---|
| GA4 + Shop Pay | 65,6% |
| GA4 + PayPal | 56,0% |
| PayPal + Shop Pay | 55,6% |
| GA4 + Klaviyo Onsite | 54,6% |
| Klaviyo Onsite + Shop Pay | 51,2% |
| GA4 + Google Tag Manager | 44,9% |
| Klaviyo Onsite + PayPal | 44,1% |
To najczytelniejszy dowód na istnienie domyślnego stosu DTC: analityka, retencja, checkout jednym kliknięciem i znana opcja portfela. Dla nowego operatora DTC jest to bardzo przydatne, bo zmniejsza niepewność. Pierwszym zadaniem nie jest wymyślanie egzotycznego stacku. Pierwszym zadaniem jest czyste uruchomienie bazy, z dokładnymi zdarzeniami, śledzeniem świadomym zgody, działającym przechwytywaniem e-mail/SMS i checkoutem, który klienci już rozpoznają.
Dla dostawców narzędzi i operatorów SaaS tworzy to trudniejszy rynek. Nowe narzędzie nie wygra tylko dlatego, że obiecuje szeroki zestaw funkcji. Baza jest już nasycona, a wiodące narzędzia są osadzone w procesach pracy. Szansa leży w rozwiązywaniu problemów, których bazowy stos nie rozwiązuje dobrze: lepsza atrybucja przy ograniczeniach prywatności, lepsze testowanie lifecycle, czystsza tożsamość między kanałami, lepszy upsell po zakupie, lepsza inteligencja zwrotów albo mniej oporna zgodność międzynarodowa.
Przykłady marek czynią ten wzorzec bardziej konkretnym. W crawlach marki takie jak Beekman 1802, Princess Polly, Fresh Clean Threads i Rare Beauty pokazują relatywnie dojrzałe wykryte stosy, które łączą narzędzia analityki, retencji, wsparcia, zgód, atrybucji lub doświadczenia klienta. Chodzi nie o to, że każda marka powinna kopiować każde narzędzie. Chodzi o to, że dojrzałe operacje DTC często dokładają specjalistyczne narzędzia na wierzch tego samego fundamentu, zamiast całkowicie go zastępować.
3. Luka w wyszukiwaniu AI: llms.txt jest wszędzie, a schemat Product prawie nigdzie
Najbardziej cytowalny wniosek w całym raporcie to rozbieżność między llms.txt a uporządkowanymi danymi produktowymi.
W pełnej próbie witryn 717 marek ma llms.txt, czyli 57,9%. Na pierwszy rzut oka wygląda to na szybkie wdrażanie praktyk wyszukiwania AI przez DTC. Ale liczy się podział:
| Status llms.txt | Liczba | Udział w pełnej próbie |
|---|---|---|
| Łączne trafienie llms.txt | 717 | 57,9% |
| Automatycznie generowany przez Shopify | 629 | 50,8% |
| Ręczny | 88 | 7,1% |
| Soft 404 | 137 | 11,1% |
| Nie skonfigurowano | 383 | 30,9% |
Wniosek nie brzmi „marki DTC stały się ekspertami od wyszukiwania AI”. Lepszy wniosek jest taki: domyślne ustawienia platform potrafią zmieniać rynek szybciej niż zespoły marek. Gdy platforma automatycznie dodaje nowy publiczny plik, wiele marek korzysta na tym bez podejmowania aktywnej decyzji strategicznej. To przydatne, ale to nie to samo co świadoma optymalizacja pod AI-search.
Jeszcze większa luka pojawia się w danych uporządkowanych. W 1 240 próbkach z pobraną zawartością strony głównej jakikolwiek JSON-LD pojawia się na 48,4%, schemat Organization na 39,5%, schemat WebSite na 36,0%, BreadcrumbList na 12,7%, a schemat Product tylko na 0,9%.
| Sygnał SEO / schema | Pokrycie |
|---|---|
| meta viewport | 90,3% |
| meta description | 84,4% |
| canonical | 81,2% |
| og:title | 79,1% |
| twitter:card | 70,0% |
| og:image | 65,2% |
| JSON-LD, dowolny typ | 48,4% |
| JSON-LD Organization | 39,5% |
| JSON-LD WebSite | 36,0% |
| hreflang | 31,5% |
| JSON-LD BreadcrumbList | 12,7% |
| manifest | 10,9% |
| kanał RSS | 4,3% |
| JSON-LD Product | 0,9% |
Schemat Product jest ważny, bo pomaga wyszukiwarkom i systemom AI rozumieć encje produktów: nazwę, cenę, dostępność, SKU, oceny, obrazy i powiązane fakty o produkcie. Marka może mieć świetny copy i nowoczesny stack ecommerce, ale jeśli publiczne crawlery nie potrafią czytać faktów o produkcie w czysty sposób, marka zostawia widoczność na stole.
Pozytywne przykłady z crawla obejmują marki takie jak Curie, Manukora, Mokobara, MoxieLash, Unbloat i Viva, które pojawiły się w niewielkiej grupie wykryć schematu Product. Nie należy traktować ich jako jedynych marek pracujących nad uporządkowanymi danymi produktowymi, bo metoda jest oparta na stronie głównej i zachowawcza. Są jednak użytecznymi przykładami rodzaju sygnału strukturalnego, którego większość publicznych stron głównych DTC w tym crawl’u nie ujawniła.
Dla zespołów SEO to najważniejszy i najbardziej praktyczny punkt całego raportu. Dodanie lub walidacja schematu Product na stronach produktowych jest zwykle znacznie tańsze niż uruchamianie nowego kanału, przebudowa strony czy dokładanie kolejnego dostawcy analityki. Łatwo też wyjaśnić to wewnętrznie: jeśli wyszukiwanie AI i wyniki rozszerzone potrzebują uporządkowanych faktów o produkcie, strona produktu powinna publikować te fakty w formacie czytelnym maszynowo.
Dla twórców treści nagłówek pisze się sam: marki DTC dostały plik dla wyszukiwania AI domyślnie, ale prawie żadna nie ujawnia schematu Product w crawl’u. Ten kontrast jest ciekawszy niż ogólna opowieść „AI search nadchodzi”, bo wskazuje na konkretną lukę.
4. Checkout: Shop Pay jest standardem, BNPL nadal pozostaje sygnałem mniejszościowym
Checkout to jedna z najsilniej ustandaryzowanych warstw w próbie.
| Metoda płatności | Marki | Pokrycie |
|---|---|---|
| Shop Pay | 711 | 57,4% |
| PayPal | 606 | 48,9% |
| Afterpay | 73 | 5,9% |
| Affirm | 24 | 1,9% |
| Amazon Pay | 16 | 1,3% |
| Klarna | 14 | 1,1% |
| Google Pay | 9 | 0,7% |
| Apple Pay | 5 | 0,4% |
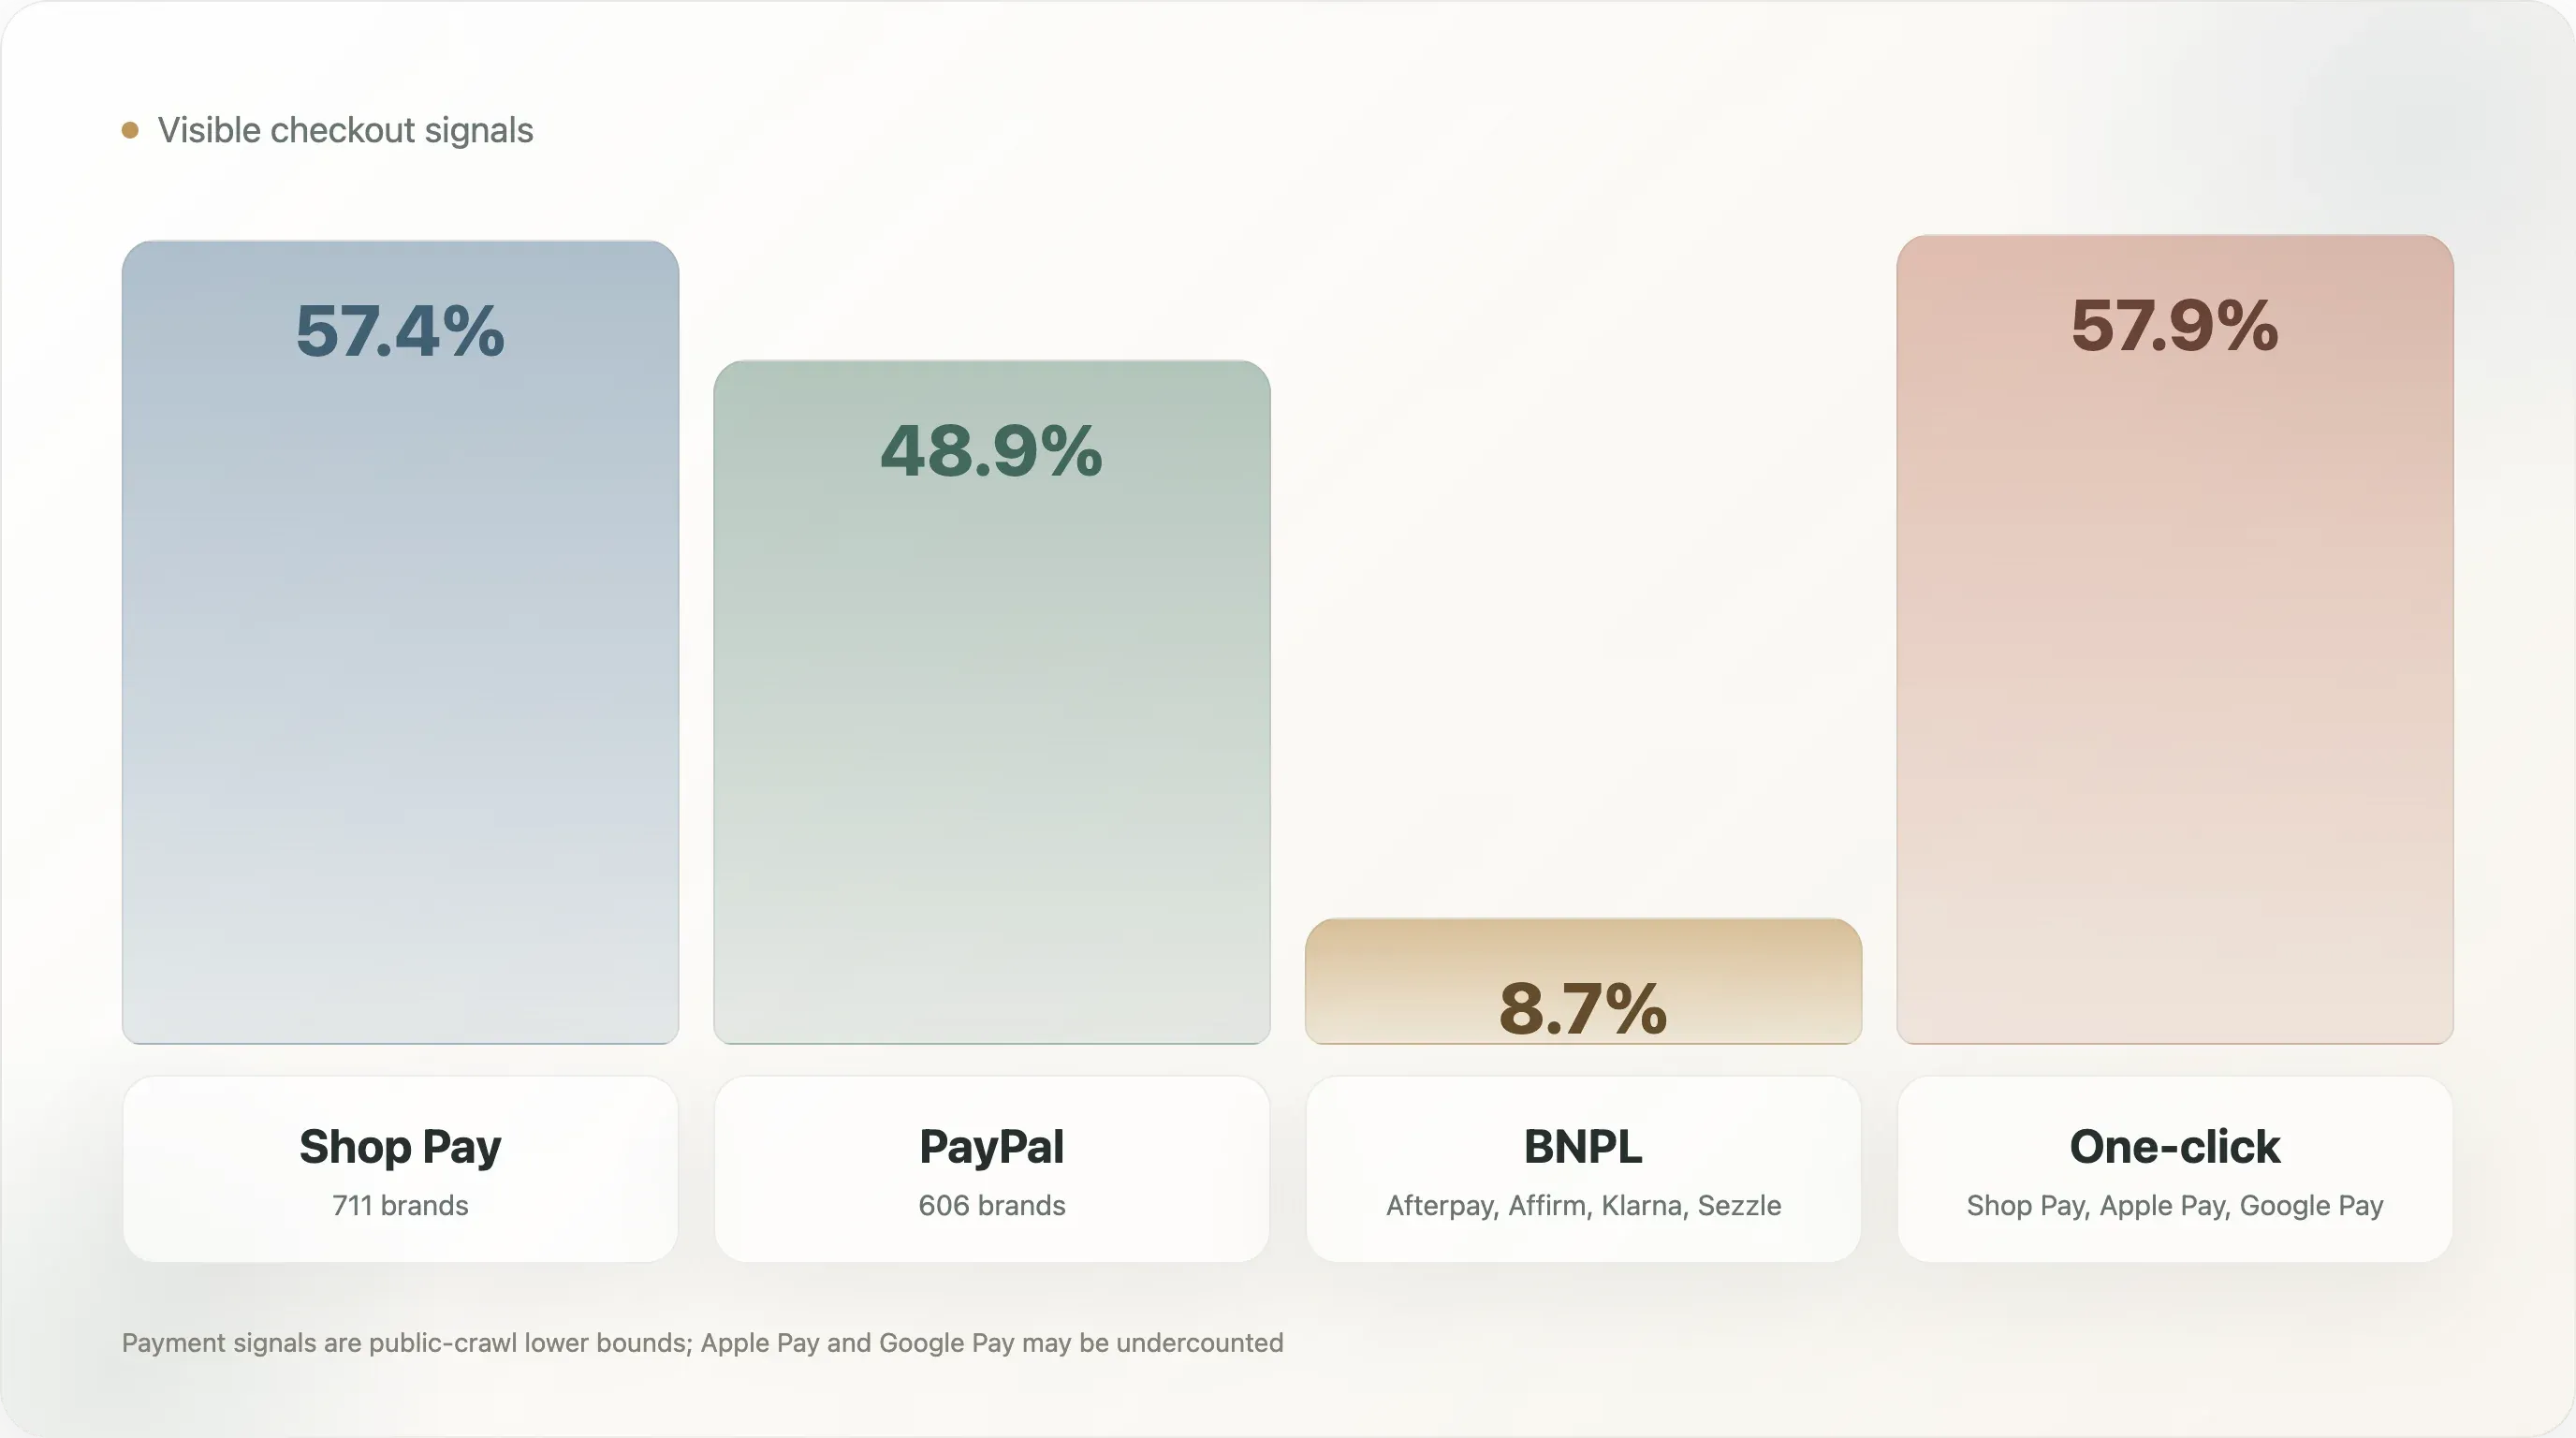
Checkout jednym kliknięciem, zdefiniowany tutaj jako Shop Pay, Apple Pay lub Google Pay, pojawia się na 57,9% kompletnych próbek. BNPL, zdefiniowany jako Afterpay, Affirm, Klarna lub Sezzle, pojawia się na 8,7%.
Apple Pay i Google Pay są prawdopodobnie zaniżone w pomiarze, bo często ładują się przez dynamiczne skrypty checkoutu, a nie statyczny HTML strony głównej. Shop Pay i PayPal są łatwiejsze do wykrycia w tej metodzie. Bezpieczny wniosek nie brzmi, że Apple Pay jest nieistotny. Bezpieczny wniosek brzmi, że Shop Pay i PayPal są najbardziej widocznymi sygnałami checkoutu w tym publicznym crawl’u.
Liczba BNPL jest strategicznie użyteczna, bo jest wystarczająco niska, by wymuszać decyzję. BNPL nie jest uniwersalnym standardem DTC w tej próbie. Pojawia się selektywniej, zależnie od kategorii i poziomu cenowego. W kategoriach o wysokim AOV, takich jak odzież, obuwie, meble, sprzęt lub premium beauty, BNPL może ograniczyć tarcie zakupowe. W przypadku dóbr konsumpcyjnych o niższym AOV korzyść może być słabsza.
Pytanie operatora nie brzmi więc „czy każda marka DTC powinna dodać BNPL?”, tylko „czy nasz AOV, struktura marży, demografia klientów, zachowanie zwrotowe i cykl rozważania zakupu uzasadniają kolejną metodę płatności?”. Dla marek powyżej około 80 USD AOV argument często warto przetestować. W przypadku subskrypcyjnych dóbr konsumpcyjnych zależy to od tego, czy BNPL poprawia konwersję pierwszego zamówienia bez osłabiania ekonomiki retencji.
Pozytywne przykłady w szerszym krajobrazie checkoutu łatwo znaleźć wśród dojrzałych marek DTC, które dają klientom więcej niż jedną zaufaną ścieżkę płatności. Glossier pojawia się w crawl’u z Afterpay, PayPal i Shop Pay. Saatva pojawia się z Affirm w polu płatności. Te przykłady są przydatne, bo pokazują różne logiki kategorii: beauty używa elastycznej płatności jako części szerokiego doświadczenia checkoutu konsumenckiego; materace i artykuły do domu wykorzystują finansowanie, by zmniejszyć tarcie przy większych zakupach.
5. Headless wciąż jest sygnałem dojrzałości, a nie standardem
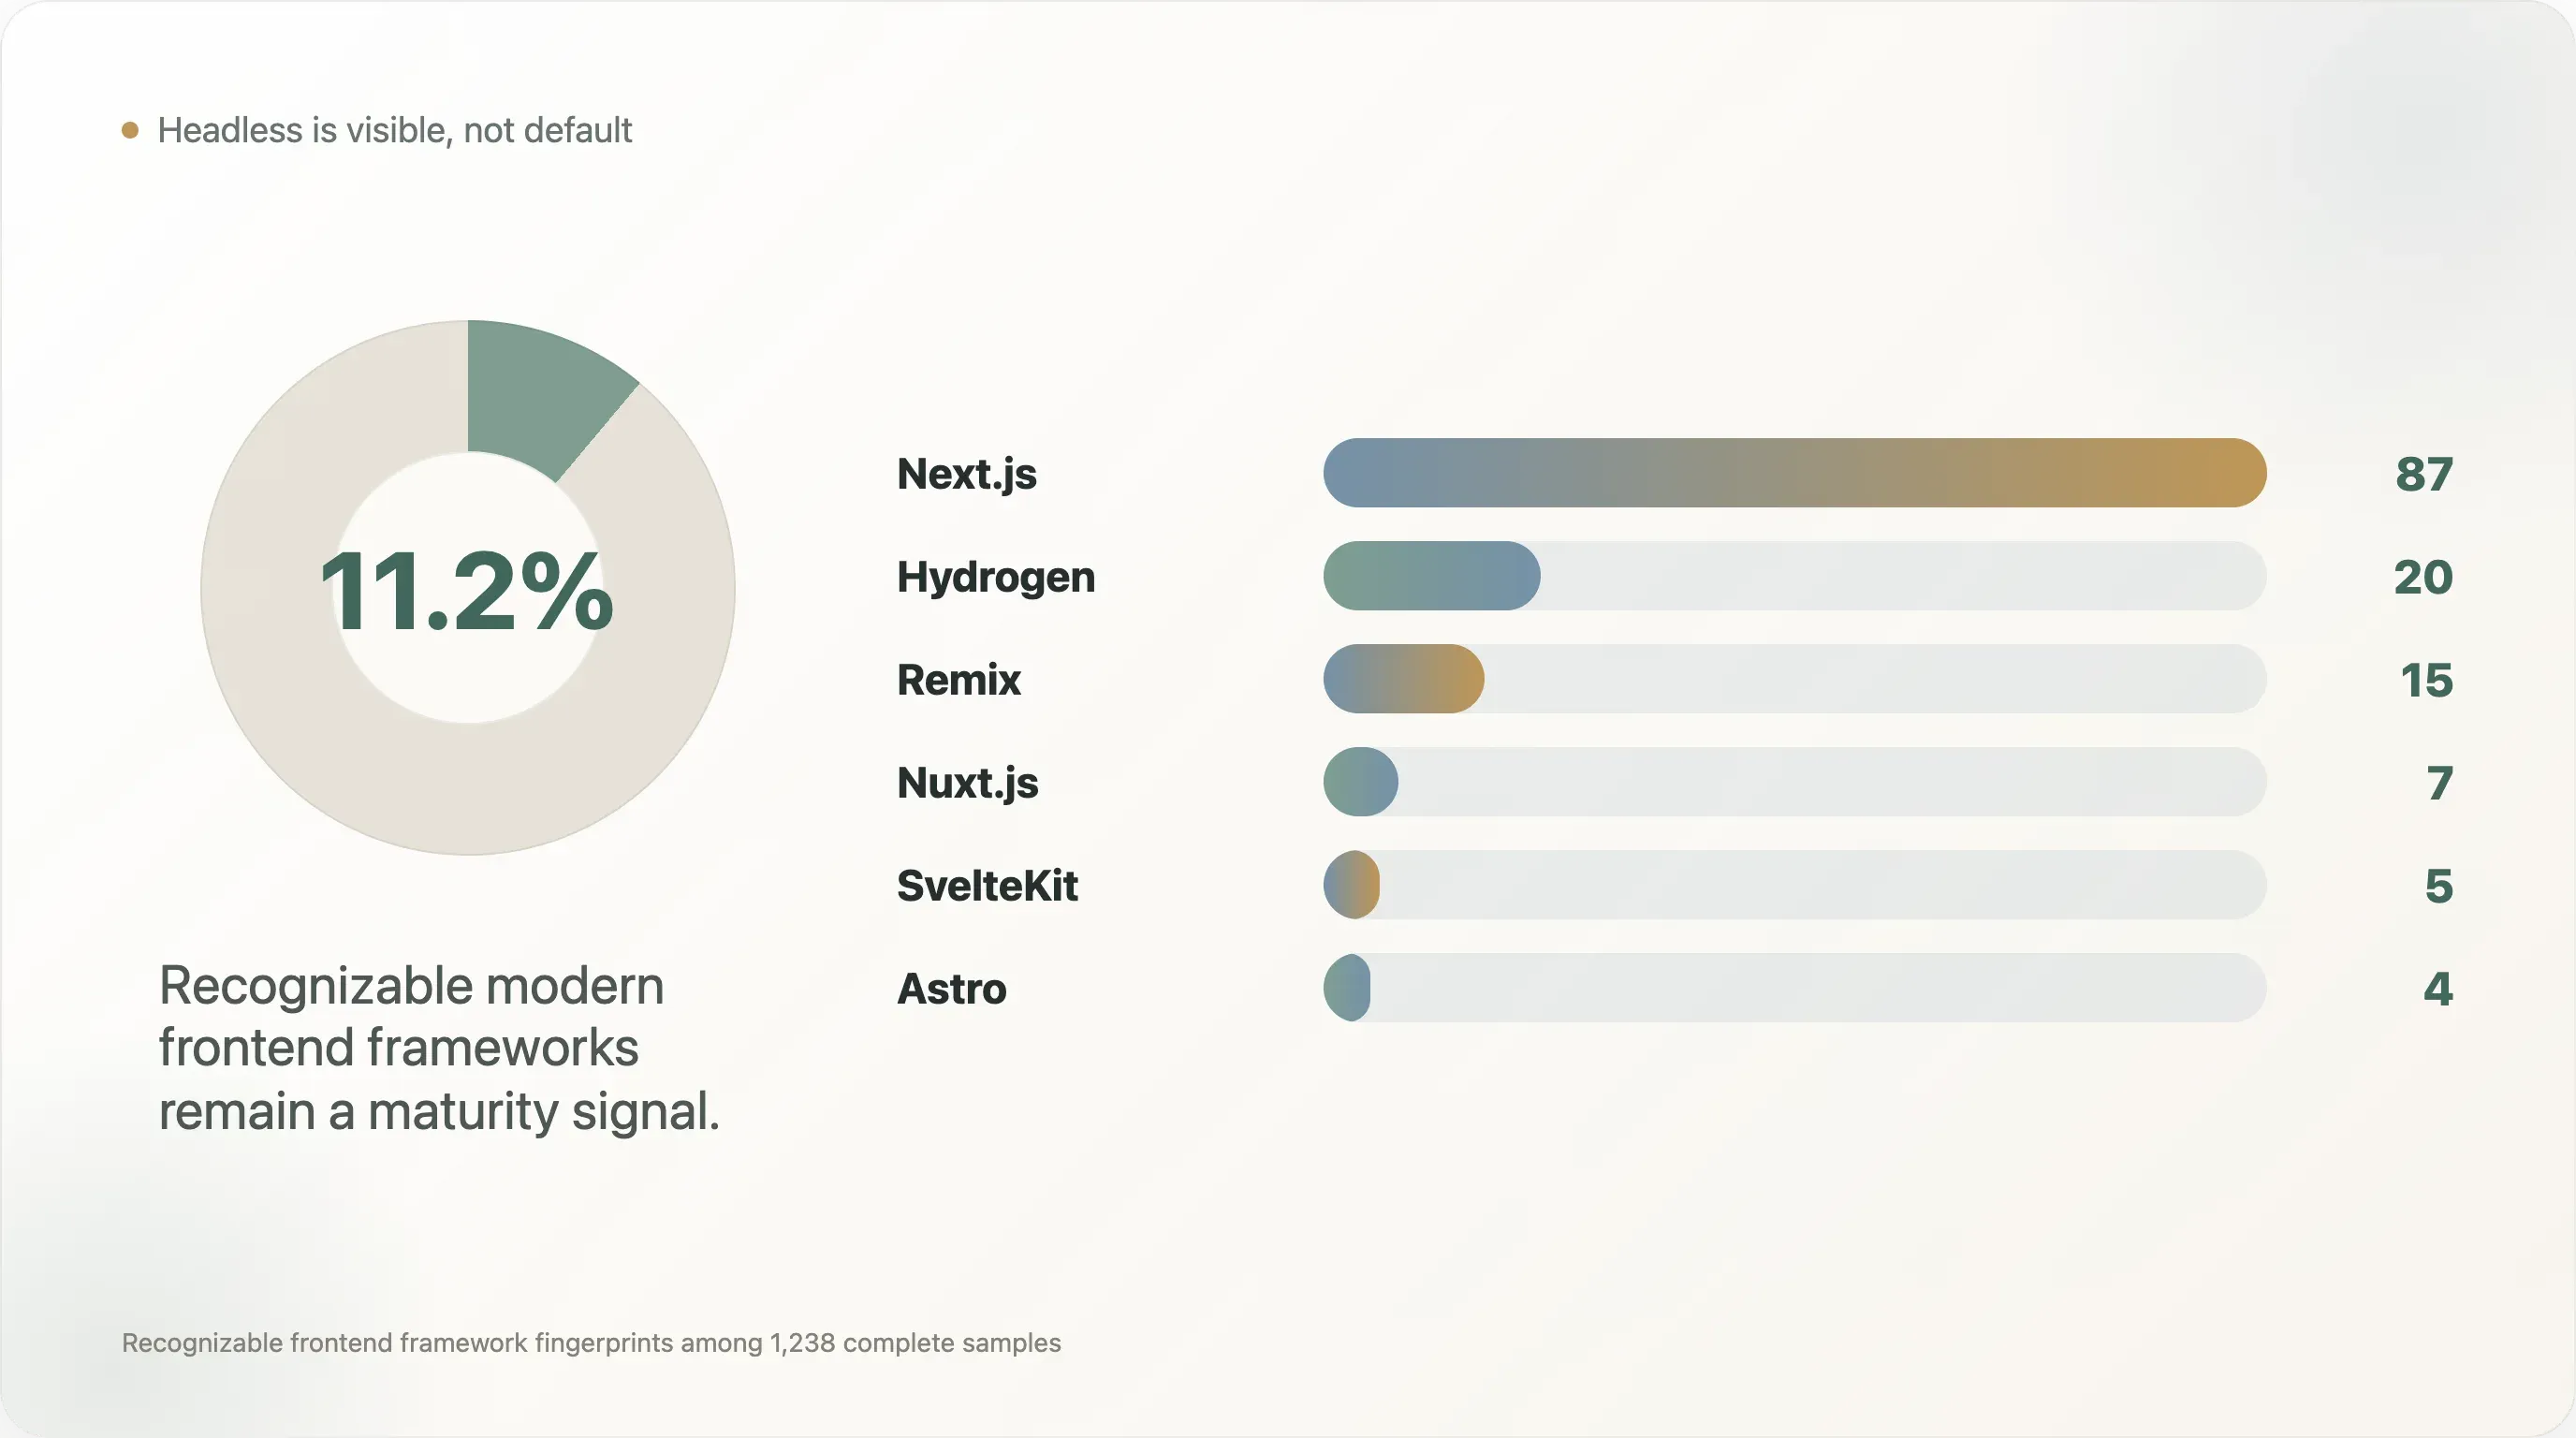
W 1 238 kompletnych próbkach nowoczesne frameworki frontendowe pojawiały się następująco:
| Frontend | Marki | Udział |
|---|---|---|
| Next.js | 87 | 7,0% |
| Hydrogen | 20 | 1,6% |
| Remix | 15 | 1,2% |
| Nuxt.js | 7 | 0,6% |
| SvelteKit | 5 | 0,4% |
| Astro | 4 | 0,3% |
| Gatsby | 1 | 0,1% |
Łącznie te rozpoznawalne nowoczesne frameworki frontendowe pojawiają się na około 139 markach, czyli 11,2% pełnej próby. Prawdziwy udział headless może być wyższy, bo wiele własnych sklepów React lub SPA nie ujawnia w prostym crawl’u czytelnych sygnatur frameworka.
Nagłówek nie brzmi „wszyscy przechodzą na headless”. Jest bardziej subtelny: headless jest wystarczająco widoczny, by mieć znaczenie, ale nadal na tyle rzadki, by sygnalizować dojrzałość. Większość zespołów DTC nie przebudowuje swojego sklepu na Next.js lub Hydrogen. Marki, które to robią, zwykle rozwiązują konkretne problemy: szybkość, kontrolę wizualną, elastyczność content-commerce, architekturę międzynarodową, złożone landing page’e lub ściślejszą kontrolę SEO.
Pozytywne przykłady z crawla obejmują Warby Parker i Stitch Fix z Next.js, Dr. Squatch, Blueland, Liquid I.V. i Chubbies z Hydrogen, Hedley Bennett i Harry's z Remix oraz Cocunat i Biossance z Astro. Te nazwy mają znaczenie, bo operatorzy wolą konkretne przykłady. Pokazują one, że headless nie jest abstrakcyjnym trendem inżynieryjnym, tylko wzorcem widocznym w branżach od okularów, przez pielęgnację, po żywność, odzież i dobra konsumenckie.
Dla większości marek headless nie powinien jednak być pierwszym priorytetem operacyjnym. Headless frontend może dać korzyści w szybkości i doświadczeniu marki, ale podnosi też koszty utrzymania. Marka potrzebuje możliwości inżynieryjnych, dyscypliny QA, ładu analitycznego, zarządzania workflow treści i niezawodnych procesów wdrożeniowych. Mała marka bez czystego setupu analitycznego, logiki lifecycle e-mail, wdrożenia schematu i kultury testowania checkoutu nie powinna od razu skakać do przebudowy frontendu.
Bardziej praktyczna drabina dojrzałości wygląda tak:
- Uruchom poprawnie bazowy stos: GA4, retencja, checkout, zgoda i czyste zdarzenia.
- Dodaj uporządkowane dane produktowe i crawlable podstawy SEO.
- Ogranicz niepotrzebne skrypty i zależności zewnętrzne.
- Dodawaj analitykę zachowań lub atrybucję tylko wtedy, gdy zespół może działać na podstawie tych danych.
- Rozważ headless wtedy, gdy marka naprawdę potrzebuje szybkości, kontroli designu, internacjonalizacji lub elastyczności content-commerce.
Ta drabina jest użyteczna, bo osadza headless w kontekście. To nie jest odznaka. To decyzja operacyjna.
6. Dług wydajnościowy: strona główna staje się hubem dostawców
Pola wydajności pokazują typowe napięcie DTC. Zespoły marketingowe chcą widoczności, atrybucji, popupów, opinii, personalizacji, wsparcia, pikseli społecznościowych, zgód, testów i retargetingu. Zespoły inżynieryjne i SEO chcą szybkości, mniejszej liczby zależności i czystszych stron. Strona główna znajduje się pośrodku.
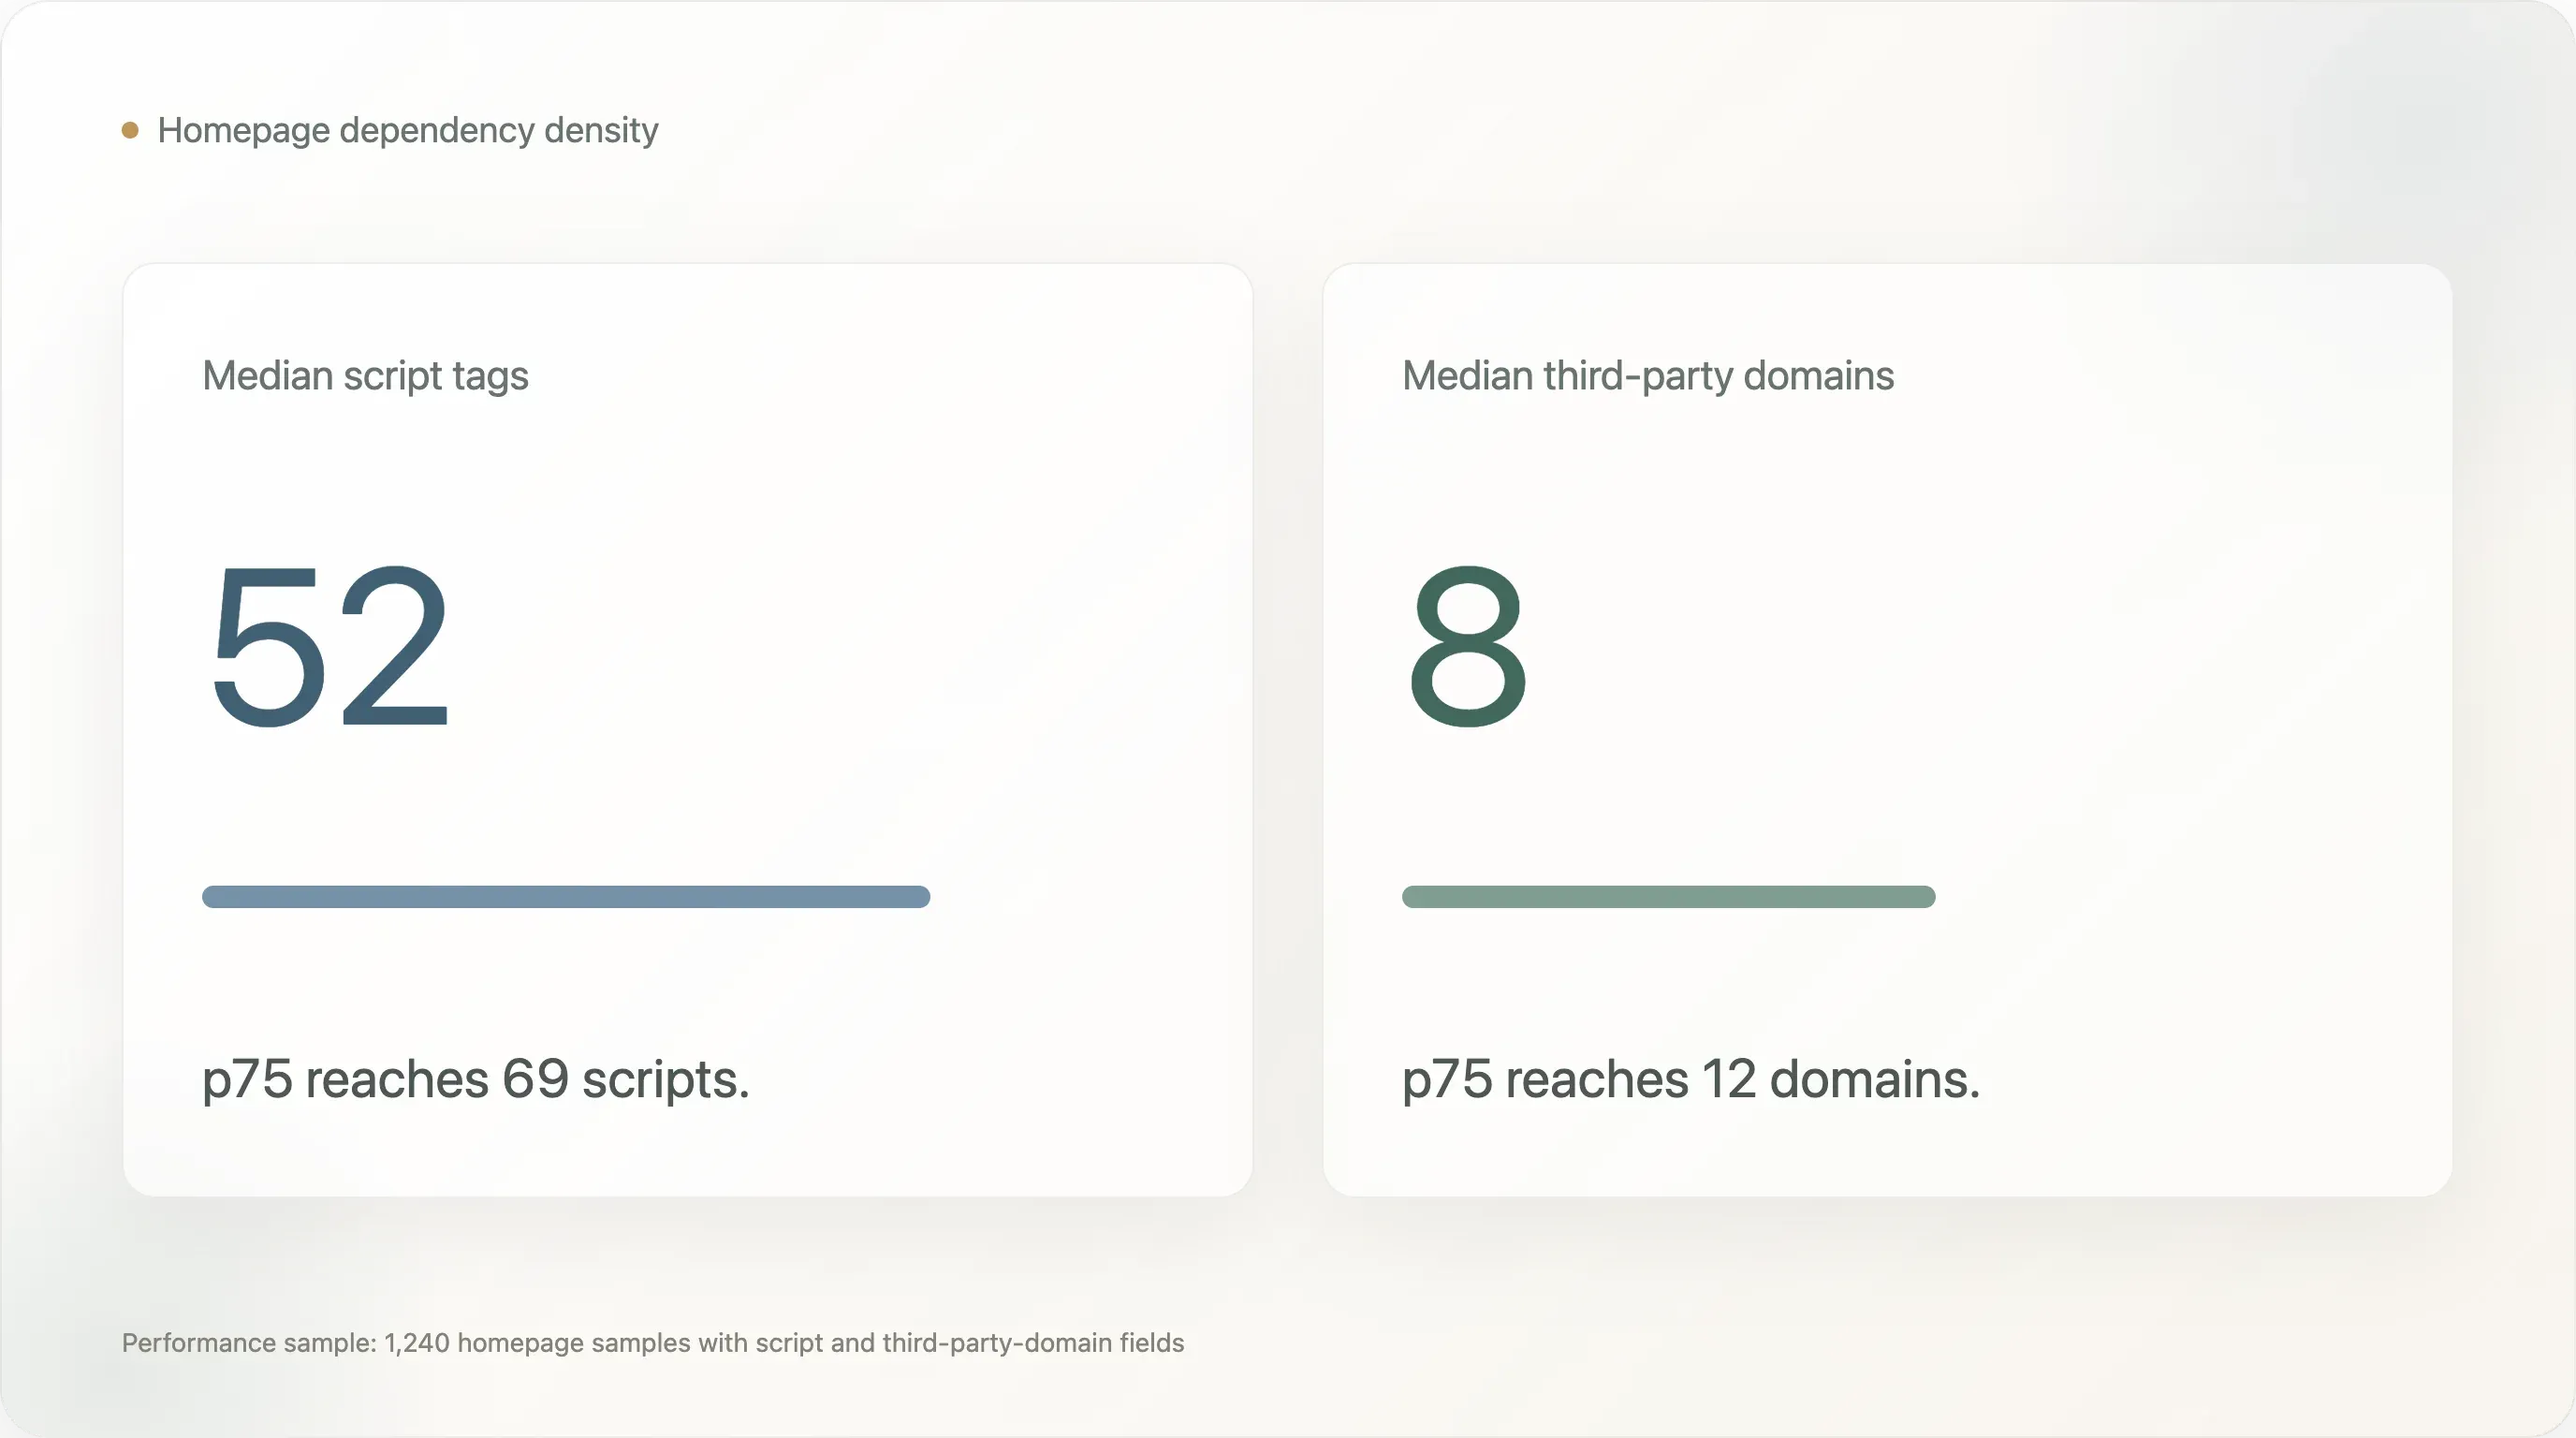
W 1 240 próbkach strony głównej z metrykami wydajności:
| Metryka | Mediana | p75 | Maksimum |
|---|---|---|---|
| Tagi skryptów | 52 | 69 | 305 |
| Domeny zewnętrzne | 8 | 12 | 41 |
Pole rozmiaru bajtowego strony głównej nie jest wiarygodnym wnioskiem, bo proces pobierania ograniczał odczyt do 256 KB. Ale liczba skryptów i liczba domen zewnętrznych nadal są użytecznymi wskaźnikami. Mediana 52 tagów skryptów oznacza, że typowa kompletna próbka strony głównej nie jest lekkim dokumentem. To punkt koordynacyjny dla wielu dostawców i zachowań po stronie przeglądarki.
Łatwo tu o błędną interpretację. Odpowiedzią nie jest „usuń każde narzędzie”. Wiele narzędzi istnieje, bo wspiera przychód. Lepszą odpowiedzią jest przypisanie właściciela. Każdy skrypt powinien mieć właściciela biznesowego, powód istnienia, strategię ładowania, zachowanie w ramach zgody i cykl przeglądu. Jeśli nikt nie odpowiada za skrypt, staje się on długiem wydajnościowym.
Najlepsze pytanie operatora brzmi: które tagi nadal zarabiają na swój koszt? Piksel wspierający główny płatny kanał może być wart kompromisu wydajnościowego. Stary tag testowy od dostawcy, z którego zespół już nie korzysta, nie jest. Narzędzie analityki zachowań może mieć sens, jeśli ktoś przegląda sesje co tydzień. Jeśli nikt nie ogląda nagrań, skrypt jest po prostu obciążeniem.
Dla zespołów SEO to użyteczny temat pomostowy. Core Web Vitals i techniczne SEO często są traktowane jako problem inżynieryjny, a tagi jako narzędzia marketingowe. W praktyce to ten sam system operacyjny. Zespół DTC nie poprawi wydajności bez ładu tagów i nie zapanuje nad tagami bez udziału marketingu.
7. Prywatność, obserwowalność i zaawansowane operacje
Kilka kategorii narzędzi w próbie jest rzadszych niż rdzeń stosu, ale po pojawieniu się mówi więcej.
Cookiebot / OneTrust pojawia się na 9,6% kompletnych próbek. To sygnał zarządzania zgodami. Często pojawia się, gdy marki działają w bardziej rygorystycznych jurysdykcjach prywatnościowych albo traktują zgodność poważnie. Jeśli marka DTC rozszerza działalność na Europę, Kanadę lub inne rynki wrażliwe prywatnościowo, zarządzanie zgodami staje się praktycznym wymogiem, a nie dodatkiem.
Microsoft Clarity pojawia się na 20,6%, a Hotjar na 8,3%. To wyraźna różnica, bo oba narzędzia są związane z analityką zachowań. Darmowe i przyjazne prywatności pozycjonowanie Clarity prawdopodobnie daje mu przewagę na rynku wrażliwym na koszty. Dla operatorów oznacza to, że analityka zachowań nie jest już tylko domeną enterprise. Zespoły DTC ze średniego segmentu mogą obserwować zachowanie użytkowników bez kupowania drogiej platformy badawczej.
Gorgias pojawia się na 19,1%. To ważne, bo obsługa klienta jest jednym z miejsc, w których DTC różni się od ogólnego ecommerce. Zwroty, zmiany zamówień, pytania o dostawę, subskrypcje, uszkodzone produkty i edukacja produktowa łączą support z przychodem. Narzędzie wsparcia zintegrowane z danymi ecommerce może stać się częścią systemu konwersji i retencji, a nie tylko skrzynką z ticketami.
Triple Whale pojawia się na 15,3% i Northbeam na 5,1%. To sygnały dojrzałości atrybucji. Gdy marka wydaje na Meta, Google, TikTok, influencerów, afiliacje, e-mail i SMS, samo GA4 może nie odpowiadać na pytanie, które naprawdę interesuje operatorów: który wydatek jest faktycznie rentowny? Obecność natywnych dla DTC narzędzi atrybucyjnych sugeruje, że problem atrybucji przeszedł z niszowej troski do powszechnego bólu zespołów growth.
Rebuy pojawia się na 9,0%. To sygnał post-purchase i upsellu. Niski udział sugeruje, że wiele marek nadal ma przestrzeń do poprawy wartości koszyka i monetyzacji po zakupie. W przypadku marek z produktami uzupełniającymi się lub z powtarzalnymi zakupami upsell po zakupie może być skuteczniejszy niż gonienie za nowym ruchem.
Te narzędzia nie są rekomendacją dla każdej marki. To markery dojrzałości. Marka nie powinna instalować Triple Whale, zanim nie ma wystarczających wydatków paid media, by uzasadnić lepszą atrybucję. Nie powinna wdrażać analityki zachowań, jeśli nikt nie będzie przeglądał sesji. Nie powinna dodawać Rebuy, jeśli katalog produktów nie ma logicznych zakupów komplementarnych. Benchmark jest użyteczny, bo pokazuje, kiedy te narzędzia wchodzą do widocznego stosu, a nie dlatego, że mówi, iż każdy ich potrzebuje.
8. Różnice między kategoriami: beauty i wellness działają na głębszych stosach
Klasyfikacja kategorii w tym badaniu jest oparta na regułach i niedoskonała. Ponad połowa całej puli marek trafia do „Other”, więc wnioski kategoriowe należy czytać orientacyjnie. Mimo to oznaczone kategorie ujawniają przydatne wzorce w grupach z wystarczającą liczbą próbek.
| Kategoria | Próba | Udział Shopify w próbie | Śr. liczba wykrytych narzędzi | TikTok | |
|---|---|---|---|---|---|
| Apparel & Footwear | 141 | 95,0% | 4,2 | 48,2% | 31,2% |
| Food & Beverage | 103 | 88,3% | 4,3 | 55,3% | 31,1% |
| Beauty & Skincare | 87 | 94,3% | 4,7 | 43,7% | 26,4% |
| Health & Wellness | 48 | 87,5% | 4,9 | 39,6% | 25,0% |
| Outdoor & Sports | 42 | 92,9% | 4,0 | 47,6% | 23,8% |
Beauty & Skincare oraz Health & Wellness mają najgłębsze wykryte stosy w tej tabeli. To ma sens. Kategorie te często obejmują edukację, zaufanie, składniki, subskrypcje, rutyny, opinie, ostrożność regulacyjną i powtarzalne zakupy. Marka wellness może potrzebować treści, edukacji e-mailowej, quizów, subskrypcji, atrybucji, wsparcia i analityki zachowań, aby przeprowadzić sceptycznego klienta od świadomości do kolejnego zakupu.
Food & Beverage ma najwyższe pokrycie Instagramem w tym ujęciu. To także pasuje do kategorii. Jedzenie jest wizualne, rytualne, związane z okazją i łatwe do pokazania w kontekście stylu życia. Apparel & Footwear ma najwyższe pokrycie TikTokiem, mniej więcej na równi z Food & Beverage, co pasuje do short-form try-on, stylizacji, haulów i treści twórców.
Dla marketerów treści ta sekcja jest mocną okazją do repurpose. Ogólny benchmark jest przydatny, ale raporty specyficzne dla kategorii często docierają dalej. „Co naprawdę instalują marki beauty DTC” albo „Dlaczego food DTC ponadprzeciętnie korzysta z Instagramu” prawdopodobnie lepiej zagra w tych społecznościach wertykalnych niż ogólna historia o stosie DTC.
9. Copy na stronie głównej: DTC jest bardziej transakcyjne, niż wynika z jego autoobrazu
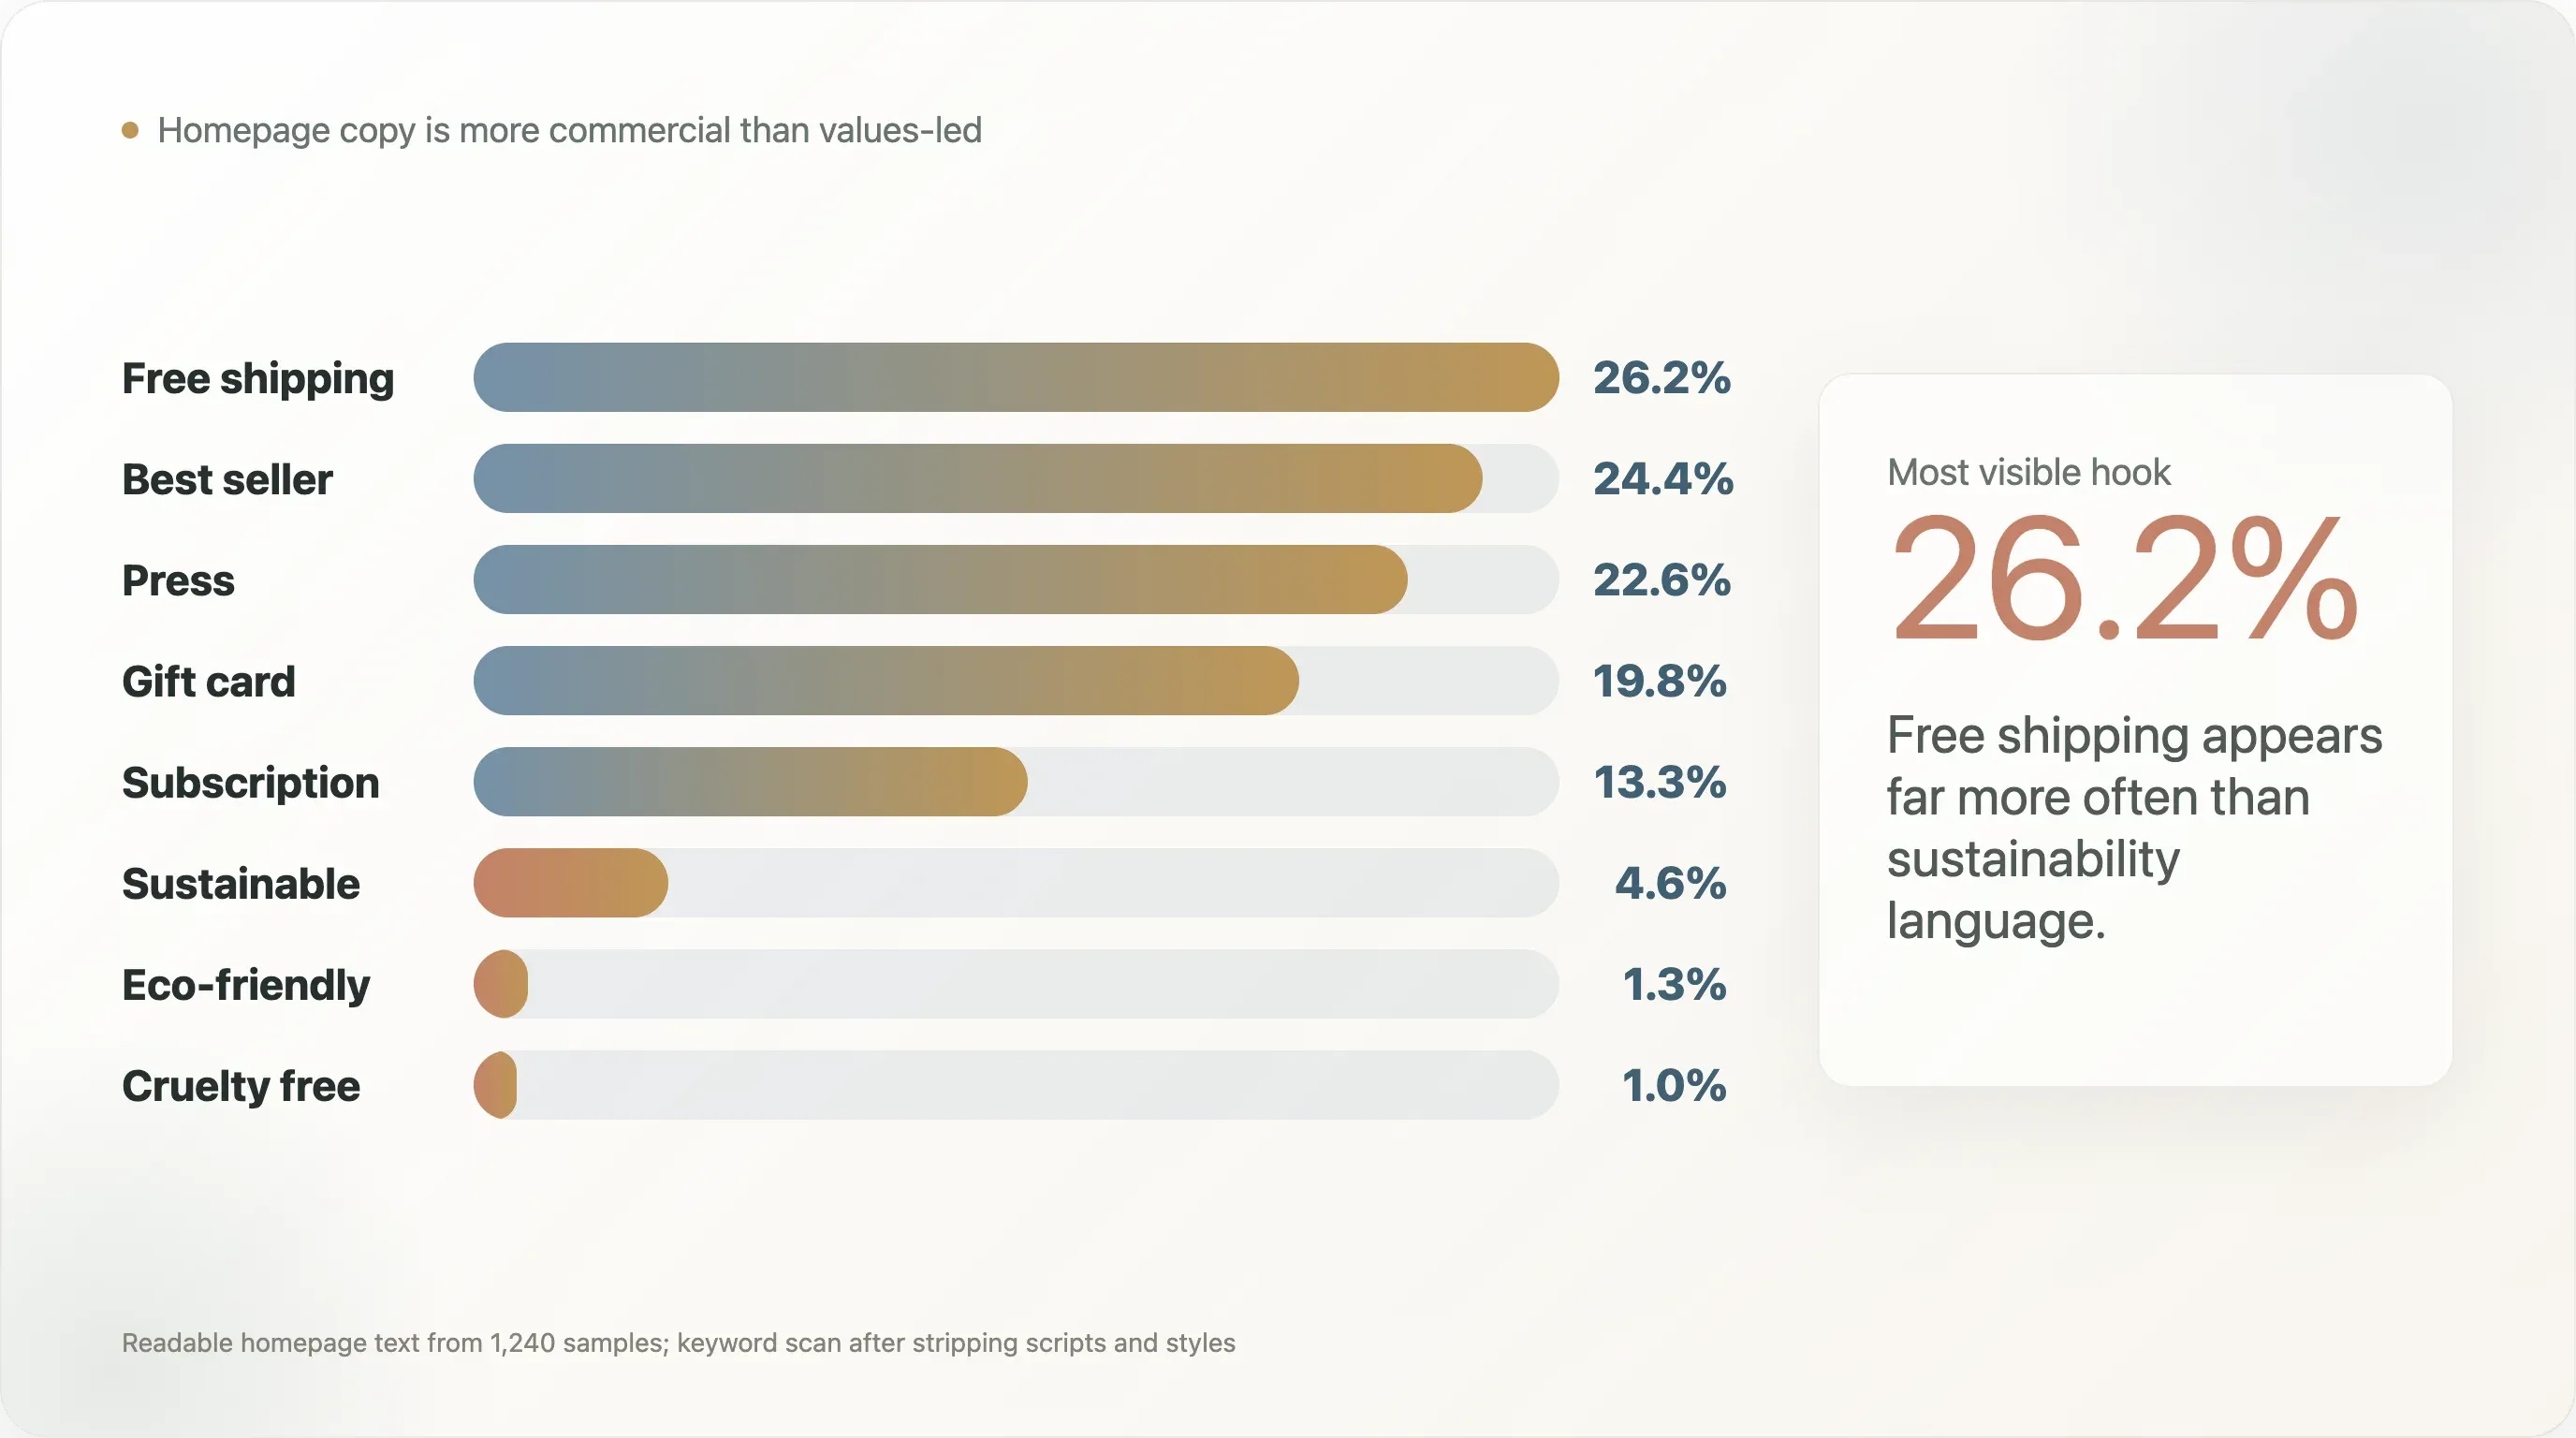
Skany tekstu propozycji wartości analizowały czytelny tekst strony głównej po usunięciu skryptów i styli. Celem nie było ocenianie jakości marki. Chodziło o sprawdzenie, które frazy pojawiają się na tyle często, by odzwierciedlać publiczne pozycjonowanie.
| Słowo kluczowe lub motyw | Pokrycie |
|---|---|
| free shipping | 26,2% |
| best seller | 24,4% |
| press / as seen on | 22,6% |
| gift card | 19,8% |
| exclusive | 14,3% |
| subscription | 13,3% |
| craft / artisan | 11,5% |
| luxury | 5,7% |
| organic | 4,9% |
| vegan | 4,7% |
| sustainable | 4,6% |
| eco-friendly | 1,3% |
| cruelty free | 1,0% |
Najbardziej widoczne komunikaty są praktyczne i komercyjne: darmowa dostawa, bestsellery, wiarygodność PR, karty podarunkowe, ekskluzywność i subskrypcje. Terminy związane ze zrównoważeniem pojawiają się znacznie rzadziej. Nie oznacza to, że marki DTC nie są zrównoważone. Oznacza to, że zrównoważenie nie jest głównym językiem konwersji na stronie głównej w tej próbie.
To użyteczna kontrnarracja dla mediów i newsletterów, bo DTC często opisuje się przez wartości, misję, zrównoważenie i społeczność. Publiczne copy na stronie głównej w tej próbie jest bardziej zorientowane na konwersję. Marki nadal muszą redukować tarcie, potwierdzać popyt, pokazywać wiarygodność i prowadzić odwiedzających do zakupu.
„Press / as seen on” na poziomie 22,6% jest szczególnie interesujące dla zespołów PR. Sugeruje, że earned media to nie tylko świadomość. Staje się ono wielokrotnie wykorzystywanym aktywem zaufania na stronie głównej. Mocny materiał prasowy może żyć w ścieżce konwersji długo po publikacji artykułu.
„Gift card” na poziomie 19,8% jest też ciekawsze, niż wygląda. Karty podarunkowe mogą działać jako narzędzie przychodu, pozyskania, lojalności i cash flow. To nie tylko dodatek świąteczny. Dla marek DTC o wysokiej „giftability” moduł kart podarunkowych może zmniejszać tarcie decyzyjne u klientów, którzy lubią markę, ale nie znają dokładnego rozmiaru, gustu, odcienia czy konkretnej potrzeby odbiorcy.
10. Liderzy kontra długi ogon: liczba narzędzi nie jest fosą
Podział na liderów i długi ogon opiera się na widoczności w źródłach, a nie na przychodzie. „Head” oznacza markę obecną w co najmniej trzech kolekcjach źródłowych. „Tail” oznacza markę obecną w jednej kolekcji źródłowej. To publiczny wskaźnik widoczności w źródłach.
| Wymiar | Grupa liderów | Grupa długiego ogona |
|---|---|---|
| Wielkość próby | 89 | 708 |
| Udział Shopify w próbie | 93,3% | 84,7% |
| Śr. liczba wykrytych narzędzi analitycznych | 4,5 | 4,1 |
| Mediana wykrytych narzędzi analitycznych | 4 | 4 |
| Shop Pay | 82,0% | 77,1% |
| PayPal | 75,3% | 64,8% |
| Afterpay | 11,2% | 7,3% |
Różnica w głębokości stosu jest niewielka. To ważne. Oznacza, że mniejsze lub mniej widoczne marki mogą korzystać z większości tej samej infrastruktury co bardziej znane marki. Współczesny operator ecommerce nie potrzebuje ogromnego zespołu, żeby wdrożyć GA4, Klaviyo, Shop Pay, PayPal, Microsoft Clarity lub podstawowe piksele.
Różnica dotyczy tego, jak te narzędzia są używane i jakie zaawansowane narzędzia pojawiają się jako następne. Marka z grupy liderów może nie mieć dużo więcej narzędzi, ale częściej ma silniejszą atrybucję, lepsze opcje checkoutu, czystszą zgodność, dojrzalsze wsparcie i lepszy ład. Fosa nie polega na liście aplikacji. Fosa polega na dyscyplinie operacyjnej.
Dla średniego segmentu DTC wniosek jest jednocześnie zachęcający i niewygodny. Zachęcający, bo narzędzia są dostępne. Niewygodny, bo jeśli każdy może zainstalować te same narzędzia, przewaga przesuwa się na egzekucję: tempo testów kreatywnych, segmentację e-mail, jakość stron produktowych, techniczne SEO, schemat, szybkość, pomiar lifecycle i dyscyplinę kampanii.
11. Co operatorzy powinni z tym zrobić
Benchmark staje się użyteczny dopiero wtedy, gdy przekłada się na decyzje. Oto praktyczna kolejność działań.
Po pierwsze, zrób audyt bazy. Sprawdź, czy zdarzenia GA4 są czyste, śledzenie zakupu jest wiarygodne, Klaviyo lub platforma retencyjna są poprawnie połączone, opcje checkoutu działają, zachowanie zgód jest zgodne z przepisami, a wszystkie główne piksele płatne są celowe. Nie dodawaj narzędzi, żeby kompensować zepsute fundamenty.
Po drugie, popraw podstawy AI-search i SEO. Zweryfikuj meta description, tagi canonical, Open Graph, hreflang tam, gdzie to ma sens, oraz JSON-LD. Największa szansa leży w schemacie Product. Jeśli marka sprzedaje produkty online, fakty o produkcie powinny być czytelne maszynowo na stronach produktowych.
Po trzecie, przeprowadź przegląd tagów. Wyeksportuj skrypty i domeny zewnętrzne. Przypisz właściciela do każdego z nich. Usuń porzuconych dostawców. Opóźniaj skrypty niekrytyczne. Uczyń zachowanie zgód jawne. To jedno z tych rzadkich zadań, które pomaga jednocześnie SEO, inżynierii, analityce i marketingowi.
Po czwarte, sprawdź tarcie checkoutu według kategorii i AOV. Jeśli AOV jest wysoki, BNPL może być warte testu. Jeśli marka sprzedaje międzynarodowo, PayPal i lokalne oczekiwania płatnicze mają znaczenie. Jeśli Apple Pay lub Google Pay są obecne, ale niewidoczne publicznie w crawl’u, upewnij się, że faktyczne doświadczenie checkoutu nadal wyraźnie je pokazuje.
Po piąte, połącz stronę z własnymi kanałami społecznościowymi w sposób celowy. Jeśli Instagram, TikTok, YouTube, Pinterest, LinkedIn lub X są ważne dla marki, oficjalna strona powinna kierować użytkowników właśnie tam. Jeśli dany kanał nie ma już znaczenia, usuń nieaktualną ikonę.
Po szóste, traktuj zaawansowane narzędzia jako zobowiązania operacyjne. Triple Whale, Northbeam, Rebuy, Attentive, Gorgias i narzędzia analityki zachowań mogą tworzyć wartość, ale tylko wtedy, gdy zespół ma wokół nich workflow. Narzędzie bez właściciela to po prostu kolejny skrypt.
Metodologia
Początkowa pula zawierała 1 597 kandydatów na marki DTC zebranych z publicznych źródeł ecommerce i DTC, w tym bibliotek case study narzędzi, materiałów ekosystemu Shopify i publicznych indeksów DTC. Spośród nich 1 431 kandydatów zostało przypisanych do domen. Crawl zakończył analizę strony głównej dla 1 238 witryn i pobrał zawartość strony głównej dla 1 240 domen w dniu 11 maja 2026 r.
Crawl próbował pobrać stronę główną, stronę produktu tam, gdzie była wykrywalna, endpointy sitemap, kandydatów llms.txt i kandydatów strony „about”. Surowy HTML był przechowywany według domen. Wykrywanie opierało się na wzorcach fingerprint dla platform ecommerce, frameworków frontend, narzędzi analitycznych i marketingowych, sygnałów płatności, pól SEO/schema, linków społecznościowych i liczników związanych z wydajnością.
Analiza odzwierciedla głównie publiczny markup witryn. Nie obejmuje dostępu do wewnętrznych kont analitycznych, kont reklamowych, ustawień administracyjnych checkoutu, skuteczności e-maili, danych sprzedażowych, współczynników konwersji, poziomu ruchu ani przychodów. Nie twierdzi też, że wykryte narzędzie jest poprawnie skonfigurowane lub aktywnie używane.
Zastrzeżenia do cytowania
-
To nie jest spis powszechny branży. Próba jest obciążona w stronę marek widocznych w ekosystemach narzędzi ecommerce i publicznych listach DTC. Używaj sformułowań typu „wśród 1 238 kompletnych próbek witryn DTC w tym badaniu”, a nie „wszystkie marki DTC”.
-
Shopify jest nadreprezentowany z założenia. Udział Shopify w próbie należy traktować jako cechę próby, a nie udział rynkowy.
-
Wykrywanie narzędzi to dolna granica. Skrypty dynamiczne, tagi za zgodą, metody checkoutu wstrzykiwane inline i treści renderowane po stronie klienta mogą zostać pominięte.
-
Rozmiar bajtowy strony głównej jest ograniczony. Proces zbierania danych ograniczał odczyt HTML do 256 KB, więc rozmiaru strony nie należy cytować jako wniosku wydajnościowego. Liczba skryptów i liczba domen zewnętrznych są bardziej użyteczne.
-
Widoczność społecznościowa to nie aktywność społecznościowa. Linki społecznościowe na stronie głównej pokazują routing z oficjalnej strony, a nie liczbę obserwujących, częstotliwość publikacji, dystrybucję twórców, paid social ani przychody z sociali.
-
Klasyfikacja kategorii ma charakter orientacyjny. Taksonomia opiera się na słowach kluczowych i ma dużą kategorię „Other”. Tabele kategorii są przydatne do rozpoznawania wzorców, a nie do dokładnego określania wielkości rynku.
-
To migawka z jednego momentu. Dane zebrano 11 maja 2026 r. Strony zmieniają się często, a przyszłe odświeżenia mogą pokazać istotne przesunięcia.
Uwagi dotyczące odtwarzalności
Folder dostawy zawiera:
00_expand_brand_pool.py— rozszerza początkową pulę kandydatów na marki DTC z publicznych list źródłowych.01_resolve_domains.py— rozwiązuje nazwy marek i wpisy źródłowe do kanonicznych domen.02_fetch_pages.py— pobiera stronę główną, stronę produktu, sitemap, kandydatówllms.txti kandydatów strony „about”.03_detect_all.py— uruchamia wykrywanie platform, analityki, płatności, SEO, schema, social i sygnałów wydajności.04_build_master.py— buduje ujednoliconą tabelę analityczną per marka.05_analyze_reports.py— generuje statystyki zbiorcze użyte w raporcie.07_categorize_brands.py— stosuje klasyfikator kategorii oparty na słowach kluczowych.08_extra_analysis.py— tworzy dodatkowe wyniki SEO, wydajności, CTA, value prop i współwystępowania.
Pobierz wszystkie skrypty i zbiory danych
Poprawki metodologiczne, kwestie związane ze zbiorem danych i analizy uzupełniające są mile widziane pod adresem support@thunderbit.com. Ten raport jest publikowany niezależnie od jakiejkolwiek komercyjnej pozycji Thunderbit; budujemy opartego na AI web scrapera i mamy strukturalny interes w tym, aby strony ecommerce stawały się bardziej czytelne dla ludzi, wyszukiwarek, systemów analitycznych i agentów AI. Benchmark opiera się na 1 238 kompletnych próbkach stron DTC zebranych 11 maja 2026 r. Dane w tym raporcie bronią się same. — Zespół badawczy Thunderbit, maj 2026.
Wypróbuj Thunderbit do benchmarkingu stron DTC Get Started Free



