
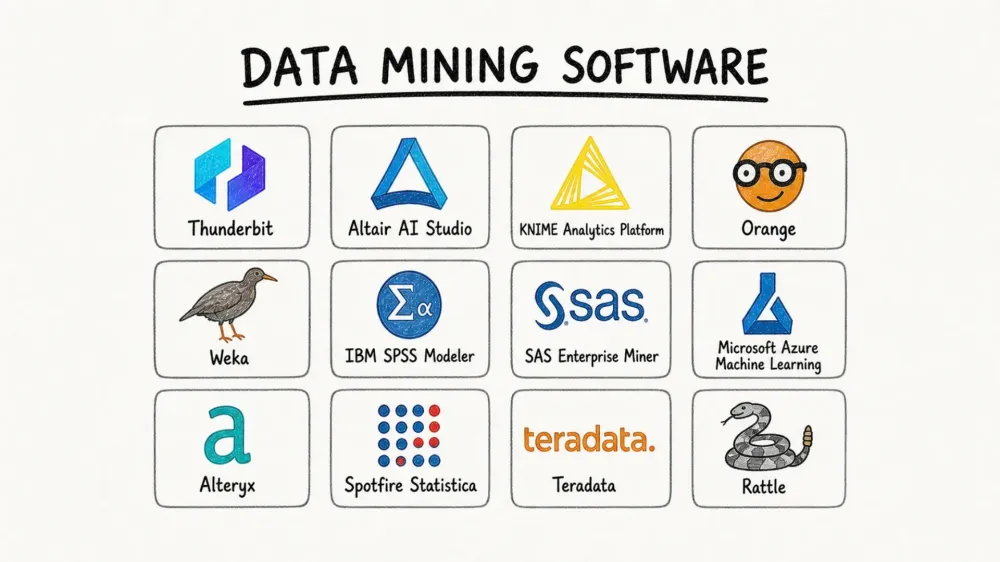
Firmy w 2026 roku nie zmagają się już z brakiem danych. Zmagają się raczej z brakiem narzędzi, które dobrze pasują do ich sposobu pracy. Światowe Forum Ekonomiczne zauważyło, że globalna produkcja danych miała osiągnąć 181 zettabajtów w 2025 roku, a IBM szacuje, że około 68% danych korporacyjnych pozostaje niewykorzystanych. Właśnie dlatego oprogramowanie do data mining nadal ma znaczenie: nie jako modne hasło, ale jako praktyczna warstwa, która zamienia surowe rekordy, dokumenty, dane ze stron internetowych i strumienie zdarzeń w wzorce, z których naprawdę da się korzystać.
Definicja IBM wciąż pozostaje najprostsza i najtrafniejsza: data mining wykorzystuje uczenie maszynowe i analizę statystyczną, aby wydobywać przydatne informacje z dużych zbiorów danych. W praktyce oznacza to, że kupujący oceniają dziś znacznie szerszy zestaw narzędzi, niż sugeruje stara definicja akademicka. Jedne zespoły potrzebują wizualnych narzędzi do modelowania. Inne — kontrolowanej analityki klasy enterprise. Jeszcze inne — chmurowego ML i infrastruktury do przetwarzania strumieniowego. A niektóre po prostu muszą najpierw zebrać chaotyczne dane z internetu, zanim w ogóle zacznie się analiza.
Szybkie rekomendacje według procesu pracy
- Potrzebujesz szybko zebrać dane ze stron internetowych przed analizą? Zacznij od Thunderbit.
- Potrzebujesz wizualnej platformy data science bez kodowania? Rozważ Altair AI Studio i KNIME.
- Szukasz najłatwiejszego open-source’owego punktu startowego do nauki lub prototypowania? Sprawdź Orange i Weka.
- Potrzebujesz enterprise predictive analytics z governance? Porównaj IBM SPSS Modeler, SAS Enterprise Miner i Spotfire Statistica.
- Potrzebujesz chmurowego ML i wdrożeń? Sprawdź Microsoft Azure Machine Learning, Dataiku i H2O.ai.
- Potrzebujesz dużych pipeline’ów lub analityki in-database? Skup się na Teradata i Google Cloud Dataflow.
Sprawdź, czy Thunderbit pasuje do Twojego procesu pracy z danymi
Co dziś liczy się jako oprogramowanie do data mining w 2026 roku?
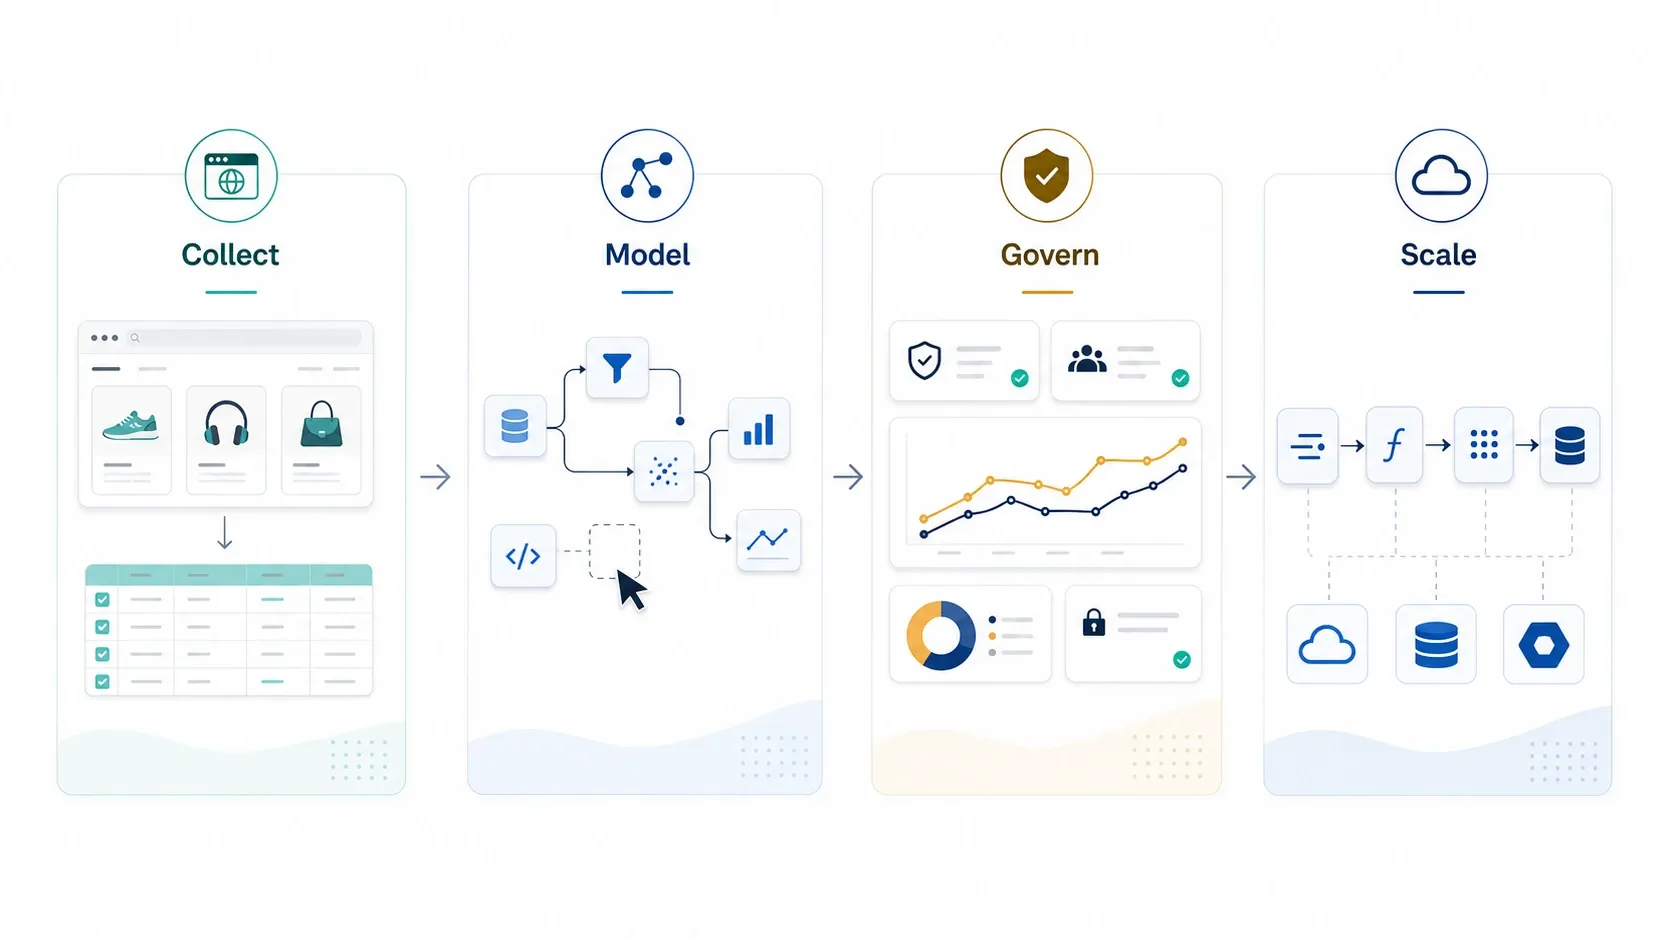
To hasło obejmuje teraz cztery różne potrzeby zakupowe:
- Narzędzia do pozyskiwania danych: produkty, które pomagają zebrać lub uporządkować surowe dane jeszcze przed rozpoczęciem analizy.
- Wizualne narzędzia workflow: platformy, które pozwalają analitykom czyścić dane, budować modele i oceniać wyniki bez ciężkiego programowania.
- Enterprise’owe pakiety statystyczne i predykcyjne: kontrolowane środowiska dla większych organizacji i zespołów działających w regulowanych branżach.
- Warstwy chmurowe i infrastrukturalne: platformy wspierające trenowanie na dużą skalę, wdrażanie modeli lub przetwarzanie w czasie rzeczywistym.
Dlatego ta lista jest celowo mieszana. Jeśli Twój zespół nadal spędza godziny na ręcznym przepisywaniu pól ze stron internetowych, narzędzie do zbierania danych z przeglądarki może dać większą wartość biznesową niż zaawansowany pakiet do modelowania, którego i tak nigdy w pełni nie wdrożycie. Z drugiej strony, jeśli wąskim gardłem jest zarządzane wdrażanie modeli albo przetwarzanie na poziomie hurtowni danych, sytuacja wygląda odwrotnie.
Jeśli chcesz najpierw obejrzeć krótki materiał wprowadzający, zanim porównasz narzędzia, ten przegląd IBM nadal jest jednym z najlepszych materiałów startowych, ponieważ wyjaśnia, gdzie data mining mieści się względem analityki, uczenia maszynowego i usprawniania procesów:
Tabela szybkiego porównania: najlepsze programy do data mining w 2026 roku
| Narzędzie | Najlepsze dla | Co wyróżnia | Sygnał cenowy |
|---|---|---|---|
| Thunderbit | Zespoły biznesowe, które potrzebują surowych danych z internetu przed analizą | Sugestie pól AI, podstrony, paginacja, eksport do Sheets / Excel / Airtable / Notion | Darmowy plan; płatne plany self-serve; plany biznesowe |
| Altair AI Studio | Wizualne workflow ML bez ciężkiego kodowania | Projektowanie metodą drag-and-drop, AutoML, interaktywne przygotowanie danych; wcześniej RapidMiner Studio | Darmowy okres próbny; wersje komercyjne |
| KNIME | Open-source’owa analityka workflow i automatyzacja | Pipeline’y oparte na węzłach, silna społeczność, szerokie rozszerzenia | Darmowa platforma; płatne produkty biznesowe |
| Orange | Początkujący i wizualne środowisko nastawione na naukę | Bardzo przystępne wizualne widgety i workflow eksploracyjne | Darmowe i open-source |
| Weka | Eksperymentowanie z algorytmami i edukacja | Bogata biblioteka klasycznych metod ML w lekkim GUI | Darmowe i open-source |
| IBM SPSS Modeler | Enterprise’owe zespoły zajmujące się predictive analytics | Wizualne strumienie, analityka tekstu, wdrożenia przyjazne governance | Wycena indywidualna / enterprise |
| SAS Enterprise Miner | Branże regulowane i zespoły korzystające z SAS | Dojrzała głębia modelowania, obsługa dużych zbiorów danych, integracja z SAS | Wycena indywidualna / enterprise |
| Azure Machine Learning | Analiza i ML w chmurze dla organizacji Microsoft-first | AutoML, MLOps, integracja z Azure, zarządzane wdrożenia | Cennik chmurowy oparty na użyciu |
| Alteryx | Analitycy automatyzujący przygotowanie danych i self-service analytics | Przygotowanie danych metodą drag-and-drop, powtarzalne workflow, szeroka adopcja biznesowa | Wersja próbna plus ceny enterprise |
| Spotfire Statistica | Głębia statystyczna plus kontrola klasy enterprise | Zaawansowana analityka, wielokrotnego użytku workflow, monitoring zorientowany na zgodność | Wycena indywidualna / enterprise |
| Teradata | Analiza in-database na ogromną skalę | Wysoka wydajność na bardzo dużych danych korporacyjnych i zarządzanych środowiskach danych | Enterprise / kontrakt |
| Rattle | Nauka oparta na R i tanie prototypowanie | GUI nad workflow R z widocznością kodu | Darmowe i open-source |
| Dataiku | Zespoły data science pracujące między działami | Współpraca no-code + code, automatyzacja, governance | Darmowa edycja; ceny enterprise |
| H2O.ai | AutoML i skalowalne budowanie modeli | Szybkie modelowanie, explainability, mocny ekosystem ML | Open-source + oferta enterprise |
| Google Cloud Dataflow | Przetwarzanie danych w czasie rzeczywistym i na dużych batchach | Zarządzane pipeline’y Apache Beam, autoscaling, obsługa streamingu | Cennik chmurowy oparty na użyciu |
15 najlepszych narzędzi do data mining dla firm w 2026 roku
Najlepsze do szybkiego zbierania danych i wizualnego workflow mining
1. Thunderbit

Thunderbit zasługuje na miejsce w tym zestawieniu, ponieważ wiele projektów data mining w firmach kończy się jeszcze przed etapem modelowania. Dane są na stronach internetowych, w PDF-ach, na wewnętrznych portalach badawczych, w katalogach lub na listach bogatych w obrazy. Jeśli nie da się ich zebrać w uporządkowany sposób, cały stos analityczny traci znaczenie.
Thunderbit sprawdza się najmocniej wtedy, gdy praca zaczyna się w przeglądarce, a zespół chce szybko dostać strukturalny wynik. Sugestie pól AI, scrapowanie podstron, obsługa paginacji i bezpośrednie eksporty sprawiają, że to dobry wybór dla zespołów sprzedaży, e-commerce, operacji, rekrutacji i badań rynkowych, które nie chcą najpierw budować całego pipeline’u do scrapowania.
- Najlepsze dla: pozyskiwania danych z internetu przez użytkowników biznesowych.
- Co wyróżnia: sugestie pól AI, wzbogacanie podstron, uruchamianie w przeglądarce lub w chmurze, eksport do Sheets / Excel / Airtable / Notion.
- Dlaczego trafił na listę: usuwa wąskie gardło zbierania danych, które blokuje dalszą analizę.
- Sygnał cenowy: dostępny jest darmowy plan, płatne plany self-serve oraz opcje biznesowe.
Wypróbuj Thunderbit AI Web Scraper za darmo
2. Altair AI Studio
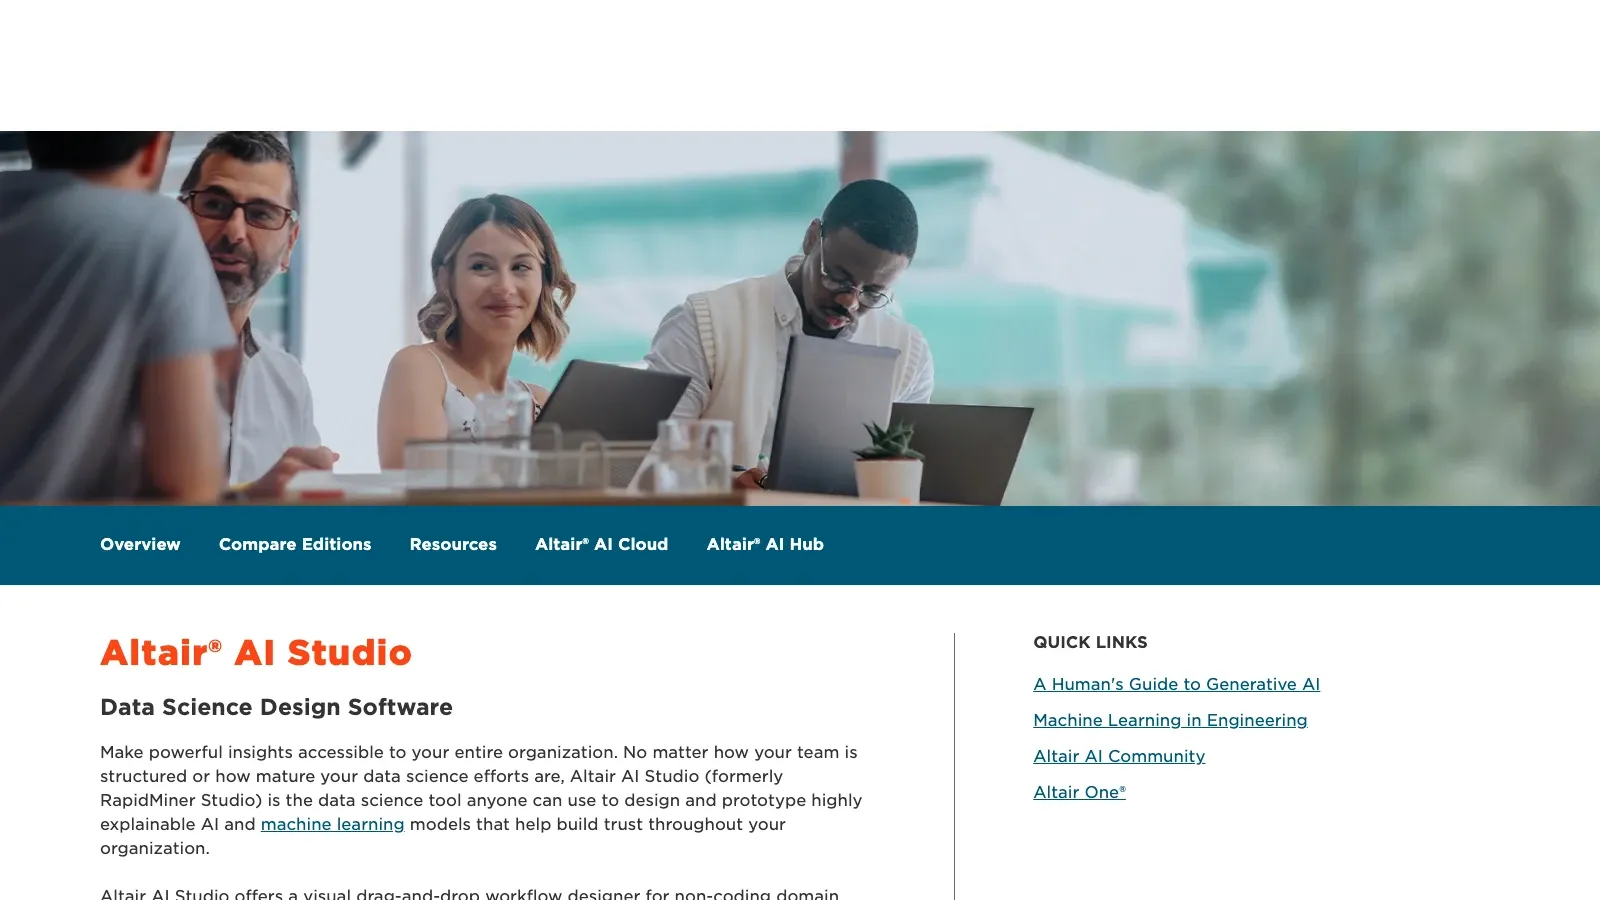
Altair AI Studio to jedna z najważniejszych zmian, które warto znać, jeśli kojarzysz tę kategorię ze starszych zestawień: to obecna nazwa produktu, który wielu kupujących pamięta jako RapidMiner Studio. Altair opisuje go jako wizualne narzędzie do projektowania data science metodą drag-and-drop z AutoML, interaktywnym przygotowaniem danych oraz wsparciem zarówno dla nowszych workflow AI, jak i klasycznego uczenia maszynowego.
To wciąż mocny wybór dla zespołów, które chcą solidnych możliwości modelowania bez budowania każdego procesu w notebookach. W porównaniu z narzędziami czysto edukacyjnymi daje lepszy pomost do powtarzalnego wykorzystania w biznesie.
- Najlepsze dla: analityków i ekspertów dziedzinowych, którzy chcą prowadzonego wizualnego workflow ML.
- Co wyróżnia: obszar roboczy drag-and-drop, AutoML, interaktywne przygotowanie, szeroka łączność danych.
- Uwaga: pozycjonowanie komercyjne jest mocniejsze niż w przypadku opcji open-source, więc zakup wymaga większej uwagi.
3. KNIME Analytics Platform
KNIME nadal jest najbardziej wszechstronnym open-source’owym narzędziem workflow na tej liście. Interfejs oparty na węzłach jest na tyle przystępny dla analityków, a jednocześnie na tyle rozbudowany, że zespoły mogą łączyć przygotowanie danych, analizę statystyczną, ML, automatyzację i rozszerzenia w jeden powtarzalny pipeline.
KNIME szczególnie dobrze działa tam, gdzie liczy się przejrzystość. Użytkownicy mogą prześledzić każdy krok workflow, współdzielić go i rozszerzać integracjami z Pythonem, R, bazami danych oraz innymi narzędziami.
- Najlepsze dla: zespołów stawiających na open-source i analityków pracujących na workflow.
- Co wyróżnia: wielokrotnego użytku pipeline’y, duży ekosystem rozszerzeń, silna społeczność.
- Uwaga: elastyczność jest świetna, ale interfejs może wydawać się bardziej „inżynierski” niż lekkie narzędzia dla początkujących.
4. Orange
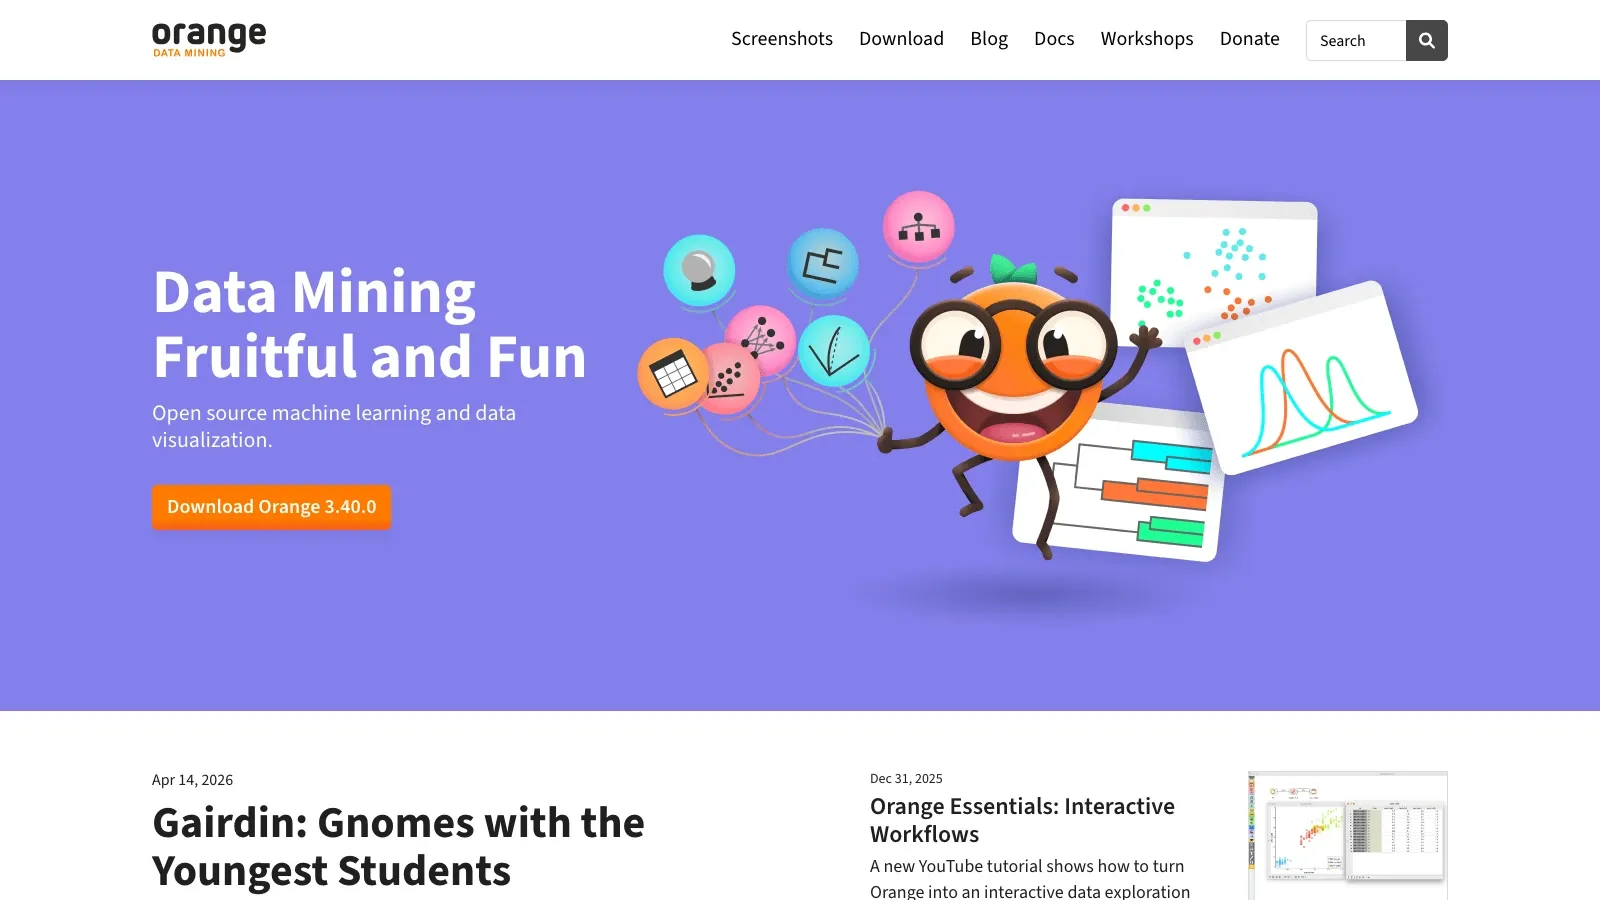
Orange pozostaje najbardziej przyjaznym środowiskiem data mining dla użytkowników, którzy chcą uczyć się przez obserwację. Interfejs oparty na widgetach sprawia, że klasyfikacja, klastrowanie, wizualizacja i text mining są znacznie łatwiejsze do zrozumienia niż w narzędziach nastawionych na wiersz poleceń.
Dla zespołów biznesowych Orange jest przede wszystkim narzędziem do szybkiego prototypowania lub nauki, a nie ciężką platformą enterprise z governance.
- Najlepsze dla: początkujących, nauczycieli, warsztatów i wczesnej eksploracji.
- Co wyróżnia: przystępny interfejs wizualny i mocne możliwości eksploracyjnej wizualizacji.
- Uwaga: nie jest to najlepszy wybór do wdrożeń enterprise ani do ciężkiej operacjonalizacji.
5. Weka
Weka pozostaje klasykiem nie bez powodu. Oferuje duży zestaw algorytmów uczenia maszynowego w kompaktowym interfejsie, który dobrze sprawdza się do eksperymentów, benchmarkingu i pracy dydaktycznej.
Jej znaczenie biznesowe jest dziś mniejsze niż kiedyś, ale nadal jest przydatna do szybkich testów, nauki i pracy na niewielkich zbiorach danych, gdy potrzebujesz szerokiego pokrycia algorytmicznego bez uruchamiania większej platformy.
- Najlepsze dla: porównywania algorytmów, edukacji i eksperymentów na małą skalę.
- Co wyróżnia: szerokie wsparcie klasycznych metod ML i lekki GUI.
- Uwaga: wygląda na starszą niż nowsze produkty workflow i nie jest zbudowana pod nowoczesne MLOps.
Jeśli chcesz zobaczyć, jak wygląda współczesny produkt do wizualnych workflow, zanim wybierzesz shortlistę, ten oficjalny przegląd GUI Altair AI Studio będzie dobrym punktem kontrolnym w środku artykułu:
Najlepsze do enterprise predictive analytics i kontrolowanego modelowania
6. IBM SPSS Modeler
IBM SPSS Modeler nadal jest najbezpieczniejszym wyborem do krótkiej listy dla organizacji, które chcą enterprise predictive analytics bez zmuszania każdego analityka do pracy w narzędziach wymagających intensywnego kodowania. Wizualny interfejs strumieniowy przetrwał próbę czasu, bo sprawia, że budowanie modeli, przygotowanie danych i scoring są zrozumiałe także dla interesariuszy biznesowych.
- Najlepsze dla: dużych organizacji, które chcą dostępnych predictive analytics z governance.
- Co wyróżnia: wizualne strumienie, wsparcie analityki tekstu, opcje wdrożeń enterprise.
- Uwaga: to zakup platformy, a nie lekkie narzędzie dla okazjonalnego użycia w zespole.
7. SAS Enterprise Miner
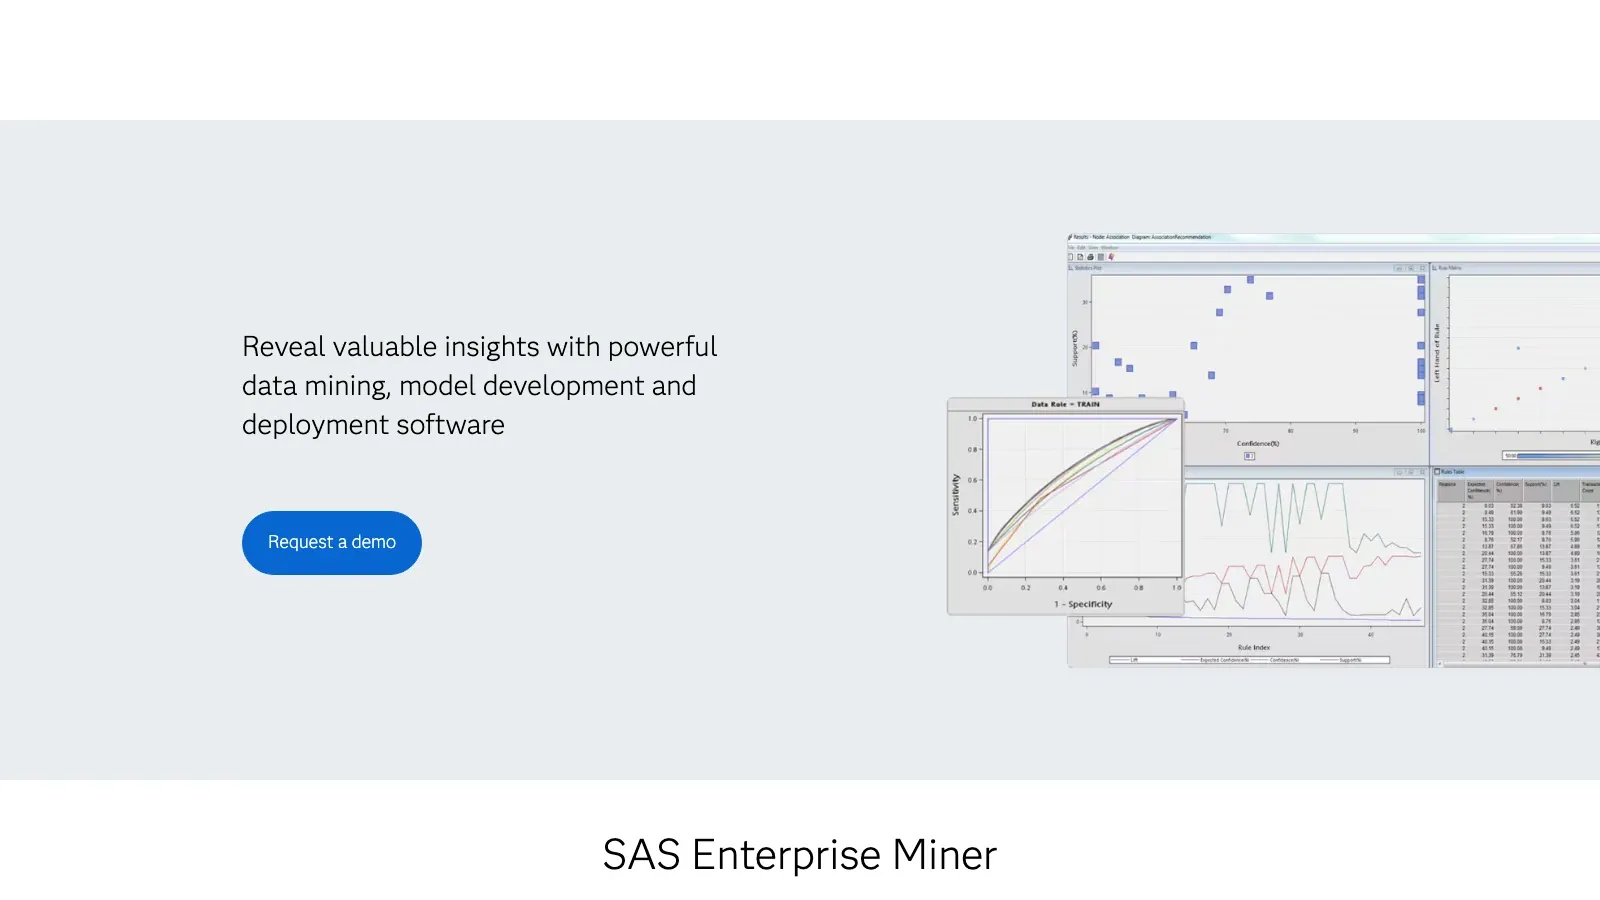
SAS Enterprise Miner pozostaje najbardziej aktualny w środowiskach regulowanych i tych, które są mocno osadzone w ekosystemie SAS. To nie jest najbardziej „modne” narzędzie w tej kategorii, ale nadal ma wysoką wiarygodność tam, gdzie ważniejsze są audytowalność, zaufanie instytucjonalne i istniejąca infrastruktura SAS niż podążanie za trendami.
- Najlepsze dla: usług finansowych, ochrony zdrowia, ubezpieczeń i innych regulowanych procesów.
- Co wyróżnia: dojrzała głębia modelowania, dopasowanie do ekosystemu SAS, obsługa dużych danych.
- Uwaga: zespoły bez wcześniejszych inwestycji w SAS mogą łatwiej wdrożyć nowsze platformy.
8. Microsoft Azure Machine Learning
Azure Machine Learning to najmocniejsza opcja dla zespołów, które już działają w ekosystemie chmurowym Microsoftu i chcą jednego środowiska do eksperymentów, AutoML, wdrożeń i monitoringu.
- Najlepsze dla: organizacji działających w modelu Azure-first, które chcą chmurowego ML i operacji.
- Co wyróżnia: AutoML, zarządzanie modelami, narzędzia wdrożeniowe, integracja z ekosystemem Microsoft.
- Uwaga: elastyczność chmury jest zaletą, ale wraz ze wzrostem użycia rośnie znaczenie kontroli kosztów.
9. Alteryx
Alteryx zasługuje na miejsce na liście, ponieważ duża część data mining w biznesie nadal sprowadza się tak naprawdę do czyszczenia, łączenia i operacjonalizowania pracy z danymi, która wcześniej żyła w arkuszach kalkulacyjnych. Alteryx od dawna jest narzędziem kupowanym przez analityków wtedy, gdy chcą przestać co tydzień ręcznie wykonywać te same bolesne transformacje.
- Najlepsze dla: analityków biznesowych automatyzujących ciężkie workflow przygotowania danych.
- Co wyróżnia: przygotowanie danych drag-and-drop, powtarzalne workflow analityczne, silna adopcja wśród użytkowników biznesowych.
- Uwaga: potężne, ale zwykle nie jest to najtańsza opcja dla mniejszych zespołów.
10. Spotfire Statistica
Spotfire Statistica pozostaje jednym z lepszych wyborów dla organizacji, które potrzebują zaawansowanych metod statystycznych i kontrolowanego wykorzystania operacyjnego. Obecne pozycjonowanie Spotfire podkreśla zaawansowaną analitykę, workflow wielokrotnego użytku oraz governance przyjazny zgodności.
- Najlepsze dla: produkcji, ochrony zdrowia, jakości i zespołów analitycznych zorientowanych na compliance.
- Co wyróżnia: dojrzała głębia statystyczna, wielokrotnego użytku workflow modeli, monitoring i governance.
- Uwaga: lepiej pasuje do uporządkowanych programów enterprise niż do lekkiego eksperymentowania.
Najlepsze do zaawansowanych platform danych, współpracy i skali
11. Teradata
Teradata znalazła się tutaj z jednego powodu: gdy Twój problem data mining siedzi w ogromnym, zarządzanym środowisku danych, wydajność i architektura liczą się równie mocno jak algorytmy. Teradata pozostaje istotna dla analityki in-database, hurtowni danych na dużą skalę i obciążeń enterprise, których mniejsze narzędzia punktowe nie są w stanie komfortowo obsłużyć.
- Najlepsze dla: ogromnych korporacyjnych zbiorów danych i analityki in-database.
- Co wyróżnia: skala, wydajność i dopasowanie do enterprise data estate.
- Uwaga: dla większości małych i średnich firm będzie to przesada.
12. Rattle
Rattle nadal jest użytecznym pomostem dla zespołów lub osób uczących się, które chcą korzystać z ekosystemu modelowania R bez dużej ilości skryptowania na starcie. Najlepiej traktować je jako tanie środowisko do nauki i prototypowania, a nie nowoczesną platformę współpracy.
- Najlepsze dla: osób uczących się R i prostego prototypowania.
- Co wyróżnia: GUI nad workflow R oraz widoczność kodu.
- Uwaga: wygląda na przestarzałe w porównaniu z nowszymi produktami do współpracy wizualnej.
13. Dataiku
Dataiku to jeden z najbardziej zrównoważonych produktów na tej liście, jeśli potrzebujesz jednocześnie współpracy i skali. Działa dobrze, ponieważ nie zmusza do fałszywego wyboru między użytkownikami no-code a zaawansowanymi praktykami. Użytkownicy biznesowi mogą pracować z recepturami i dashboardami, a użytkownicy techniczni zachowują kontrolę na poziomie kodu tam, gdzie jest to potrzebne.
- Najlepsze dla: zespołów data science i analitycznych działających między działami.
- Co wyróżnia: współpraca no-code + code, mocny governance, automatyzacja i wsparcie wdrożeń.
- Uwaga: to bardziej platforma niż to, czego potrzebuje wiele mniejszych zespołów przy wąskim zastosowaniu.
14. H2O.ai
H2O.ai pozostaje wysoko na liście dla organizacji, którym zależy na skalowalnym modelowaniu, AutoML i explainability. Jest szczególnie atrakcyjne, gdy szybkość i iteracja modeli są ważniejsze niż budowanie każdego elementu workflow od zera.
- Najlepsze dla: zespołów ML, które chcą szybkich iteracji i skalowalnej automatyzacji.
- Co wyróżnia: AutoML, szybkość modelowania, explainability, mocny ekosystem.
- Uwaga: jest bardziej zorientowane na ML, niż potrzebuje to wiele zespołów biznesowych.
15. Google Cloud Dataflow
Google Cloud Dataflow nie jest klasycznym „desktopowym narzędziem do data mining”, ale zasługuje na ostatnie miejsce, ponieważ wiele współczesnych projektów miningowych zależy od strumieniowych lub bardzo dużych batchowych pipeline’ów danych jeszcze zanim rozpocznie się analiza. Jeśli Twój przypadek użycia obejmuje dane streamingowe, przetwarzanie zdarzeń albo przygotowanie cech na dużą skalę, Dataflow staje się częścią faktycznego stosu data mining.
- Najlepsze dla: pipeline’ów streamingowych i przygotowania dużych batchy danych.
- Co wyróżnia: zarządzane Apache Beam, autoscaling, mocna integracja z GCP.
- Uwaga: to rozwiązanie infrastrukturalne, a nie narzędzie analityczne stworzone przede wszystkim dla użytkowników biznesowych.
Jak wybrać, żeby nie kupić zbyt dużo
Najczęstszy błąd zakupowy polega na pomyleniu źródła problemu:
- Jeśli problemem jest dostęp do danych, zacznij od narzędzia do ich pozyskiwania, takiego jak Thunderbit.
- Jeśli problemem jest produktywność analityków, najpierw porównaj Altair AI Studio, KNIME, Alteryx i Orange.
- Jeśli problemem jest governance enterprise, zawęź wybór do SPSS Modeler, SAS Enterprise Miner, Spotfire Statistica lub Dataiku.
- Jeśli problemem jest operacje ML w chmurze, zacznij od Azure Machine Learning, H2O.ai lub Dataiku.
- Jeśli problemem jest streaming lub architektura na ogromną skalę, zwróć się w stronę Teradata lub Dataflow.
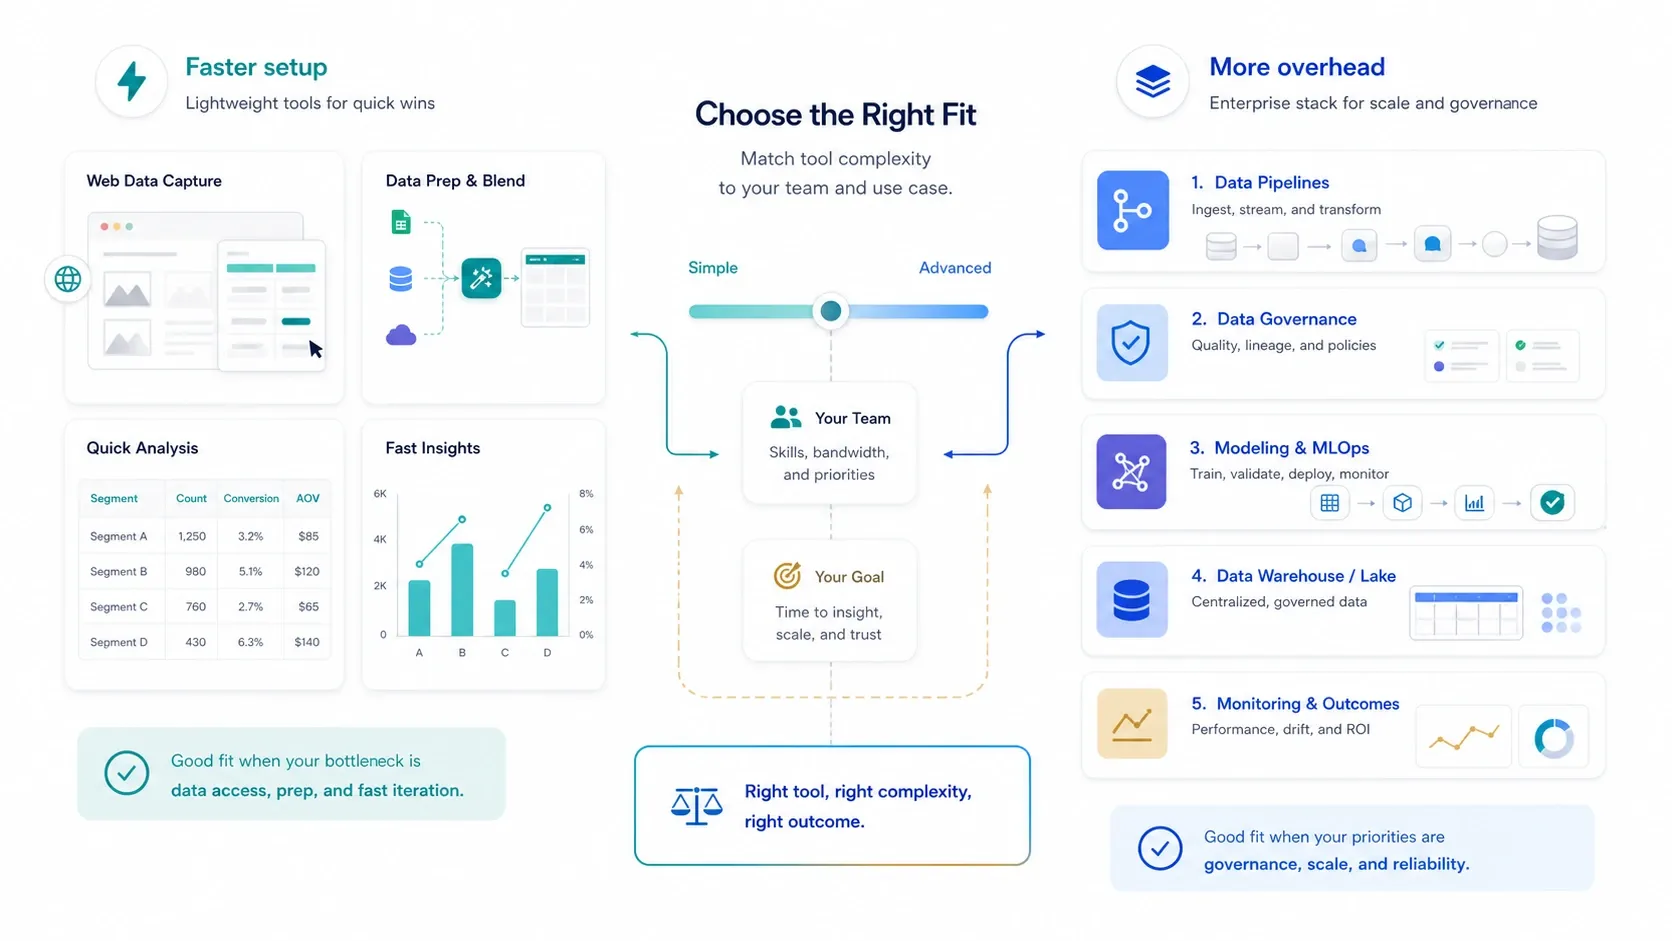
Pomaga prosta zasada: kup najmniej złożone narzędzie, które faktycznie usuwa Twoje wąskie gardło. Wiele zespołów nie potrzebuje ogromnej platformy data science. Potrzebują lepszego zbierania danych, czystszego przygotowania i jednego powtarzalnego workflow, którego analitycy naprawdę będą używać.
Jeśli na Twojej liście znajduje się webowe pozyskiwanie danych jako część stosu, ten krótki materiał startowy Thunderbit jest szczególnie przydatny, bo pokazuje drogę od chaotycznej strony do uporządkowanej tabeli bez wchodzenia w złożoność inżynierską:
Ostateczna krótka lista według typu zespołu
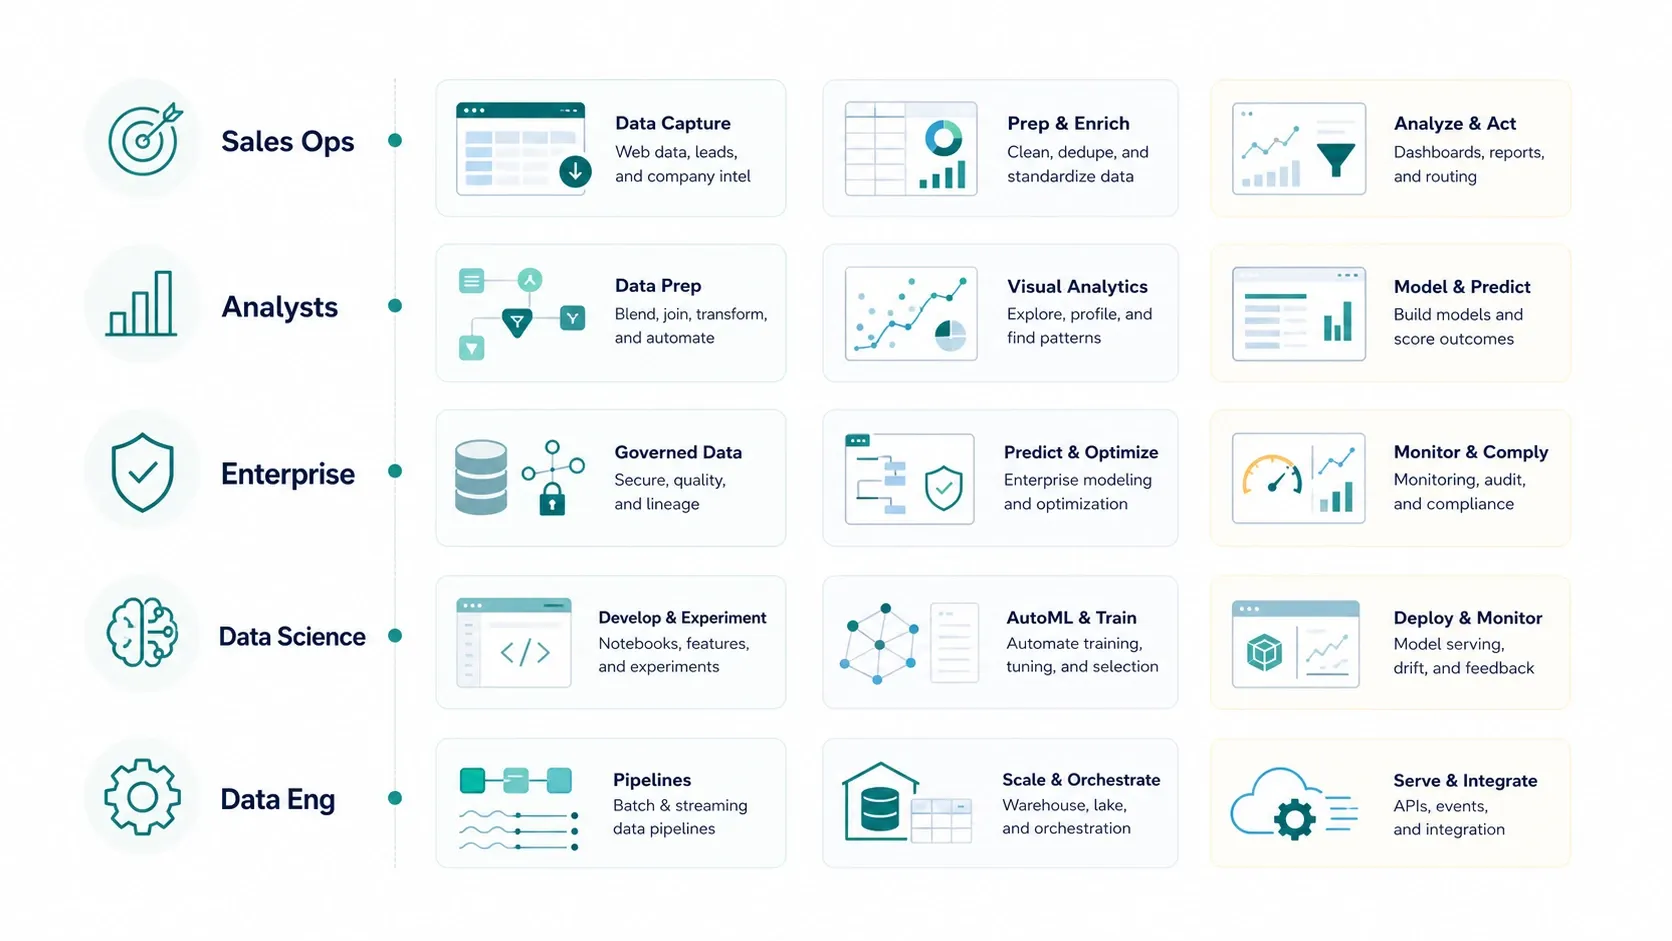
- Sprzedaż, e-commerce i zespoły operacyjne pracujące głównie w przeglądarce: Thunderbit, Alteryx, KNIME.
- Analitycy, którzy chcą wizualnych workflow bez głębokiej zależności od kodu: Altair AI Studio, KNIME, Alteryx, Orange.
- Enterprise’owe zespoły predictive analytics: IBM SPSS Modeler, SAS Enterprise Miner, Spotfire Statistica.
- Organizacje data science działające między działami: Dataiku, Azure Machine Learning, H2O.ai.
- Zespoły data engineering i platformowe: Teradata, Google Cloud Dataflow, Azure Machine Learning.
- Osoby uczące się lub budujące prototypy przy ograniczonym budżecie: Orange, Weka, Rattle, KNIME.
Gdybym miał skrócić tę listę do najbardziej praktycznej shortlisty dla większości kupujących biznesowych w 2026 roku, wyglądałaby ona tak:
- Thunderbit do szybkiego pozyskiwania danych ze stron i dokumentów przed analizą.
- Altair AI Studio do wizualnego data science i AutoML bez workflow opartego najpierw na notebookach.
- KNIME dla elastyczności open-source’owego workflow.
- IBM SPSS Modeler dla enterprise predictive analytics z przyjaznym dla biznesu interfejsem.
- Dataiku dla zespołów, które potrzebują jednocześnie współpracy, governance i skali.
Podsumowanie
Prawdziwe pytanie nie brzmi, który produkt ma najdłuższą listę funkcji. Brzmi raczej: które narzędzie doprowadzi Twój zespół od surowych danych do obronionej decyzji przy najmniejszym oporze. W 2026 roku zwykle oznacza to rozdzielenie problemów związanych z pozyskiwaniem, przygotowaniem, modelowaniem i wdrażaniem danych, zamiast udawać, że jeden zakup równie dobrze rozwiąże każdy z tych poziomów.
Jeśli Twoja praca zaczyna się od publicznych stron internetowych, PDF-ów i nieustrukturyzowanych stron, zacznij od Thunderbit. Jeśli zaczyna się od kontrolowanego enterprise modelowania, zacznij wyżej w stosie narzędzi, takich jak SPSS Modeler, Dataiku lub Azure Machine Learning. A jeśli nadal uczysz się, jakiej klasy platformy w ogóle potrzebujesz, KNIME, Orange i Altair AI Studio wciąż są najlepszym miejscem, by szybko uzyskać wartościowe sygnały.
Polecane lektury
- Czym jest data scraping i jak go zrobić
- Jak scrapować dowolną stronę internetową z użyciem AI
- Najlepsze narzędzia do web scrapingu w 2026 roku
FAQ
1. Czym w prostych biznesowych słowach jest oprogramowanie do data mining?
Oprogramowanie do data mining pomaga zespołom znajdować wzorce, segmenty, anomalie, trendy i sygnały predykcyjne w surowych danych. W realnym procesie biznesowym zwykle oznacza to połączenie pozyskiwania danych, czyszczenia, budowania modeli, scoringu i raportowania.
2. Czy oprogramowanie do data mining jest tylko dla data scientistów?
Nie. Rynek jest dziś podzielony między kupujących technicznych i nietechnicznych. Thunderbit, Altair AI Studio, KNIME, Orange i Alteryx obniżają próg wejścia dla analityków i zespołów biznesowych, a platformy takie jak Dataiku, Azure ML i H2O.ai obsługują też bardziej zaawansowanych użytkowników.
3. Jakie jest najlepsze oprogramowanie do data mining dla zespołu nietechnicznego?
Jeśli Twoje dane zaczynają się w internecie, Thunderbit jest najszybszym pierwszym krokiem. Jeśli potrzebujesz szerszej analityki wizualnej i modelowania workflow, Altair AI Studio, KNIME, Orange i Alteryx to najmocniejsze opcje no-code lub low-code na tej liście.
4. Czy wybrać narzędzie open-source czy platformę enterprise?
Wybierz open-source, gdy potrzebujesz elastyczności, niższego kosztu wejścia i przestrzeni do eksperymentów. Wybierz platformy enterprise, gdy ważniejsze od prostoty licencyjnej są governance, wsparcie, kontrola wdrożeń, zgodność i standaryzacja między zespołami.
5. Czy mogę używać kilku z tych narzędzi razem?
Tak, i wiele zespołów powinno to robić. Popularny zestaw to zbieranie danych w Thunderbit, przygotowanie lub modelowanie w KNIME albo Alteryx, a potem operacjonalizacja i monitoring w platformie chmurowej lub enterprise. Najlepszy stack zwykle rozwiązuje różne warstwy procesu, zamiast zmuszać jedno narzędzie do robienia wszystkiego.



