
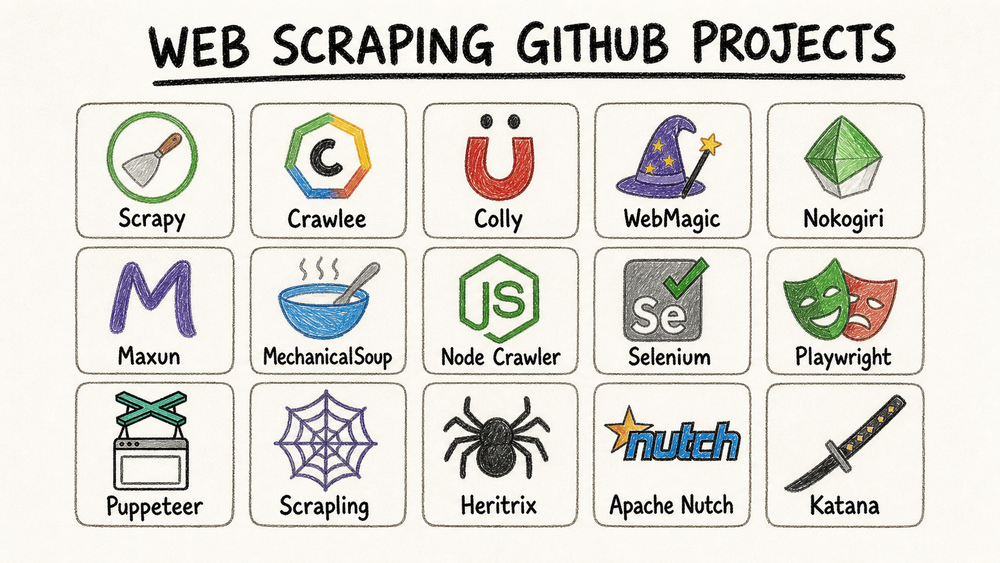
W 2026 roku sieć nadal jest pełna wartościowych danych, ale większość zespołów nie potrzebuje po prostu „jakiegoś scrapera”. Potrzebuje konkretnej odpowiedzi na jedno z trzech pytań: który projekt open source nadal warto rozwijać, jaki stos poradzi sobie z nowoczesnymi stronami mocno opartymi na JavaScript, oraz czy osoba nietechniczna powinna w ogóle pominąć GitHub i zamiast tego skorzystać z no-code workflow.
Ta aktualizacja została zbudowana właśnie wokół takiej ścieżki decyzyjnej. 6 sierpnia 2026 ponownie sprawdziłem publiczne strony repozytoriów GitHub, liczbę gwiazdek oraz aktywność w feedach commitów, a następnie porównałem poniższe projekty pod kątem złożoności wdrożenia, obsługi JavaScript, sygnałów utrzymania, wygody eksportu i dopasowania do użytkownika.
Szybka odpowiedź
- Wybierz Scrapy, jeśli chcesz najbardziej dojrzały framework Python do strukturalnego scrapingu na dużą skalę.
- Wybierz Crawlee, jeśli Twój zespół pracuje w JavaScript lub TypeScript i chce jednego stosu zarówno do scrapingu HTTP, jak i przeglądarkowego.
- Wybierz Playwright lub Puppeteer, jeśli strona jest mocno oparta na JavaScript i potrzebujesz przede wszystkim realnej automatyzacji przeglądarki.
- Wybierz Maxun, jeśli zamiast pisać scraper od zera chcesz open-source’ową, wizualną warstwę no-code z możliwością samodzielnego hostowania.
- Wybierz Heritrix, Apache Nutch lub Katana tylko wtedy, gdy masz bardzo wyspecjalizowane zadanie: archiwizację, rozproszony crawling albo rekonesans bezpieczeństwa.
- Wybierz Thunderbit, jeśli wcale nie chcesz budować rozwiązania na GitHubie i po prostu zależy Ci na szybkim dostarczeniu danych do Sheets, Airtable, Notion, CSV lub JSON.
Wypróbuj scraper no-code, zanim zdecydujesz się na stos kodu
Porównanie w skrócie
Gwiazdki GitHub i sygnały ostatnich commitów poniżej zostały sprawdzone na publicznych stronach repozytoriów oraz w feedach commitów 6 sierpnia 2026.
| Projekt | Język / Model | Złożoność wdrożenia | Obsługa JS | Najlepsze zastosowanie | Gwiazdek GitHub | Sygnał ostatniego commita |
|---|---|---|---|---|---|---|
| Scrapy | Framework Python | Średnia | Brak natywnej obsługi JS | Duże spider-y, e-commerce, newsy | 63,7 tys. | 6 sierpnia 2026 |
| Crawlee | Framework Node.js / TypeScript | Średnia | Tak | Jedno środowisko do scrapingu statycznego i dynamicznego | 25,2 tys. | 6 sierpnia 2026 |
| Maxun | Open-source’owa platforma no-code | Średnia przy wdrożeniu, łatwa dla użytkownika | Tak | Użytkownicy biznesowi, którzy nadal chcą kontroli open source | 17,1 tys. | 5 sierpnia 2026 |
| MechanicalSoup | Biblioteka Python | Łatwa | Nie | Formularze, sesje i proste strony statyczne | 4,9 tys. | 4 sierpnia 2026 |
| Node Crawler | Crawler Node.js | Średnia | Nie | Szybki crawling statyczny i agregacja feedów | 6,8 tys. | 18 czerwca 2026 |
| Heritrix | Archiwalny crawler Java | Zaawansowana | Nie | Archiwizacja stron i przechwytywanie na skalę domeny | 3,3 tys. | 5 sierpnia 2026 |
| Apache Nutch | Rozproszony crawler Java | Zaawansowana | Nie | Crawling w stylu wyszukiwarki i przetwarzanie big data | 3,3 tys. | 5 sierpnia 2026 |
| Selenium | Automatyzacja przeglądarki w wielu językach | Średnia | Tak | Procesy wymagające interakcji i wierne odwzorowanie przeglądarki | 34,3 tys. | 6 sierpnia 2026 |
| Playwright | Automatyzacja przeglądarki w wielu językach | Średnia | Tak | Nowoczesne dynamiczne strony i solidne skrypty | 94,1 tys. | 6 sierpnia 2026 |
| Puppeteer | Automatyzacja przeglądarki Node.js | Średnia | Tak | Automatyzacja i scraping w środowisku Chrome-first | 95,4 tys. | 6 sierpnia 2026 |
| Scrapling | Python stealth scraping toolkit | Średnia | Tak | Scraping przeglądarkowy w środowiskach z antybotem | 72,8 tys. | 30 lipca 2026 |
| Katana | Crawler / CLI w Go | Średnia | Opcjonalnie headless | Security crawling i odkrywanie URL-i | 17,3 tys. | 5 sierpnia 2026 |
| Colly | Framework Go | Średnia | Nie | Wysokowydajny scraping statyczny | 25,4 tys. | 18 czerwca 2026 |
| WebMagic | Framework Java | Średnia | Brak natywnej obsługi JS | Ogólne pipeline’y scrapingu w Javie | 11,7 tys. | 20 grudnia 2025 |
| Nokogiri | Parser Ruby | Łatwa | Nie | Aplikacje Ruby i niestandardowe workflow parsowania | 6,3 tys. | 3 sierpnia 2026 |
| Thunderbit | AI no-code rozszerzenie do Chrome | Gotowe do użycia | Tak | Zespoły nietechniczne, które chcą szybko uzyskać użyteczne dane | Brak danych | Produkt zarządzany, stale aktualizowany |
Zanim wybierzesz projekt GitHub, zastanów się, czy w ogóle chcesz workflow oparty na kodzie
Thunderbit nie jest projektem GitHub — i właśnie dlatego zasługuje na miejsce w tym przewodniku decyzyjnym. Duża część osób szukających „najlepszych projektów GitHub do web scrapingu” tak naprawdę nie chce utrzymywać własnego stosu crawlerów. Chcą po prostu dziś wyciągnąć uporządkowane dane z działającej strony.
Thunderbit to najprostsza droga od badań nad scrapingiem opartym na kodzie do wykonania gotowego do biznesu:
- Najlepszy dla: prospectingu sprzedażowego, monitoringu e-commerce, pozyskiwania danych o nieruchomościach, researchu rekrutacyjnym i pracy operacyjnej w przeglądarce.
- Dlaczego się wyróżnia: sugestie pól AI, wzbogacanie podstron, obsługa stron dynamicznych oraz eksport do Sheets, Airtable, Notion, CSV i JSON bez pisania logiki scrapingu.
- Na co uważać: jeśli budujesz długowieczną wewnętrzną platformę crawlującą z własną infrastrukturą, framework open source nadal da Ci większą kontrolę.
Jeśli chcesz najpierw zobaczyć ścieżkę no-code, zanim zdecydujesz, czy w ogóle chcesz działać w GitHubie, ten aktualny walkthrough Thunderbit to najszybszy test rzeczywistości:
Wypróbuj Thunderbit AI Web Scraper za darmo
Jak oceniłem te projekty GitHub do scrapingu
Nie wszystkie projekty GitHub do scrapingu są porównywalne. Niektóre to pełne frameworki. Inne to biblioteki do automatyzacji przeglądarki. Jeszcze inne to parsery albo niszowe crawlery stworzone dla archiwów lub zespołów bezpieczeństwa.
Żeby lista była naprawdę użyteczna, wybrałem projekty, które nadal spełniają cztery praktyczne kryteria:
- Nadal mają realne znaczenie rynkowe.
Same wysokie gwiazdki nie wystarczą, ale niska adopcja i przestarzałe utrzymanie zwykle są złym znakiem. - Widać, że projekt nadal żyje.
W tej aktualizacji ponownie sprawdziłem publiczną aktywność commitów 6 sierpnia 2026 zamiast ufać starym rankingom. - Rozwiązują prawdziwe zadanie scrapingu.
Pominąłem schludne, ale niszowe repozytoria, które słabo przekładają się na realne workflow biznesowe albo badawcze. - Są na tyle różne, by dało się je sensownie shortlistować.
Celem nie jest wrzucenie 50 repozytoriów. Chodzi o pomoc w wyborze między frameworkami, stosami przeglądarkowymi, open-source’owymi narzędziami no-code i specjalistycznymi crawlerami.
Wymiary porównania są dokładnie tymi, które w praktyce najczęściej decydują o sukcesie lub porażce:
- Złożoność wdrożenia: jak szybko nowy użytkownik może dojść do działającego scrapingu.
- Obsługa JavaScript: czy projekt poradzi sobie z nowoczesnymi stronami renderowanymi po stronie klienta.
- Stan projektu: czy repo wygląda na wystarczająco aktywne, by mu zaufać.
- Obsługa danych: czy projekt tworzy uporządkowane wyniki, czy zostawia większość pracy Tobie.
- Dopasowanie do użytkownika: czy projekt jest faktycznie dla początkujących, data engineerów, zespołów bezpieczeństwa czy osób nietechnicznych.
Złożoność wdrożenia: jak szybko możesz zacząć?
Ta taksonomia nadal się sprawdza, ale w 2026 wygodniej patrzeć na nią prościej:
- Gotowe do użycia: Thunderbit dla użytkowników biznesowych; MechanicalSoup lub Nokogiri dla lekkich skryptów tworzonych od razu w kodzie.
- Średnie: Scrapy, Crawlee, Maxun, Selenium, Playwright, Puppeteer, Colly, Katana, Scrapling, WebMagic i Node Crawler wymagają już trochę kodowania, pracy w CLI albo wdrożenia.
- Zaawansowane: Heritrix i Apache Nutch mają sens tylko wtedy, gdy naprawdę potrzebujesz archiwizacji albo rozproszonego crawlningu w Javie.
Maxun zasługuje tu na osobną wzmiankę, bo łączy dwa światy. Sama platforma wymaga wdrożenia, ale codzienny workflow użytkownika jest dużo lżejszy niż bezpośrednia praca z Scrapy albo Playwright.
Obsługa treści dynamicznych: które projekty radzą sobie z nowoczesną siecią?
Nowoczesne strony pełne są Reacta, Vue, nieskończonego scrollowania, wywołań API w tle i flow z logowaniem. To właśnie ta granica oddziela „mam HTML” od „mam dane, których naprawdę potrzebowałem”.
Projekty z tej listy można podzielić na trzy grupy:
- Pełna automatyzacja przeglądarki: Selenium, Playwright i Puppeteer wykonują JavaScript w pełni i nadal są najbardziej niezawodnym wyborem dla stron wymagających interakcji.
- Rozwiązania hybrydowe lub wrappery: Crawlee może przełączać się między lekkim crawlingiem HTTP a scrapingiem opartym na przeglądarce. Scrapling dokłada narzędzia stealth do trudniejszych celów. Maxun korzysta z podejścia przeglądarkowego ukrytego za interfejsem wizualnym.
- Domyślnie tylko statyczny HTML: Scrapy, MechanicalSoup, Node Crawler, Colly, WebMagic, Nokogiri, Heritrix i Apache Nutch same z siebie nie rozwiązują natywnie problemów nowoczesnego renderowania.
Jeśli Twoje największe pytanie brzmi: „czy ten stos poradzi sobie ze stronami mocno opartymi na JavaScript bez ręcznego odtwarzania każdego kroku w przeglądarce?”, ten aktualny tutorial Playwright do scrapingu jest najlepszym sprawdzianem pośrodku całego artykułu:
Stan projektu: które repozytoria w 2026 roku nadal wyglądają na godne zaufania?
Wersja z 2025 roku opierała się na liczbie gwiazdek i kilku przestarzałych notkach o aktualizacjach. To już za mało. Sprawdziłem zarówno bieżącą liczbę gwiazdek, jak i świeże sygnały commitów 6 sierpnia 2026.
Zdrowy podział wygląda tak:
- Wyraźnie aktywne teraz: Scrapy, Crawlee, Maxun, MechanicalSoup, Heritrix, Apache Nutch, Selenium, Playwright, Puppeteer, Scrapling, Katana i Nokogiri wypchnęły publiczne commity w ciągu dwóch tygodni przed tym sprawdzeniem.
- Żywe, ale rozwijane wolniej: Colly i Node Crawler miały ostatni commit 18 czerwca 2026. Nadal wyglądają na użyteczne, ale aktualizacje pojawiają się tam raczej skokowo niż w tygodniowym rytmie Playwright czy Crawlee.
- Wymagają większej ostrożności: WebMagic to jedyna naprawdę wyraźna luka na tej liście. Najnowszy publiczny sygnał commita, jaki znalazłem, pochodził z 20 grudnia 2025, więc traktowałbym ten projekt jako stabilny, a nie aktywnie rozwijany.
To ważne, bo styl utrzymania powinien wpływać na shortlistę:
- Jeśli chcesz bezpieczny domyślny wybór do nowego builda inżynieryjnego, stawiaj na bardziej aktywne repozytoria.
- Jeśli narzędzie jest proste, a zakres zastosowania wąski, wolniejsze tempo rozwoju jest akceptowalne.
- Jeśli projekt jest specjalistyczny, najpierw oceń dopasowanie, a nie to, czy wypuszcza nowe wersje co tydzień.
15 najlepszych projektów GitHub do web scrapingu w 2026 roku
Frameworki do scrapingu ogólnego przeznaczenia i na dużą skalę
1. Scrapy
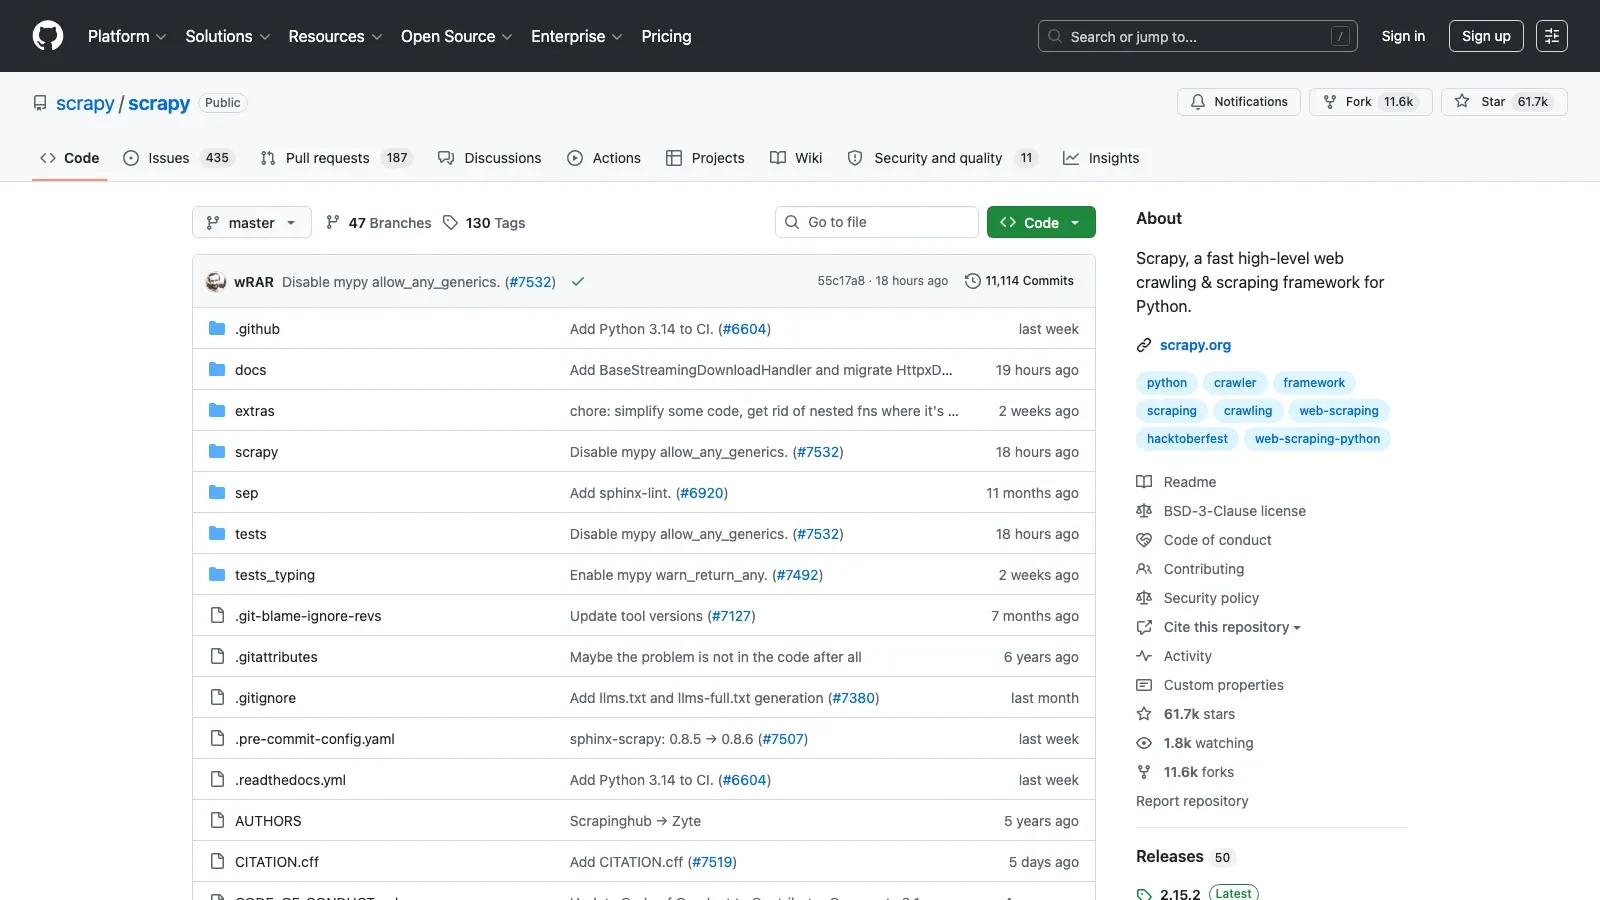
Scrapy nadal jest domyślną odpowiedzią w Pythonie, gdy zadanie jest większe niż krótki skrypt. Jeśli potrzebujesz spiderów, pipeline’ów, middleware, throttlingu, retry i dojrzałego ekosystemu, to wciąż najbezpieczniejszy open-source’owy wybór z tej listy.
- Złożoność wdrożenia: Średnia
- Najlepsze zastosowanie: katalogi e-commerce, scraping katalogów, crawling newsów i długowieczne wewnętrzne systemy scrapingu
- Obsługa JS: Brak natywnego renderowania; w razie potrzeby połącz z Playwrightem lub Selenium
- Dlaczego warto: dojrzała architektura, mocna dokumentacja i jeden z najlepszych stosunków możliwości do społeczności w open-source’owym scrapingu
- Na co uważać: próg wejścia jest realny, jeśli nigdy wcześniej nie pracowałeś w frameworku crawlerowym
Jeśli chcesz ocenić, czy ścieżka Scrapy jest dla Ciebie odpowiednia, zanim się na nią zdecydujesz, ten aktualny poradnik dla początkujących nadal będzie pomocny:
2. Crawlee
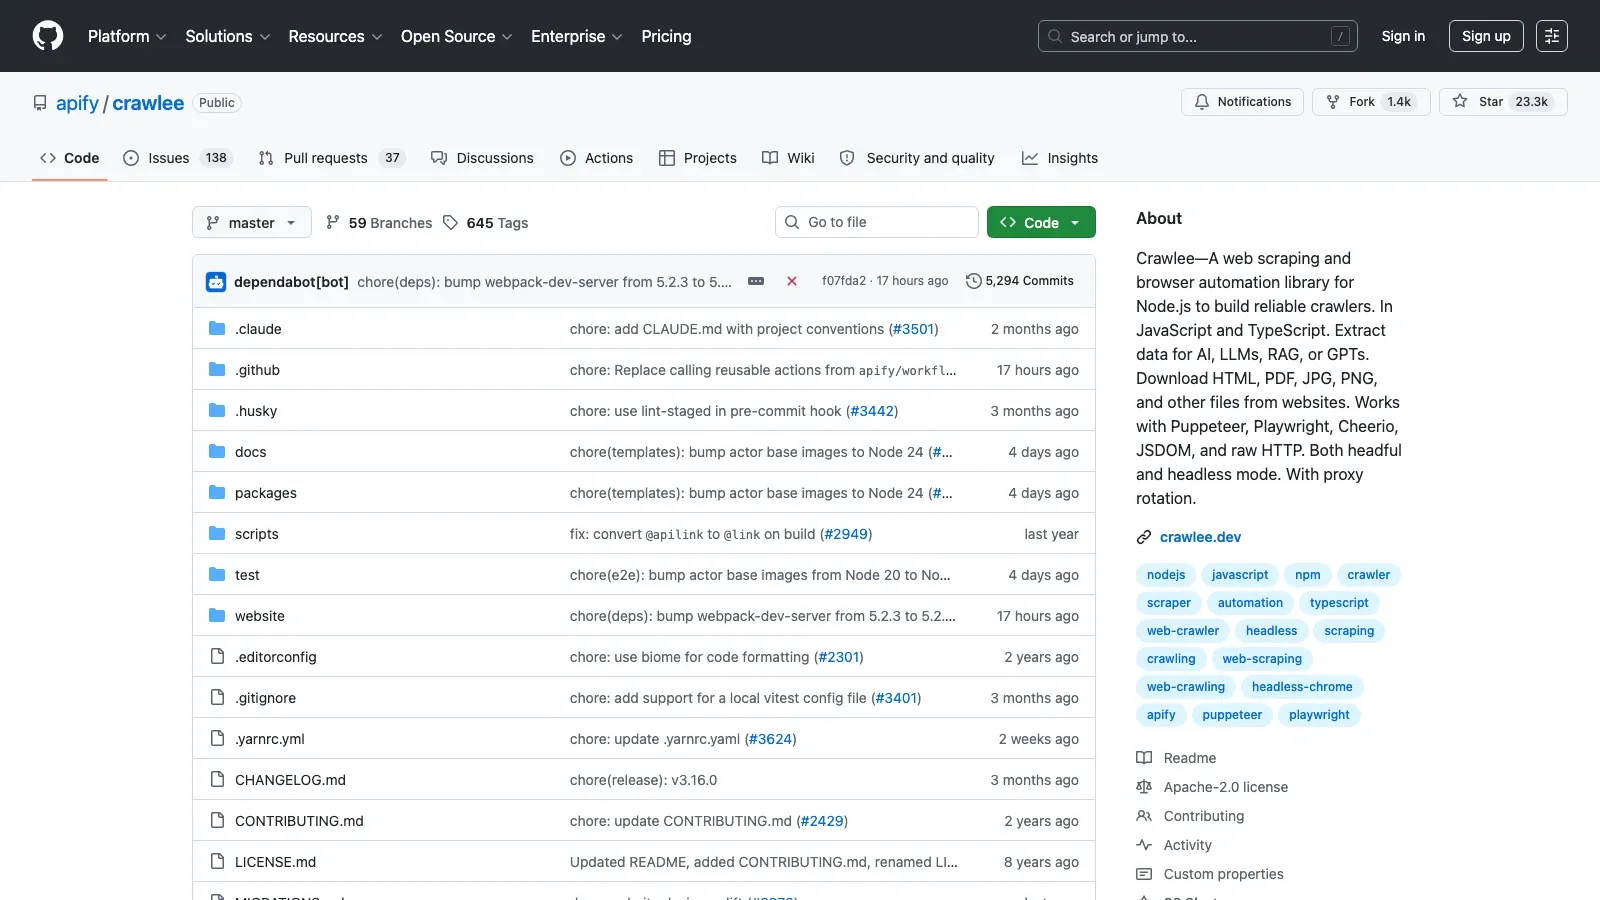
Crawlee stał się najciekawszym wyborem frameworka dla JavaScript lub TypeScript, gdy chcesz jeden projekt obejmujący zarówno lekkie crawling, jak i scraping wspierany przez przeglądarkę. Prawdziwą zaletą jest możliwość przełączania się między workflow HTTP-first a tymi opartymi na Playwright lub Puppeteer.
- Złożoność wdrożenia: Średnia
- Najlepsze zastosowanie: zespoły JS i TS, hybrydowe cele statyczne i dynamiczne oraz wewnętrzne narzędzia z dużą liczbą automatyzacji
- Obsługa JS: Tak
- Dlaczego warto: elastyczny model działania, pomoc w obchodzeniu blokad i lepsza ergonomia pracy z przeglądarką niż w starszych stosach tylko-crawlerowych
- Na co uważać: ma największy sens wtedy, gdy Twój zespół swobodnie porusza się w Node.js
3. Colly
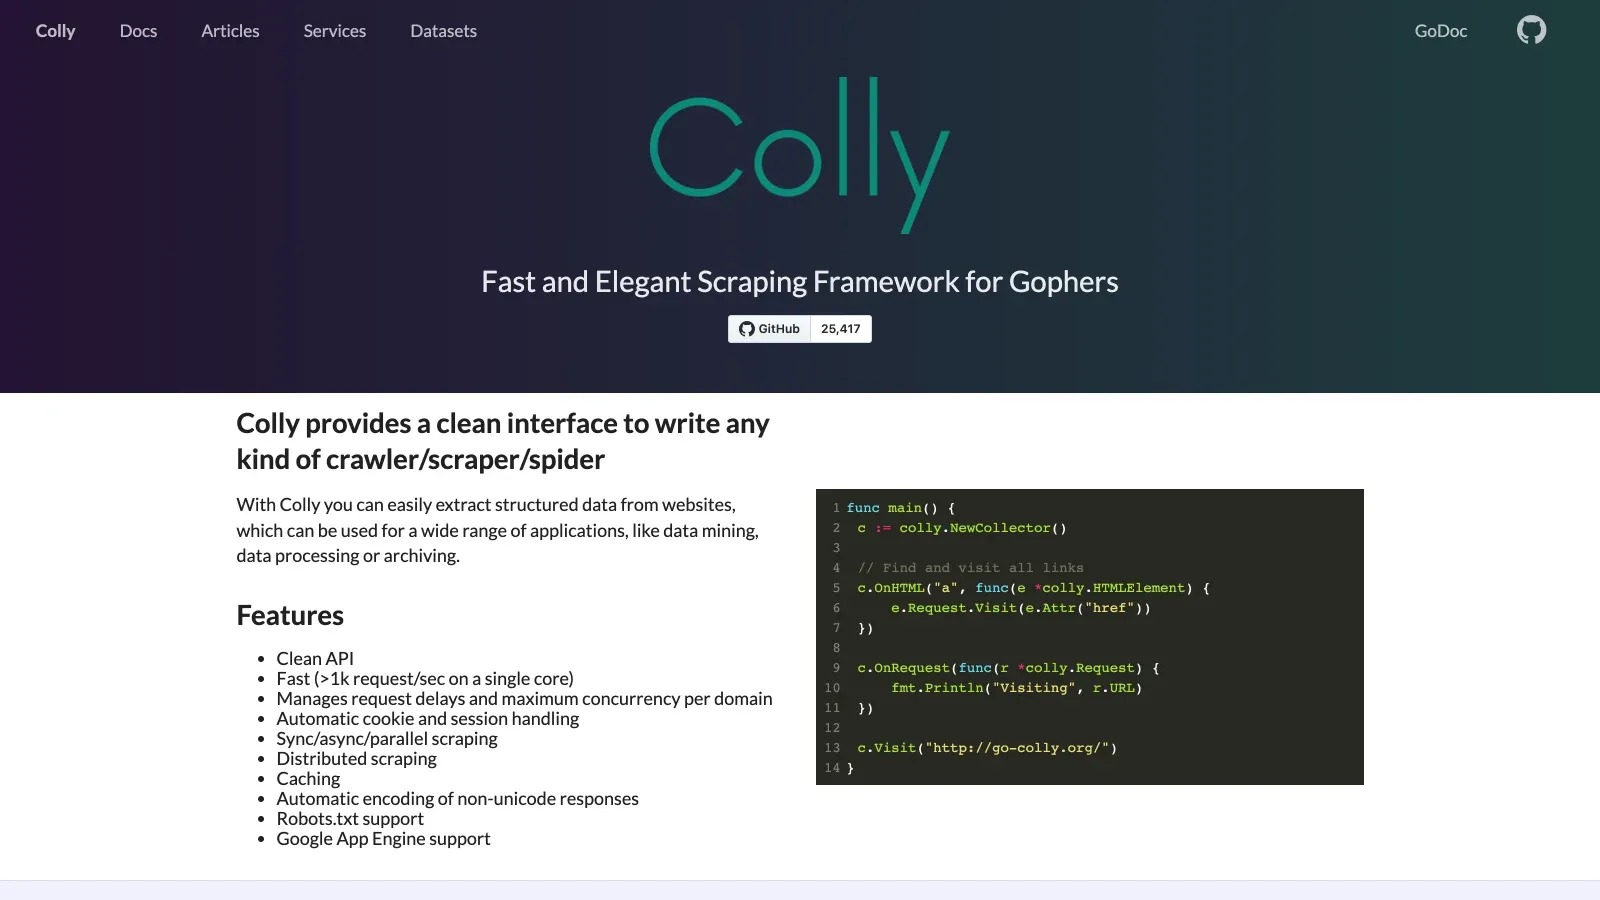
Colly wciąż jest jednym z najczystszych i najbardziej wydajnych wyborów dla zespołów Go, które nie potrzebują domyślnie renderowania przeglądarkowego. Jest szybki, elegancki i praktyczny tam, gdzie wąskim gardłem jest wolumen, a nie złożoność interfejsu.
- Złożoność wdrożenia: Średnia
- Najlepsze zastosowanie: deweloperzy Go budujący szybkie crawlery statyczne
- Obsługa JS: Brak natywnego renderowania
- Dlaczego warto: współbieżność, rate limiting i przyjemne API do zadań o dużym throughputcie
- Na co uważać: nie jest to właściwy wybór, gdy prawdziwym wymaganiem jest automatyzacja przeglądarki
4. WebMagic
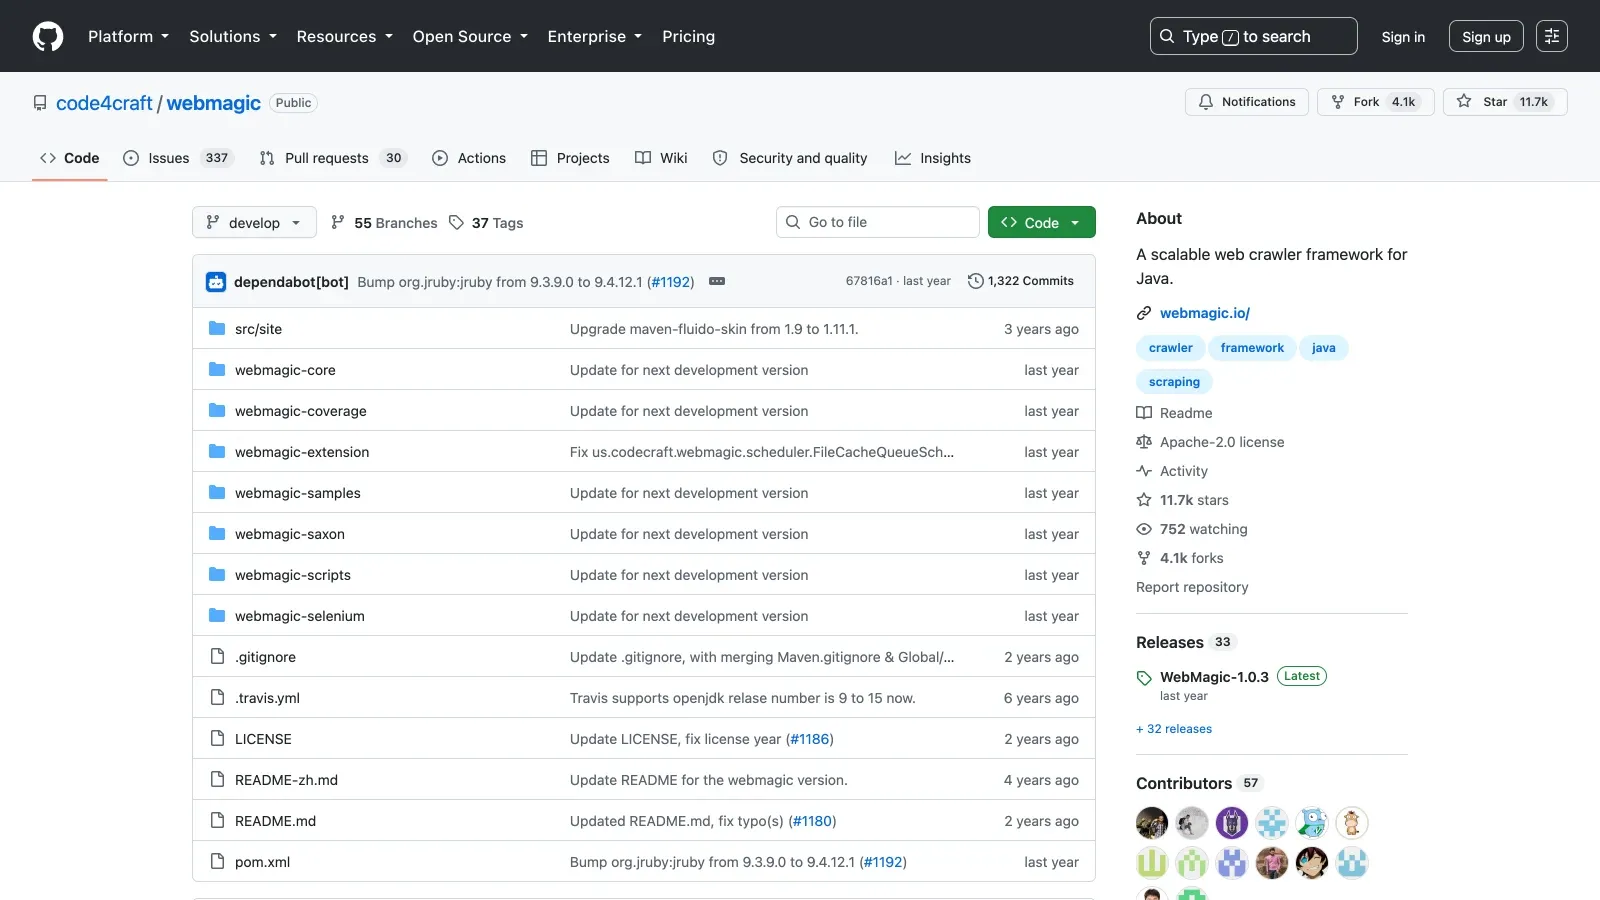
WebMagic pozostaje Java’owym odpowiednikiem dla zespołów, które lubią model Scrapy, ale chcą pozostać w ekosystemie JVM. Nadal ma sens w środowiskach Java, nawet jeśli wokół niego jest mniej szumu niż wokół opcji opartych na Pythonie czy Node.
- Złożoność wdrożenia: Średnia
- Najlepsze zastosowanie: pipeline’y scrapingu w Javie
- Obsługa JS: Brak natywnego renderowania
- Dlaczego warto: schedulery, pipeline’y i prosta struktura frameworka
- Na co uważać: ekosystem jest spokojniejszy niż w większych opcjach Python i Node, a najnowszy publiczny sygnał commita, jaki znalazłem, pochodził z 20 grudnia 2025, więc traktuj go jako stabilny, a nie intensywnie rozwijany
5. Nokogiri
Nokogiri nie jest frameworkiem crawlerowym. To parser, po który deweloperzy Ruby nadal sięgają, gdy chcą czystej obsługi HTML lub XML w ramach własnego skryptu albo przepływu aplikacji.
- Złożoność wdrożenia: Łatwa
- Najlepsze zastosowanie: aplikacje Ruby i Rails, które potrzebują parsowania, a nie pełnego frameworka crawlerowego
- Obsługa JS: Nie
- Dlaczego warto: szybkie, stabilne i bezpieczne domyślnie parsowanie
- Na co uważać: nadal trzeba samodzielnie dodać warstwę HTTP, sesji lub przeglądarki
Lekkie projekty statyczne i przyjazne dla początkujących
6. Maxun
Maxun to open-source’owa odpowiedź dla osób, którym podoba się idea scrapingu no-code, ale nadal chcą samodzielnego hostowania i kontroli na poziomie GitHuba. Jest dużo bardziej przystępny dla osób nietechnicznych niż czysty framework, ale nadal jest realnym projektem open source, a nie zamkniętym SaaS-em.
- Złożoność wdrożenia: Średnia przy wdrożeniu, później łatwiejsza dla użytkowników końcowych
- Najlepsze zastosowanie: zespoły, które chcą wizualnego UI z kontrolą open source
- Obsługa JS: Tak
- Dlaczego warto: ekstrakcja point-and-click, wieloetapowe flow i większa dostępność niż pisanie kodu od zera
- Na co uważać: krok wdrożeniowy jest nadal cięższy niż w pełni zarządzane rozszerzenie do przeglądarki
7. MechanicalSoup
MechanicalSoup nadal zasługuje na miejsce w zestawieniu, bo nie każdy scraping wymaga headless browsera. Jeśli prawdziwy problem to obsługa sesji, wysyłanie formularzy albo przechodzenie przez statyczny flow za logowaniem, to pozostaje zaskakująco mały i zrozumiały.
- Złożoność wdrożenia: Łatwa
- Najlepsze zastosowanie: proste formularze, statyczne strony chronione logowaniem i szybkie skrypty automatyzujące w Pythonie
- Obsługa JS: Nie
- Dlaczego warto: niski próg tarcia, czytelny kod i łagodne wejście dla użytkowników Pythona
- Na co uważać: na stronach mocno opartych na JS szybko przestaje być wystarczający
8. Node Crawler
Node Crawler nadal ma sens, jeśli cel opiera się na statycznym HTML, a najważniejsze są współbieżność, kolejki i parsowanie w stylu Cheerio. Nie wybrałbym go do nowego projektu z dużą ilością pracy w przeglądarce, ale nadal może być dobrym wyborem do kolekcji feedów i statycznych stron.
- Złożoność wdrożenia: Średnia
- Najlepsze zastosowanie: szybki crawling statyczny i agregacja
- Obsługa JS: Nie
- Dlaczego warto: kontrola współbieżności i znajomy workflow parsowania podobny do jQuery
- Na co uważać: najnowszy publiczny sygnał commita, jaki znalazłem, pochodził z 18 czerwca 2026, a przerwy między aktualizacjami są długie, więc nie zaczynałbym od tego przy nowym, długowiecznym stosie dla dynamicznych stron
Projekty do stron dynamicznych i automatyzacji przeglądarki
9. Selenium
Selenium jest starszy niż Playwright, ale wciąż ma znaczenie tam, gdzie dokładne zachowanie przeglądarki i wierność interakcji są ważniejsze niż elegancja. Nadal jest szczególnie istotny w miejscach, gdzie scraping przecina się z QA, automatyzacją regresji albo stronami wymagającymi bardzo dosłownego zachowania przeglądarki.
- Złożoność wdrożenia: Średnia
- Najlepsze zastosowanie: flow z dużą ilością interakcji, starsza automatyzacja przeglądarki i zespoły, które już używają Selenium do testów
- Obsługa JS: Tak
- Dlaczego warto: szerokie pokrycie przeglądarek, ogromny ekosystem i wieloletnia dojrzałość
- Na co uważać: nowsze stosy automatyzacji często wydają się czystsze i szybsze w nowych projektach scrapingu
10. Playwright
Playwright to mój domyślny nowoczesny wybór dla zespołów deweloperskich potrzebujących scrapingu dynamicznych stron. Połączenie obsługi wielu przeglądarek, solidnego oczekiwania na elementy i czystego API sprawia, że to najłatwiejszy projekt do polecenia szerokiej grupie użytkowników.
- Złożoność wdrożenia: Średnia
- Najlepsze zastosowanie: nowoczesne aplikacje webowe, flow z logowaniem i cele mocno oparte na JavaScript
- Obsługa JS: Tak
- Dlaczego warto: kontrola między przeglądarkami, solidne prymitywy automatyzacji i aktywne utrzymanie
- Na co uważać: nadal musisz sam zadbać o selektory, infrastrukturę przeglądarki, retry i jakość wyjściowych danych
11. Puppeteer
Puppeteer nadal jest klasykiem w podejściu Chrome-first. Jeśli Twój zespół już działa w Node.js i głównie celuje w workflow zgodne z Chromium, pozostaje praktycznym i dobrze znanym wyborem.
- Złożoność wdrożenia: Średnia
- Najlepsze zastosowanie: automatyzacja skoncentrowana na Chrome, zrzuty ekranu, PDF-y i ekstrakcja treści dynamicznych
- Obsługa JS: Tak
- Dlaczego warto: bogata kontrola przeglądarki i ogromna liczba przykładów w społeczności
- Na co uważać: Playwright stał się silniejszym domyślnym wyborem, jeśli potrzebujesz szerszej obsługi przeglądarek albo bardziej nowoczesnego podejścia cross-browser
12. Scrapling
Scrapling to najbardziej wyspecjalizowany nowy gracz w tej grupie. Jest dla osób, które już wiedzą, że renderowanie przeglądarkowe nie jest jedynym problemem. Potrzebują też stealth, świadomości proxy i mocniejszej odporności na antybota.
- Złożoność wdrożenia: Średnia
- Najlepsze zastosowanie: stealth scraping, cele wrażliwe na antybota i dynamiczne strony w podejściu Python-first
- Obsługa JS: Tak
- Dlaczego warto: aktywny rozwój i wyraźniejsze skupienie na problemach scrapingu, które prostsze frameworki ignorują
- Na co uważać: to przesada przy zwykłych stronach statycznych i mniej przyjazne dla początkujących niż MechanicalSoup czy Scrapy
Specjalistyczne crawlery do zadań badawczych, bezpieczeństwa i infrastruktury
13. Heritrix
Heritrix nie jest scraperem do porównywania produktów. To archiwalny crawler stworzony dla instytucji, którym zależy na pełnym zachowaniu stron i zgodnym ze standardami przechwytywaniu treści.
- Złożoność wdrożenia: Zaawansowana
- Najlepsze zastosowanie: archiwa, biblioteki i workflowy zachowywania dużych zbiorów stron
- Obsługa JS: Nie
- Dlaczego warto: rodowód Internet Archive i archiwalne workflowy oparte na WARC
- Na co uważać: zły wybór do ukierunkowanego scrapingu list lub cen
14. Apache Nutch
Apache Nutch nadal ma sens dla zespołów myślących o rozproszonym crawlowaniu, indeksowaniu lub zbieraniu danych w stylu wyszukiwarki, a nie jednorazowym scrapi ngu biznesowym.
- Złożoność wdrożenia: Zaawansowana
- Najlepsze zastosowanie: rozproszony crawling, zbiory badawcze i kolekcja danych w stylu wyszukiwarki
- Obsługa JS: Nie
- Dlaczego warto: model pluginów i enterprise’owa znajomość stylu Apache
- Na co uważać: zdecydowanie zbyt ciężki do większości zadań „najpierw spreadsheet” albo „najpierw przeglądarka”
15. Katana
Katana należy do tego zestawienia, bo crawling bezpieczeństwa to osobny przypadek użycia. Jeśli zadanie polega na rekonesansie, odkrywaniu endpointów albo szybkim mapowaniu struktury celu, Katana pasuje dużo lepiej niż uniwersalny framework do scrapingu.
- Złożoność wdrożenia: Średnia
- Najlepsze zastosowanie: rekonesans bezpieczeństwa, wykrywanie linków i budowanie inwentarza URL-i
- Obsługa JS: Opcjonalny tryb headless
- Dlaczego warto: szybkość, współbieżność i model crawlowania nastawiony na bezpieczeństwo
- Na co uważać: nie jest projektowany jako dopracowany stos do ekstrakcji danych biznesowych
Moja shortlista według typu zespołu
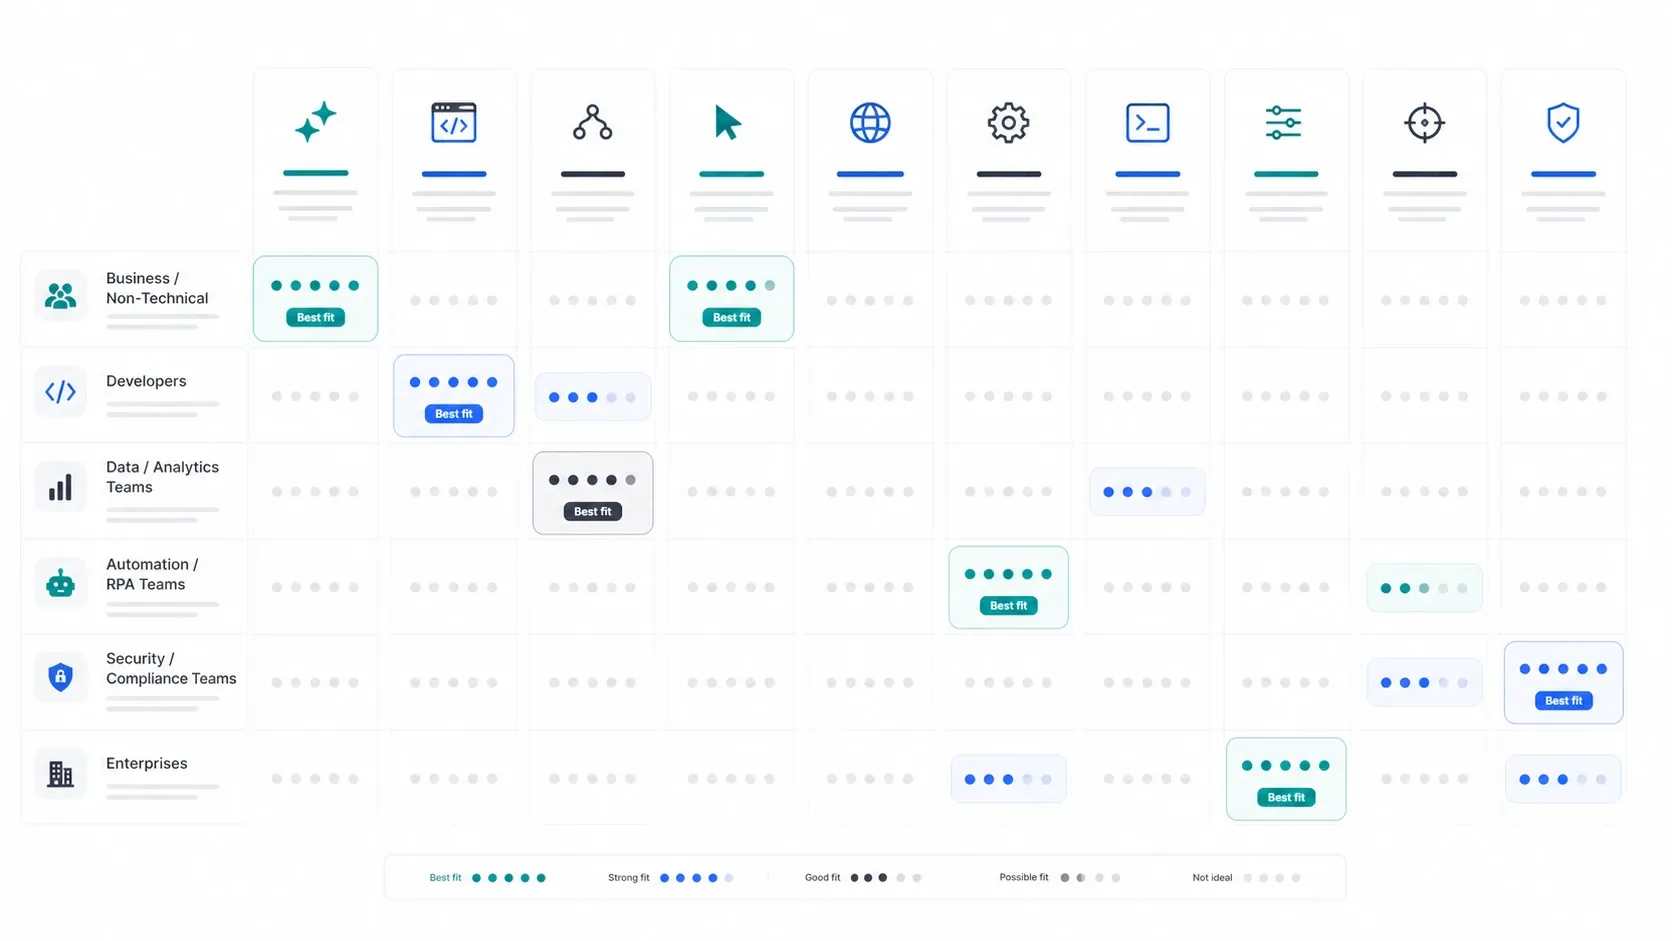
- Programiści Python: zacznij od Scrapy jako frameworka, MechanicalSoup do mniejszych statycznych flow i Scrapling, jeśli stealth albo walka z antybotem już są częścią problemu.
- Zespoły JavaScript lub TypeScript: zacznij od Crawlee jako frameworka, Playwright do automatyzacji przeglądarki i Puppeteer, jeśli wystarczą Ci workflowy skupione na Chrome.
- Zespoły Go: Colly do scrapingu, Katana do security crawlingu opartego na odkrywaniu.
- Zespoły Java: WebMagic do ogólnego crawlningu, Heritrix do archiwizacji, Apache Nutch do rozproszonego crawlningu w stylu wyszukiwarki.
- Operatorzy nietechniczni: Maxun, jeśli chcesz open-source z samodzielnym hostowaniem, albo Thunderbit, jeśli chcesz zarządzany workflow no-code, który szybciej daje użyteczny wynik.
Od czego większość osób powinna faktycznie zacząć?
Oto pragmatyczna odpowiedź:
- Jeśli chcesz zbudować i posiadać własny scraper, zacznij od Scrapy albo Crawlee.
- Jeśli musisz kontrolować prawdziwą przeglądarkę, zacznij od Playwright.
- Jeśli potrzebujesz wizualnej warstwy open source, zacznij od Maxun.
- Jeśli potrzebujesz specjalistycznej archiwizacji albo crawlningu bezpieczeństwa, wybierz Heritrix, Nutch lub Katana tylko wtedy, gdy Twój przypadek użycia wyraźnie tego wymaga.
- Jeśli chcesz pominąć kod i od razu dostać dane, nie zmuszaj się najpierw do GitHuba. Użyj Thunderbit.
Ostateczny wniosek
Najlepszy projekt GitHub do web scrapingu w 2026 roku zależy mniej od samej liczby gwiazdek, a bardziej od tego, jaki ciężar chcesz wziąć na siebie. Scrapy nadal jest najbezpieczniejszym domyślnym frameworkiem Python. Crawlee to najlepszy nowoczesny wybór dla JavaScript. Playwright to najmocniejszy domyślny wybór do automatyzacji przeglądarki. Maxun to najciekawsza open-source’owa ścieżka no-code. Heritrix, Apache Nutch i Katana to narzędzia specjalistyczne, które świetnie sprawdzają się tylko wtedy, gdy zadanie jest naprawdę wyspecjalizowane.
Najważniejsze jest to, by nie mylić „najmocniejszego” z „najlepiej dopasowanym”. Jeśli Twój zespół potrzebuje tylko czystych danych w arkuszu, GitHub wcale nie musi być najlepszym miejscem na start.
Omiń koszty utrzymania i zacznij scrapować szybciej Get Started Free



