
Twój CRM jest tak dobry, jak dane, które do niego trafiają. A najlepsze dane znajdziesz w publicznie dostępnych witrynach — nie w drogich bazach firm trzecich.
Narzędzia do wyciągania danych z sieci zamieniają ten chaotyczny webowy bałagan w czyste arkusze kalkulacyjne. Dobre rozwiązania robią to w kilka minut, bez pisania kodu.
Korzystałem z tych narzędzi w prawdziwych projektach — od budowania list leadów, przez monitorowanie cen konkurencji, po zgrywanie katalogów produktów. Oto 12 rozwiązań, które zdały egzamin, uporządkowane według tego, jak dobrze sprawdzały się w faktycznych zadaniach biznesowych.
Dlaczego narzędzia do wyciągania danych z sieci są dziś biznesową koniecznością
Bądźmy szczerzy: sieć to największa i najbardziej chaotyczna baza danych na świecie. A w 2026 roku firmy, które potrafią zamienić ten chaos w konkretne wnioski, wyraźnie wychodzą na prowadzenie. Organizacje oparte na danych konsekwentnie osiągają lepsze wyniki niż konkurencja zarówno pod względem produktywności, jak i rentowności. Ta przewaga jest realna — o ile naprawdę potrafisz zdobyć dane.
Narzędzia do wyciągania danych z sieci (czasem nazywane web page extractorami lub rozwiązaniami do web extracting) są tu kluczowe. Umożliwiają zespołom sprzedaży zbieranie publicznych katalogów, mediów społecznościowych i stron firmowych w celu budowania precyzyjnych list potencjalnych klientów — bez kupowania przestarzałych arkuszy leadów i bez liczenia na to, że stażysta nie zniknie w połowie kopiowania i wklejania (Thunderbit Blog). Zespoły marketingowe i e-commerce używają takich narzędzi do śledzenia cen konkurencji, monitorowania stanów magazynowych i porównywania produktów w czasie rzeczywistym — przykładowo John Lewis przypisuje 4% wzrost sprzedaży właśnie mądrzejszemu pricingowi wspieranemu web scrapingiem (Thunderbit Blog).
Ale nie chodzi tylko o liczby. Takie narzędzia oszczędzają ogrom czasu (jeden z użytkowników mówił o „setkach godzin” zaoszczędzonych dzięki automatyzacji zbierania danych) i eliminują błędy ludzkie (Thunderbit Blog). Zespoły operacyjne ustawiają dziś scrapery tak, by stale gromadziły dane, których ręczne zbieranie zajęłoby praktykantom tygodnie — uwalniając godziny wcześniej tracone na żmudne kopiowanie i wklejanie (Thunderbit Blog). A dzięki ekstraktorom opartym na AI nawet osoby nietechniczne mogą przekształcać strony internetowe w uporządkowane dane gotowe do analizy (Box Piper).
Wniosek? Jeśli w 2026 roku nie korzystasz z web extractora, prawdopodobnie zostawiasz w tyle zarówno wnioski, jak i pieniądze.
Jak wybraliśmy 12 najlepszych narzędzi do wyciągania danych z sieci
Przy takiej liczbie narzędzi do web extracting, jak wybrać właściwe? Przejrzałem dziesiątki opcji, ale tylko 12 trafiło na tę listę. Oto na czym się skupiłem:
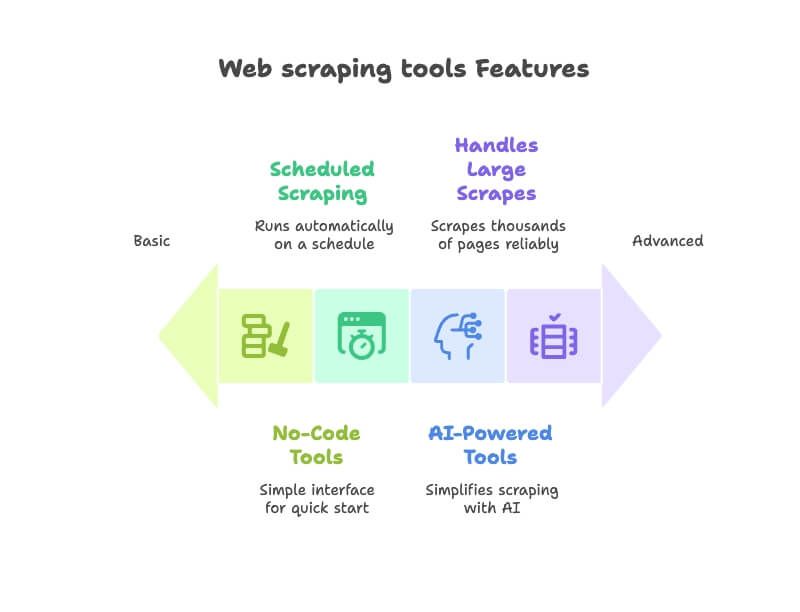
- Łatwość obsługi: Czy osoba nietechniczna może zacząć szybko, bez pisania kodu? Priorytetem były narzędzia no-code lub low-code z intuicyjnym interfejsem (Thunderbit Blog).
- Możliwości AI: Narzędzia nowej generacji, które wykorzystują AI do uproszczenia scrapowania — na przykład automatyczne wykrywanie pól danych, obsługę nawigacji po stronie czy opisywanie potrzeb prostym językiem (Thunderbit Blog).
- Automatyzacja i harmonogramy: Najlepsze web extractory działają praktycznie na autopilocie. Wybrałem narzędzia, które obsługują cykliczne pobieranie danych lub monitorowanie stron (Thunderbit Blog).
- Eksport danych i integracje: Czy łatwo wyeksportujesz dane do Excela, Google Sheets, Airtable lub Notion? Dodatkowe punkty przyznawałem za integracje z procesami pracy (Thunderbit Blog).
- Skalowalność i niezawodność: Niezależnie od tego, czy scrapujesz jedną stronę, czy tysiące, te narzędzia muszą dawać radę. Brałem też pod uwagę opinie użytkowników dotyczące stabilności.
- Praktyczne zastosowania biznesowe: Najbardziej liczyły się narzędzia popularne wśród zespołów sprzedaży, marketingu, e-commerce i operacji — nie tylko wśród programistów.
Część z tych rozwiązań to nowe narzędzia napędzane AI, inne to sprawdzone klasyki branżowe. Wszystkie mają jeden cel: pomóc Ci zamienić web w Twoją własną bazę danych biznesowych — bez bólu głowy.
Szybkie porównanie: narzędzia do wyciągania danych z sieci w skrócie
Oto zestawienie 12 omawianych narzędzi, żeby łatwiej było ocenić ich możliwości:
| Narzędzie | Automatyzacja AI | Łatwość użycia | Najlepszy scenariusz użycia |
|---|---|---|---|
| Thunderbit | Tak – AI sugeruje pola i automatycznie obsługuje strony | Bardzo łatwe (rozszerzenie Chrome, bez kodu) | Szybkie zbieranie leadów, cen itd. przez osoby nietechniczne, które chcą efektów w kilka minut. |
| Octoparse | Ograniczona (szablony, bez AI) | Łatwe dla większości (wizualny interfejs drag-and-drop) | Niestandardowe workflow scrapowania (z logowaniem, paginacją) dla analityków, którzy chcą kontroli bez kodowania. |
| Browse AI | Częściowo – roboty typu point-and-click | Łatwe (no-code, chmura) | Automatyczne monitorowanie danych (cen, ofert itp.) według harmonogramu, z alertami i integracjami. |
| WebScraper.io | Nie (ręczna konfiguracja) | Średnie (rozszerzenie przeglądarki z ustawianiem sitemap) | Wizualne scrapowanie wielopoziomowych stron dla osób gotowych skonfigurować kroki ręcznie. |
| ScraperAPI | N/D (usługa API, obsługa proxy przez API) | Wymaga kodowania (integracja z API) | Ekstrakcja danych web na dużą skalę dla zespołów technicznych — proxy i CAPTCHA obsługiwane przy dużych pobraniach. |
| Data Miner | Nie | Bardzo łatwe (rozszerzenie przeglądarki z szablonami jednym kliknięciem) | Szybkie jednorazowe wyciąganie danych ze stron (zwłaszcza tabel lub list) prosto do CSV/Excela. |
| Simplescraper | Nie (część funkcji wspieranych przez AI) | Łatwe (kreator receptur point-and-click) | No-code scraping z integracjami — świetne do wysyłania danych do Google Sheets, Airtable lub API. |
| Instant Data Scraper | Tak – automatycznie wykrywa tabele danych | Bardzo łatwe (wystarczy kliknąć, bez konfiguracji) | Natychmiastowe, darmowe scrapowanie tabel HTML i list przez każdego (idealne do szybkiego pobrania danych). |
| ScrapeStorm | Tak – AI identyfikuje elementy strony | Łatwe (interfejs wizualny; aplikacja wieloplatformowa) | Duże lub złożone projekty scrapowania bez kodowania, także z harmonogramem. |
| Apify | Częściowo – dostępne gotowe boty „actor” | Średnie (interfejs webowy; kod opcjonalny) | Skalowalne scrapowanie w chmurze i automatyzacja dzięki gotowym lub własnym skryptom. |
| ParseHub | Nie (bez skryptów, ale z ręczną konfiguracją) | Łatwe do podstawowego użycia (wizualny edytor; aplikacja desktopowa) | Scrapowanie dynamicznych lub złożonych stron (treści AJAX) przez no-code interfejs. |
| OutWit Hub | Nie | Łatwe (desktopowa aplikacja GUI) | Prosta, offline’owa ekstrakcja danych i archiwizacja treści w małych projektach. |
Większość narzędzi oferuje darmowy plan lub okres próbny oraz zróżnicowane subskrypcje. Skupiamy się tu na możliwościach i zastosowaniach, a nie na cenie.
Thunderbit: narzędzie do wyciągania danych z sieci oparte na AI dla każdego

Wyciągaj dane z dowolnej strony z pomocą AI Bez selektorów i bez konfiguracji — AI odczytuje stronę i jednym kliknięciem zwraca uporządkowaną tabelę. Get Started Free
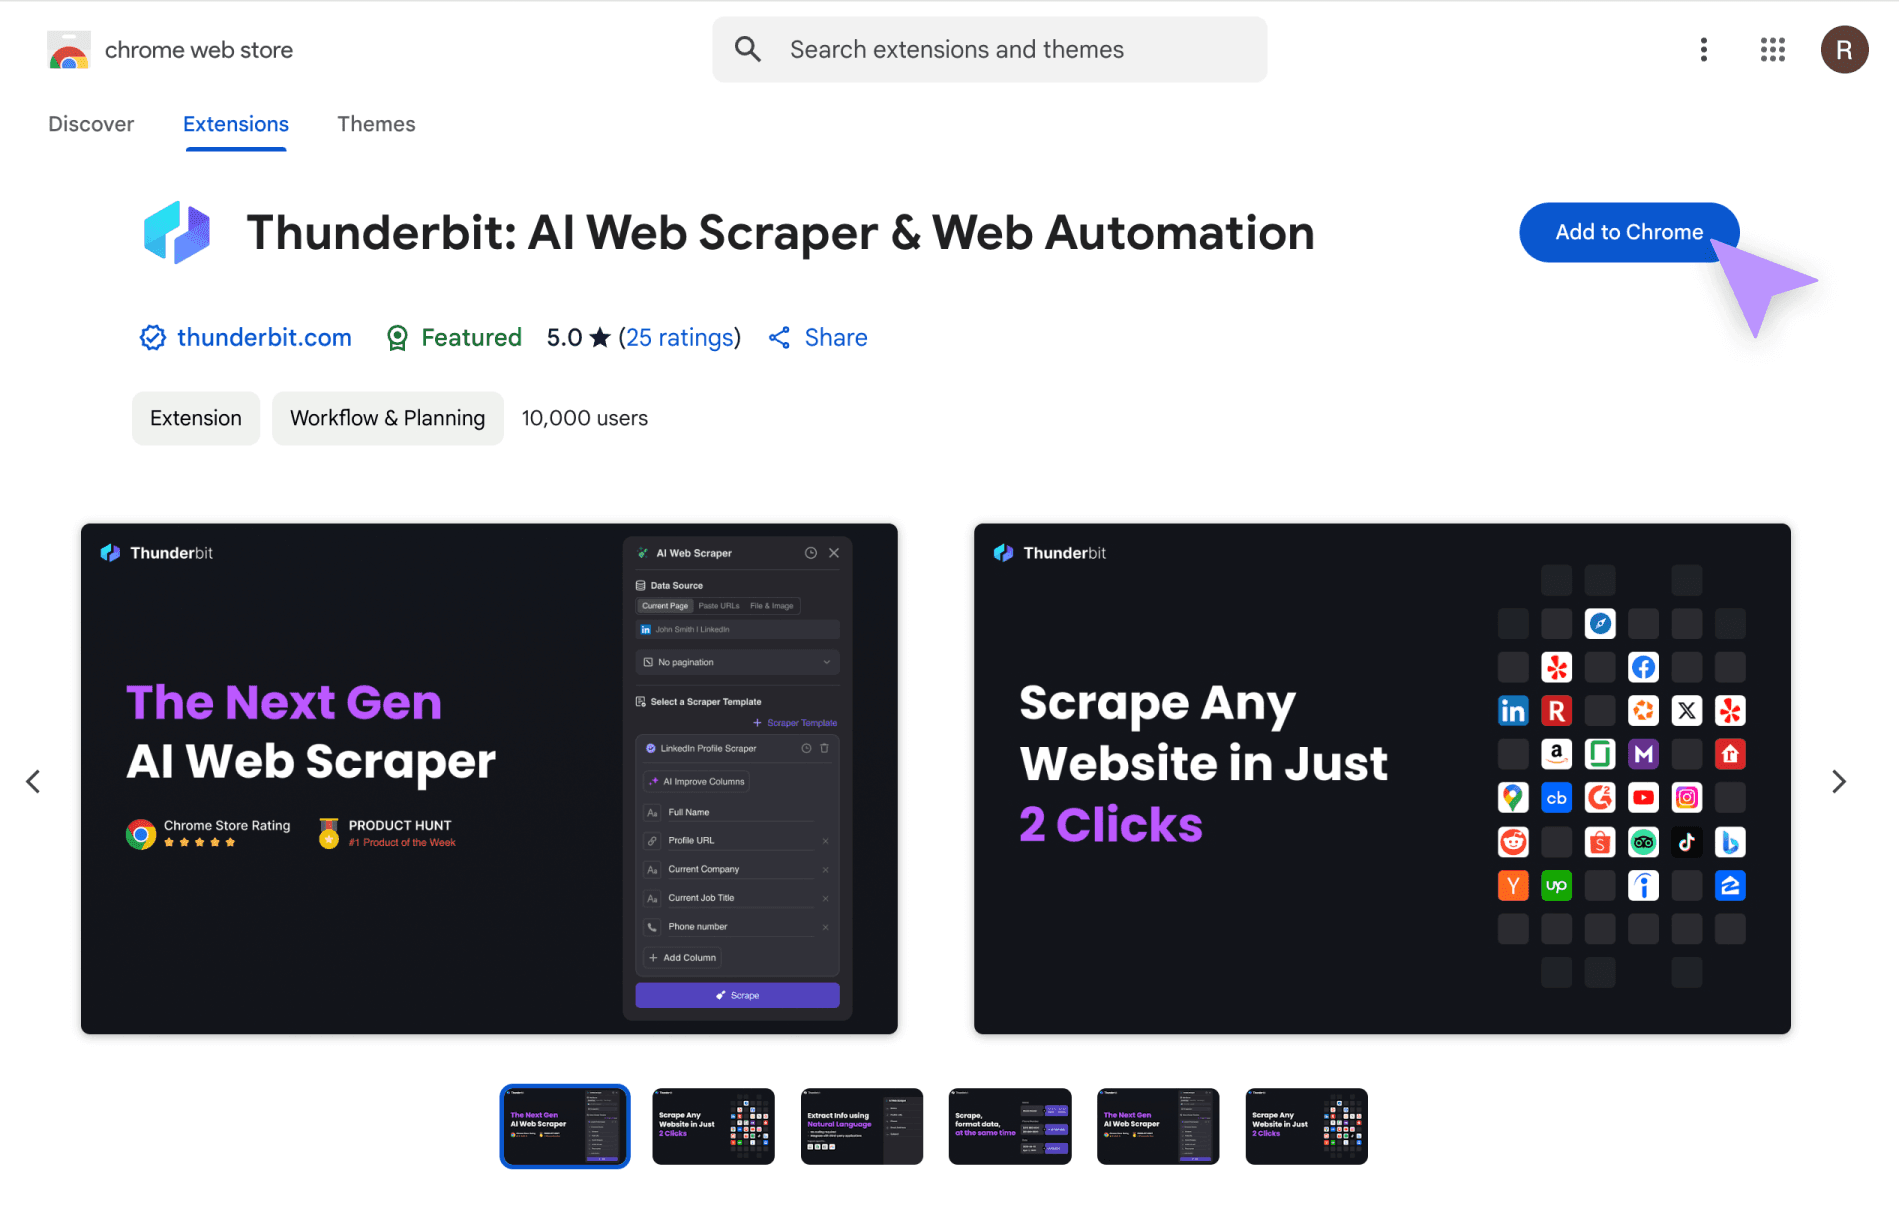
Zacznijmy od Thunderbit — tak, to moje „dziecko”, ale posłuchaj mnie. Branża wyciągania danych z sieci przechodzi od modelu „skonfiguruj własnego scrapera” do „po prostu powiedz AI, czego potrzebujesz”. Thunderbit to pierwsze narzędzie, które widziałem (i pomagałem tworzyć), naprawdę przypominające asystenta danych AI, a nie kolejny zwykły „crawler”.
W Thunderbit nie bawisz się w XPath, selektory CSS ani wyrażenia regularne. Po prostu opisujesz po angielsku, jakie dane chcesz — na przykład „pobierz tytuł, autora i datę z tej strony” — a AI Thunderbit zajmuje się resztą (Thunderbit Blog). Klikasz „AI Suggest Fields”, a Thunderbit odczytuje stronę, proponuje kolumny i automatycznie obsługuje podstrony oraz paginację (Thunderbit Blog).
Ale nie chodzi tylko o samo pobieranie danych. Thunderbit potrafi czyścić, przekształcać, kategoryzować, a nawet tłumaczyć pola podczas scrapowania. Chcesz ujednolicić numery telefonów, streścić opisy albo przetłumaczyć nazwy produktów? Wystarczy krótka instrukcja, a AI zrobi swoje. A gdy skończysz, możesz wyeksportować dane bezpośrednio do Excela, Google Sheets, Airtable lub Notion (Thunderbit Blog).
To, co naprawdę wyróżnia Thunderbit, to zero konfiguracji i zero krzywej uczenia się. To rozszerzenie Chrome, więc uruchamiasz je w kilka sekund. Bez wtyczek, bez konfiguracji, bez technicznego żargonu. Dlatego stał się ulubionym narzędziem dla zespołów sprzedaży, marketingu i operacji, które potrzebują szybkich rezultatów (Thunderbit Blog). Darmowy plan pozwala przetestować cały workflow, a płatne plany są przystępne cenowo (dla większości zespołów to mniej niż miesięczny budżet na kawę).
Jeśli chcesz sprawdzić, jak wygląda AI web extracting, pobierz rozszerzenie Thunderbit Chrome i przetestuj je sam. Dni kopiowania i wklejania mogą właśnie dobiegać końca.
Octoparse: wizualny web extractor do niestandardowych workflow
Octoparse to klasyk w świecie wizualnego scrapowania webu. To aplikacja desktopowa z interfejsem point-and-click — wchodzisz w interakcję ze stroną, zaznaczasz dane, których potrzebujesz, a Octoparse buduje workflow w tle (Thunderbit Blog). Możesz obsługiwać logowania, ustawiać paginację, a nawet automatyzować wysyłanie formularzy — wszystko bez kodu.
Jedną z mocnych stron Octoparse jest biblioteka ponad 500 gotowych szablonów dla popularnych serwisów (Amazon, Twitter, LinkedIn itd.), więc często wystarczy załadować szablon i od razu zacząć pobieranie danych (Thunderbit Blog). Przy bardziej złożonych stronach możesz przełączyć się na tryb ręczny i wizualnie ustawić każdy krok. Octoparse obsługuje treści ładowane po kliknięciu lub przewijaniu, a w trudniejszych przypadkach radzi sobie też z proxy i CAPTCHA. Dostępna jest również opcja chmurowa do planowania i uruchamiania zadań na większą skalę.
Minus? Jest tu pewna krzywa uczenia się, zwłaszcza jeśli chcesz obsługiwać bardziej zaawansowane scenariusze. Ale dla osób nietechnicznych i analityków danych, którzy chcą spersonalizowanego workflow scrapowania bez kodu, Octoparse to solidny wybór (Dev.to).
Browse AI: zautomatyzowane wyciąganie danych z sieci z gotowymi robotami
Browse AI ma ciekawy, przyjazny styl działania: uczysz „robota”, wskazując i klikając dane, które chcesz pobierać, a on uczy się wyciągać je z podobnych stron (Thunderbit Blog). To rozwiązanie w chmurze i bez kodu, więc nie musisz martwić się skryptami ani serwerami.
To, co wyróżnia Browse AI, to automatyzacja i monitoring. Możesz zaplanować regularne uruchamianie robotów i otrzymywać alerty, gdy dane się zmienią (na przykład gdy konkurent obniży cenę albo pojawi się nowe ogłoszenie o pracę). Firma oferuje też bibliotekę gotowych robotów do typowych zadań — często możesz zacząć od gotowego rozwiązania i dostosować je do swoich potrzeb (ToolsForHumans).
Browse AI integruje się z tysiącami aplikacji przez Zapier i Make, a dane może eksportować bezpośrednio do Google Sheets albo przez API/webhooki (Thunderbit Blog). To świetne rozwiązanie do ciągłego monitoringu i cyklicznego zbierania danych, zwłaszcza jeśli zależy Ci na alertach i integracjach bez angażowania się w codzienną obsługę.
WebScraper.io: przeglądarkowy extractor stron internetowych
WebScraper.io (często po prostu „Web Scraper”) to rozszerzenie przeglądarki, które pozwala tworzyć „sitemapy” — wizualne plany tego, jak poruszać się po witrynie i jakie elementy pobierać (Thunderbit Blog). Określasz selektory dla potrzebnych danych i linków do śledzenia (na przykład „kliknij przycisk next, aby przejść dalej” albo „wejdź w każdy link produktu, by pobrać szczegóły”).
Jest tu pewna krzywa uczenia się, ale nie piszesz kodu — po prostu wybierasz elementy strony i ustawiasz działania ekstrakcji. Web Scraper obsługuje wielopoziomową nawigację, paginację, a nawet infinite scroll (choć te kroki trzeba ustawić ręcznie). Jest elastyczny i działa w przeglądarce, więc możesz scrapować strony wymagające logowania, logując się samodzielnie.
WebScraper.io jest idealny dla „obywatelskich analityków danych”, którzy rozumieją strukturę stron i chcą darmowego, elastycznego narzędzia. To niezawodny „koń roboczy”, jeśli chcesz samodzielnie ustawiać sitemapy.
ScraperAPI: API-first web extractor dla programistów i zespołów
Nie każdy zespół chce klikać w interfejs — czasem potrzebujesz rozwiązania backendowego, które przepchnie dane z sieci bezpośrednio do aplikacji lub baz danych. ScraperAPI to API-first web extractor: podajesz URL, a w odpowiedzi dostajesz surowy HTML albo wyekstrahowane dane, podczas gdy ono samo ogarnia trudne elementy, takie jak proxy, rotacja adresów IP z geolokalizacją, headless browsery i CAPTCHA (ScraperAPI Pricing).
ScraperAPI utrzymuje pulę 40 mln proxy w 50 krajach i deklaruje obsługę miliardów zapytań dla ponad 10 000 firm. Najlepiej sprawdza się przy automatycznym scrapowaniu na dużą skalę, gdzie liczą się niezawodność i odporność na blokady. Do korzystania z niego potrzebujesz umiejętności programistycznych, ale jeśli budujesz pipeline’y danych albo integrujesz scrapowanie ze swoim produktem, to jedna z najlepszych opcji.
Data Miner: rozszerzenie Chrome do szybkiego wyciągania danych ze stron
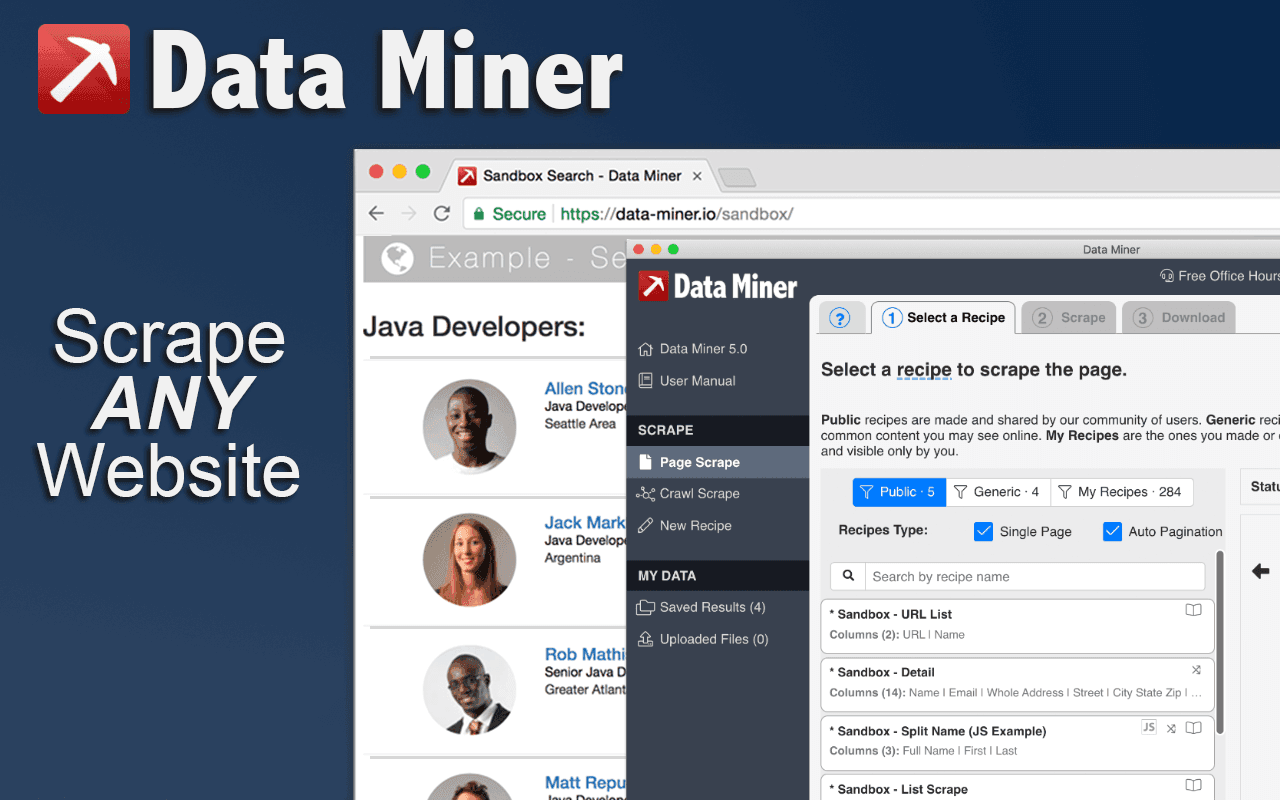
Data Miner to rozszerzenie Chrome stworzone dla użytkowników biznesowych i badaczy, którzy chcą szybko pobierać dane. Oferuje scraping metodą point-and-click i bibliotekę gotowych „przepisów” dla popularnych wzorców, takich jak tabele, listy czy konkretne strony (Dev.to).
Wystarczy zainstalować rozszerzenie, przejść na stronę docelową i kliknąć ikonę Data Miner. Wybierasz przepis albo tworzysz własny, zaznaczając elementy na stronie. To świetne rozwiązanie do jednorazowych zadań lub szybkich potrzeb danych — na przykład gdy handlowiec wyciąga listę leadów z katalogu online albo manager e-commerce kopiuje ceny konkurencji.
Data Miner jest prosty, działa bezpośrednio w przeglądarce i świetnie nadaje się do interaktywnego scrapowania na żądanie.
Simplescraper: no-code web extractor dla natychmiastowych efektów
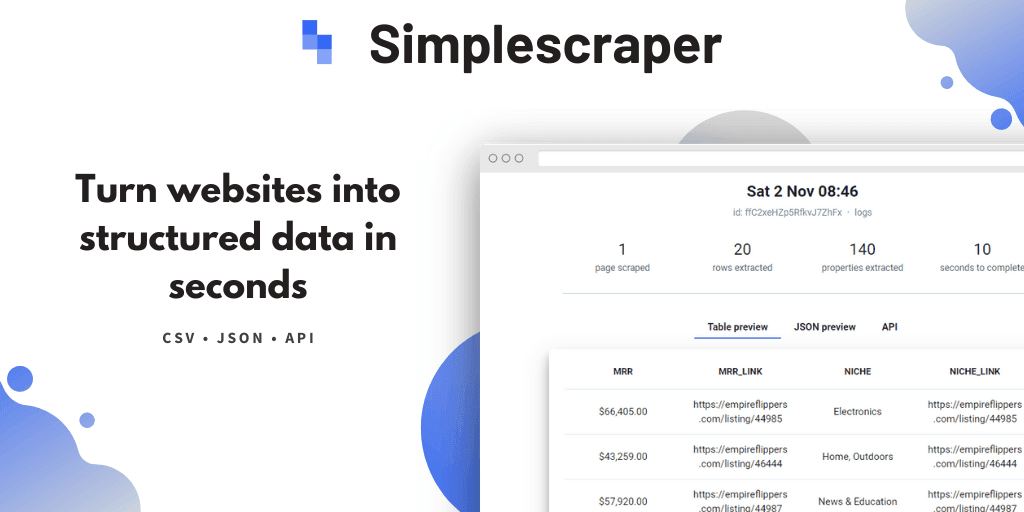
Simplescraper dokładnie odpowiada swojej nazwie. To no-code rozszerzenie Chrome (oraz aplikacja webowa), które pozwala wizualnie wskazywać dane na stronie i tworzyć „receptę” na ekstrakcję (Thunderbit Blog). Możesz podążać za linkami, by scrapować podstrony, obsługiwać paginację, a nawet jednym kliknięciem zamienić scraping w endpoint API.
Tam, gdzie Simplescraper naprawdę błyszczy, są integracje — dane możesz wysyłać bezpośrednio do Google Sheets, Airtable lub narzędzi takich jak Zapier (Thunderbit Blog). Dostępne są też scraping w chmurze i harmonogramowanie zadań cyklicznych, a funkcja „AI Enhance” pozwala czyścić lub analizować dane z pomocą GPT.
Jeśli chcesz szybkich rezultatów i łatwych integracji, Simplescraper to coś w rodzaju scyzoryka szwajcarskiego dla lekkiego web scrapingu.
Instant Data Scraper: błyskawiczne wyciąganie danych z tabel i list
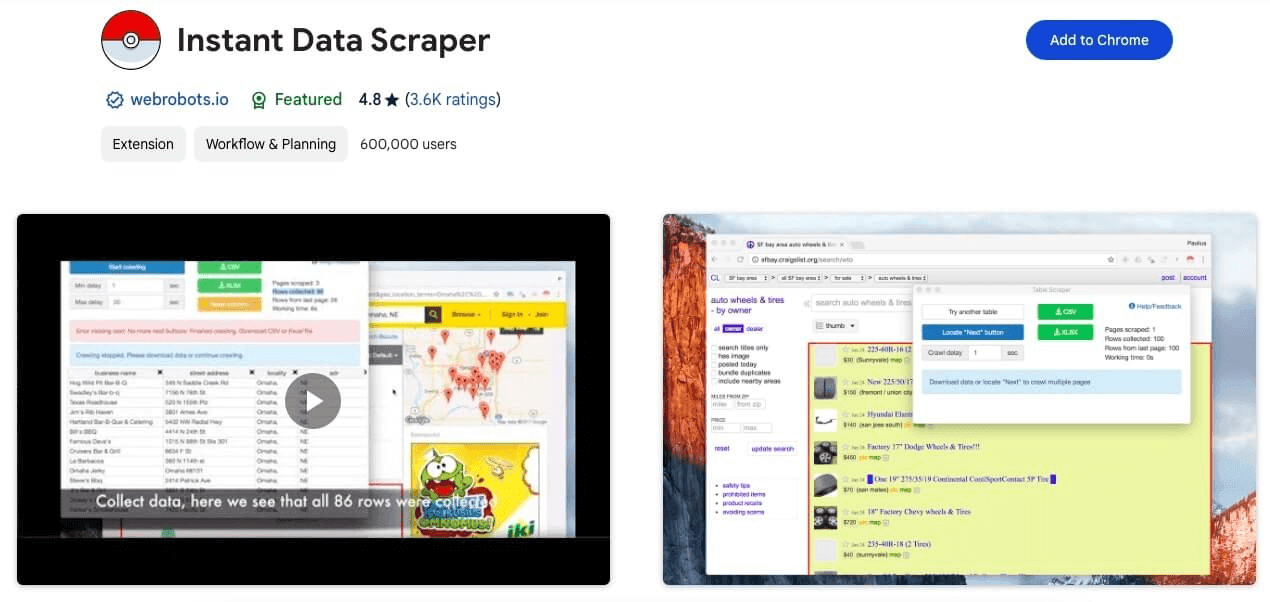
Czasem po prostu chcesz dostać dane od razu, bez żadnej konfiguracji. I właśnie tu wchodzi Instant Data Scraper (IDS). To darmowe rozszerzenie Chrome znane z jednoklikowego scrapowania danych tabelarycznych (Thunderbit Blog). Po uruchomieniu rozszerzenia IDS automatycznie wykrywa tabele lub listy na stronie. Radzi sobie nawet z paginacją i infinite scroll, automatycznie przechodząc przez kolejne strony.
IDS jest w 100% darmowy, bez rejestracji, bez kodowania, bez czekania. To idealne rozwiązanie do luźnych albo pilnych potrzeb związanych ze scrapingiem — na przykład gdy handlowiec potrzebuje szybko listy leadów albo student pobiera dane z tabel Wikipedii. Jeśli narzędzie znajdzie dane, będziesz je mieć w kilka sekund.
ScrapeStorm: chmurowy extractor z AI
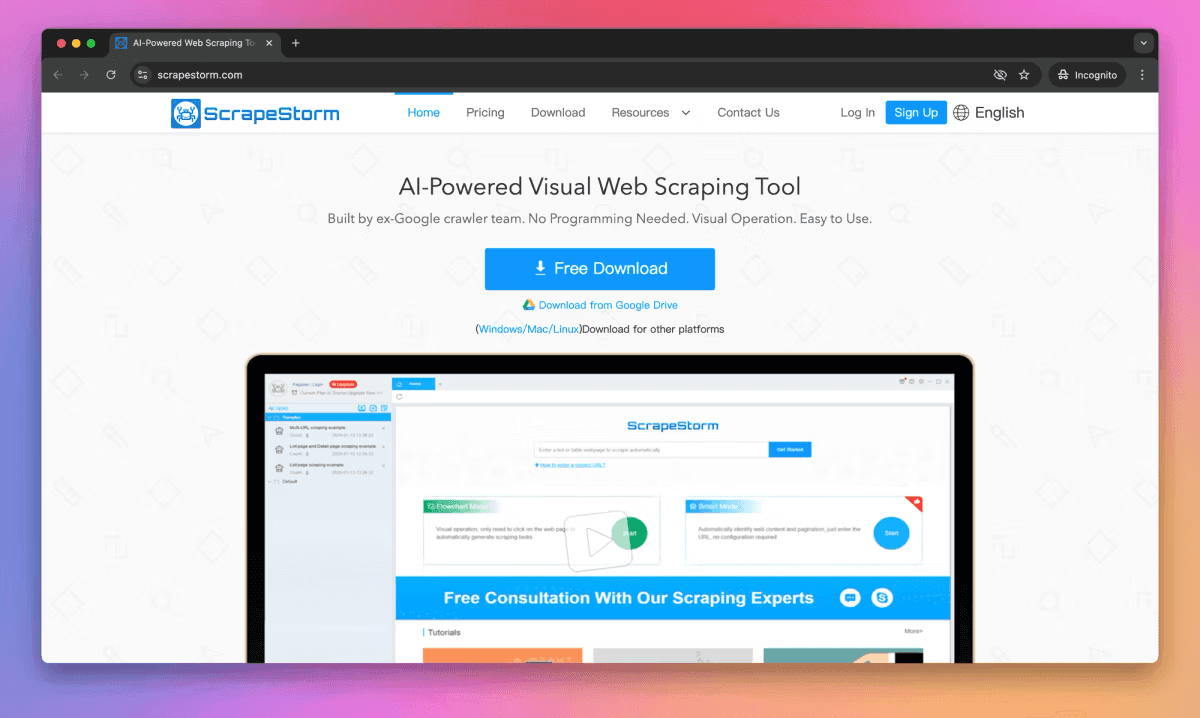
ScrapeStorm to narzędzie do web scrapingu zasilane AI, które łączy interfejs wizualny z mocnymi algorytmami sztucznej inteligencji (AI Tools Inc.). Wpisujesz URL, a jego AI automatycznie identyfikuje pola danych — listy, tabele, przyciski następnej strony i wiele więcej.
ScrapeStorm działa wieloplatformowo (Windows, Mac, Linux) i oferuje zarówno scrapowanie desktopowe, jak i chmurowe. Możesz planować zadania, uruchamiać wiele procesów równolegle i eksportować dane do Excela, CSV, JSON, a nawet przesyłać je do bazy danych (AI Tools Inc.). Narzędzie jest szczególnie popularne w e-commerce i badaniach rynku, a dzięki AI potrafi nawet analizować dane z obrazów lub PDF-ów.
Jeśli potrzebujesz inteligentnego asystenta do dużych lub złożonych projektów scrapowania, ScrapeStorm zdecydowanie warto sprawdzić.
Apify: marketplace extractorów i platforma automatyzacji
Apify to nie tylko scraper — to platforma do web scrapingu i automatyzacji. Możesz uruchamiać „actors”, czyli skrypty do scrapowania lub automatyzacji w przeglądarce. Prawdziwa siła Apify tkwi w marketplace gotowych actorów do popularnych zadań (Dev.to). Chcesz pobrać wszystkie recenzje ze sklepu internetowego? Najpewniej znajdzie się na to gotowy actor.
Dla programistów Apify umożliwia tworzenie własnych scraperów w Node.js lub Pythonie i wdrażanie ich w chmurze. Jest skalowalne, łatwe do automatyzacji i integruje się przez API. Apify najlepiej sprawdza się w rękach power userów i organizacji, które traktują dane z sieci jako kluczowy zasób — na przykład przy ciągłym, dużoskalowym scrapowaniu lub wpinaniu scrapingu w pipeline danych.
ParseHub: wizualny extractor stron do złożonych serwisów
ParseHub to aplikacja desktopowa z opcją pracy w chmurze, znana z radzenia sobie z złożonymi, dynamicznymi stronami. Poruszasz się po witrynie w interfejsie podobnym do przeglądarki, klikasz punkty danych, a ParseHub buduje scraper za Ciebie (Dev.to). Obsługuje logikę warunkową, zagnieżdżone scrapowanie, treści AJAX i wiele więcej.
ParseHub często jest wybierany wtedy, gdy inne narzędzia nie radzą sobie z poprawnym pobraniem strony. Korzystają z niego badacze, analitycy i właściciele małych firm, którzy muszą zmierzyć się z trudnymi witrynami. Krzywa uczenia się istnieje, ale jeśli masz złożoną stronę do scrapowania i nie chcesz pisać kodu, to jedna z najlepszych opcji.
OutWit Hub: desktopowy extractor do archiwizacji treści
OutWit Hub ma trochę oldschoolowy charakter, ale jako aplikacja desktopowa świetnie sprawdza się do zbierania wielu typów treści (linków, obrazów, adresów e-mail itd.) i porządkowania ich (Scrapeless). Działa jak połączenie przeglądarki z arkuszem kalkulacyjnym — wchodzisz na stronę, a OutWit Hub potrafi wyciągać tabele, listy, obrazy i więcej.
Szczególnie przydaje się do archiwizacji treści i researchu — na przykład do pobrania wszystkich wpisów z forum albo pobrania kolekcji plików. To narzędzie desktopowe, więc działa lokalnie i pozwala zachować prywatność danych. OutWit Hub najlepiej sprawdza się przy małych i średnich zadaniach scrapowania, kiedy chcesz prosty interfejs desktopowy.
Który web extractor będzie najlepszy dla Twoich potrzeb?
Dwanaście narzędzi, tysiąc zastosowań. Który web extractor wybrać? Oto moja ściąga:
-
Dla zupełnych początkujących lub jednorazowych szybkich zadań:
Wypróbuj Instant Data Scraper do prostych tabel i list (jest darmowy i działa od razu). Data Miner to kolejna przyjazna opcja z większą liczbą szablonów, jeśli często scrapujesz podobne strony.
-
Dla osób nietechnicznych, które potrzebują ciągłego scrapowania lub integracji:
Thunderbit oferuje najprostszy workflow dzięki podejściu opartemu na AI — idealny dla użytkowników biznesowych, którzy chcą szybkich rezultatów i często z nich korzystają. Browse AI jest świetny do ciągłego monitoringu i alertów. Simplescraper będzie dobrym wyborem, jeśli chcesz, by dane trafiały do Google Sheets albo wewnętrznej aplikacji przez API.
-
Dla złożonych stron lub niestandardowych workflow bez kodowania:
Wybierz wizualny scraper, taki jak Octoparse lub ParseHub. Octoparse jest przyjazny w obsłudze i ma mnóstwo szablonów. ParseHub radzi sobie z bardzo złożonymi dynamicznymi stronami i daje dużą kontrolę. WebScraper.io też jest świetny, jeśli chcesz samodzielnie konfigurować sitemapy.
-
Dla programistów lub inżynierów danych, którzy potrzebują skali:
ScraperAPI jest stworzony do wpinania web scrapingu w oprogramowanie lub do dużych projektów. Apify to świetny wybór, gdy potrzebujesz skalowalnej platformy z marketplace gotowych lub własnych skryptów.
-
Dla treściowych projektów lub pracy offline:
OutWit Hub to solidny wybór do systematycznego zbierania i archiwizowania treści, szczególnie jeśli wolisz narzędzie desktopowe ze względu na prywatność i kontrolę.
Zobacz, co AI wyłapie z Twojej własnej strony Otwórz stronę, która naprawdę Cię interesuje, i pozwól Thunderbit samodzielnie odczytać kolumny — uporządkowana tabela jednym kliknięciem, z darmowym planem w pakiecie. Get Started Free
Szczerze mówiąc, wiele zespołów korzysta z kilku narzędzi naraz, w zależności od zadania. Możesz zacząć od Instant Data Scraper przy czymś prostym, przejść na Thunderbit lub Octoparse przy bardziej złożonym projekcie, a ScraperAPI lub Apify wykorzystać wtedy, gdy chcesz ten proces zindustrializować. Dobra wiadomość? Większość tych narzędzi ma darmowy plan lub wersję próbną, więc możesz testować i sprawdzić, co najlepiej pasuje.
Podsumowanie: przyszłość wyciągania danych z sieci dla zespołów biznesowych
Narzędzia do wyciągania danych z sieci przeszły długą drogę. W 2026 roku stały się już w pełni mainstreamowe. Najważniejszy trend? Web scraping staje się prostszy, bardziej zautomatyzowany i lepiej wpięty w codzienne procesy pracy (HubSpot Blog). Scrapery oparte na AI sprawiają, że nawet złożone, dynamiczne strony można opanować bez specjalistycznych kompetencji. Jak powiedział jeden z data engineerów: „Kiedy na rynku pojawiły się narzędzia do AI web scrapingu, mogłem wykonywać zadania znacznie szybciej i na większą skalę... dzięki AI [czyszczenie danych] jest automatycznie częścią mojego workflow.”
Kolejna duża zmiana to zacieranie granic między scrapingiem, monitoringiem i automatyzacją. Narzędzia takie jak Browse AI i Thunderbit nie tylko wyciągają dane, ale też utrzymują je w aktualności, a nawet potrafią wykonywać działania (np. wypełniać formularze lub uruchamiać alerty). Skala adopcji jest naprawdę duża — jedna z większych platform odnotowała wzrost miesięcznej liczby aktywnych użytkowników o ponad 140% w ciągu roku (Apify Blog). Firmy każdej wielkości zaczynają rozumieć, że dostęp do publicznych danych z sieci — etycznie i zgodnie z prawem — jest kluczem do utrzymania konkurencyjności.
Dla zespołów biznesowych wniosek jest prosty: większa sprawczość. Nie musisz już czekać tygodniami na dewelopera ani opierać decyzji wyłącznie na przeczuciu. Narzędzia z tej listy oddają moc danych webowych w Twoje ręce, oferując interfejsy i funkcje dopasowane do realnych zastosowań w sprzedaży, marketingu, operacjach i nie tylko. A biorąc pod uwagę kierunek rozwoju, w najbliższej przyszłości zobaczymy jeszcze prostsze interfejsy, mądrzejszą AI i głębsze integracje z platformami BI oraz analitycznymi.
Pamiętaj tylko: szanuj regulaminy stron i zasady robots.txt oraz upewnij się, że działasz zgodnie z przepisami o ochronie danych. Etyczny scraping jest ważny dla trwałości całego ekosystemu.
Niezależnie od tego, czy zaczynasz od darmowego rozszerzenia, czy wdrażasz narzędzia klasy enterprise, nigdy nie było lepszego momentu, by zamienić informacje z sieci w konkretne wnioski biznesowe. Rewolucja web extractora już trwa — wybierz narzędzie, przetestuj je i odblokuj wartość, która była na wyciągnięcie ręki. Twoja data-driven przyszłość jest dosłownie jedno kliknięcie stąd.
FAQ
1. Czym jest web extractor i dlaczego jest ważny dla firm?
Web extractor to narzędzie, które automatycznie zbiera uporządkowane dane ze stron internetowych. Jest ważny, ponieważ pozwala firmom zamieniać chaotyczne informacje online w praktyczne wnioski — zwiększając produktywność, poprawiając rentowność i eliminując ręczne zbieranie danych.
2. Kto może korzystać z web extractorów — czy potrzebuję umiejętności technicznych?
W przypadku wielu nowoczesnych web extractorów umiejętności techniczne nie są potrzebne. Narzędzia takie jak Thunderbit, Browse AI i Instant Data Scraper zostały stworzone z myślą o użytkownikach nietechnicznych, z intuicyjnym interfejsem, automatyzacją opartą na AI i workflow bez kodu.
3. Jak zespoły sprzedaży, marketingu i operacji mogą skorzystać z web extractorów?
Zespoły sprzedaży mogą budować listy leadów z katalogów online, marketing może monitorować ceny konkurencji, a operacje automatyzować procesy zbierania danych. Takie narzędzia oszczędzają czas, zmniejszają liczbę błędów i dostarczają świeże, wiarygodne informacje do decyzji strategicznych.
4. Na co zwrócić uwagę przy wyborze narzędzia do wyciągania danych z sieci?
Kluczowe czynniki to łatwość obsługi, możliwości AI, automatyzacja i harmonogramy, integracja z narzędziami takimi jak Google Sheets lub Airtable, skalowalność oraz dopasowanie do konkretnego zastosowania biznesowego (np. leady sprzedażowe, monitoring cen, archiwizacja treści).
5. Czy są dostępne darmowe lub tanie narzędzia do wyciągania danych z sieci?
Tak, wiele takich narzędzi oferuje darmowe plany lub przystępne cenowo opcje. Instant Data Scraper jest całkowicie darmowy do podstawowych zastosowań, a narzędzia takie jak Thunderbit, Simplescraper i Data Miner mają hojne darmowe plany z możliwością rozszerzenia w razie potrzeby.
Chcesz dowiedzieć się więcej o web extracting, AI scrapingu albo o tym, jak zamienić strony internetowe w nową przewagę Twojego zespołu? Sprawdź Thunderbit Blog, gdzie znajdziesz więcej poradników, wskazówek i prawdziwych historii z frontu automatyzacji danych.
Wypróbuj Thunderbit AI Web Extractor Get Started Free



