
Zautomatyzowany ruch stanowi dziś 53% całej sieci, czyli więcej niż ruch generowany przez ludzi, a systemy anty-botowe reagują na to coraz ostrzej.
Widziałem na własne oczy, jak jeden błąd — na przykład użycie niewłaściwego user agenta — potrafi zamienić projekt danych w ścianę błędów 403. Dla zespołów sprzedaży, e-commerce i operacji oznacza to utracone leady, nieaktualne ceny albo spadek przychodów.
Oto, czego nauczyłem się o user agentach w scrapingu — najważniejszych praktyk, typowych błędach i tego, jak narzędzia takie jak Thunderbit automatycznie ogarniają cały proces.

Dlaczego wybór najlepszego user agenta do scrapingu ma znaczenie
Zacznijmy od podstaw: czym właściwie jest user agent? Najprościej mówiąc, to „dowód osobisty” Twojej przeglądarki. Za każdym razem, gdy odwiedzasz stronę — niezależnie od tego, czy jesteś człowiekiem, czy botem — przeglądarka wysyła w nagłówkach żądania ciąg User-Agent. To krótka informacja w stylu: „Cześć, jestem Chrome na Windowsie” albo „Jestem Safari na iPhonie” (ScraperAPI). Oto jak wygląda typowy user agent Chrome:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36
Strony internetowe wykorzystują te dane z dwóch głównych powodów:
- Aby wyświetlić odpowiednią wersję treści (np. mobilną lub desktopową).
- Aby wykrywać boty i scrapery.
Jeśli Twój user agent brzmi jak „python-requests/2.28.1” albo „Scrapy/2.9.0”, równie dobrze możesz mieć tabliczkę z napisem „Cześć, jestem botem!”. Serwisy trzymają listy blokad dla takich oczywistych identyfikatorów i potrafią zatrzasnąć drzwi szybciej, niż zdążysz powiedzieć „403 Forbidden”. Z drugiej strony, użycie popularnego, aktualnego user agenta przeglądarki pomaga wtopić się w tłum.
Krótko mówiąc: user agent to Twoja przykrywka. Im lepsza, tym większa szansa, że zdobędziesz potrzebne dane.
Rola user agenta w skutecznym web scrapingu
Dlaczego wybór user agenta ma aż tak duże znaczenie? Bo to pierwsza linia obrony większości systemów anty-botowych. Oto, co może pójść nie tak, jeśli trafisz źle:
- Natychmiastowe blokady (błędy 403/429): Jeśli użyjesz domyślnego user agenta z biblioteki scrapingowej, możesz zostać zablokowany, zanim w ogóle zobaczysz stronę główną (Webmasters StackExchange).
- Puste albo fałszywe dane: Niektóre strony podają puste lub „testowe” treści podejrzanym user agentom.
- CAPTCHA lub przekierowania: Botopodobny UA wywołuje testy typu „Czy jesteś człowiekiem?” albo zapętla logowanie.
- Ograniczanie ruchu i bany: Jeśli bombardujesz stronę tym samym UA w kółko, licz się z limitowaniem albo blokadą IP.
Zobaczmy, jak różne user agenty wypadają w praktyce:
| Ciąg User Agent | Wynik na większości stron (2026) |
|---|---|
python-requests/2.28.1 | Natychmiast zablokowany, oznaczony jako bot |
Scrapy/2.9.0 (+https://scrapy.org) | Zablokowany albo otrzymuje fałszywe treści |
Mozilla/5.0 (Windows NT 10.0; Win64; x64)... | Traktowany jak prawdziwy użytkownik, dostęp przyznany |
AhrefsBot/7.0 (+http://ahrefs.com/robot/) | Zablokowany, znany crawler |
| Pusty lub bezsensowny UA | Czasem przepuszczany, ale często budzący podejrzenia |
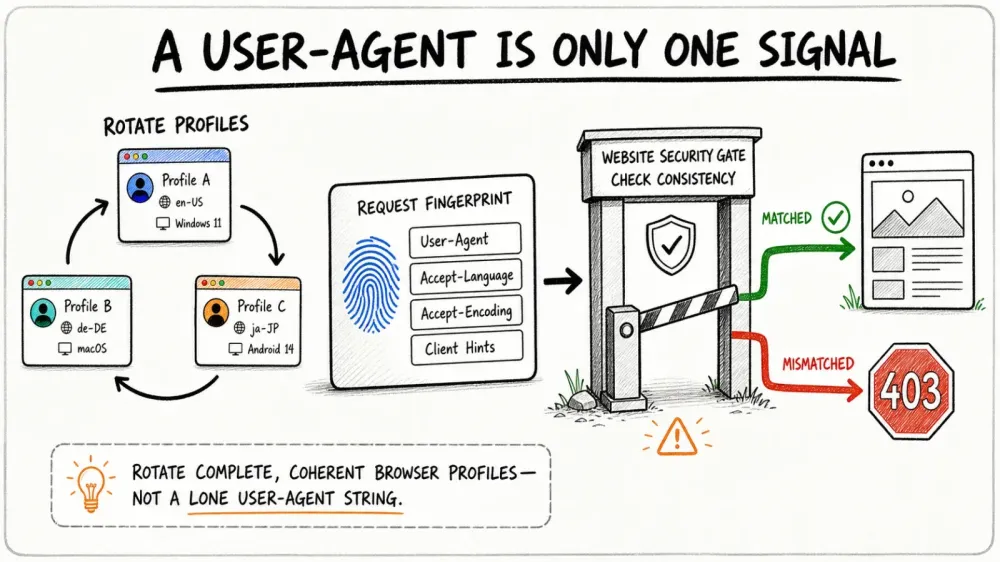
Wniosek? Wybierz przebrane mądrze. I nie zapominaj — nowoczesne systemy anty-botowe nie patrzą wyłącznie na user agenta. Sprawdzają też, czy inne nagłówki żądań (np. Accept-Language albo Referer) do siebie pasują. Jeśli twierdzisz, że jesteś Chrome, ale nie wysyłasz odpowiednich nagłówków, i tak zostaniesz wykryty (ScraperAPI).
Zbieraj dane z dowolnej strony z pomocą AI Agentowy web scraper Thunderbit sam radzi sobie z renderowaniem i strukturą strony, więc nie musisz ręcznie zarządzać user agentami. Get Started Free
I właśnie tu pojawia się Thunderbit. Rozmawiałem z wieloma użytkownikami biznesowymi — handlowcami, menedżerami e-commerce, agentami nieruchomości — którzy chcą po prostu danych, a nie kursu obsługi nagłówków HTTP. Dlatego zbudowaliśmy Thunderbit tak, aby zarządzanie user agentem było niewidoczne i w pełni automatyczne.
Thunderbit: prostsze zarządzanie user agentem dla każdego
Dzięki scrapingowi jednym kliknięciem w Thunderbit w ogóle nie musisz wybierać user agenta. Nasz silnik AI zrobi to za Ciebie, dobierając najbardziej realistyczny i aktualny podpis przeglądarki dla każdej strony. Niezależnie od tego, czy korzystasz z rozszerzenia Thunderbit do Chrome (które dosłownie używa prawdziwego UA Chrome), czy ze scrapingu w chmurze (gdzie AI rotuje pulą aktualnych UA przeglądarek), zawsze wyglądasz jak normalny ruch użytkowników.
I nie chodzi tylko o sam user agent. Thunderbit wysyła pełny, spójny zestaw nagłówków — Accept-Language, Accept-Encoding, Client Hints i inne — dzięki czemu żądania zachowują się jak prawdziwa przeglądarka. Koniec z niedopasowanymi nagłówkami i czerwonymi flagami sugerującymi bota.
Najlepsze jest to, że nie musisz niczego konfigurować. AI Thunderbit obsługuje wszystkie techniczne szczegóły w tle, więc możesz skupić się na tym, co naprawdę ważne: na wiarygodnych, wysokiej jakości danych.
Wypróbuj agentowy web scraper Thunderbit za darmo Zainstaluj darmowe rozszerzenie Chrome i wyciągaj uporządkowane dane z dowolnej strony jednym kliknięciem — bez ręcznego maskowania nagłówków. Get Started Free
Dlaczego dynamiczna rotacja user agentów to dziś must-have
Załóżmy, że znalazłeś idealny user agent. Czy powinieneś używać go przy każdym żądaniu? Nie tak szybko. W 2026 roku ciągłe korzystanie z tego samego UA to gotowy sygnał alarmowy. Prawdziwi użytkownicy korzystają z różnych przeglądarek, wersji i urządzeń. Jeśli Twój scraper odwiedzi stronę 500 razy z rzędu z tym samym UA, wygląda to jak defilada identycznych bliźniaków — nikt się nie nabierze.
Dlatego dynamiczna rotacja user agentów stała się standardem branżowym. Pomysł jest prosty: przy każdym żądaniu albo sesji przełączasz się między listą realistycznych, aktualnych user agentów. Dzięki temu scraper wygląda jak zróżnicowana grupa prawdziwych odwiedzających, a nie jeden skrypt automatyzujący wszystko (Capsolver).
Rotacja oparta na AI w Thunderbit idzie jeszcze dalej. Przy crawlowaniu wielu stron lub zadaniach zaplanowanych Thunderbit automatycznie rotuje user agentami i łączy je z różnymi proxy IP. Jeśli strona zaczyna się czegoś domyślać, Thunderbit reaguje w czasie rzeczywistym — zmienia UA, dopasowuje nagłówki albo spowalnia żądania, jeśli trzeba. Wszystko dzieje się w tle, więc scraping pozostaje niewykryty, a dane nadal płyną.
User agent i nagłówki żądań: siła spójności
Oto rada od praktyka: user agent to tylko jeden element „odcisku palca” Twojego żądania. Nowoczesne systemy anty-botowe sprawdzają, czy UA zgadza się z innymi nagłówkami, takimi jak Accept-Language, Accept-Encoding czy Referer. Jeśli podajesz Chrome na Windowsie, ale wysyłasz francuski Accept-Language z adresu IP z Nowego Jorku, to aż się prosi o kłopoty (ScraperAPI).
Dobra praktyka:
- Zawsze wysyłaj pełny zestaw nagłówków zgodny z user agentem.
- Utrzymuj Accept-Language i Accept-Encoding w zgodzie z UA oraz — jeśli to możliwe — z geolokalizacją IP.
- Korzystaj z narzędzi deweloperskich przeglądarki, aby podejrzeć prawdziwe żądania i skopiować pełny zestaw nagłówków dla wybranego UA.
Thunderbit robi to za Ciebie. Nasza AI dopilnuje, aby każde żądanie idealnie pasowało — user agent, nagłówki, a nawet fingerprint przeglądarki. Dostajesz profil żądania łudząco podobny do ludzkiego bez kiwnięcia palcem.
Najczęstsze pułapki: czego NIE robić z user agentami
Widziałem mnóstwo projektów scrapingowych, które kończyły się niepowodzeniem z tych samych powodów. Oto największe błędy, których warto unikać:
- Używanie domyślnych UA z bibliotek scrapingowych: Ciągi typu
python-requests/2.x,Scrapy/2.9.0czyJava/1.8to natychmiastowe wyzwalacze blokad. - Przestarzałe wersje przeglądarek: Podszywanie się pod Chrome 120 w 2026 roku? Podejrzane — ta wersja ma już ponad dwa lata. Zawsze używaj UA z aktualnego stabilnego kanału (w chwili pisania: Chrome 147); lista starsza o 12 miesięcy to już dla botów zbyt oczywisty ślad.
- Niedopasowane nagłówki: Nie wysyłaj UA Chrome bez brakujących albo niespójnych Accept-Language, Accept-Encoding czy Client Hints.
- Znane UA crawlerów: Wszystko z „bot”, „crawler”, „spider” albo nazwami narzędzi (np. AhrefsBot) jest od razu podejrzane.
- Puste lub bezsensowne UA: Czasem przechodzą, ale często budzą podejrzenia i są mało niezawodne.
Krótka checklista bezpiecznych user agentów:
- Używaj prawdziwych, aktualnych UA przeglądarek (Chrome, Firefox, Safari).
- Rotuj między wieloma UA.
- Dbaj o spójność nagłówków z UA.
- Aktualizuj listę UA co miesiąc (przeglądarki zmieniają się szybko).
- Unikaj wszystkiego, co krzyczy „automatyzacja”.
Thunderbit w praktyce: realne scenariusze dla sprzedaży i operacji
Przejdźmy do konkretów. Oto jak zarządzanie user agentem w Thunderbit pomaga prawdziwym zespołom:
| Przypadek użycia | Stary sposób: ręczny scraping | Z Thunderbit | Efekt |
|---|---|---|---|
| Pozyskiwanie leadów sprzedażowych | Częste blokady, braki w danych | AI wybiera najlepszy UA, rotuje i naśladuje prawdziwe przeglądanie | Więcej leadów, lepsza jakość, mniej odrzuceń |
| Monitorowanie e-commerce | Skrypt się psuje, bany IP | Scraping w chmurze z dynamiczną rotacją UA i proxy | Niezawodne śledzenie cen i stanów magazynowych |
| Oferty nieruchomości | Uciążliwe poprawki, blokady | AI dopasowuje UA/nagłówki, automatycznie obsługuje podstrony | Pełne, aktualne listy nieruchomości |

Jeden zespół sprzedaży korzystający z Thunderbit zebrał leady z tysięcy stron i osiągnął tylko około 8% odrzuceń e-maili — w porównaniu z 15–20% w przypadku kupionych list (Reddit). To właśnie siła świeżego scrapingu, który wygląda jak ruch prawdziwego człowieka.
Krok po kroku: jak scrapować z najlepszym user agentem używając Thunderbit
Oto, jak łatwo zacząć pracę z Thunderbit — bez żadnych umiejętności technicznych:
- Zainstaluj rozszerzenie Thunderbit do Chrome.
- Przejdź do wybranej strony. Zaloguj się, jeśli trzeba — Thunderbit działa także na stronach po zalogowaniu.
- Kliknij „One Click Extract”. AI Thunderbit przeskanuje stronę i zaproponuje najlepsze kolumny do pobrania.
- Sprawdź i popraw pola, jeśli chcesz. Zmień nazwy, dodaj lub usuń kolumny według potrzeb.
- Kliknij „Scrape”. Thunderbit wyciągnie dane, rotując w tle user agentami i nagłówkami.
- Wyeksportuj dane. Wyślij je bezpośrednio do Excel, Google Sheets, Airtable, Notion albo pobierz jako CSV/JSON.
Nie musisz wybierać ani aktualizować user agentów — AI Thunderbit robi to wszystko, dostosowując się do każdej strony, aby zmaksymalizować skuteczność.
Scraping z rotacją user agentów wspieraną przez AI Thunderbit uruchamia zadania scrapingowe na własnej infrastrukturze, więc jedno kliknięcie zastępuje ręczne skrypty rotujące user user agentami. Get Started Free
Thunderbit kontra tradycyjne zarządzanie user agentami
Zobaczmy, jak Thunderbit wypada na tle starego, ręcznego podejścia:
| Funkcja/Zadanie | Ręczne podejście do scrapingu | Podejście Thunderbit |
|---|---|---|
| Konfiguracja user agenta | Research i ustawianie w kodzie | Automatyczna, wybierana przez AI dla każdej strony |
| Aktualizowanie UA | Ręczne, łatwo zapomnieć | AI aktualizuje je zgodnie z trendami przeglądarek |
| Rotacja UA | Własna logika w kodzie | Wbudowana, inteligentna rotacja |
| Spójność nagłówków | Ręczne dopasowywanie do UA | AI zapewnia pełny, spójny zestaw nagłówków |
| Obsługa blokad/CAPTCHA | Ręczne podmiany, duże utrzymanie | AI adaptuje się, ponawia próby i rotuje w razie potrzeby |
| Wymagana wiedza techniczna | Wysoka (kodowanie, HTTP) | Żadna — rozwiązanie stworzone dla użytkowników biznesowych |
| Czas spędzony na debugowaniu | Często, frustrująco | Minimalny — skupiasz się na danych, nie na problemach scrapingu |
Thunderbit jest zbudowany dla każdego, kto chce niezawodnego, skalowalnego scrapingu — bez technicznego balastu.
Zobacz, jak działa agentowy web scraping AI Thunderbit czyta stronę jak człowiek i wyciąga dane jednym kliknięciem, eliminując potrzebę ręcznego strojenia scrapera. Get Started Free
Najważniejsze wnioski: jak zbudować strategię user agenta odporną na przyszłość
Oto, czego nauczyłem się o zarządzaniu user agentami w 2026 roku — czasem na własnych błędach:
- Nigdy nie używaj domyślnych ani przestarzałych user agentów. To główny powód blokad scraperów.
- Rotuj user agentami dynamicznie. Różnorodność działa na Twoją korzyść — nie pozwól, by Twój scraper wyglądał jak parada robotów.
- Dbaj o spójne i realistyczne nagłówki. Twój user agent jest tak dobry, jak nagłówki, które mu towarzyszą.
- Bądź na bieżąco. Wersje przeglądarek zmieniają się szybko, więc Twoja lista UA też powinna.
- Pozwól AI zająć się trudną częścią. Narzędzia takie jak Thunderbit mają najlepsze praktyki wbudowane od razu, więc możesz skupić się na wynikach, a nie na żądaniach.
Jeśli masz dość blokad, debugowania skryptów albo po prostu chcesz scrapować jak profesjonalista bez zbędnych komplikacji, wypróbuj Thunderbit. Nasz agentowy web scraper zaufały już tysiące użytkowników na całym świecie i został zaprojektowany tak, by uczynić dane z sieci dostępnymi dla każdego — bez technicznego bólu głowy.
Po więcej porad, tutoriali i dogłębnych analiz web scrapingu zajrzyj na blog Thunderbit.
FAQ
1. Czym jest user agent i dlaczego ma znaczenie w web scrapingu?
User agent to ciąg wysyłany przy każdym żądaniu do strony, który identyfikuje przeglądarkę i system operacyjny. Strony wykorzystują go do serwowania właściwej treści i wykrywania botów. Odpowiedni user agent pomaga scraperowi wtopić się w ruch i uniknąć blokad.
2. Dlaczego nie powinienem używać domyślnego user agenta z biblioteki scrapingowej?
Domyślne UA, takie jak python-requests/2.x, są powszechnie znanymi sygnaturami botów i często są blokowane natychmiast. Zawsze używaj realistycznych, aktualnych user agentów przeglądarek.
3. Jak Thunderbit obsługuje rotację user agentów?
AI Thunderbit automatycznie rotuje pulą aktualnych, realistycznych user agentów przeglądarek przy każdym żądaniu lub sesji. Dzięki temu scraping wygląda jak ruch prawdziwych, zróżnicowanych użytkowników.
4. Czy muszę ręcznie ustawiać nagłówki typu Accept-Language lub Referer w Thunderbit?
Nie! AI Thunderbit dba o to, by wszystkie nagłówki były spójne i zgodne z user agentem, więc żądania zachowują się jak prawdziwa przeglądarka.
5. Co się stanie, jeśli strona i tak zacznie blokować moje żądania?
Thunderbit wykrywa blokady lub CAPTCHA i dostosowuje się w czasie rzeczywistym — zmienia user agenta, dopasowuje nagłówki albo ponawia próbę w razie potrzeby. Dostajesz niezawodne dane bez ręcznego debugowania.
Gotowy na mądrzejszy scraping? Pobierz Thunderbit i pozwól naszej AI przejąć zabawę w kotka i myszkę z user agentami. Miłego scrapingu!
Dowiedz się więcej
- Czym są AI Agents? Jak działają i jak z nich korzystać
- Czym jest agent AI Manus? Jak działa i jak z niego korzystać
- Przewodnik dla początkujących: jak zbudować agenta AI krok po kroku
- Przewodnik po vertical AI agents: pojęcia i zastosowania w praktyce
- Zrozumienie statystyk agentów AI: od dokładności po skalowalność
Wypróbuj agentowy web scraper Get Started Free



