
Prawie połowa całego ruchu w internecie generowana jest dziś przez boty. Większość z nich na dużą skalę zbiera linki, dane i adresy URL. Jeśli nadal robisz to ręcznie, po prostu zostajesz w tyle.
Przetestowałem 12 narzędzi do wyodrębniania linków — od rozszerzeń Chrome opartych na AI po biblioteki Pythona — żeby sprawdzić, które z nich naprawdę dają radę, gdy trzeba szybko pobrać tysiące adresów URL.
Oto, co ustaliłem.
Dlaczego ekstraktory linków są tak ważne
Bądźmy szczerzy: internet pęka w szwach od danych, a firmy ścigają się, by przekuć ten chaos w konkretne wnioski. Ekstraktory linków i ekstraktory URL stały się dziś kluczowe dla zespołów, które chcą:
- Generować leady: zespoły sprzedaży mogą w kilka minut pobrać linki do profili firm z katalogów lub LinkedIna, a potem podać te URL-e narzędziom wyciągającym dane kontaktowe. Koniec z męczącym, bez końca powtarzanym klikaniem.
- Agregować treści i poprawiać SEO: marketerzy mogą zebrać wszystkie adresy artykułów z bloga, monitorować linki zwrotne konkurencji albo audytować strukturę witryny pod kątem niedziałających linków.
- Monitorować konkurencję i prowadzić research rynkowy: zespoły operacyjne mogą automatycznie zbierać linki do nowych produktów, stron z cennikiem czy informacji prasowych — i śledzić rynek bez wysiłku.
- Automatyzować procesy i oszczędzać czas: nowoczesne scrapery linków obsługują masowe URL-e, przechodzą przez podstrony i eksportują dane w uporządkowanych formatach (CSV, Excel, Google Sheets, Notion — co tylko chcesz). To oznacza koniec maratonów kopiuj-wklej i ręcznego sprzątania chaotycznych plików tekstowych.
Skoro codziennie indeksowane są dziesiątki miliardów stron internetowych, ręczne wykonywanie tego zadania nie wchodzi w grę. Dobry ekstraktor linków działa jak superszybki asystent, który nigdy się nie męczy, nie gubi linków i nie prosi o przerwę na kawę.
Jak wybraliśmy najlepsze ekstraktory linków
Przy takiej liczbie narzędzi wybór odpowiedniego ekstraktora linków może przypominać speed dating na konferencji technologicznej — wszyscy obiecują, że są „tym jedynym”, ale tylko nieliczni naprawdę dają radę. Oto, jak zawęziłem listę do top 12:
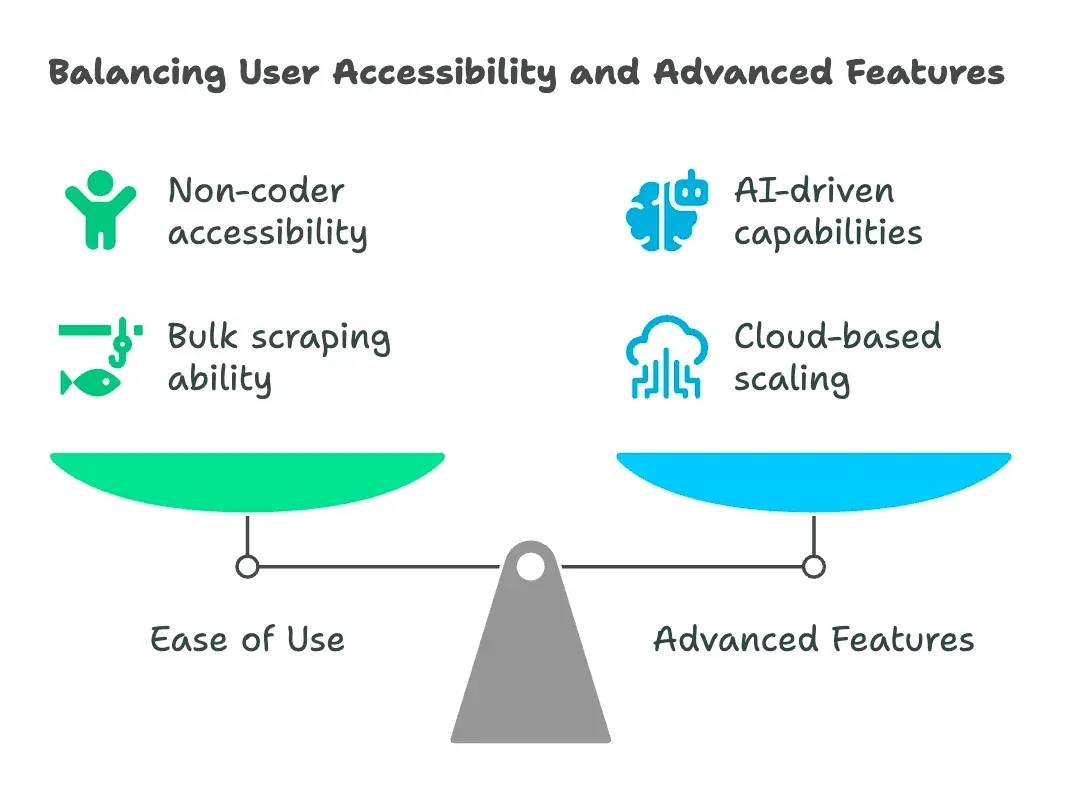
- Łatwość obsługi: czy osoby nietechniczne poradzą sobie bez doktoratu z regexów? Rozwiązania no-code i low-code dostały dodatkowe punkty.
- Masowe i wielopoziomowe scrapowanie: czy narzędzie obsłuży setki URL-i naraz? Czy automatycznie przechodzi przez podstrony i podąża za linkami?
- Eksport i integracje: czy potrafi eksportować do CSV, Excel, Google Sheets, Notion, Airtable lub przez API? Im mniej ręcznej pracy, tym lepiej.
- Typ użytkownika i elastyczność: czy jest przeznaczone dla użytkowników biznesowych, analityków czy developerów? Niektóre narzędzia są uniwersalne, inne bardziej niszowe.
- Zaawansowane funkcje: rozpoznawanie oparte na AI, harmonogramy, skalowanie w chmurze, czyszczenie danych i szablony dla popularnych stron.
- Cena i skalowalność: darmowe plany, model pay-as-you-go czy enterprise? Sprawdziłem, co faktycznie dostajesz za swoje pieniądze.
Uwzględniłem wszystko — od rozszerzeń przeglądarkowych po platformy enterprise — więc niezależnie od tego, czy jesteś soloprzedsiębiorcą, czy zespołem danych w firmie z listy Fortune 500, znajdziesz tu coś dla siebie.
Thunderbit: najinteligentniejszy ekstraktor linków dla użytkowników biznesowych
Zacznijmy od najlepszego. Thunderbit to moja pierwsza rekomendacja do wyodrębniania linków — i nie tylko dlatego, że współtworzyłem to narzędzie. Thunderbit to rozszerzenie Chrome do web scrapingu oparte na AI, stworzone z myślą o użytkownikach biznesowych, którzy chcą szybkich rezultatów.
Co wyróżnia Thunderbit? To trochę jak stażysta AI, który naprawdę słucha. Możesz opisać naturalnym językiem, czego potrzebujesz („Pobierz wszystkie linki do produktów i ceny z tej strony”), a AI Thunderbit zajmie się resztą. Bez dłubania przy selektorach i bez pisania skryptów.
Ale to nie wszystko:
- Obsługa masowych URL-i: wklej jeden adres albo listę setek — Thunderbit poradzi sobie ze wszystkim za jednym razem.
- Nawigacja po podstronach: chcesz pobrać linki ze strony listy, a potem wejść na każdą stronę szczegółów, aby wyciągnąć kolejne URL-e? Logika wielopoziomowego scrapowania Thunderbit to ogarnie.
- Uporządkowany eksport: po wyodrębnieniu linków możesz zmieniać nazwy pól, kategoryzować je i eksportować bezpośrednio do Google Sheets, Notion, Airtable, Excela lub CSV. Koniec z problemami po przetwarzaniu.
Wyodrębniaj linki z dowolnej strony z pomocą AI Get Started Free
Thunderbit zaufało ponad 200 000 użytkowników na całym świecie — od zespołów sprzedaży, przez agentów nieruchomości, po niezależne sklepy e-commerce. I tak, dostępny jest darmowy plan (do 6 stron, albo 10 w ramach boosta próbnego), więc możesz przetestować go bez ryzyka.
Wypróbuj Thunderbit Link Extractor za darmo
Najmocniejsze funkcje Thunderbit
Sprawdźmy, co naprawdę wyróżnia Thunderbit:
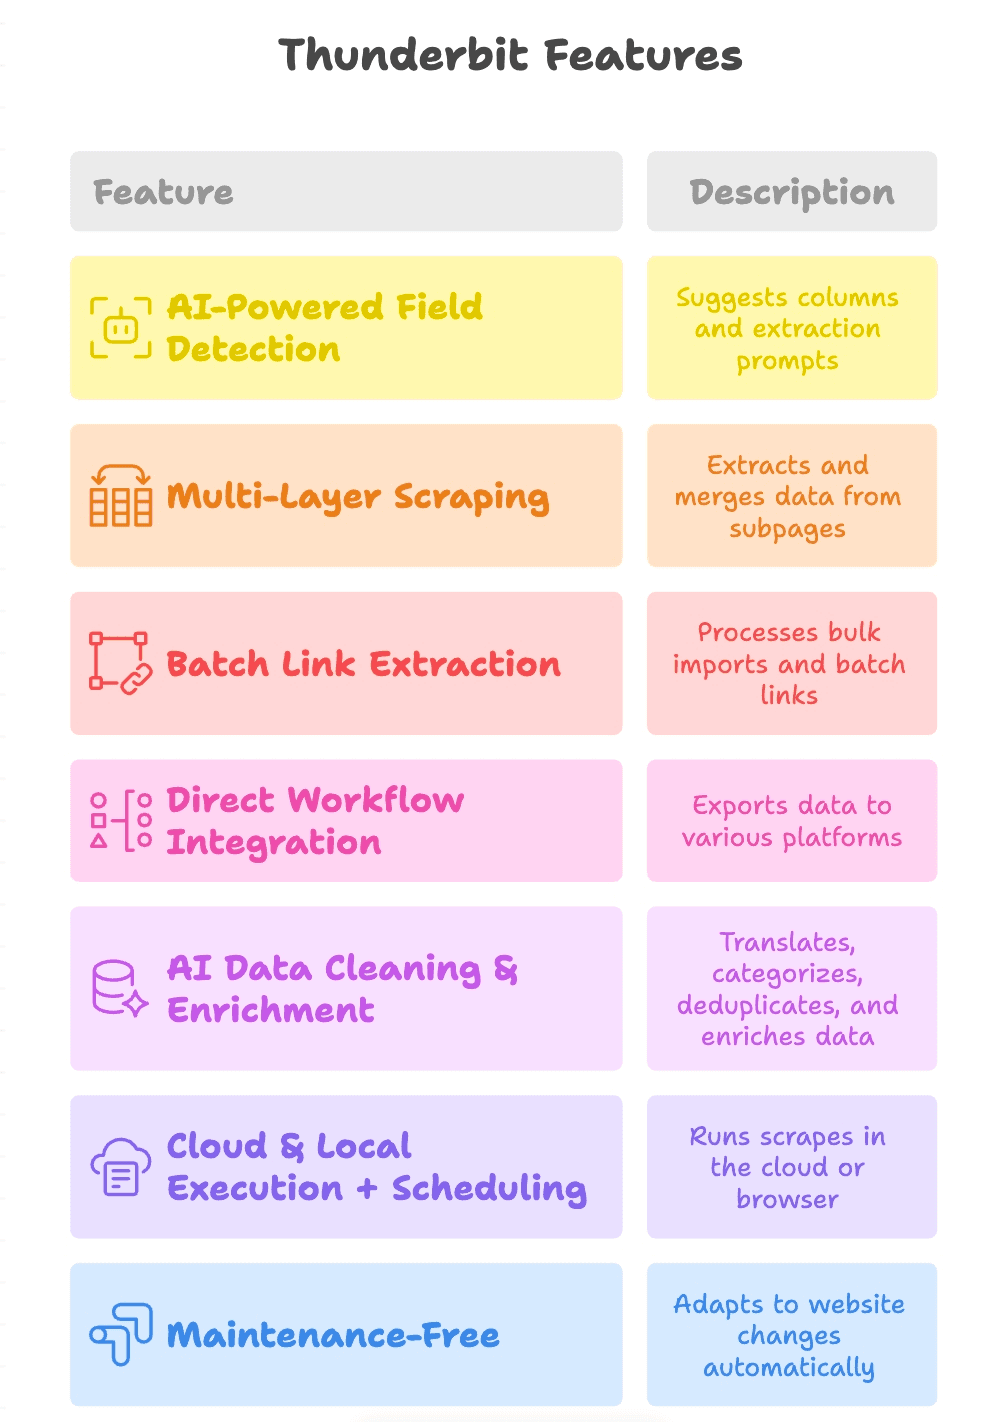
- Wykrywanie pól przez AI: wystarczy kliknąć „AI Suggest Fields”, a Thunderbit odczytuje stronę, proponuje kolumny (np. „Product Link”, „PDF URL”, „Contact Email”) i tworzy prompt do ekstrakcji dla każdego pola.
- Scraping wielopoziomowy: Thunderbit może przechodzić z głównej strony na podstrony (np. strony produktów lub pliki PDF), pobierać kolejne linki i scalać wszystko w jedną tabelę.
- Masowe wyodrębnianie linków: niezależnie od tego, czy scrapujesz jedną stronę, czy tysiąc, Thunderbit bez problemu obsługuje import zbiorczy i batch processing.
- Bezpośrednia integracja z workflow: eksportuj wyniki do Google Sheets, Notion, Airtable albo pobieraj je jako CSV/Excel. Dane trafiają dokładnie tam, gdzie potrzebuje ich Twój zespół.
- AI do czyszczenia i wzbogacania danych: Thunderbit może tłumaczyć, kategoryzować, usuwać duplikaty, a nawet wzbogacać dane w trakcie scrapowania — dzięki czemu wynik jest od razu gotowy do użycia.
- Uruchamianie w chmurze i lokalnie + harmonogramy: uruchamiaj scrapingi w chmurze dla większej szybkości albo w przeglądarce, jeśli strona wymaga logowania. Ustaw cykliczne zadania, by dane były zawsze świeże.
- Bezobsługowość: AI Thunderbit dostosowuje się do zmian na stronach, więc spędzasz mniej czasu na naprawianiu zepsutych scraperów, a więcej na pracy z wynikami.
Octoparse: no-code scraper linków dla każdego
Octoparse to klasyka w świecie scrapingu bez kodu. To aplikacja desktopowa (Windows/Mac) z wizualnym interfejsem typu point-and-click. Wczytujesz stronę, klikasz linki, które chcesz pobrać, a Octoparse resztę robi sam.
- Świetny dla początkujących: bez kodowania. Po prostu kliknij, wyciągnij i gotowe.
- Obsługuje paginację i dynamiczne treści: Octoparse potrafi klikać przyciski „Next”, przewijać stronę, a nawet logować się do witryn.
- Scraping w chmurze i harmonogramy: płatne plany pozwalają uruchamiać zadania w chmurze i planować cykliczne uruchomienia.
- Opcje eksportu: pobieraj dane jako CSV, Excel, JSON albo wysyłaj je do baz danych.
Darmowy plan jest całkiem hojny przy mniejszych zadaniach (do 10 tasków i 50 000 wierszy miesięcznie), ale bardziej wymagający użytkownicy będą potrzebować płatnego planu (od ok. 69 USD miesięcznie).
Apify: elastyczny ekstraktor URL dla niestandardowych workflow
Apify to szwajcarski scyzoryk web scrapingu. Oferuje marketplace gotowych „actorów” (narzędzi do scrapingu), a także możliwość pisania własnych skryptów w JavaScript lub Pythonie.
- Gotowe i konfigurowalne: korzystaj z community actorów do popularnych zadań albo buduj własne pod niestandardowe procesy.
- Masowe i zaplanowane scrapowanie: dodawaj URL-e do kolejki, uruchamiaj zadania równolegle i ustawiaj cykliczne scrape’y.
- API-first: eksport do JSON, CSV, Excel lub Google Sheets i integracja z pipeline’em danych.
- Model pay-as-you-go: co miesiąc dostajesz darmowe kredyty, a potem płacisz za zużycie.
Apify to świetny wybór dla zespołów częściowo technicznych i developerów, którzy chcą elastyczności oraz skalowalności.
Bright Data URL Scraper: link scraping klasy enterprise
Bright Data zostało zbudowane dla firm, które potrzebują scrapować na dużą skalę. Ich Web Scraper API oferuje gotowe, wcześniej przygotowane scrapery do zadań o dużym wolumenie.
- Ogromna skala: scrapuj tysiące lub miliony stron, korzystając z solidnej infrastruktury proxy, która pomaga omijać blokady.
- Gotowe szablony: scrapery do e-commerce, social mediów, nieruchomości i wielu innych zastosowań.
- Funkcje enterprise: narzędzia zgodności, wsparcie ekspertów i zaawansowane mechanizmy antyblokujące.
- Cennik: darmowy plan (5 000 kredytów/mies.), potem 1,50 USD za 1k rekordów w modelu PAYG lub 499 USD/mies. za plan Scale — nadal poziom enterprise.
Jeśli prowadzisz startup, może to być przesada. Ale do krytycznego, wysoko wolumenowego scrapingu Bright Data jest prawdziwą potęgą.
WebHarvy: wizualny ekstraktor linków w prostym modelu point-and-click
WebHarvy to desktopowa aplikacja (Windows), która pozwala wyciągać linki po prostu klikając je w wbudowanej przeglądarce.
- Bardzo proste: kliknij link, a WebHarvy zaznaczy wszystkie podobne elementy do wyodrębnienia.
- Obsługa wyrażeń regularnych: wbudowane wzorce do typowych zadań, bez potrzeby kodowania.
- Eksport do Excel, CSV, JSON, XML, SQL: świetne rozwiązanie dla użytkowników biznesowych, którzy chcą danych w znanych formatach.
- Jednorazowa licencja: płacisz raz i używasz bezterminowo.
Idealne dla małych firm, badaczy i każdego, kto chce szybko, bez kombinowania, pobierać linki bez pisania kodu.
Web Scraper (rozszerzenie Chrome): szybkie scrapowanie linków w przeglądarce
Web Scraper Chrome Extension to darmowe, open-source’owe narzędzie, które zamienia przeglądarkę w scraper.
- Definiowanie sitemap: określasz, jak ma się poruszać i co ma wyodrębniać.
- Obsługa paginacji i wielopoziomowego crawlowania: przechodzi przez kategorie, podkategorie i strony szczegółów.
- Eksport do CSV/XLSX: pobierasz dane bezpośrednio z przeglądarki.
- Szablony od społeczności: dużo udostępnionych sitemap dla popularnych stron.
To świetna opcja do szybkich, jednorazowych zadań albo dla studentów i małych zespołów z ograniczonym budżetem.
ScraperAPI: skalowalny scraper linków dla developerów
ScraperAPI jest dla developerów, którzy chcą pobierać strony na dużą skalę bez martwienia się o proxy, blokady czy CAPTCHA.
- Oparte na API: wysyłasz URL i otrzymujesz HTML albo zeskrobane dane.
- Skala i ochrona antybotowa: rotacja proxy, renderowanie JS i rozwiązywanie CAPTCHA wbudowane w usługę.
- Integracja z kodem: używaj z Pythonem, Node.js lub dowolnym innym językiem.
- Cennik: darmowy trial (ok. 5 000 kredytów API), potem płatność za każde wywołanie.
Świetne do własnych crawlerów albo wtedy, gdy potrzebujesz niezawodności i szybkości w dużej skali.
ParseHub: wizualny scraper linków z zaawansowanym wyborem elementów
ParseHub to aplikacja desktopowa (Windows, Mac, Linux), która pozwala budować projekty scrapingu wizualnie.
- Zaawansowany wybór i nawigacja: klikaj, zapętlaj i warunkowo wyodrębniaj linki — nawet z dynamicznych lub ukrytych elementów.
- Obsługa zagnieżdżonych stron: przechodź przez kategorie, potem strony szczegółów, a następnie pobieraj kolejne linki.
- Eksport do CSV, Excel, JSON: w płatnych planach dostępne są uruchomienia w chmurze i API.
- Darmowy plan: 5 projektów, do 200 stron na jedno uruchomienie.
ParseHub jest chętnie wybierany przez marketerów i badaczy, którzy chcą mocy bez kodowania.
Scrapy: ekstraktor linków w Pythonie dla developerów
Scrapy to złoty standard dla developerów Pythona, którzy chcą pełnej kontroli.
- Najpierw kod: twórz własne spider-y do crawlowania i wyodrębniania linków w dowolnej skali.
- Obsługuje rozproszone crawlowanie: wydajne, asynchroniczne i bardzo elastyczne.
- Eksport do CSV, JSON, XML lub bazy danych: pełna kontrola nad wynikiem.
- Open-source i darmowe: ale musisz samodzielnie zarządzać środowiskiem.
Jeśli dobrze czujesz się w Pythonie, Scrapy daje naprawdę ogromne możliwości.
Diffbot: ekstraktor linków zasilany AI do danych strukturalnych
Diffbot to „AI-owy mózg” web scrapingu. Analizuje strony i zwraca dane strukturalne — w tym linki — bez ręcznej konfiguracji.
- Automatyczne rozpoznawanie treści: podajesz URL, a dostajesz dane strukturalne (artykuły, produkty, linki itd.).
- Crawlbot i Knowledge Graph: skanuj całe witryny albo wyszukuj w ich ogromnym indeksie webowym.
- Oparte na API: integracja z narzędziami BI lub pipeline’em danych.
- Cennik enterprise: od ok. 299 USD/mies., ale płacisz za realną jakość.
Najlepsze dla firm, które chcą czystych, uporządkowanych danych bez zarządzania scraperami.
Cheerio: lekki ekstraktor linków dla Node.js
Cheerio to szybki parser HTML przypominający jQuery dla Node.js.
- Bardzo szybki: analizuje HTML w milisekundach.
- Znana składnia: jeśli znasz jQuery, Cheerio będzie intuicyjne.
- Świetne do statycznych stron: nie renderuje JS, ale świetnie sprawdza się przy treściach generowanych po stronie serwera.
- Open-source i darmowe: do zapytań możesz połączyć je z axios albo fetch.
Idealne dla developerów tworzących własne skrypty, którym zależy na szybkości i prostocie.
Puppeteer: automatyzacja przeglądarki do zaawansowanego scrapowania linków
Puppeteer to biblioteka Node.js do sterowania Chrome w trybie headless.
- Pełna automatyzacja przeglądarki: wczytuj strony, klikaj, przewijaj i wchodź w interakcje jak prawdziwy użytkownik.
- Obsługa dynamicznych treści i logowania: idealne do stron z ciężkim JavaScriptem lub złożonych procesów.
- Precyzyjna kontrola: czekanie na elementy, zrzuty ekranu, przechwytywanie żądań sieciowych.
- Open-source i darmowe: ale bardziej zasobożerne i wolniejsze niż lekkie narzędzia.
Używaj Puppeteer, gdy musisz wyciągać linki ze stron, które nie współpracują z prostymi scraperami.
Porównanie w skrócie: który ekstraktor linków pasuje do Twoich potrzeb?
Oto szybkie zestawienie wszystkich 12 narzędzi:
| Narzędzie | Najlepsze dla | Obsługa masowa i podstron | Opcje eksportu danych | Cena |
|---|---|---|---|---|
| Thunderbit | Osoby nietechniczne, biznes | Tak (AI, wielopoziomowo) | Excel, CSV, Sheets, Notion, Airtable | Darmowy trial, od ok. 9 USD/mies. |
| Octoparse | Użytkownicy no-code, analitycy | Tak | CSV, Excel, JSON, cloud storage | Darmowy plan, ok. 69 USD/mies. |
| Apify | Półtechniczni, developerzy | Tak | CSV, JSON, Sheets przez API | Darmowe kredyty, model usage-based |
| Bright Data | Enterprise | Tak (duży wolumen) | CSV, JSON, NDJSON przez API | Darmowy plan, potem 1,50 USD/1k rekordów |
| WebHarvy | Osoby nietechniczne, desktop | Tak | Excel, CSV, JSON, XML, SQL | Płatna licencja |
| Web Scraper Extension | Każdy, szybko/darmowo | Tak | CSV, XLSX | Darmowe, open-source |
| ScraperAPI | Developerzy, użytkownicy API | Tak | JSON (HTML przez API) | Darmowe 5k kredytów trial, płatne plany |
| ParseHub | Osoby nietechniczne, zaawansowani | Tak | CSV, Excel, JSON, API | Darmowy plan: 5 projektów, potem płatny |
| Scrapy | Developerzy, Python | Tak | CSV, JSON, XML, DB | Darmowe, open-source |
| Diffbot | Enterprise, AI | Tak (crawlowanie AI) | JSON (dane strukturalne przez API) | ok. 299 USD/mies.+ |
| Cheerio | Developerzy, Node.js | Tak (kod własny) | Własne (JSON itd.) | Darmowe, open-source |
| Puppeteer | Developerzy, złożone strony | Tak (pełna automatyzacja) | Własne (wynik ze skryptu) | Darmowe, open-source |
Jak wybrać odpowiedni scraper linków dla Twojej firmy
No i jak wybrać właściwe narzędzie? Oto moja ściągawka:
- Nie umiesz programować? Zacznij od Thunderbit, Octoparse, ParseHub, WebHarvy albo rozszerzenia Web Scraper.
- Potrzebujesz niestandardowych workflow? Apify, ScraperAPI albo Cheerio świetnie sprawdzą się u developerów.
- Skala enterprise? Bright Data albo Diffbot są stworzone właśnie do tego.
- Developer Pythona lub Node.js? Scrapy (Python) albo Cheerio/Puppeteer (Node.js) dają pełną kontrolę.
- Chcesz eksportować dane bezpośrednio do Sheets/Notion? Thunderbit będzie najlepszym wyborem.
Dobierz narzędzie do swoich umiejętności technicznych, wolumenu danych i potrzeb integracyjnych. Większość oferuje darmowe wersje próbne, więc nie bój się testować.
Odkryj więcej poradników o web scrapingu Get Started Free
Unikalna wartość Thunderbit w wyodrębnianiu linków w 2026 roku
Wróćmy do tego, co naprawdę wyróżnia Thunderbit:
- Prostota dzięki AI: opisz po ludzku, czego chcesz — resztę zrobi AI Thunderbit.
- Scraping wielopoziomowy: wyciągaj linki z głównych stron, przechodź do podstron i pobieraj kolejne URL-e — wszystko w jednym procesie.
- Import masowy i przetwarzanie wsadowe: wklej setki URL-i, wyodrębniaj linki hurtowo i eksportuj uporządkowane dane od razu.
- Integracja z workflow: eksportuj bezpośrednio do Google Sheets, Notion, Airtable albo pobieraj jako CSV/Excel.
- Zero utrzymania: AI Thunderbit dostosowuje się do zmian na stronie, więc nie musisz ciągle naprawiać zepsutych scraperów.
Thunderbit łączy świat „po prostu scrapowania danych” ze światem „danych, które naprawdę da się wykorzystać”. To narzędzie, które chciałbym mieć lata temu, gdy tonąłem w ręcznych zadaniach związanych z danymi.
Zacznij darmowe wyodrębnianie linków z Thunderbit
Podsumowanie: sprytniejsze scrapowanie linków i lepszy workflow
Dane z sieci to paliwo dla wzrostu biznesu — a odpowiedni ekstraktor linków jest Twoim silnikiem. Niezależnie od tego, czy budujesz listy leadów, monitorujesz konkurencję, czy automatyzujesz research, znajdziesz tu narzędzie dopasowane do swoich potrzeb i poziomu technicznego.
Jeśli chcesz zobaczyć, jak wygląda nowoczesne wyodrębnianie linków, wypróbuj darmowy plan Thunderbit. Myślę, że zaskoczy Cię, ile można osiągnąć w zaledwie kilka kliknięć. A jeśli Thunderbit nie okaże się idealnym wyborem, przetestuj kilka innych narzędzi z tej listy — nigdy nie było lepszego momentu, by zautomatyzować nudne zadania i skupić się na tym, co naprawdę ważne.
Udanych scrapów — i oby Twoje linki zawsze były czyste, uporządkowane i gotowe do działania. Jeśli chcesz zagłębić się bardziej w web scraping, zajrzyj na Thunderbit Blog, gdzie znajdziesz więcej poradników i wskazówek.
Wypróbuj Thunderbit Link Extractor za darmo Get Started Free
FAQ
1. Dlaczego ekstraktory linków są niezbędne?
Przy tym, że prawie połowa ruchu w internecie pochodzi od botów, a firmy agresywnie zbierają dane, ekstraktory linków są kluczowe do zamieniania internetowego chaosu w konkretne wnioski. Pomagają automatyzować zadania takie jak generowanie leadów, agregacja treści, audyty SEO i monitorowanie konkurencji, oszczędzając ogromne ilości czasu i wysiłku.
2. Co wyróżnia Thunderbit na tle innych ekstraktorów linków?
Thunderbit wykorzystuje AI, by uprościć scraping — wystarczy opisać cel prostym językiem, a narzędzie zajmie się resztą. Obsługuje masowe wprowadzanie URL-i, wielopoziomowe scrapowanie, inteligentne wykrywanie pól i bezproblemowy eksport do platform takich jak Google Sheets czy Notion. To idealne rozwiązanie dla osób nietechnicznych i użytkowników biznesowych, którzy chcą mocnych rezultatów bez technicznych komplikacji.
3. Czy są narzędzia do wyodrębniania linków odpowiednie dla developerów i niestandardowych workflow?
Tak. Narzędzia takie jak Apify, ScraperAPI, Cheerio, Puppeteer i Scrapy są stworzone z myślą o developerach. Oferują skryptowanie, integracje API i elastyczność potrzebną do obsługi złożonych zadań scrapingowych, dużych wolumenów i zaawansowanej automatyzacji.
4. Które narzędzia są najlepsze dla osób bez doświadczenia w kodowaniu?
Thunderbit, Octoparse, ParseHub, WebHarvy i rozszerzenie Web Scraper Chrome to najlepsze opcje dla użytkowników nietechnicznych. Oferują wizualne interfejsy, gotowe szablony i funkcje oparte na AI, które sprawiają, że wyodrębnianie linków staje się dostępne dla każdego.
5. Jak wybrać odpowiedni ekstraktor linków do swoich potrzeb?
Weź pod uwagę swoje umiejętności techniczne, wolumen danych i potrzeby eksportu. Osoby nietechniczne powinny wybrać narzędzia takie jak Thunderbit lub Octoparse, a developerzy mogą preferować Scrapy albo Puppeteer. Firmy enterprise mogą spojrzeć na Bright Data lub Diffbot przy operacjach na dużą skalę. Zawsze zacznij od darmowej wersji próbnej, żeby sprawdzić, co najlepiej pasuje.




