
Jedna strona wyników Google Shopping potrafi ukrywać sponsorowane pozycje między wynikami organicznymi, usuwać ceny przy produktach niedostępnych w magazynie i pokazywać ten sam produkt u pięciu różnych sprzedawców. Przez ostatnie kilka tygodni rozkładałem na czynniki pierwsze dziewięć narzędzi, które twierdzą, że potrafią zamienić ten chaos w czyste, użyteczne dane — i uczciwa odpowiedź brzmi: „najlepsze” zależy wyłącznie od tego, czy jesteś deweloperem budującym pipeline, czy marketerem, który po prostu chce mieć liczby w arkuszu przed piątkiem.
Ten podział widać wszędzie w researchu. Na r/learnpython i r/node ludzie wymieniają się uwagami o Puppeteer, Playwright i rotacji proxy. Na r/PPC z kolei pytają o coś w stylu „dajcie mi po prostu dane, nie chcę dotykać kodu”. Dlatego zamiast ustawiać te dziewięć narzędzi alfabetycznie albo przyklejać plakietkę „najlepsze ogółem” temu dostawcy, który ma najbardziej efektowną stronę główną, oceniłem każde z nich według sześciu konkretnych kryteriów i ułożyłem je według workflow — najpierw zarządzane API SERP, potem infrastruktura proxy i scraperów, następnie platforma actorów dla deweloperów, a na końcu narzędzie no-code do przeglądarki.
Co sprawia, że Google Shopping Scraper jest „najlepszy”? Nasze kryteria oceny
Słowo „najlepszy” w takich zestawieniach często znaczy wszystko i nic, więc tutaj wyjaśniam, co naprawdę oznacza. Wszystkie dziewięć narzędzi oceniłem według tych samych sześciu czynników, zamiast powtarzać to, co twierdzi marketing każdej firmy:
- Zakres danych — czy udokumentowany schemat rzeczywiście zwraca cenę, sprzedawcę, ocenę, liczbę opinii, wysyłkę i wyraźnie rozróżnia wyniki sponsorowane od organicznych?
- Obsługa lokalizacji / geo — czy można realnie wskazać kraj, język lub urządzenie, czy jesteś skazany na to, jak akurat rozwiąże się IP proxy?
- Złożoność konfiguracji — czy wystarczy klucz API i żądanie GET, czy potrzebne są zadania w kolejce z callbackami, workflow z dwoma krokami, czy może po prostu strona, którą klikasz?
- Koszt utrzymania — kto odpowiada, gdy Google zmieni strukturę HTML albo rzuci CAPTCHA: Ty czy dostawca?
- Ścieżka eksportu / integracji — zrzut JSON czy bezpośrednie połączenie z Sheets, Airtable albo hurtownią danych?
- Przejrzystość cen — czy dostawca publikuje realny koszt jednostkowy, który można obliczyć, czy trzeba „skontaktować się z działem sprzedaży”, żeby w ogóle dowiedzieć się, ile coś kosztuje?
Jednej rzeczy nie będę tu robić: nie będę wymyślać współczynników skuteczności, benchmarków szybkości ani procentów dokładności. Nikt z tej listy nie porównywał niezależnie swoich narzędzi z innymi, a obietnice typu „99,9% success” albo „błyskawicznie” to marketing, nie pomiar. Zamiast tego dostaniesz to, co rzeczywiście potwierdza dokumentacja każdego dostawcy — a to, jak się okazuje, i tak jest sporo.
Deweloperzy chcą kodu, marketerzy chcą zero kodu
Jeśli masz za sobą jakikolwiek kontakt z forami związanymi ze scrapingiem, to już wiesz, że ten podział istnieje — ale warto go nazwać wprost, bo to wyjaśnia kolejność tej listy. Deweloperzy budujący pipeline danych chcą klucza API, przewidywalnego JSON-a, jawnych parametrów lokalizacji i schematu, który da się zwalidować i znormalizować dalej w procesie. To oni pytają o rotację proxy i renderowanie w headless browserze.
Osoby z marketingu i PPC chcą czegoś bliższego „wskaż stronę, dostarcz arkusz”. Nie chcą utrzymywać skryptu Puppeteer, gdy Google po raz trzeci w tym kwartale zmieni układ Shopping (a to się wydarzy — Google zmienia markup Shopping na tyle często, że nawet dostawcy API publikują o tym changelogi).
Dlatego lista przechodzi od dostawców zarządzanego API SERP (SerpApi, Serper, SearchAPI, DataForSEO) — uporządkowany JSON, bez zabawy z proxy, ale nadal z wymaganym kodem — przez infrastrukturę proxy i scraperów (Bright Data, Oxylabs), która daje większą kontrolę kosztem większej konfiguracji, potem przez w pełni konfigurowalną platformę actorów dla deweloperów (Apify), aż do Thunderbit, no-code agentic browser tool dla osób, które naprawdę nie chcą pisać ani utrzymywać kodu do scrapowania.
9 najlepszych Google Shopping Scraperów w skrócie
| Narzędzie | Model zbierania danych | Złożoność konfiguracji | Obsługa lokalizacji | Najlepsze dla | Koszt utrzymania |
|---|---|---|---|---|---|
| SerpApi | Zarządzane API Shopping | Niska (klucz API) | Mocna (location, gl, hl, device) | Deweloperzy danych, narzędzia SEO | Po stronie dostawcy |
| Serper | Ogólne API SERP, Shopping jako jeden typ wyniku | Niska | Umiarkowana (udokumentowany kraj/język) | Deweloperzy wrażliwi na koszty | Po stronie dostawcy |
| SearchAPI | Zarządzane API Shopping + Product Offers | Niska–średnia (dla ofert dwa kroki) | Umiarkowana | Zespoły porównujące oferty / merchantów | Po stronie dostawcy |
| DataForSEO | Merchant API oparte na zadaniach | Średnia (kolejka/callback) | Mocna | Hurtowe / cykliczne pipeline’y | Po stronie dostawcy |
| Bright Data | Dataset + Scraper API + SERP API | Średnia (zależna od interfejsu) | Bardzo mocna | Zespoły danych w enterprise | Współdzielony |
| Oxylabs | Dwustopniowe wyszukiwanie + API szczegółów produktu | Średnia (łączenie tokenów) | Bardzo mocna | Zespoły danych w enterprise | Współdzielony |
| Scrapingdog | Dedykowany endpoint Shopping | Niska–średnia | Umiarkowana | Deweloperzy dbający o budżet | Po stronie dostawcy |
| Apify | Platforma actorów / dla deweloperów | Średnia–wysoka | Zależy od actor | Twórcy niestandardowych pipeline’ów | Zarządzany przez użytkownika |
| Thunderbit | Agentic no-code extraction w przeglądarce | Bardzo niska (One Click Extract) | Zależy od strony docelowej | Marketerzy / PPC, osoby bez kodu | Niski, zależny od strony |
(Przed podjęciem decyzji sprawdź aktualne ceny, limity kredytów i zakres obsługi lokalizacji w bieżącej dokumentacji każdego dostawcy — te rzeczy zmieniają się szybko, a kilku z tych vendorów już w 2026 wprowadziło breaking changes.)
1. SerpApi — Zarządzane, bogate w funkcje i jawnie świadome cache
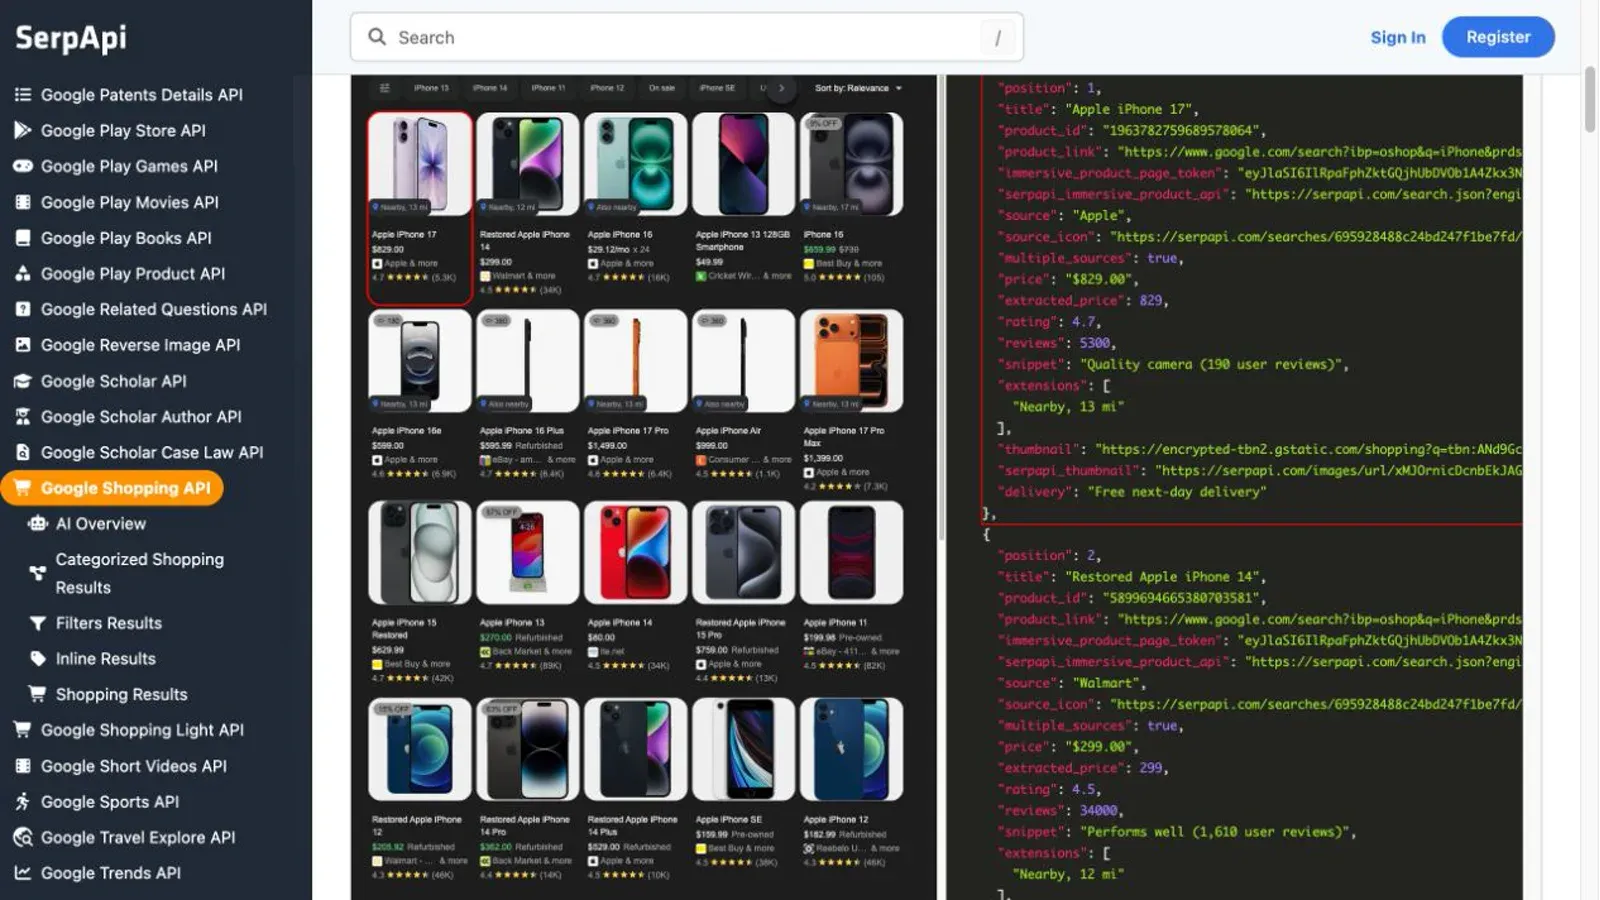
SerpApi ma dedykowany silnik Google Shopping (engine=google_shopping), który przyjmuje zapytanie i zwraca uporządkowane shopping_results — pozycję, tytuł, ID produktu, cenę wraz z wyciągniętą wartością liczbową, starą cenę / raty, dostawę, stan, ocenę, liczbę opinii i obrazy. To naprawdę mocny schemat, a SerpApi osobno dokumentuje sponsorowane wyniki Shopping przez schemat Google Ads Shopping, więc da się wykryć płatne pozycje — tylko nie jako pojedynczy, niezawodny flag sponsored: true/false wbudowany w odpowiedź dedykowanego Shopping.
To, co wyróżnia SerpApi, to przejrzystość w kwestiach, które zwykle wychodzą dopiero później. Targetowanie lokalizacji obsługuje kanoniczne location na poziomie miasta lub dokładne uule, a także osobne parametry gl (kraj), hl (język) i device (desktop, tablet, mobile). Dostawca wprost mówi też, że identyczne zapytania mogą trafiać do cache nawet do jednej godziny domyślnie — trafienia z cache są darmowe, a no_cache=true wymusza świeże pobranie. Tego typu jawność większość vendorów ukrywa albo pomija.
Cennik (sprawdzone 2026-08-13) jest publiczny i miesięczny: Free tier z 250 wyszukiwaniami, Starter za 25 USD za 1 000, aż do Big Data za 275 USD za 30 000. Do limitu wliczają się tylko udane wyszukiwania — odpowiedzi z cache i nieudane żądania nie obciążają konta. Warto wiedzieć: na początku 2026 Google pozwał SerpApi w związku z metodami dostępu do danych; SerpApi kwestionuje tę interpretację i twierdzi, że korzysta z publicznych, niewymagających logowania wyników. To realna sytuacja prawna, nie wyrok, więc traktuj ją jako czynnik ryzyka do obserwowania, a nie jako powód, by automatycznie odrzucić narzędzie.
Najlepszy dla: deweloperów, którzy chcą najbogatszego udokumentowanego schematu Shopping i najbardziej przejrzystej kontroli nad cache oraz lokalizacją.
2. Serper — Szybki, korzystny cenowo i z najczystszą deklaracją świeżości
Serper pozycjonuje się jako ogólne Google SERP API, w którym Shopping stoi obok Search, Images, News, Maps i kilku innych typów wyników. Jeśli już pobierasz zwykłe wyniki wyszukiwania i potrzebujesz tylko dołożyć dane Shopping, to jest to prostsze wdrożenie niż stawianie drugiego, wyspecjalizowanego dostawcy.
Publiczny przykład Shopping zwraca tytuł, źródło, bezpośredni link do sprzedawcy, sformatowaną cenę, dostawę, ocenę, liczbę ocen, liczbę ofert, ID produktu i pozycję — wystarczająco dobrze do podstawowego monitoringu kart produktowych, choć dokumentacja publiczna nie pokazuje tej samej głębi detali ofert sprzedawców ani pól cen promocyjnych, które opisują SearchAPI czy Oxylabs. Najmocniejszym argumentem Serper jest obietnica świeżości: firma twierdzi, że każde wywołanie pyta Google na żywo i nic nie jest cache’owane, co usuwa decyzję o cache, przed którą stają użytkownicy SerpApi (ale też oznacza płacenie za każde powtórzone zapytanie, niezależnie od tego, czy byłoby cache).
Cennik działa w modelu przedpłaconych pakietów kredytów zamiast subskrypcji — na start 2 500 darmowych zapytań, potem 50 USD za 50 000 kredytów, a na najwyższym progu 0,30 USD za 1 000, z kredytami ważnymi przez sześć miesięcy. Strona z cenami ujawnia też coś wyjątkowo uczciwego: pojedyncze żądania mogą trwać 2–4 sekundy „gdy trzeba ponowić próbę do Google”, co jest realnym ogonem opóźnień, który trzeba uwzględnić, a nie benchmarkiem do analizowania.
Najlepszy dla: zespołów, które już integrują szersze API SERP i chcą Shopping jako bonusu, a nie osobnego produktu.
3. SearchAPI — Mocne dane na poziomie ofert, ale z jednym haczykiem w dokumentacji
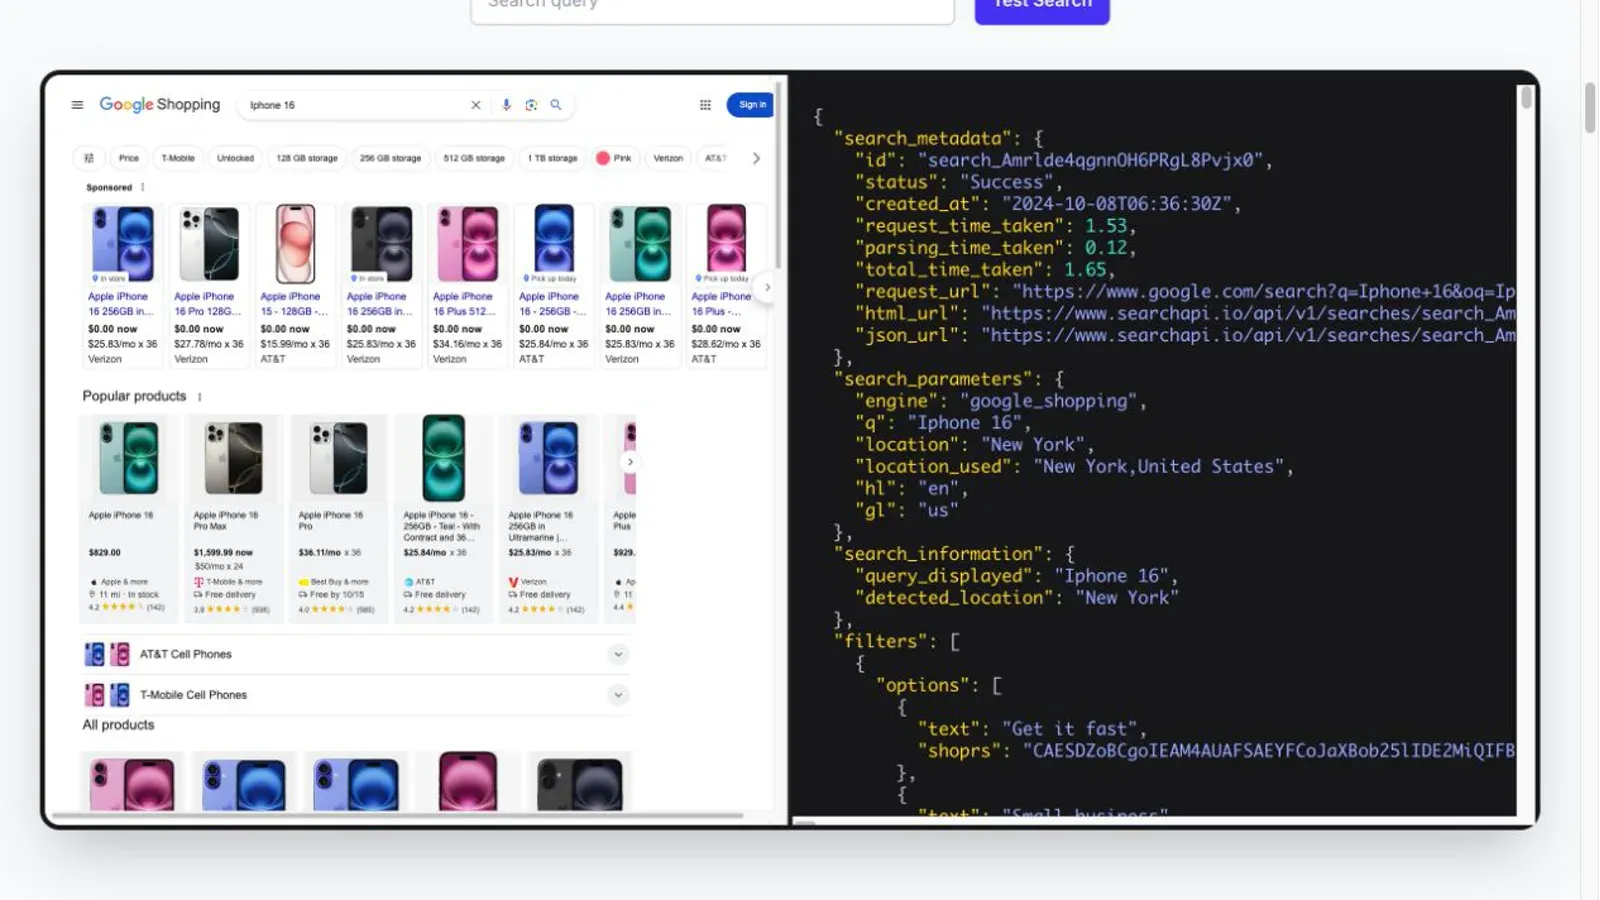
SearchAPI działa w dwustopniowym workflow, który jest naprawdę przydatny, jeśli potrzebujesz porównań cen na poziomie sprzedawców. Endpoint Shopping zwraca standardowe pola kart produktu oraz product_token — a ten token odblokowuje osobne Product Offers API, które zwraca tablicę offers z linkiem do sprzedawcy, ceną, kosztem dostawy, ceną całkowitą, statusem magazynowym i metodami płatności dla każdego sprzedawcy. Jeśli Twój przypadek użycia to „pokaż mi wszystkie ceny tego samego produktu u różnych sprzedawców”, to jest to najprostsza ścieżka z całej listy.
Jest tu jednak ważny problem, który trzeba zaznaczyć: od 15 maja 2026 zmiany po stronie Google wymusiły na SearchAPI świeży product_token dla każdego żądania — starsze parametry product_id/prds zwracają teraz prosty błąd 400. Jeśli integrujesz się na podstawie starszych przykładów kodu lub tutoriali, to bez ostrzeżenia przestanie działać.
SearchAPI jasno ostrzega również, że filtry w języku naturalnym w zapytaniu (takie jak „under $30” albo „used”) są wskazówkami, a nie twardymi filtrami — Google nadal może zwrócić wyniki spoza nich, jeśli dopasowań jest mało. Twardą drogą są zakodowane filtry shoprs. Jest też nierozwiązana sprzeczność w dokumentacji, o której warto wiedzieć: SearchAPI promuje endpoint jako „real-time”, ale w swoim data processing agreement pisze, że cache’uje wyniki dla wydajności. Publicznie nie ma też podanego TTL, więc jeśli zależy Ci na szybko zmieniających się cenach, przetestuj to wielokrotnymi zapytaniami, zanim zbudujesz pipeline oparty na założeniu świeżości.
Cennik (sprawdzone 2026-08-13) startuje od 40 USD miesięcznie za plan Developer przy stawce 4 USD za 1 000 wyszukiwań, a przy większych wolumenach koszt jednostkowy spada; udokumentowany jest też limit godzinowy równy 20% miesięcznych kredytów.
Najlepszy dla: zespołów robiących porównania na poziomie sprzedawców/ofert, które mogą zaakceptować dwudniowy workflow i samodzielnie przetestować świeżość danych.
4. DataForSEO — Dane Merchant i Shopping na dużą skalę, w kolejce
DataForSEO jest tu naprawdę nietypowe, bo nie działa jak API request/response na żywo — to kolejka oparta na zadaniach. Wysyłasz zadanie z keywordem, lokalizacją i językiem, dostajesz ID zadania i albo odpytyjesz o wynik, albo konfigurujesz URL callback. Standardowe pobieranie danych; dla głównych endpointów Shopping nie ma trybu live, niezależnie od tego, co sugeruje ogólny marketing.
Ma to znaczenie, bo zmienia sposób myślenia o złożoności konfiguracji. To nie jest trudne samo w sobie, ale jest to inny model mentalny niż „wywołuję API i dostaję JSON” — zarządzasz stanem zadania, a dokumentacja DataForSEO wprost mówi, że serwer callback, który nie odpowie w ciągu 10 sekund, przenosi zadanie do kolejki „Tasks Ready”, którą trzeba potem odpytywać ręcznie.
Miejsce na tej liście zdobywa dzięki researchowi hurtowemu: endpoint Products zwraca pozycję, domenę, tytuł, cenę, starą cenę, ocenę i liczbę głosów, z wyraźnymi identyfikatorami typu wyniku rozróżniającymi google_shopping_sponsored_carousel, google_shopping_paid i wyniki organiczne — to naprawdę jedno z najczytelniejszych rozróżnień sponsorowane / organiczne w całym zestawieniu. Dokumentacja wprost ostrzega też, że product_id jest dynamiczne i może mieć wartość null, a czynniki personalizacji rankingu (historia użytkownika, preferencje lokalizacji) są celowo wykluczone z wyników — to przydatna dawka szczerości, której większość vendorów nie podaje.
Rozliczenie odbywa się za blok wyników (40 dla Products, 10 dla Sellers/Reviews) przy zwykłej prędkości kolejki do 45 minut lub w kolejce priorytetowej do jednej minuty za podwójną cenę. Nowe konta dostają 1 USD kredytu testowego bez daty wygaśnięcia.
Najlepszy dla: zespołów, które dobrze czują się z workflow opartym na kolejce i zadaniach, a potrzebują hurtowych danych merchant/product według harmonogramu.
5. Bright Data — Trzy produkty pod jedną nazwą
Tutaj muszę zwolnić, bo Bright Data oferuje tak naprawdę trzy różne sposoby pobierania danych Google Shopping i działają one zupełnie inaczej. Jest gotowy dataset (reklamowany jako ponad 7,4 miliarda rekordów, dostarczany jako JSON/CSV/Parquet do chmury według harmonogramu), Google Scraper API z dedykowanymi identyfikatorami scraperów Shopping, działające synchronicznie lub asynchronicznie, oraz SERP API, które pobiera na żywo URL-e Shopping i parsuje wyniki w czasie rzeczywistym. Traktowanie tego jako jednego produktu to jeden z powodów, dla których wiele artykułów porównawczych jest niedokładnych — ja tego tutaj nie zrobię.
Przykładowe dane z datasetu pokazują wartości null dla product ID, opisu, oceny i liczby opinii w niektórych rekordach — to dobre, pierwszorzędne potwierdzenie, że „ustrukturyzowany dataset” nie znaczy „każde pole jest zawsze wypełnione”. Z kolei SERP API osobno dokumentuje Product Listing Ads jako własny typ wyniku (top_pla, bottom_pla, jackpot_pla) z tytułem, ceną, sklepem i rangą — naprawdę użyteczne rozróżnienie sponsorowane / organiczne, ale tylko wtedy, gdy pracujesz konkretnie z SERP API, a nie z datasetem.
Zadania asynchroniczne przez Scraper API mogą zakończyć się ogólnym statusem „success”, podczas gdy pojedyncze wejścia w paczce nie powiedzą się — dokumentacja wprost każe sprawdzać pole errors i ponawiać je osobno, co jest ważnym szczegółem utrzymaniowym, jeśli uruchamiasz duże wsady.
Cennik (sprawdzone 2026-08-13) bardzo się różni zależnie od produktu: dataset pokazywał 250 USD za 100 000 rekordów jednorazowych, SERP API miało 5 000 darmowych zapytań miesięcznie i model pay-as-you-go za 1,50 USD / 1 000, a dedykowane Shopping Scraper API miało osobno własny free tier i stawki. Nie zakładaj, że te liczby są zamienne — sprawdź konkretną stronę produktu, z której rzeczywiście korzystasz.
Najlepszy dla: zespołów enterprise, które chcą jednej platformy obejmującej zarówno przygotowane datasety, jak i dostęp do live API, i są gotowe osobno wyceniać każdy z tych powierzchniowych produktów.
6. Oxylabs — Najczytelniejszy dwustopniowy łańcuch: wyszukiwanie + szczegóły produktu
Oxylabs dzieli Shopping na dwa dedykowane cele: google_shopping_search dla wyników na poziomie listingu oraz google_shopping_product dla szczegółów per produkt, połączone tokenem produktu. Odpowiedź wyszukiwania jasno rozdziela pla (płatne listing ads) od produktów organic — prawdopodobnie najczytelniejsze, udokumentowane rozróżnienie sponsorowane / organiczne w całej tej liście — a endpoint produktu dodaje oferty per sprzedawca z ceną liczbową, stanem, podatkiem, ceną całkowitą i dostawą.
Jest jednak haczyk i to poważny: ten workflow z tokenem działa tylko wtedy, gdy żądanie wyszukiwania używa jednocześnie render: "html" i parse: true. Pomiń jedno z nich, a token produktu nie zostanie wygenerowany i cały krok ze szczegółami produktu się rozsypie. Oxylabs wyraźnie ostrzega też, że żądania wyszukiwania i produktu muszą używać identycznych wartości lokalizacji — jeśli rozjedzie się geo_location między obiema próbami, wyniki produktu mogą być niepełne albo błędne. A jeśli chcesz rozwinąć panel „More stores” dla dodatkowych ofert sprzedawców, musisz mieć włączony rendering, co zwiększa koszt.
Jeden szczegół łatwy do przeoczenia: FAQ cenowe Oxylabs definiuje „successful” (a więc rozliczane) żądania jako obejmujące zarówno odpowiedzi 2xx, jak i 4xx. Jeśli Twoje żądanie jest błędne, możesz mimo to zostać za nie obciążony.
Recenzje produktów są opisane jako dostępne wyłącznie dla lokalizacji US, a locale/language oraz locale/results-language to naprawdę dwa oddzielne przełączniki — ustawienie jednego nie ustawia automatycznie drugiego.
Najlepszy dla: zespołów technicznych, które potrzebują zarówno danych na poziomie rankingu, jak i ofert per sprzedawca, i które poradzą sobie z łańcuchowaniem tokenów oraz spójnością lokalizacji w ramach konfiguracji.
7. Scrapingdog — Prosty endpoint, mało publicznych szczegółów
Scrapingdog oferuje jeden, dedykowany endpoint Google Shopping, który przyjmuje klucz API i zapytanie, zwracając JSON z tytułem, ceną i wyciągniętą wartością liczbową, starą ceną, oceną, recenzjami, źródłem / sprzedawcą, dostawą i pozycją. Strona wspomina też o filtrowaniu po cenie, marce, kraju i języku, a także o osobnej kategorii odpowiedzi „ads” do śledzenia pozycji sponsorowanych — choć dokładny schemat ads i dokładne nazwy parametrów dla filtrowania lokalizacji nie są w publicznej dokumentacji w pełni opisane, więc zostaw sobie czas na testy pod własny przypadek użycia, zanim zbudujesz wokół tego automatyzację.
To jedyny wpis na tej liście, w którym matematyka kosztu kredytowego nie składa się na podstawie samej dokumentacji publicznej: strona cenowa Scrapingdog pokazuje miesięczne pakiety kredytów (LITE za 40 USD / miesiąc za 200 000 kredytów, STANDARD za 90 USD / miesiąc za 1 000 000), ale nie mówi jasno, ile kredytów kosztuje pojedyncze zapytanie Google Shopping. Nie zakładaj, że to relacja 1:1 z przykładami ich ogólnego API wyszukiwania — potwierdź to bezpośrednio u vendora, zanim policzysz realny koszt za zapytanie.
Jak większość dostawców z tej listy, Scrapingdog reklamuje wbudowane rotujące residential proxies i automatyczne obchodzenie CAPTCHA jako obsługiwane po stronie dostawcy. Traktuj to jako informację o granicy odpowiedzialności za utrzymanie, a nie jako dowód gwarantowanego dostępu.
Najlepszy dla: deweloperów z ograniczonym budżetem, którzy chcą wąskiego, dedykowanego endpointu i są gotowi samodzielnie zweryfikować koszt kredytów przed decyzją.
8. Apify — Oceniaj actor, nie marketplace
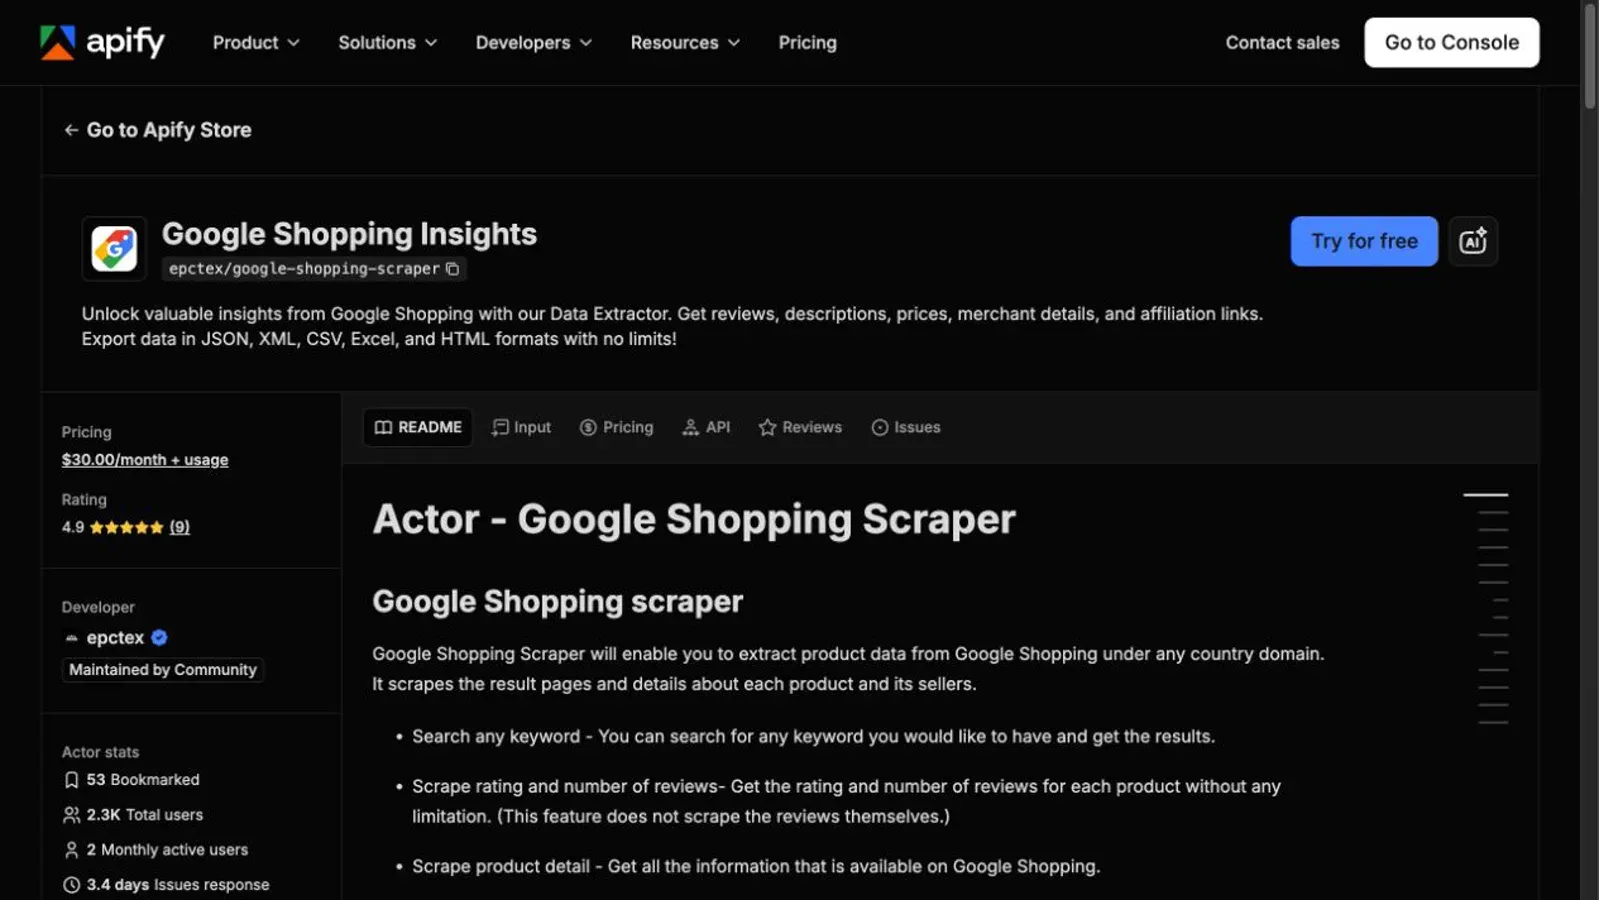
Muszę powiedzieć to wprost: Apify nie jest jednym scraperem Google Shopping — to marketplace niezależnie utrzymywanych „Actorów”, a ten, któremu przyjrzałem się bliżej (Google Shopping Insights, opublikowany przez dewelopera epctex i oznaczony jako „Maintained by Community”), działa zupełnie inaczej niż narzędzia zarządzane przez vendorów powyżej. Apify dostarcza runtime, infrastrukturę proxy i narzędzia dataset/export. Sama logika ekstrakcji Shopping — i jej utrzymanie — należy do epctex, a nie do Apify jako takiego.
To ważne, bo oficjalny przykład outputu tego konkretnego Actora ma pole price ustawione na null. Nie „czasami”, nie „dla produktów niedostępnych” — sam udokumentowany rekord pokazuje price: null i withoutDiscountPrice: null obok wypełnionych pól nazwy produktu, merchant i ratingu. To chyba najmocniejszy dowód pierwszorzędny w całym zestawieniu, że nie można zakładać pełności danych cenowych, i pochodzi wprost z dokumentacji narzędzia.
Dostajesz konfigurowalne wejścia — includeSponsoredResults, includeComparisonPrices dla cen między sprzedawcami, kraj docelowy, maxItemsPerQuery — oraz wymaganą konfigurację proxy (własną albo Apify). Wyniki eksportują się jako JSON, XML, CSV lub Excel przez system Dataset Apify. Listing w Store, który sprawdzałem, pokazywał około 2 300 użytkowników łącznie, ale tylko 2 aktywnych użytkowników miesięcznie w momencie sprawdzenia — to warte odnotowania, bo „maintained by community” działa w dwie strony: elastyczne, ale tak niezawodne, jak osoby, które faktycznie z niego korzystają i zgłaszają problemy.
Najlepszy dla: deweloperów, którzy potrafią ocenić aktywność utrzymaniową konkretnego Actora i przejrzeć jego rzeczywisty schemat wyjścia przed decyzją — nie dla osób, które oczekują, że marka Apify zagwarantuje spójne działanie.
9. Thunderbit — No-code collection dla marketerów
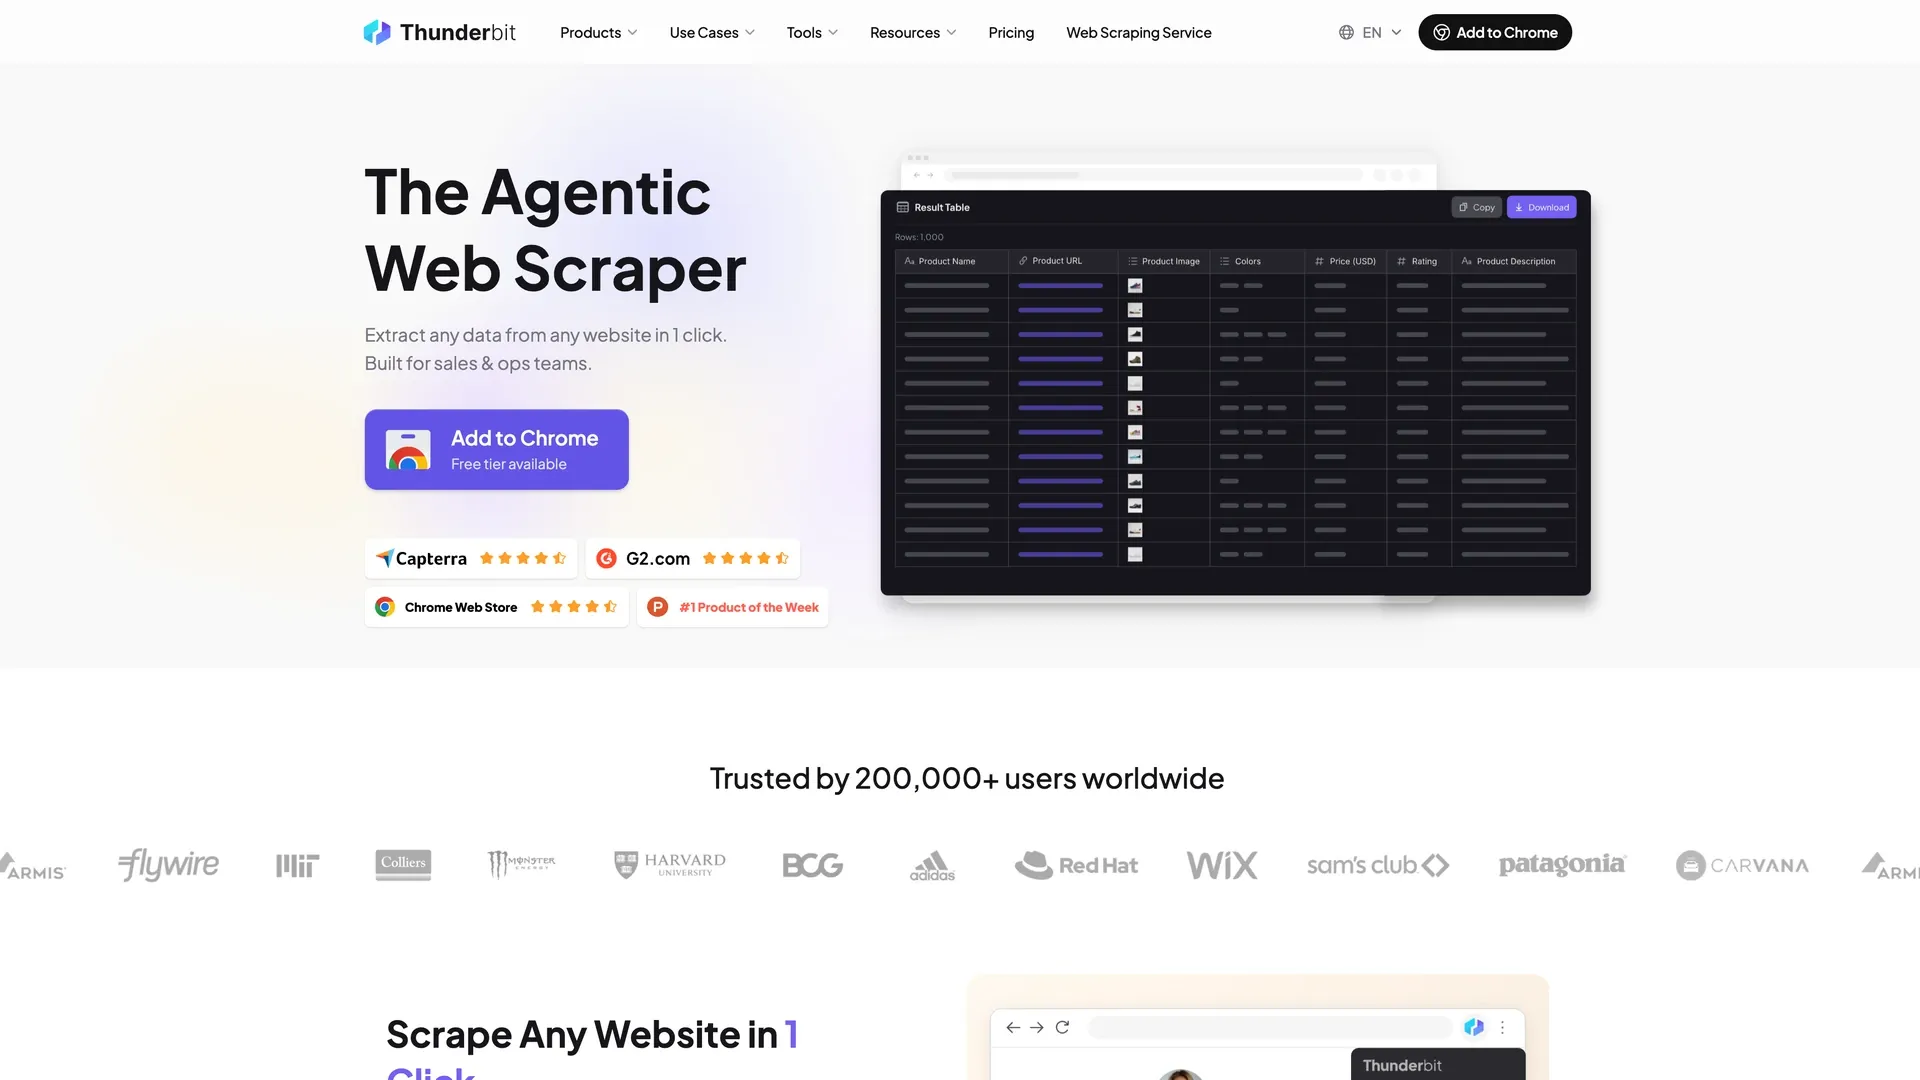
Thunderbit reprezentuje drugi biegun tej listy: workflow browser-based, no-code dla osób, które chcą przejrzeć widoczną stronę i zamienić ją w uporządkowaną tabelę, zamiast integrować Google Shopping API. To naturalnie pasuje do marketerów, osób pracujących z PPC i małych zespołów ecommerce, które robią ad hoc kontrole zamiast wysokowolumenowego backendowego pipeline’u.
Dostajesz ekstrakcję po stronie przeglądarki: otwierasz stronę wyników Shopping, która Cię interesuje, pozwalasz Thunderbit odczytać renderowaną stronę jednym kliknięciem i eksportujesz pola prosto do Excel, Google Sheets, Airtable albo Notion. Jest tu realne zastrzeżenie, ale dotyczy ono Shopping jako kategorii, a nie jednego narzędzia — ponieważ ekstrakcja działa na stronie widocznej przed Tobą, wynik dziedziczy lokalizację, język i sesję tej przeglądarki. Zablokuj te ustawienia, zanim uznasz, że dzisiejszy eksport jest porównywalny z zeszłotygodniowym. To ten sam problem wiarygodności pól, który omawia następna sekcja, i dotyczy każdej opcji na tej liście.
Najlepszy dla: zespołów nietechnicznych, które cenią widoczną, sprawdzaną ekstrakcję w przeglądarce bardziej niż zarządzany przez dewelopera pipeline JSON — i które pobierają konkretne strony Shopping na żądanie, zamiast prowadzić masowy crawl wielu lokalizacji.
Jakim danym naprawdę można ufać? Problem wiarygodności pól

To część, którą większość artykułów porównujących Google Shopping pomija całkowicie, a jednocześnie najważniejsza rzecz do zrozumienia przed automatyzacją czegokolwiek: nie każde pole pojawia się przy każdym wyniku, a traktowanie „braku” jako „zera” po cichu zepsuje Twoje dane.
| Pole | Niezawodność | Haczyk |
|---|---|---|
| Tytuł | Wysoka | Znormalizuj warianty / zestawy, zanim będziesz dopasowywać produkty między źródłami |
| ID produktu | Warunkowa | DataForSEO wprost dokumentuje, że jest dynamiczne i czasem ma wartość null |
| Cena | Warunkowa | W oficjalnym przykładzie Apify pole ceny ma null mimo w pełni wypełnionego rekordu |
| Sprzedawca / merchant | Zazwyczaj obecne | Wielu sprzedawców oznacza, że jeden produkt może mieć kilka oddzielnych ofert |
| Ocena / liczba opinii | Warunkowa | Nowe lub nieocenione produkty mogą tego po prostu nie mieć — nie zamieniaj tego na zero |
| Dostawa / wysyłka | Niespójna | Może zależeć od miejsca docelowego, stanu magazynowego sprzedawcy i sesji |
| Flaga sponsorowane | Zależna od narzędzia | Oxylabs wyraźnie rozdziela pla od organic; kilka innych narzędzi pozwala dołączać/wykluczać sponsorowane wyniki bez nadawania wiarygodnej etykiety w każdym wierszu |
Praktyczna zasada brzmi: zanim zautomatyzujesz jakikolwiek workflow, pobierz rzeczywistą próbkę z własnymi słowami kluczowymi i sprawdź, co faktycznie jest null, zduplikowane albo brakujące — nie to, co według dokumentacji „powinno” tam być.
Oficjalne Google Merchant Center vs. Google Shopping Scraper: czego potrzebujesz?
To pytanie zadają zespoły ecommerce jeszcze zanim zaczną porównywać dostawców, i warto odpowiedzieć wprost: jeśli zarządzasz własnymi listami produktów, cenami albo reklamami Shopping, to zadanie dla oficjalnych narzędzi Google Merchant Center — nie dla zewnętrznego scrapera. Narzędzia z tej listy służą do obserwowania cudzych ofert: cen konkurencji, widoczności rynkowej, researchu kategorii, monitorowania pozycji sponsorowanych. Nie mieszaj tych rzeczy. Zajrzyj bezpośrednio do aktualnej oficjalnej dokumentacji Google, żeby sprawdzić bieżącą nazwę i zakres ich pierwszoplanowego API, bo te rozwiązania bywają okresowo zmieniane i restrukturyzowane.
Jak te narzędzia radzą sobie z obroną Google przed botami
Ujmę to jako kwestię zarządzania i odpowiedzialności, a nie jako poradnik „jak pokonać Google”, bo tylko tak można o tym uczciwie myśleć. Kilku dostawców z tej listy — SerpApi, SearchAPI, Bright Data, Oxylabs, Scrapingdog — publicznie deklaruje, że po ich stronie odbywa się rotacja proxy, renderowanie w przeglądarce i obsługa CAPTCHA. To realna granica odpowiedzialności za utrzymanie: nie Ty będziesz debugować zablokowany adres IP o 2:00 w nocy. Nie jest to jednak i nigdy nie powinno być odczytywane jako gwarancja stałego lub powszechnego dostępu.
Co nie znika nawet przy w pełni zarządzanym dostawcy: limity tempa i wydatków, klasyfikacja błędów, ponawianie prób oraz monitoring zmian po stronie Google (a z changelogów SearchAPI i Oxylabs, które znalazłem, wynika, że dzieje się to dość regularnie). Bright Data dokumentuje częściowe błędy paczek wprost; DataForSEO dokumentuje zachowanie przy timeoutach callbacków; Oxylabs dokumentuje błędy nieprawidłowego tokena. Żadne z tego nie jest instrukcją obejścia czegokolwiek — to uczciwy opis tego, kto odpowiada za który typ awarii.
Jak wybrać najlepszy Google Shopping Scraper dla swojego zespołu
Przejdź przez to po kolei:
- Określ swoją personę. Budujesz pipeline jako deweloper czy jesteś marketerem / osobą opsową, która chce wyników bez dotykania kodu?
- Zdefiniuj rzeczywiście potrzebne pola. Dane na poziomie rankingu to coś innego niż szczegóły cenowe na poziomie merchant / offer — SearchAPI i Oxylabs zasłużyły na miejsce właśnie za to drugie.
- Bądź szczery co do możliwości utrzymania. Mapowanie API i obsługa błędów, konfiguracja Actora i proxy albo ekstrakcja ze sprawdzanej strony w przeglądarce — wybierz to, co Twój zespół realnie będzie w stanie utrzymać długoterminowo.
- Przetestuj zachowanie lokalizacji i urządzenia na realnych zapytaniach zanim przywiążesz się do dostawcy, bo dokumentacja publiczna nie zawsze idealnie zgadza się z działaniem na żywo.
- Zweryfikuj ścieżkę eksportu, czy pasuje do Twojego stacku — zrzut JSON do hurtowni danych to zupełnie inny poziom pracy niż arkusz, który marketer może otworzyć od razu.
Wnioski: z którego Google Shopping Scrapera powinieneś korzystać?
Nie ma jednego „najlepszego” i jeśli jakiś artykuł listowy twierdzi inaczej, podchodź do tego z rezerwą. Jeśli jesteś deweloperem budującym pipeline danych i chcesz najbogatszego dokumentowanego schematu z jawną kontrolą cache i lokalizacji, zacznij od SerpApi. Jeśli Twoim realnym celem jest porównywanie cen na poziomie ofert i sprzedawców, SearchAPI albo tokenowy workflow Oxylabs prowadzi tam najbardziej bezpośrednio. Jeśli prowadzisz hurtowy, cykliczny research i nie przeszkadza Ci kolejka zadań, DataForSEO dobrze się skaluje. Jeśli chcesz jedną platformę enterprise obejmującą zarówno gotowe datasety, jak i live query, Bright Data obejmuje najszerszy zakres — tylko wyceń osobno każdy wariant.
A jeśli pracujesz w zespole PPC lub marketingu i nie chcesz dotykać klucza API, browser-based kategoria reprezentowana przez Thunderbit jest bezpośrednią odpowiedzią na „potrzebuję tylko danych, nie projektu programistycznego”. Trzeba tylko jasno wiedzieć, którą ścieżkę wybierasz: workflow w przeglądarce jest zbudowany dla stron, które otwierasz i sam sprawdzasz, podczas gdy dokumentacja API Thunderbit i CLI to osobne, deweloperskie ścieżki. Wybierz tę, która naprawdę pasuje do sposobu pracy Twojego zespołu.
Niezależnie od wyboru, najpierw pobierz prawdziwą próbkę. Każdy dostawca z tej listy dokumentuje przynajmniej jedno pole, którego nie ma zawsze — sprawdź to, zanim zbudujesz cokolwiek na tej podstawie.
FAQ
Czy scrapowanie danych Google Shopping jest legalne? Nie mogę odpowiedzieć na to kategorycznie — i nie powinien tego robić też żaden artykuł listowy. Publicznie widoczne dane i deklaracje zgodności dostawcy nie sprawiają automatycznie, że każde użycie jest legalne. Zanim zbudujesz cokolwiek, sprawdź aktualne warunki korzystania z Google, przeanalizuj obowiązujące przepisy w swojej jurysdykcji i upewnij się, że metoda zbierania danych jest dozwolona. Traktuj to jako sytuację typu „sprawdź u swojego prawnika”, a nie coś, co może rozstrzygnąć wpis na blogu.
Jaka jest różnica między SERP API a Google Shopping scraperem? SERP lub Shopping API przyjmuje ustrukturyzowane parametry żądania i zwraca przeparsowany JSON — dostawca odpowiada za większość infrastruktury pobierania danych. Browser-based scraper (np. Thunderbit) wyciąga dane ze strony, którą Ty lub użytkownik faktycznie ma otwartą. Produkty typu dataset (jak część oferty Bright Data) dostarczają wcześniej zebrane rekordy według harmonogramu, zamiast wykonywać live requesty. Cel mają podobny, ale różnią się mocno świeżością danych, kontrolą lokalizacji i tym, ile tak naprawdę musisz utrzymywać.
Czy potrzebuję umiejętności programowania, żeby scrapować Google Shopping? Nie zawsze. Cały pomysł Thunderbit opiera się właśnie na no-code, workflow opartym na kliknięciach. Apify da się technicznie uruchomić przez web UI bez pisania kodu, choć sensowne dostosowanie działania wymaga już większego komfortu technicznego. Każde narzędzie API-based z tej listy — SerpApi, Serper, SearchAPI, DataForSEO, Bright Data, Oxylabs, Scrapingdog — wymaga przynajmniej podstawowych umiejętności deweloperskich: autoryzacji, obsługi parametrów i sprawdzania błędów.
Jak często zmieniają się dane Google Shopping? Częściej, niż wielu osobom się wydaje, ale nie ma żadnej uniwersalnej zasady „aktualizuje się co X godzin”, na której można polegać. Ceny, stany magazynowe, pozycje sponsorowane i rankingi mogą się zmieniać w zależności od sesji, lokalizacji i pory dnia. Kilku vendorów z tej listy oferuje tryby live / real-time właśnie dlatego, że cache’owane dane szybko się starzeją w tej kategorii. Jeśli Twoje decyzje zależą od aktualnych cen, uruchom zapytanie ponownie zamiast ufać wynikowi sprzed wczoraj.
Dowiedz się więcej




