
Martwe linki. Osierocone podstrony. Strona „testowa” z 2019 roku, którą Google jakoś zindeksował. Jeśli zarządzasz witryną, to ten ból na pewno dobrze znasz.
Dobry crawler stron internetowych wyłapie to wszystko — i zmapuje całą stronę, żebyś mógł faktycznie coś z tym zrobić. Ale wiele osób myli „web crawler” z „web scraperem”. To nie jest to samo.
Przetestowałem 10 darmowych crawlerów na prawdziwych serwisach. Niektóre świetnie nadają się do audytów SEO. Inne lepiej sprawdzają się przy pozyskiwaniu danych. Oto, co zadziałało — i co nie.
Czym jest crawler stron internetowych? Podstawy bez żargonu
Najpierw rozwiejmy wątpliwości: crawler stron internetowych to nie to samo co web scraper. Wiem, te terminy latają wszędzie jak ciasto na pizzę, ale w praktyce oznaczają coś zupełnie innego. Crawler możesz potraktować jak kartografa Twojej witryny — zagląda w każdy zakamarek, podąża za każdym linkiem i buduje mapę wszystkich podstron. Jego zadanie to odkrywanie: znajdowanie URL-i, mapowanie struktury witryny i indeksowanie treści. Tak działają boty wyszukiwarek, takich jak Google, i tak też korzystają z crawlerów narzędzia SEO, żeby oceniać kondycję serwisu (Thunderbit Blog: What Is a Web Crawler?).
Z kolei web scraper to taki „łowca danych”. Nie interesuje go cała mapa — on chce wyciągnąć konkretny skarb: ceny produktów, nazwy firm, opinie, adresy e-mail, cokolwiek potrzebujesz. Scraper pobiera określone pola z podstron, które crawler wcześniej znajdzie (Thunderbit Blog: How to Web Crawl a Site?).
Porównanie w praktyce:
- Crawler: osoba, która przechodzi wszystkie alejki w sklepie spożywczym i spisuje cały asortyment.
- Scraper: osoba, która idzie prosto do półki z kawą i zapisuje ceny każdej ekologicznej mieszanki.
Dlaczego to ważne? Bo jeśli chcesz po prostu znaleźć wszystkie podstrony na swojej witrynie (np. do audytu SEO), potrzebujesz crawlera. Jeśli chcesz pobrać wszystkie ceny produktów ze strony konkurencji, potrzebujesz scrapera — albo najlepiej narzędzia, które robi jedno i drugie.
Po co korzystać z internetowego crawlera? Najważniejsze korzyści biznesowe
Po co w ogóle zawracać sobie głowę crawlerem? Internet przecież sam się nie zmniejsza. W praktyce ponad 54% marek enterprise korzysta z dedykowanych platform crawlingowych do optymalizacji swoich serwisów, a niektóre narzędzia SEO crawlują nawet 7 miliardów stron dziennie.
Oto, co crawler może dla Ciebie zrobić:
- Audyt SEO: znajdowanie uszkodzonych linków, brakujących tytułów, duplikatów treści, osieroconych stron i wielu innych problemów (SEO.ai).
- Sprawdzanie linków i QA: wychwytywanie błędów 404 i pętli przekierowań, zanim zauważą je użytkownicy (Screaming Frog).
- Generowanie mapy witryny: automatyczne tworzenie map XML dla wyszukiwarek i planowania (PowerMapper).
- Inwentaryzacja treści: lista wszystkich stron, ich hierarchii i metadanych.
- Zgodność i dostępność: sprawdzanie każdej strony pod kątem WCAG, SEO i wymogów prawnych (SiteOne Crawler).
- Wydajność i bezpieczeństwo: wykrywanie wolnych stron, zbyt dużych grafik lub problemów bezpieczeństwa (SiteOne Crawler).
- Dane dla AI i analiz: przekazywanie zebranych danych do narzędzi analitycznych lub AI (Thunderbit Blog: Crawl4AI Review).
Oto szybka tabela pokazująca powiązanie zastosowań z rolami biznesowymi:
| Przykład użycia | Dla kogo | Korzyść / efekt |
|---|---|---|
| Audyt SEO i witryny | Marketing, SEO, właściciele małych firm | Wykrywanie problemów technicznych, optymalizacja struktury, lepsze pozycje |
| Inwentaryzacja treści i QA | Content managerowie, webmasterzy | Audyt lub migracja treści, wykrywanie uszkodzonych linków i obrazów |
| Generowanie leadów (scraping) | Sprzedaż, rozwój biznesu | Automatyzacja prospectingu, uzupełnianie CRM świeżymi leadami |
| Analiza konkurencji | E-commerce, product managerowie | Monitorowanie cen konkurencji, nowych produktów i stanów magazynowych |
| Klonowanie mapy i struktury witryny | Programiści, DevOps, konsultanci | Odtworzenie struktury serwisu na potrzeby redesignu lub backupu |
| Agregacja treści | Badacze, media, analitycy | Zbieranie danych z wielu stron do analizy lub monitorowania trendów |
| Badania rynku | Analitycy, zespoły AI | Gromadzenie dużych zbiorów danych do analiz lub trenowania modeli AI |
(Thunderbit Blog: How to Web Crawl a Site?)
Jak wybraliśmy najlepsze darmowe narzędzia do crawlowania stron
Spędziłem sporo późnych wieczorów — i wypiłem więcej kawy, niż chciałbym przyznać — analizując narzędzia crawlingowe, czytając dokumentację i uruchamiając testowe crawl’e. Na co zwracałem uwagę:
- Możliwości techniczne: czy radzi sobie z nowoczesnymi stronami (JavaScript, logowanie, dynamiczna treść)?
- Łatwość obsługi: czy jest przyjazne dla nietechnicznych użytkowników, czy wymaga magii z poziomu terminala?
- Limity darmowego planu: czy rzeczywiście jest darmowe, czy tylko udaje?
- Dostęp online: czy to narzędzie chmurowe, aplikacja desktopowa czy biblioteka kodu?
- Unikalne funkcje: czy oferuje coś wyjątkowego — np. AI extraction, wizualne mapy witryny albo crawling uruchamiany zdarzeniami?
Przetestowałem każde narzędzie, sprawdziłem opinie użytkowników i porównałem funkcje obok siebie. Jeśli jakieś narzędzie sprawiało, że miałem ochotę wyrzucić laptop przez okno, nie trafiało na listę.
Szybkie porównanie: 10 najlepszych darmowych crawlerów stron w skrócie
| Narzędzie i typ | Najważniejsze funkcje | Najlepszy przypadek użycia | Wymagania techniczne | Szczegóły darmowego planu |
|---|---|---|---|---|
| Bright Data (Cloud/API) | Crawling dla enterprise, proxy, renderowanie JS, rozwiązywanie CAPTCHA | Duża skala zbierania danych | Przydają się umiejętności techniczne | Darmowy pakiet: 5 000 rekordów/miesiąc w Web Scraper API, bez karty kredytowej |
| Crawlbase (Cloud/API) | Crawling przez API, ochrona anty-bot, proxy, renderowanie JS | Dla developerów potrzebujących backendowej infrastruktury crawl | Integracja z API | Darmowy start: do 20 000 requestów na początek, bez karty; potem rozliczanie za request |
| ScraperAPI (Cloud/API) | Rotacja proxy, renderowanie JS, crawling asynchroniczny, gotowe endpointy | Developerzy, monitoring cen, dane SEO | Minimalna konfiguracja | Darmowe: 5 000 wywołań API przez 7 dni, potem 1 000/miesiąc |
| Diffbot Crawlbot (Cloud) | Crawling i ekstrakcja z AI, knowledge graph, renderowanie JS | Strukturalne dane na dużą skalę, AI/ML | Integracja z API | Darmowe: 10 000 kredytów/miesiąc dla API ekstrakcji; Crawl wymaga planu Plus |
| Screaming Frog (Desktop) | Audyt SEO, analiza linków i meta, sitemap, własna ekstrakcja | Audyty SEO, zarządzanie witrynami | Aplikacja desktopowa, GUI | Darmowe: 500 URL-i na crawl, tylko podstawowe funkcje |
| SiteOne Crawler (Desktop) | SEO, wydajność, dostępność, bezpieczeństwo, eksport offline, Markdown | Developerzy, QA, migracje, dokumentacja | Desktop/CLI, GUI | Darmowy i open source, 1 000 URL-i w raporcie GUI (konfigurowalne) |
| Crawljax (Java, OpenSrc) | Crawling sterowany zdarzeniami dla stron opartych na JS, eksport statyczny | Developerzy, QA dla dynamicznych aplikacji webowych | Java, CLI/konfiguracja | Darmowy i open source, bez limitów |
| Apache Nutch (Java, OpenSrc) | Rozproszony, oparty na pluginach, integracja z Hadoop, własne wyszukiwanie | Własne wyszukiwarki, crawling na dużą skalę | Java, wiersz poleceń | Darmowy i open source, tylko koszty infrastruktury |
| YaCy (Java, OpenSrc) | Crawl i wyszukiwanie peer-to-peer, prywatność, indeksowanie web/intranet | Prywatne wyszukiwanie, decentralizacja | Java, interfejs przeglądarkowy | Darmowy i open source, bez limitów |
| PowerMapper (Desktop/SaaS) | Wizualne mapy witryny, dostępność, QA, zgodność z przeglądarkami | Agencje, QA, wizualne mapowanie | GUI, łatwe w użyciu | Darmowy trial: 30 dni, 100 stron (desktop) lub 10 stron (online) na skan |
Jedna ważna uwaga zanim przewiniesz dalej: „darmowy” oznacza w tej tabeli kilka zupełnie różnych rzeczy. SiteOne, Crawljax, Nutch i YaCy są open source — bezpłatne, bez limitu poza możliwościami Twojego sprzętu. Screaming Frog jest darmowy na zawsze, ale ograniczony do 500 URL-i na crawl. Bright Data, ScraperAPI i Diffbot oferują realne, ale niewielkie darmowe limity, a w przypadku Diffbot darmowy plan nie obejmuje samego crawlera. Crawlbase daje jeden pakiet darmowych requestów na start, a potem rozlicza za każde wywołanie. PowerMapper to jedyny produkt oparty wyłącznie na trialu — po 30 dniach trzeba zapłacić.
Bright Data: crawler klasy enterprise w chmurze
Bright Data to ciężka artyleria w świecie crawlowania. To platforma chmurowa z ogromną siecią proxy, renderowaniem JavaScriptu, rozwiązywaniem CAPTCHA i IDE do tworzenia własnych crawl’i. Jeśli prowadzisz zbieranie danych na dużą skalę — na przykład monitorujesz setki sklepów e-commerce pod kątem cen — infrastruktura Bright Data jest naprawdę trudna do pobicia (aimultiple.com).
Mocne strony:
- Radzi sobie z trudnymi stronami i zabezpieczeniami anty-bot
- Skaluje się do potrzeb enterprise
- Gotowe szablony dla popularnych serwisów
Ograniczenia:
- Darmowy plan istnieje, ale jest niewielki: 5 000 rekordów miesięcznie w Web Scraper API
- Może być przesadą do prostych audytów
- Dla osób nietechnicznych wiąże się z pewną krzywą uczenia
Jeśli potrzebujesz crawlowania na dużą skalę, Bright Data jest jak wynajęcie bolidu Formuły 1. Darmowe 5 000 rekordów miesięcznie pozwoli Ci zrobić rundkę po osiedlu; później płacisz za zużycie (Bright Data Pricing).
Crawlbase: darmowy crawler API dla developerów
Crawlbase (dawniej ProxyCrawl) stawia na crawling programistyczny. Wysyłasz URL do ich API, a ono zwraca HTML — w tle obsługując proxy, geotargetowanie i CAPTCHA (Capterra).
Mocne strony:
- Bardzo wysoki współczynnik skuteczności (99%+)
- Dobrze radzi sobie ze stronami ciężkimi od JavaScriptu
- Świetny do integracji z własnymi aplikacjami i workflowami
Ograniczenia:
- Wymaga integracji przez API lub SDK
- Darmowy plan: do 20 000 requestów na start (bez karty), potem płatność za request
Jeśli jesteś developerem i chcesz crawlować — a może też scrapować — na dużą skalę bez zarządzania proxy, Crawlbase to solidny wybór (Crawlbase Pricing).
ScraperAPI: prostsze crawlowanie dynamicznych stron
ScraperAPI to API typu „po prostu pobierz mi to”. Podajesz URL, a ono ogarnia proxy, headless browser i zabezpieczenia anty-bot, po czym zwraca HTML (albo ustrukturyzowane dane dla niektórych stron). Narzędzie szczególnie dobrze sprawdza się na stronach dynamicznych, choć część „free” jest raczej symboliczna: 5 000 kredytów API przez pierwsze 7 dni bez karty, a potem 1 000 kredytów miesięcznie w stałym darmowym planie (ScraperAPI Pricing).
Mocne strony:
- Bardzo łatwe dla developerów (wystarczy jedno wywołanie API)
- Obsługuje CAPTCHA, blokady IP i JavaScript
- Darmowe: 5 000 wywołań API przez 7 dni, potem 1 000/miesiąc
Ograniczenia:
- Brak wizualnych raportów crawlingowych
- Jeśli chcesz podążać za linkami, musisz napisać logikę crawl’u samodzielnie
Jeśli chcesz w kilka minut wpiąć crawling do swojego kodu, ScraperAPI to oczywisty wybór.
Diffbot Crawlbot: automatyczne odkrywanie struktury witryny
Diffbot Crawlbot to moment, w którym robi się naprawdę „smart”. To nie tylko crawler — wykorzystuje AI do klasyfikowania stron i wyciągania danych strukturalnych (artykułów, produktów, wydarzeń itd.) do JSON-a. To jak posiadanie robota-stażysty, który naprawdę rozumie, co czyta (Diffbot Free Plan).
Mocne strony:
- Ekstrakcja wspierana przez AI, nie tylko samo crawlingowanie
- Obsługuje JavaScript i dynamiczną treść
- Darmowe: 10 000 kredytów miesięcznie, bez karty, obejmujące Extract, Natural Language, Knowledge Graph i Search
Ograniczenia:
- Nastawione na developerów (integracja przez API)
- To nie jest wizualne narzędzie SEO — bardziej do projektów data-driven
- Sam Crawlbot, czyli część przeszukująca całą stronę, jest w planie Plus i wyżej; darmowe kredyty dotyczą API ekstrakcji (Diffbot Pricing)
Jeśli potrzebujesz danych strukturalnych na dużą skalę, zwłaszcza do AI lub analityki, Diffbot to prawdziwa potęga.
Screaming Frog: darmowy desktopowy crawler SEO
Screaming Frog to klasyka wśród desktopowych crawlerów do audytów SEO. W darmowej wersji skanuje do 500 URL-i na jedno uruchomienie i daje praktycznie wszystko: błędne linki, meta tagi, duplikaty treści, sitemapę i wiele więcej (Screaming Frog User Guide).
Mocne strony:
- Szybki, dokładny i ceniony w świecie SEO
- Bez kodowania — wystarczy wpisać URL i ruszyć
- Darmowy do 500 URL-i na crawl
Ograniczenia:
- Tylko desktop, bez wersji chmurowej
- Zaawansowane funkcje (renderowanie JS, planowanie) wymagają płatnej licencji
Jeśli poważnie podchodzisz do SEO, Screaming Frog to pozycja obowiązkowa — tylko nie licz, że za darmo przeskanuje Ci 10-tysięczną witrynę.
SiteOne Crawler: eksport statycznych stron i dokumentacja
SiteOne Crawler to szwajcarski scyzoryk do audytów technicznych. Jest open source, działa na wielu platformach i potrafi nie tylko crawlować, ale też eksportować witrynę do Markdowna na potrzeby dokumentacji lub pracy offline (SiteOne Crawler).
Mocne strony:
- Obejmuje SEO, wydajność, dostępność i bezpieczeństwo
- Eksportuje witryny do archiwizacji lub migracji
- Darmowy i open source, bez limitów użycia
Ograniczenia:
- Bardziej techniczny niż niektóre narzędzia GUI
- Raport audytu w GUI jest domyślnie ograniczony do 1 000 URL-i (można to skonfigurować)
Jeśli jesteś developerem, QA lub konsultantem i lubisz open source, SiteOne to naprawdę ciekawy ukryty skarb.
Crawljax: open source crawler Java do dynamicznych stron
Crawljax to specjalista od zadań specjalnych: został stworzony do crawlowania nowoczesnych aplikacji webowych opartych na JavaScripcie, symulując interakcje użytkownika (kliknięcia, wypełnianie formularzy itd.). Działa zdarzeniowo i potrafi nawet wygenerować statyczną wersję dynamicznej strony (Wikipedia: Crawljax).
Mocne strony:
- Świetny do crawlowania SPA i stron mocno opartych na AJAX
- Open source i łatwy do rozbudowy
- Bez limitów użycia
Ograniczenia:
- Wymaga Javy oraz pewnej wiedzy programistycznej / konfiguracyjnej
- Nie dla użytkowników nietechnicznych
Jeśli chcesz crawlować aplikację w React albo Angularze tak, jak zrobiłby to prawdziwy użytkownik, Crawljax będzie Twoim sprzymierzeńcem.
Apache Nutch: skalowalny, rozproszony crawler stron internetowych
Apache Nutch to nestor wśród open-source’owych crawlerów. Jest projektowany do ogromnych, rozproszonych crawl’i — na przykład do budowy własnej wyszukiwarki albo indeksowania milionów stron (Martechvibe).
Mocne strony:
- Skaluje się do miliardów stron z Hadoopem
- Bardzo konfigurowalny i rozszerzalny
- Darmowy i open source
Ograniczenia:
- Stroma krzywa uczenia (Java, terminal, konfiguracja)
- Nie dla małych stron ani okazjonalnych użytkowników
Jeśli chcesz crawlować internet na dużą skalę i nie boisz się pracy w terminalu, Nutch będzie właściwym narzędziem.
YaCy: peer-to-peer crawler i wyszukiwarka
YaCy to wyjątkowy, zdecentralizowany crawler i silnik wyszukiwania. Każda instancja crawluje i indeksuje strony, a potem można dołączyć do sieci peer-to-peer i dzielić się indeksami z innymi (TechRadar: YaCy).
Mocne strony:
- Prywatność przede wszystkim, bez centralnego serwera
- Świetny do budowania prywatnej wyszukiwarki lub wyszukiwania intranetowego
- Darmowy i open source
Ograniczenia:
- Wyniki zależą od zasięgu sieci
- Wymaga pewnej konfiguracji (Java, interfejs przeglądarkowy)
Jeśli interesuje Cię decentralizacja albo chcesz zbudować własną wyszukiwarkę, YaCy to fascynująca opcja.
PowerMapper: wizualny generator map witryny do UX i QA
PowerMapper skupia się na wizualizacji struktury witryny. Crawluje serwis i tworzy interaktywne mapy witryny, a do tego sprawdza dostępność, zgodność z przeglądarkami i podstawy SEO (Slickplan Review).
Mocne strony:
- Wizualne mapy świetnie sprawdzają się w agencjach i u projektantów
- Sprawdza dostępność i zgodność
- Prosty interfejs GUI, bez potrzeby wiedzy technicznej
Ograniczenia:
- Tylko darmowy trial (30 dni, 100 stron desktop / 10 stron online na skan)
- Pełna wersja jest płatna
Jeśli chcesz pokazać klientowi mapę serwisu albo sprawdzić zgodność, PowerMapper będzie bardzo pomocny.
Jak wybrać odpowiedni darmowy web crawler do swoich potrzeb
Przy tak wielu opcjach, jak wybrać tę właściwą? Oto mój szybki przewodnik:
- Do audytów SEO: Screaming Frog (małe strony), PowerMapper (wizualnie), SiteOne (głębokie audyty)
- Do dynamicznych aplikacji webowych: Crawljax
- Do dużej skali lub własnej wyszukiwarki: Apache Nutch, YaCy
- Dla developerów potrzebujących dostępu przez API: Crawlbase, ScraperAPI, Diffbot
- Do dokumentacji lub archiwizacji: SiteOne Crawler
- Do zastosowań enterprise z niewielkim stałym darmowym limitem: Bright Data, Diffbot
Najważniejsze czynniki:
- Skalowalność: jak duża jest Twoja strona lub zadanie crawlingowe?
- Łatwość użycia: wolisz kod czy klikanie?
- Eksport danych: potrzebujesz CSV, JSON czy integracji z innymi narzędziami?
- Wsparcie: czy istnieje społeczność albo dokumentacja, gdy utkniesz?
Gdy web crawling spotyka web scraping: dlaczego Thunderbit to mądrzejszy wybór
Wyciągaj dane z dowolnej strony z pomocą AI Agentic web scraper od Thunderbit czyta dowolną stronę, którą chcesz crawlować, i jednym kliknięciem wyciąga z niej dane strukturalne — za darmo dla 6 stron miesięcznie. Get Started Free
Prawda jest taka: większość ludzi nie crawluje stron tylko po to, żeby robić ładne mapy. Zwykle chodzi o dane strukturalne — listy produktów, dane kontaktowe albo inwentaryzację treści. I właśnie tutaj wchodzi Thunderbit.
Thunderbit to nie tylko crawler ani tylko scraper — to rozszerzenie do Chrome oparte na AI, które łączy oba podejścia. Tak działa:
- AI Crawler: Thunderbit eksploruje stronę, tak jak klasyczny crawler.
- Waterfall Crawling: jeśli własny silnik Thunderbit nie może pobrać strony (na przykład przez mocną blokadę anty-bot), automatycznie przełącza się na zewnętrzne usługi crawlingowe — bez ręcznej konfiguracji.
- AI Data Structuring: gdy ma już HTML, AI Thunderbit podpowiada odpowiednie kolumny i wyciąga dane strukturalne (nazwy, ceny, e-maile itd.) bez pisania ani jednego selektora.
- Subpage Scraping: potrzebujesz szczegółów z każdej strony produktu? Thunderbit może automatycznie odwiedzać kolejne podstrony i wzbogacać tabelę.
- Czyszczenie i eksport danych: potrafi streszczać, kategoryzować, tłumaczyć i eksportować dane do Excel, Google Sheets, Airtable lub Notion jednym kliknięciem.
- Bez kodowania: jeśli umiesz korzystać z przeglądarki, poradzisz sobie z Thunderbit. Bez kodu, bez proxy, bez bólu głowy.
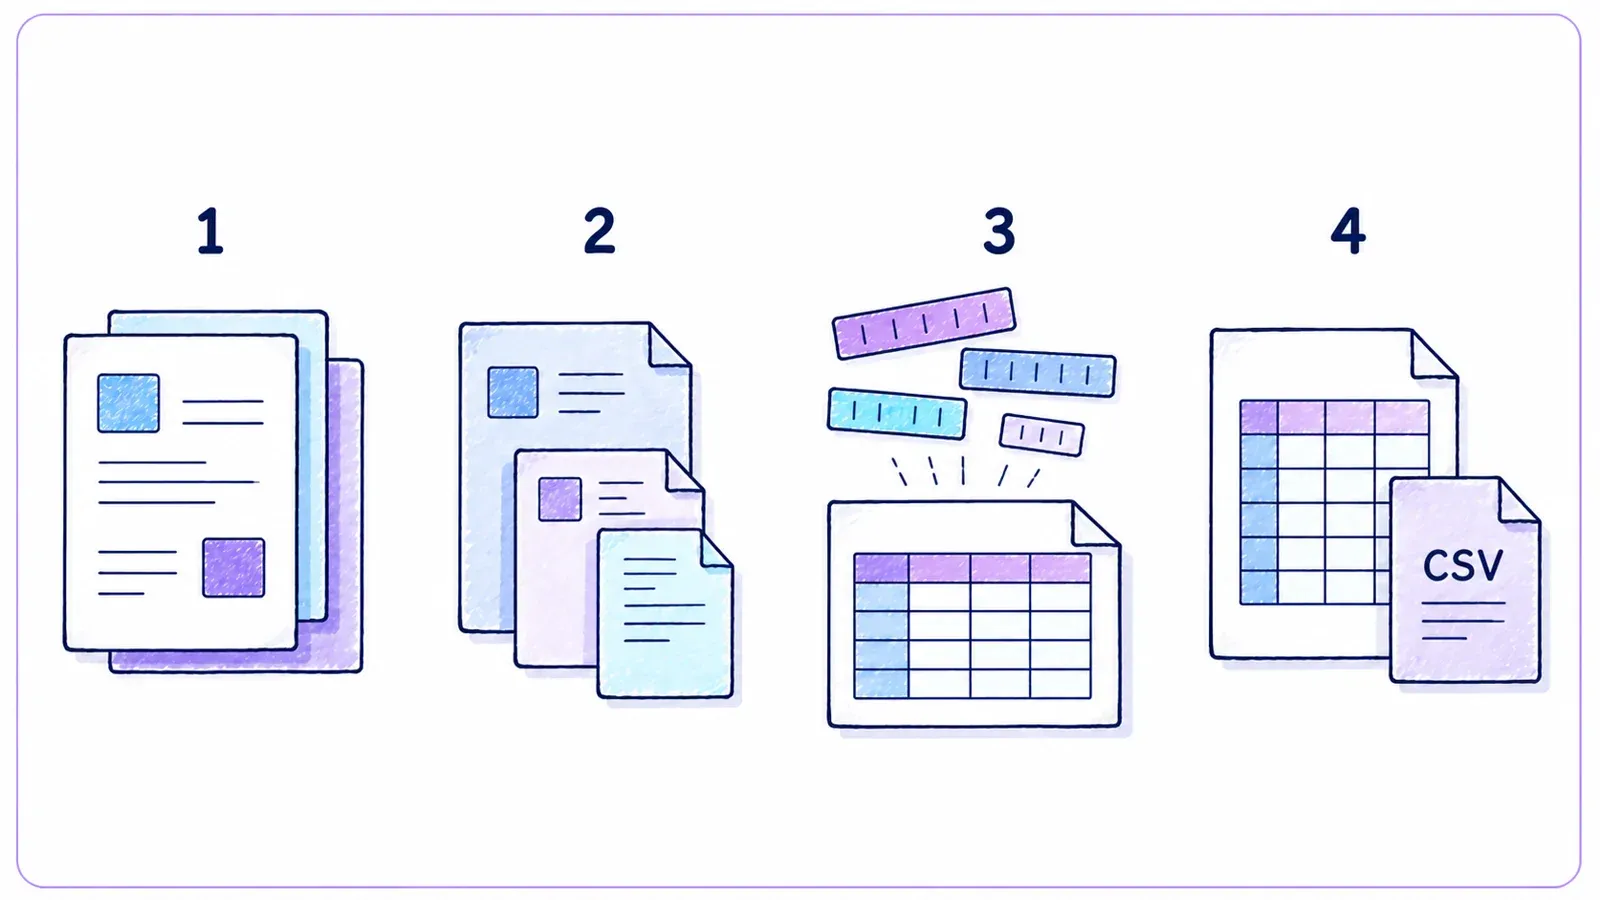
Kiedy wybrać Thunderbit zamiast tradycyjnego crawlera?
- Gdy celem jest czysty, użyteczny arkusz kalkulacyjny, a nie tylko lista URL-i.
- Gdy chcesz zautomatyzować cały proces — crawling, ekstrakcję, czyszczenie i eksport — w jednym miejscu.
- Gdy cenisz swój czas i spokój.
Możesz pobrać rozszerzenie Thunderbit do Chrome tutaj i sam zobaczysz, dlaczego tak wielu użytkowników biznesowych przechodzi na to rozwiązanie.
Wypróbuj Thunderbit za darmo – Agentic Web Scraper Zainstaluj darmowe rozszerzenie Chrome i zacznij crawlować dowolną stronę jednym kliknięciem, bez kodu. Get Started Free
Podsumowanie: jak wycisnąć maksimum z darmowych crawlerów stron
Zobacz, jak działa agentic web scraping AI Thunderbit czyta stronę jak człowiek i decyduje, co wyciągnąć, eliminując ręczną konfigurację crawlera. Get Started Free
Crawlerów stron internetowych jest dziś naprawdę wiele. Niezależnie od tego, czy jesteś marketerem, developerem, czy po prostu chcesz utrzymać swoją stronę w dobrej formie, znajdziesz narzędzie darmowe — albo przynajmniej darmowe do przetestowania. Od platform enterprise, takich jak Bright Data i Diffbot, przez open-source’owe perełki jak SiteOne i Crawljax, po wizualne mapery jak PowerMapper — wybór jest większy niż kiedykolwiek.
Ale jeśli szukasz mądrzejszego i bardziej zintegrowanego sposobu, by przejść od „potrzebuję tych danych” do „oto mój arkusz”, wypróbuj Thunderbit. To rozwiązanie stworzone dla użytkowników biznesowych, którzy chcą efektów, a nie tylko raportów.
Gotowy do crawl’owania? Pobierz narzędzie, uruchom skan i sprawdź, czego Ci brakowało. A jeśli chcesz przejść od crawlowania do gotowych, użytecznych danych jednym kliknięciem, sprawdź Thunderbit.
Po więcej praktycznych porad i pogłębionych analiz zajrzyj na Thunderbit Blog.
Wyciągaj dane ze stron z AI jednym kliknięciem Ustaw Thunderbit tak, by podążał za podstronami i działał według harmonogramu, dzięki czemu Twoje dane będą zawsze aktualne bez ręcznego powtarzania crawl’i. Get Started Free
Wypróbuj agentic web scraper Get Started Free
FAQ
Jaka jest różnica między crawlerem strony a web scraperem?
Crawler odkrywa i mapuje wszystkie podstrony witryny (czyli buduje coś w rodzaju spisu treści). Scraper wyciąga konkretne dane z tych stron, takie jak ceny, e-maile czy opinie. Crawler znajduje, scraper wydobywa (Thunderbit Blog: What Is a Web Crawler?).
Który darmowy crawler stron będzie najlepszy dla osób nietechnicznych?
Do małych stron i audytów SEO Screaming Frog jest bardzo przyjazny. Do wizualnego mapowania świetny jest PowerMapper (w czasie trialu). Thunderbit będzie najłatwiejszy, jeśli Twoim celem są dane strukturalne i chcesz rozwiązania no-code w przeglądarce.
Czy istnieją strony blokujące crawlerów?
Tak — niektóre witryny używają pliku robots.txt albo zabezpieczeń anty-bot, takich jak CAPTCHA czy blokady IP. Narzędzia typu ScraperAPI, Crawlbase i Thunderbit (z waterfall crawling) często potrafią sobie z tym poradzić, ale zawsze crawluj odpowiedzialnie i szanuj zasady serwisu (Bright Data Pricing).
Czy darmowe crawlery mają limity stron lub funkcji?
Większość tak. Na przykład darmowa wersja Screaming Frog jest ograniczona do 500 URL-i na crawl, a trial PowerMapper do 100 stron. Narzędzia API zwykle mają miesięczne limity kredytów. Open-source’owe rozwiązania, takie jak SiteOne czy Crawljax, zazwyczaj nie mają twardych limitów, ale ogranicza Cię sprzęt.
Czy używanie crawlera jest legalne i zgodne z zasadami prywatności?
Zasadniczo crawlowanie publicznych stron jest legalne, ale zawsze sprawdzaj regulamin serwisu i robots.txt. Nigdy nie crawluj prywatnych ani chronionych hasłem danych bez pozwolenia i uważaj na przepisy o prywatności, jeśli wyciągasz dane osobowe (Crawlbase Guide).



