
Jeśli kiedykolwiek wpatrywałeś się w stos stron internetowych, arkuszy kalkulacyjnych albo plików PDF i myślałeś: „Musi istnieć lepszy sposób na pobranie tych danych”, nie jesteś sam. Od lat tworzę narzędzia automatyzujące pracę i rozmawiam z zespołami biznesowymi, które mają już dość kopiowania i wklejania. Prawda jest taka, że w 2026 roku skala nieustrukturyzowanych danych jest przytłaczająca — 80–90% nowych danych w przedsiębiorstwach ma postać nieustrukturyzowaną, a tylko niewielka część firm naprawdę dobrze je wykorzystuje (Docsumo). Ręczne zbieranie danych to nie tylko nuda — to kosztowne, podatne na błędy i mocno obniżające produktywność.
Pozyskuj dane z dowolnej strony z pomocą AI Get Started Free
Właśnie tutaj wchodzą do gry ekstraktory danych. Niezależnie od tego, czy pracujesz w sprzedaży, operacjach, eCommerce czy badaniach, odpowiednie narzędzie może oszczędzić Ci godziny, a nawet dni, poprawić dokładność i pozwolić zespołowi skupić się na tym, co naprawdę ważne. Ale przy tak szerokim wyborze — rozszerzenia Chrome oparte na AI, platformy no-code, frameworki dla developerów — jak wybrać najlepsze rozwiązanie do swoich potrzeb? Przejrzałem dokładnie 10 najlepszych ekstraktorów danych na 2026 rok, opisując ich mocne strony, ograniczenia i najlepsze zastosowania. Zaczynajmy.
Dlaczego firmy potrzebują ekstraktorów danych, aby osiągnąć maksymalną efektywność
Bądźmy szczerzy: 94% firm tonie w powtarzalnych, czasochłonnych zadaniach takich jak ręczne wprowadzanie danych (ServiceNow). A koszt to nie tylko utracony czas — ręczne pozyskiwanie danych może kosztować nawet 1 500 USD na pracownika miesięcznie (ResolvePay). Ekstraktory danych automatyzują żmudną pracę, dzięki czemu możesz:
- Oszczędzić nawet 77% czasu poświęcanego na zbieranie danych (ServiceNow).
- Zwiększyć efektywność operacyjną o 40% (PerfectDataEntry).
- Skrócić czas przetwarzania o 50% lub więcej (Docsumo).
- Osiągnąć dokładność sięgającą 99,9% w pozyskiwaniu danych z dokumentów (Docsumo).
Efekt? Szybsze decyzje, lepsza jakość danych i bardziej zadowolone zespoły. Niezależnie od tego, czy pozyskujesz leady, monitorujesz ceny konkurencji, czy zasilasz dane do narzędzi BI, dobry ekstraktor działa jak cyfrowy asystent, który nigdy się nie męczy (ani nie prosi o podwyżkę).
Jak wybrać najlepszy ekstraktor danych: kluczowe kryteria
Nie wszystkie ekstraktory danych są sobie równe. Oto, na co zwracam uwagę, gdy polecam narzędzie:
- Łatwość obsługi: Czy osoby nietechniczne mogą szybko zacząć? Czy dostępna jest konfiguracja AI albo metodą „kliknij i wybierz”?
- Dostosowanie i elastyczność: Czy poradzi sobie ze złożonymi stronami, logowaniem albo dynamiczną treścią? Czy możliwe jest skryptowanie dla bardziej zaawansowanych potrzeb?
- Obsługiwane typy danych: Czy wyciąga tekst, liczby, obrazy, e-maile, numery telefonów, PDF-y itp.?
- Skalowalność i wydajność: Czy poradzi sobie z tysiącami stron? Czy oferuje chmurę lub scrapowanie wielowątkowe?
- Integracje i automatyzacja: Czy można eksportować bezpośrednio do Excel, Google Sheets, Airtable, Notion albo łączyć się przez API?
- Cena i opłacalność: Czy jest darmowy plan? Czy płatne plany są przystępne w Twoim scenariuszu?
- Wsparcie i społeczność: Czy dostępna jest dobra dokumentacja, poradniki i szybka pomoc?
Różne zespoły będą inaczej ważyć te kryteria. Na przykład działy sprzedaży często stawiają na prostotę i szybki eksport, a programiści — na szerokie możliwości konfiguracji i dostęp do API.
Ekstraktory danych dla eCommerce i badań rynkowych
eCommerce i zespoły badań rynkowych żyją aktualnymi danymi — chodzi o śledzenie cen, analizę opinii o produktach i monitorowanie konkurencji. W takich scenariuszach potrzebujesz narzędzi, które radzą sobie z dużą skalą, zabezpieczeniami anty-botowymi i harmonogramami uruchomień.
- Octoparse: Znany z rozbudowanego interfejsu no-code i setek gotowych szablonów dla Amazon, eBay i wielu innych serwisów. Świetny do monitorowania cen i scrapowania opinii.
- Import.io: Skupia się na włączaniu danych z sieci do narzędzi BI, oferując harmonogramy i wykrywanie zmian. Idealny dla firm badawczych potrzebujących stałego dopływu danych.
- Dexi.io: Rozwiązanie klasy enterprise z automatyzacją procesów i transformacją danych. Wykorzystywane przez duże sieci handlowe do analizy konkurencji i śledzenia cen.
Te narzędzia są stworzone do pracy na dużą skalę i poradzą sobie z technikami utrudniającymi scrapowanie, które spotkasz na największych platformach eCommerce.
Ekstraktory danych dla zespołów technicznych i niestandardowych workflow
Jeśli w Twoim zespole są developerzy albo nie boisz się kodu, warto sięgnąć po narzędzia dające maksymalną elastyczność:
- Scrapy: Złoty standard scrapowania w Pythonie. Open-source, bardzo konfigurowalny i stworzony do dużych projektów. Idealny do budowania własnych crawlerów albo integracji scrapingu z aplikacją.
- ParseHub: Wizualny kreator workflow, który świetnie radzi sobie z dynamicznymi stronami opartymi na JavaScript. Obsługuje logikę warunkową, własny JS i dostęp przez API.
- Apify: Platforma chmurowa do uruchamiania własnych skryptów scrapujących („Actors”) w JavaScript lub Pythonie. Świetna do łączenia workflow, automatyzacji w przeglądarce headless i skalowania w chmurze.
To narzędzia, które polecam, gdy trzeba zeskrobać trudne strony, zautomatyzować wieloetapowe procesy albo zbudować coś, czego nie da się zrobić prostym narzędziem klikanym.
Ekstraktory danych do integracji danych i automatyzacji workflow
Niektóre zespoły potrzebują czegoś więcej niż surowych danych — chcą zautomatyzować cały proces, od pobrania po analizę:
- Import.io: Jak już wspomniano, świetnie integruje dane z sieci z dashboardami analitycznymi i BI, oferując harmonogramy oraz dostarczanie danych przez API.
- Dexi.io: Stworzony do automatyzacji end-to-end, w tym czyszczenia danych, transformacji i integracji z CRM-ami, bazami danych i innymi systemami.
Jeśli Twój workflow składa się z kilku etapów albo dane mają trafiać bezpośrednio do istniejących systemów, to właśnie te ekstraktory warto rozważyć.
Tabela porównawcza: 10 najlepszych ekstraktorów danych w skrócie
Oto szybkie porównanie, które pomoże Ci zawęzić wybór:
| Nazwa narzędzia | Łatwość użycia | Najlepsze zastosowanie | Cena | Możliwości dostosowania | Obsługiwane typy danych |
|---|---|---|---|---|---|
| Thunderbit | ⭐ Bardzo łatwe | Wszystkie branże, osoby nietechniczne | Darmowe i płatne | Prompt AI, low-code | Tekst, liczby, daty, URL-e, e-maile, telefony, obrazy, PDF-y |
| Octoparse | 🙂 Umiarkowane | eCommerce, badania rynku | Darmowe i płatne | Wysokie (wizualnie, regex) | Tekst, liczby, URL-e, obrazy |
| ParseHub | 🙂 Umiarkowane | Dynamiczne strony, użytkownicy techniczni | Płatne | Wysokie (JS, logika) | Tekst, liczby, URL-e, obrazy |
| Import.io | 😀 Łatwe | Integracja danych, BI | Płatne (Enterprise) | Średnie | Tekst, tabele, listy |
| Scrapy | 😐 Trudne | Własny development, duża skala | Darmowe (open source) | Bardzo wysokie (kod) | Dowolne (definiowane przez dev) |
| Apify | 😐 Trudne | Automatyzacja workflow, developerzy | Darmowe i płatne | Bardzo wysokie (kod) | Dowolna zawartość webowa |
| Dexi.io | 🙂 Umiarkowane | Enterprise, workflow | Płatne (Enterprise) | Wysokie (wizualnie, skrypt) | Tekst, obrazy, pliki |
| WebHarvy | 😀 Łatwe | Małe firmy, statyczne strony | Licencja jednorazowa | Niskie-średnie | Tekst, liczby, URL-e, obrazy |
| Data Miner | 😀 Łatwe | Szybki eksport do arkusza, sprzedaż | Darmowe i płatne | Średnie (recipes) | Tekst, tabele, listy |
| Helium Scraper | 🙂 Umiarkowane | Logika własna, dane relacyjne | Licencja jednorazowa | Wysokie (JS, SQL) | Tekst, URL-e, obrazy, pliki |
Dwie nazwy, których być może szukasz, nie znajdują się w tej tabeli. Visual Web Ripper już nie istnieje — Sequentum wyłączyło serwer licencji w 2022 roku. Content Grabber został włączony do Sequentum Enterprise już w 2020 roku, a starszy produkt nie jest już sprzedawany ani wspierany.
Legenda: 😀 Łatwe (przyjazne dla osób nietechnicznych), 🙂 Umiarkowane (pewna krzywa uczenia się), 😐 Trudne (wymaga kodowania)
1. Thunderbit
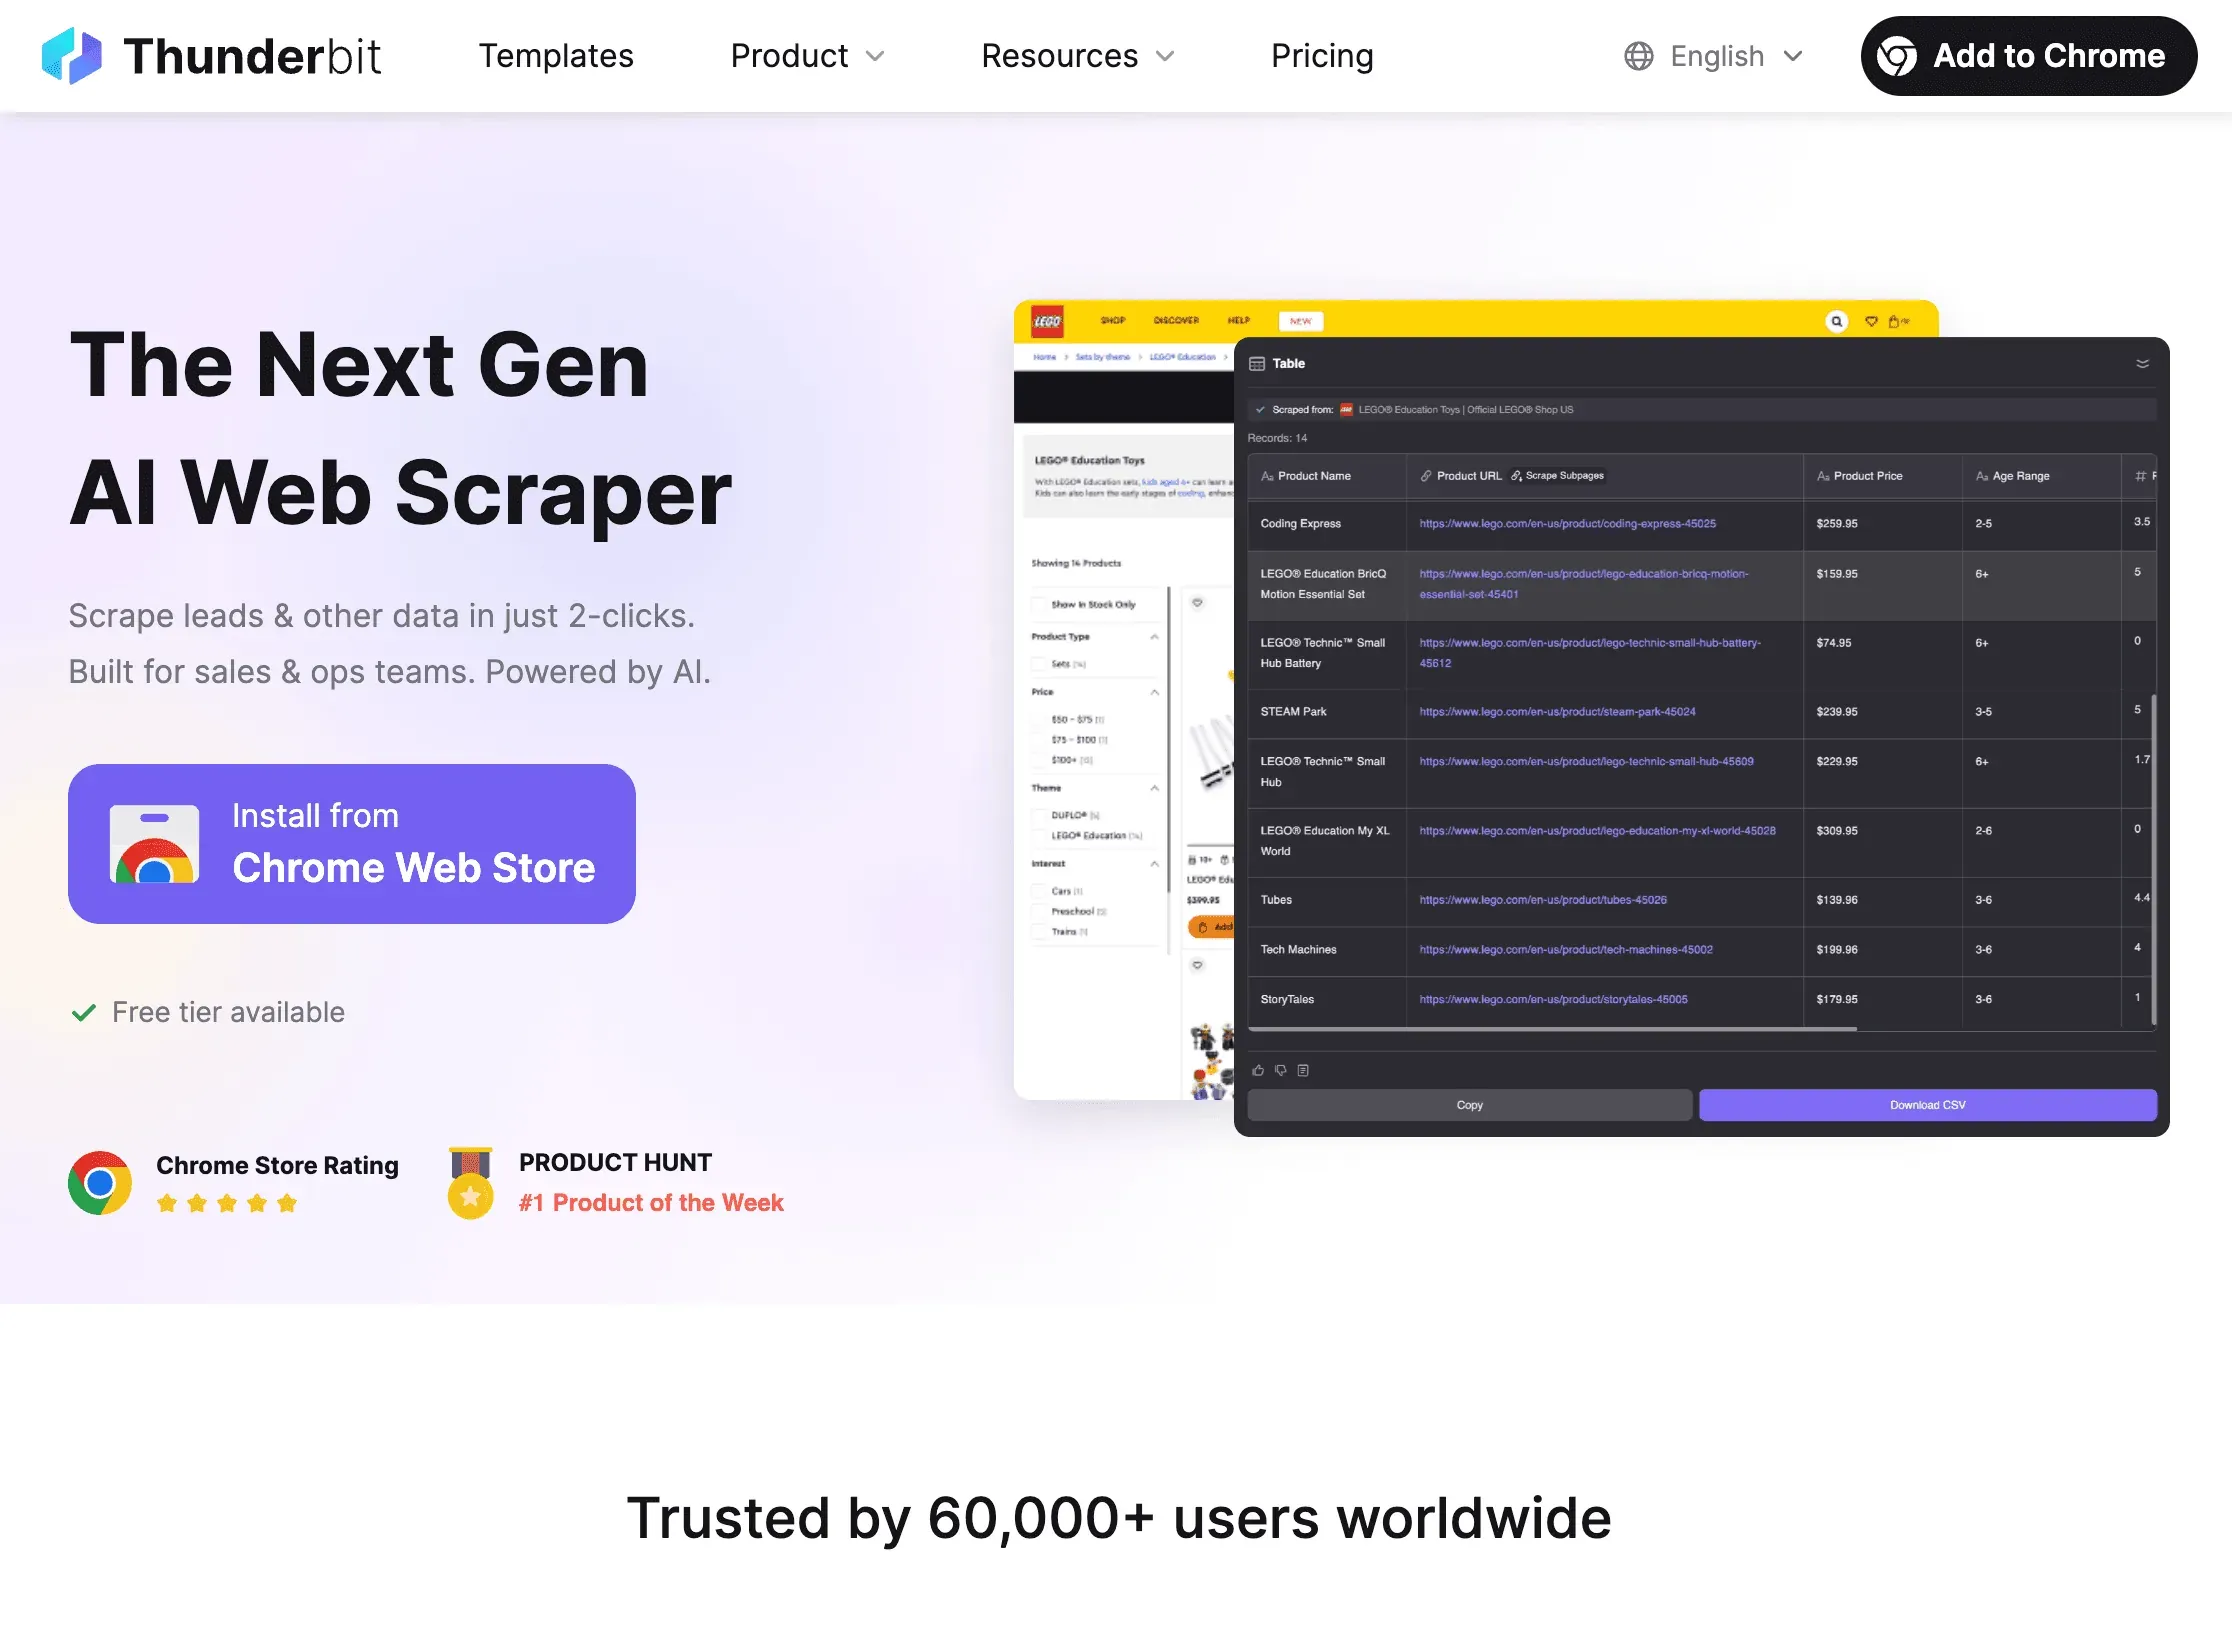 Thunderbit to mój najlepszy wybór dla osób nietechnicznych, które chcą maksymalnej wydajności przy minimalnym wysiłku. Jako rozszerzenie Chrome oparte na AI jest stworzone z myślą o użytkownikach biznesowych — sprzedaży, operacjach, nieruchomościach, eCommerce — czyli o tych, którzy chcą po prostu danych, a nie problemów.
Najważniejsze funkcje:
- AI Suggest Columns: Jedno kliknięcie i AI Thunderbit analizuje stronę oraz proponuje najlepsze pola do pobrania — bez ręcznej konfiguracji.
- Scraping w 2 kliknięciach: Potwierdzasz pola, klikasz „Scrape” i gotowe. Moja mama też by sobie poradziła (a i tak nadal dzwoni do mnie, gdy Wi‑Fi przestaje działać).
- Scraping podstron: Potrzebujesz więcej szczegółów? Thunderbit może automatycznie odwiedzać każdą podstronę (np. produktową lub profilową) i wzbogacać tabelę.
- Darmowy eksport danych: Przesyłaj wyniki bezpośrednio do Excel, Google Sheets, Airtable albo Notion — bez dodatkowych opłat.
- Ekstrakcja e-maili, telefonów i obrazów jednym kliknięciem: Idealne do lead generation i pobierania danych kontaktowych z dowolnej strony.
- Scraping w chmurze lub w przeglądarce: Wybierz szybkie scrapowanie w chmurze dla stron publicznych albo tryb przeglądarkowy dla stron wymagających logowania.
- Obsługa 34 języków: Globalne zespoły mogą odetchnąć z ulgą.
Zalety: Niesamowicie proste, bez kodowania, radzi sobie z nieustrukturyzowanymi danymi i automatycznie dostosowuje się do zmian na stronie. Darmowy plan dla mniejszych zadań, przystępne płatne plany dla większych potrzeb.
Wady: Mniej konfigurowalne niż narzędzia dla developerów przy bardzo złożonych stronach. Cennik oparty na kredytach dla użytkowników o dużym wolumenie.
Dla kogo: Zespoły sprzedaży, operacje eCommerce, agenci nieruchomości i każdy, kto chce przejść od „potrzebuję tych danych” do „oto mój arkusz” w mniej niż pięć minut. Wypróbuj Thunderbit za darmo.
2. Octoparse
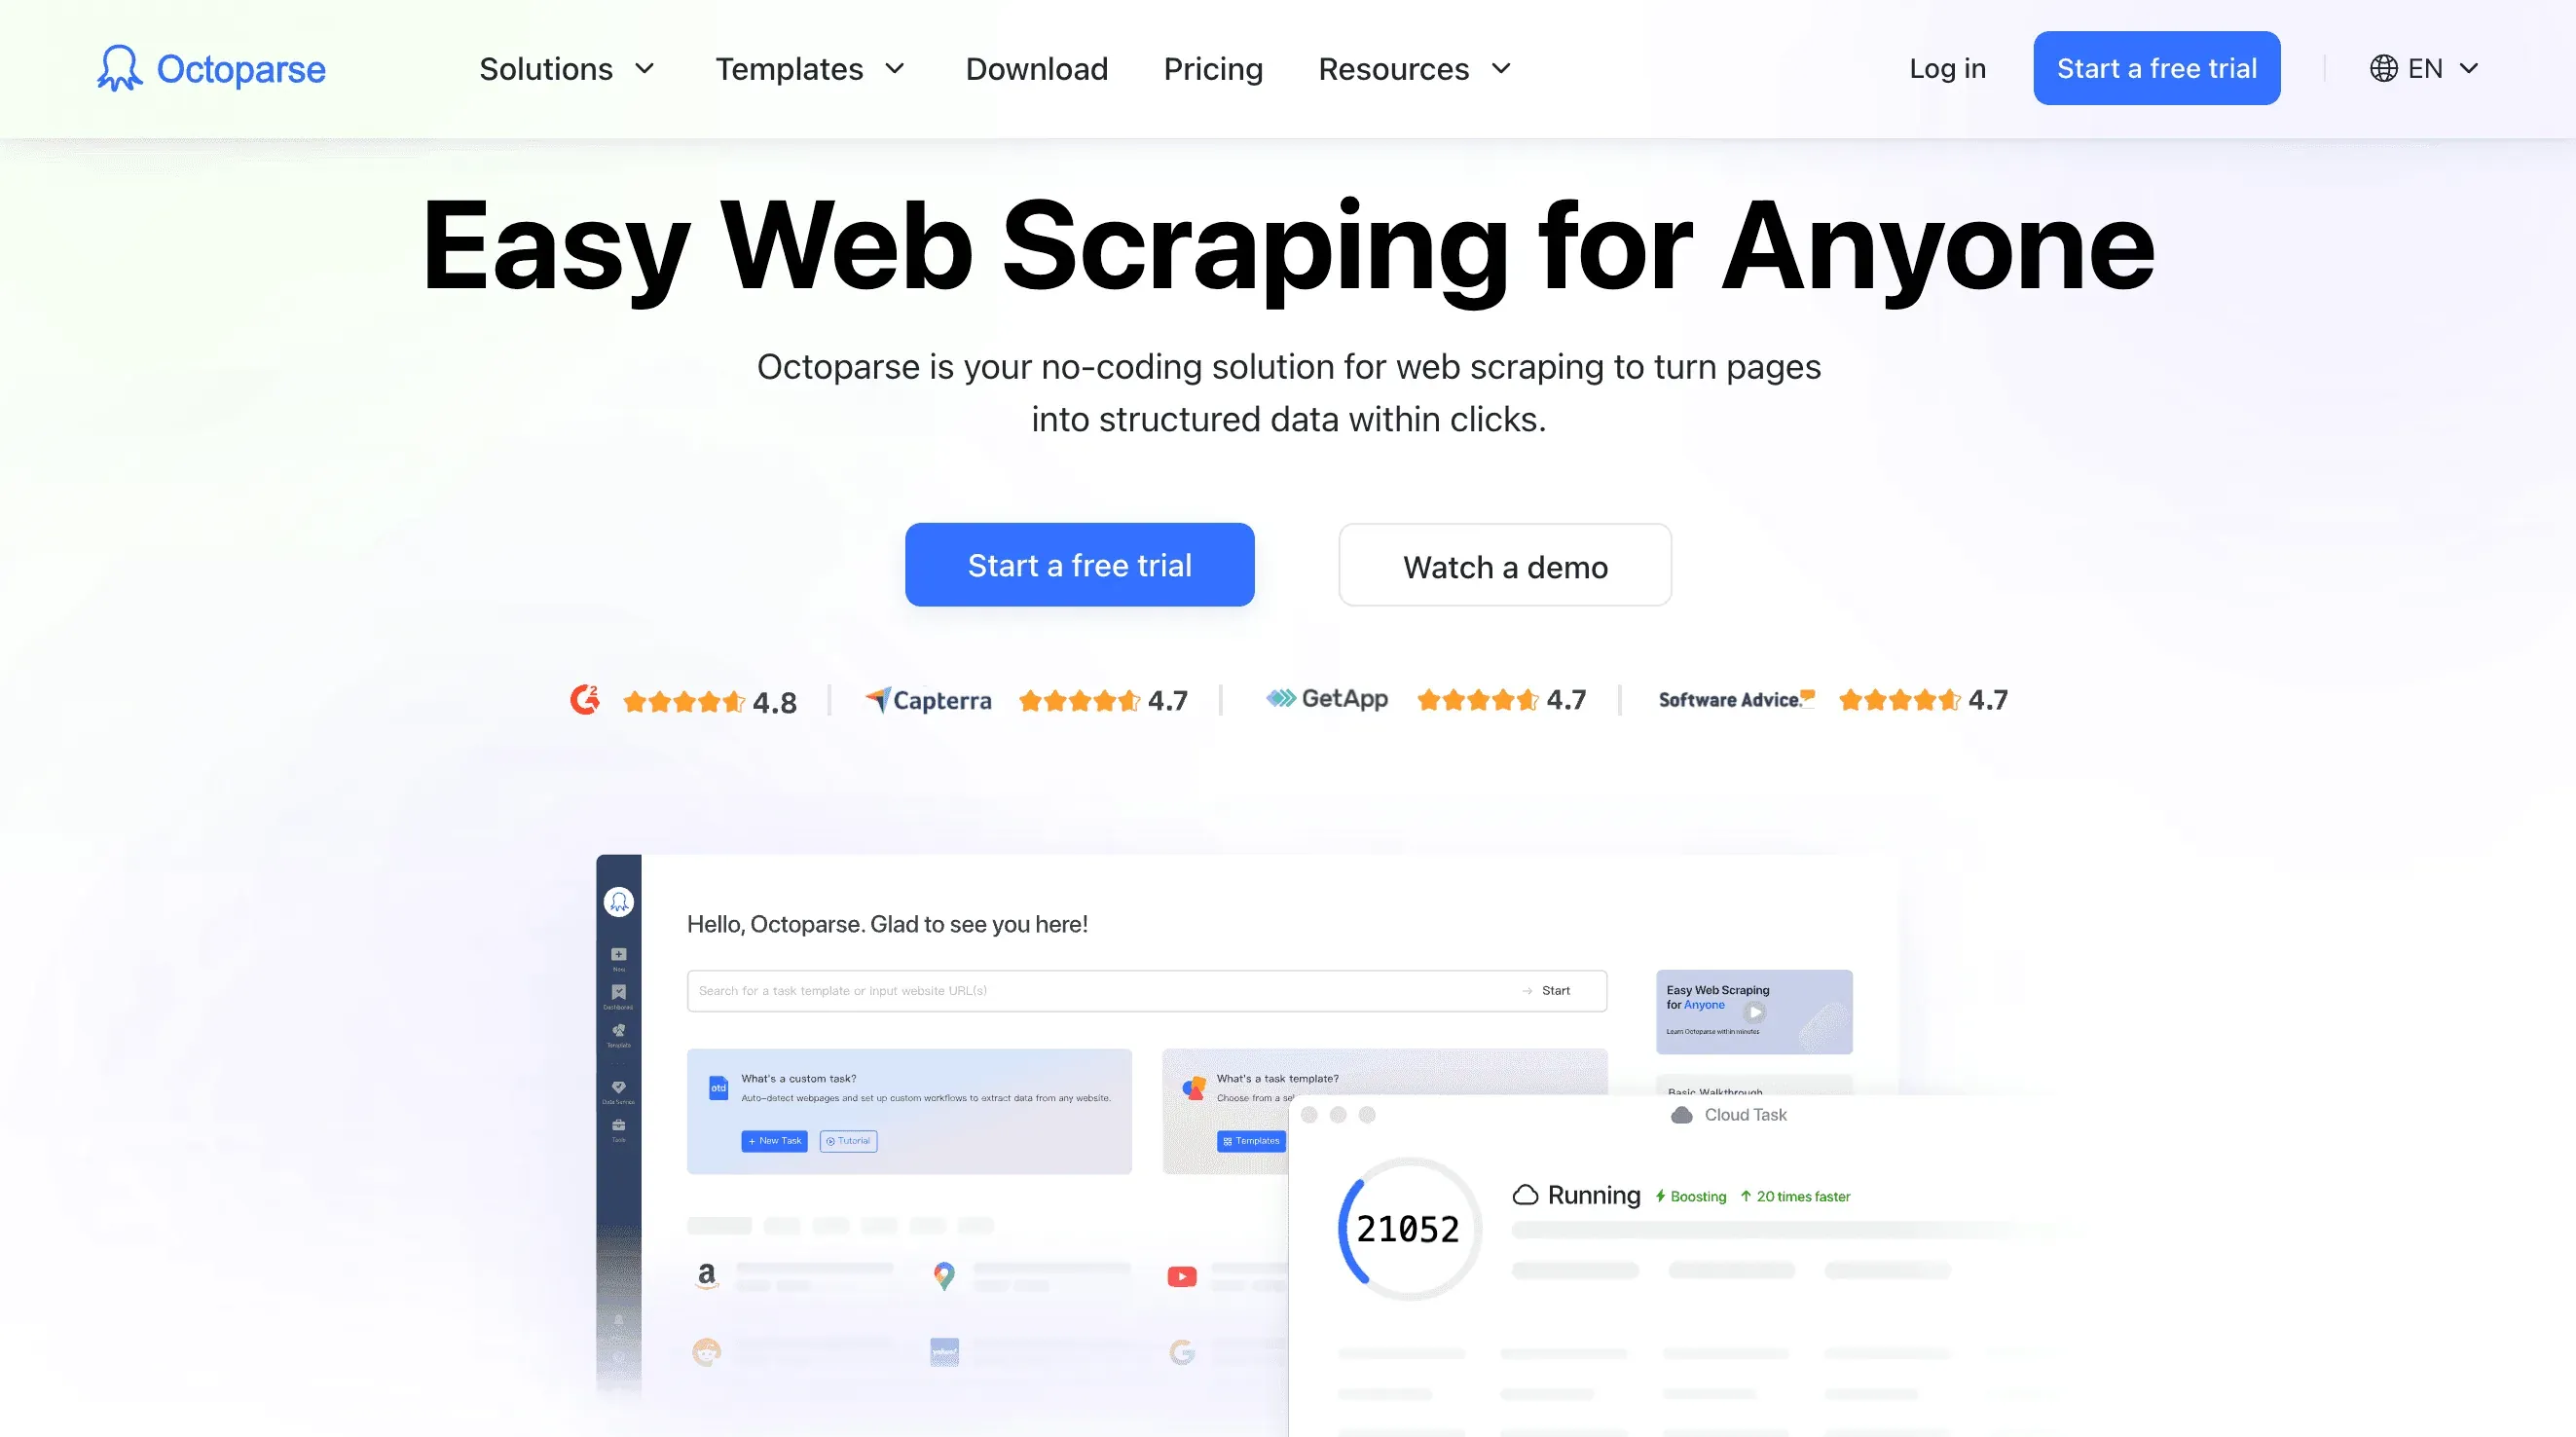 Octoparse to mocne narzędzie dla zespołów eCommerce i badań rynkowych. To desktopowa aplikacja no-code (Windows) z wizualnym kreatorem workflow i setkami gotowych szablonów dla serwisów takich jak Amazon, eBay czy Zillow.
Najważniejsze funkcje:
- Interfejs „kliknij i wybierz”: Buduj zadania scrapujące, klikając elementy na stronie.
- Scraping w chmurze i harmonogramy: Płatne plany pozwalają uruchamiać zadania w chmurze i planować regularne pobieranie danych.
- Rotacja IP i anty-bot: Radzi sobie ze stronami blokującymi scrapery, oferując wbudowane proxy i rozwiązania captcha.
- Biblioteka szablonów: Ponad 500 gotowych szablonów dla popularnych serwisów.
- Scraping wielopoziomowy i stron paginowanych: Obsługuje złożoną nawigację i pobieranie danych ze stron szczegółów.
Zalety: Świetny do dużej skali monitorowania cen, analizy opinii i nadzoru eCommerce. W większości zadań nie wymaga kodowania.
Wady: Tylko desktop, może być kosztowny dla intensywnych użytkowników, a zaawansowane workflow mają swoją krzywą uczenia się.
Dla kogo: Analitycy eCommerce, badacze rynku i każdy, kto musi monitorować wiele produktów lub konkurentów.
3. ParseHub
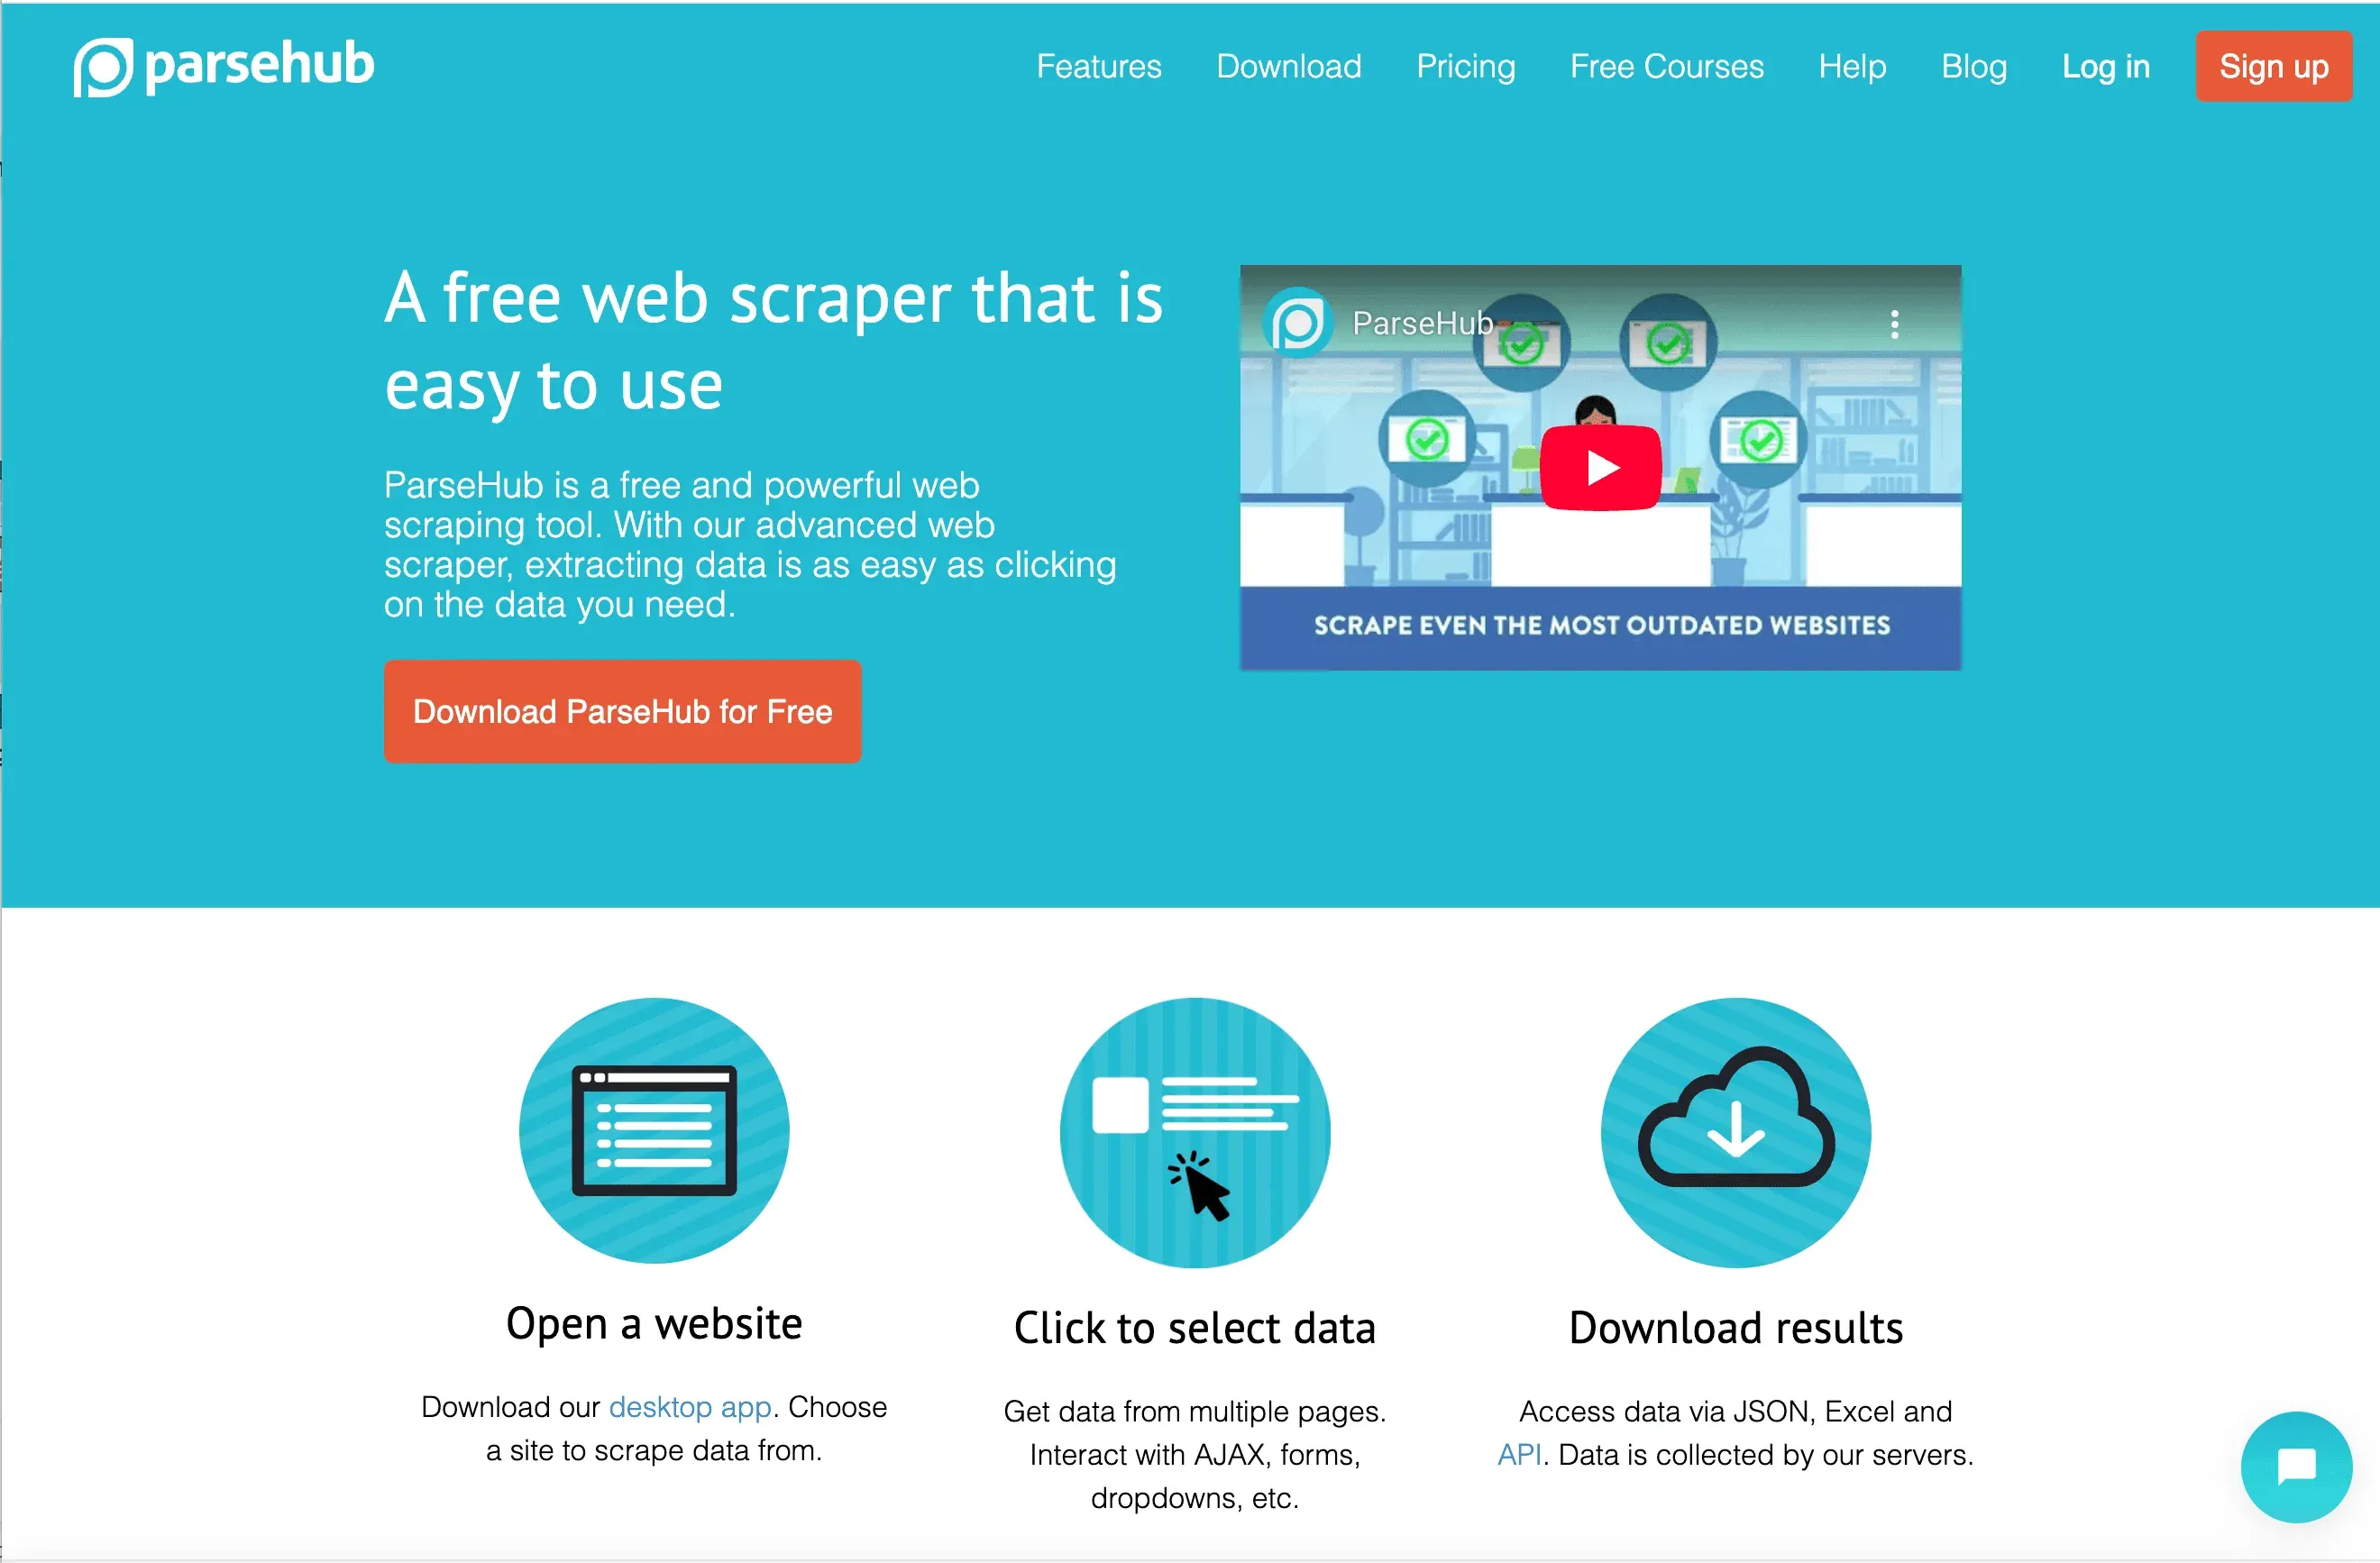 ParseHub to elastyczny wizualny scraper, który świetnie sprawdza się na dynamicznych stronach opartych na JavaScript. To aplikacja desktopowa (Windows, Mac, Linux) z kreatorem workflow obsługującym logikę warunkową, własny JS i dostęp do API.
Najważniejsze funkcje:
- Obsługa dynamicznej treści: Działa z aplikacjami single-page, AJAX i interaktywnymi stronami.
- Workflow i skrypty: Buduj wieloetapowe procesy, wstrzykuj własny JS i używaj regex do dopracowania wyników.
- Uruchamianie lokalne i w chmurze: Możesz uruchamiać zadania na swoim komputerze lub w chmurze (płatne).
- Dostęp do API: Integruj scraping z własnymi aplikacjami lub automatyzuj go przez webhooki.
Zalety: Bardzo konfigurowalny dla osób technicznych, radzi sobie z trudnymi stronami i obsługuje złożoną logikę.
Wady: Wolniejszy przy dużych zadaniach, umiarkowana krzywa uczenia się, a uruchomienia w chmurze kosztują dodatkowo.
Dla kogo: Analitycy techniczni, developerzy lub każdy, kto musi scrapować strony z dużą interaktywnością.
4. Import.io
 Import.io koncentruje się na włączaniu danych z internetu do workflow business intelligence. To platforma webowa z interfejsem „kliknij i wybierz” oraz mocnymi funkcjami planowania i API.
Najważniejsze funkcje:
- Automatyczne wykrywanie tabel: Wklej URL, a Import.io spróbuje automatycznie pobrać dane w ustrukturyzowanej formie.
- Harmonogramy i wykrywanie zmian: Ustaw zadania cykliczne i otrzymuj alerty, gdy dane się zmienią.
- Integracja przez API: Pobieraj dane programowo lub wysyłaj je do narzędzi BI.
- Transformacja danych: Czyść i formatuj dane bezpośrednio w platformie.
Zalety: Przyjazny dla użytkownika, świetny dla analityków biznesowych i dobrze integruje się z narzędziami analitycznymi.
Wady: Cennik enterprise, ograniczenia dla bardzo interaktywnych stron i mniejsza kontrola dla zaawansowanych użytkowników.
Dla kogo: Zespoły badań rynkowych, analitycy biznesowi i działy operacyjne potrzebujące stałego strumienia danych.
5. Scrapy
 Scrapy to open-source'owy framework w Pythonie, który uwielbiają developerzy. Jeśli chcesz pełnej kontroli, skalowalności i możliwości budowy własnych crawlerów, Scrapy będzie Twoim najlepszym przyjacielem.
Najważniejsze funkcje:
- Asynchroniczne crawlowanie: Szybkie, wydajne i stworzone do dużych projektów.
- Pełna kontrola kodu: Pisz spider’y w Pythonie, dostosowuj każdy krok i integruj z dowolnym systemem.
- Middleware i pluginy: Rotacja proxy, obsługa logowania i rozszerzenia od społeczności.
- Ustrukturyzowany eksport: Eksport do JSON, CSV, baz danych lub własnych formatów.
Zalety: Darmowy, bardzo elastyczny i wspierany przez ogromną społeczność.
Wady: Wymaga znajomości Pythona, brak GUI, a utrzymanie spoczywa na Tobie.
Dla kogo: Developerzy, data engineerowie i każdy, kto chce wbudować scraping we własne aplikacje lub pipeline'y danych.
6. Apify
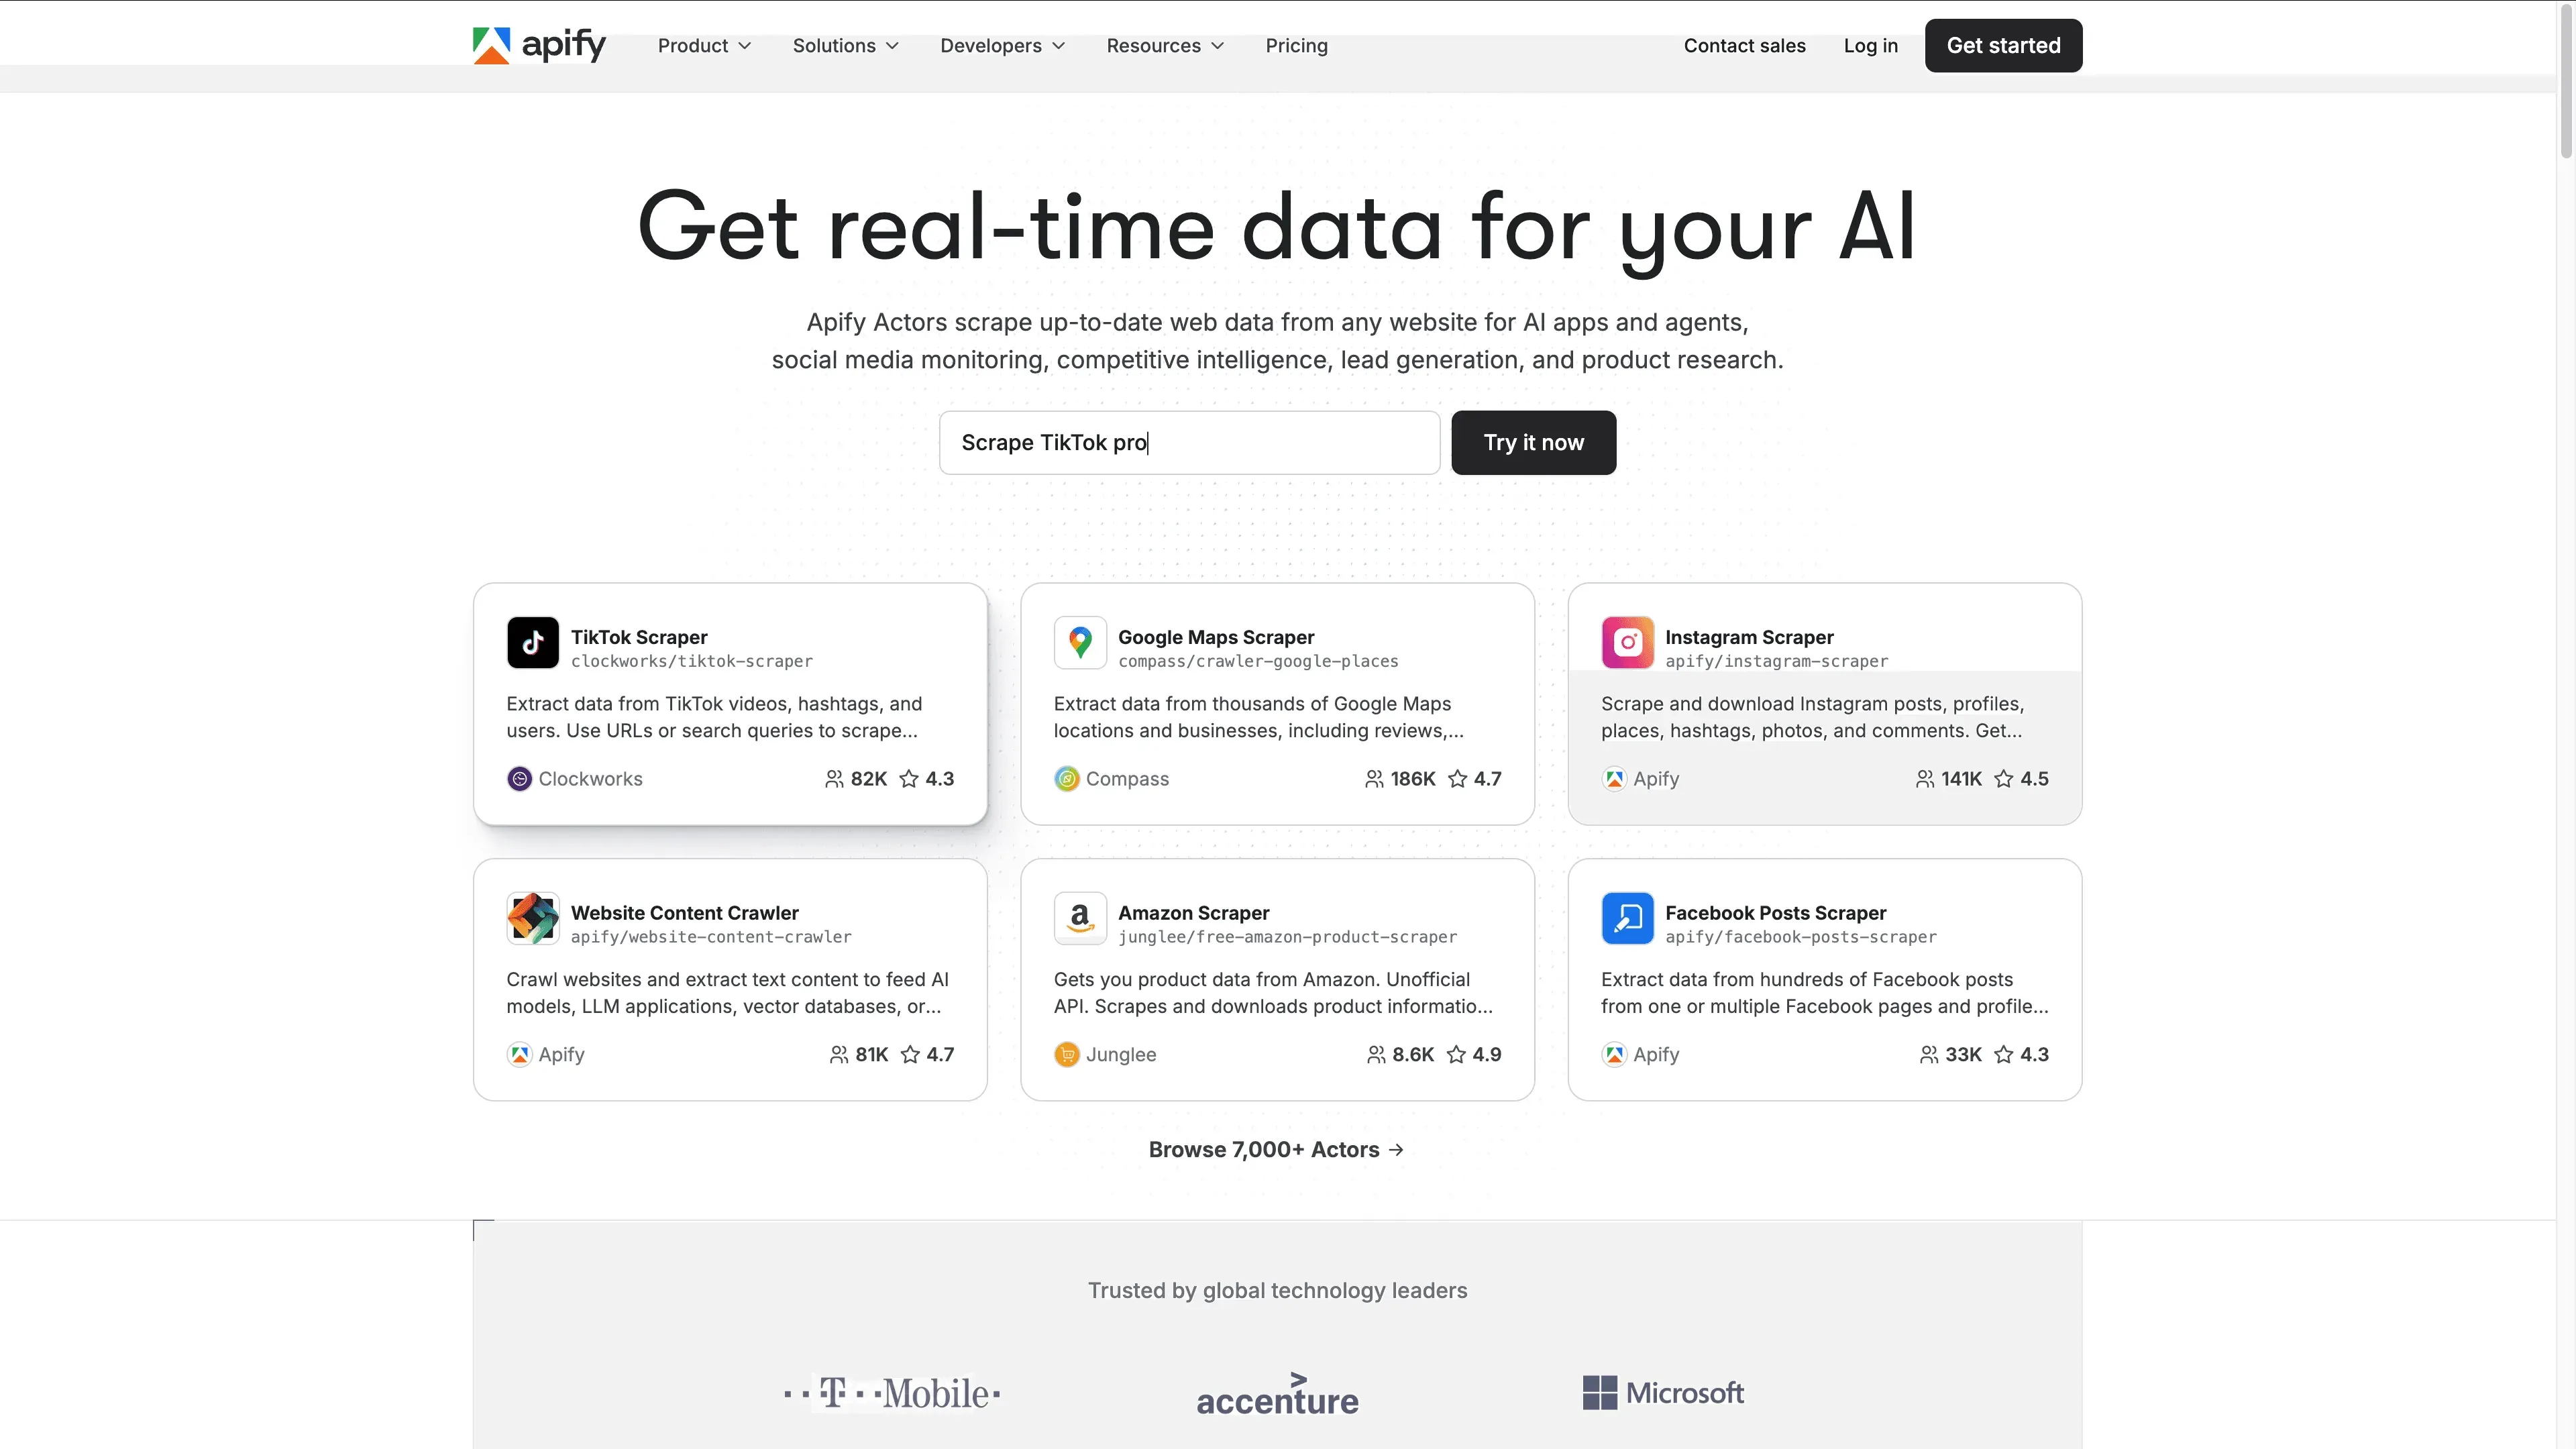 Apify to platforma chmurowa do uruchamiania i udostępniania skryptów scrapujących („Actors”) w JavaScript lub Pythonie. Została stworzona z myślą o automatyzacji, łączeniu workflow i skalowaniu w chmurze.
Najważniejsze funkcje:
- Actors i SDK: Pisz własne skrypty albo korzystaj z gotowych actors z Apify Store.
- Automatyzacja w przeglądarce headless: Scrapuj dynamiczne strony, obsługuj logowania i automatyzuj zadania webowe.
- Łączenie workflow: Uruchamiaj jednego aktora po drugim, automatyzuj wieloetapowe procesy.
- API i integracje: Łącz się z Zapier, Make, Google Drive, AWS i innymi narzędziami.
Zalety: Bardzo mocne dla developerów, skalowalne i świetne do automatyzacji złożonych workflow.
Wady: Do własnych zadań potrzebne jest kodowanie, cennik oparty na użyciu może szybko rosnąć, a próg wejścia nie jest zerowy.
Dla kogo: Startupy, zespoły developerskie i każdy, kto potrzebuje chmurowego, zautomatyzowanego scrapingu na dużą skalę.
7. Dexi.io
 Dexi.io (dawniej CloudScrape) to platforma klasy enterprise do automatyzacji zbierania i integracji danych. Chodzi w niej o budowanie kompletnych workflow — od ekstrakcji po transformację i dostarczenie danych.
Najważniejsze funkcje:
- Wizualny projektant robotów: Buduj wieloetapowe workflow metodą „kliknij i wybierz”.
- Uruchamianie w chmurze i harmonogramy: Odpalaj roboty w chmurze, planuj regularne zadania i obsługuj duże wolumeny.
- Przetwarzanie i integracja danych: Czyść, przekształcaj i eksportuj dane do CRM-ów, baz danych lub API.
- Funkcje enterprise: Zarządzanie użytkownikami, zgodność i opcje lokalnego wdrożenia.
Zalety: Skalowalne, bardzo mocne w złożonych workflow i świetnie integruje się z innymi systemami.
Wady: Cennik enterprise, nie dla początkujących i wymaga szkolenia przy zaawansowanym użyciu.
Dla kogo: Duże organizacje, zespoły analiz retailowych i każdy, kto automatyzuje wieloetapowe pipeline'y danych.
8. WebHarvy
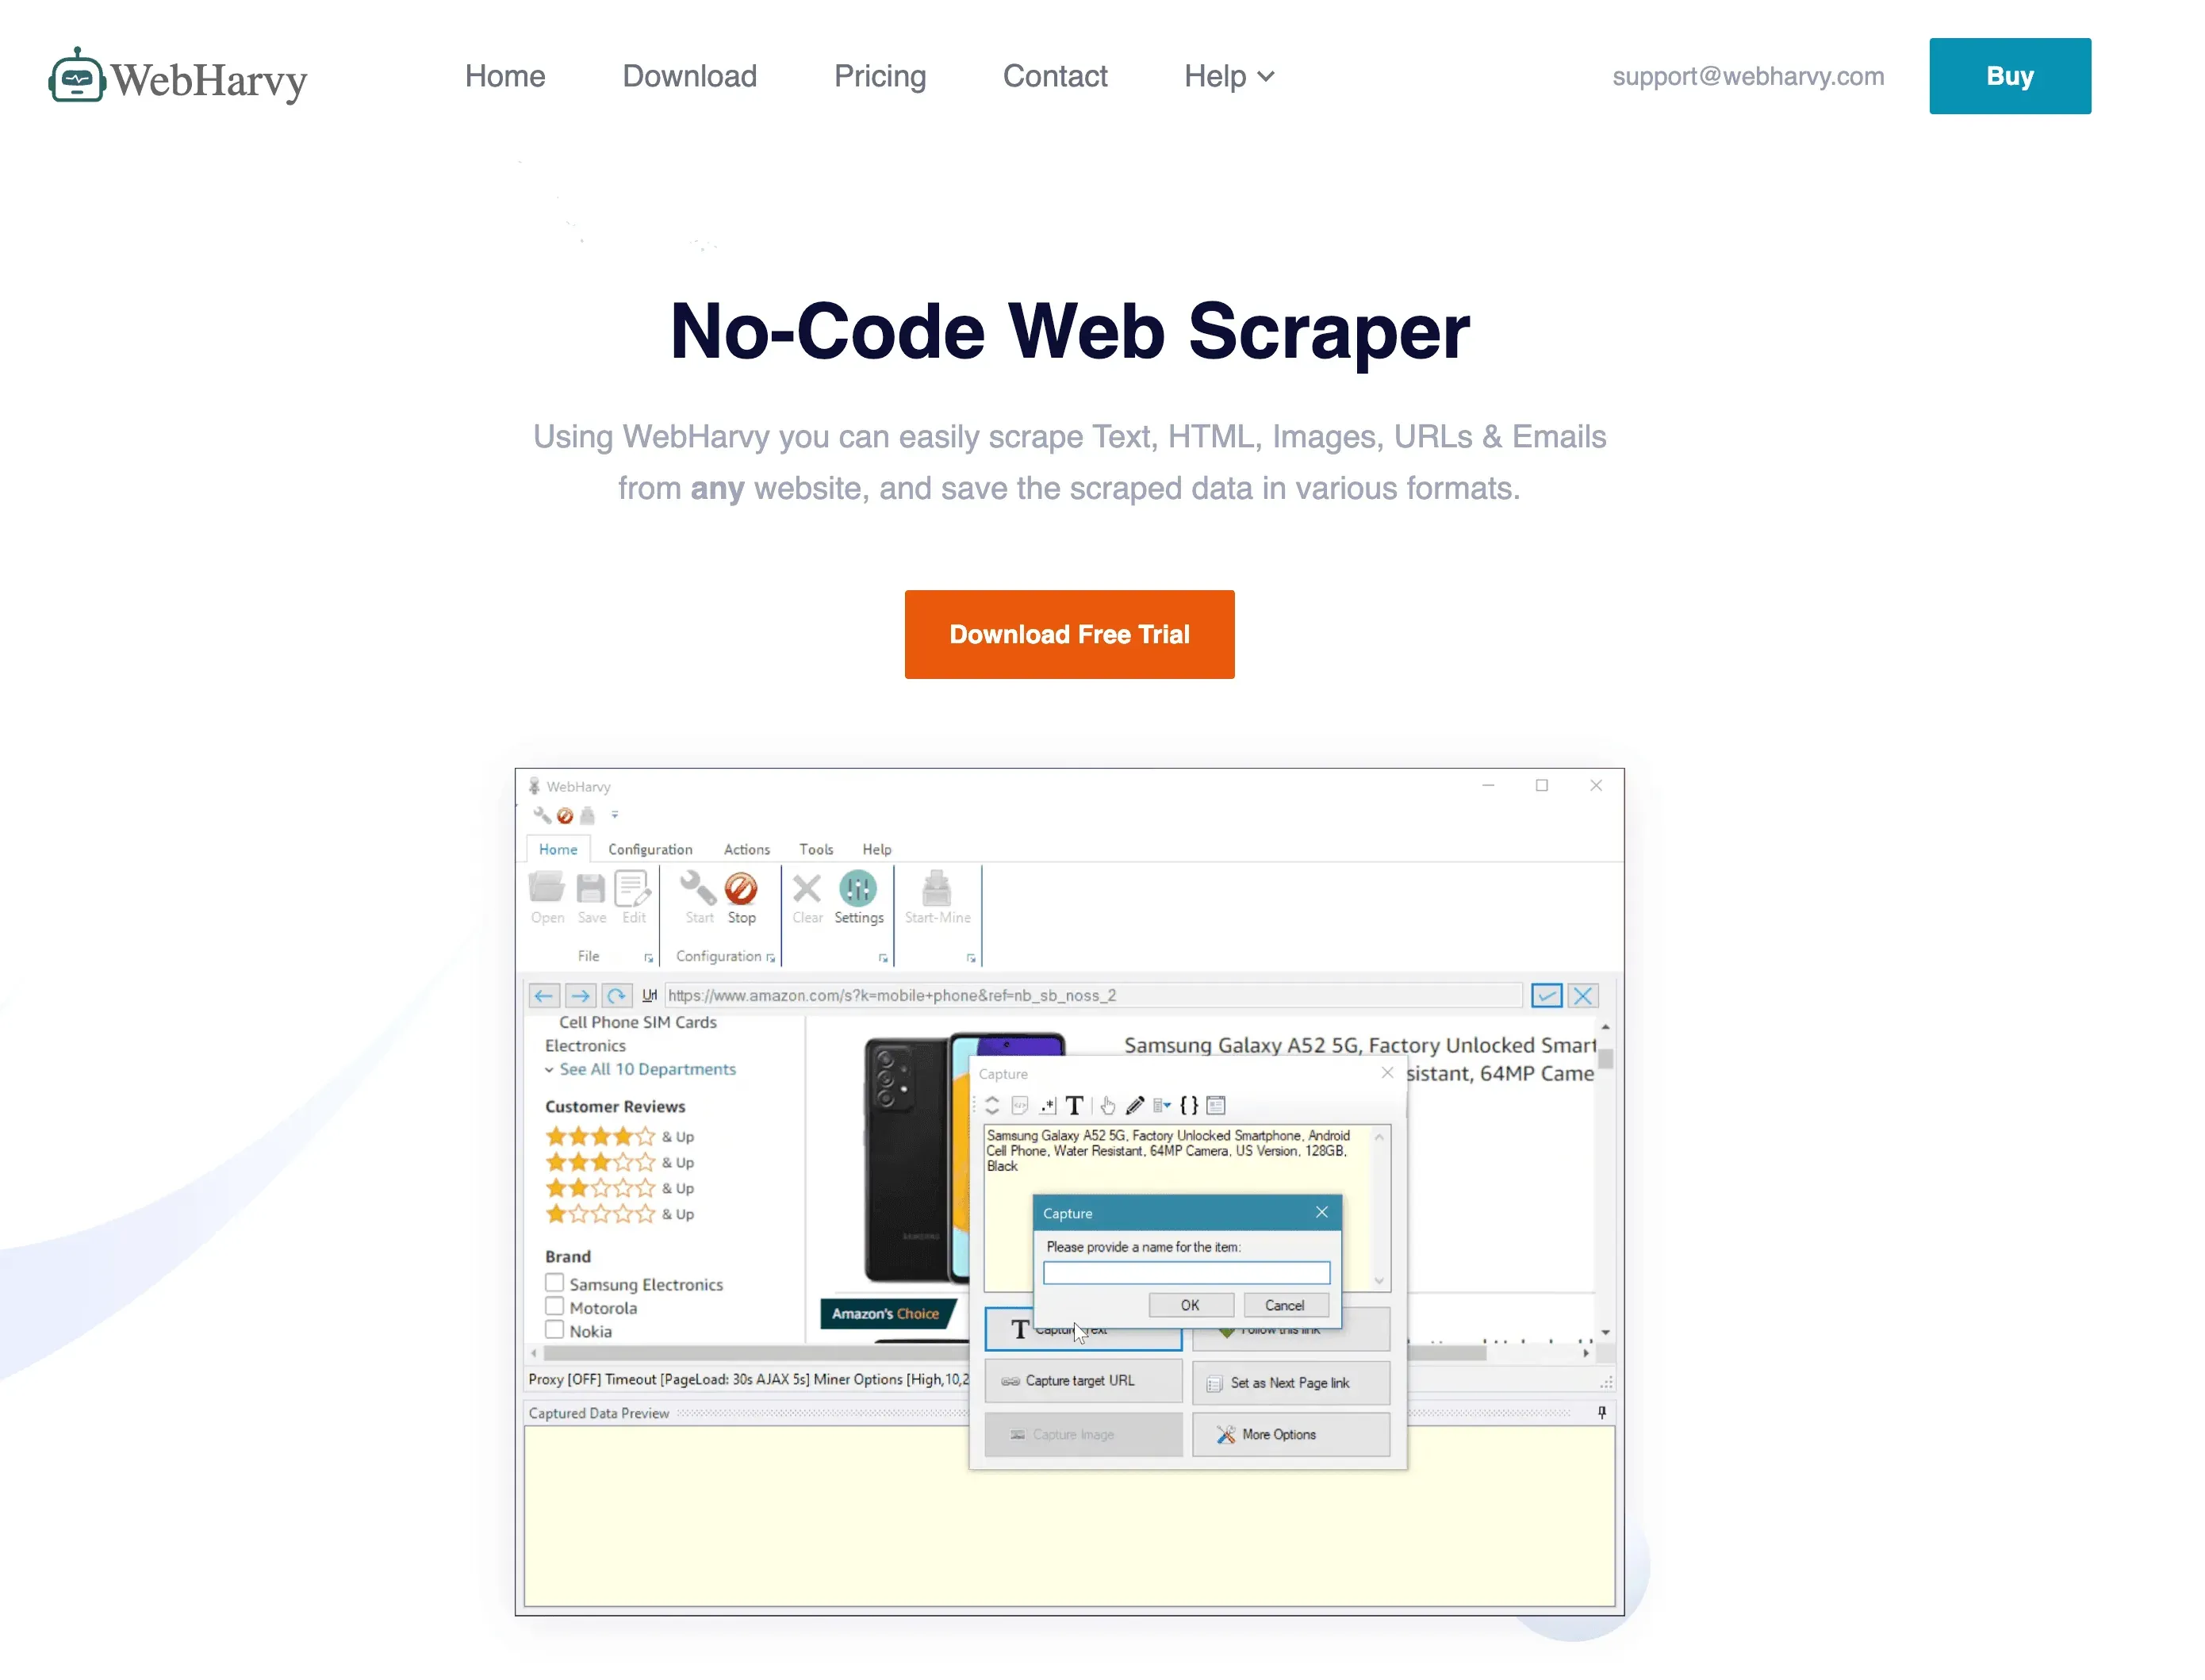 WebHarvy to scraper na Windowsa, znany z prostoty typu „kliknij i wybierz” oraz modelu licencji jednorazowej.
Najważniejsze funkcje:
- Wybór wizualny: Klikaj elementy w wbudowanej przeglądarce, aby definiować pola.
- Automatyczne wykrywanie wzorców: Samodzielnie rozpoznaje listy i tabele.
- Pobieranie obrazów i plików: Ekstrahuje obrazy i dokumenty, nie tylko tekst.
- Harmonogramy: Automatyzacja uruchomień przez Windows Task Scheduler.
Zalety: Przystępny koszt jednorazowy, łatwy dla prostych stron i działa offline.
Wady: Ma problemy z ciężkim JavaScriptem i stronami z zabezpieczeniami anty-bot, działa tylko na Windowsie i ma ograniczone zaawansowane możliwości konfiguracji.
Dla kogo: Małe firmy, badacze i każdy, kto chce budżetowego, bezproblemowego scrapera do statycznych stron.
9. Data Miner
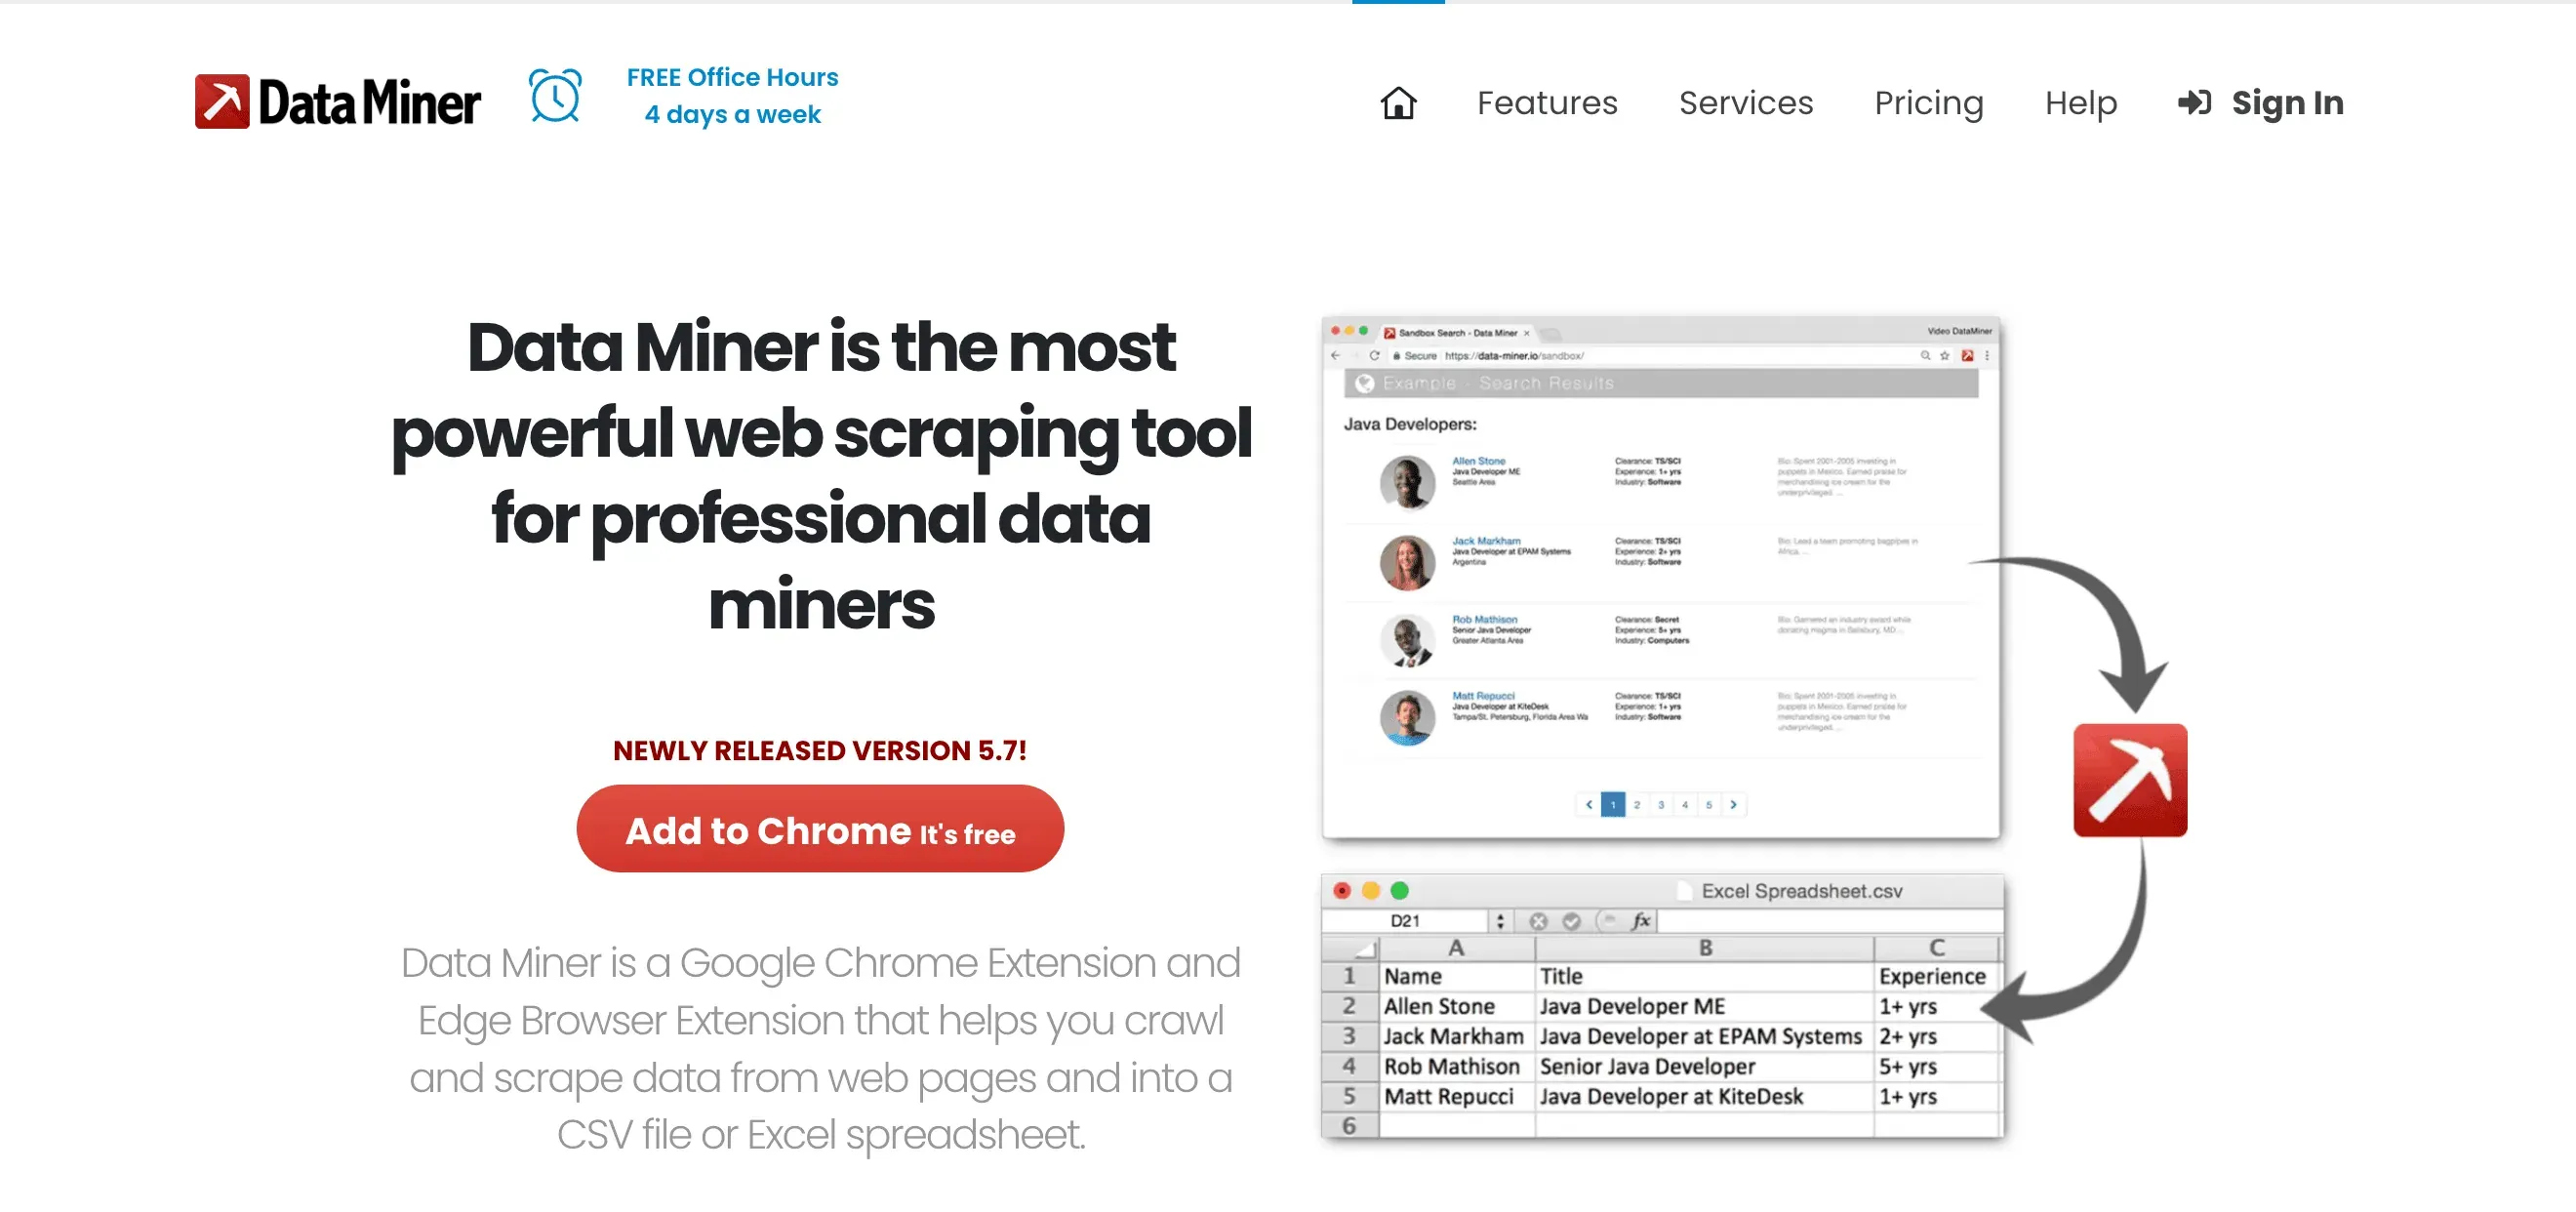 Data Miner to rozszerzenie Chrome/Edge idealne do szybkiej ekstrakcji danych z sieci opartej na szablonach — szczególnie dla zespołów sprzedaży i operacji.
Najważniejsze funkcje:
- Ponad 50 000 publicznych recipes: Scrapowanie popularnych stron jednym kliknięciem.
- Kreator recipes metodą „kliknij i wybierz”: Twórz własne reguły ekstrakcji.
- Natychmiastowe pobieranie tabel: Zbieraj tabele HTML lub listy w kilka sekund.
- Bezpośredni eksport: Wysyłaj dane do Google Sheets, Excel lub CSV.
Zalety: Szybki, działa w przeglądarce, bez kodowania i świetny do stron wymagających logowania.
Wady: Ograniczony przez szybkość przeglądarki, limity stron w planach darmowych i płatnych, nie jest idealny do bardzo dużych zadań.
Dla kogo: Prospecting sprzedażowy, szybkie zadania badawcze i każdy, kto chce przycisku „Eksportuj do Excel” dla internetu.
10. Helium Scraper
 Helium Scraper to aplikacja na Windowsa, która łączy prostotę drag-and-drop z głęboką możliwością dostosowania.
Najważniejsze funkcje:
- Model Kinds i Actions: Definiuj wzorce danych wizualnie, a potem ustawiaj działania do ekstrakcji.
- Dane wielopoziomowe i relacyjne: Twórz relacje rodzic-dziecko, uruchamiaj zapytania SQL na zeskrobanych danych.
- Własne skrypty: Wstawiaj JavaScript lub SQL dla bardziej zaawansowanej logiki.
- Wielowątkowość: Scrapuj wiele stron równolegle, aby przyspieszyć pracę.
Zalety: Elastyczny, obsługuje złożone struktury danych i ma przystępną jednorazową cenę.
Wady: Krzywa uczenia się związana z pojęciem „Kinds”, działa tylko na Windowsie i ma mniej popularne wsparcie.
Dla kogo: Analitycy i entuzjaści technologii, którzy chcą większej mocy niż podstawowe narzędzia „kliknij i wybierz”, ale nie są jeszcze gotowi pisać kodu od zera.
Który ekstraktor danych będzie dla Ciebie najlepszy? Przykłady zastosowań i rekomendacje
- Generowanie leadów sprzedażowych: Thunderbit (AI, łatwy eksport), Data Miner (przeglądarkowy, szybkie recipes).
- Monitorowanie eCommerce: Octoparse (szablony, harmonogramy), Dexi.io (enterprise, integracje).
- Zaawansowane dostosowanie techniczne: Scrapy (Python, open-source), Apify (chmura, automatyzacja workflow), ParseHub (wizualny, dynamiczne strony).
- Integracja danych i automatyzacja: Import.io (workflow BI).
- Szybkie, małe zadania: WebHarvy (kliknij i wybierz, jednorazowy koszt), Helium Scraper (drag-and-drop, własna logika).
Wskazówka: Większość narzędzi oferuje darmowe wersje próbne lub plany — przetestuj kilka na swoich realnych danych, zanim podejmiesz decyzję.
Czym jest data scraping i jak go robić w 2025 roku Get Started Free
Podsumowanie: odblokuj maksymalną efektywność dzięki odpowiedniemu ekstraktorowi danych
Czasy ręcznego żonglowania danymi są policzone. Dzięki właściwemu ekstraktorowi możesz zautomatyzować godziny żmudnej pracy, zwiększyć dokładność i podejmować lepsze decyzje — niezależnie od tego, czy jesteś solo founderem, zespołem sprzedaży, czy menedżerem operacyjnym w Fortune 500. Kluczem jest dopasowanie narzędzia do zastosowania, komfortu technicznego i budżetu.
Jeśli szukasz najszybszej drogi od „potrzebuję tych danych” do „mam je w arkuszu”, Thunderbit to świetny punkt startowy. Ale niezależnie od potrzeb, na tej liście znajdziesz narzędzie, które pomoże Ci pracować mądrzej, a nie ciężej.
Gotowy, by wejść na wyższy poziom pracy z danymi? Wypróbuj kilka z tych ekstraktorów i zobacz, ile czasu — i nerwów — możesz zaoszczędzić.
Pobierz rozszerzenie Thunderbit do Chrome
FAQ
1. Czym jest ekstraktor danych i dlaczego go potrzebuję?
Ekstraktor danych to narzędzie, które automatyzuje zbieranie ustrukturyzowanych informacji ze stron internetowych, dokumentów lub baz danych. Oszczędza czas, ogranicza błędy i pozwala skupić się na analizie zamiast na ręcznym kopiowaniu.
2. Który ekstraktor danych jest najlepszy dla osób nietechnicznych?
Thunderbit wyróżnia się konfiguracją opartą na AI, działającą w 2 kliknięciach, oraz promptami w naturalnym języku. Został zaprojektowany dla użytkowników biznesowych, którzy chcą wyników bez kodowania i skomplikowanej konfiguracji.
3. Czy ekstraktory danych radzą sobie z dynamicznymi stronami lub witrynami opartymi na JavaScript?
Tak — narzędzia takie jak ParseHub, Apify i Scrapy (z obsługą headless browser) świetnie sprawdzają się przy scrapowaniu dynamicznej treści i interaktywnych witryn.
4. Jak wybrać między darmowym a płatnym ekstraktorem danych?
Darmowe narzędzia są świetne do małych, okazjonalnych zadań. Przy stałych, dużych lub krytycznych procesach płatne plany oferują więcej funkcji, wyższe limity i lepsze wsparcie. Zawsze zacznij od darmowego okresu próbnego, aby sprawdzić dopasowanie.
5. Czy używanie ekstraktorów danych jest legalne?
Zasadniczo pobieranie publicznie dostępnych danych jest legalne, ale zawsze sprawdź regulamin strony i respektuj przepisy o prywatności. W przypadku danych wrażliwych lub osobowych upewnij się, że działasz zgodnie z przepisami, takimi jak RODO.
Chcesz więcej wskazówek o web scrapingu, automatyzacji i produktywności? Sprawdź blog Thunderbit, gdzie znajdziesz szczegółowe poradniki, tutoriale i najnowsze informacje o ekstrakcji danych wspieranej przez AI.
Dowiedz się więcej
- Jak zeskrobać dane z PDF za pomocą AI
- Jak wyciągnąć dane ze strony internetowej: poradnik dla początkujących
- Jak wyciągać dane ze strony internetowej za pomocą Thunderbit
- Top 12 darmowych narzędzi do scrapowania danych w 2025 roku
Wypróbuj AI Web Scraper Get Started Free




