
Internet nie jest już tylko cyfrowym placem zabaw — to największy magazyn danych na świecie, a każdy, od zespołów sprzedaży po analityków rynku, chce z niego korzystać. Bądźmy szczerzy: ręczne zbieranie danych z sieci jest mniej więcej tak przyjemne jak składanie mebli z IKEA bez instrukcji (i z dwa razy większą liczbą zbędnych śrubek). Ponieważ firmy coraz bardziej polegają na analizie rynku w czasie rzeczywistym, monitorowaniu cen konkurencji i generowaniu leadów, zapotrzebowanie na wydajne i niezawodne narzędzia do crawlowania danych nigdy nie było większe. W praktyce niemal 85% przedsiębiorstw korzysta dziś z pozyskiwania danych z sieci, aby podejmować decyzje, a globalny rynek web scrapingu ma według prognoz podwoić się do 2030 roku.
Pozyskuj dane z dowolnej strony dzięki AI Get Started Free
Jeśli masz już dość kopiowania i wklejania, tracisz okazje na świeże leady albo po prostu chcesz zobaczyć, co da się osiągnąć, gdy automatyzacja przejmie ciężką pracę, jesteś we właściwym miejscu. Od lat tworzę i testuję narzędzia do pozyskiwania danych z internetu (i tak, prowadzę zespół w Thunderbit), więc wiem z własnego doświadczenia, jak odpowiednie narzędzie potrafi zamienić godziny żmudnej pracy w kilka kliknięć. Niezależnie od tego, czy jesteś osobą nietechniczną i potrzebujesz natychmiastowych rezultatów, czy programistą, który chce mieć pełną kontrolę, ta lista 10 najlepszych narzędzi do crawlowania danych pomoże Ci znaleźć idealne rozwiązanie.
Dlaczego wybór odpowiednich narzędzi do crawlowania danych ma znaczenie
Spójrzmy prawdzie w oczy: różnica między dobrym narzędziem do crawlowania danych a przeciętnym nie sprowadza się tylko do wygody — to bezpośredni wpływ na rozwój biznesu. Gdy automatyzujesz pozyskiwanie danych z sieci, oszczędzasz nie tylko czas (choć jeden z recenzentów G2 twierdził, że oszczędzał „prawdopodobnie 10 godzin tygodniowo”), ale też ograniczasz liczbę błędów, odkrywasz nowe możliwości i masz pewność, że zespół pracuje na najświeższych i najbardziej precyzyjnych danych. Ręczne researchowanie jest powolne, podatne na pomyłki i często nieaktualne, zanim skończysz pracę. Z odpowiednim narzędziem możesz monitorować konkurencję, śledzić ceny lub budować listy leadów w kilka minut — nie w kilka dni.
Dobry przykład: jedna firma kosmetyczna wykorzystywała web scraping do monitorowania stanów magazynowych i cen konkurencji, podnosząc dokładność prognoz do 85% i podwajając przychody w ciągu czterech miesięcy. Tego typu efektu nie da się osiągnąć samymi arkuszami kalkulacyjnymi i ciężką pracą.
Jak ocenialiśmy najlepsze narzędzia do crawlowania danych
Przy tak wielu dostępnych opcjach wybór właściwego narzędzia do crawlowania danych może przypominać szybkie randki na konferencji technologicznej. Oto kryteria, których użyłem, aby odróżnić najlepsze rozwiązania od reszty:
- Łatwość obsługi: Czy można zacząć bez doktoratu z Pythona? Czy jest interfejs wizualny albo wsparcie AI dla osób nietechnicznych?
- Możliwości automatyzacji: Czy narzędzie radzi sobie z paginacją, podstronami, dynamiczną treścią i harmonogramami? Czy może działać w chmurze przy większych zadaniach?
- Cena i skalowalność: Czy jest darmowy plan lub przystępny plan startowy? Jak rośnie koszt wraz z rosnącymi potrzebami danych?
- Zakres funkcji i integracje: Czy można eksportować do Excela, Google Sheets albo przez API? Czy są szablony, harmonogramy lub wbudowane funkcje czyszczenia danych?
- Dla kogo: Dla kogo tak naprawdę jest to narzędzie — użytkowników biznesowych, deweloperów czy zespoły enterprise?
Na końcu dodałem krótką tabelę porównawczą, żeby łatwo zobaczyć, jak wypada każde z narzędzi.
Przejdźmy teraz do 10 najlepszych narzędzi do crawlowania danych do wydajnego pozyskiwania informacji z sieci w 2026 roku.
1. Thunderbit
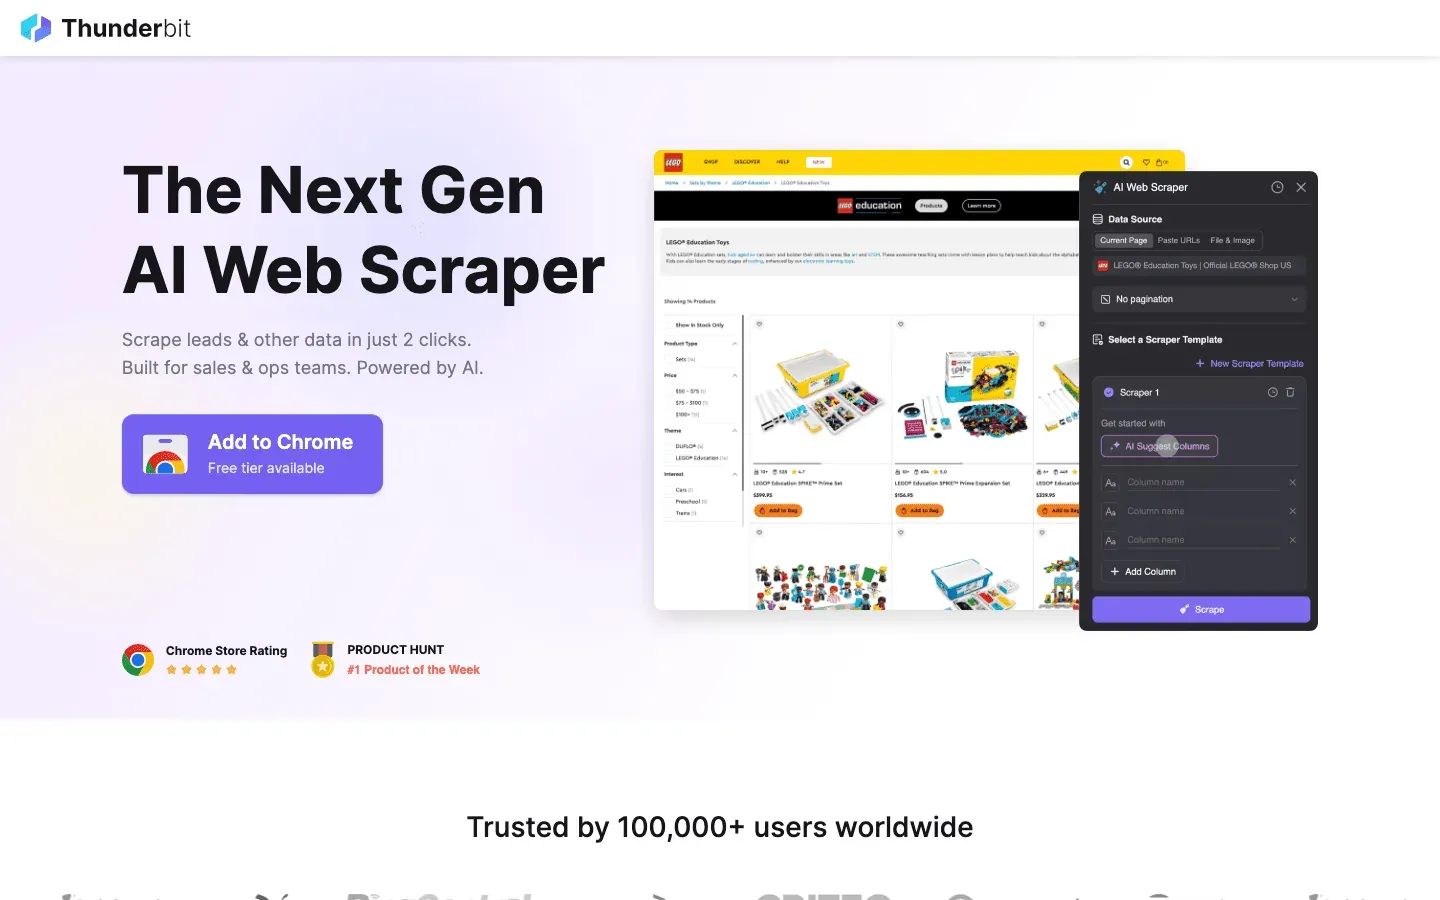 Thunderbit to mój pierwszy wybór dla każdego, kto chce, aby crawlowanie danych było tak proste jak zamawianie jedzenia na wynos. Zbudowany jako rozszerzenie Chrome oparte na AI, Thunderbit stawia na scraping jednym kliknięciem: wystarczy raz kliknąć, a AI przejmuje sterowanie — wie, które elementy strony trafią do tabeli, a które są tylko „dekoracją” strony — i wypełnia wszystko za Ciebie, gdy Ty możesz zająć się czymś ważniejszym. Wolisz bardziej niestandardowe podejście? Po prostu powiedz, jakie dane chcesz pobrać, a narzędzie dopasuje się do Twojego opisu. Bez kodowania, bez dłubania w selektorach — tylko natychmiastowe rezultaty.
Co sprawia, że Thunderbit jest tak chętnie wybierany przez zespoły sprzedaży, marketingu i e-commerce? Jest zaprojektowany pod rzeczywiste procesy biznesowe:
- Kolumny ustawiane automatycznie: Dostajesz listę kolumn bez proszenia — imiona i nazwiska, ceny, e-maile, co tylko chcesz — a jeśli wolisz samemu podyktować listę, narzędzie też to uwzględni.
- Scraping podstron: Potrzebujesz więcej szczegółów? Thunderbit może automatycznie odwiedzać każdą podstronę (np. kartę produktu lub profil LinkedIn) i wzbogacać Twoją tabelę.
- Natychmiastowy eksport: Przesyłaj dane bezpośrednio do Excela, Google Sheets, Airtable lub Notion. Wszystkie eksporty są darmowe.
- Szablony jednym kliknięciem: Dla popularnych serwisów (Amazon, Zillow, Instagram) możesz użyć gotowych szablonów, aby działać jeszcze szybciej.
- Darmowy eksport danych: Nie ma paywalla przy samym wyciąganiu danych.
- Scraping według harmonogramu: Ustaw cykliczne zadania prostym językiem („co poniedziałek o 9:00”) — idealne do monitorowania cen lub cotygodniowej aktualizacji leadów.
Thunderbit korzysta z systemu kredytów (1 kredyt = 1 wiersz, 2 kredyty, gdy wiersz pochodzi z podstrony), a darmowy plan obejmuje do 6 stron (lub 10 z bonusem próbnym). Płatne plany zaczynają się od 15 USD miesięcznie za 500 kredytów, więc jest to rozwiązanie dostępne dla zespołów każdej wielkości.
Jeśli chcesz zobaczyć, jak Thunderbit działa w praktyce, zajrzyj na nasz kanał YouTube albo blog. To narzędzie, które sam chciałbym mieć, gdy tonąłem w ręcznym wprowadzaniu danych.
Wypróbuj Thunderbit za darmo – AI Web Scraper jednym kliknięciem
2. Octoparse
 Octoparse to ciężka artyleria w świecie crawlowania danych, szczególnie dla użytkowników enterprise, którzy potrzebują dużej mocy. Oferuje wizualny interfejs desktopowy (Windows i Mac), w którym możesz budować przepływy ekstrakcji metodą point-and-click — bez kodowania. Ale nie daj się zwieść przyjaznemu UI: pod maską Octoparse obsługuje logowanie, nieskończone przewijanie, rotujące proxy, a nawet rozwiązywanie CAPTCHA.
- 500+ gotowych szablonów: Zacznij szybko dzięki szablonom dla Amazon, Twittera, LinkedIn i wielu innych.
- Scraping w chmurze: Uruchamiaj zadania na serwerach Octoparse, planuj cykle i skaluj większe projekty.
- Dostęp do API: Integruj zebrane dane bezpośrednio z aplikacjami biznesowymi lub bazami danych.
- Zaawansowana automatyzacja: Obsługuje dynamiczną treść, paginację i wieloetapowe procesy.
Darmowy plan obejmuje 10 zadań oraz solidny limit 50 000 wierszy eksportu miesięcznie, więc to prawdziwy plan do pracy — nie tylko wersja demo. Płatne plany zaczynają się od 69 USD miesięcznie za Standard (rozliczenie roczne; ok. 82 USD miesięcznie przy płatności miesięcznej) oraz 249 USD miesięcznie za Professional. Krzywa nauki jest bardziej stroma niż w Thunderbit, ale jeśli potrzebujesz niezawodnie zeskrobywać tysiące stron i zależy Ci na uruchamianiu zadań w chmurze, Octoparse nadal jest jedną z dłużej obecnych i wartą uwagi opcji. Ceny zweryfikowano na podstawie octoparse.com/pricing w dniu 2026-05-13.
3. Scrapy
 Scrapy to złoty standard dla programistów, którzy chcą mieć pełną kontrolę nad projektami crawlowania danych. To framework open-source w Pythonie, który pozwala pisać własne spidery (crawlery) dla dowolnej strony. Jeśli potrafisz to sobie wyobrazić, możesz to zbudować w Scrapy.
- Pełna programowalność: Piszesz kod w Pythonie, aby dokładnie określić, jak ma działać crawling i parsowanie.
- Asynchroniczność i szybkość: Obsługuje tysiące stron równolegle przy dużych projektach.
- Rozszerzalność: Możesz dodać middleware do proxy, headless browserów lub własnej logiki.
- Silna społeczność: Mnóstwo poradników, wtyczek i wsparcia przy trudniejszych przypadkach scrapingu.
Scrapy jest darmowy i open-source, ale wymaga umiejętności programowania. Jeśli masz zespół techniczny albo chcesz zbudować własny pipeline, trudno o lepszy wybór. Dla osób nietechnicznych to jednak spore wyzwanie.
4. ParseHub
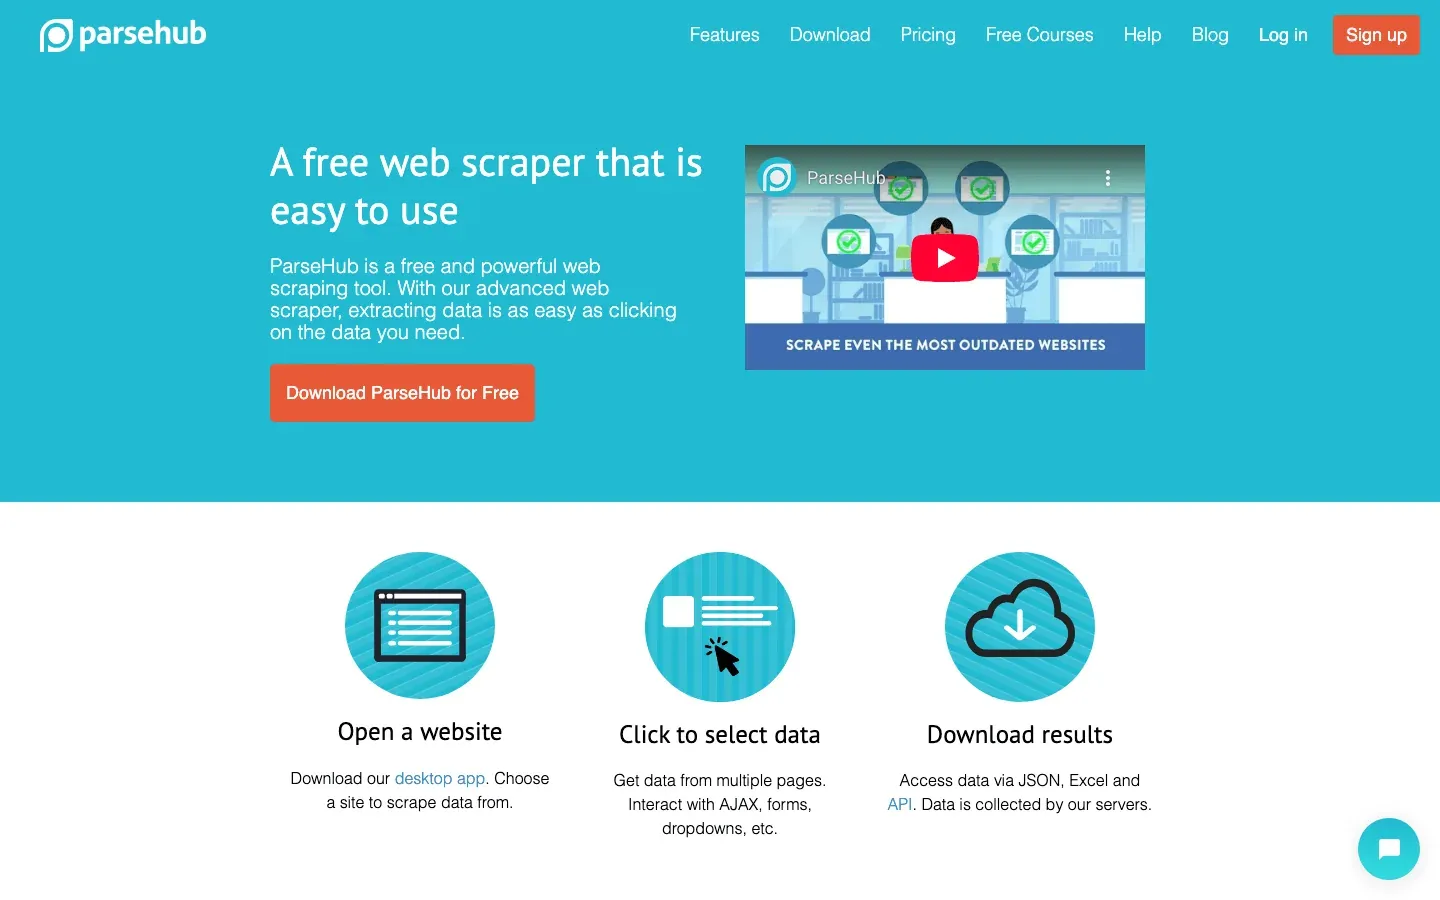 ParseHub to wizualne narzędzie do web scrapingu bez kodu, idealne dla osób nietechnicznych mierzących się ze złożonymi stronami. Interfejs point-and-click pozwala zaznaczać elementy, definiować działania i budować procesy scrapingu — nawet dla stron z dynamiczną treścią lub skomplikowaną nawigacją.
- Wizualny kreator workflow: Klikasz, by wybrać dane, ustawić paginację i obsłużyć wyskakujące okna lub listy rozwijane.
- Obsługa dynamicznej treści: Działa z witrynami opartymi mocno na JavaScript i interaktywnymi stronami.
- Uruchamianie w chmurze i harmonogramy: Uruchamiaj scraping w chmurze i planuj cykliczne zadania.
- Eksport do CSV, Excela lub przez API: Łatwa integracja z ulubionymi narzędziami.
ParseHub oferuje darmowy plan (5 projektów), a płatne zaczynają się od ok. 189 USD/miesiąc. Jest nieco droższy niż część konkurencji, ale wizualne podejście sprawia, że jest przystępny dla analityków, marketerów i badaczy, którzy potrzebują czegoś więcej niż zwykłego rozszerzenia Chrome.
5. Apify
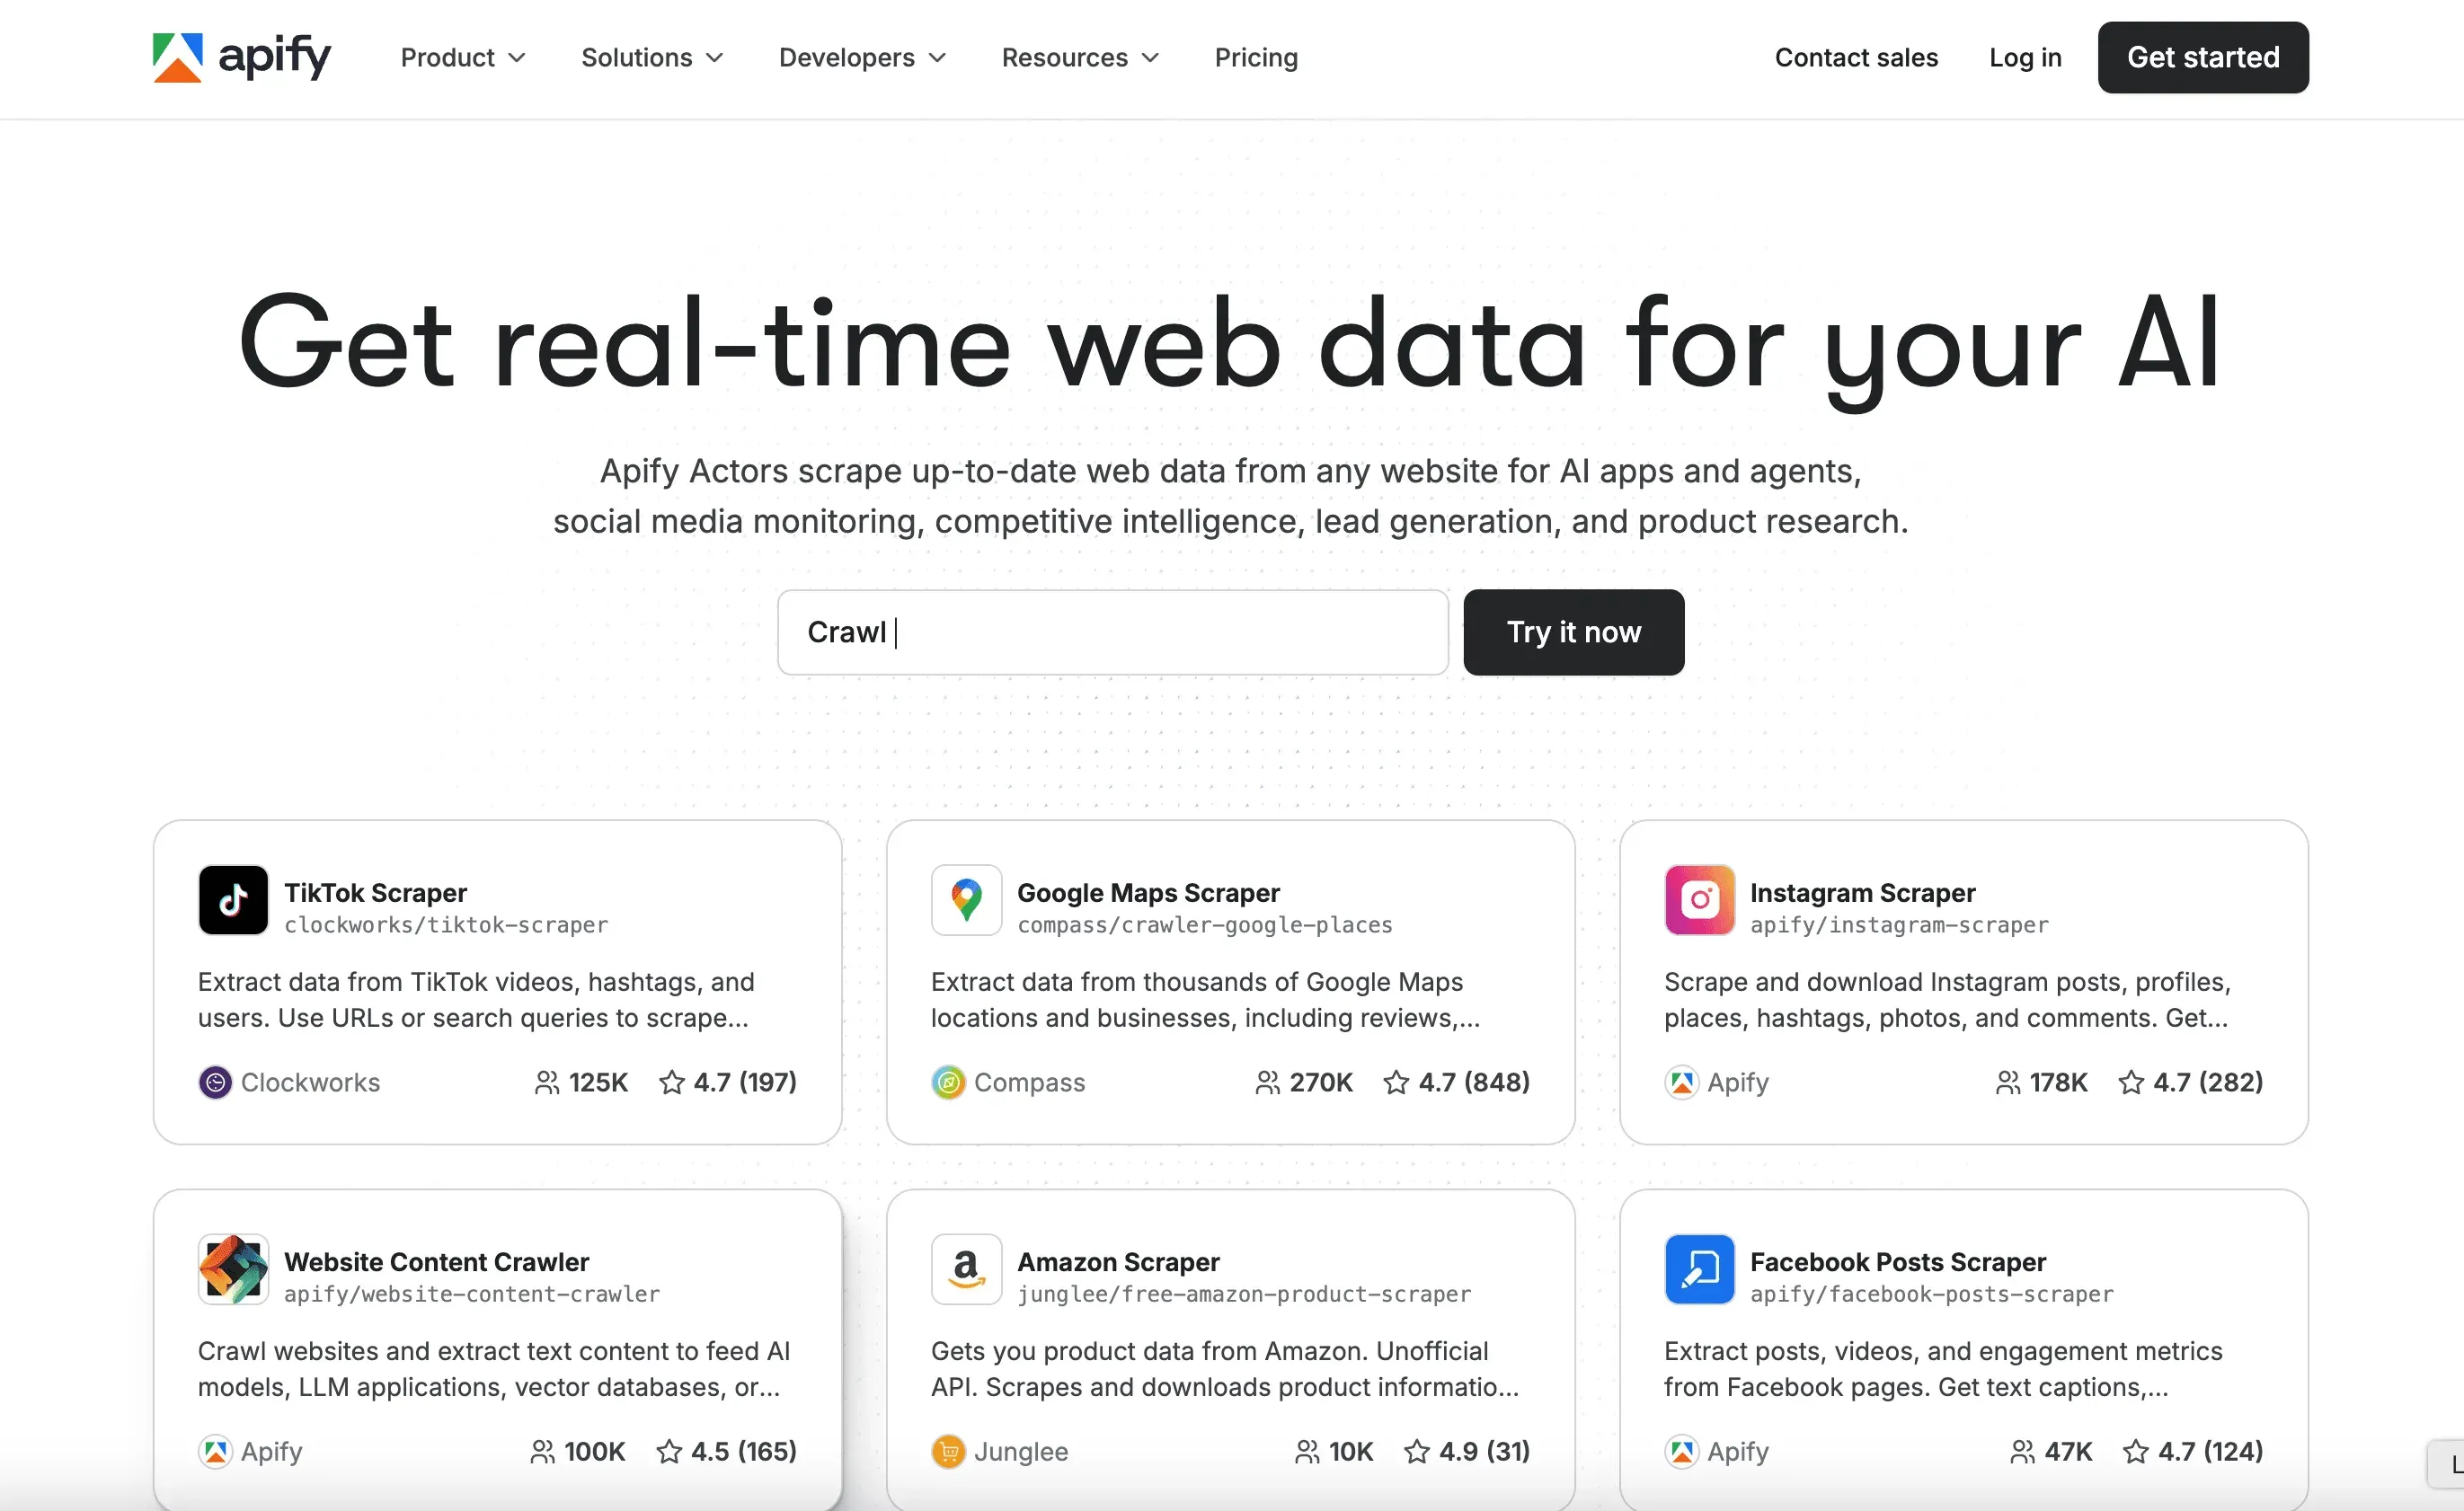 Apify to jednocześnie platforma i marketplace do crawlowania danych. Oferuje ogromną bibliotekę gotowych „Actorów” (gotowych scraperów) dla popularnych stron, a także możliwość budowania i uruchamiania własnych crawlerów w chmurze.
- Ponad 5000 gotowych Actorów: Błyskawicznie pozyskuj dane z Google Maps, Amazon, Twittera i wielu innych źródeł.
- Własne skrypty: Deweloperzy mogą używać JavaScriptu lub Pythona do budowy zaawansowanych crawlerów.
- Skalowanie w chmurze: Uruchamiaj zadania równolegle, planuj harmonogramy i zarządzaj danymi w chmurze.
- API i integracje: Podłącz wyniki do aplikacji, workflowów lub pipeline’ów danych.
Apify daje 5 USD darmowego kredytu na start, a potem przechodzi do planów Starter za 29 USD/miesiąc, Scale za 199 USD/miesiąc i Business za 999 USD/miesiąc — każdy poziom to „kredyt platformy + płatność za jednostki obliczeniowe”, więc to faktyczne użycie napędza rachunek. Krzywa nauki jest tu odrobinę bardziej stroma, ale jeśli chcesz mieć zarówno gotowe actory „plug-and-play”, jak i możliwość pisania własnych crawlerów w JS lub Pythonie, Apify należy do najmocniejszych opcji na tej liście. Ceny zweryfikowano na podstawie apify.com/pricing w dniu 2026-05-13.
6. Data Miner
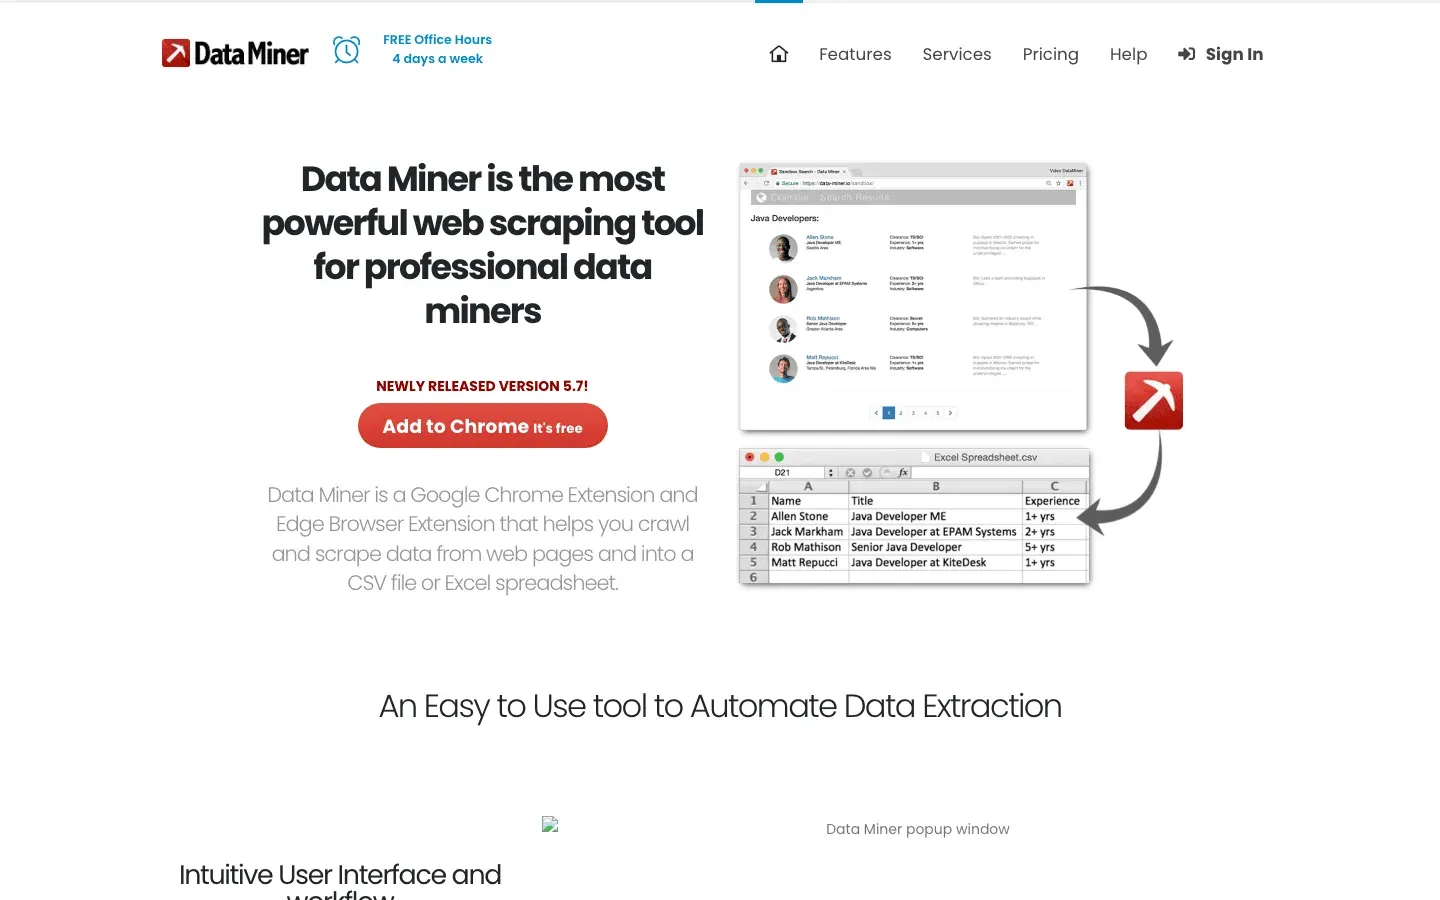 Data Miner to rozszerzenie Chrome stworzone do szybkiego, szablonowego crawlowania danych. Jest idealne dla użytkowników biznesowych, którzy chcą pobierać dane z tabel lub list bez żadnej konfiguracji.
- Ogromna biblioteka szablonów: Ponad tysiąc gotowych „przepisów” dla popularnych serwisów (LinkedIn, Yelp itd.).
- Ekstrakcja point-and-click: Wybierasz szablon, podglądasz dane i od razu eksportujesz.
- Działa w przeglądarce: Korzysta z bieżącej sesji — świetne rozwiązanie do scrapingu po zalogowaniu.
- Eksport do CSV lub Excela: Przeniesiesz dane do arkusza w kilka sekund.
Darmowy plan obejmuje 500 stron miesięcznie, a płatne plany startują od 20 USD miesięcznie. Najlepiej sprawdza się przy małych, jednorazowych zadaniach albo wtedy, gdy dane są potrzebne natychmiast — nie oczekuj jednak, że poradzi sobie z ogromnymi projektami czy złożoną automatyzacją.
7. Import.io
 Import.io to platforma klasy enterprise dla organizacji, które potrzebują ciągłej i niezawodnej integracji danych z sieci. To coś więcej niż crawler — to zarządzana usługa, która dostarcza czyste, ustrukturyzowane dane bezpośrednio do systemów biznesowych.
- Ekstrakcja bez kodu: Wizualna konfiguracja tego, jakie dane mają być pobrane.
- Strumienie danych w czasie rzeczywistym: Przesyłanie danych do dashboardów, narzędzi analitycznych lub baz danych.
- Zgodność i niezawodność: Obsługuje rotację IP, mechanizmy anty-bot i zgodność prawną.
- Usługi zarządzane: Zespół Import.io może skonfigurować i utrzymywać Twoje scrapery.
Cennik jest indywidualny i zależny od wolumenu, a platforma SaaS oferuje 14-dniowy darmowy okres próbny. Jeśli Twój biznes opiera się na zawsze aktualnych danych z sieci (np. handel detaliczny, finanse lub badania rynku), Import.io zdecydowanie warto rozważyć.
8. WebHarvy
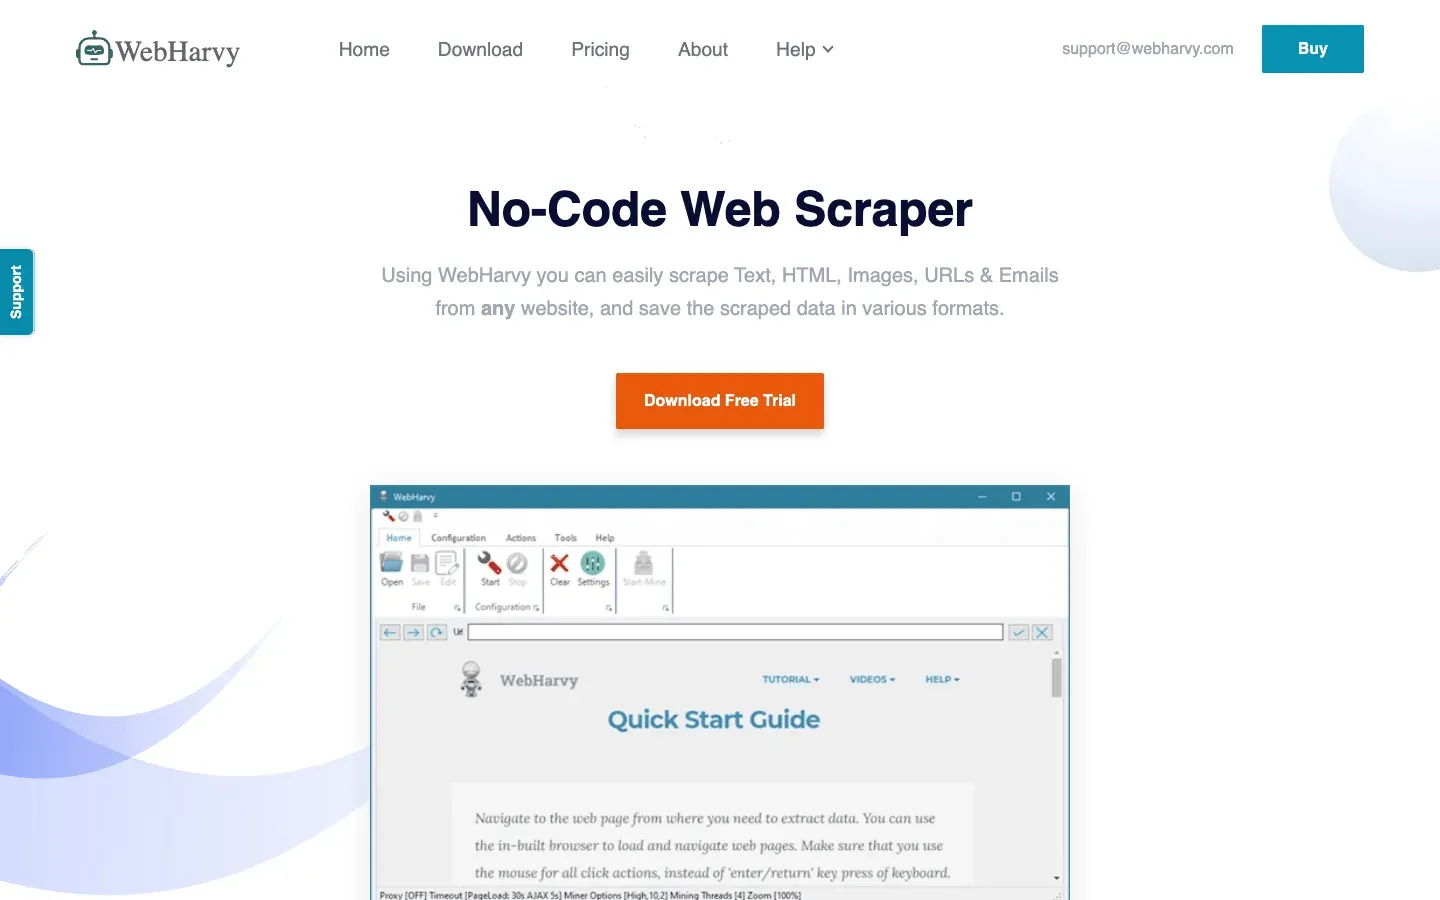 WebHarvy to desktopowy scraper dla użytkowników Windows, którzy chcą rozwiązania point-and-click bez abonamentu. Jest szczególnie popularny wśród małych firm i osób prywatnych preferujących jednorazowy zakup.
- Wizualne wykrywanie wzorców: Klikasz elementy danych, a WebHarvy automatycznie wykrywa powtarzające się schematy.
- Obsługa tekstu, obrazów i więcej: Pozyskuje wszystkie popularne typy danych, w tym e-maile i adresy URL.
- Paginacja i harmonogramy: Nawigacja po wielostronicowych serwisach i ustawianie cyklicznych uruchomień.
- Eksport do Excela, CSV, XML, JSON lub SQL: Elastyczny format wyjściowy dla każdego workflow.
Licencja dla jednego użytkownika kosztuje około 99 USD jednorazowo (dożywotnio), co czyni ją opłacalnym wyborem do regularnego użycia — trzeba tylko pamiętać, że działa wyłącznie na Windows.
9. Mozenda
 Mozenda to platforma do crawlowania danych w chmurze, stworzona z myślą o operacjach biznesowych i stałych potrzebach danych. Łączy desktopowy kreator (Windows) z wydajnym uruchamianiem w chmurze i automatyzacją.
- Wizualny kreator agentów: Projektowanie procesów ekstrakcji metodą point-and-click.
- Skalowanie w chmurze: Uruchamianie wielu agentów równolegle, planowanie zadań i centralne zarządzanie danymi.
- Konsola zarządzania danymi: Łączenie, filtrowanie i czyszczenie zbiorów po ekstrakcji.
- Wsparcie enterprise: Dedykowani opiekunowie kont i usługi zarządzane dla dużych zespołów.
Samodzielny plan Pilot w Mozenda kosztuje 500 USD miesięcznie (5000 kredytów przetwarzania, 10 agentów, 10 GB przestrzeni), a plan Enterprise wymaga wyceny indywidualnej. Dostępny jest też 14-dniowy darmowy Trial z 500 kredytami, jeśli chcesz najpierw przetestować rozwiązanie. Mozenda najlepiej sprawdza się w firmach, które chcą niezawodnych i powtarzalnych danych z sieci w codziennej pracy — tu ceny są realne, a platforma zakłada, że potraktujesz ją serio. Ceny zweryfikowano na podstawie mozenda.com/pricing w dniu 2026-05-13.
10. BeautifulSoup
 BeautifulSoup to klasyczna biblioteka Pythona do parsowania HTML i XML. Nie jest pełnym crawlerem, ale programiści bardzo ją cenią przy małych, niestandardowych projektach scrapingu.
- Proste parsowanie HTML: Łatwe wyciąganie danych ze statycznych stron.
- Współpracuje z Python Requests: Można łączyć z innymi bibliotekami do pobierania i crawlowania.
- Elastyczna i lekka: Idealna do szybkich skryptów lub projektów edukacyjnych.
- Ogromna społeczność: Mnóstwo poradników i odpowiedzi na Stack Overflow.
BeautifulSoup jest darmowy i open-source, ale musisz samodzielnie napisać kod i logikę crawlowania. Najlepiej nadaje się dla programistów lub osób uczących się, które chcą zrozumieć, jak web scraping działa od środka.
Tabela porównawcza: narzędzia do crawlowania danych w skrócie
| Narzędzie | Łatwość użycia | Poziom automatyzacji | Cena | Opcje eksportu | Dla kogo najlepsze |
|---|---|---|---|---|---|
| Thunderbit | Bardzo łatwe, bez kodu | Wysoki (AI, podstrony) | Darmowy okres próbny, od 15 USD/mies. | Excel, Sheets, Airtable, Notion, CSV | Sprzedaż, marketing, e-commerce, osoby nietechniczne |
| Octoparse | Średnia, UI wizualny | Bardzo wysoki, chmura | Darmowy, 69–249 USD/mies. | CSV, Excel, JSON, API | Enterprise, zespoły danych, dynamiczne strony |
| Scrapy | Niska (wymaga Pythona) | Wysoki (konfigurowalny) | Darmowy, open-source | Dowolne (przez kod) | Deweloperzy, duże projekty niestandardowe |
| ParseHub | Wysoka, wizualna | Wysoki (dynamiczne strony) | Darmowy, od 189 USD/mies. | CSV, Excel, JSON, API | Osoby nietechniczne, złożone struktury stron |
| Apify | Średnia, elastyczna | Bardzo wysoki, chmura | Darmowy, 29–999 USD/mies. | CSV, JSON, API, storage w chmurze | Deweloperzy, firmy, gotowe lub własne actory |
| Data Miner | Bardzo łatwe, w przeglądarce | Niski (manualny) | Darmowy, 20–99 USD/mies. | CSV, Excel | Szybkie, jednorazowe ekstrakcje, małe zbiory danych |
| Import.io | Średnia, zarządzane | Bardzo wysoki, enterprise | Indywidualna, zależna od wolumenu | CSV, JSON, API, bezpośrednie integracje | Enterprise, ciągła integracja danych |
| WebHarvy | Wysoka, desktop | Średni (harmonogramy) | 99 USD jednorazowo | Excel, CSV, XML, JSON, SQL | MŚP, użytkownicy Windows, regularny scraping |
| Mozenda | Średnia, wizualna | Bardzo wysoki, chmura | Pilot 500 USD/mies. | CSV, Excel, JSON, chmura, DB | Ciągłe, duże operacje biznesowe |
| BeautifulSoup | Niska (wymaga Pythona) | Niski (ręczne kodowanie) | Darmowy, open-source | Dowolne (przez kod) | Deweloperzy, osoby uczące się, małe skrypty własne |
Jak wybrać odpowiednie narzędzie do crawlowania danych dla Twojego zespołu
Czym jest web scraping i jak go zrobić w 2026 roku Get Started Free
Wybór najlepszego narzędzia do crawlowania danych nie polega na znalezieniu „najmocniejszego” — chodzi o to, by dopasować je do umiejętności, potrzeb i budżetu zespołu. Oto moja krótka rekomendacja:
- Osoby nietechniczne lub użytkownicy biznesowi: Zacznij od Thunderbit, ParseHub lub Data Miner, jeśli zależy Ci na szybkim efekcie i prostej konfiguracji.
- Potrzeby enterprise lub duża skala: Sprawdź Octoparse, Mozenda lub Import.io pod kątem automatyzacji, harmonogramów i wsparcia.
- Deweloperzy lub projekty niestandardowe: Scrapy, Apify lub BeautifulSoup dają pełną kontrolę i elastyczność.
- Ograniczony budżet lub jednorazowe zadania: WebHarvy (Windows) albo Data Miner (przeglądarka) są ekonomiczne i proste.
Zawsze testuj najlepsze opcje na swoich rzeczywistych docelowych stronach w darmowym okresie próbnym — to, co działa na jednej witrynie, niekoniecznie zadziała na innej. I nie zapomnij o integracji: jeśli potrzebujesz danych w Sheets, Notion lub bazie danych, upewnij się, że narzędzie obsługuje to od razu.
Podsumowanie: jak odblokować wartość biznesową dzięki najlepszym narzędziom do crawlowania danych
Dane z sieci to nowa ropa naftowa — ale tylko wtedy, gdy masz odpowiednie narzędzia do ich wydobycia i przetworzenia. Dzięki nowoczesnym narzędziom do crawlowania danych możesz zamienić godziny ręcznego researchu w minuty zautomatyzowanych wniosków — i wesprzeć mądrzejszą sprzedaż, skuteczniejszy marketing oraz bardziej elastyczne operacje. Niezależnie od tego, czy tworzysz listy leadów, śledzisz konkurencję, czy po prostu masz dość kopiowania i wklejania, na tej liście znajdziesz narzędzie, które znacząco ułatwi Ci pracę.
Sprawdź więc potrzeby swojego zespołu, przetestuj kilka z tych narzędzi i zobacz, ile więcej możesz osiągnąć, gdy ciężką pracę przejmie automatyzacja. A jeśli chcesz zobaczyć, jak wygląda scraping oparty na AI i działający jednym kliknięciem, wypróbuj darmowy okres próbny Thunderbit. Udanych crawli — niech Twoje dane zawsze będą świeże, uporządkowane i gotowe do działania.
Wypróbuj Thunderbit AI Web Scraper za darmo
FAQ
1. Czym jest narzędzie do crawlowania danych i dlaczego warto z niego korzystać?
Narzędzie do crawlowania danych automatyzuje proces wyciągania informacji ze stron internetowych. Oszczędza czas, zmniejsza liczbę błędów i pomaga zespołom zbierać aktualne dane do sprzedaży, marketingu, badań i operacji — znacznie sprawniej niż ręczne kopiowanie i wklejanie.
2. Które narzędzie do crawlowania danych jest najlepsze dla osób nietechnicznych?
Thunderbit, ParseHub i Data Miner to świetne wybory dla osób bez wiedzy programistycznej. Thunderbit wyróżnia się workflow opartym na AI i działającym jednym kliknięciem, a ParseHub oferuje wizualne podejście do bardziej złożonych stron.
3. Czym różnią się modele cenowe narzędzi do crawlowania danych?
Ceny są bardzo zróżnicowane: niektóre narzędzia (np. Thunderbit i Data Miner) oferują darmowe plany i przystępne abonamenty, podczas gdy platformy enterprise (np. Import.io i Mozenda) korzystają z wyceny indywidualnej lub opartej na wolumenie. Zawsze sprawdź, czy koszt narzędzia odpowiada Twoim potrzebom.
4. Czy mogę używać tych narzędzi do ciągłego, zaplanowanego pozyskiwania danych?
Tak — narzędzia takie jak Thunderbit, Octoparse, Apify, Mozenda i Import.io obsługują scraping według harmonogramu lub cykliczny, więc świetnie nadają się do stałego monitorowania cen, generowania leadów czy badań rynku.
5. Co warto wziąć pod uwagę przed wyborem narzędzia do crawlowania danych?
Weź pod uwagę poziom techniczny zespołu, złożoność stron, które chcesz crawlować, wolumen danych, potrzeby integracyjne i budżet. Zanim zdecydujesz się na płatny plan, przetestuj kilka narzędzi na realnych zadaniach.
Więcej praktycznych analiz i poradników znajdziesz na Thunderbit Blog.
Wypróbuj AI Web Scraper Get Started Free
Dowiedz się więcej
- 10 najlepszych automatycznych narzędzi do web scrapingu w 2025 roku
- 5 najlepszych programów do scrapingu danych z sieci w 2026 roku
- 15 najlepszych narzędzi do ekstrakcji danych w 2025 roku
- 6 kluczowych narzędzi do web scrapingu, które warto znać w 2025 roku
- Jak wydajnie pozyskiwać dane ze stron internetowych za pomocą najlepszych narzędzi




