
W ubiegłym kwartale nasz zespół operacyjny spędzał 40 godzin tygodniowo na ręcznym kopiowaniu danych konkurencji do arkuszy. W tym kwartale zajmuje to 20 minut.
Różnica? Zautomatyzowane narzędzia do web scrapingu. Z rozwiązania dla programistów stały się czymś, z czego każdy handlowiec czy marketer może skorzystać przy lunchu.
Od lat tworzę SaaS i narzędzia automatyzujące pracę (i tak, jestem współzałożycielem Thunderbit). Tegoroczna grupa narzędzi na 2026 rok jest najmocniejsza do tej pory — natywna dla AI, samonaprawiająca się i naprawdę przydatna dla osób nietechnicznych.
Oto 10 narzędzi, które przetestowałem samodzielnie i porównałem pod kątem zastosowań oraz poziomu zaawansowania.
Dlaczego zautomatyzowane narzędzia do web scrapingu są ważne dla biznesu
Nie oszukujmy się: czasy ręcznego kopiowania danych ze stron internetowych minęły (chyba że lubisz przeciążenie nadgarstków i egzystencjalny ból). Zautomatyzowane narzędzia do web scrapingu stały się kluczowe dla firm każdej wielkości. W rzeczywistości ponad 97% organizacji inwestuje dziś w inicjatywy związane z big data i AI, a web scraping jest ważnym elementem tej strategii.
Oto, dlaczego te narzędzia są tak cenne:
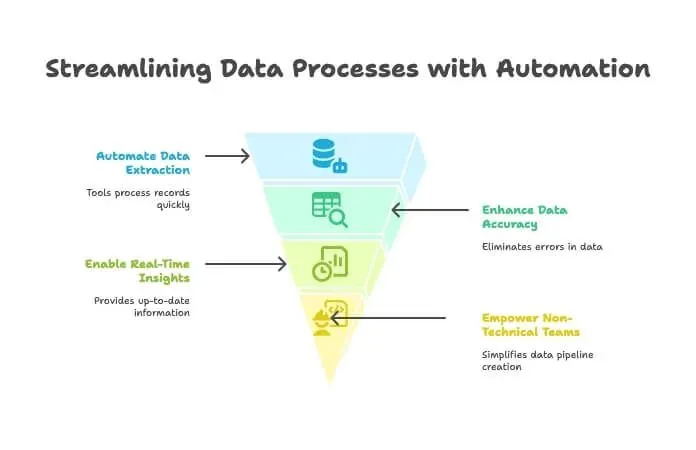
- Oszczędność czasu i mniej pracy ręcznej: Automatyczne scrapery potrafią przetwarzać tysiące rekordów w kilka minut, odciążając zespół i pozwalając mu skupić się na zadaniach o większej wartości. Jeden z użytkowników narzędzia mówił o oszczędności „setek godzin” dzięki automatyzacji zbierania danych (browsercat.com).
- Wyższa dokładność danych: Koniec z literówkami i pominiętymi wpisami. Automatyczne pozyskiwanie danych oznacza czystsze i bardziej wiarygodne informacje.
- Szybsze podejmowanie decyzji: Dzięki strumieniom danych w czasie rzeczywistym możesz monitorować konkurencję, śledzić ceny czy budować listy leadów bez czekania na comiesięczny raport stażysty.
- Dostęp dla zespołów nietechnicznych: Dzięki narzędziom no-code i opartym na AI nawet osoby, które myślą, że „XPath” to pozycja z jogi, mogą dziś tworzyć potoki danych webowych (cpomagazine.com).
Nic dziwnego, że 100% ankietowanych specjalistów ds. danych korzysta z publicznych danych webowych w swojej pracy, a prawie 80% twierdzi, że bez nich ich organizacja nie mogłaby działać sprawnie. W 2026 roku, jeśli nie automatyzujesz zbierania danych, prawdopodobnie zostawiasz na stole pieniądze — i cenne wnioski.
Jak wybraliśmy najlepsze zautomatyzowane narzędzia do web scrapingu
Rynek oprogramowania do web scrapingu ma według prognoz ponad dwukrotnie urosnąć do 2032 roku, więc wybór odpowiedniego narzędzia może przypominać zakupy butów w sklepie z 10 000 modeli. Oto kryteria, którymi się kierowałem:
- Łatwość obsługi: Czy osoba bez doświadczenia technicznego może szybko zacząć? Czy nauka jest trudna?
- Możliwości AI: Czy narzędzie wykorzystuje AI do automatycznego wykrywania pól danych, obsługi dynamicznych stron lub opisywania potrzeb prostym językiem?
- Eksport i integracje danych: Jak łatwo przenieść dane do Excel, Google Sheets, Airtable, Notion albo CRM?
- Cena: Czy dostępny jest darmowy okres próbny? Czy płatne plany są przystępne dla osób indywidualnych i małych zespołów, czy tylko dla enterprise?
- Skalowalność: Czy narzędzie poradzi sobie zarówno z jednorazowymi małymi zadaniami, jak i z dużymi, cyklicznymi ekstrakcjami?
- Grupa docelowa: Czy zostało stworzone dla użytkowników biznesowych, programistów, czy obu grup?
- Unikalne atuty: Co wyróżnia to narzędzie na tle konkurencji?
Uwzględniłem rozwiązania dla każdego poziomu — od „chcę po prostu arkusz” do „chcę zeskrobać cały internet”. Zaczynajmy.
1. Thunderbit: Narzędzie do web scrapingu z AI dla każdego
Pozyskuj dane z dowolnej strony dzięki AI Get Started Free
Na początek narzędzie, które znam najlepiej — bo właśnie z myślą o takich problemach, z którymi od lat zmagają się użytkownicy biznesowi, zbudowałem je wraz z zespołem. Thunderbit nie jest typowym scraperem typu „przeciągnij i upuść” ani narzędziem „napisz własny selektor”. To asystent danych oparty na AI, który pozwala opisać, czego potrzebujesz, a resztę wykonuje sam — bez kodowania, bez grzebania w XPath, bez łez.
Dlaczego Thunderbit jest na pierwszym miejscu
Thunderbit to najbliższe temu, co widziałem, do „zamiany dowolnej strony w bazę danych”. Tak to działa:
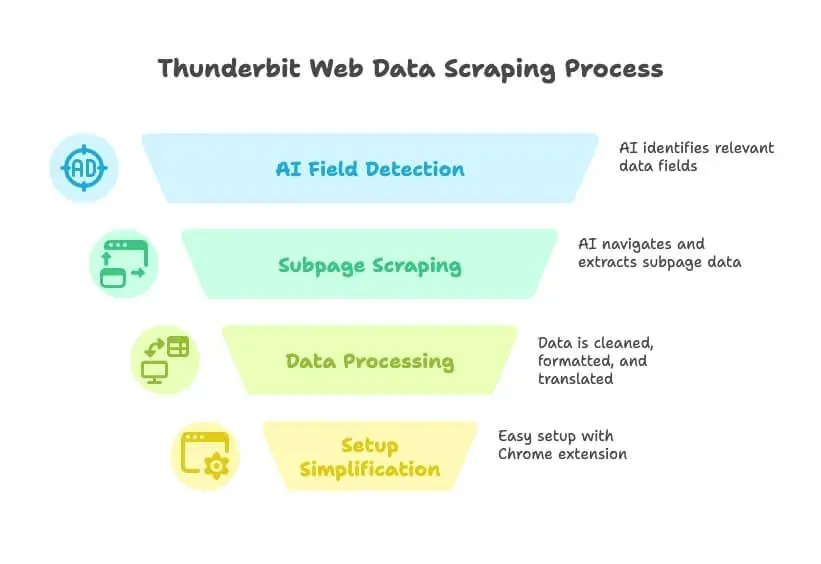
- Sterowanie naturalnym językiem: Po prostu powiedz Thunderbit, jakich danych potrzebujesz („Chcę wszystkie nazwy firm, e-maile i numery telefonów z tego katalogu”), a AI automatycznie wykryje odpowiednie pola.
- Propozycje pól od AI: Jednym kliknięciem Thunderbit analizuje stronę i podpowiada najlepsze kolumny do pobrania — koniec z domysłami i próbami metodą prób i błędów.
- Scraping podstron i wielopoziomowy: Potrzebujesz danych z podstron każdego wpisu? Thunderbit przejdzie przez kolejne strony, pobierze dodatkowe informacje i dopisze je do tabeli.
- Czyszczenie, tłumaczenie i klasyfikacja danych: Thunderbit nie tylko pobiera surowe dane — podczas scrapingu może je czyścić, formatować, tłumaczyć, a nawet kategoryzować.
- Bez problemów z konfiguracją: Zainstaluj rozszerzenie Chrome, kliknij „AI Suggest Fields” i zacznij scrapować w mniej niż minutę.
- Darmowy test i niska cena: Hojny darmowy plan (do 6 stron za darmo), a płatne pakiety od zaledwie 9 USD miesięcznie. To mniej niż wydaję na kawę w tydzień.
Thunderbit został stworzony z myślą o zespołach sprzedaży, marketingu i operacji, które potrzebują danych — szybko. Bez kodowania, bez wtyczek, bez szkolenia. To jak praktykant od danych, który naprawdę słucha i nigdy nie narzeka.
Najmocniejsze strony Thunderbit
- Scraping napędzany AI: AI rozumie strukturę strony, dopasowuje się do zmian układu i automatycznie obsługuje paginację oraz podstrony (cpomagazine.com).
- Natychmiastowy eksport danych: Wyślij wyniki bezpośrednio do Excel, Google Sheets, Airtable, Notion albo pobierz je jako CSV/JSON.
- Uruchamianie w chmurze lub lokalnie: Wykonuj zadania w chmurze, aby uzyskać szybkość i skalę, albo w przeglądarce, jeśli potrzebujesz użyć własnej sesji/logowania.
- Scraping według harmonogramu: Ustaw cykliczne zadania, aby dane były zawsze aktualne — idealne do monitorowania cen lub regularnych aktualizacji leadów.
- Bezobsługowość: AI Thunderbit dostosowuje się do zmian na stronie, więc mniej czasu tracisz na naprawianie zepsutych scraperów (cpomagazine.com).
Dla kogo? Dla każdego, kto chce przejść od „Potrzebuję tych danych” do „Oto twój arkusz” w kilka minut — szczególnie dla użytkowników nietechnicznych. Z ponad 200 000 użytkowników i oceną 4,2★, Thunderbit szybko staje się rozwiązaniem pierwszego wyboru dla zespołów biznesowych, które chcą wyników, a nie problemów.
Chcesz zobaczyć to w praktyce? Sprawdź kanał Thunderbit na YouTube albo przejrzyj więcej poradników na blogu Thunderbit.
Wypróbuj Thunderbit AI Web Scraper za darmo
2. Clay: automatyczne wzbogacanie danych połączone z web scrapingiem
Clay to coś w rodzaju szwajcarskiego scyzoryka dla zespołów growth. To nie tylko web scraper — to arkusz automatyzacji, który łączy się z 150–200+ źródłami danych na żywo (takimi jak Apollo, LinkedIn czy Crunchbase) i wykorzystuje wbudowaną AI do wzbogacania leadów, pisania maili sprzedażowych i oceniania potencjalnych klientów.
- Automatyzacja workflow: Każdy wiersz to lead, a każda kolumna może pobierać dane albo uruchamiać akcję. Chcesz pobrać listę firm, wzbogacić ją o profile LinkedIn i wysłać spersonalizowany e-mail? Clay to ogarnia.
- Integracja z AI: Wykorzystuje GPT-4 do pisania otwieraczy wiadomości, streszczania biogramów i nie tylko.
- Integracje: Łączy się natywnie z HubSpot, Salesforce, Gmail, Slack i wieloma innymi aplikacjami.
- Cena: Plan Launch zaczyna się od około 167 USD miesięcznie (lub ok. 60 USD miesięcznie przy rozliczeniu rocznym), a przy lekkim użyciu dostępny jest darmowy okres próbny.
Najlepszy dla: zespołów outbound, growth hackerów i marketerów, którzy chcą budować własne lejki leadowe — łącząc scraping, wzbogacanie danych i outreach w jednym miejscu. To potężne narzędzie, ale jeśli dopiero zaczynasz pracę z automatyką, nauka może chwilę zająć (lindy.ai).
3. Bardeen: scraper przeglądarkowy do automatyzacji pracy
Bardeen to jak robot przeglądarkowy, który może zbierać dane i automatyzować powtarzalne zadania w sieci — wszystko z poziomu rozszerzenia Chrome.
- Automatyzacja bez kodu: Ponad 500 „Playbooks” do scrapingu, wypełniania formularzy, przenoszenia danych między aplikacjami i wielu innych zadań.
- Kreator poleceń AI: Opisz zadanie prostym językiem, a Bardeen zbuduje workflow.
- Integracje: Działa z Notion, Trello, Slack, Salesforce i ponad 100 innymi aplikacjami.
- Cena: Plan Basic zaczyna się od 10 USD miesięcznie (100 kredytów/mies.), a Premium kosztuje 50 USD miesięcznie (lub 480 USD rocznie) dla zespołów.
Najlepszy dla: zaawansowanych użytkowników i zespołów go-to-market, które chcą automatyzować scraping i dalsze działania w wielu aplikacjach. Elastyczność jest duża, ale początkujący mogą uznać naukę za nieco trudniejszą (porównanie na blogu Thunderbit).
4. Bright Data: zautomatyzowane narzędzia do web scrapingu klasy enterprise
Bright Data (dawniej Luminati) to ciężki sprzęt świata web scrapingu — pomyśl o globalnych sieciach proxy, zaawansowanych API i możliwości crawlowania tysięcy stron dziennie.
- Skala enterprise: Ponad 400 milionów adresów IP, Web Scraper API, Web Unlocker do omijania zabezpieczeń anty-bot.
- Możliwość dostosowania: Buduj złożone, wielkoskalowe ekstrakcje o wysokiej niezawodności.
- Cena: Web Scraper API zaczyna się od 499 USD miesięcznie, dostępny jest też darmowy plan i rozliczanie pay-as-you-go.
Najlepszy dla: dużych przedsiębiorstw, agregatorów danych i zaawansowanych użytkowników, którzy potrzebują solidnych, skalowalnych rozwiązań. Jeśli codziennie crawlujesz tysiące stron i musisz unikać blokad IP, Bright Data zostało stworzone właśnie dla Ciebie (blog.apify.com).
5. Octoparse: wizualne narzędzie do web scrapingu dla średnio zaawansowanych
Octoparse to popularne narzędzie no-code z wizualnym interfejsem typu kliknij i wybierz — idealne dla użytkowników, którzy chcą mocy bez programowania.
- Interfejs drag-and-drop: Klikaj elementy, aby określić, co chcesz pobrać; obsługuje logowania, paginację i więcej.
- Szablony: Ponad 500 gotowych szablonów dla popularnych serwisów (Amazon, Twitter itd.).
- Scraping w chmurze: Uruchamiaj zadania na serwerach Octoparse, planuj ekstrakcje i korzystaj z rotacji IP.
- Cena: Darmowy plan z ograniczeniami; płatne zaczynają się od 69 USD miesięcznie.
Najlepszy dla: osób nietechnicznych i analityków danych, którzy chcą sprawnego scrapera bez pisania kodu. Świetne do monitorowania cen, listingów produktów i projektów badawczych (thunderbit.com).
6. Import.io: platforma do scrapingu danych dla firm
Import.io to jedna z legend web scrapingu, która dziś rozwinęła się w pełnoprawną platformę do ekstrakcji danych.
- Ekstrakcja typu point-and-click: Obsługuje logowania, listy rozwijane i elementy interaktywne.
- Działanie w chmurze: Równoległe przetwarzanie tysięcy adresów URL, harmonogram ekstrakcji i dostęp do API.
- Nastawienie na enterprise: Wykorzystywane do monitorowania cen, badań rynku i budowania zestawów danych do uczenia maszynowego.
- Cena: Plan Standard za 199 USD miesięcznie, Professional za 399 USD miesięcznie, Advanced za 699 USD rocznie; Enterprise wycena indywidualna.
Najlepszy dla: średnich i dużych firm oraz zespołów danych, które potrzebują niezawodnych, utrzymywanych rozwiązań do dużych projektów. Raczej przesada dla projektów hobbystycznych, ale prawdziwa potęga w zastosowaniach biznesowych (import.io).
7. Parsehub: elastyczny scraper z edytorem wizualnym
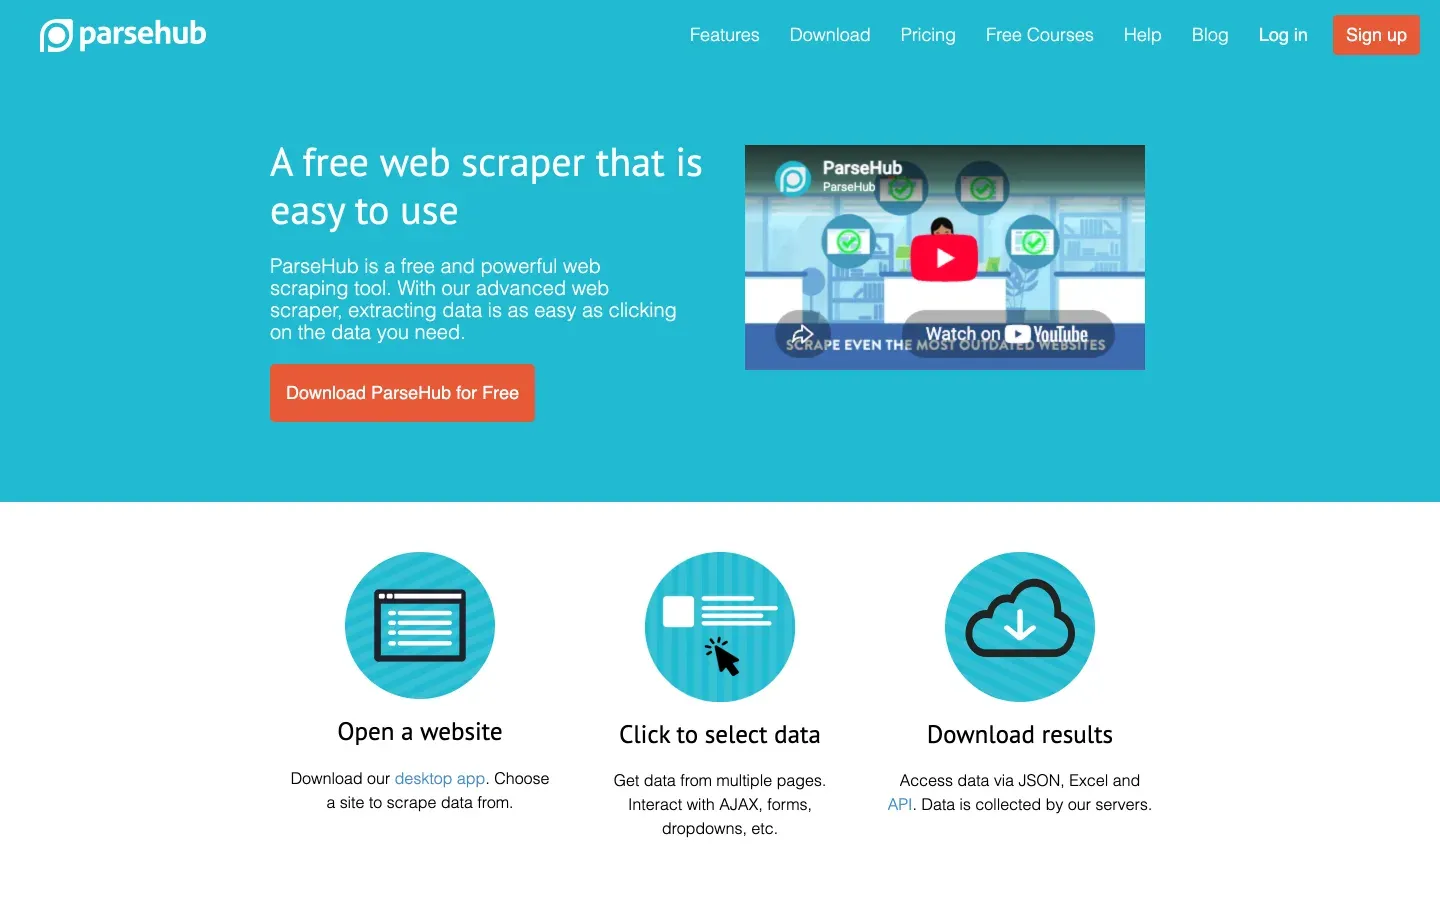
Parsehub to aplikacja desktopowa (Windows, Mac, Linux), która pozwala budować scrapery, klikając po interfejsie strony internetowej.
- Wizualny workflow: Zaznaczaj elementy, ustawiaj reguły ekstrakcji i obsługuj logowania, listy rozwijane oraz nieskończone przewijanie.
- Funkcje chmurowe: Uruchamiaj scrapowanie w chmurze, planuj zadania i korzystaj z dostępu API.
- Cena: Darmowy plan do małych zadań; płatne zaczynają się od 149 USD miesięcznie.
Najlepszy dla: badaczy, małych firm i osób indywidualnych, które chcą większej kontroli niż daje rozszerzenie przeglądarki, ale nie są gotowe pisać własnego scrapera (scrapingbee.com).
8. Common Crawl: otwarte dane webowe dla AI i badań
Common Crawl nie jest narzędziem w tradycyjnym sensie — to ogromny otwarty zbiór danych z crawlowania sieci, aktualizowany co miesiąc.
- Skala: około 400 TB danych webowych obejmujących miliardy stron.
- Darmowy i otwarty: Nie musisz uruchamiać własnego crawlera.
- Wymaga umiejętności technicznych: Potrzebne będą narzędzia big data i trochę zaplecza inżynierskiego, aby filtrować i parsować dane.
Najlepszy dla: data scientistów i inżynierów tworzących modele AI lub prowadzących badania na dużą skalę. Jeśli potrzebujesz ogólnego tekstu z internetu albo długoterminowych archiwów, to prawdziwa kopalnia złota (scrapingbee.com).
9. Crawly: lekkie zautomatyzowane narzędzie do web scrapingu dla startupów
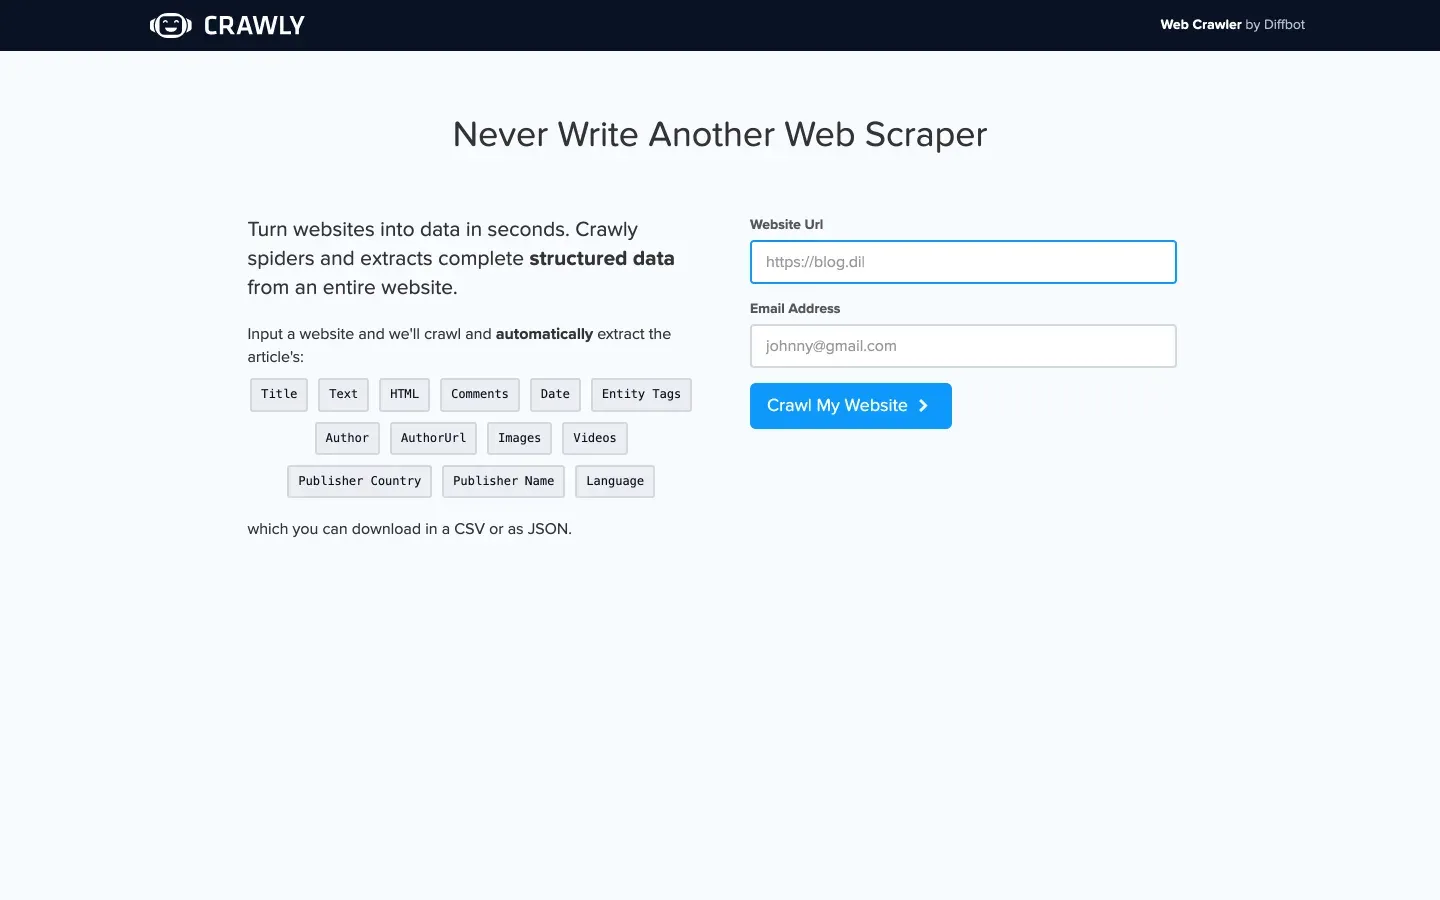
Crawly (od Diffbot) to chmurowy crawler oparty na AI, który potrafi pobierać dane z milionów stron i zwracać ustrukturyzowane wyniki — bez potrzeby definiowania reguł parsowania.
- Ekstrakcja AI: Wykorzystuje machine vision i NLP do rozpoznawania oraz pobierania treści.
- Dostęp przez API: Możesz odpytywać zebrane dane i integrować je z narzędziami analitycznymi lub bazami danych.
- Cena: Dostępny darmowy plan (10 000 kredytów miesięcznie przez Diffbot); płatne plany zaczynają się od 299 USD miesięcznie.
Najlepszy dla: startupów i zespołów z pewnym zapleczem technicznym, które potrzebują inteligentnej ekstrakcji danych webowych na dużą skalę bez budowania własnych scraperów (aitoptools.com).
10. Apify: przyjazne dla programistów narzędzie do web scrapingu z marketplace’em
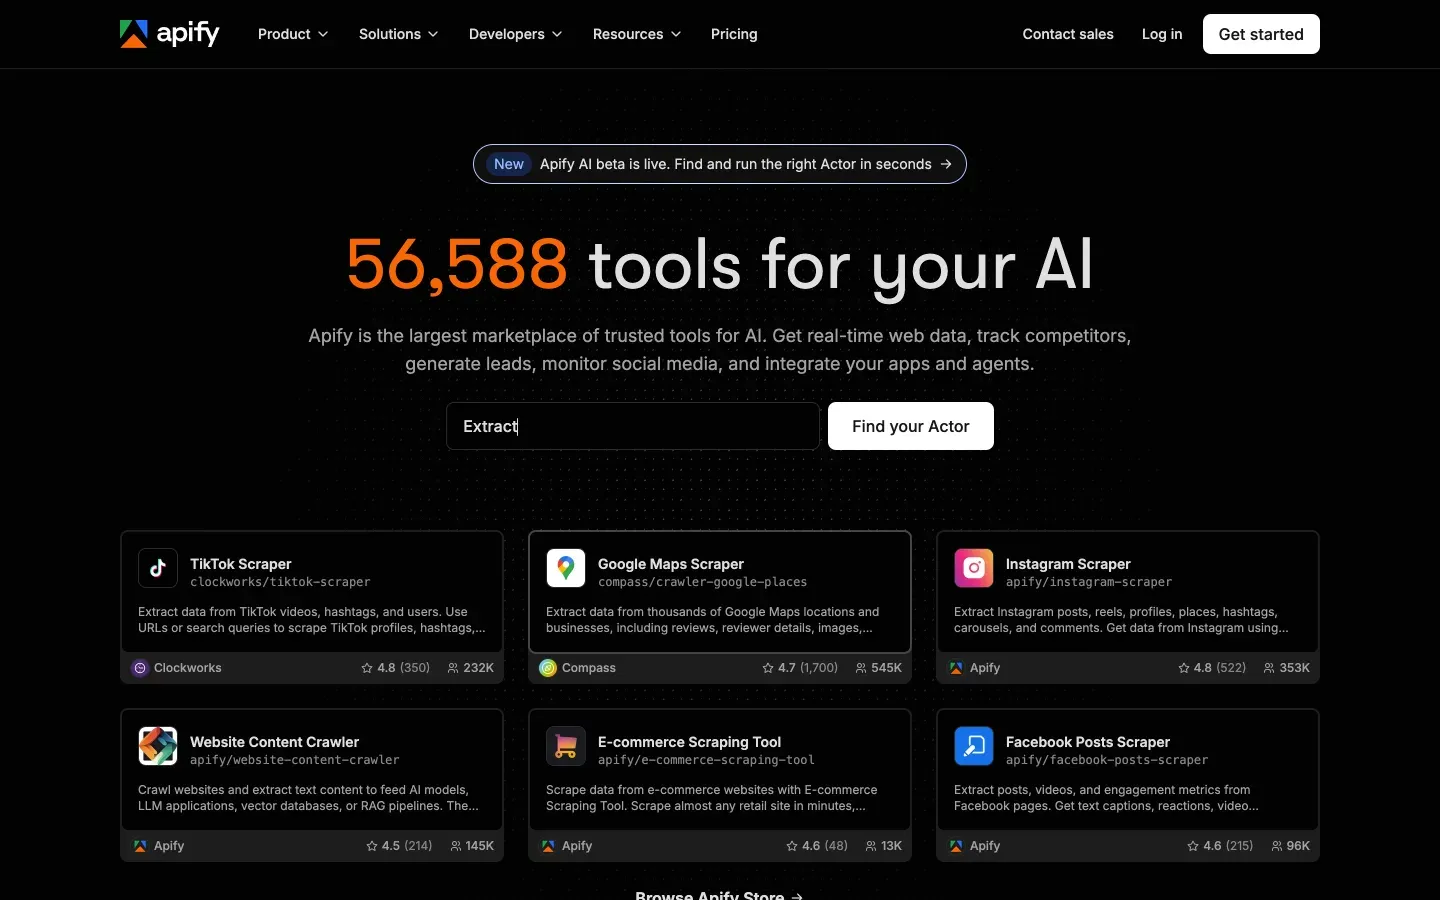
Apify to platforma chmurowa, na której możesz tworzyć własne scrapery („Actors”) albo korzystać z biblioteki gotowych scraperów społeczności.
- Elastyczność dla programistów: Obsługuje scraping w JavaScript/Python, headless Chrome, zarządzanie proxy i harmonogramy.
- Marketplace: Bogata biblioteka gotowych scraperów dla popularnych serwisów.
- Cena: Darmowy plan z 5 USD miesięcznie w kredytach; płatne zaczynają się od 29 USD miesięcznie.
Najlepszy dla: programistów i analityków z technicznym zacięciem, którzy chcą pełnej kontroli i skalowalności. Nawet osoby bez kodowania mogą korzystać z gotowych Actors do typowych zadań (blog.apify.com).
Tabela porównawcza zautomatyzowanych narzędzi do web scrapingu
| Narzędzie | Łatwość obsługi | Funkcje AI | Cena początkowa | Grupa docelowa | Najmocniejsze strony |
|---|---|---|---|---|---|
| Thunderbit | ★★★★★ | Naturalny język, AI Suggest Fields, scraping podstron | 9 USD/mies. | Nietechniczni użytkownicy biznesowi | Konfiguracja w 2 kliknięciach, bez kodu, natychmiastowy eksport, darmowy okres próbny |
| Clay | ★★★★☆ | Wzbogacanie AI, GPT-4 | 167 USD/mies. | Growth / sales ops | Arkusz automatyzacji, wzbogacanie, outreach |
| Bardeen | ★★★★☆ | Kreator poleceń AI | 10 USD/mies. | Zaawansowani użytkownicy, zespoły GTM | Browser RPA, 500+ playbooków, głębokie integracje |
| Bright Data | ★★☆☆☆ | Rotacja proxy, AI anty-bot | 499 USD/mies. | Enterprise, deweloperzy | Skala, niezawodność, globalne proxy |
| Octoparse | ★★★★☆ | Wizualne wykrywanie AI | 69 USD/mies. | Analitycy, osoby bez kodowania | Drag-and-drop, szablony, scraping w chmurze |
| Import.io | ★★★☆☆ | Interaktywne ekstraktory | 199 USD/mies. | Enterprise, zespoły danych | Równoległość, harmonogramy, API, wsparcie |
| Parsehub | ★★★★☆ | Wizualne workflow | 149 USD/mies. | Badacze, MŚP | Aplikacja desktopowa, obsługa dynamicznych stron |
| Common Crawl | ★☆☆☆☆ | Brak (tylko zbiór danych) | Darmowe | Data scientisty, inżynierowie | Ogromny otwarty zbiór danych, archiwa na skalę internetu |
| Crawly | ★★☆☆☆ | Ekstrakcja AI | Darmowe / 299+ USD/mies. | Startupy, zespoły techniczne | Oparte na AI, bez reguł parsowania, dostęp do API |
| Apify | ★★★★☆ | Marketplace Actors | 29 USD/mies. | Programiści, analitycy techniczni | Tworzenie/marketplace, automatyzacja w chmurze, elastyczność |
Jak wybrać odpowiednie narzędzie do web scrapingu dla swoich potrzeb
Czym jest data scraping i jak go wykonywać Get Started Free
Wybór najlepszego zautomatyzowanego narzędzia do web scrapingu zależy od wielkości zespołu, umiejętności technicznych i celów biznesowych. Oto mój krótki przewodnik:
- Dla użytkowników nietechnicznych (sprzedaż, marketing, operacje): Wybierz Thunderbit. Został stworzony właśnie dla Ciebie — bez kodu, bez konfiguracji, po prostu wyniki. Idealny do pozyskiwania leadów, monitorowania cen i szybkich projektów danych.
- Dla zespołów zakochanych w automatyzacji: Clay i Bardeen błyszczą wtedy, gdy chcesz łączyć scraping ze wzbogacaniem danych, outreachiem lub automatyzacją workflow.
- Dla enterprise i programistów: Bright Data, Import.io i Apify to najlepszy wybór przy dużych, mocno konfigurowalnych projektach.
- Dla badaczy i analityków: Octoparse i Parsehub oferują wizualne interfejsy i zaawansowane możliwości bez potrzeby pisania kodu.
- Dla projektów AI i data science: Common Crawl i Crawly dostarczają ogromne zbiory danych oraz ekstrakcję opartą na AI dla tych, którzy chcą budować lub trenować modele.
Zadaj sobie pytanie: chcesz zacząć w kilka minut, czy potrzebujesz zbudować własne rozwiązanie klasy enterprise? Jeśli nie jesteś pewien, zacznij od darmowego okresu próbnego — większość narzędzi go oferuje.
Zacznij scrapować z Thunderbit już teraz
Unikalna wartość Thunderbit: asystent AI do danych biznesowych
Na tle wszystkich tych narzędzi Thunderbit wyróżnia się jako jedyne, które naprawdę działa jak „asystent AI” do web scrapingu i transformacji danych. Nie chodzi tylko o pobieranie danych — chodzi o zamianę chaotycznych stron internetowych w czyste, uporządkowane wnioski bez żadnych barier technicznych.
- Interfejs w naturalnym języku: Opisz swoje potrzeby prostym językiem, a Thunderbit zajmie się resztą.
- Pełna automatyzacja workflow: Od ekstrakcji po czyszczenie, tłumaczenie i eksport — Thunderbit obsługuje cały proces.
- Idealny do szybkich testów: Chcesz zweryfikować nowy rynek, zbudować listę leadów albo monitorować konkurencję? Thunderbit to najszybszy i najtańszy punkt startu.
To jak mieć analityka danych wbudowanego w przeglądarkę — takiego, który nigdy nie prosi o podwyżkę ani nie bierze urlopu.
Podsumowanie: zacznij mądrzej dzięki odpowiedniemu narzędziu do automatycznego web scrapingu
Krajobraz scrapingu w 2026 roku jest nie do poznania w porównaniu z tym sprzed dwóch lat. Samonaprawiające się scrapery AI, potoki natywne dla LLM i naprawdę użyteczne narzędzia no-code zmieniły zasady gry. Niezależnie od tego, czy jesteś solo founderem, zwinym zespołem sprzedaży, czy enterprise data scientist, na tej liście znajdziesz narzędzie dopasowane do swoich potrzeb. Kluczem jest dopasowanie workflow i umiejętności do właściwej platformy — tak, aby przestać walczyć z kodem i zacząć wydobywać insighty.
Jeśli chcesz pożegnać ręczne kopiowanie i zacząć mądrzej, pobierz Thunderbit za darmo i zobacz, jak łatwy może być web scraping. Możesz też przejrzeć inne opcje powyżej, zależnie od swoich celów. Tak czy inaczej, przyszłość biznesu opartego na danych należy do tych, którzy automatyzują.
Chcesz dowiedzieć się więcej? Zajrzyj na blog Thunderbit, gdzie znajdziesz pogłębione analizy, poradniki i wskazówki, jak wycisnąć maksimum z danych webowych. Udanych scrapów — i oby Twoje dane były zawsze czyste, a scrapery nigdy się nie psuły (a jeśli już, niech zajmie się tym AI).
Wypróbuj Thunderbit AI Web Scraper za darmo Get Started Free
FAQ
1. Dlaczego zautomatyzowane narzędzia do web scrapingu są ważne dla biznesu w 2026 roku?
Zautomatyzowane narzędzia do web scrapingu usprawniają zbieranie danych, oszczędzają czas i ograniczają pracę ręczną. Zwiększają dokładność danych, wspierają podejmowanie decyzji w czasie rzeczywistym i umożliwiają zespołom nietechnicznym pozyskiwanie oraz wykorzystywanie danych webowych bez pisania kodu. Dziś są kluczowe dla sprzedaży, marketingu i operacji.
2. Co wyróżnia Thunderbit na tle innych narzędzi do web scrapingu?
Thunderbit wykorzystuje AI, aby użytkownicy mogli opisać prostym językiem, jakich danych potrzebują. Automatycznie wykrywa pola danych, obsługuje podstrony i paginację oraz natychmiast eksportuje wyniki do takich platform jak Excel czy Airtable. Jest przeznaczony dla użytkowników nietechnicznych i oferuje zaawansowane funkcje, takie jak czyszczenie danych i scrapowanie według harmonogramu, w niskiej cenie.
3. Które narzędzie najlepiej nadaje się do dużych projektów enterprise?
Bright Data i Import.io są idealne do zastosowań enterprise. Oferują funkcje takie jak rotacja proxy, mechanizmy anty-bot, duża równoległość przetwarzania i dostęp do API, dzięki czemu sprawdzają się tam, gdzie trzeba niezawodnie przetwarzać tysiące stron internetowych na dużą skalę.
4. Czy są narzędzia, które łączą scraping z automatyzacją i outreachiem?
Tak, narzędzia takie jak Clay i Bardeen nie tylko pobierają dane ze stron, ale też włączają je do workflow. Clay wzbogaca leady i automatyzuje outreach, a Bardeen pozwala automatyzować zadania w przeglądarce i workflow za pomocą playbooków opartych na AI.
5. Jaka jest najlepsza opcja dla osób bez zaplecza technicznego?
Thunderbit wyróżnia się dla użytkowników nietechnicznych dzięki interfejsowi w naturalnym języku, konfiguracji opartej na AI i łatwości obsługi. Nie wymaga kodowania ani skomplikowanej konfiguracji i jest idealny dla użytkowników biznesowych, którzy potrzebują szybkich i niezawodnych danych bez technicznej złożoności.




