Wikipedia-scraper voor infoboxen, citaten en secties













Wikipedia-artikelen slim ordenen voor onderzoek
Houd artikelinformatie, infoboxwaarden, citaten en sectiecontext in aparte velden.
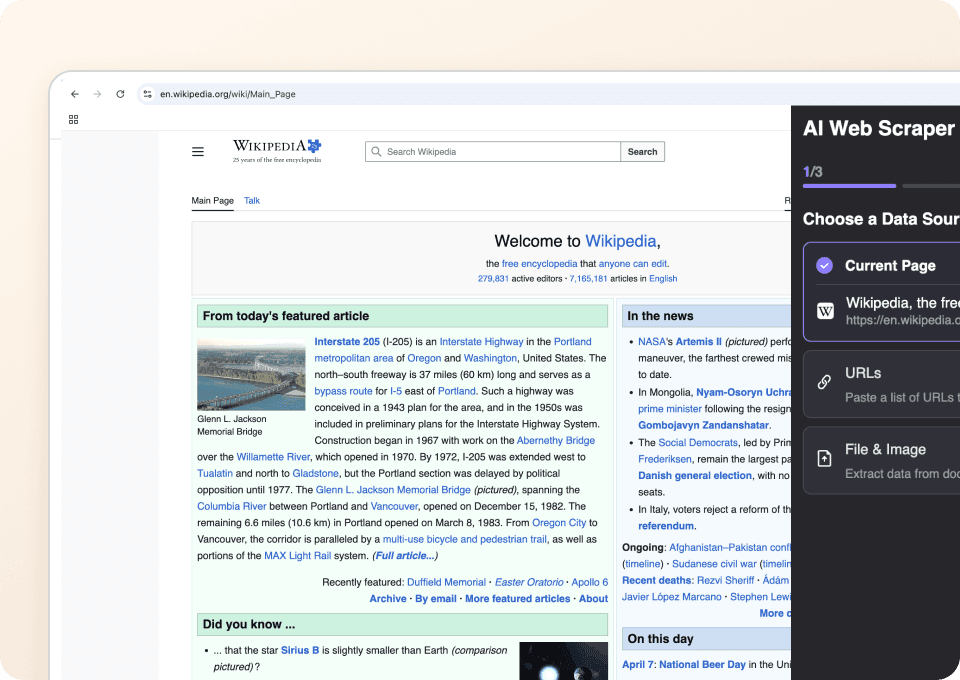
Wikipedia-gegevens met één klik extraheren
Het stelt kolommen voor op basis van de pagina die je opent en voltooit de extractie in één run. Pas velden in natuurlijke taal aan of hernoem ze, en voer het daarna gerust opnieuw uit.
Werken met verschillende Wikipedia-paginatypen
De agent leest zichtbare labels, koppen en sectietitels om waarden te koppelen aan de pagina die je kunt openen. Als een veld ontbreekt, blijft de kolom leeg.
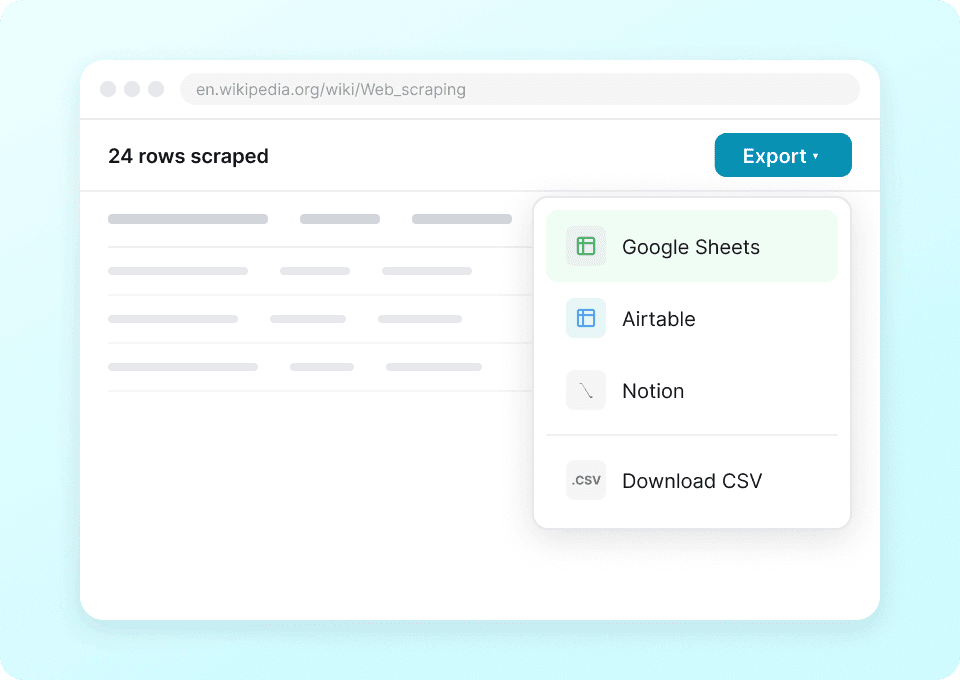
Wikipedia-data direct exporteren
Ga verder met onderzoek in Google Sheets, Excel, Airtable, Notion of via een gedownloade CSV.
Wikipedia-onderzoeksdata verzamelen zonder zelf een scraper te bouwen
Minder onderhoud van selectors voor Wikipedia-onderzoek.
Handmatige of selector-gedreven opzet
Tijd kwijt aan het onderhouden van regelsThunderbit AI-agent
Veldsuggesties en één enkele runKolommen voor artikelinformatie, infobox, citaten en secties
Kolommen verschijnen alleen wanneer ze zichtbaar zijn op de pagina die je kunt openen.
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.
Vragen over Wikipedia-onderzoeksruns
Korte antwoorden voor Agent Mode op Wikipedia.
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Flixster Webscraper
Met de Thunderbit Flixster Webscraper kun je moeiteloos gegevens verzamelen van Flixster’s box office-lijsten en bioscopen in de buurt. Dankzij AI-gestuurde veldsuggesties verzamel je snel filmtitels, box office-opbrengsten, beoordelingen, releasedata, bioscoopnamen, locaties en het actuele filmaanbod voor analyse of onderzoek.
Meer info ->
olympustaff.com Webscraper
Met de Thunderbit olympustaff.com Webscraper kun je eenvoudig gegevens verzamelen uit stripboekenlijsten en reacties op olympustaff.com. Dankzij AI-gestuurde veldsuggesties verzamel je snel titels, auteurs, verschijningsdata en feedback van lezers voor analyse of onderzoek. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde data van olympustaff.com willen ophalen.
Meer info ->
Hatena Webscraper
Met de Thunderbit Hatena Webscraper kun je eenvoudig gegevens uit Hatena-blogs en onderwerplijsten halen dankzij AI-gestuurde veldsuggesties. Verzamel blogtitels, auteursnamen, publicatiedata, samenvattingen en populaire onderwerpen voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde Hatena-data willen verzamelen.
Meer info ->
namu.wiki Scraper
Met de Thunderbit namu.wiki Webscraper kun je moeiteloos gegevens van namu.wiki verzamelen, zoals relevante pagina's en actuele discussies. Dankzij AI-gestuurde veldsuggesties verzamel je snel paginatitels, URL's, laatste bewerkingsdata, discussieonderwerpen en deelnemersnamen – ideaal voor onderzoek, contentcreatie of community-analyses.
Meer info ->
NetEase Music Webscraper
Met de Thunderbit NetEase Music Webscraper kun je moeiteloos gegevens verzamelen uit NetEase Music zoekresultaten en artiestenpagina’s. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albumdetails, speelduur en song-URL’s voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en liefhebbers die gestructureerde NetEase Music data willen verzamelen.
Meer info ->
QQ Music Webscraper
Met de Thunderbit QQ Music Webscraper kun je moeiteloos gegevens uit QQ Music zoekresultaten en artiestenoverzichten halen. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albuminformatie, releasedata en meer voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en muziekliefhebbers die gestructureerde QQ Music data willen verzamelen.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.


