

Thunderbit’s PubMed-scraper helpt je om PubMed-pagina’s met AI om te zetten in schone, gestructureerde datasets. Je kunt trending medische research, bewijs uit klinische studies, abstracts, auteurs, affiliaties, publicatiedata, PMIDs en artikellinks extraheren en daarna exporteren naar Excel, Google Sheets, Airtable of Notion. Je opent PubMed gewoon in Chrome, laat AI de beste kolommen voorstellen en start met scrapen.
🧬 Wat is de PubMed-scraper
De PubMed-scraper is een AI-webscraper die is gebouwd voor PubMed | US National Library of Medicine. Met Thunderbit (een AI-webscraper Chrome-extensie) kun je naar elke PubMed-resultatenpagina gaan, op AI Suggest Columns klikken en vervolgens op Scrape om gestructureerde data te extraheren zonder code te schrijven.
🔎 Wat kun je scrapen met PubMed
PubMed staat vol met waardevolle biomedische metadata, maar is niet altijd direct klaar voor analyse. Thunderbit’s AI Web Scraper (https://thunderbit.com/) helpt je om PubMed-vermeldingen te verzamelen en te structureren, en ze via Subpage Scraping uit te breiden met artikeldetails (open elke artikelpagina en voeg velden toe zoals abstract, affiliaties, DOI en meer).
Hieronder vind je twee veelgebruikte workflows die je in enkele minuten kunt uitvoeren.
📈 Scrape PubMed Trending Medical Research Monitoring
Gebruik deze workflow om bij te houden wat er trending is in medisch onderzoek op de PubMed trending-pagina. Handig om actueel te blijven, interne updates samen te stellen, publicaties van concurrenten te volgen of een literatuurmonitoring-pijplijn te voeden.
Voorbeeld van de doelpagina: PubMed Trending
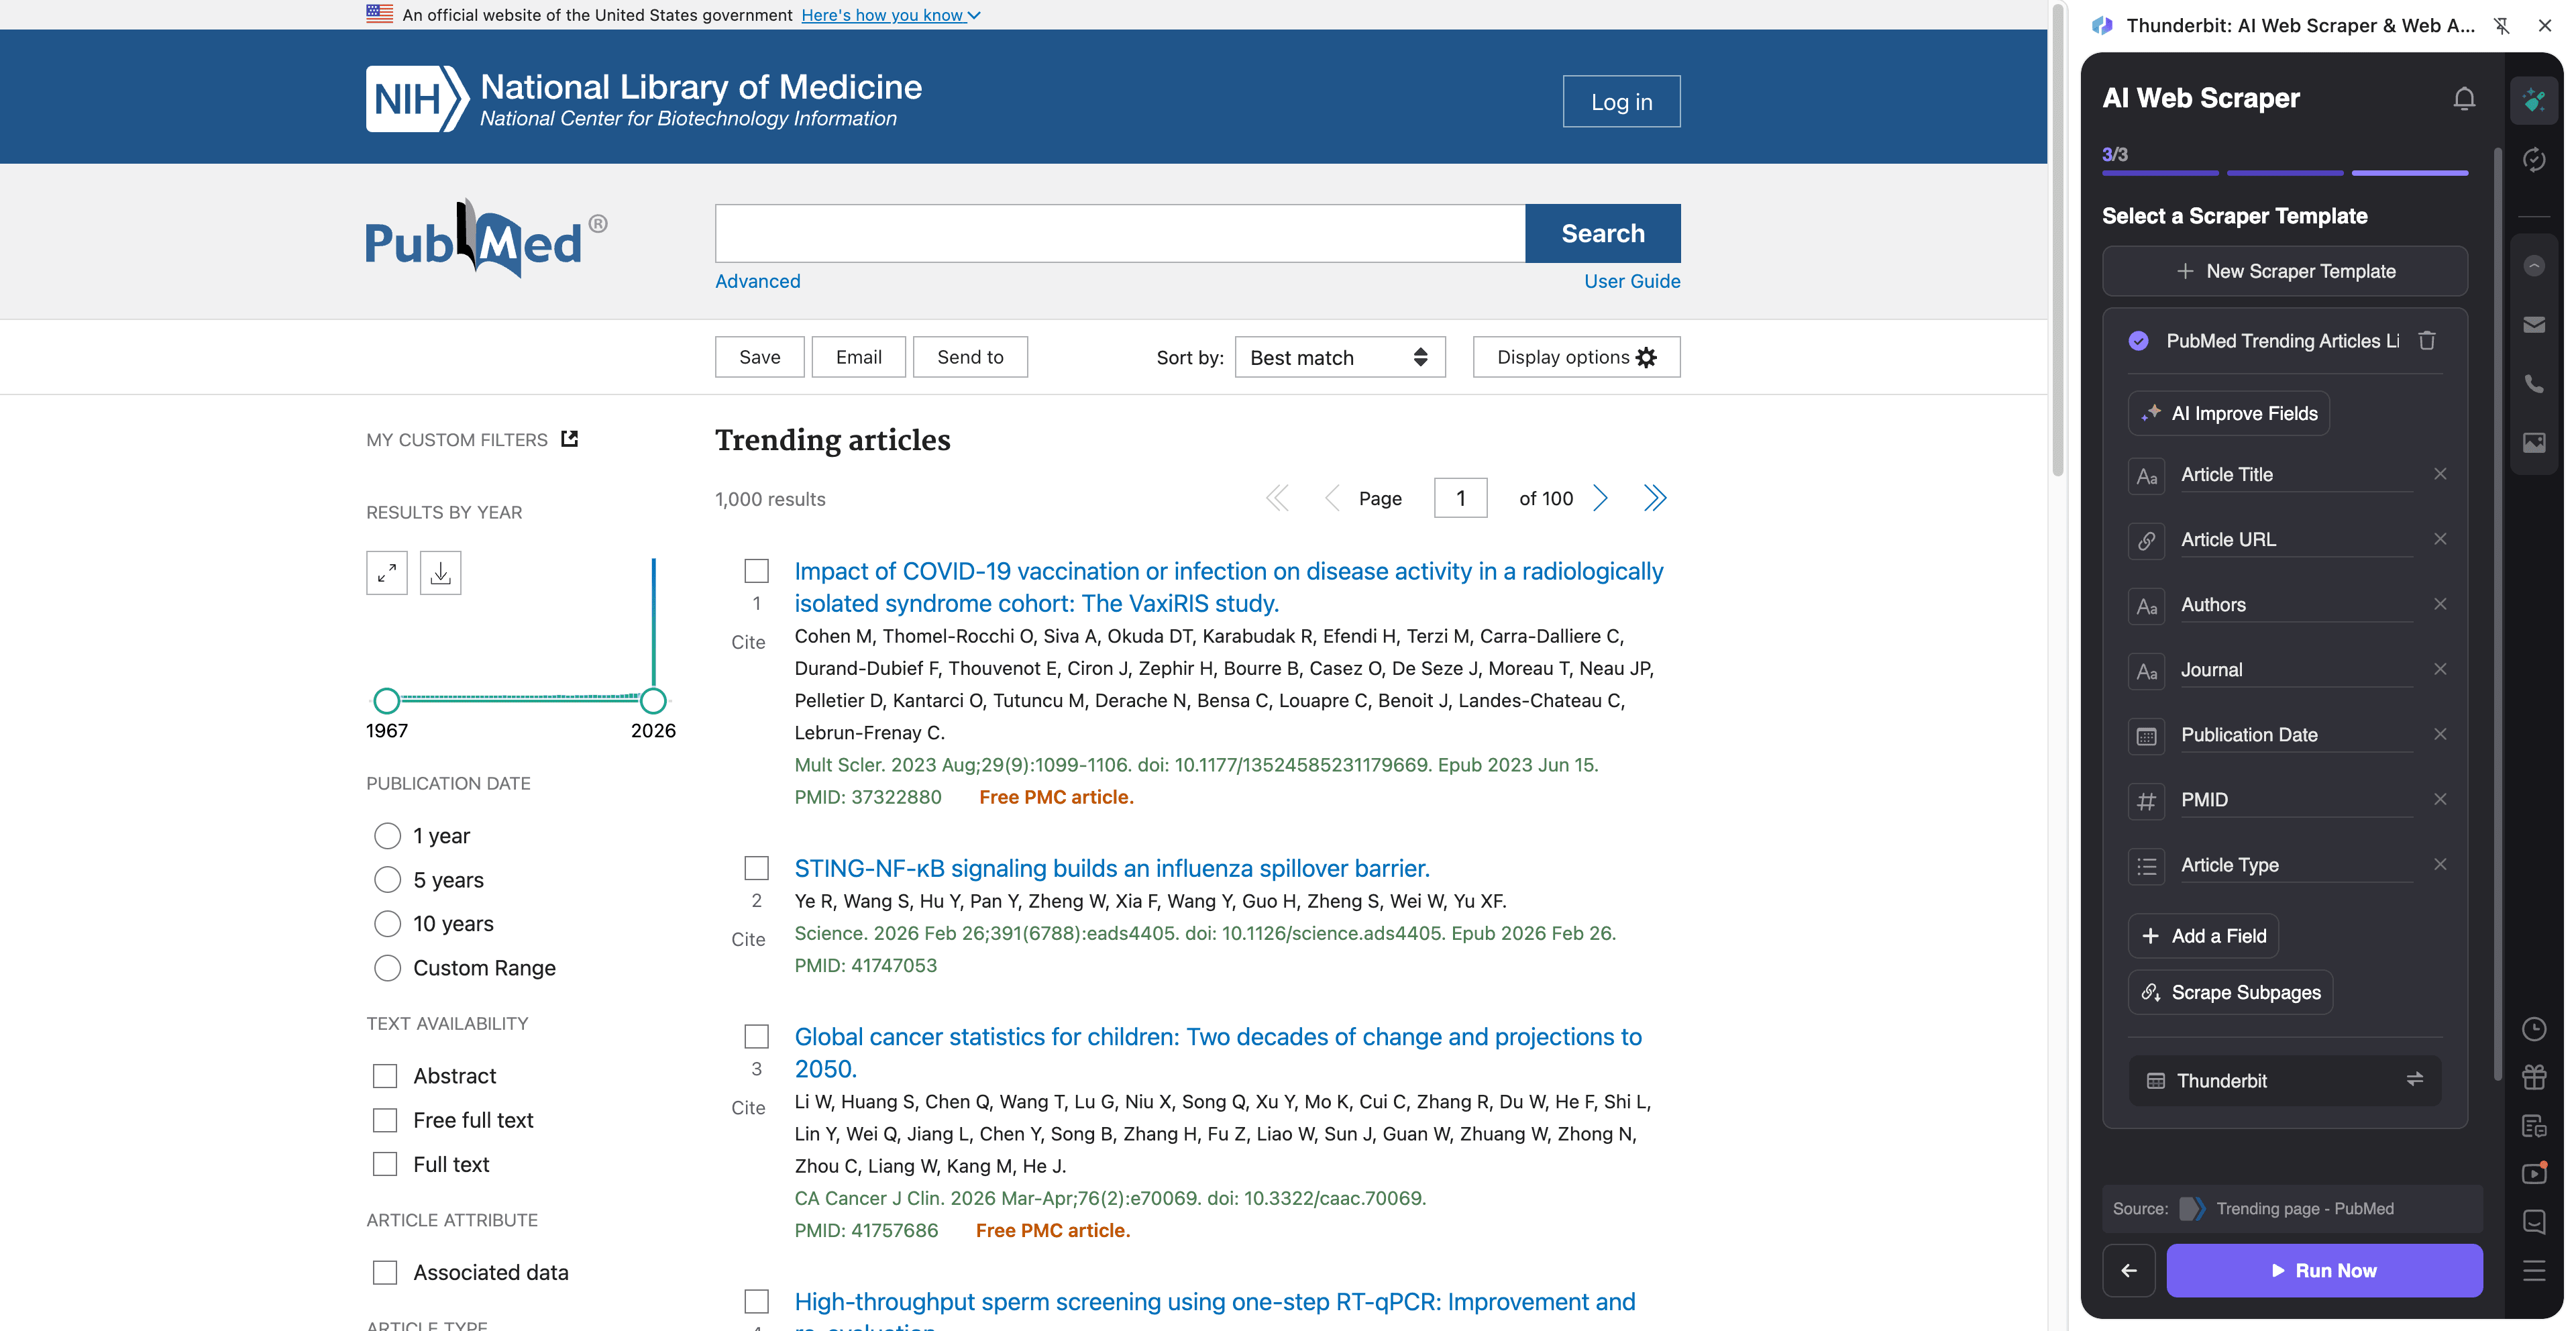
Stappen:
- Download de Thunderbit Chrome Extension en maak een account aan.
- Ga naar de doelpagina, bijvoorbeeld: PubMed Trending.
- Klik op AI Suggest Columns zodat AI de beste kolomnamen en gegevenstypen kan voorstellen.
- Klik op Scrape om de data te extraheren en exporteer daarna naar Excel, Google Sheets, Airtable of Notion.
Kolomnamen
| Kolom | Beschrijving |
|---|---|
| 🧾 Artikeltitel | De titel van het trending PubMed-artikel. |
| 🔗 Artikel-URL | Rechtstreekse link naar de PubMed-recordpagina. |
| 🆔 PMID | PubMed-identificatie van het record (handig als stabiele sleutel). |
| 🏛️ Tijdschrift | Naam van het tijdschrift waarin het artikel is gepubliceerd. |
| 📅 Publicatiedatum | De publicatiedatum zoals weergegeven in de lijst. |
| ✍️ Auteurs | De auteurstekst die op de resultkaart wordt getoond. |
| 🧪 Artikelformaat / type | Publicatietype indien beschikbaar (bijv. Review, Clinical Trial). |
| 🏷️ Trefwoorden / onderwerpen | Zichtbare onderwerpstags of trefwoorden in de vermelding (indien aanwezig). |
| 📝 Snippet / samenvatting | Korte tekstsnippet die in de lijst wordt getoond (indien aanwezig). |
| 🧷 DOI | DOI wanneer beschikbaar (vaak het best op te halen via subpage scraping). |
| 🧑🔬 Affiliaties | Affiliaties van auteurs (meestal via subpage scraping). |
| 📄 Abstract | Abstracttekst (meestal via subpage scraping). |
🧫 Scrape PubMed Clinical Trial Evidence Extraction
Gebruik deze workflow om bewijs rond klinische studies uit PubMed-zoekresultaten te halen en verrijk vervolgens elke rij door de artikelpagina te openen voor abstract, trialsignalen en metadata die je nodig hebt voor review.
Voorbeeld van de doelpagina: Clinical trial search results
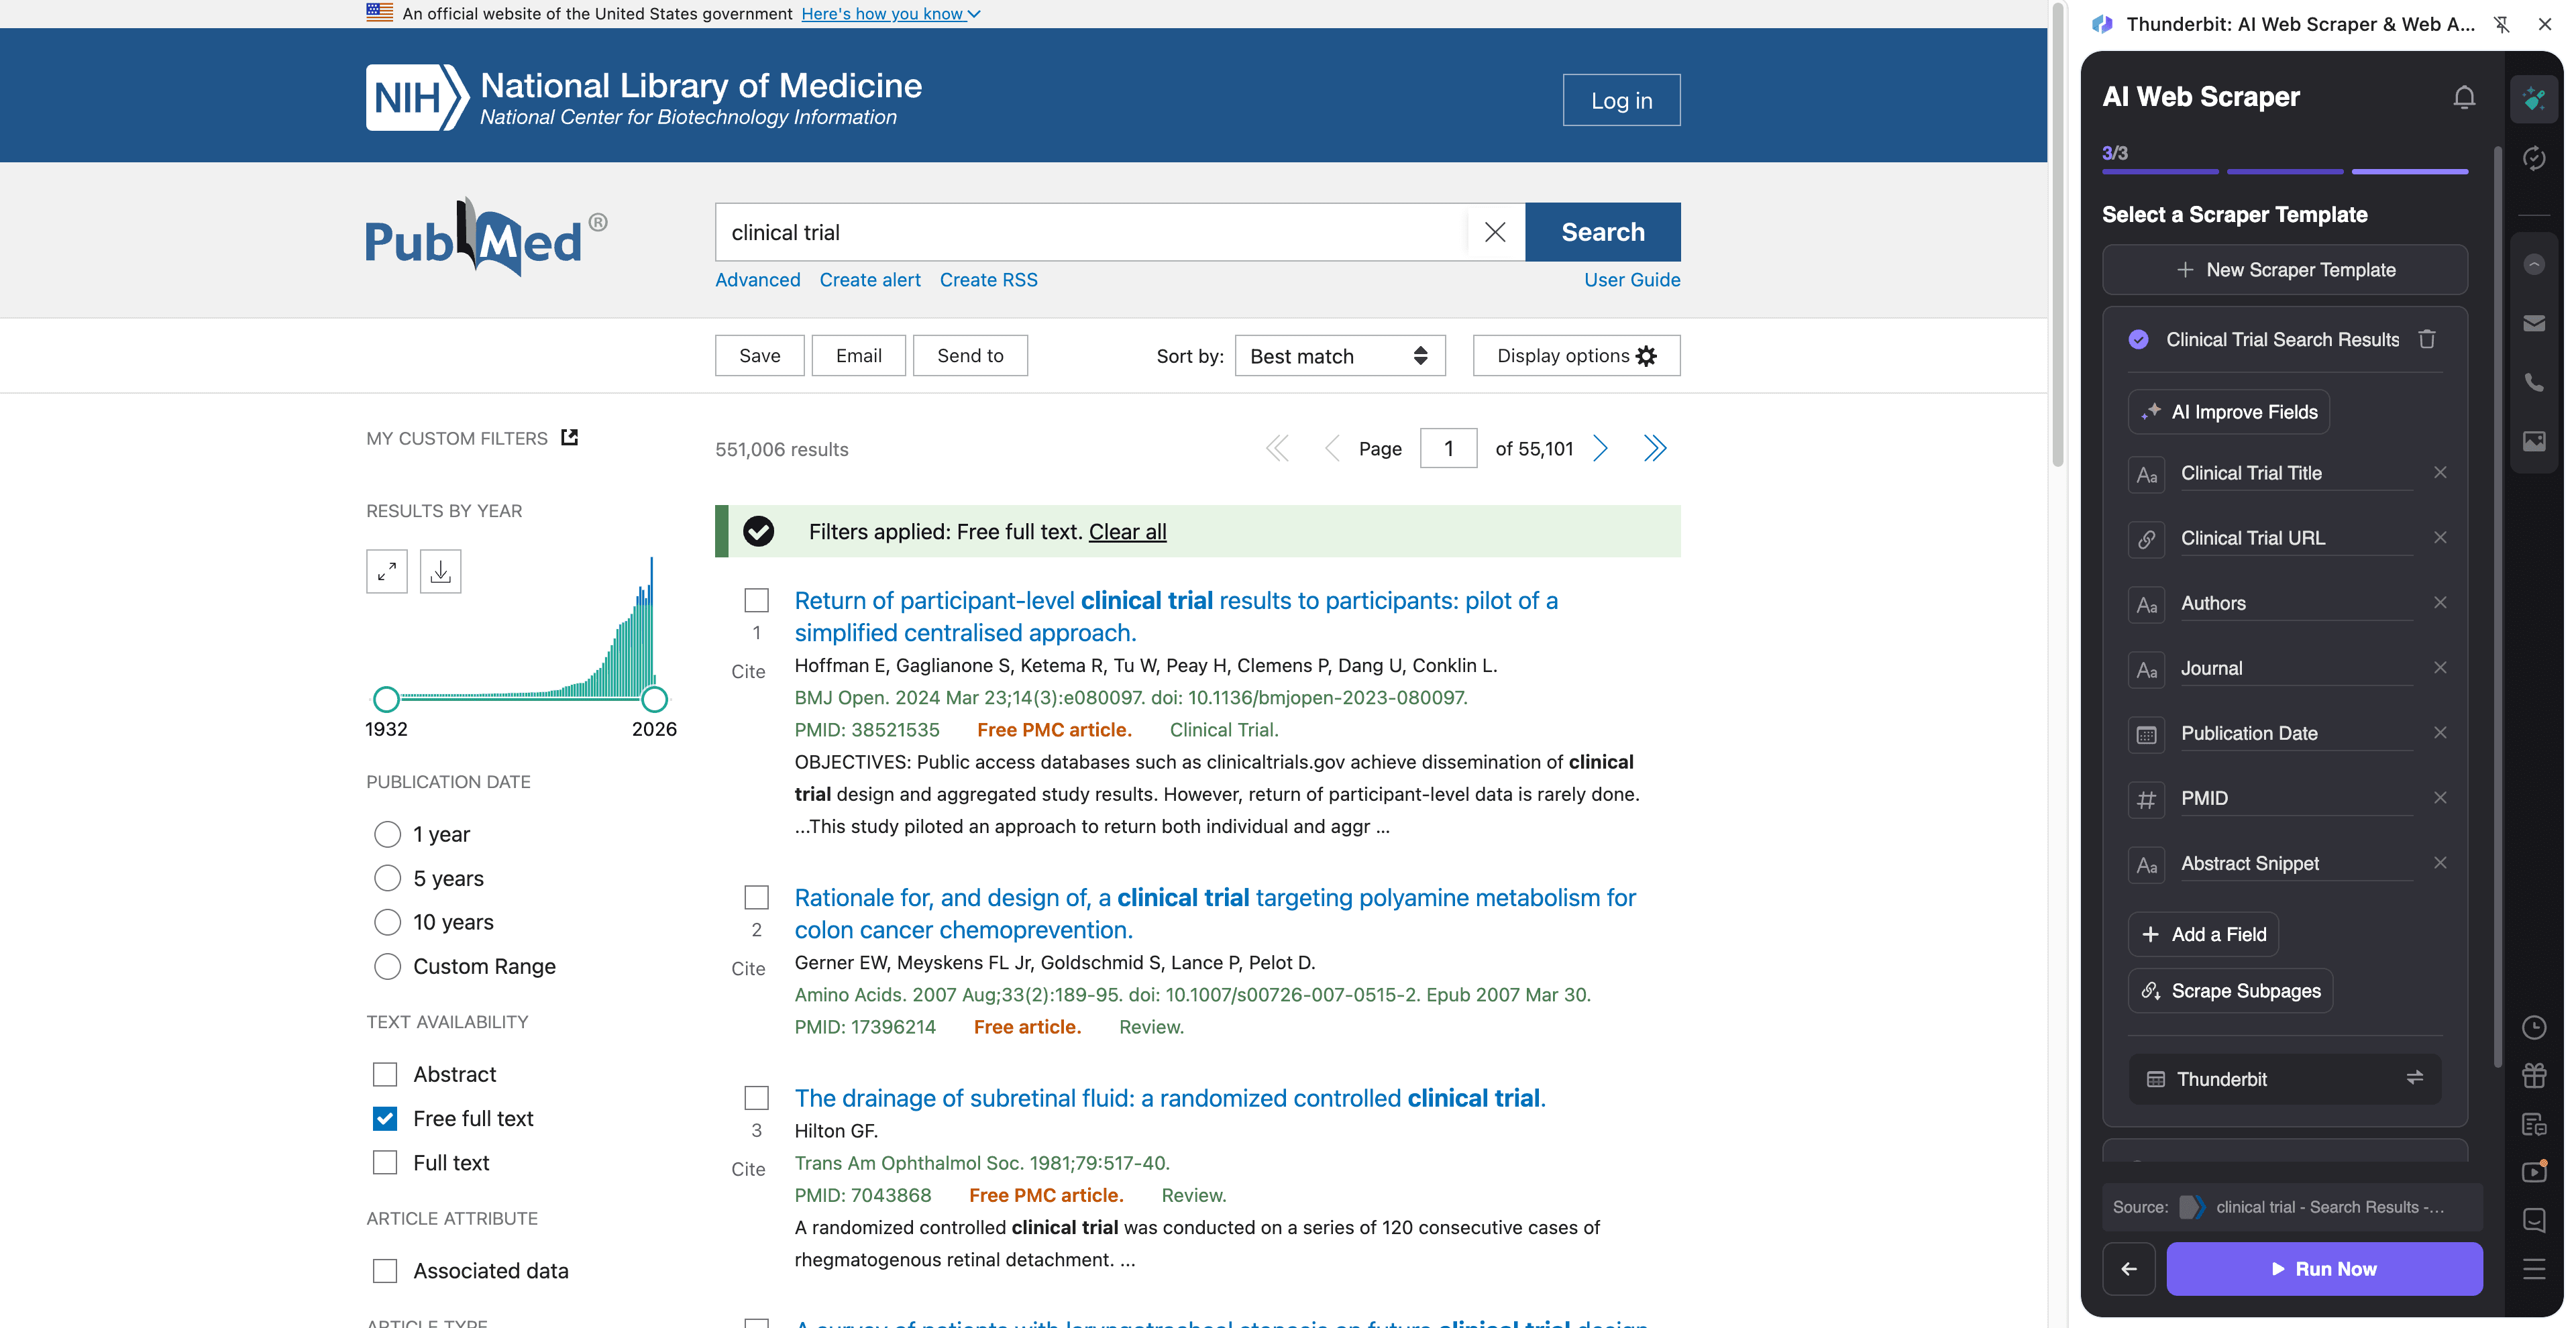
Stappen:
- Download de Thunderbit Chrome Extension en maak een account aan.
- Ga naar de doelpagina, bijvoorbeeld: Clinical trial search results.
- Klik op AI Suggest Columns om aanbevolen velden te genereren (je kunt deze hernoemen of zelf extra velden toevoegen).
- Klik op Scrape om de resultaten te verzamelen en gebruik daarna Scrape Subpages om elke rij aan te vullen met abstract, affiliaties, DOI en meer.
Kolomnamen
| Kolom | Beschrijving |
|---|---|
| 🧾 Titel | Artikeltitel uit de zoekresultaten. |
| 🔗 PubMed-URL | Link naar de PubMed-artikelpagina voor verrijking via subpagina’s. |
| 🆔 PMID | PubMed-identificatie voor deduplicatie en verwijzing. |
| 🧑⚕️ Auteurs | Auteurs die in de resultsnippet worden vermeld. |
| 🏛️ Tijdschrift | Tijdschriftnaam en citatiegegevens zoals getoond in de resultaten. |
| 📅 Datum | Publicatiedatum (of ePub-datum) zoals weergegeven in de lijst. |
| 🧪 Publicatietype | Signalen zoals Clinical Trial, Randomized Controlled Trial, Meta-Analysis (vaak duidelijker op de artikelpagina). |
| 🧾 Abstract | Volledige abstracttekst (het best via subpage scraping). |
| 🧬 MeSH-termen | Medical Subject Headings wanneer beschikbaar (vaak op de artikelpagina). |
| 🧷 DOI | DOI voor koppelingen naar uitgeverspagina’s en referentiemanagers. |
| 🏥 Affiliaties | Affiliaties van auteurs voor institutionele analyse (subpage scraping). |
| 🌍 Land / instelling | Geparseerd uit affiliaties met Field AI Prompts (optioneel). |
| 🔍 Kernwoorden voor klinische studies | AI-labels zoals “randomized”, “double-blind”, “placebo” (optioneel via Field AI Prompt). |
| 📎 Volledige-tekstlinks | Uitgaande links naar uitgevers of gratis full text indien aanwezig. |
🎯 Waarom de PubMed-tool gebruiken
PubMed scrapen draait om snelheid, consistentie en het bruikbaar maken van onderzoeksdata in je workflow. In plaats van citaties één voor één te kopiëren, kun je een gestructureerde dataset opbouwen die je kunt filteren, taggen en delen.
Veelvoorkomende redenen waarom teams PubMed scrapen:
- Medical affairs- en farma-teams: Volg nieuwe publicaties binnen een therapeutisch gebied, monitor concurrentiestudies en bouw evidence-tabellen voor interne reviews.
- Biotech- en clinical operations-teams: Verzamel publicaties over studies, breng instellingen en onderzoekers in kaart en houd een levende literatuurlijst bij.
- Healthcare marketing- en contentteams: Identificeer trending onderwerpen, toptijdschriften en opkomende zoekwoorden voor contentplanning.
- Academische onderzoekers en bibliothecarissen: Bouw datasets voor literatuuronderzoek, dedupliceer op PMID en exporteer naar spreadsheets voor screening.
- Datateams: Maak gestructureerde input voor analytics, dashboards of interne kennisbanken.
Thunderbit is vooral handig wanneer je meer nodig hebt dan alleen de lijstpagina. Met Subpage Scraping kun je op schaal abstracts, affiliaties, DOI, MeSH-termen en full-textlinks extraheren.
🧩 Hoe gebruik je de PubMed Chrome-extensie
- Installeer de Thunderbit Chrome-extensie: Download deze uit de Chrome Web Store en maak je account aan.
- Navigeer naar een PubMed-pagina: Open PubMed, een trending-pagina zoals Trending, of een zoekopdracht zoals clinical trial results.
- Activeer de AI-gestuurde scraper: Klik op AI Suggest Columns om velden te genereren, pas gegevenstypen aan (tekst/datum/url) en voeg optionele Field AI Prompts toe voor labeling, opmaak of het extraheren van trialsignalen.
- Scrape en exporteer: Klik op Scrape. Als je abstracts/affiliaties/MeSH nodig hebt, gebruik dan Scrape Subpages om elke rij te verrijken en exporteer daarna naar Excel, Google Sheets, Airtable of Notion.
Handige lectuur als je een herhaalbare workflow wilt bouwen:
- How to Scrape Any Website Using AI
- What Is Data Scraping and How to Do It in 2025
- How to Scrape Website Data into Excel using AI
- What Is List Crawling and How to Do It Using AI
💳 Prijzen voor PubMed
Thunderbit werkt met een eenvoudig creditsysteem:
- 1 credit = 1 uitvoerregel in je resultatentabel (bijvoorbeeld één PubMed-record).
- Data exporteren is gratis: download CSV/JSON of stuur naar Excel, Google Sheets, Airtable of Notion.
Je kunt beginnen met:
- Gratis tier: scrape 6 pagina’s per maand (pagina-gebaseerde limiet in de gratis versie).
- Gratis proefperiode: scrape 10 pagina’s gratis, ideaal om PubMed-trendingpagina’s en een paar klinische-studieresultaten te testen.
Als je regelmatig scraped (wekelijkse monitoring, evidence-updates of grote zoekopdrachten), geven betaalde plannen je meer credits. Het jaarabonnement is doorgaans voordeliger omdat het korting bevat ten opzichte van maandelijks betalen.
Je kunt de opties bekijken op Thunderbit Pricing.
❓ FAQ
-
Wat is de AI-aangedreven PubMed-scraper?
De AI-aangedreven PubMed-scraper is een workflow in Thunderbit die gestructureerde data uit PubMed-zoekresultaten en artikelpagina’s haalt. Je kunt AI gebruiken om kolommen voor te stellen, lijsten te scrapen en elke rij te verrijken door artikel-subpagina’s te bezoeken voor abstracts, affiliaties, DOI en meer. -
Wat is Thunderbit?
Thunderbit is een AI-webscraper Chrome-extensie voor zakelijke en onderzoeksworkflows waarin je gestructureerde data van websites nodig hebt. Het helpt je data snel te extraheren, labelen en exporteren, zonder scraping-scripts te bouwen of te onderhouden. -
Kun je PubMed-trendingpagina’s en gewone zoekresultaten scrapen?
Ja. Je kunt de PubMed Trending pagina, standaard zoekopdrachten op trefwoorden en gefilterde resultaatpagina’s scrapen (zoals queries gericht op klinische studies). Thunderbit’s AI past zich aan verschillende layouts aan door de pagina te lezen en velden voor te stellen. -
Kan Thunderbit abstracts, affiliaties en MeSH-termen extraheren?
Ja, en daar komt Subpage Scraping het meest van pas. Je kunt eerst de resultatenlijst scrapen en vervolgens Thunderbit elke PubMed-recordpagina laten openen om abstracttekst, affiliaties, MeSH-termen, DOI en andere metadata in dezelfde tabel te zetten. -
Hoe werken pagination en infinite scroll op PubMed?
Thunderbit ondersteunt scrapen met paginering, inclusief navigatie via “volgende pagina”. Als PubMed verandert hoe resultaten laden, is AI-gebaseerde extractie meestal robuuster dan vaste selectors, omdat de pagina-structuur bij elke run opnieuw wordt gelezen. -
In welke formaten kan ik PubMed-data exporteren?
Je kunt exporteren naar CSV of JSON, of de dataset sturen naar Excel, Google Sheets, Airtable of Notion. Dat is handig voor screeningworkflows, evidence-tabellen, dashboards en samenwerking met collega’s. -
Hoeveel PubMed-records kan ik gratis scrapen?
In de gratis tier kun je 6 pagina’s per maand scrapen, wat vaak genoeg is voor kleine monitoringtaken. Met de gratis proefperiode kun je 10 pagina’s gratis scrapen om je kolomopzet en subpage-verrijking te testen. -
Kan ik kolommen aanpassen voor specifieke evidence-extractie?
Ja. Je kunt kolommen hernoemen, gegevenstypen instellen (tekst/datum/url) en Field AI Prompts toevoegen om informatie te extraheren of labelen, zoals trefwoorden voor studiedesign, populatie, interventie, comparator, uitkomsten of land uit affiliaties. Zo ga je verder dan rauwe scraping en bouw je gestructureerde evidence-voorbereiding. -
Mag je PubMed scrapen?
PubMed is een publieke bron en veel teams verzamelen bibliografische metadata voor onderzoek en analyse. Je moet wel de toepasselijke wetgeving volgen, rekening houden met de voorwaarden van de website en verantwoord scrapen, vooral bij grote en frequente runs.
📚 Meer leren
- Download de extensie: Thunderbit Chrome Extension Download Page
- Bekijk gidsen op de Thunderbit Blog
- Leer de basis: What Is Data Scraping and How to Do It in 2025
- Bouw lijstworkflows: What Is List Crawling and How to Do It Using AI
- Exporteren naar spreadsheets: How to Scrape Website Data into Excel using AI
- Als je in research ops ook PDF’s scrapt: How to Scrape Data from PDF using AI










